
Can Agentic Trading Systems Pay for Their Own Intelligence?
Qiqi Duan, Changlun Li, Chen Wang, Fan Zhang, Mengxiang Wang, Dayi Miao 외 6명
AI 트레이딩 봇이 돈을 벌었다면, 그중에서 정말로 "AI가 벌어 준 돈"은 얼마일까? 이 논문은 그 계산을 처음부터 끝까지 제대로 해 본 결과, 대부분의 인기 LLM이 자기 지능값조차 못 벌어들이는 것으로 나타났다 — 그런데 진짜 교훈은 따로 있다.
들어가며: 카페 사장님의 불안
동네 카페를 하나 차렸다고 상상해 봅시다. 한 달이 지나 장부를 보니 매출이 들어오긴 했습니다. 그런데 이걸로 "장사가 잘 된다"고 말할 수 있을까요? 커피 원두값, 알바생 월급, 월세, 전기세를 다 빼고 남은 돈이 있어야 진짜 남는 장사입니다. 매출이 높아 보여도 비용을 빼면 마이너스인 가게가 의외로 많죠.
최근 트레이딩 세계에서는 "AI 트레이딩 봇"이 화제입니다. 인공지능(LLM, 대규모 언어 모델)이 뉴스를 읽고, 시장을 분석하고, 직접 매매 결정을 내리는 시스템이죠. 그런데 이런 시스템을 평가하는 방식을 보면, 마치 "카페 매출만 보고 장사가 잘 된다고 말하는" 것과 비슷한 구석이 있습니다. 대부분의 연구가 총수익이나 Sharpe 지표(위험 대비 수익 지표)만 보여 주거든요.
잠깐만요. 그 AI는 판단을 하면서 계속 값을 치릅니다. 모델에게 질문할 때마다 돈이 나가고(추론 비용), 도구를 호출하고, 실시간으로 판단을 이어가죠. 이 비용을 다 빼고도 남는 돈이 있어야 "AI를 쓰길 잘했다"는 말이 성립합니다. 수익이 10만 원인데 AI 쓰는 데 15만 원이 든다면, 그건 그냥 비싼 취미죠.
오늘 살펴볼 논문(Can Agentic Trading Systems Pay for Their Own Intelligence?, arXiv:2607.10286)은 바로 이 질문을 정면으로 다룹니다. "이 AI 트레이딩 시스템은 자기 지능값(pay for their own intelligence)을 스스로 벌어들이는가?"
무엇이 문제였나: "수익이 났다"와 "AI가 값어치를 했다"는 다르다
기존의 AI 트레이딩 시스템 평가는 대체로 이런 식이었습니다. "우리 시스템으로 두 달간 운용했더니 수익이 났어요!" 또는 "Sharpe 지표가 경쟁 모델보다 높아요!"
물론 이런 지표가 쓸모없는 건 아닙니다. 하지만 실제 운용을 하려는 사람(개발자이든 투자자이든)에게는 두 가지가 더 필요합니다.
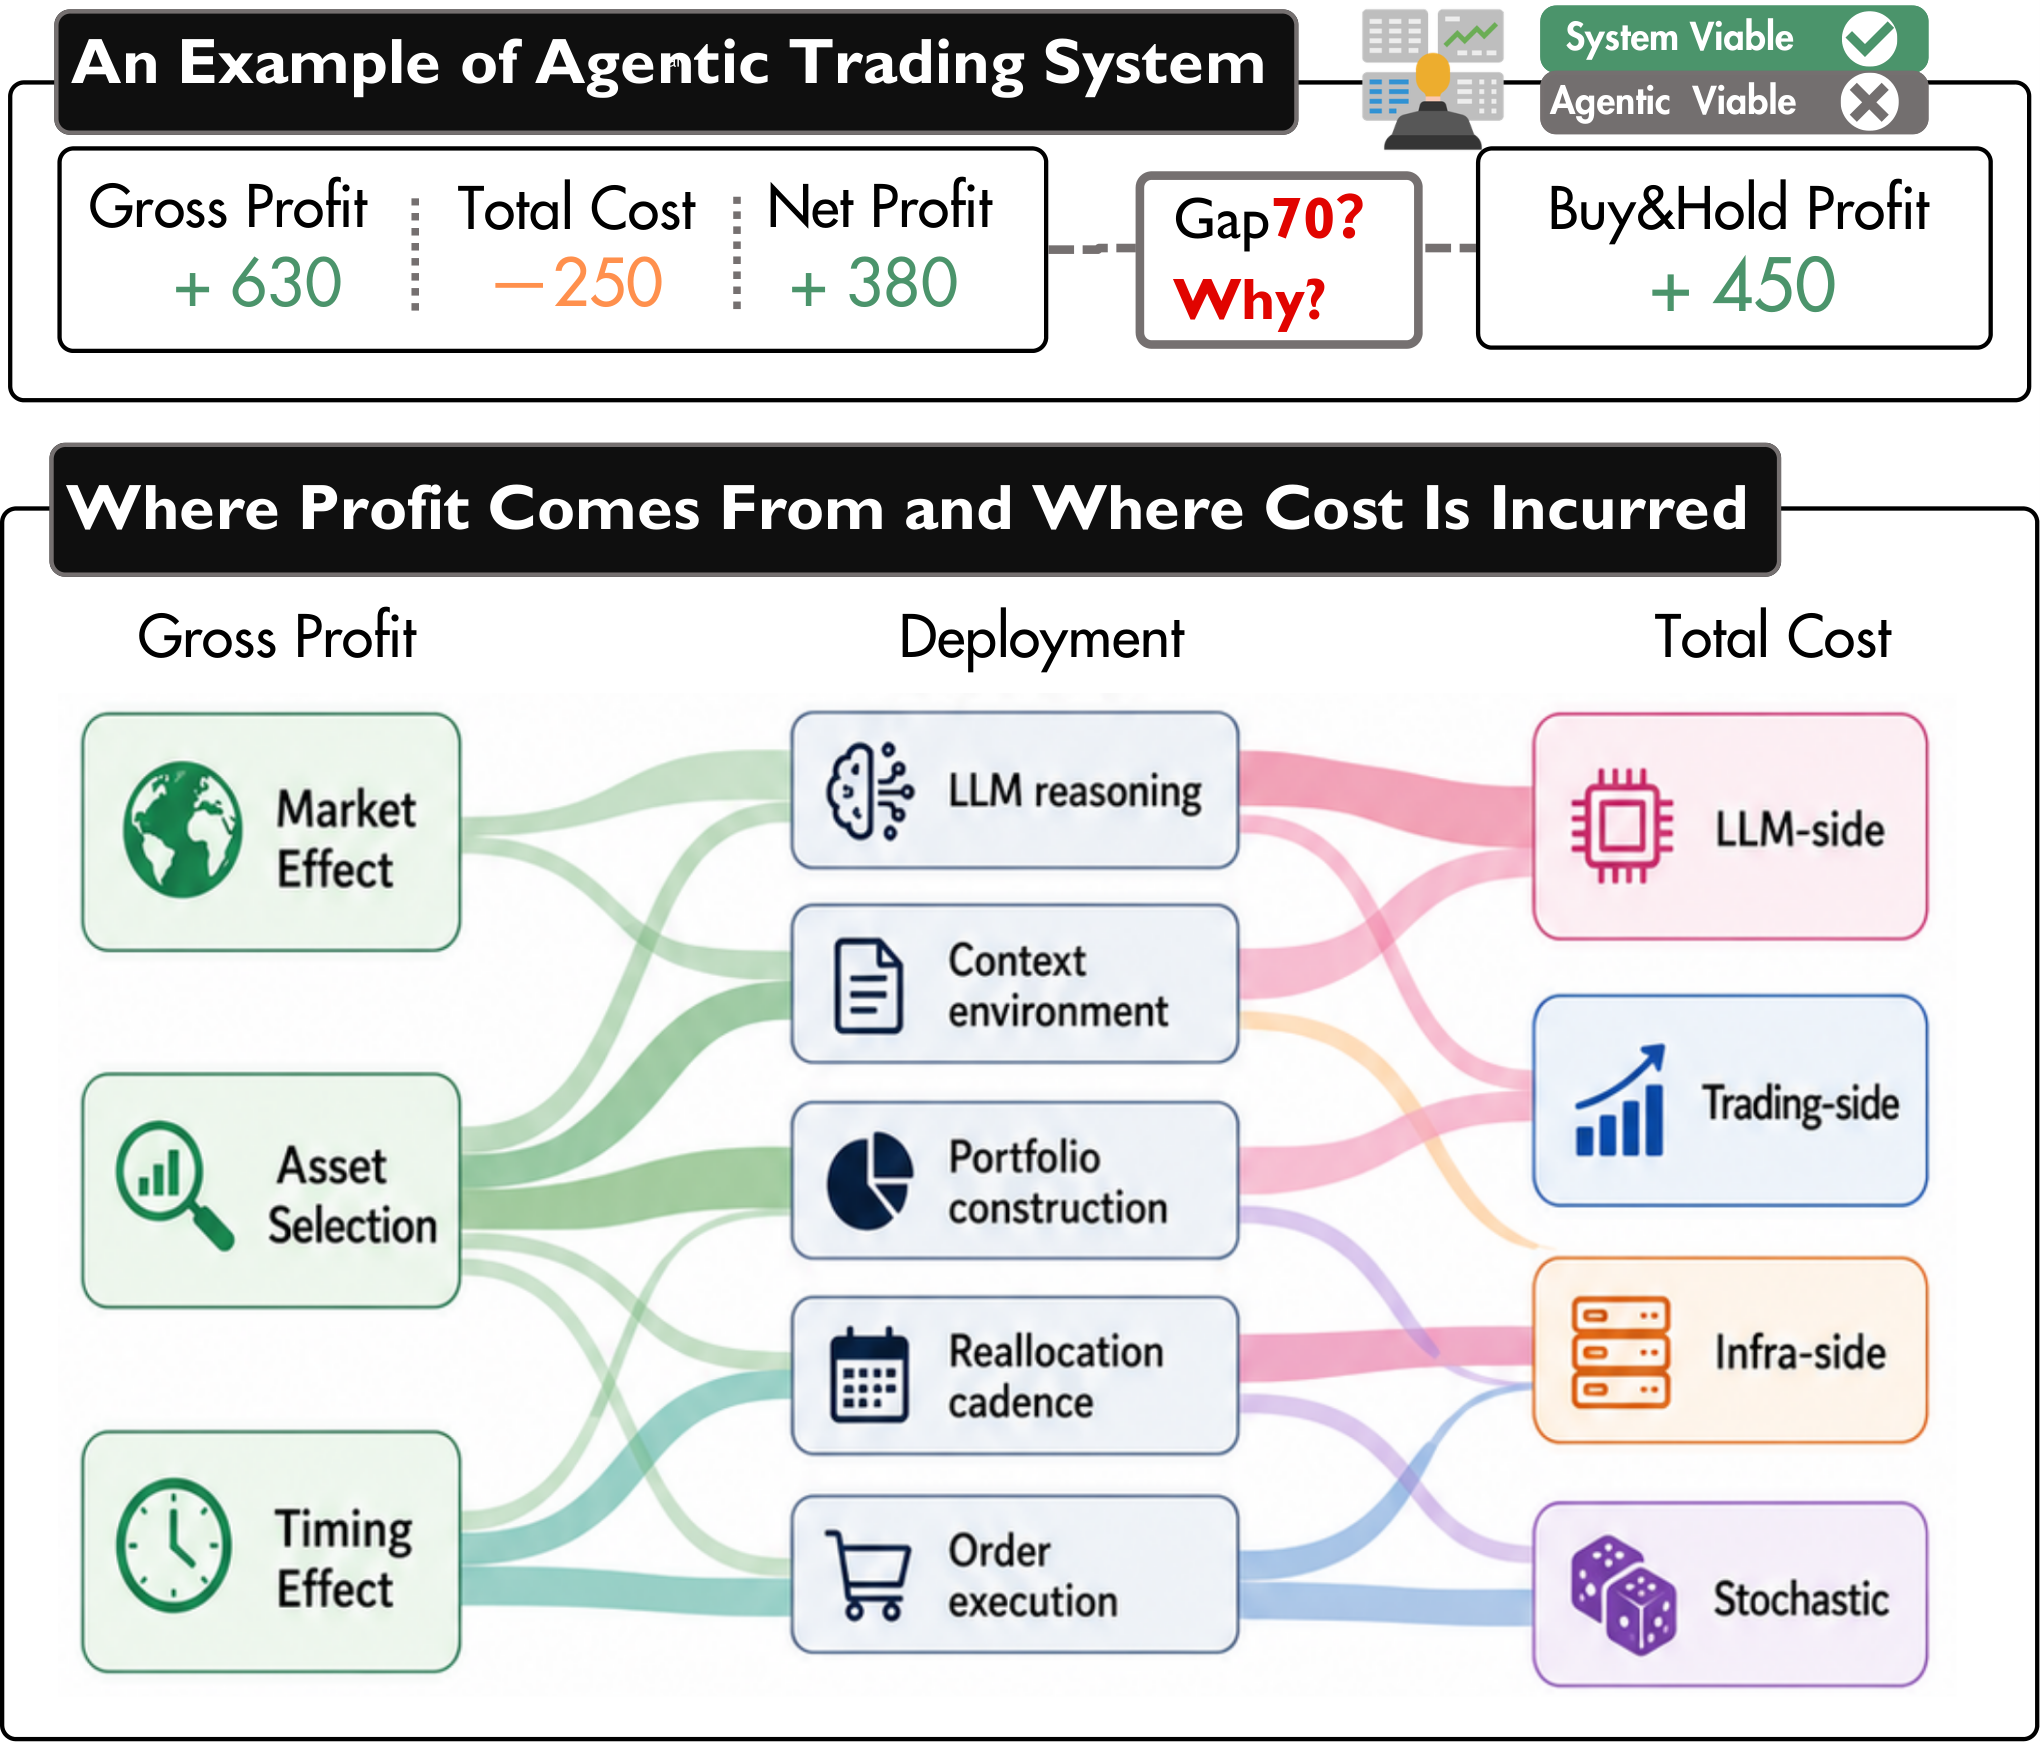
첫째, 그 수익이 어디서 나왔는지. 두 달간 주식 시장 자체가 올랐다면, 아무것도 안 하고 지수를 사 두기만 해도 수익이 납니다. 진짜 실력은 "시장이 그냥 준 돈" 말고, 종목을 잘 고르거나 매매 타이밍을 잘 잡아서 만든 돈이어야 합니다. 똑같이 "수익 100만 원"이라도 시장이 80만 원을 갖다 준 것인지, AI가 100만 원을 벌어 준 것인지 전혀 다른 이야기죠.
둘째, 그 수익이 비용을 넘어서는지. LLM은 공짜가 아닙니다. 판단할 때마다 토큰 비용이 쌓이고, 도구 호출과 재시도도 돈이 듭니다. 게다가 거래 수수료, 데이터 구독료, 서버 비용도 있고요. 논문은 이걸 "토큰 경제(token-economy)" 요구사항이라고 부릅니다. 쉽게 말해 "AI가 소비한 지능값만큼의 증분 이익을 내야 한다"는 조건입니다.
더 구체적인 함정이 하나 있습니다. 총수익이 플러스여도 AI의 개입이 마이너스일 수 있다는 점입니다. AI가 처음에 종목을 잘 골라 놓고(선택이 좋음), 그 후에 이리저리 사고팔며(타이밍이 나쁨) 돈을 까먹을 수 있거든요. 총액만 보면 멀쩡해 보이는데, 자세히 뜯어보면 "안 건드리면 더 많이 벌었을" 수도 있는 겁니다.
핵심 아이디어: 돈의 출처를 세 갈래로 갈라서 본다
이 논문이 제안하는 방법은 회계 감사와 닮았습니다. 이름하여 손익 귀인(profit attribution) — 벌어들인 돈을 "누구 덕분"인지 나눠 보는 거죠.
수익을 세 가지로 갈라 봅니다.
- 시장 효과(market effect): 처음에 투자한 돈을 그냥 시장 전체(실험에서는 S&P 500)에 넣어 두기만 했을 때 벌었을 돈. 아무 실력 없이 배 타고 간 값이죠.
- 자산 선택 효과(asset selection): AI가 처음에 고른 종목을 그대로 들고만 있었을 때의 추가 이익. "종목 고르기 실력"입니다.
- 타이밍 효과(timing): 실제로 AI가 이리저리 재배분하며 만든 추가 이익. 동적인 AI 개입이 만들어 낸 돈이 바로 이 부분입니다.
비용도 같은 방식으로 갈라 봅니다. LLM 추론 비용(질문할 때 나가는 돈), 거래 실행 비용(수수료 등), 인프라 비용(서버·데이터 구독), 그 밖의 잡비. 그다음 두 가지 질문에 답합니다.
- 시스템 생존성: 총수익 − 총비용 ≥ 0 인가? (파이프라인 전체가 본전 이상인가)
- 에이전트 생존성: 타이밍 효과 − (AI가 유발한 동적 비용) ≥ 0 인가? (AI의 '움직임'이 자기 값어치를 하는가)
두 번째가 이 논문의 핵심입니다. 시스템이 돈을 벌어도, 그 돈이 전부 "처음에 잘 골라 놓은 덕"이고 AI의 잦은 개입이 오히려 손해였다면 — 그 AI는 사실 무임승차입니다. 반대로 총액은 작게 손해여도 AI의 타이밍이 큰 플러스라면, 다른 부분을 고치면 되니 AI 자체는 값어치가 있는 겁니다.
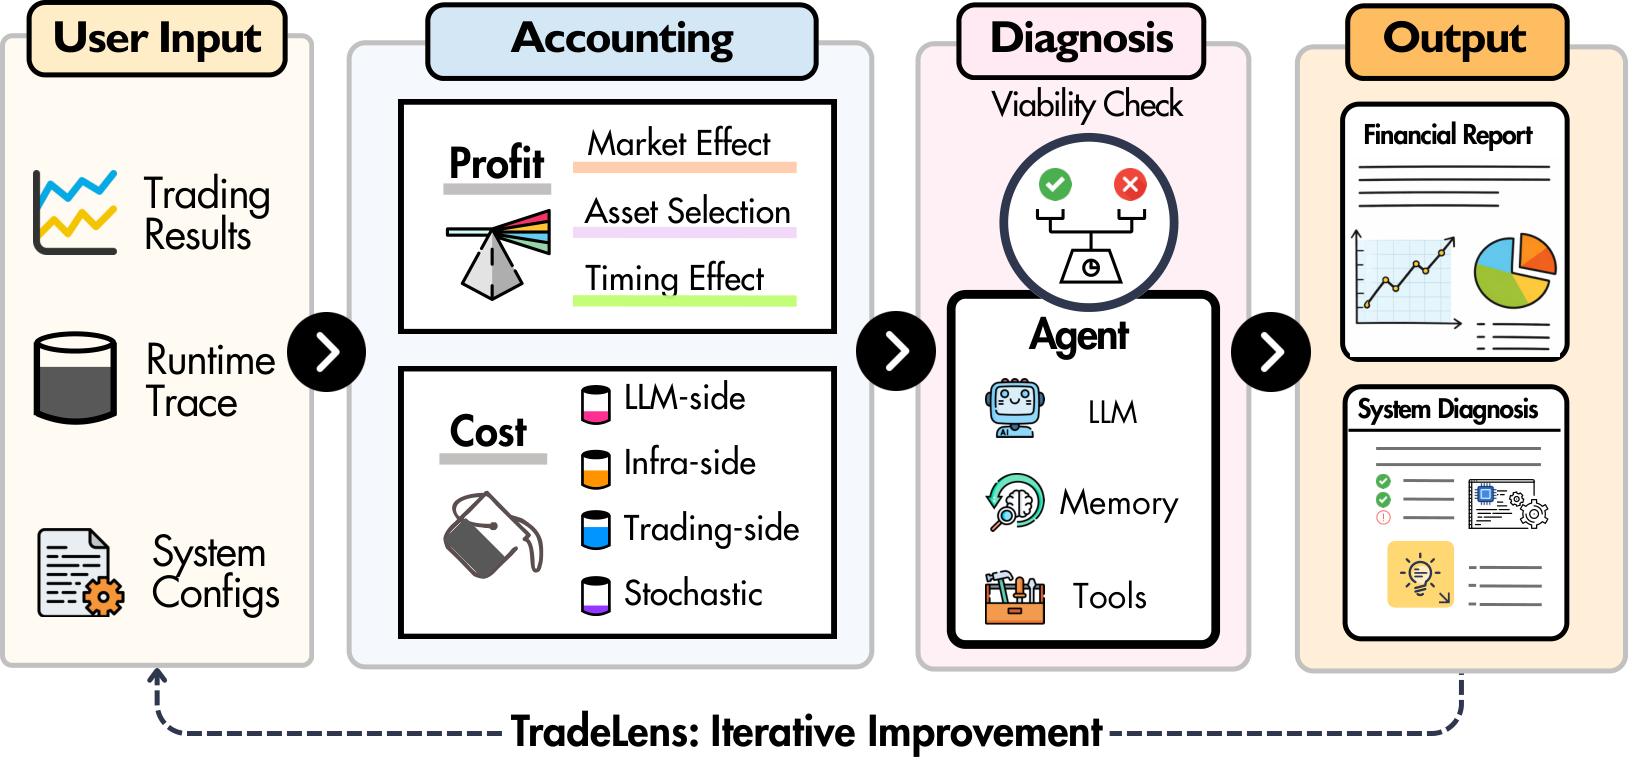
저자들은 이 회계·감사 과정을 자동화한 도구 TradeLens를 만들고, 코드도 공개했습니다(개인·소규모 트레이더도 쓸 수 있게 설계했다고 명시). 어떤 에이전트 구조든 상관없이, 남기는 기록(거래 결과 + 실행 기록 + 설정)만 있으면 감사할 수 있게 만든 것이 특징입니다.
결과 — 무엇을 알아냈나
실험은 꽤 현실적입니다. 미국 유동성 주식, 초기 자본 $100,000(약 1억 3천만 원), 2025년 12월 1일부터 2026년 1월 30일까지 두 달간 운용하는 설정에서, 대표적인 LLM 트레이딩 에이전트 시스템 위에 10개의 LLM 백본(GPT-5.2, Claude Sonnet 4.5, Gemini 3 Flash, DeepSeek-V3.2, Qwen3-Max, GLM-4.7, Kimi-K2, MiniMax-M2.1, Llama-4-scout, Mistral-Large-3)을 얹어 비교했습니다.
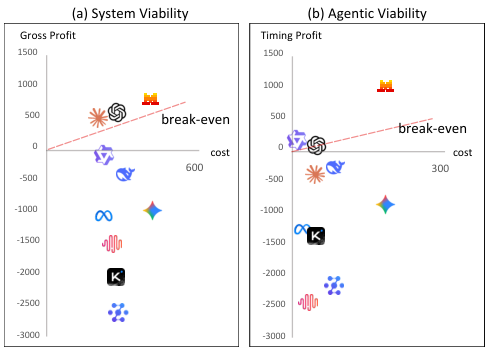
결과는 "대부분의 AI가 자기 값어치를 못 한다"였습니다. 10개 중 시스템 전체가 흑자인 모델은 3개뿐이었고(그중 2개만 AI 개입 자체도 흑자), 나머지는 전부 적자였습니다.
- Mistral-Large-3가 압도적이었습니다. 순이익 +833.52로 10개 중 최고. 타이밍 효과가 +$1,040.14로, 동적 재배분이 진짜 돈을 벌었습니다.
- GPT-5.2는 양쪽 다 플러스이긴 한데(순이익 +45.06로 얇습니다.
- Claude Sonnet 4.5는 재미있는 케이스입니다. 순이익은 +372.86. 즉 "그냥 놔뒀으면 더 벌었다"는 뜻입니다. 시스템은 남는데 AI는 무임승차한 거죠.
- 반대로 Qwen3-Max는 AI 개입은 +273.47. "AI는 쓸모 있는데 시스템 전체가 비싸다"는 이야기입니다.
- 나머지 6개(DeepSeek-V3.2, GLM-4.7, Kimi-K2, MiniMax-M2.1, Llama-4-scout, Gemini 3 Flash)는 두 기준 모두 적자. GLM-4.7이 순이익 −1,500.44), GLM-4.7과 MiniMax-M2.1은 타이밍이 망쳤습니다(각각 −2,380.44).
여기서 가장 흥미로운 발견이 나옵니다. 비용이 문제의 주범이 아니었다는 것. LLM 추론 비용은 모델에 따라 23.84에 불과했고, 오히려 서버·데이터 같은 인프라 고정비(모두 $208.20)가 더 컸습니다. 즉 "AI 쓰는 비용이 아까워서 진 게" 아니라, AI가 내린 판단 자체가 돈을 잃게 만든 것입니다. 진단 결과도 그래서 "토큰을 아끼라"가 아니라 "타이밍 품질을 고쳐라"라는 처방을 내놓았습니다.
논문은 이어서 세 가지 더 확인합니다.
자본을 키우면 나아질까? (아니오, 항상은 아니다). 500,000까지 자본을 늘려 가며 본 결과, 자본 확대는 단순한 "비용 희석"이 아니었습니다. DeepSeek-V3.2는 $500,000에서 오히려 손실이 급격히 커졌고(불리한 타이밍이 증폭), GPT-5.2는 자본이 커져도 타이밍 효과는 여전히 음수였습니다. 큰 돈이 들어오면 잘하는 만큼, 못하는 것도 커지는 겁니다.
더 자주 매매하면 나아질까? (아니오, 오히려 나쁘다). 한 달 구간에서 시간별 매매와 일별 매매를 비교했는데, 두 모델 모두 일별 매매가 이겼습니다. DeepSeek-V3.2는 시간별이 −29.84로 뒤집혔고, GPT-5.2도 −198.28로 개선됐습니다. 원인은 비용 증가만이 아니라, 판단이 잦아질수록 거래 노이즈와 타이밍 오류가 쌓인 탓입니다. "AI니까 24시간 쉴 새 없이 판단시켜야지"라는 직관이 정면으로 뒤집힌 결과입니다.
더 똑똑한 구조면 나아질까? (비싸도, 제대로 된 구조라면 가능). 세 가지 시스템 구조(단순한 생각의 사슬 프롬프트 / 중간 난이도의 AI-Trader / 가장 복잡한 DeepFund)를 비교했는데, 가장 저렴한 단순 구조가 오히려 최악이었습니다(DeepSeek 기준 증분 이익 −$3,285.12). 반면 가장 비싼 DeepFund는 비용이 가장 높음에도 유일하게 손익과 증분 이익이 모두 플러스였습니다. 비용을 더 쓴 게 아니라, 그 비용을 더 나은 타이밍으로 되돌려 받은 것이죠.
한계와 주의점
이 연구 결과를 그대로 일반화하기는 어렵습니다. 논문 스스로도 솔직하게 밝히고 있습니다.
- 특정 설정에서의 진단일 뿐. 두 달 구간, 미국 주식, 초기 자본 $100,000이라는 구체적 조건의 결과이지, 어떤 LLM이 "본래 트레이딩을 잘한다"는 일반론이 아닙니다. 시장 국면이 바뀌면 손익의 출처가 크게 달라진다고 저자들은 강조합니다.
- 벤치마크 선택의 편향. 시장 효과를 S&P 500으로 잡았는데, 실제 운용 유니버스와 안 맞으면 귀인이 약간 틀어질 수 있습니다.
- 비용은 측정이 아니라 입력. 인프라 비용 같은 항목은 사용자가 넣는 값이라, 입력이 부정확하면 진단도 부정확합니다.
- 사용자 평가는 소규모. 소매 트레이더 13명의 정성적 피드백에 그치고, "이 진단을 받고 실제로 의사결정이 좋아졌는지"는 통제 실험으로 검증되지 않았습니다.
- 데이터 재배포 없음. 시장 데이터는 라이선스 구독이 필요한데다 원시 데이터를 공개하지 않아, 완전한 재현에는 데이터 확보 과제가 남습니다. 그래도 진단 도구 자체의 코드는 공개되어 있습니다.
그래서 투자/실무엔?
일반 독자 눈높이에서 정리하면, 이 논문이 남기는 교훈은 세 가지입니다.
첫째, "AI가 돈을 벌었다"는 말은 반쪽짜리다. 어떤 돈이 시장이 그냥 준 것인지, 종목을 잘 골라서 번 것인지, AI가 적절한 타이밍으로 번 것인지 갈라 봐야 합니다. 특히 마지막 항목 — 동적 판단의 증분 이익 — 이 AI의 진짜 값어치입니다. 자기자본으로 AI 트레이딩 시스템을 운용해 보려는 사람들에게는, 이 "증분 이익 회계"가 손익분기점을 따지는 출발점이 됩니다.
둘째, 비용 절감이 만능은 아니다. 놀랍게도 이 실험에서 AI 쓰는 비용은 전체 비용의 작은 부분이었습니다. 문제는 판단의 질이었고, 처방도 "더 싸게 쓰라"가 아니라 "덜 흔들리게, 타이밍을 고쳐라"였습니다. 오히려 매매 빈도를 낮추는(일별) 쪽이 이득이었습니다.
셋째, 구조에 투자하되 "비싼 것이 좋은 것"은 아니다. 가장 싼 구조가 최악이었고, 가장 비싼 구조가 최선이었지만, 그 차이는 비용이 아니라 "추론 비용을 좋은 결정으로 변환하는 능력"에서 나왔습니다. 쓰는 AI가 비싸다는 사실 자체는 아무것도 보증하지 않습니다.
AI 트레이딩이 점점 대중화되는 지금, "성능 순위표" 대신 "자기 값어치를 하는가"를 묻는 이 관점 전환은 꽤 상쾌합니다. 카페 매출 자랑 대신 장부 끝단의 순이익을 보자는 것 — 평범해 보이지만, 아직 아무도 제대로 안 하고 있던 일입니다.
더 알아보기
- 원문: Can Agentic Trading Systems Pay for Their Own Intelligence? (arXiv:2607.10286) — HKUST(GZ), Paradoox AI Research, MBZUAI, E Fund Management 공동 연구. 진단 도구 코드는 논문에 링크되어 있습니다(공개 라이선스, 연구 목적).
- KB 5차원 점수 (참고): 참신성 68 · 실전 적용성 84 · 엄밀성 48 · 재현성 32 · 통찰 76 (종합 65.2, A등급). 재현성 점수는 초록 기반이라 낮게 잡혔지만, 전문 기준으로는 코드가 공개되어 재현 가능성이 상향될 여지가 있습니다.
- 관련 논문 (KB 유사 이웃):
- Time Travel is Cheating: Going Live with DeepFund for Real-Time Fund Investment (arXiv:2505.11065) — 이 글의 실험에서 "복잡한 구조"로 등장한 DeepFund가 실시간 운용에 나선 이야기.
- Beyond Agent Architecture: Execution Assumptions and Reproducibility (arXiv:2606.08285) — 에이전트 아키텍처보다 실행 가정이 재현성을 좌우한다는 분석.
- FinMCP-Bench: Benchmarking LLM Agents for Real-World Financial Tool Use (arXiv:2603.24943) — 금융 도구 사용 LLM 에이전트의 실전 능력 벤치마크.
- TriAgent: Divergence-Aware Multi-Agent Committees for Cost-Efficient Financial Decision Making (arXiv:2607.19794) — 비용 효율을 노린 멀티 에이전트 금융 의사결정.
관련 글
 LLM 트레이딩 에이전트A
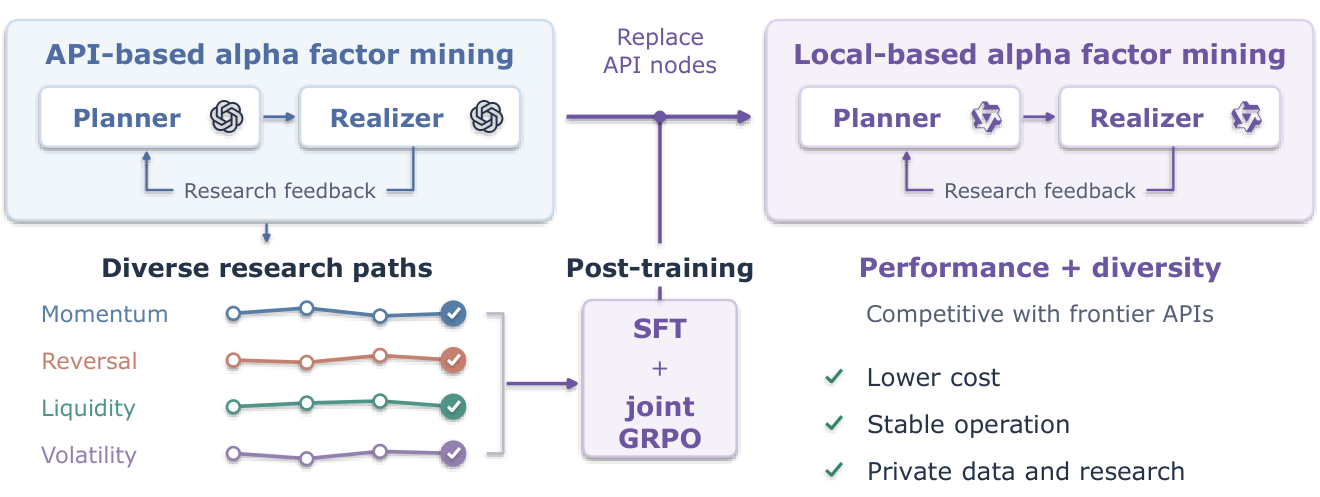
알파 팩터 마이닝 LLM 에이전트: 로컬 훈련으로 탐색 다양성을 되살리다
LLM 멀티 에이전트로 알파 팩터를 자동 발굴하면서도 같은 아이디어만 반복하는 연구 경로 붕괴를 극복하고, 외부 API 없이 로컬 모델로 훈련한 AlphaDiverse 논문을 쉽게 설명합니다. 예측 성능과 탐색 다양성을 함께 얻은 비결과 한계를 짚어봅니다.
 LLM 트레이딩 에이전트A
AI 트레이딩 에이전트 15종 보안 진단 — 80%는 위기 대응, 100%는 보안에서 실패
자금을 직접 굴리는 LLM 트레이딩 에이전트 15개를 견고성과 보안 9개 지표로 진단한 FARSIGHT 연구를 쉽게 풀어 설명합니다. 플래시 크래시 대응 부재, 프롬프트 주입, 에이전트 탈취 위험과 실무 방어 설계까지 AI 트레이딩 보안이 왜 필요한지 알려드립니다.
 딥러닝 가격 예측A
90만 파라미터가 초거대 AI를 이겼다 — 재무제표 5년 장기 예측의 비밀
78개 재무제표 항목을 최대 20분기 앞까지 jointly 예측하는 전문 트랜스포머 Forma가 랜덤포레스트, LLM, 시계열 기반 모델 모두를 압도한 연구를 소개합니다. DCF 밸류에이션의 핵심 입력을 장기로 정확하게 추정하는 방법을 살펴봅니다.