
AlphaDiverse: Post-Training Local Quantitative Research Agents for Diverse Exploration in Alpha Factor Mining
Qingzhuo Wang, Zikun Wei, Zhihua Wei, Wen Shen
AI 에이전트에게 투자 아이디어를 찾게 했더니, 하나의 성공 공식만 반복해서 만들어 내는 '길 잃음'이 발생했습니다. 연구자들은 이 문제를 로컬 모델 훈련과 '다양성 보상'이라는 두 가지로 풀어 냈습니다.
들어가며
직장에서 팀을 꾸려 프로젝트를 할 때 가끔 보이는 상황이 있습니다. 팀에서 어떤 아이디어가 히트를 치면, 그 다음부터 팀은 그 아이디어의 변형만 잔뜩 만들어 냅니다. "지난번에 그게 됐으니까, 이번에도 비슷하게 가보죠." 새로운 방향을 시도하는 제안은 묻히고, 결국 팀이 만든 결과물은 하나의 틀에서 나온 비슷한 것들뿐입니다.
퀀트(계량 투자) 연구에서 '알파 팩터'를 찾는 일도 비슷합니다. 알파 팩터란 주가나 거래량 같은 시장 데이터에서 뽑아낸, 미래 수익률을 예측하는 신호입니다. 예를 들어 "최근 3일 연속 오른 주식은 다음 날 살짝 밀린다" 같은 규칙이죠. 좋은 팩터를 많이 찾을수록 투자 전략의 재료가 풍부해집니다.
요즘은 이 일을 대규모 언어 모델(LLM)에게 시키는 연구가 활발합니다. 여러 AI 에이전트가 역할을 나눠서 — 가설을 세우고, 수식으로 구현하고, 백테스트하고, 결과를 보고 다음 가설을 세우는 — 자동 연구 루프를 돌리는 겁니다. 그런데 이런 시스템을 오래 돌려 보면 위에서 말한 팀의 병이 그대로 나타납니다. 초기에 성공한 몇 개의 경제적 메커니즘(예: 모멘텀, 역전)만 반복 탐색하게 되는 현상. 연구자들은 이걸 연구 경로 붕괴(research path collapse)라고 부릅니다.
2026년 9월에 나온 AlphaDiverse 논문은 이 두 가지 문제 — 외부 API 의존과 연구 경로 붕괴 — 를 동시에 정면으로 다룹니다. 게다가 "AI가 찾은 팩터의 성능을 자랑하는 대신, AI가 얼마나 다양한 아이디어를 탐험했는지"를 정식 평가 지표로 세웠다는 점에서 신선합니다.
무엇이 문제였나
LLM 기반 팩터 마이닝 시스템의 문제점을 하나씩 짚어 봅시다.
첫째, 외부 API 의존입니다. 지금까지의 자동 팩터 연구 시스템은 대부분 GPT 같은 외부 API에 접속해 작동합니다. 그런데 이건 세 가지가 걸려 있습니다.
- 비용: 연구 루프를 수십 번 돌리면 API 사용료가 계속 쌓입니다.
- 안정성: API의 가용성, 응답 속도, 모델의 행동이 우리 통제 밖에 있습니다.
- 기밀성: 자기만의 데이터와 연구 과정은 기밀인 경우가 많은데, 이를 외부 API에 그대로 보낼 수 없습니다. 헤지 펀드 입장에서는 자산입니다.
둘째, 연구 경로 붕괴입니다. 연구 루프가 길어질수록 에이전트는 초기에 성공한 경제적 메커니즘을 반복 확장합니다. 흥미로운 점은, 수식이나 코드 레벨에서 중복 표현을 걸러 내는 장치를 만들어도 이 문제가 해결되지 않는다는 것입니다. 표현은 다른데 경제적 아이디어가 같은 경우가 많기 때문입니다. 예를 들어 "거래량 급증 후 하락"과 "거래대금 급증 후 하락"은 수식은 달라도 같은 메커니즘입니다.
셋째, 보이지 않는 함정 — 테스트셋 튜닝. 자동 연구 시스템은 같은 데이터로 반복 피드백을 받다가, 나중에 그 데이터로 최종 성과를 보고해 버리는 오류에 빠지기 쉽습니다. 시험 문제를 풀면서 답지를 계속 들여다본 셈이죠.
핵심 아이디어
AlphaDiverse의 해법은 크게 세 가지 축으로 이루어집니다.
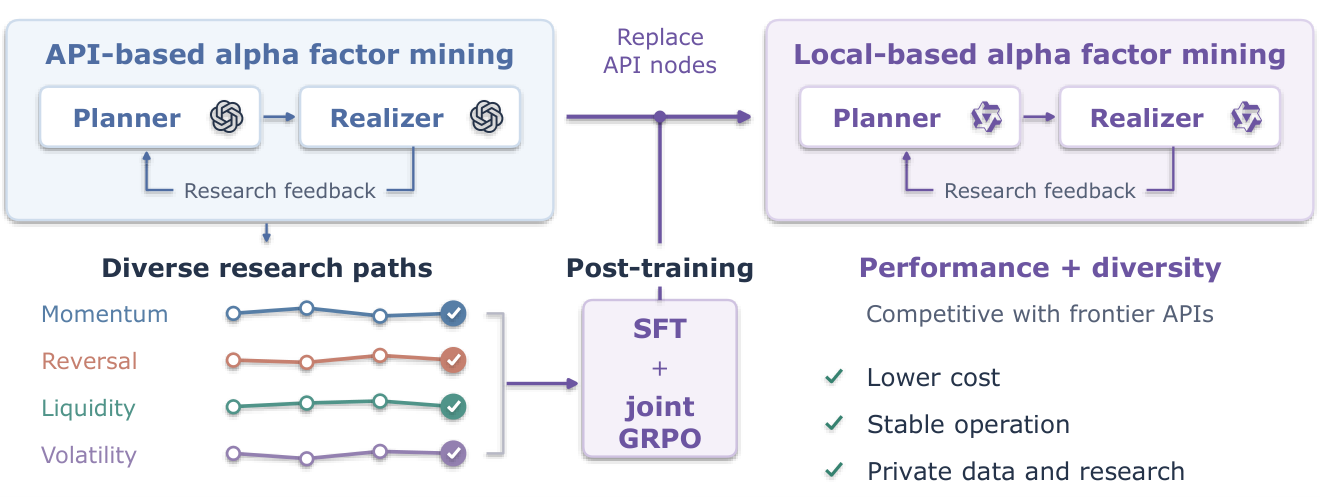
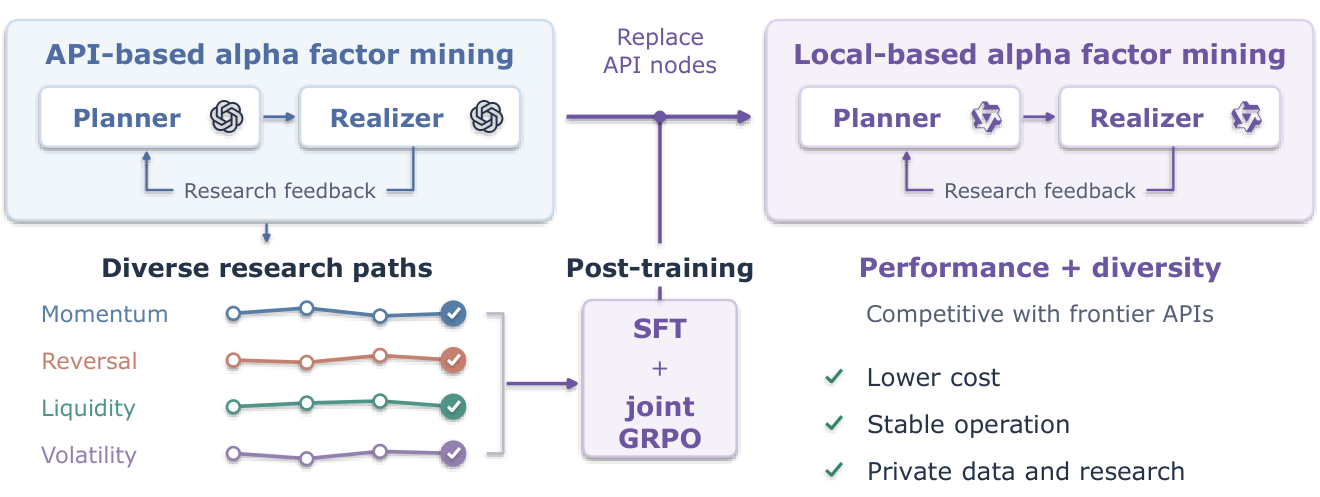
1단계: 연구 루프를 '다양하게' 돌리기. 시스템은 계획(Planner)–구현(Realizer)으로 역할을 나눕니다. Planner는 매 라운드 서로 다른 경제적 메커니즘에 기반한 여러 개의 연구 계획을 '상보적으로'(서로 겹치지 않게) 제안합니다. 최소 세 가지 테마가 한 라운드에 섞이도록 강제하죠. Realizer는 각 계획을 실행 가능한 팩터 수식으로 구현하는데, 하나의 계획에 대해 구조적으로 서로 다른 두 개의 구현을 내야 합니다. 이름만 다르게 바꾼 복사본은 통과되지 않습니다.
이 루프 안에는 몇 가지 안전장치도 있습니다. 미래 정보를 몰래 쓰는 수식(이른바 lookahead leakage)은 컴파일 단계에서 거부되고, 통과된 팩터도 '커버리지(모든 거래일에 값이 있는가), 예측력, 기존 팩터와의 중복성' 세 가지 검사를 모두 통과해야 채택됩니다. 그리고 최종 채택은 "지난번보다 예측 점수가 좋아지고, 여러 검증 구간 중 다수에서도 개선될 때만"이라는 보수적인 규칙을 따릅니다.
2단계: 그 경험으로 로컬 모델 훈련하기. 이렇게 모인 '다양한 연구 궤적'을 교재 삼아, Qwen 같은 로컬 모델을 훈련합니다. 두 단계입니다. 먼저 교사 지도 학습(SFT)으로 연구 방법을 익히게 하고, 다음으로 강화학습(GRPO)으로 두 에이전트를 함께 조율합니다. 이때 보상 함수가 이 논문의 핵심 아이디어입니다.
보상 = 0.75 × 예측 품질 + 0.25 × 다양성
다양성 점수는 "새 계획이 기존 연구 아카이브의 예측을 얼마나 새롭게 바꾸는가"를 행렬의 부피(log det)로 측정합니다. 쉽게 말하면, 이미 낸 아이디어와 비슷한 예측을 만드는 계획은 점수를 적게 받고, 품질이 높으면서 남들과 다른 방향으로 예측을 움직이는 계획을 높게 평가하는 겁니다. 마치 팀 회의에서 "그 아이디어는 지난번이랑 비슷하니 0.25점만 줄게"라고 채점하는 것과 같습니다.
3단계: 시험 데이터와 철저히 격리하기. 데이터를 두 덩어리로 나눕니다. 연구 피드백은 2022년 5월2025년 12월 구간(내부 기간)에서만 받고, 최종 모델과 팩터를 얼린 뒤 2026년 1월8월 구간(외부 기간)에서 단 한 번 평가합니다. 답지를 보지 않고 진짜 실력만 보는 설계입니다.
그리고 훈련이 끝나면, 외부 API 노드를 전부 로컬 에이전트로 교체합니다. 데이터와 연구 궤적이 회사 밖으로 나가지 않고, API 요금도 0원이 됩니다.
결과 — 무엇을 알아냈나
성능과 다양성, 두 축 모두에서 결과를 냈습니다.
예측·투자 성능: 중국 주식 4개 유니버스(CSI300, CSI500, CSI1000, 상하이·선전 A주 전체) 중 대표인 CSI300에서 AlphaDiverse는 정보계수(IC) 0.0378, 순위정보계수(RIC) 0.0407로 비교 대상 전체 1위였습니다. 포트폴리오 측면에서는 연 수익률(ARR) 42.10%로 2위, 정보비율(IR) 3.210, 칼마비율(CR) 7.641, 최대낙폭(MDD) 5.51%로 위험 조정 지표는 모두 1위였습니다. 참고로 이 수치들은 평가 기간(2026년 1~8월)과 특정 시장 국면에 대한 것이며, 거래비용 반영 방식이 논문에 명확하지 않아 실전 수익으로 그대로 읽으면 안 됩니다.
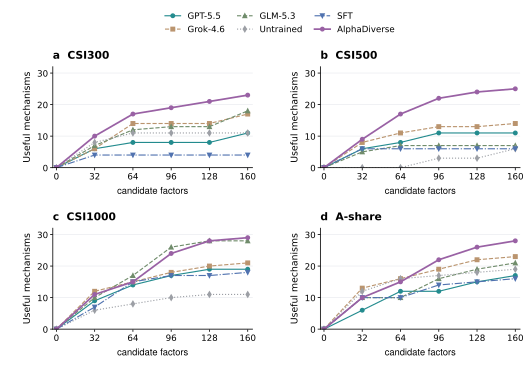
탐색 다양성: 이게 더 흥미로운 부분입니다. 연구자들은 '발굴한 경제 메커니즘 수', '그중 실제 모델에 채택된 유용 메커니즘 수', '서로 다른 신호 클러스터 수' 같은 지표를 만들었습니다.
- 지도 학습(SFT)만 적용한 에이전트는 CSI300에서 유용 메커니즘을 4개밖에 못 찾았습니다.
- 강화학습과 다양성 보상을 더한 완전한 AlphaDiverse는 23개를 찾았습니다. (CSI500에서는 6개 → 25개)
- 다른 자동 연구 시스템 벤치마크들의 유용 메커니즘 수는 2~8개 수준이었습니다.
흥미로운 대조 실험이 하나 더 있습니다. 'Single Synthesis' 변형 — 계획과 구현을 나누지 않고 한 에이전트가 여덟 개 팩터를 한 번에 내놓게 한 버전 — 은 신호 클러스터 수는 비슷하게 만들었지만 실제 모델에 남는 메커니즘은 훨씬 적었습니다. 즉, 아이디어를 서로 다른 경제 계획으로 잘게 나누어 제시하게 하는 것 자체가 다양성을 '표면적 변주'가 아니라 '실질적 재료'로 바꾸는 핵심이었습니다.
곁가지 발견들:
- 다양성 보상을 빼면 유용 메커니즘이 23개에서 18개로 줄고, 한 계획의 두 구현 간 상관도 0.316에서 0.365로 나빠졌습니다. '서로 다른 구현'이 실제로 다른 신호를 만든다는 뜻입니다.
- 학습 데이터에서 '성공한 결과'만 모으면 유용 메커니즘이 1개로 붕괴했습니다. 실패 뒤 방향을 바꾼 궤적이 오히려 교훈적이었다는 이야기입니다.
- 비용 면에서, CSI300 20라운드 완주 기준 API 사용료는 GPT 계열이 5.57와 0이고 H200 GPU 1.436시간이면 충분했습니다. 성능까지 세 API 백엔드보다 나았다고 합니다.
한계와 주의점
논문이 스스로 밝힌 한계와, 읽을 때 주의할 점을 정직하게 정리하면 다음과 같습니다.
- 탐색의 상한이 미리 정해져 있습니다. 에이전트가 쓸 수 있는 경제 메커니즘 카탈로그와 연산자 목록이 고정되어 있습니다. 목록에 없는 아이디어는 아무리 훈련해도 나오지 않습니다. 저자들도 이를 첫 번째 한계로 꼽습니다.
- 강화학습 보상은 근사치입니다. 샘플링한 계획의 가치를 유한한 내부 상태 모음에서 평가하는데, 긴 연구 루프에서의 지연된 기여까지 정확히 반영하지는 못합니다.
- 실험이 중국 주식에 한정됩니다. 네 개 유니버스 모두 중국 시장이고, 다른 국가·자산군에서의 검증은 없습니다.
- 성능 수치의 해석에 주의가 필요합니다. 최종 평가가 2026년 1~8월 단일 구간 단 한 번이고, 연 수익률 42.10% 같은 숫자는 거래비용·슬리피지 반영 방식이 불명확합니다. '이렇게 번다'로 읽으면 과장입니다.
- 재현 가능성 점수가 낮습니다(5부 중 1.9 부근, 원문 기준 38/100). 공식 코드·데이터 공개 경로가 논문에서 확인되지 않아, 독자적 재현에는 상당한 노력이 필요합니다.
- 연구에 기업이 참여한 산학 연계 프로젝트입니다. 이해관계 참고.
그래서 투자/실무엔?
일반 독자와 실무자 눈높이에서 이 논문이 주는 교훈은 이렇습니다.
- AI 리서치 보조의 '지식 자산화' 패턴. 값비싼 API로 쌓은 연구 경험을 로컬 모델에 담아 사내에 남기는 구조는, 자기자본 운용처럼 데이터 기밀성이 중요한 곳에 그대로 쓸 수 있는 설계입니다. 'API로 잠깐 쓰고'가 아니라 '경험을 모아 내 것으로 만드는' 흐름이라는 점이 실무적으로 큽니다.
- 다양성은 운이 아니라 설계로. 투자 아이디어가 한쪽으로 몰리는 문제(공모화)는 사람 팀에서도 늘 있는 일입니다. 이 논문은 '서로 다른 경제 메커니즘을 강제하고, 중복되지 않는 기여에 보상을 주는' 방식이 수치로 효과가 있었다는 점을 보여 줍니다. 아이디어 회의의 채점 규칙을 바꾸는 것만으로 탐색의 질이 달라진다는 관찰은 팀 운영에도 응용할 만합니다.
- 성능보다 '채택된 메커니즘 수'를 보라. 팩터 자동 발굴 도구를 평가할 때, 백테스트 수익률만 보지 말고 '실제 포트폴리오에 남은 서로 다른 아이디어가 몇 개인가'를 함께 보라는 제안입니다. 수익률은 국면이 바뀌면 흔들리지만, 아이디어의 다양성은 구조의 속성입니다.
- 시험 데이터 격리 원칙은 공짜 점심이 아닙니다. 내부/외부 기간 분리와 최종 1회 평가는 성능을 오히려 깎을 수도 있는 불편한 규율이지만, 'AI가 찾은 전략이 진짜로 돈을 벌 수 있는가'라는 질문에 답하려면 이 규율이 필수입니다.
더 알아보기
- 원문: AlphaDiverse: Post-Training Local Quantitative Research Agents for Diverse Exploration in Alpha Factor Mining (arXiv:2609.29014) — Tongji University / Shanghai Non-convex Intelligent Technology
- 5차원 점수 (참고): 새로움 82 · 적용성 78 · 엄밀성 70 · 재현성 38 · 통찰 79 (종합 72.0, A등급)
- 관련 논문 (KB 기준):
- Time Travel is Cheating: DeepFund 실시간 펀드 벤치마크 (arXiv:2505.11065) — LLM 투자 에이전트를 실시간 환경에서 평가하는 문제
- R&D-Agent-Quant: 데이터 중심 팩터·모델 연구 멀티 에이전트 (arXiv:2505.15155) — 팩터 연구 자동화의 또 다른 대표 접근
- The Alpha Illusion: LLM 트레이딩 에이전트의 보고된 알파를 그대로 믿지 말 것 (arXiv:2605.16895) — 이 글의 '수익률 과장 주의' 경고를 확장한 연구
이 글은 2026년 9월 26일 수집 논문을 기반으로 작성한 초안입니다. 발행 전 전문가 검수가 필요합니다.
관련 글
 LLM 트레이딩 에이전트A
AI 트레이딩 에이전트 15종 보안 진단 — 80%는 위기 대응, 100%는 보안에서 실패
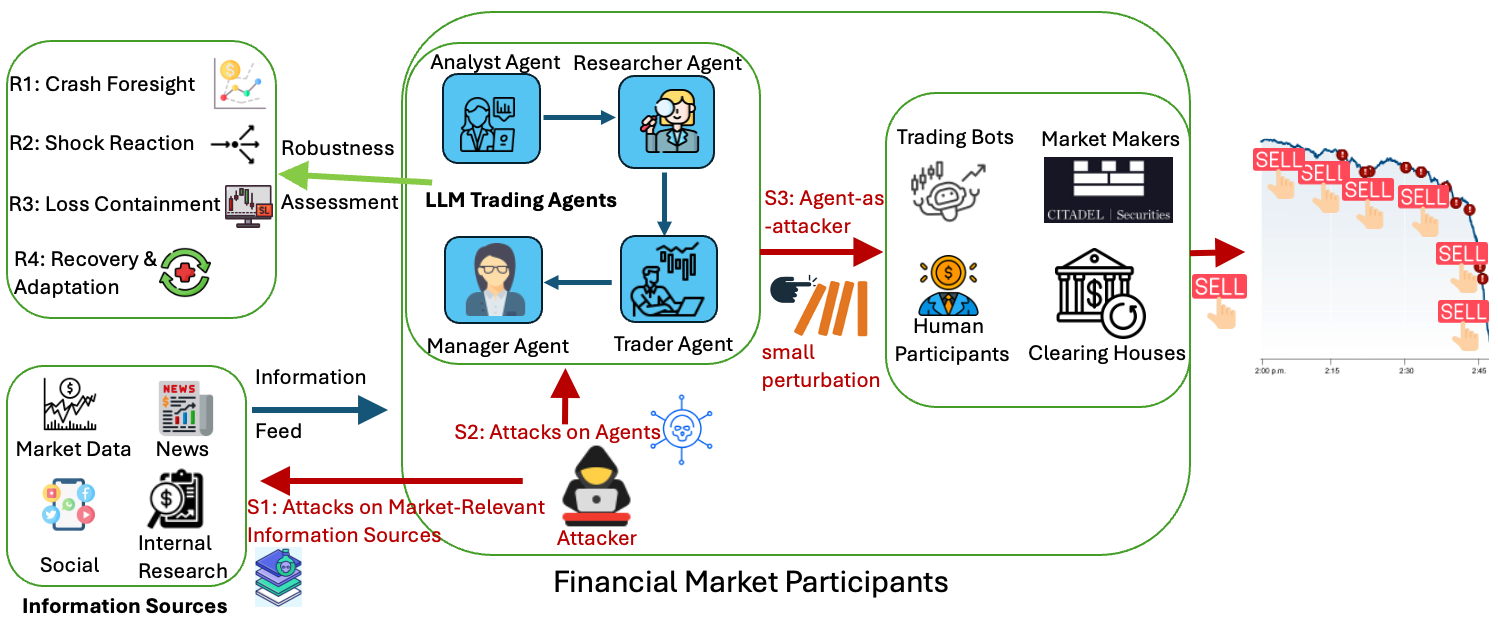
자금을 직접 굴리는 LLM 트레이딩 에이전트 15개를 견고성과 보안 9개 지표로 진단한 FARSIGHT 연구를 쉽게 풀어 설명합니다. 플래시 크래시 대응 부재, 프롬프트 주입, 에이전트 탈취 위험과 실무 방어 설계까지 AI 트레이딩 보안이 왜 필요한지 알려드립니다.
 LLM 트레이딩 에이전트A
LLM 트레이딩 에이전트는 자기 지능값을 벌까? TradeLens 손익 감사
AI 트레이딩 봇이 벌어들인 수익에서 추론 비용을 빼면 남는 건 무엇일까? 10개 LLM 백본의 손익을 시장·자산선택·타이밍으로 분해한 TradeLens 진단에서, 성패를 가른 것은 AI 사용 비용이 아니라 의사결정의 질이었다. LLM 트레이딩 에이전트 비용효율성 분석.
 강화학습 포트폴리오
가상 시장을 만들어 연습시킨 AI 포트폴리오 매니저 — vine copula 시뮬레이션과 강화학습이 거래비용을 41.5% 줄인 비결
투자는 미래가 한 번뿐이라 연습할 수 없다. 이 논문은 자산 간 관계를 배워 가상 시장을 찍어내고, 그 가상 세계에서 강화학습 매니저를 훈련시켜 22개월 실전에서 연 34.13%, 샤프 2.31을 기록했다. 시뮬레이션 연습이 거래비용을 41.5% 줄인 과정과, '모형을 믿어도 되는가'를 수학적으로 따진 점을 쉽게 정리한다.