
SoK: Trading Agents or Market Crashers? Dissecting Robustness and Security Failures in Academic Financial LLM Trading Schemes
Mengxiao Wang, Nitesh Saxena
"AI에게 돈을 맡기는 시대가 왔다. 그런데 그 AI가 거짓 뉴스 한 줄에 속거나, 다른 AI에게 조종당한다면?" — 학술 트레이딩 에이전트 15개를 '해커의 눈'으로 진단한 연구가 내놓은 답은 착잡하다. 15개 모두가 뚫렸다.
들어가며: 자동으로 사고파는 AI, 그 운전대는 누가 잡고 있나
생각해 보세요. 회사에 자금을 다루는 새 직원이 왔습니다. 이 직원은 아주 부지런해서 뉴스, 공시, 소문까지 눈코 뜰 새 없이 읽고, 판단도 빠르고, 글도 잘 씁니다. 대단히 똑똑한 직원이죠.
그런데 이 직원에게 세 가지 특징이 있습니다.
- 책상 위로 오는 어떤 편지든 그대로 읽고 믿습니다. (출처 확인이 없습니다.)
- 매매 결정에 실제 돈이 바로 연결되어 있습니다. (실수하면 돈이 나갑니다.)
- 자기가 쓴 메모를 계속 쌓아 두고, 그 메모를 다음 판단에 그대로 씁니다. (누가 슬쩍 메모를 바꿔 놓으면 영원히 영향을 받습니다.)
바로 지금 금융 시장에 풀려나고 있는 'LLM 트레이딩 에이전트'의 모습입니다. 대형 언어 모델(LLM)이 시장 데이터와 뉴스를 읽고 매수·매도를 결정하는 자동화 시스템이죠. 이미 로빈후드(Robinhood) 한 곳에서만 10만 개 이상의 트레이딩 에이전트가 보고되었고, 영국 중앙은행(Bank of England)은 2026년 중반에 "자율 AI 에이전트가 시장 붕괴를 촉발할 수 있다"고 공개 경고했습니다. 미국 하원 금융서비스위원회 위원들은 2026년 6월 SEC에 "AI 트레이딩 에이전트의 동조적 거래와 몰림 현상"에 대한 질문 13개를 보냈고, 한 설문에서는 미국 은행의 72%가 AI 모델을 강제로 멈추는 장치(킬스위치)나 장애 보고 절차조차 없는 것으로 드러났습니다.
그런데 이상하게도, 이런 시스템의 보안과 위기 대응 능력을 체계적으로 점검한 연구는 거의 없었습니다. 오늘 소개할 논문이 바로 그 빈 자리를 메우는 연구입니다. 텍사스 A&M 대학의 Mengxiao Wang, Nitesh Saxena 두 연구자가 쓴 이 SoK 논문은, 지금까지 발표된 학술 트레이딩 에이전트 15개를 하나하나 뜯어보며 "이 시스템들, 위기와 공격 앞에서 사실상 무방비다"라는 결론을 냅니다.
무엇이 문제였나: 금융이라서 더 위험한 다섯 가지 이유
AI 에이전트 보안 연구 자체는 꽤 있습니다. 그런데 대부분은 법률, 의료, 교육처럼 '일반적인 고위험 영역'을 다룹니다. 금융은 다릅니다. 논문은 금융 LLM 에이전트의 공격이 가지는 다섯 가지 특성을 이렇게 정리합니다.
- 눈 깜짝할 사이(Instant): 밀리초 단위로 반응하며 잠깐 생기는 가격 틈을 노립니다. 사람이 개입할 틈이 없습니다.
- 티 안 나게(Inconspicuous): 조작된 신호가 정상적인 시장 신호처럼 보입니다. "이상한 거래"가 아니라 "평범한 매수"처럼 위장합니다.
- 확인 안 하고(Unverified): 속도가 최우선이라 외부 데이터를 검증 없이 그대로 삼킵니다.
- 적응하며(Adaptive): 뉴스, 감정, 공시, 가격 등 여러 통로의 정보를 섞어 쓰므로 공격 경로도 여러 개입니다.
- 도미노처럼(Cascading): 작은 흔들림이 다른 에이전트와 인간 트레이더, 마켓메이커를 거쳐 시장 전체로 퍼집니다.
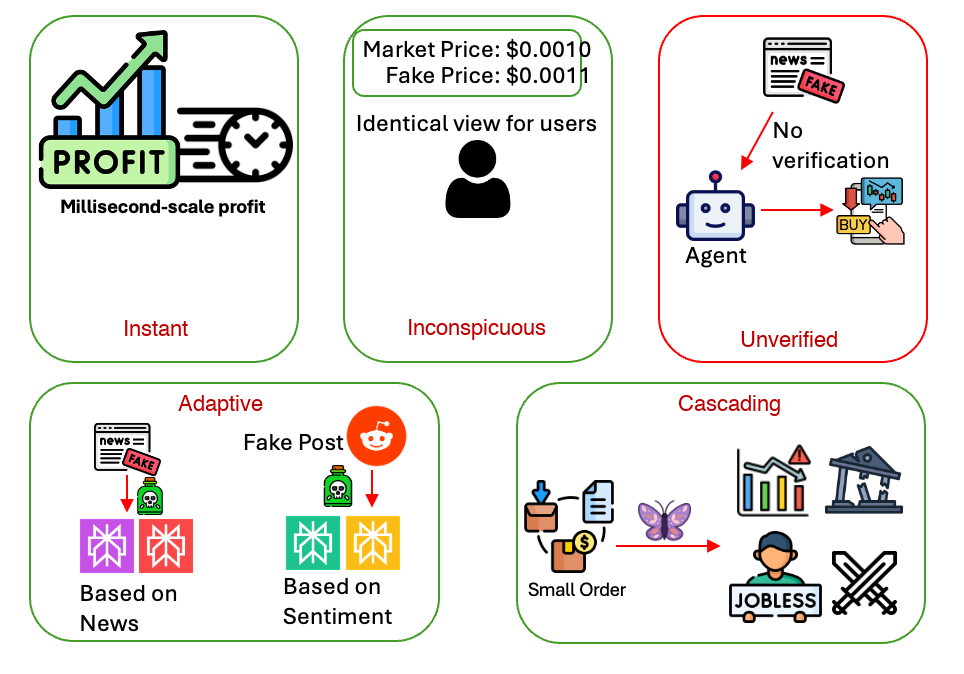
그림 설명: 금융 LLM 에이전트만의 다섯 가지 공격 특성. 다른 분야 에이전트와 근본적으로 다른, 시장 속도와 실행 권한이 만드는 위험입니다.
쉽게 비유하면 이렇습니다. 법률 AI가 잘못 대답하면 소송에서 질 수 있고, 의료 AI가 틀리면 오진이 됩니다. 둘 다 무섭지만 '한 번의 사고'로 끝날 가능성이 있습니다. 그런데 금융 트레이딩 에이전트는 실제 돈을 움직이는 권한을 가지고 있고, 그 행동이 곧바로 다른 참가자의 입력이 되어 되돌아옵니다(시장의 '반사성'). 여기에 상대가 직접 돈을 벌 목적으로 공격하기까지 합니다. 논문은 이를 '고위험 에이전트 보안(high-stakes agentic security)'의 대표 사례로 규정합니다.
실제 역사도 이 경고를 뒷받침합니다. 2010년 플래시 크래시는 시장에서 거의 1조 달러가 수 분 만에 증발했습니다. 2013년에는 AP 트위터 계정이 해킹되어 "백악관 폭발"이라는 거짓 뉴스가 올라왔고, 미검증 헤드라인에 자동으로 반응한 시스템들 때문에 1,360억 달러(원화 약 177조 원)가 수 분 만에 사라졌습니다. 그때는 '단순한 자동화 시스템'이었죠. 이제는 스스로 읽고 추론하고 주문까지 넣는 AI가 같은 자리를 대신하고 있습니다.
핵심 아이디어: FARSIGHT — 견고성 4개와 보안 3개로 채점하기
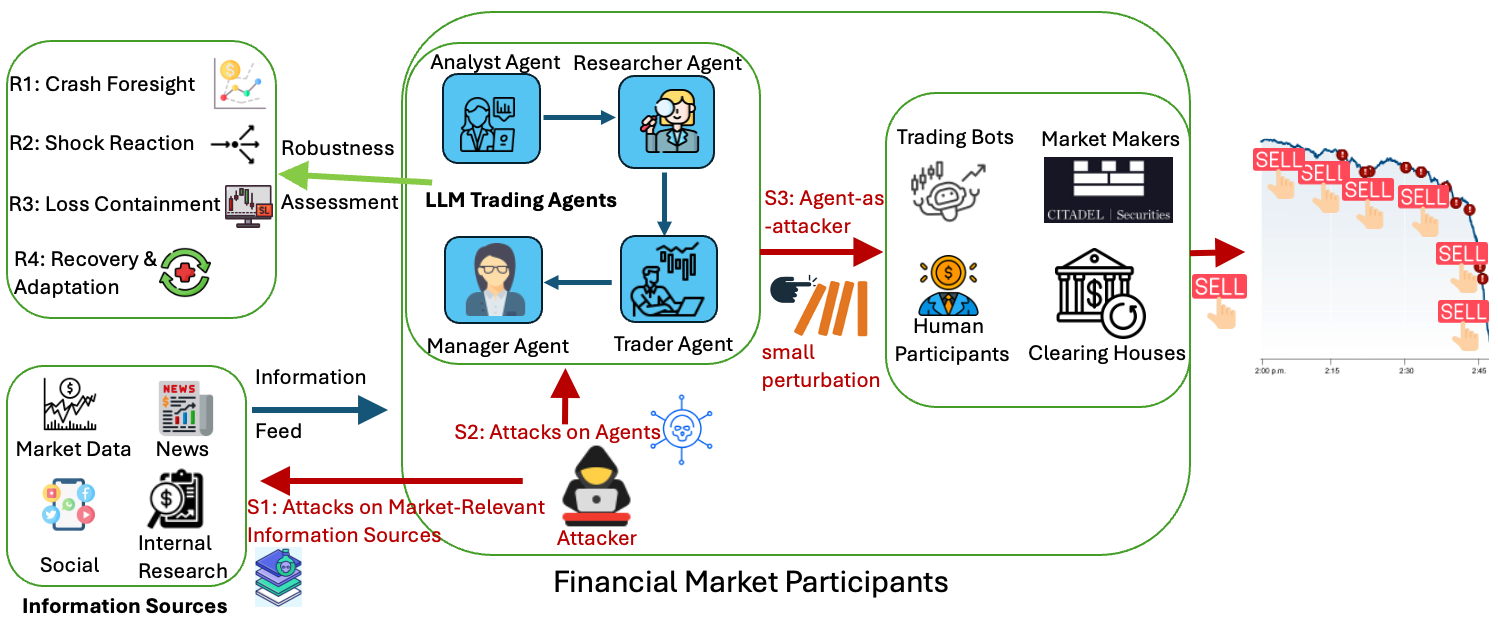
연구진이 만든 프레임워크 이름은 FARSIGHT(Financial Agent Robustness and Security Investigation and Global Holistic Testing)입니다. 이름이 거창하지만 아이디어는 단순합니다. 트레이딩 에이전트를 두 개의 축, 아홉 개의 항목으로 채점하자는 겁니다.
축 1: 견고성 — 위기가 왔을 때 버티는가? (네 가지 물음)
자동차에 비유하면 훨씬 잘 이해됩니다.
| 항목 | 물음 | 자동차 비유 |
|---|---|---|
| R1 사전 인지 | 폭락 조짐을 미리 감지하는가? | 전방의 위험을 미리 보는 눈 |
| R2 신속 대응 | 충격이 오면 얼마 만에 멈추는가? | 브레이크 반응 속도 |
| R3 손실 억제 | 이미 사고가 났을 때 피해를 막는가? | 에어백과 차체 안전 구조 |
| R4 회복·적응 | 사고 후 다시 정상 궤도에 오르는가? | 사고 후 정비와 재점검 |
축 2: 보안 — 공격자에게 뚫리는가? (세 가지 물음)
| 항목 | 공격 방식 | 직장 비유 |
|---|---|---|
| S1 정보원 공격 | 뉴스·데이터·소문을 조작해 속인다 | 거짓 신문을 책상 위에 올려 두기 |
| S2 에이전트 공격 | 프롬프트 주입, 도구·API 악용, 메모리 오염 | 사무실에 침입해 지시서를 바꾸기 |
| S3 에이전트 = 공격자 | 이미 탈취된 에이전트가 시장을 교란한다 | 탈취된 직원이 돌변해 거래를 조작하기 |
특히 S3이 이 논문의 핵심 통찰입니다. 한 개의 에이전트가 뚫리면 그 에이전트는 이제 피해자가 아니라 공격자가 됩니다. 가짜 정보를 흘리고, 다른 에이전트와 짜고 큰 주문을 때리고, 유동성을 흔들어 연쇄 매도를 유발할 수 있습니다. 논문의 제목이 "트레이딩 에이전트인가, 시장 붕괴 유발자인가?"인 이유입니다.
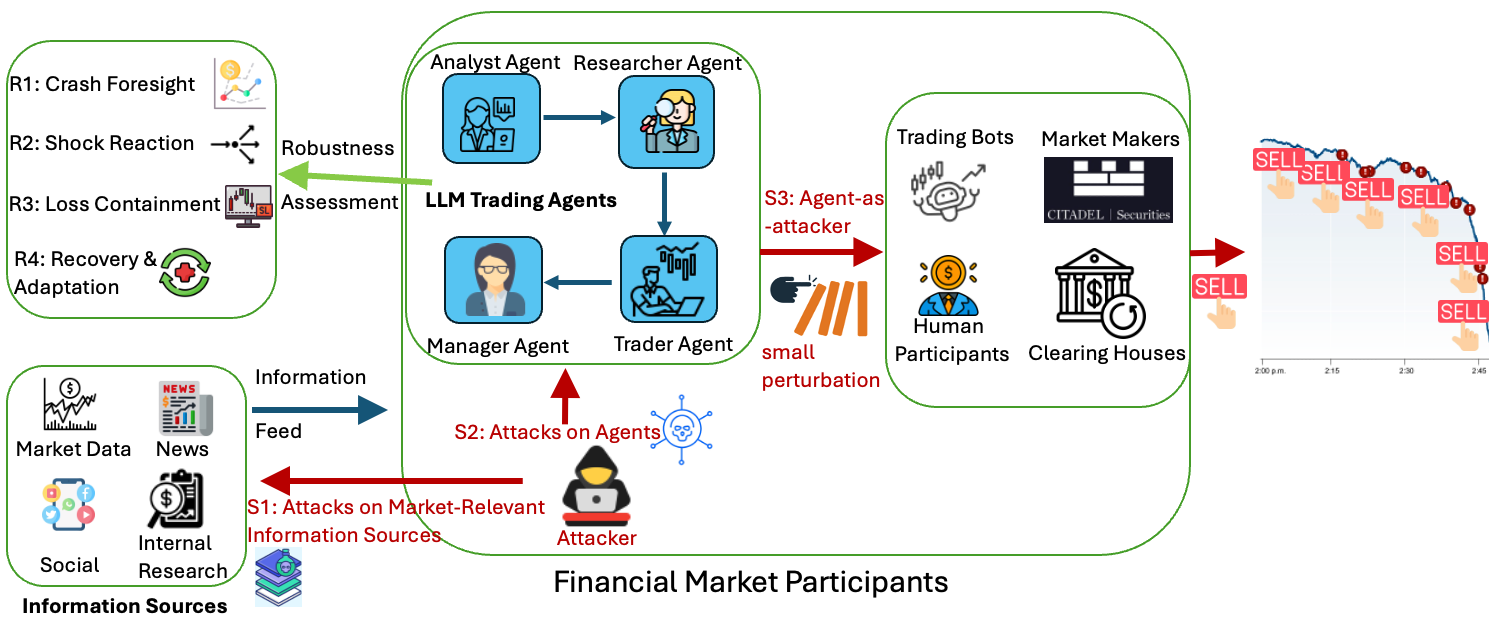
그림 설명: 논문이 그린 위협 지도. 공격은 위에서 아래로(S1→S2→S3) 흐르고, 견고성 평가(R1~R4)는 시간축을 따라 위기의 전·중·후를 덮습니다.
어떻게 채점했나: 127편에서 15개 시스템으로
연구진은 키워드 검색과 인용 추적(스노우볼링)으로 후보 논문 127편을 모았습니다. 두 명의 심사자가 독립적으로 제목·초록을 걸러 87편을 빼고 40편을 전문까지 읽었으며, "에이전트 구조를 알아볼 수 있고(G1), 스스로 또는 절반 자율로 판단하는(G2)" 시스템만 남기니 최종 15개가 되었습니다. TradingGPT, FinMem, MarketSenseAI, FinCon, StockAgent, FinAgent, FinRobot, Alpha-GPT 2.0, QuantAgent, TradExpert, TradingAgents, FLAG-Trader, ContestTrade, TradingGroup 같은 이름들입니다.
채점은 논문에 공개된 설계를 근거로 하는 '코드북 채점'입니다. 여기서 중요한 점이 하나 있습니다. 이 연구는 실제 시스템을 해킹한 침투 테스트가 아니라 설계 문서 기반의 체계적 정리(SoK)라는 점입니다. 마치 건물 설계도만 보고 "소방 설비가 빠졌다"고 판정하는 안전 점검 같은 겁니다.
결과 — 무엇을 알아냈나
한 줄 요약: 15개 중 80%가 위기 대응에 구멍, 100%가 보안에 구멍
- 15개 시스템의 80%가 견고성 4개 지표 중 최소 하나에서 실패했습니다.
- 15개 시스템 전부(100%)가 보안 취약점을 최소 하나 가지고 있었습니다.
더 구체적으로 들여다보면 상황은 더 심각합니다.
- 사전 인지(R1)를 완벽히 갖춘 시스템은 0개. 5개만 부분 점수를 받았고, 모두 '이미 손실이 난 뒤에' 반응하는 식이었습니다. 전통적인 퀀트 시스템이 쓰는 VIX 급등 감지, 주문장 유독성 지표 같은 정량 조기경보를 갖춘 에이전트는 하나도 없었습니다.
- 신속 대응(R2) 완벽 0개. 어떤 시스템도 '밀리초 만에 주문 동결' 같은 빠른 경로를 갖지 못했습니다.
- 손실 억제(R3)에서 6개가 부분 점수를 받았지만, 알고리즘 스탑로스를 확정 규칙으로 집행하는 시스템은 0개. 리스크를 '개념'으로 이야기할 뿐, '경성 한도'로 강제하지 않았습니다.
- 회복(R4)에서 7개가 부분 점수를 받았지만, 사고(크래시)를 계기로 재학습을 트리거하는 시스템은 0개. 그냥 계속 조금씩 배울 뿐이었습니다.
4분이 아니라 240초: 속도의 현실
가장 뼈아픈 수치는 지연 시간입니다.
| 거래 유형 | 대응 시간 |
|---|---|
| 초단타 매매(HFT) | 0.0001초 미만 |
| 알고리즘 트레이딩 | 0.1초 미만 |
| 데이 트레이딩 | 약 1초 |
| 스윙 트레이딩 | 약 10초 |
| TradingAgents (LLM 에이전트) | 240초 초과 |
TradingAgents는 가장 작은 모델과 가장 짧은 사고 과정으로 실행했을 때(즉, 최선의 경우에 해당하는 하한) 5번의 실행 중앙값 기준으로 의사결정에 4분 넘게 걸렸습니다. 15개 전 시스템이 LLM 추론 지연과 입출력 지연을 가지고 있었고, 10개는 에이전트 간 대화 오버헤드까지 더했습니다. 그 결과는 오래된 가격에 기반한 판단(가격 정체), 늦게 발동하는 스탑로스, 계획과 다른 체결가(슬리피지)입니다.
자물쇠가 없는 백본 모델
15개 시스템 중 12개가 GPT-4 계열 모델 위에서 돌아갔고(그중 10개는 순수 GPT-4), 13개는 폐쇄형 상용 API에 의존했습니다. 문제는 이런 모델들도 탈옥(jailbreak) 공격에 취약하다는 사실입니다.
| 백본 모델 | 벤치마크 | 탈옥 성공률 |
|---|---|---|
| GPT-4 | Do Anything Now (DAN) | 95% |
| GPT-4o | HarmNet | 94.8% |
| GPT-4o-mini | GRAF | 95.0% |
| GPT-3.5-Turbo | DAN | 95% |
| DeepSeek-V3 | CNSafe-RT | 최대 100% |
중요한 주의: 이 숫자는 일반 탈옥 벤치마크에서 측정한 베이스 모델 기준 상한입니다. 실제 트레이딩 에이전트에는 시스템 프롬프트, 도구 제한, 출력 필터, 에이전트 간 검증 같은 방어가 겹쳐 있어 실질 악용률은 다를 수 있습니다. 논문도 이를 '상한 위험 지표'로 명시하고, "베이스 모델과 실제 에이전트 사이의 격차는 미해결 연구 과제"라고 솔직하게 밝힙니다.
AI 심사관은 믿을 만한가: 절반은 틀렸다
흥미로운 부가 실험 하나. 연구진은 같은 채점을 AI(챗GPT 딥 리서치)에게도 시켰습니다. 5개 시스템 × 9개 지표 = 45개 판정 중 24개(53.3%)가 인간 전문가와 달랐습니다. 이미 알려진 공격 유형에는 꽤 정확했지만, 논문이 새로 정의한 공격 유형에서는 오류율이 최대 100%까지 치솟았습니다. 평가 자동화의 유혹과 한계를 동시에 보여주는 결과입니다.
가장 잘 만든 시스템들조차
| 기준 | 최우수 시스템 | 비결 |
|---|---|---|
| 견고성 | QuantAgent | 전담 리스크 모니터링 에이전트 |
| 보안 | Alpha-GPT 2.0 | 사람 감독 + API 노출 최소화 (실제 매매 없음) |
| 종합 | TradingAgents | 다중 에이전트 협업 + 리스크 팀 (단, 4분 지연) |
재미있는 교환 관계가 보입니다. 자율성이 커질수록 공격면이 넓어지고, 보안을 강하게 조이면 자율성이 줄어듭니다. Alpha-GPT 2.0가 안전한 이유는 애초에 돈을 직접 움직이지 않기 때문입니다.
한계와 주의점
이 논문도 솔직한 한계를 밝히고 있습니다.
- 학술 시스템만 봤습니다. 실제 운용되는 사모(프로라이터터리) 시스템은 접근할 수 없어, 결론의 일반화에는 한계가 있습니다.
- 실거래가 아니라 문헌 기반 평가입니다. 위협 모델링과 공격 시뮬레이션은 통제된 환경에서 이루어졌고, 실제 시장에서의 검증은 아닙니다.
- '논문에 없다'는 것이 '없다'는 뜻은 아닙니다. 코드북 채점은 논문에 서술된 것만 봅니다. 공개 코드나 후속 버전에 있는 방어 장치는 과소 계상되었을 수 있습니다.
- 탈옥 성공률은 상한치입니다. 앞서 설명한 대로, 실제 에이전트의 실질 악용률은 별개 문제입니다.
- 설계 점검은 침투 테스트를 대신하지 못합니다. 논문도 라이브 레드티밍과 커뮤니티 벤치마크의 필요성을 미래 과제로 남깁니다.
그래서 투자/실무엔?
이 논문이 남기는 교훈은 'AI 트레이딩을 하지 말라'가 아닙니다. "AI를 믿되, 안전장치는 AI 밖에 두라"입니다. 자기자본으로 AI 트레이딩 시스템을 설계하거나 운용하는 팀이라면 다음 체크리스트가 그대로 도움이 됩니다.
- 규칙은 AI 바깥에서 집행하라. "종목당 최대 2%", "제한 종목 금지", "장후 시장가 주문 금지" 같은 불변식을 LLM이 아니라 외부 정책 엔진이 강제해야 합니다. 프롬프트로 지켜지는 규칙은 프롬프트로 뚫립니다.
- 사고 경로와 고속 경로를 나눠라. 분석·토론은 LLM이 하되, 위기 신호(1분 내 3σ 초과 가격 갭, 스프레드 폭증, 변동성 레짐 점프)가 잡히면 LLM을 부르지 않는 규칙 엔진이 주문을 동결하고 자본보존 모드로 전환해야 합니다.
- 스탑로스는 원장(브로커·거래소) 데이터로 판단하라. LLM이 읽은 뉴스 피드가 오염되어도 스탑은 유지되어야 합니다. 포지션·전략·포트폴리오 3계층의 차단 장치를 두고, 고변동성 구간에서는 포지션을 줄이는 방식으로 조이세요.
- 모든 입력에 출처를 매겨라. 도메인·시각·인증 정보를 붙이고, 단일 출처의 시장 움직임 뉴스는 독립 매체가 확인하기 전까지 거래로 연결하지 마세요. 소셜 미디어는 가장 조작하기 쉬운 채널입니다.
- 기억 장치를 관리하라. 검증된 관찰만 장기 기억에 올리고, 의심스러운 경험은 격리 구역에 두었다가 다시 확인한 뒤 승격시키세요. 메모리 오염은 리셋해도 살아남습니다.
- 탈취를 전제로 한 봉쇄 장치를 둬라. 주문 빈도·자산군·유동성의 급변을 감지하고, 하나의 에이전트만 격리하며, 여러 에이전트가 똑같이 큰 주문을 몰아갈 때는 리스크 담당 에이전트의 승인을 받게 하세요. 그리고 사람의 하드 스탑은 언제나 최우선이어야 합니다.
- 지연 시간을 겁내지 마세요. 논문의 프로토타입 테스트에 따르면, 수일 단위 보유가 기본인 스윙 트레이딩에서는 뉴스 공개 10분 뒤에 판단해도 수익성 있는 진입 기회가 남아 있다고 합니다. 서브초 속도에 집착하기보다, 240초짜리 사고 과정을 되돌아보는 편이 낫습니다.
결국 이 연구가 말하는 것은 이것입니다. 지금의 금융 AI 에이전트는 분석은 잘하지만, 위기 대응과 자기 방어는 설계 단계에서 빠져 있다. 뛰어난 직원을 뽑았다면, 이제 사무실의 잠금장치와 비상정지 버튼을 설치할 차례입니다.
더 알아보기
- 📄 원 논문: arXiv:2609.19705 — SoK: Trading Agents or Market Crashers?
- 5차원 점수: Novelty 72 / Applicability 81 / Rigor 58 / Reproducibility 45 / Insight 79 (composite 69.5, A등급)
- 관련 분과: C4 (LLM 기반 트레이딩 에이전트)
- 함께 읽으면 좋은 논문:
- TradeTrap: Are LLM-based Trading Agents Truly Reliable and Faithful? — LLM 트레이딩 에이전트의 신뢰성·충실도를 실험으로 파고든 연구
- ContestTrade: A Multi-Agent Trading System Based on Internal Contest Mechanism — 내부 경쟁으로 과적합을 줄이는 다중 에이전트 설계
- The Price of Agreement: Measuring LLM Sycophancy in Agentic Financial Applications — 금융 에이전트에서의 '아첨 성향'이 만드는 비용 측정
- AlphaEval: A Comprehensive and Efficient Evaluation Framework for Formulaic Factors — LLM 기반 알파 발굴의 평가 프레임워크
관련 글
 LLM 트레이딩 에이전트A
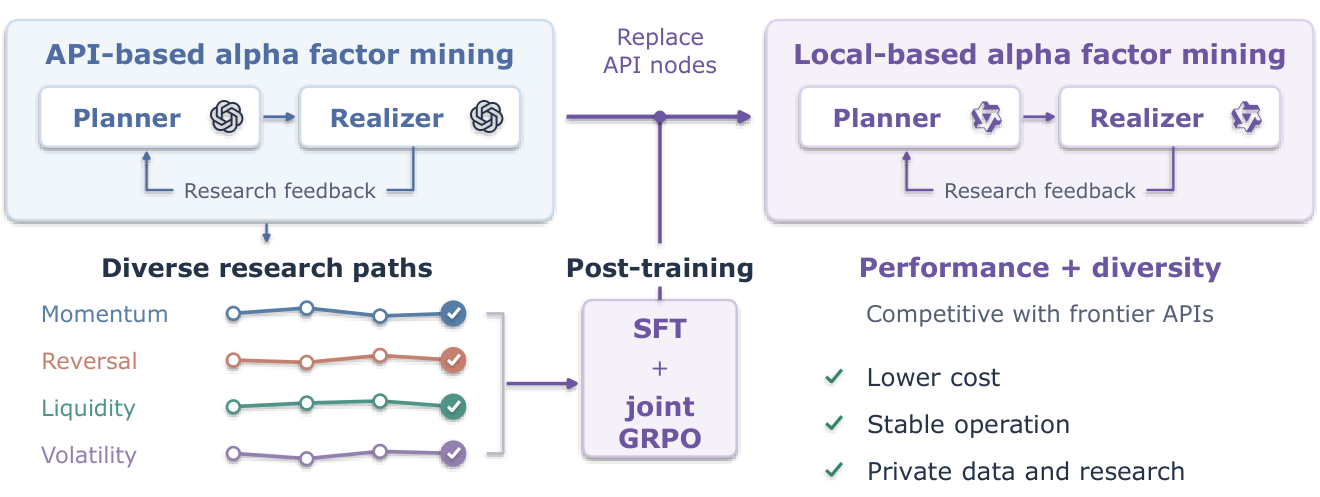
알파 팩터 마이닝 LLM 에이전트: 로컬 훈련으로 탐색 다양성을 되살리다
LLM 멀티 에이전트로 알파 팩터를 자동 발굴하면서도 같은 아이디어만 반복하는 연구 경로 붕괴를 극복하고, 외부 API 없이 로컬 모델로 훈련한 AlphaDiverse 논문을 쉽게 설명합니다. 예측 성능과 탐색 다양성을 함께 얻은 비결과 한계를 짚어봅니다.
 LLM 트레이딩 에이전트A
LLM 트레이딩 에이전트는 자기 지능값을 벌까? TradeLens 손익 감사
AI 트레이딩 봇이 벌어들인 수익에서 추론 비용을 빼면 남는 건 무엇일까? 10개 LLM 백본의 손익을 시장·자산선택·타이밍으로 분해한 TradeLens 진단에서, 성패를 가른 것은 AI 사용 비용이 아니라 의사결정의 질이었다. LLM 트레이딩 에이전트 비용효율성 분석.
 강화학습 포트폴리오
가상 시장을 만들어 연습시킨 AI 포트폴리오 매니저 — vine copula 시뮬레이션과 강화학습이 거래비용을 41.5% 줄인 비결
투자는 미래가 한 번뿐이라 연습할 수 없다. 이 논문은 자산 간 관계를 배워 가상 시장을 찍어내고, 그 가상 세계에서 강화학습 매니저를 훈련시켜 22개월 실전에서 연 34.13%, 샤프 2.31을 기록했다. 시뮬레이션 연습이 거래비용을 41.5% 줄인 과정과, '모형을 믿어도 되는가'를 수학적으로 따진 점을 쉽게 정리한다.