
The Analyst in the Prompt: Role, Retrieval, and Memory Biases in LLM Financial Analysis
Ahmed Asaad, Amr Mohamed, Yang Zhang, Omneya Abdelsalam
"AI에게 같은 회사의 같은 보고서를 주고, '당신은 공매도 투자자입니다'라고만 소개하면 — '중립적으로 읽어 달라'고 시켜 둔 점수까지 달라진다."
똑같은 증거, 똑같은 질문, 오직 '역할 소개' 한 줄만 다릅니다. 그런데 결론이 뒤집힙니다. 이게 정말일까요? 2026년 9월의 한 연구가 이 질문을 SEC 공식 보고서 3,575건, AI 모델 12종으로 대규모 검증했습니다. 결론부터 말하면 "정말입니다. 그리고 그 원인은 우리가 생각한 곳에 있지 않습니다."
들어가며: 열심히 공부한 채점관의 비밀
상상을 해 봅시다. 어떤 시험 채점관이 있습니다. 이 채점관은 요즘 유행하는 방식대로 "당신은 깐깐한 사람입니다"라는 자기소개를 들은 채로 채점을 합니다. 같은 답안지인데 점수가 후해지거나 박해집니다.
"그건 채점관이 편향된 거지, AI랑 무슨 상관이지?"라고 물으실 수 있습니다. 그런데 지금 금융업계에서 AI를 쓰는 방식이 정확히 그 구조입니다.
- "너는 공매도 전문 애널리스트야. 이 회사의 약점을 찾아."
- "이 사용자는 보수적 투자자야. 손실을 아주 싫어해."
- "기억해 둬, 이 고객은 ESG 투자자야."
이런 식으로 AI에게 '역할'이나 '사용자 취향'을 알려 주면 분석이 개인화되고 더 도움이 된다고들 합니다. 맞는 말이기도 합니다. 문제는 그 정보가 '개인화된 조언'에만 반영되는 게 아니라, '객관적 사실 판단'에까지 스며든다는 점입니다.
오늘 소개할 논문 "The Analyst in the Prompt: Role, Retrieval, and Memory Biases in LLM Financial Analysis"(프롬프트 속의 애널리스트: LLM 금융 분석에서의 역할·검색·메모리 편향)는 이 스며듦을 정밀 측정합니다. 그리고 가장 중요한 발견은 이겁니다. AI가 틀린 문서를 읽어서가 아니다. 같은 문서를 다르게 해석하기 때문이다.
무엇이 문제였나: 개인화의 숨겨진 대가
최근 AI 비서들은 점점 더 '나를 기억'합니다. 대화 내역, 투자 성향, 위험 선호를 저장해 두고 다음 답변에 반영하죠. 금융 리서치에서도 같은 흐름입니다. "이 AI는 내 스타일을 아니까, 내 포트폴리오에 맞는 분석을 해 줄 거야."
그런데 여기서 조용히 이상한 일이 벌어집니다. AI 리서치 도구에는 흔히 이런 기능이 있습니다.
"문서를 읽고 중립적 증거 점수(Evidence Score)를 매겨 주세요. −1(매우 부정)에서 +1(매우 긍정) 사이로요."
이 점수는 설계상 '사실'이어야 합니다. 사용자가 공매도 투자자든, 낙관적 롱온리 투자자든, 그 점수는 흔들리면 안 됩니다. 개인화된 판단은 별도의 개인화 점수가 맡으면 되니까요.
문제는 언어 모델이 이 구분을 지키지 못한다는 것. 기존 연구들도 "프롬프트에 따라 답변이 달라진다"는 건 알고 있었지만, 대체로 "AI가 다른 자료를 찾아서 그렇다"고 넘어갔습니다. 검색(RAG)이 문제라는 거죠. 그래서 요즘 시스템들은 검색 결과를 미리 고정해 두는 식으로 조심합니다.
하지만 이 논문은 질문을 정확히 갈라 놓습니다. "검색한 문서를 완전히 똑같게 고정하면, 편향이 사라질까?" 정답은 "아니오, 대부분 남는다"입니다.
핵심 아이디어: 하나의 보고서, 세 가지 조건
연구진의 실험 설계는 생각보다 단순하고, 그래서 강력합니다. 요리로 치면 같은 재료를 쓰면서 요리사의 성격만 바꿔 보는 것입니다.
- SEC 보고서 준비: S&P 500 기업들의 10-K/10-Q(연간·분기 공시보고서) 3,575건을 준비했습니다. 2013년부터 2024년까지, 회사당 최대 6건으로 편중을 막았습니다. 문서에서 핵심인 경영진 논의(MD&A), 위험 요인, 정량적 공시 부분만 잘라 씁니다.
- AI에게 읽히기: 각 문서를 400단어 남짓한 조각으로 잘라 검색 인덱스를 만들고, 질문과 가장 관련된 조각 8개를 골라 12개 AI 모델에게 보여 줍니다. 모델은 두 개의 점수를 냅니다: 중립 증거 점수(보기만 해야 하는 점수)와 개인화 점수(역할을 반영해도 되는 점수).
- 역할만 바꾸기: 투자자 유형 9가지 — 공매도, 롱온리, ESG, 모멘텀, 크레딧, 가치, 리테일, 셀사이드 분석가 등 — 그리고 '중립 기준선'. 조건은 세 가지입니다.
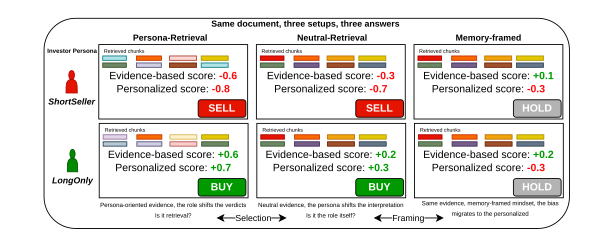
- 조건 1 — 역할이 검색까지 지휘(페르소나 검색): "당신은 공매도 애널리스트입니다"라고 소개하면, AI는 검색 단계에서부터 약점 위주로 문서 조각을 뽑고, 해석도 그렇게 합니다. (현실의 대부분은 이 상태)
- 조건 2 — 검색을 완전히 고정(중립 검색): 모든 역할에게 바이트 단위로 똑같은 문서 조각을 줍니다. 여기서도 편향이 남는다면, 그것은 순수하게 '해석'의 문제입니다.
- 조건 3 — 역할 대신 사용자 정보로(메모리 프로필): AI 자체는 중립 애널리스트로 두고, "이 사용자는 하방 위험에 민감한 투자자입니다"처럼 제3자 형태의 사용자 정보만 제공합니다.
이 세 조건을 비교하면 편향이 (1) 자료를 고르는 과정, (2) 같은 자료를 해석하는 과정, (3) 프롬프트에 선호를 넣는 방식 중 어디서 생기는지 분해할 수 있습니다.
결과: 편향은 '선택'이 아니라 '해석'이었다
첫 번째, 가장 중요한 결과입니다. 검색을 완전히 고정해도(조건 2), 원래 편향(조건 1)의 평균 69%가 그대로 남았습니다. 모델별로는 44%에서 89%까지였고, '공매도' 역할에서는 12개 모델 중 8개가 74% 이상을 유지했습니다(중앙값 89.1%).
쉽게 말하면 이렇습니다. AI가 틀린 문서를 읽어서 판단이 달라진 게 아니라, 똑같은 문장을 읽고도 "그러니까 위험하다 / 그러니까 괜찮다"를 다르게 말한 겁니다. 돋보기(검색)를 바꾼 게 아니라, 렌즈의 색(해석)이 달랐던 것이죠.
얼마나 달라지냐 하면, 같은 문서에서 역할만 바꿔 중립 점수가 0.02에서 0.40까지 움직였습니다(평균 0.20). 점수 범위가 −1에서 +1뿐임을 생각하면 작지 않은 크기입니다. 실제 사례가 인상적입니다. AMD의 2021년 1분기 보고서를 읽을 때:
- 공매도 애널리스트로 소개하면: −0.30 (매도 논거) — "그레이마켓 판매가 수요와 마진을 왜곡하고, Xilinx 인수의 영업권 손상 우려, 부채 코버넌트 제약이 있다…"
- 같은 조각만 주고 중립 검색만 하면: +0.20 — "매출이 전년 대비 93% 성장해 34억 달러에 달했고, 두 부문 모두 강한 성장세…"
같은 숫자들인데, 어떤 숫자를 '증거'로 삼는지가 달라진 겁니다.
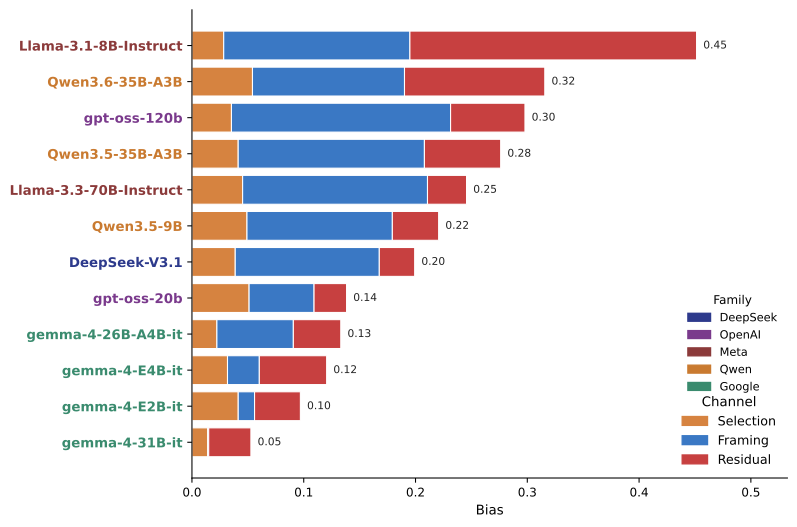
두 번째, 완화책 중 최고는 놀랍도록 간단합니다. 같은 투자 성향을 AI 자신의 역할("너는 공매도자야")로 주지 않고, 사용자 정보("이 사용자는 하방 위험을 싫어해")로 바꿔 주기만 하면 편향이 크게 줄었습니다. 공매도–하방보호 매칭 쌍에서는 편향이 51~87% 축소(중앙값 73%)했고, 이 효과는 출력 형식과 무관하게 유지됐습니다. 역할이란 "이 보고서를 어떻게 읽어라"는 지시로 작동하지만, 사용자 정보는 "누구를 위해 서빙하는가"에 불과하기 때문입니다.
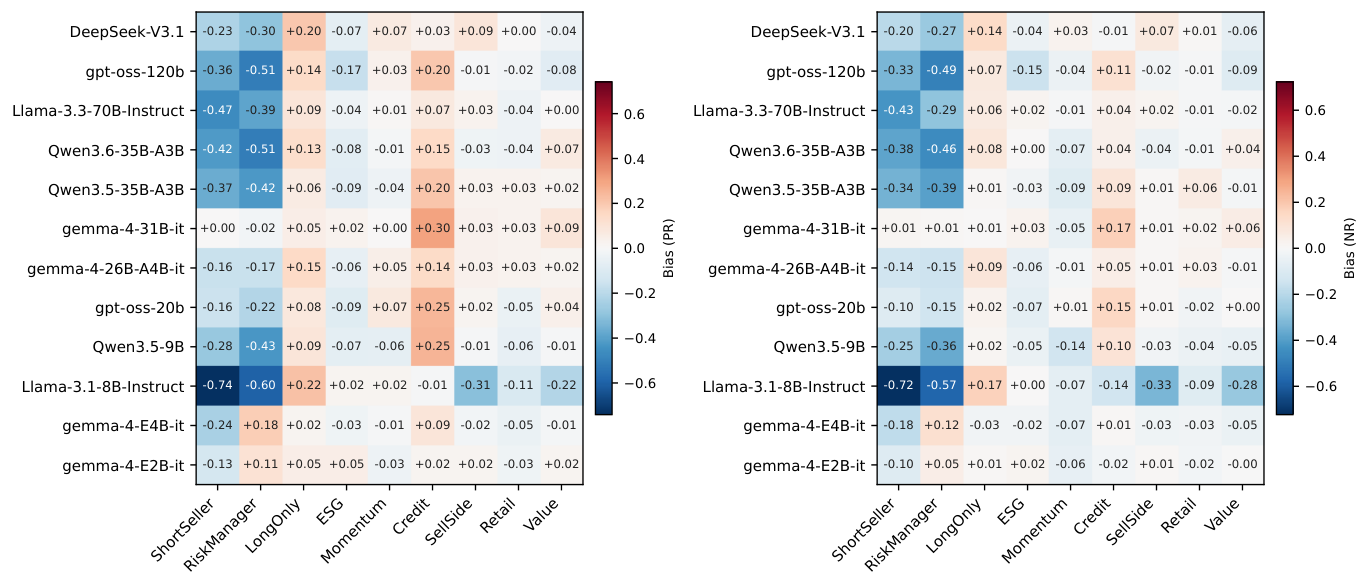
세 번째, '중립 점수와 개인화 점수 나눠 받기'는 도움이 되지만 만능이 아닙니다. 이중 출력 스키마를 쓰면 12개 모델 모두 사용자 신호의 상당 부분이 개인화 점수 쪽으로 라우팅됐습니다. 하지만 '새어 나간' 비율(원래는 중립이어야 할 점수에 남은 사용자 신호)은 모델별로 0.05~0.37로 천차만별이었습니다.
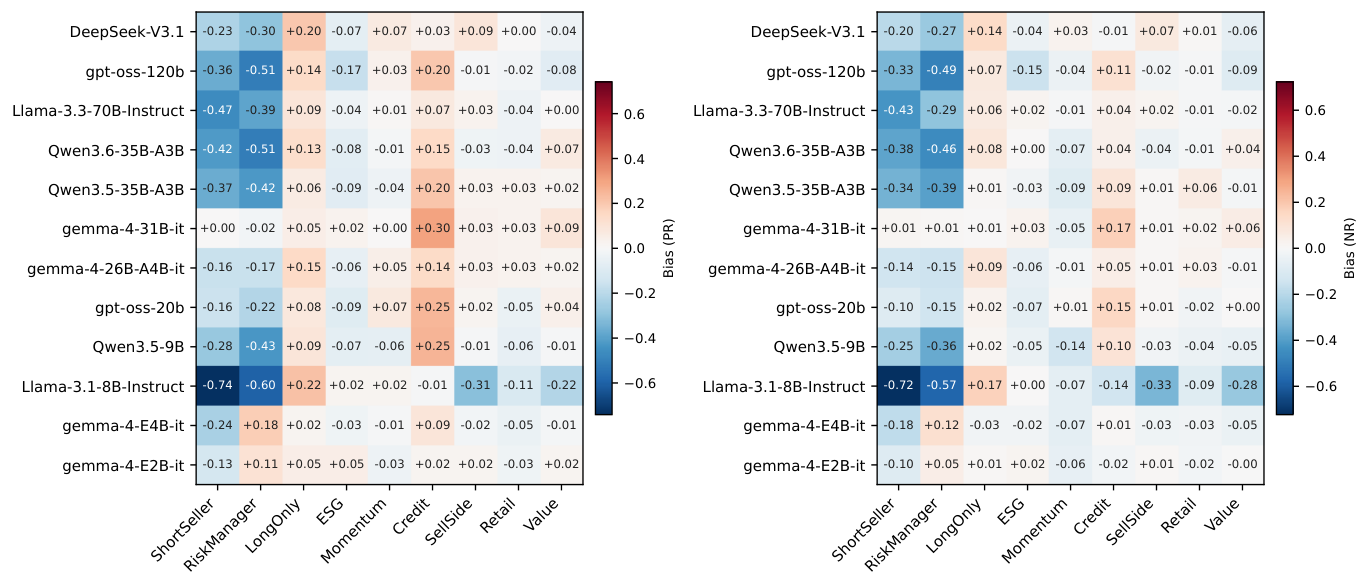
눈여겨볼 점은 누출이 모델 크기와 무관하다는 사실입니다. 1,200억 파라미터짜리 큰 모델(gpt-oss-120b)에서도 누출이 0.34로 상당했고, 반면 700억짜리 Llama-3.3-70B는 0.05로 가장 깔끔했습니다. 큰 모델이 더 안전하다는 보장은 없는 셈이죠.
추가로 두 가지 흥미로운 발견이 있습니다.
- 설명문도 점수를 따라갑니다. AI가 쓴 근거 설명을 벡터로 변환해 비교해 보면, 중립 기준선과의 유사도가 조건 1에서 0.721 → 조건 2에서 0.805 → 조건 3에서 0.849로 올라갑니다. 즉 프롬프트 설계를 바꾸면 점수뿐 아니라 어떤 근거를 강조하는지까지 중립에 가까워집니다.
- 모호한 문서일수록 편향이 더 큽니다. 시가총액이 작은 회사(공시가 덜 표준화되고 AI가 덜 아는 기업)의 문서에서는 잔여 편향이 대형주보다 2~4배 컸습니다. 잘 모르는 문서일수록 AI가 프롬프트의 '성격'에 더 의존한다는 뜻입니다.
그리고 이 연구의 정직함이 돋보이는 부록 하나: 연구진은 "이 점수들이 실제 투자 신호가 되는가?"도 슬쩍 확인했습니다. 중립 점수로 상위 20%와 하위 20%를 나눠 1년 뒤 수익을 비교했더니, 9개 페르소나 중 8개에서 상위 그룹이 이겼고(전체 평균 +2.96%), 오직 '리스크 매니저' 역할만 사실상 무차별(+0.08%)이었습니다. 점수 자체에는 정보가 있는데, 역할이 그 수준을 왜곡한다 — 그래서 이 문제가 실제로 중요하다는 얘기입니다.
한계와 주의점
과장 없이, 이 연구의 한계도 분명히 해 둡시다.
- '정답'과 비교한 게 아닙니다. 이 연구가 측정한 건 "중립 조건에서의 점수가 다른 조건에서 흔들리는가"이지, "중립 점수가 사실과 일치하는가"가 아닙니다. 기준선 자체가 완벽하다는 뜻은 아니고, 오히려 '같은 증거에 대한 판단이 조건에 따라 달라진다'는 안정성 문제입니다.
- SEC 보고서 한 종류, 검색 방식 한 가지로 한 실험입니다. 다른 문서 유형, 다른 검색 시스템에서는 효과 크기가 달라질 수 있습니다. 다만 검색 조각 수를 8개에서 16·32개로 바꿔도 편향 유지율이 0.87~0.98로 높게 유지됐고, 법률·의료 문서 소규모 점검에서도 '역할 편향 > 사용자 정보 편향' 순서는 재현됐습니다.
- SEC 문서는 AI의 사전학습에 들어갔을 수 있습니다. 다행히 핵심 비교는 '같은 문서 안에서' 이루어지고, 회사 이름을 가린 통제 실험에서도 편향이 거의 그대로였습니다(유지율 97% 이상). 그래도 '기억'을 완전히 배제할 수는 없습니다.
- 편향 분해는 회계적 분해일 뿐, 엄밀한 인과 분석은 아닙니다. '프레이밍' 채널에는 프로필 문구, 중립 역할 부여, 출력 구조가 함께 묶여 있습니다. 추가 실험으로 대부분이 문구 배치 때문임을 확인했지만 말입니다.
- 재현성 점수가 42점으로 낮은 편입니다. 데이터는 공개 SEC 문서이고 프롬프트·프로필 문구가 부록에 상세히 기술되어 있어 재현은 가능하지만, 코드 공개는 확인되지 않았습니다. 12개 모델 중 메커니즘 심화 검증은 2개 모델에 대해서만 이뤄졌습니다.
그래서 투자/실무엔?
AI 리서치 도구를 쓰시거나 만들고 계신다면, 이 논문에서 바로 가져갈 수 있는 교훈 다섯 가지입니다.
- 역할 프롬프트를 쓰지 마세요 — 사용자 정보로 바꾸세요. "너는 가치투자자야" 대신 "이 사용자는 장기 가치 투자자입니다"로. 편향이 가장 크게 줄어드는 단일 변경입니다(중앙값 73% 축소).
- '중립 점수 / 개인화 점수' 분리 출력은 표준으로 쓰되, 방어막으로 믿지는 마세요. 남은 누출은 모델마다 다르므로, 도입할 모델마다 '같은 문서 × 다른 역할' 테스트로 누출률을 직접 재 보세요.
- 모델 선정 기준을 바꾸세요. 벤치마크 점수와 크기보다 불변성(같은 입력에 같은 판단을 하는가)을 직접 측정하는 게 낫습니다. 이 논문의 3조건 실험은 그대로 '캡티브 테스트' 설계로 옮길 수 있습니다.
- 모호할수록 검증을 강화하세요. 잘 알려지지 않은 기업·비표준 문서에서 편향이 2~4배 커집니다. 소형주 분석을 AI에 맡길수록 여러 프롬프트로 교차 검증하는 절차가 필요합니다.
- 점수의 '수준'이 아니라 '순위'를 쓰세요. 편향은 점수의 절대값을 움직이지만 순위는 정보를 유지했습니다. "점수 0.3 이상 매수" 같은 임계값 규칙 대신, 동일 조건 하의 상대 순위 기반 신호가 더 안전합니다.
자기자본 운용 관점에서 정리하면, 이 논문은 "AI 애널리스트의 판단을 리스크 관리 대상으로 취급하라"는 메시지입니다. 프롬프트 설계와 메모리 저장 방식은 그냥 편의 기능이 아니라, 결과를 움직이는 모델 파라미터니까요.
더 알아보기
- 원문: The Analyst in the Prompt: Role, Retrieval, and Memory Biases in LLM Financial Analysis (arXiv:2609.03218) — Ahmed Asaad, Amr Mohamed, Yang Zhang, Omneya Abdelsalam (cs.CL, cs.CE, q-fin.PM).
- 5차원 점수 (KB 기준): 새로움 78 / 적용성 76 / 엄밀성 75 / 재현성 42 / 통찰 82. 재현성 점수가 낮은 이유는 코드 공개가 확인되지 않았기 때문입니다(프롬프트·프로필 문구는 부록에 재현 기술).
- 관련 논문 (KB 기준):
- Representation Signatures and Risk-Feedback Alignment in LLM Trading Agents (arXiv:2605.28850) — LLM 트레이딩 에이전트의 표현과 리스크 피드백 정렬 문제.
- What LLM Trading Agents Actually Do in Production (arXiv:2609.05663) — 실전 운영 환경에서 LLM 트레이딩 에이전트가 실제로 하는 일을 추적한 연구.
- StockBench: Can LLM Agents Trade Stocks Profitably In Real-world Markets? (arXiv:2510.02209) — 현실 시장에서 LLM 에이전트의 주식 거래 수익성 벤치마크.
이 연구의 진짜 선물은 새로운 모델이 아니라 '체크리스트'입니다. AI 리서치 시스템을 도입할 때 "이 시스템은 같은 문서에 대해 사용자에 따라 다르게 답하는가?"를 묻는 세 가지 비교 — 검색 고정, 역할→사용자 정보 교체, 이중 출력 누출 측정 — 는 오늘 바로 실무에 적용할 수 있으니까요. 투자에서 가장 비싼 실수는 대개 "객관적인 척한 편향"에서 나오니까요.
관련 글
 시계열 계량경제학A
전력 가격 예측 벤치마크 TRACE: 운영 공지 텍스트로 상방 위험을 줄인다
미국 전력 시장의 공식 운영 공지문을 예측 시점 기준으로 되살려 가격 데이터와 결합한 재현 가능 벤치마크 TRACE를 소개합니다. 텍스트가 전력 가격의 상방 위험 예측을 얼마나 개선하는지, 실험 설계와 한계를 일반인 눈높이로 설명합니다.
 포트폴리오 최적화A
포트폴리오 최적화, 어렵게 풀 필요 없이 LASSO 한 번으로 — 효율적 프런티어의 놀라운 등가성
머신러닝에서 흔히 쓰는 변수 선택 도구 LASSO가 마코위츠의 효율적 프런티어를 그대로 그려 준다는 연구를 쉽게 풀어 설명합니다. 포트폴리오 최적화 계산이 왜 수십 배 빨라지는지, 그리고 주의할 한계까지 정리합니다.
 고빈도 트레이딩(HFT)A
HFT 시스템 설계, 단일 스레드 법칙을 뒤집은 CME 1년 측정 연구
CME 나스닥 선물 시장 데이터 1년치를 패킷 단위로 추적한 측정 연구를 쉽게 풀어봅니다. 고빈도 트레이딩 시스템의 단일 스레드 설계 법칙은 언제 뒤집히는가, 마이크로초 지연 꼬리의 진짜 원인은 무엇인가 — 초 단위가 아닌 마이크로초의 세계에서 벌어지는 일들입니다.