
TRACE: A Reproducible Benchmark for Electricity Price Forecasting with Official Operational Text
Xinyi Yi, Moy Yuan, Ioannis Lestas
폭염이나 한파가 몰아치면 전력 가격은 하룻밤새 몇 배로 뛰기도 합니다. 그런데 시장 운영자는 그런 일이 터지기 몇 시간 전에 경보문을 이미 발표하곤 합니다. 그렇다면 그 공지문의 '글'을 읽기만 해도 가격 급등을 미리 예측할 수 있을까요? 이 질문을 처음부터 끝까지 깔끔하게 실험한 벤치마크 논문이 나와 소개합니다.
들어가며
전력은 참 이상한 상품입니다. 냉방 수요가 몰리는 여름철 오후, 난방 수요가 폭발하는 한파의 아침처럼 시간과 계절의 패턴이 아주 뚜렷한데, 동시에 발전기 고장·연료 수급·송전 제한 같은 돌발 상황에 가격이 폭발적으로 반응합니다. 그래서 전력 가격 예측은 '평소의 패턴'과 '비상시의 급등'을 함께 잡아야 하는, 예측 세계에서 난도가 높은 문제로 꼽힙니다.
흥미로운 점은, 비상 상황이 오면 시장 운영자가 먼저 글로 알린다는 것입니다. 미국 대형 전력 시장 PJM의 운영사도 한파 경보(Cold Weather Alert), 발전 제약, 수급 불안 같은 공식 운영 문서를 미리 공개합니다. 논문이 소개하는 사례 하나를 봅시다. 2022년 1월 6일, PJM은 한파 경보를 발표했습니다. 예측 마감 시각보다 네 시간 이른 시점이었죠. 그다음 날(1월 7일) 시카고 일대를 담당하는 COMED 구역에서는 시간별 전력 가격 아홉 개가 직전 14일의 최고가를 넘어섰습니다.
경보문이 가격보다 먼저 나온 셈입니다. 문제는 "그럼 이 글을 예측에 넣으면 정말로 도움이 되는가, 아니면 우연인가?"입니다. 이게 생각보다 까다로운 질문인데, 왜 그런지부터 차근차근 살펴봅시다.
무엇이 문제였나
전력 가격 예측 연구는 오래됐고, 방법도 잘 정립되어 있습니다. 과거 가격, 전력 수요, 날씨, 연료 가격, 달력 변수 같은 숫자 데이터를 넣어 다음 날이나 다음 시간의 가격을 예측하는 방식이 표준입니다. 최근에는 시계열 파운데이션 모델이라는, 대규모 데이터로 미리 학습된 범용 예측 모델을 그대로 쓰는 방법도 널리 쓰입니다.
그런데 여기에 '텍스트'를 더하는 연구에는 두 가지 함정이 있었습니다.
첫째, '미래 정보가 몰래 섞이는' 문제입니다. 사후에 작성된 기사나 요약을 실수로 예측 입력에 넣으면, 모델은 훌륭한 성능을 내는 것처럼 보이지만 실제로는 정답을 미리 본 셈입니다. 흔히 말하는 데이터 누출이죠. 텍스트는 발행 시각이 정확히 언제인지, 나중에 수정되지는 않았는지가 불확실해서 이 문제가 특히 심각합니다.
둘째, '재현 불가능한' 텍스트였습니다. 최근 나온 유사 연구(NSW-EPNews)가 있었는데, 이 연구는 제3자 시장 해설과 GPT-4o로 생성한 요약에 의존했습니다. 이런 텍스트는 누가 언제 만들었는지 추적하기 어려워서, 예측 시점에 정말로 알 수 있었던 내용인지 재구성하기 어렵습니다. 결과적으로 "텍스트는 별로 도움이 안 된다"는 결론이 나와도, 그게 텍스트 자체의 한계인지 실험 설계의 한계인지 가르기 어렵습니다.
핵심 아이디어
TRACE는 이 두 함정을 정면으로 해결하기 위해 설계된 전력 가격 예측 벤치마크(비교 실험의 표준 무대)입니다. 이름은 '전력 가격 예측을 위해 사용 가능한 맥락을 시간에 맞춰 재구성한다'는 뜻의 약자입니다.
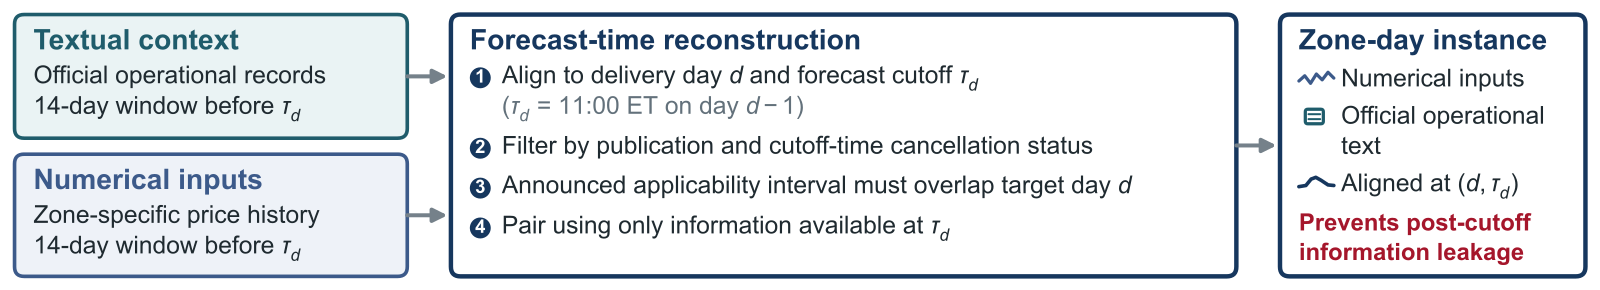
아이디어 1: 예측 시점의 '문서 사진첩'을 되살린다. TRACE는 PJM이 공식 보관한 운영 문서 아카이브를 씁니다. 그리고 각 문서에 대해 세 가지를 확인합니다 — 언제 발행됐는지, 예측 시점까지 취소되지는 않았는지, 발표된 적용 기간이 목표일과 겹치는지. 이렇게 하면 예측 마감 시각(하루 전 오전 11시, PJM 일전 입찰 마감)에 실제로 알 수 있었던 글만 남습니다. 사후 정보 누출이 구조적으로 차단되는 겁니다. 참고로 이 방식은 새로 문서가 쌓여도 그대로 적용할 수 있습니다.
이 규칙으로 미국 전력 시장 PJM의 다섯 개 구역(COMED, AEP, DOM, PSEG, BGE)에서 2021년 10월 2일부터 2025년 9월 30일까지 1,460일, 구역을 곱하면 7,300개의 '구역–일' 예측 문제가 만들어집니다. 가격 입력은 직전 14일치 시간별 가격(여름철 시각 조정 보정을 거쳐 336개 시간 값)으로 고정했고, 14일이라는 길이는 무제한으로 과거를 보는 것 대비 정보량의 87.6%를 유지하면서 오래된 문서의 잔향은 줄이는 균형점으로 선택했습니다. 실험은 시간 순서를 지켜 학습 821일/검증 366일/테스트 273일로 나눴습니다(앞날을 예측하는 상황과 같은 조건).
참고로 공식 운영 문서가 존재하는 날은 많지 않습니다 — 문서 702건이 학습 400일, 검증 146일, 테스트 131일을 덮습니다. 즉 TRACE는 '매일 있는 텍스트'가 아니라 드문 드문 오지만 결정적인 텍스트의 가치를 묻는 실험입니다.
아이디어 2: '글을 읽는다'를 두 가지 방식으로 실험한다. TRACE는 텍스트를 쓰는 방법을 둘로 나눠 비교합니다.
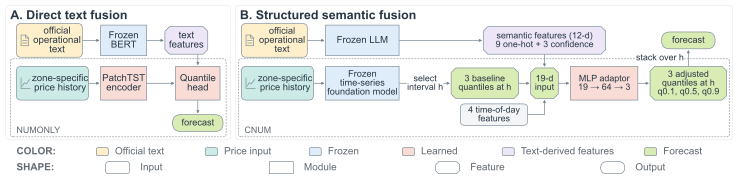
- 직접 텍스트 결합: 가격 패턴을 읽는 모델(PatchTST)과 글을 읽는 모델(BERT)을 나란히 두고, 두 읽기 결과를 합쳐 가격 분위수를 예측합니다. 텍스트를 빼고 똑같이 학습한 모델(NumOnly)과 비교하면 텍스트의 순수한 기여가 보입니다.
- 구조화 의미 결합: 먼저 대형 언어 모델이 문서를 읽고 "가격 중심이 오를/내릴/변화 없음"과 "상방 위험 증가/변화 없음/감소", "하방 위험 증가/변화 없음/감소"를 각각 판단합니다. 이렇게 뽑은 12차원짜리 '의미 신호'를 기존 예측 모델의 분위수 예측과 시간대 정보와 함께 작은 신경망에 넣어 최종 예측을 만듭니다. 여기서는 의미 신호를 빼고 학습한 대조군(Cnum)과 비교합니다.
예측 모델 기준선으로는 TimesFM 2.5·3.0, Chronos-Bolt(작은/기본형), Chronos-2, Moirai-2, Sundial 등 이름이 널리 알려진 시계열 파운데이션 모델 7종을 그대로 썼습니다. 그리고 남은 결정적 의문 하나 — "글이 도움이 되는 게 정말 '오늘의 글'이기 때문인가?" — 를 확인하기 위해 위약 검정도 넣었습니다. 테스트 날짜와 문서의 짝을 1,000번 무작위로 뒤섞어서 성능을 다시 재는 겁니다.
결과 — 무엇을 알아냈나
결과 1: 공식 문서의 의미는 실제 가격과 맞아떨어진다. 언어 모델 두 종(Claude Opus 5, DeepSeek V4-Flash)이 문서만 읽고 내놓은 판단을 실제 가격과 비교했더니, 중심 방향은 20개 설정 중 17개, 상방 위험은 20개 전부, 하방 위험은 16개에서 통계적으로 유의하게 일치했습니다. 상방 위험의 순위 상관(스피어만 상관)은 0.164~0.449로, 세 가지 중 가장 일관됐습니다. 쉽게 말하면 "이 글은 가격이 뛸 징조다"라는 판독이 실제 급등과 가장 자주 맞아떨어진 겁니다.
결과 2: 예측 오차가 실제로 줄어든다. 예측 성능은 분위수 예측의 표준 손실인 핀볼 손실(단위 USD/MWh, 낮을수록 좋음)로 측정했습니다. 가격이 뛸 쪽 위험(0.9 분위수)을 예측할 때:
- 직접 텍스트 결합: 다섯 구역 모두에서 텍스트 없는 모델보다 오차가 3.7~9.1% 감소했습니다. 예를 들어 COMED 구역에서는 5.2348에서 4.8973으로 6.4% 줄었습니다.
- 구조화 의미 결합: 구역 × 예측 모델 × 언어 모델로 나눈 70개 조합 전부에서 의미 신호가 없는 대조군보다 개선됐고, 오차 감소 중위값은 7.4%(범위 1.4
19.3%)였습니다. 텍스트를 아예 모르는 동결 기준선과 비교하면 11.3%(범위 2.824.3%)였죠.
결과 3: 중요한 건 '오늘의 글'이다. 위약 검정이 가장 극적인 결과입니다. 날짜와 문서의 짝을 무작위로 섞어 버리면 이득이 사라지는 데 그치지 않고, 아예 텍스트 없는 기준선보다 성능이 나빠졌습니다. 올바른 짝지음이 무작위 재짝지기보다 좋았던 것은 직접 결합 5개 구역 전부(중위값 20.7%), 의미 결합 70개 조합 전부(중위값 13.9%)였고, 확률도 1,000번 섞은 중 어떤 경우보다 좋았습니다(p = 1/1001). 즉 모델이 얻는 이득은 '글에서 뽑은 특성'이 아니라 '정확한 시점의 정확한 글'에서 나옵니다. 틀린 날의 경보문을 읽는 것은 아예 안 읽는 것보다 해로운 겁니다.
잠깐 정리하면, 텍스트의 가치는 위험한 급등(상방 위험) 예측에 집중되어 있습니다. 상방 위험에서는 70개 조합 전부가 개선된 반면, 하방 위험(0.1 분위수)에서는 70개 중 24개 조합만 개선됐고, 직접 텍스트 결합은 일부 구역에서 오히려 악화했습니다(예: COMED에서 3.4357 vs 텍스트 없는 3.1988).
한계와 주의점
정직하게 적어 두면:
- 텍스트가 있는 날이 적습니다. 테스트 기간 중 공식 문서가 있는 날은 131일입니다. 드문 결정적 문서의 가치를 측정한 실험이라는 뜻이지만, 표본이 큰 편은 아닙니다.
- 이득이 한쪽으로 쏠려 있습니다. 상방 위험(가격 급등)에서 강하고, 하방에서는 약하거나 때로 해롭습니다. '텍스트를 넣으면 무조건 좋다'가 아니라 어떤 위험을 예측하느냐에 따라 다르다는 점에 유의해야 합니다.
- 한 시장, 한 출처입니다. 미국 PJM의 공식 운영 문서에 한정된 결과입니다. 뉴스·소셜미디어·기업 공시 등 다른 텍스트 출처로 그대로 일반화할 수는 없습니다. 동시 연구인 NSW-EPNews가 제3자 해설·생성 요약으로는 이득이 제한적이었다고 보고한 것도, 출처와 시점 재구성 가능성 자체가 결과를 좌우함을 시사합니다.
- 의미 판독은 언어 모델에 의존합니다. 두 개 언어 모델로 평가했고, 성능 지표는 예측 오차(핀볼 손실)입니다. 실제 매매의 수익성·거래비용·체결 문제는 이 연구의 범위 밖입니다.
그래서 투자/실무엔?
전력 관련 투자나 헤지를 다루는 분이라면, 운영 공지 같은 공식 문서가 가격 급등 위험의 선행 신호가 될 수 있다는 실증 근거를 얻은 셈입니다. 발전 제약·수급 경보가 뜬 날에는 상방 위험 관리(노출 축소, 헤지 강화)를 한 단계 조이는 식의 조건부 접근이 근거를 갖게 됐죠. 물론 앞서 본 대로 실제 수익으로 이어지는지는 별도의 검증이 필요합니다.
한편 훨씬 일반적인 교훈도 큽니다. 우리 모두 뉴스·공시·리포트 같은 글을 예측에 넣고 싶어 합니다. 이 연구는 그럴 때 세 가지를 가르쳐 줍니다.
- 언제 알게 됐는지를 기록하십시오. 나중에 쓰인 글이 섞이면 성능은 허상이 됩니다. 예측 시점에 가용했던 정보만 쓰는 '시점 가용성' 규칙이 실험의 신뢰도를 좌우했습니다.
- 섞어 보기 위약 검정을 돌리십시오. 글의 날짜를 무작위로 뒤섞어도 성능이 그대로라면, 그 글은 사실 아무 쓸모가 없었던 겁니다. TRACE에서는 이 검정이 텍스트 가치의 진짜 증거가 됐습니다.
- 평균이 아니라 꼬리를 보십시오. 텍스트의 가치는 평상시가 아니라 위험한 급등 국면에 집중돼 있었습니다. 중앙값 예측 하나로 평가하면 이런 사실이 숨습니다. 분위수 예측으로 꼬리 위험을 따로 측정하는 편이 실무에 유용합니다.
더 알아보기
- 원문 논문: TRACE: A Reproducible Benchmark for Electricity Price Forecasting with Official Operational Text (arXiv:2610.02256)
- KB 5차원 점수 (참고): 참신성 68 / 실용성 67 / 엄밀성 72 / 재현성 76 / 통찰 70 — 종합 70.3, A 티어, 시계열 계량경제학 분과. 재현성 점수가 높은 이유는 벤치마크 구성 규칙과 데이터가 공개되어 예측 시점 재구성이 그대로 재현되기 때문입니다.
- 관련 논문 (KB 기준):
- Forecasting day-ahead electricity prices: A review of state-of-the-art (arXiv:2008.08004) — 전력 가격 예측 연구를 총정리한 리뷰(A 티어). TRACE가 놓인 지도를 보고 싶다면 여기부터.
- Stealing profits: Spread-based temporal hierarchy forecasting (arXiv:2609.23223) — 일전 전력 가격 예측에서 시간 단계 구조를 활용한 최근 연구(A 티어).
- A data-driven merit order: Learning a fundamental electricity price model (arXiv:2501.02963) — 전력 시장의 원리(우선순위 발전 순서)를 학습한 가격 모델(A 티어).
- NSW-EPNews: A News-Augmented Benchmark for Electricity Price Forecasting (arXiv:2506.11050) — 뉴스를 더한 동시 연구. 텍스트 출처 설계에 따라 결과가 달라짐을 보여 주는 대비 사례.
관련 글
 강화학습 포트폴리오
가상 시장을 만들어 연습시킨 AI 포트폴리오 매니저 — vine copula 시뮬레이션과 강화학습이 거래비용을 41.5% 줄인 비결
투자는 미래가 한 번뿐이라 연습할 수 없다. 이 논문은 자산 간 관계를 배워 가상 시장을 찍어내고, 그 가상 세계에서 강화학습 매니저를 훈련시켜 22개월 실전에서 연 34.13%, 샤프 2.31을 기록했다. 시뮬레이션 연습이 거래비용을 41.5% 줄인 과정과, '모형을 믿어도 되는가'를 수학적으로 따진 점을 쉽게 정리한다.
 포트폴리오 최적화A
옵션 가격 모형의 무차익 보장: GROMM과 S&P 옵션 219만 건 검증
옵션 시장 모형이 '무차익'이라는 말을 증명하려면 무엇을 해야 할까. GROMM은 S&P 500 옵션 219만 개 호가로 가격표면을 맞추고, 5천 개 계약 전체에서 위험중립성을 검증했습니다. 국소변동성과 시나리오 생성의 시사점을 정리합니다.
 시계열 계량경제학A
유동성 배급이 정보의 가치를 바꾼다: AUC 0.80 모델이 0.70에 지는 이유
2020년 모기지 시장 위기에서 비은행 대출기관이 대출 매입을 미룬 이유를 190만 건 자료로 분석한 연구입니다. 유동성 제약이 투자 선택을 어떻게 왜곡하고, 예측 모델 평가(AUC)를 어떻게 바꾸는지 일반인 눈높이로 설명합니다.