Comparing tail forecasts: the number of exceedances is the sample size
Raphael Coelho
"데이터가 2년치나 있는데 왜 비교가 안 된다는 거지?" — 답은 간단합니다. 중요한 날이 2년치가 아니라 6일치뿐이기 때문입니다. 이 논문은 그 6일의 비밀을 수학으로 풀어, 전 세계 리스크 관리자가 매일 저지르는 실수의 원인을 정확히 짚어 냅니다.
들어가며
일기예보를 생각해 보세요. 기상청 A와 민간 예보 B가 매일 "내일 비가 오지 않을 구간"을 내놓습니다. 그런데 둘 다 "99% 확률로 이 구간 안에 들어온다"고 주장합니다. 어느 쪽이 더 정확한지 알려면 어떻게 해야 할까요?
"2년치 기록을 비교하면 되지!"라고 답하기 쉽습니다. 하지만 잠깐 생각해 보면 이상합니다. 두 예보가 모두 99% 신뢰 구간을 주장한다면, 구간에서 벗어나는 날은 2년(약 500일)에 5일 정도입니다. 나머지 495일에는 무슨 일이 있었을까요? 예보 A의 구간이 [10도, 20도], 예보 B의 구간이 [9도, 21도]였다면 실제 기온이 15도였다는 사실은 두 예보의 점수 차이를 예보가 나가기 전에 이미 결정해 버립니다. 실제 비교의 재료가 되는 것은 "구간을 벗어난 날" 다섯 번뿐입니다.
금융에서는 이 문제가 훨씬 심각합니다. 은행과 자산운용사는 시장 리스크 자본을 97.5% VaR(위험가치)와 ES(기대부족분)에 기초해 계산하고, 감독기관은 250일 백테스트 창에서 모델을 평가합니다. 97.5% 수준에서 실제 손실이 예측을 넘어선 날은 250일 중 약 6일입니다. 리스크 모델을 바꿀지 말지의 결정이, 겨우 6일치 증거에 달려 있는 셈입니다.
2026년 10월 공개된 이 비교 확률론 논문은 바로 이 구조를 정면으로 다룹니다. 결론부터 말하면, "표본이 250개"가 아니라 "증거가 6개"인 문제라는 사실을 수학으로 증명하고, 그 때문에 지금 쓰는 검정이 어떻게 틀리는지, 그리고 확실하게 비교하려면 무엇을 써야 하는지 알려 줍니다.
무엇이 문제였나
두 예측 모델을 비교하는 표준 도구는 Diebold–Mariano(DM) 검정입니다. 매일 두 모델의 예측 점수 차이를 계산해 그 평균이 0인지 검정하는, 예측 모델 비교 분야의 교과서적 방법입니다. 대부분의 경우 훌륭하게 동작합니다.
문제는 꼬리(tail), 즉 극단적인 날들에서 생깁니다. 꼬리 예측을 비교할 때 쓰는 점수 함수(구간 점수, 분위수 점수 등)에는 특이한 성질이 있습니다. 결과가 두 구간 안에 들어오면 두 모델의 점수 차이는 "구간 폭의 차이"로 정확히 결정됩니다. 구간 폭은 예측이 나가는 순간 이미 아는 값입니다. 다시 말해 그날의 실제 결과는 점수 차이에 아무 정보도 더하지 못합니다. 점수 차이가 진짜로 움직이는 것은 결과가 구간을 벗어난 날, 즉 초과사건(exceedance)이 날 때뿐입니다.
이것이 의미하는 바는 냉정합니다.
- 97.5% VaR의 250일 평가창: 초과사건 약 6일 (보정된 모델 기준)
- 99% 예측 구간 1만 라운드: 초과사건 약 100건
- 필요한 관측 수는 신뢰 수준이 높아질수록(오탐 허용치 α가 작아질수록) 1/α 배로 늘어나지만, 정작 판정에 쓰이는 초과사건 수는 그만큼 늘지 않습니다
전통적인 검정 이론은 "관측 수가 많으면 평균이 정규분포에 가까워진다"는 중심극한정리에 기대고 있습니다. 그런데 초과사건이 몇 개 안 되면 이 근거 자체가 무너집니다. 논문의 표현을 빌면, 데이터가 부족할 때 DM 검정은 "더 겁 없는(덜 보수적인) 모델을, 실제로는 어느 쪽이 더 나은지와 무관하게, 최소한 '초과사건이 한 번도 없었을 확률'만큼은 이겼다고 선언해 버립니다.
핵심 아이디어
논문의 공헌은 세 가지입니다.
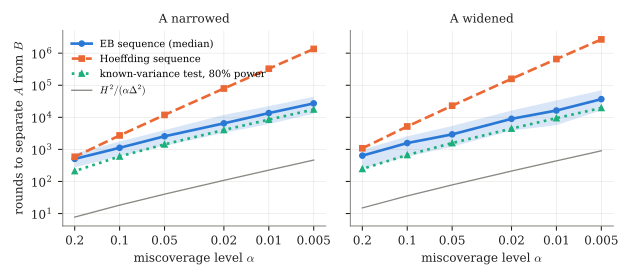
첫째, 비교에 필요한 데이터량을 정확히 계산했습니다. 어떤 예측 구간 쌍에 대해서는 α가 아무리 작아져도 필요한 초과사건 수가 줄지 않고, 따라서 필요한 관측 수는 1/α로 늘어난다는 하한을 증명했습니다. 동시에 이 속도를 실제로 달성하는 상한도 제시합니다. 주인공은 empirical-Bernstein 신뢰구간 시퀀스(EB 시퀀스)라는 도구입니다. 쉽게 말하면 "도박꾼의 자금" 비유로 만든 검정입니다. 어떤 후보 값 m에 대해 "두 모델의 진짜 점수 차이가 m보다 크다"에 베팅하는 도박꾼을 상상하면, m이 진실이라면 그 도박꾼의 자금이 크게 불어날 확률은 작습니다. 자금이 실제로 많이 불었다면 m을 기각할 수 있다는 논리입니다. 이 방식은 분포를 전혀 가정하지 않으면서도, 표본을 늘려가며 중간에 언제 들여다봐도 유효한(anytime-valid) 결론을 줍니다.
둘째, DM 검정이 왜 틀리는지 그 기작을 밝혔습니다. 초과사건이 희박하면 점수 차이의 분포가 크게 치우칩니다. 구간이 좁은(덜 보수적인) 모델은 "구간을 놓친 날"에 큰 벌점을 받지만, 그런 날이 거의 없으면 대체로 폭이 좁아 점수가 유리해 보입니다. 검정은 이 치우침을 눈치채지 못하고 "좁은 모델이 유의하게 낫다"고 결론 내립니다. 흔히 쓰는 소표본 보정(Harvey 등)으로도 이 문제는 해결되지 않았고, block bootstrap-t 버전만 오류를 거의 없앴습니다.
셋째, ES(기대부족분) 비교의 비대칭성을 정리했습니다. VaR와 ES를 함께 비교할 때, 덜 보수적인 ES 예측이 "더 나쁘다"는 것은 가정 없이 증명할 수 있지만, "더 낫다"는 것은 손실 분포의 꼬리에 대한 가정 없이 증명이 불가능합니다. 한쪽 방향만 인증 가능한 구조라는 뜻입니다.
결과 — 무엇을 알아냈나
논문은 시뮬레이션과 두 개의 실증 응용으로 이론을 확인합니다.
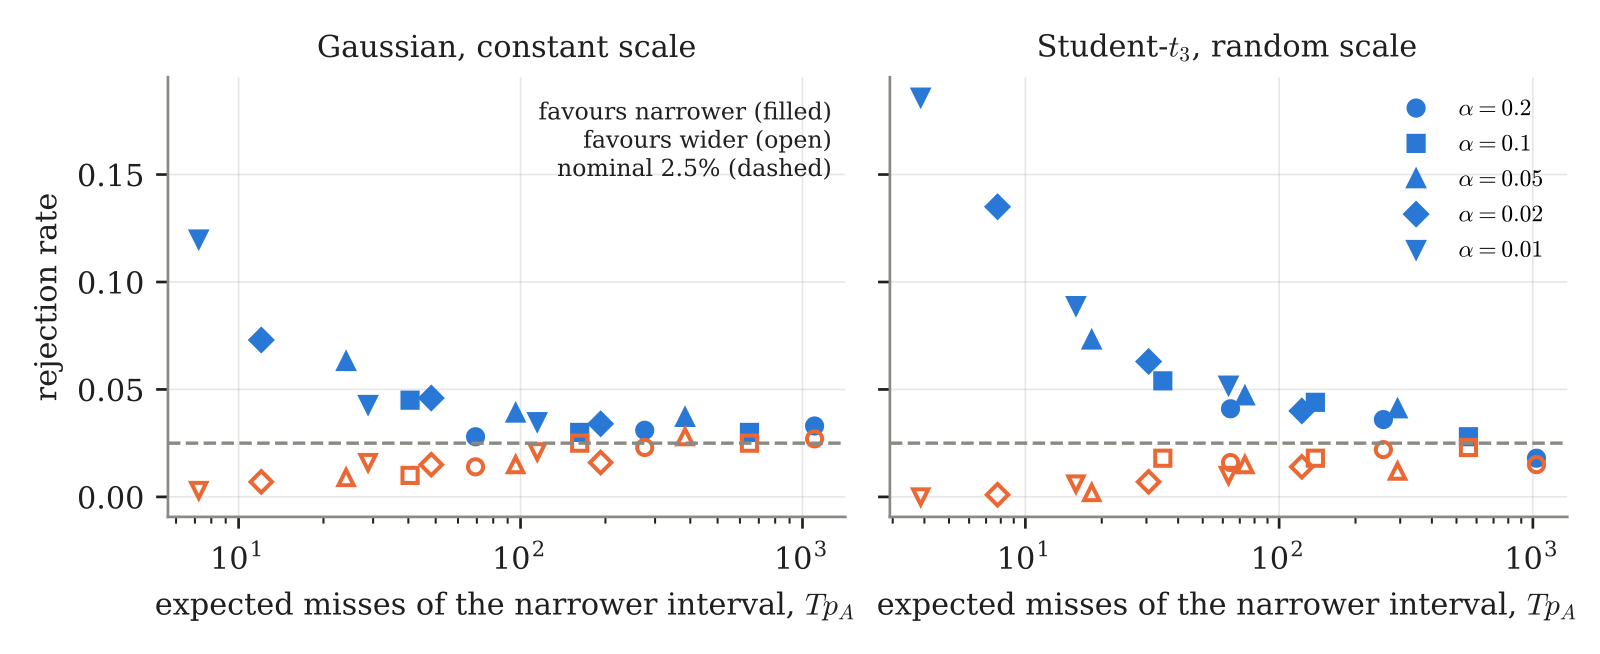
시뮬레이션에서: 구간이 좁은 모델 쪽의 기대 초과사건 수가 25개 미만인 모든 설계에서 DM 검정의 오류가 명목 수준(5%)의 2배를 넘었습니다. 두꺼운 꼬리 데이터에서는 초과사건이 63개까지 있어도 오류가 넘쳤습니다. 반면 bootstrap-t 버전은 가장 극단적인 설계를 빼면 오류를 명목 수준 근처로 유지했습니다.
온라인 conformal 예측 6개 방법 비교(7개 데이터셋, 수준 80~99%): 신뢰 수준이 높아질수록 "이 방법이 낫다"고 판별되는 비율이 급감합니다. 99% 수준에서 범위 보정 방식은 단 한 쌍도 판별하지 못했고, EB 시퀀스는 18%, DM 검정은 54%를 판별했습니다. 하지만 후반부 데이터로 검증해 보면 DM의 유의한 결론 중 10%가 부호가 뒤집혔고, EB의 결론 149건은 전부 부호가 일치했습니다.
실제 주가지수 7개(S&P 500, FTSE 100, DAX, 니케이 225, 유로스톡스 50, 항셍, 보베스파), 2000~2026년, 6개 VaR·ES 모델 비교: 이 결과가 가장 무섭습니다. 250일 창에서 DM 검정이 유의한 결과를 내놓은 경우 중 덜 보수적인 모델을 이겼다고 선언한 비율이 73%(τ=0.025)에서 80%(τ=0.01)에 달했습니다. 그리고 그런 "덜 보수 모델의 승리" 선언 중 18.4%(τ=0.025)는 나머지 날들의 순위와 정반대였습니다. 더 보수적인 모델이 이겼다고 선언된 쪽의 모순률은 6.9%에 불과했습니다. 즉, "겁 없는 모델이 이겼다"는 결론일수록 뒤집힐 확률이 2.7배 높습니다.
다행히 대안은 있습니다. 정규분포 가정 대신 block bootstrap-t로 임계값을 바꾸면 기울기가 대부분 사라졌습니다(덜 보수 모델 편이 73%→51%, 80%→60%). 그리고 EB 신뢰구간 시퀀스는 250일 창 안에서는 인증에 성공하지 못했습니다(초과사건이 49일뿐이라 당연합니다). 하지만 전체 기간(수천 일)에서는 쌍의 약 4448%에 대해 "덜 보수적인 모델이 자국의 나쁜 날들에 실제로 더 나빴다"는 것을 가정 없이 인증했습니다. 데이터가 쌓이면 확실한 결론이 난다는, 정직한 도구의 모습입니다.
한계와 주의점
- 이 논문이 보여 주는 것은 "비교가 불가능하다"가 아니라 "정직하게 비교하려면 그만큼의 초과사건이 필요하다"입니다. 초과사건이 6개뿐인 250일 창에서 확실한 순위를 매기려면 (이 논문의 하한에 따르면) 애초에 불가능에 가깝습니다.
- EB 신뢰구간 시퀀스는 확실한 대가가 있습니다. 같은 검정력을 내기 위해 DM 검정의 2~3배 많은 라운드가 필요합니다. 공짜 점심은 없습니다.
- 구간의 끝점 거리 자체가 두꺼운 꼬리라면(예: 두꺼운 꼬리 변동성으로 스케일된 구간) 필요한 데이터량은 실현된 범위에 의존하게 되고, DM 통계량 자체가 정규분포로 수렴하지 않을 수도 있습니다.
- 실증 분석의 모델 튜닝이 전체 기간에서 선택되어, "앞으로도 이렇게 나쁠까"에 대한 완전한 외표본 검증은 아닙니다.
그래서 투자/실무엔?
리스크 모델을 검증하거나, 두 예측 전략의 꼬리 예측력을 비교하는 일을 해 본 적이 있다면 이 세 가지를 기억하세요.
- "초과사건 수"를 항상 보고하세요. 점수 차이가 예측 전 값에서 벗어난 날이 몇 일이었는지는 예측과 결과만으로 계산할 수 있습니다. 이 숫자가 비교의 진짜 표본 크기입니다.
- 초과사건이 적을 때 DM 검정의 정규 임계값을 믿지 마세요. 실무적으로 가장 간단한 대안은 block bootstrap-t입니다. 논문은 시뮬레이션과 실제 지수 데이터 모두에서 이것이 기울기를 대부분 제거함을 보여 줍니다.
- 결론에 규제적 무게가 실리거나 순차적으로 모니터링한다면, 분포 가정 없이 언제든 유효한 신뢰구간 시퀀스를 쓰세요. 비용은 2~3배의 데이터, 이익은 "지금까지의 결론이 틀릴 확률이 α 이하"라는 확실성입니다.
더 큰 그림에서 이 논문은 "리스크 모델 검증"이라는 분야가 여전히 얼마나 연약한 기초 위에 있는지 보여 줍니다. 250일 백테스트 창이라는 규제 표준은, 97.5% 수준에서 겨우 6번의 초과사건을 제공합니다. 모델을 갈아타고 싶은 유혹이 있을 때, 그 유혹이 "덜 보수적인 모델이 이겼다"는 검정 결과에서 온다면 — 이 논문은 그 결론이 뒤집힐 확률이 정확히 얼마인지까지 알려 줍니다.
더 알아보기
- 원문: Comparing tail forecasts: the number of exceedances is the sample size (arXiv:2610.40366)
- 5차원 점수 (참고): 새로움 82 / 적용성 79 / 엄밀성 89 / 재현성 43 / 통찰 86 (composite 78.0, A등급). 재현성 점수가 낮은 것은 실증 데이터의 라이선스 성격 탓이지만, 논문의 모든 표·그림 수치를 재현하는 코드가 Zenodo와 GitHub에 공개되어 있다는 점은 오히려 실무 재현에 유리합니다.
- 관련 논문:
- Optimal probabilistic forecasts for risk management (arXiv:2303.01651) — 리스크 관리를 위한 최적 확률 예측의 점수 함수 설계
- Using quantile time series and historical simulation to forecast financial risk (arXiv:2502.20978) — 분위수 시계열과 역사적 시뮬레이션의 VaR·ES 예측 비교
- Mixed-frequency quantile regressions to forecast Value-at-Risk and Expected Shortfall (arXiv:2011.00552) — 혼합 빈도 분위수 회귀로 VaR·ES 예측
관련 글
 시장 미시구조S
예치를 늘렸는데 이자가 줄었다? 대출 풀 금리곡선의 숨은 규칙
가상자산 대출 시장에 예금을 더 넣었더니 이자 수입이 오히려 줄어드는 일이 실제로 벌어집니다. 이 논문은 '언제 예치가 독이 되는가'를 하나의 부등식으로 답하고, 실제 솔라나 시장 데이터에서 큰 예치자들이 시간의 약 10분의 1 동안 이런 위험에 놓여 있었음을 보여 줍니다.
 강화학습 포트폴리오A
강화학습 트레이딩 보상 정합성 인증: AI가 진짜 투자 목표를 따르는지 검증하기
포트폴리오 강화학습 에이전트가 보상을 정확히 최대화해도 다른 투자 선호를 구현할 수 있습니다. 잔차 인증서로 보상 오정의와 학습 오차를 분리해 검증한 2026년 최신 연구를, 432개월 실증 결과와 한계까지 쉽게 풀어 설명합니다.
 포트폴리오 최적화A
옵션 가격에 맞춘 변동성 모형 — 마팅게일 최적수송 캘리브레이션 쉽게 이해하기
시장에서 관측한 옵션 가격을 지키면서 기준 모형의 변동성을 최대한 따라 하는 확률 모형을 만드는 방법을 소개합니다. 마팅게일 최적수송과 병렬 계산으로 캘리브레이션 문제를 푸는 2026년 이론 논문을 비전공자 눈높이로 풀어 설명합니다.