Certifying Reward Alignment in Portfolio Reinforcement Learning
Matin Tavakoli, Seyedreza Tavakoli, Faezeh Salmani, Amir Amini, Mohammad Hosein Rohban, Gholamali Aminian 외 1명
한 줄 요약: AI 트레이더에게 내려 준 '지시서'와 AI가 실제로 추구한 '목표'가 다르면 어떻게 알 수 있을까? 이 논문은 그 간극을 숫자로 인증하는 감사 도구를 제안합니다.
들어가며: 시험을 잘 본 학생이 지시를 잘못 따르는 경우
자녀에게 "숙제를 열심히 해라"고 말했는데, 아이가 밤새 게임 점수를 올리는 데 열심이었다고 상상해 보세요. 아이는 정말 "열심히" 했습니다. 문제는 '무엇에' 열심히였는지입니다.
금융 강화학습(reinforcement learning, 이하 RL)에서도 비슷한 일이 벌어집니다. 투자 지시서는 "수익은 이만큼, 위험은 이 정도, 거래 비용은 이 수준에서"라고 말합니다. 그런데 RL 에이전트는 이런저런 계산을 거쳐 결국 '보상 함수'라는 하나의 숫자를 최대화합니다. 이 보상 함수가 지시서의 뉘앙스를 완벽히 담고 있을까요?
논문이 지적하는 것은 이런 상황입니다. 에이전트가 보상을 정확히 최대화했는데도, 정작 투자 스타일은 지시서가 원하던 것과 다를 수 있습니다. 더 곤란한 것은, 백테스트 성적이 좋으면 이 사실이 전혀 눈에 띄지 않는다는 점입니다.
2026년 10월 arXiv에 올라온 "Certifying Reward Alignment in Portfolio Reinforcement Learning"(강화학습 포트폴리오에서의 보상 정합성 인증)은 바로 이 '지시서와 행동의 간극'을 측정하고 인증하는 방법을 제안합니다. 미국 버지니아 공대(Virginia Tech)와 데이터이즘 연구소(Dataism Laboratory for Quantitative Finance) 등의 연구진이 썼고, 2026년 11월 이탈리아 밀라노에서 열리는 금융 모델 해석 가능성·정합성 워크숍에서 발표될 예정입니다.
무엇이 문제였나: 보상 함수 하나로는 뉘앙스가 사라진다
투자 지시서는 대개 이렇게 생겼습니다. "기대수익은 높이되, 변동성이 크면 싫어하고, 거래가 잦아 비용이 많이 발생하는 것도 싫어한다." 이 세 가지 선호를 RL의 보상 하나로 압축하려면 어쩔 수 없이 단순화가 필요합니다.
논문은 이 단순화가 어떻게 다른 결정으로 이어지는지 구체적인 예를 듭니다.
- 분산 대신 '제곱의 평균'을 쓰면: 수익의 변동을 벌점으로 주려다 보니, 기대수익 자체의 제곱까지 함께 벌점으로 때리게 됩니다. 수익이 클수록 과도하게 보수적인 포지션이 나옵니다.
- 자산 간 의존성을 무시하면: 지금 들고 있는 포지션이 앞으로의 위험을 헤지해 주는 '연속 헤지' 효과가 보상에서 빠집니다. 당장은 좋아 보여도 나중에 위험이 커지는 선택을 하게 됩니다.
- 위험은 교정했는데 비용을 함께 조정하지 않으면: 위험 항의 계수만 바꾸는 사이, 거래 비용에 대한 상대적 선호가 조용히 바뀝니다.
핵심은 "보상을 정확히 최대화했다"는 사실이 "지시서를 정확히 따랐다"는 뜻이 아니라는 점입니다. 그리고 좋은 백테스트 결과는 이 둘을 구분해 주지 못합니다. 백테스트는 "그 목적함수가 시장에서 잘 됐는지"를 말할 뿐, "그 목적함수가 애초에 원하던 것이었는지"는 말하지 않으니까요.
핵심 아이디어: '행동을 한 번 바꾸면 얼마나 좋아질까'로 검사한다
논문의 제안은 놀랍도록 실용적입니다. 학습이 끝난 정책(에이전트의 행동 규칙)을 감사(audit) 대상으로 삼고, "지금 상태에서 행동 하나만 바꾸면 목적함수가 얼마나 개선될 수 있는가"의 상한을 계산하는 것입니다.
이 상한이 작으면, 에이전트는 사실상 "지금 행동이 최선"이라는 뜻이고, 크면 "무언가 개선 여지가 남아 있다", 즉 지시서대로 동작하지 않는다는 뜻입니다. 마치 자동차 정비소에서 "이 부품을 교체하면 성능이 얼마나 좋아질까"를 측정해 보는 것과 같습니다. 개선 여지가 0에 가깝다면 부품은 멀쩡한 겁니다.
이 감사 도구에는 몇 가지 교묘한 설계가 숨어 있습니다.
첫째, 오류를 세 가지로 분리합니다. 지시서의 오류(보상 설계 오정의), 학습 과정의 오류(액터 오차), 그리고 미래 가치를 예측하는 부분의 오류(크리틱 오차)를 따로 떼어 봅니다. 그래야 "보상 자체가 틀렸는지"와 "보상은 맞는데 학습이 덜 됐는지"를 구분할 수 있습니다.
둘째, 크리틱의 '상수 오차'는 무시합니다. 가치 예측 모델이 전체적으로 100만큼을 과대평가하고 있다면, 그것만으로는 결정이 틀려지지 않습니다. 문제는 상태에 따라 오차가 달라질 때입니다. 논문의 인증서는 상태 간 '차이'만 추적하도록 설계되어, 실제로 결정을 흔드는 오차에만 반응합니다. 수치 실험에서 크리틱 전체를 상수만큼 어긋나게 해도 인증서 값의 변화는 1.7×10⁻¹⁵(소수점 아래 14자리) 미만이었습니다.
셋째, 균형 정책을 미리 알 필요가 없습니다. 감사 대상 정책과 가치 예측 모델만 있으면 됩니다. '정답 정책'을 모르는 현실 상황에서도 그대로 쓸 수 있다는 뜻입니다.
넷째, 판단을 유보할 줄 압니다. 별도의 감사 표본으로 계산한 상한이 너무 헐렁하면 "통과"도 "탈락"도 아닌 "판단 불가"를 반환합니다. 안전장치를 빈틈없이 만들겠다는, 오히려 보수적인 설계입니다.
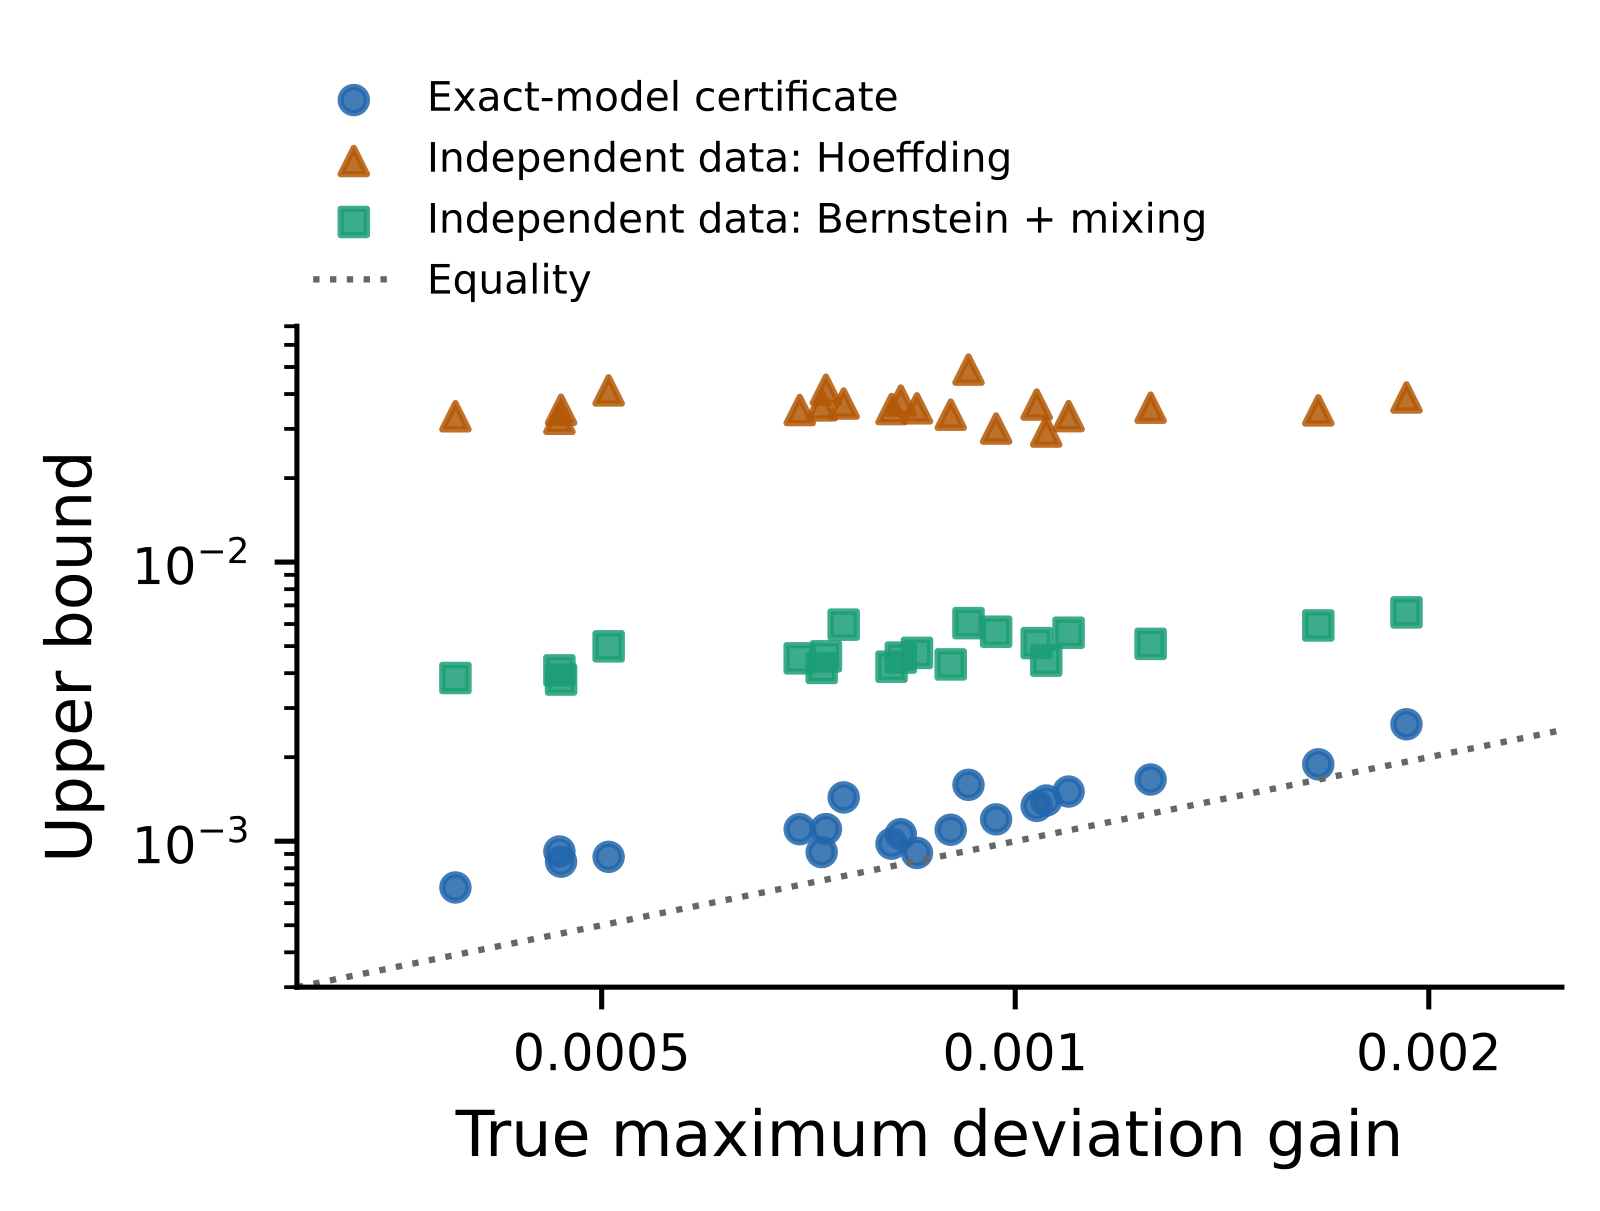
위 그림은 정책 20개에 대해 계산한 상한과 실제 개선 이득을 겹쳐 본 것입니다. 점들이 모두 대각선 위에 있다는 것은 모든 상한이 실제를 덮고 있다는 뜻이고, 정교화된 상한(오른쪽 범례)이 가장 실제에 가깝게 붙어 있는 것을 볼 수 있습니다.
결과 — 무엇을 알아냈나
1. '연속 헤지'를 보상에 넣자 행동이 진짜 목표에 가까워졌다
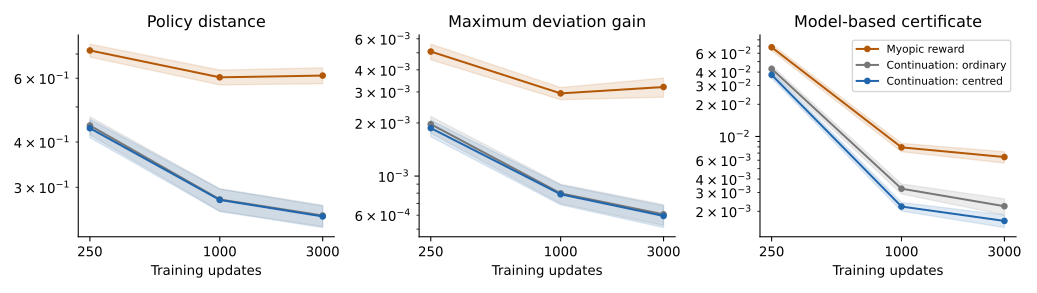
연구진은 작은 통제 시장(두 가지 시장 상황이 오가는 가상 시장)을 만들어 세 가지 학습 방법을 비교했습니다: 미래를 고려하지 않는 보상(근시안), 미래 보정을 넣은 보상, 그리고 미래 보정 + 중앙정렬 기법을 넣은 보상. 시장 9종 × 무작위 초기값 20개로 총 180번 실험했습니다.
- 중앙정렬 기법을 넣은 방법은 근시안 방법보다 목표 정책과의 거리를 59.2% 줄였고, '행동 하나를 바꿀 때의 개선 이득'은 81.4% 줄였습니다.
- 표본 수를 128개에서 8,192개로 늘리면 근시안 학습의 오차도 줄어들지만(1.497 → 0.5871), 미래 보정을 넣은 학습이 항상 더 낮았습니다(1.436 → 0.1649). 데이터를 아무리 많이 넣어도 보상에서 빠진 항목은 채워지지 않습니다. 데이터가 아니라 설계의 문제입니다.
- 일반적인 최적화 알고리즘(PPO)을 쓰는 별도 실험에서도 같은 보상 교정만으로 거리 33.3%, 개선 이득 49.8% 감소했습니다. 즉, 특정 학습 알고리즘의 트릭이 아니라 보상 설계 자체의 효과입니다.
흥미로운 반전도 있습니다. 신경망이 "수렴했다"고 판단하는 순간(그래디언트가 0)을 인위적으로 만들어 봤더니, 실제 개선 이득은 0.10263이나 남아 있었습니다. 학습이 멈춘 것처럼 보이는 것이 진짜 최선이라는 뜻은 아닙니다. 그래서 감사 도구가 필요한 것입니다.
2. 36년치 실제 데이터: 목적함수는 맞출 수 있어도 수익은 못 맞춘다
이번에는 진짜 시장 데이터입니다. 케네스 프렌치(Kenneth French) 데이터 라이브러리의 미국 산업 포트폴리오 수익률로 1990년 1월부터 2025년 12월까지 432개월을, 공분산 추정 방법 7가지 × 산업 분류 3종(10개·30개·49개 산업)으로 나눠 검증했습니다.
결과는 두 갈래였습니다.
- 좋은 소식: 논문이 제안한 '결합 보상 캘리브레이션'은 모든 21개 조합에서 자기 목표와의 거리가 0.00000016(1.60×10⁻⁷)보다 작았습니다. 즉, 정한 목적함수를 거의 완벽하게 구현했습니다. 비교군인 단순 보상들은 눈에 띄는 오차가 남았습니다.
- 냉정한 소식: 그러나 실제 투자 성과는 개선되지 않았습니다. 공분산 모형을 바꿔 가며 18번 비교했는데, 전부에서 성과 차이의 95% 신뢰구간이 0을 포함했습니다. 통계적으로 '차이 없음'입니다.
이것은 논문이 오히려 강조하는 지점입니다. "목적함수를 정확히 구현하는 것"과 "그 목적함수가 돈을 잘 버는 것"은 별개의 문제입니다. 감사 도구는 전자를 검사할 뿐, 후자를 보장하지 않습니다. 최소분산 포트폴리오가 오히려 21개 조합 전부에서 변동성 대비 성과가 가장 좋았다는 점도, 복잡한 방법이 늘 이기지 않는다는 전통적인 교훈을 다시 확인시켜 줍니다.
3. 현실적인 감사 시나리오: '통과'가 아니라 '판단 불가'가 나오기도 한다
논문은 실제 운영을 흉내 낸 예시도 보여줍니다. "행동 하나를 바꿔서 얻을 수 있는 개선이 0.001(정규화된 효용 단위) 이하여야 승인"이라는 내부 기준을 세우고, 감사 표본 786,432개로 검사한 결과 상한은 0.004992. 기준(0.001)을 넘으므로 판정은 '판단 불가'입니다. 흥미롭게도 시뮬레이션의 실제 개선 이득은 0.000506으로 기준 안이었지만, 상한이 이를 증명해 주지 못한 겁니다. 검증 장비의 정밀도가 기준에 못 미치면 부품이 멀쩡해도 합격 판정을 내릴 수 없는 것과 같습니다.
여기서 주의할 점: 0.001은 백테스트 수익률 10bp(0.1%p)가 아니라 논문 실험의 '정규화 효용 단위'입니다. 원문도 "사후에 적용해 본 예시일 뿐, 사전에 등록된 수용 판정이 아니다"라고 명시합니다.
한계와 주의점
정직하게 짚어야 할 것들이 있습니다.
- 작은 실험실 증거가 핵심입니다. 순차 학습 실험은 두 가지 상황만 오가는 작은 가상 시장에서, 표본을 마음대로 뽑을 수 있는 환경(현실보다 유리한 조건)으로 이뤄졌습니다. 논문도 "현실적인 순차 다자산 테스트는 열린 과제"라고 씁니다.
- 역사적 36년 실증은 새 학습 방법의 백테스트가 아닙니다. 그 실험은 단일 기간 문제의 목적함수 정합성을 검사한 것이며, 순차 학습자의 시장 성과를 검증한 게 아닙니다.
- 가정이 있습니다. 자산수익의 분산이 유한하고, 미래 충격이 조건부로 독립이며, 정책이 현재 자산 규모에 의존하지 않는다는 가정. 숨은 상태로 움직이는 트레이딩 전략에는 맞지 않을 수 있습니다.
- 인증서는 '한 단계'의 상한입니다. 전체 전략의 최악 손실을 보장하는 것이 아니라, 당장 행동 하나를 바꿀 때의 개선 여지만 묶습니다.
- 감사에 쓰는 표본은 학습에 안 쓴 신선한 데이터여야 하고, 오차에 상한이 있어야 합니다. 시간열 데이터를 그대로 감사에 쓰면 이 보장이 깨질 수 있습니다.
다만 재현성 면에서는 후한 점수를 줄 만합니다. 실험 코드가 공개되어 있고(GitHub: DataismLab/Reward-alignment), 20개 초기값 전부를 보고했으며, 저작권 표시(CC BY 4.0)도 명확합니다.
그래서 투자/실무엔?
일반 독자 눈높이에서 세 가지만 남기면 이렇습니다.
- "성과가 좋다"와 "지시를 잘 따랐다"는 다른 질문입니다. AI 투자 전략을 검토할 때 백테스트 차트만 보지 말고, "이 전략이 원래 세운 목표를 그대로 추구했는가"를 따로 물어야 합니다. 이 논문은 그 질문에 답하는 측정 도구를 처음으로 정밀하게 만든 작업입니다.
- 오류의 원인을 구분해야 해결할 수 있습니다. 보상 설계가 틀린 것인지, 학습이 덜 된 것인지, 미래 예측이 흔들린 것인지 — 원인에 따라 처방이 완전히 다르기 때문입니다.
- "모르겠다"고 말하는 검증 절차가 오히려 신뢰할 만합니다. 증거가 부족하면 통과시키지 않는 설계는, 금융에서 모델 리스크를 다루는 가장 건강한 태도와 닮아 있습니다.
물론 이 도구가 투자 수익을 늘려 주지는 않습니다. 대신 "우리 AI가 우리가 시킨 대로 하고 있는가"라는, AI를 쓰기 시작한 모든 팀이 언젠가 마주치는 질문에 대해 처음으로 숫자로 답할 수 있게 해 줍니다.
더 알아보기
- 원문: Certifying Reward Alignment in Portfolio Reinforcement Learning (arXiv:2610.34153) — 2026년 10월 27일 게재, 밀라노 워크숍 발표 예정, 코드 공개(DataismLab/Reward-alignment)
- KB 5차원 점수 (참고): 새로움 74 / 실용성 68 / 엄밀성 83 / 재현성 88 / 통찰 82 — 종합 77.5 (A등급)
- 함께 읽으면 좋은 논문 (KB 엔티티 기준 이웃):
- Mean–Variance Portfolio Selection by Continuous-Time Reinforcement Learning (2412.16175) — 연속시간 RL로 푸는 평균-분산 선택의 또 다른 경로
- Exploratory Mean-Variance Portfolio Optimization with Regime-Switching (2501.16659) — 시장 상황 전환을 반영한 탐험형 최적화
- Mean-Variance Efficient Reinforcement Learning (2010.01404) — 평균-분산과 RL을 잇는 초기 연구
- Towards Generalizable Reinforcement Learning for Trade Execution (2307.11685) — 집행 전략 RL의 일반화 문제 (S등급)
관련 글
 시장 미시구조S
LOB 시뮬레이터 시장충격 벤치마크: AI 트레이더가 배우는 가짜 충격
가짜 주문장(LOB) 시뮬레이터에서 훈련한 AI 트레이더가 실제 시장에서 실패하는 이유를 다룬 벤치마크 논문 해설. 메타오더 주입 실험으로 생성형 LOB 모델의 시장충격이 제곱근 법칙에서 벗어나고 이완되지 않음을 밝힌다.
 강화학습 포트폴리오
가상 시장을 만들어 연습시킨 AI 포트폴리오 매니저 — vine copula 시뮬레이션과 강화학습이 거래비용을 41.5% 줄인 비결
투자는 미래가 한 번뿐이라 연습할 수 없다. 이 논문은 자산 간 관계를 배워 가상 시장을 찍어내고, 그 가상 세계에서 강화학습 매니저를 훈련시켜 22개월 실전에서 연 34.13%, 샤프 2.31을 기록했다. 시뮬레이션 연습이 거래비용을 41.5% 줄인 과정과, '모형을 믿어도 되는가'를 수학적으로 따진 점을 쉽게 정리한다.
 포트폴리오 최적화A
옵션 가격에 맞춘 변동성 모형 — 마팅게일 최적수송 캘리브레이션 쉽게 이해하기
시장에서 관측한 옵션 가격을 지키면서 기준 모형의 변동성을 최대한 따라 하는 확률 모형을 만드는 방법을 소개합니다. 마팅게일 최적수송과 병렬 계산으로 캘리브레이션 문제를 푸는 2026년 이론 논문을 비전공자 눈높이로 풀어 설명합니다.