LOB-Impact Benchmark: Emergent Market Impact in Generative Limit Order Book Models
George Nigmatulin, Valentin Mohl, Sascha Frey, Kang Li, Aramis Marti-Shahandeh, Mihai Cucuringu 외 3명
한 줄 요약: 주가 흐름을 그럴듯하게 흉내 내는 인공지능 시뮬레이터라도, "내가 큰 주문을 넣으면 시장이 어떻게 반응할지"는 엉터리로 배울 수 있고 — 그걸 정확히 잡아내는 검사법이 나왔습니다.
들어가며
게임 레이싱 시뮬레이터를 생각해 보세요. 화면에 뜨는 풍경, 엔진 소리, 속도감까지 진짜와 똑같습니다. 그런데 그 시뮬레이터에서 훈련한 드라이버가 실제 서킷에 나가면 코너마다 사고를 친다면? 문제는 그래픽이 아니라 "내가 핸들을 꺾으면 차가 어떻게 미끄러지는가"라는 반응 물리학이 틀렸기 때문입니다.
금융 시장 시뮬레이터도 정확히 같은 상황에 놓여 있습니다. 요즘 인공지능은 실제 주문 흐름(limit order book, 이하 LOB — 시장에 제시된 매수·매도 주문들의 목록)을 놀랍도록 비슷하게 만들어 냅니다. 스프레드(매수·매도 가격 차이), 거래량, 주문 도착 패턴까지 통계적으로 진짜와 구별하기 어렵습니다. 그래서 이런 시뮬레이터를 "강화학습 트레이딩 에이전트의 연습용 가상 시장"으로 쓰자는 아이디어가 활발합니다.
그런데 여기서 한 가지가 빠져 있습니다. 큰 주문을 넣으면 시장이 어떻게 움직이는가. 기관 투자자는 큰 주문을 한 번에 내지 않고 잘게 쪼개서 수십~수백 번에 나눠 냅니다(이렇게 쪼갠 큰 주문을 '메타오더'라고 합니다). 이 메타오더가 가격을 얼마나 밀어 올리고, 실행이 끝나면 가격이 얼마나 돌아오는지는 트레이딩 비용의 핵심입니다. 시뮬레이터가 이 반응을 틀리게 배우면, 연습에서만 통하는 "가짜 최적 전략"이 나옵니다. 옥스퍼드 대학 연구진이 만든 LOB-Impact Benchmark는 바로 이 반응을 측정하는 검사 도구입니다.
무엇이 문제였나
지금까지 생성형 LOB 모델의 평가 방식은 "만들어 낸 주문 흐름이 실제 데이터와 얼마나 비슷한가"였습니다. 분포 비교 지표로 스프레드 분포, 거래량 분포, 주문 사이 시간 간격 등을 점수화합니다. 대표적인 것이 LOB-Bench라는 평가 도구입니다.
하지만 이런 지표에는 맹점이 있습니다. 가상 시장에 내 주문을 넣었을 때 가격이 어떻게 반응하는지는 측정하지 못합니다. 시장 가격은 '모두의 주문'이 얽혀 만드는 결과라서, 역사적 데이터만으로는 "내가 주문을 넣었더니 가격이 이만큼 움직였다"는 반사실(counterfactual)을 확인할 수 없습니다. 시뮬레이터라면 가능하죠 — 실제로 주문을 넣어 보면 되니까요.
실제 금융 시장에서 이 반응은 잘 알려진 경험 법칙으로 정리되어 있습니다. 바로 제곱근 법칙(square-root law)입니다. 쉽게 말하면 "메타오더가 하루 거래량의 10%를 차지하면 가격은 일일 변동성의 절반 정도만큼 밀린다"는 식의 법칙인데, 주식·선물·외환 전반에서 반복적으로 관측된 사실입니다. 핵심은 법칙의 모양이 제곱근(0.5제곱)이라는 점입니다 — 주문이 4배 커져도 충격은 2배만 커집니다. 왜냐하면 큰 주문이 시장의 유동성을 먹어 치우면, 그 뒤로 새로운 유동성이 채워 들어오면서(push가 축적되는 대신 완화되는) 충격이 덜 쌓이기 때문입니다. 실행이 끝나면 가격은 피크의 약 2/3 수준까지 되돌아오기도 합니다.
문제는, 인공지능 시뮬레이터가 이 법칙을 지키는지 아무도 검사하지 않았다는 것입니다.
핵심 아이디어
연구진은 아주 단순한 질문에서 출발했습니다. "생성형 LOB 모델에 진짜처럼 큰 주문을 넣어 보면, 진짜 시장처럼 반응하는가?"
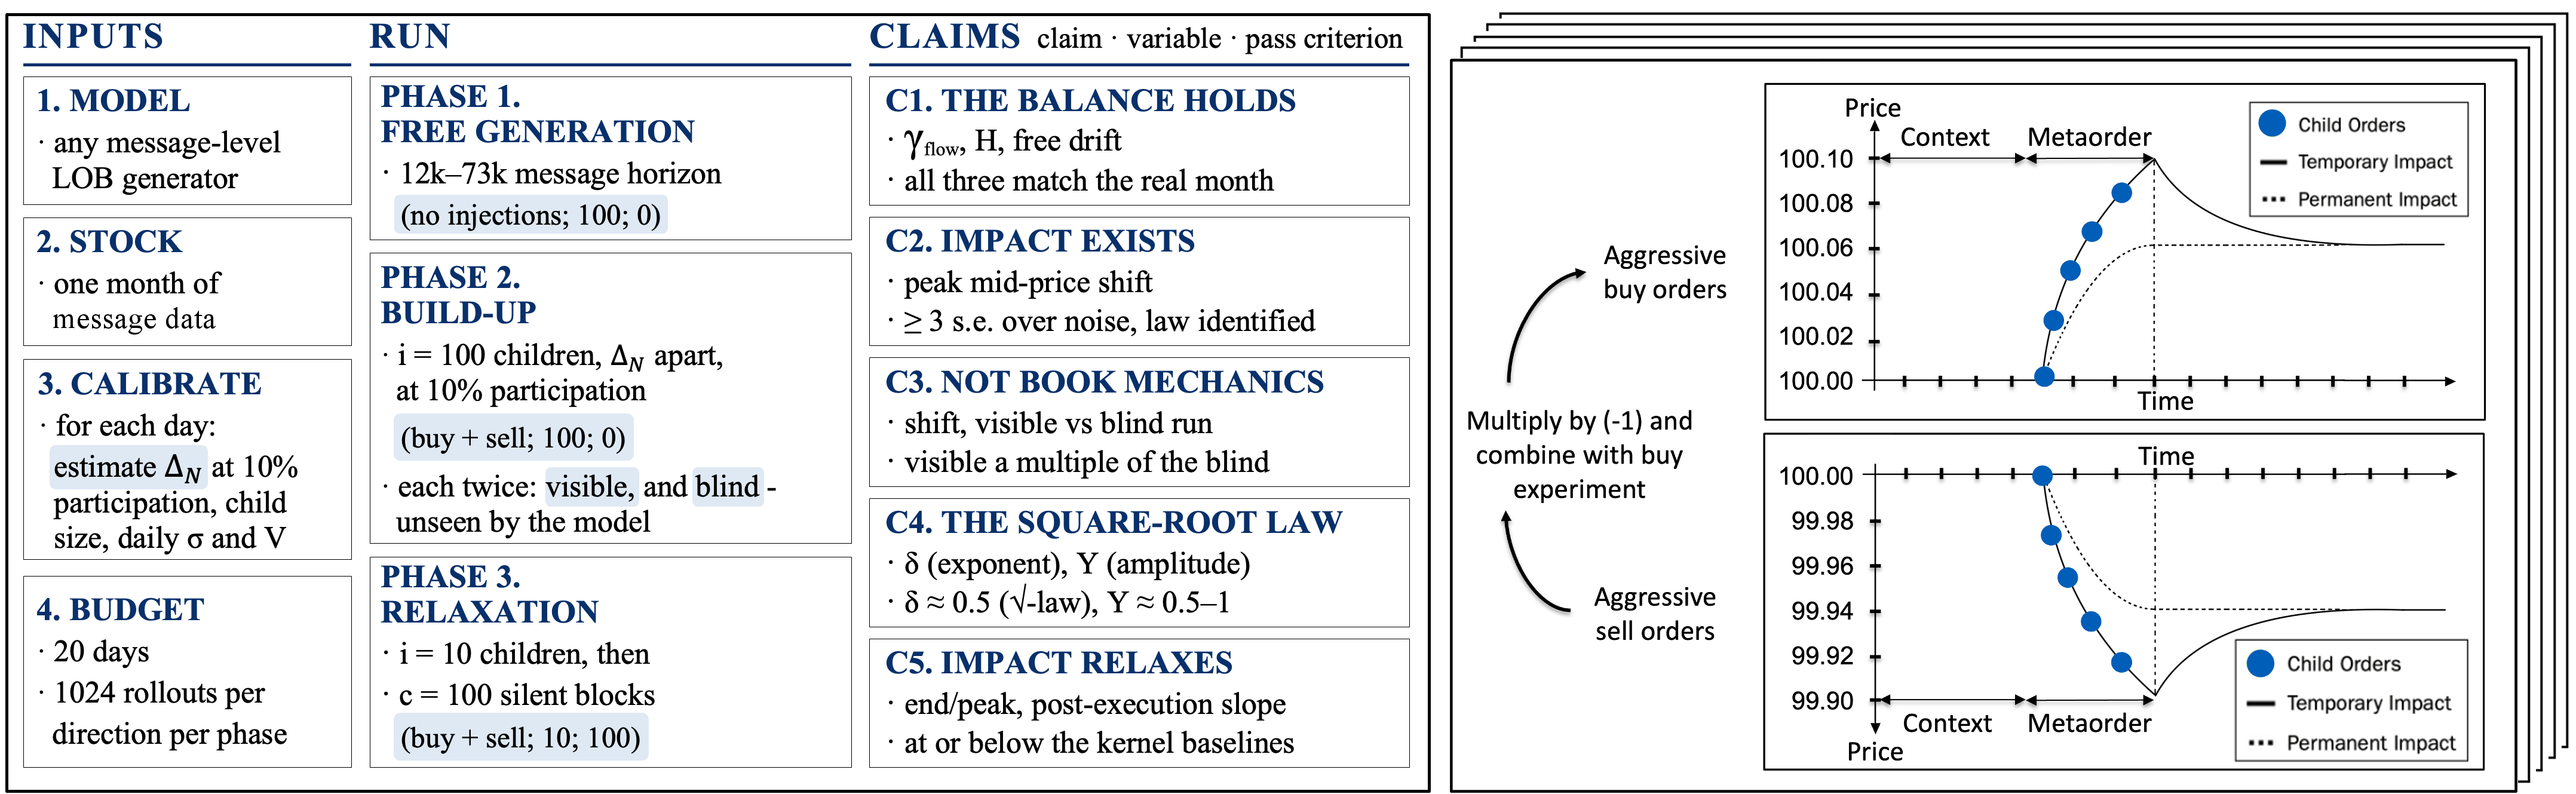
검사 절차는 세 단계입니다.
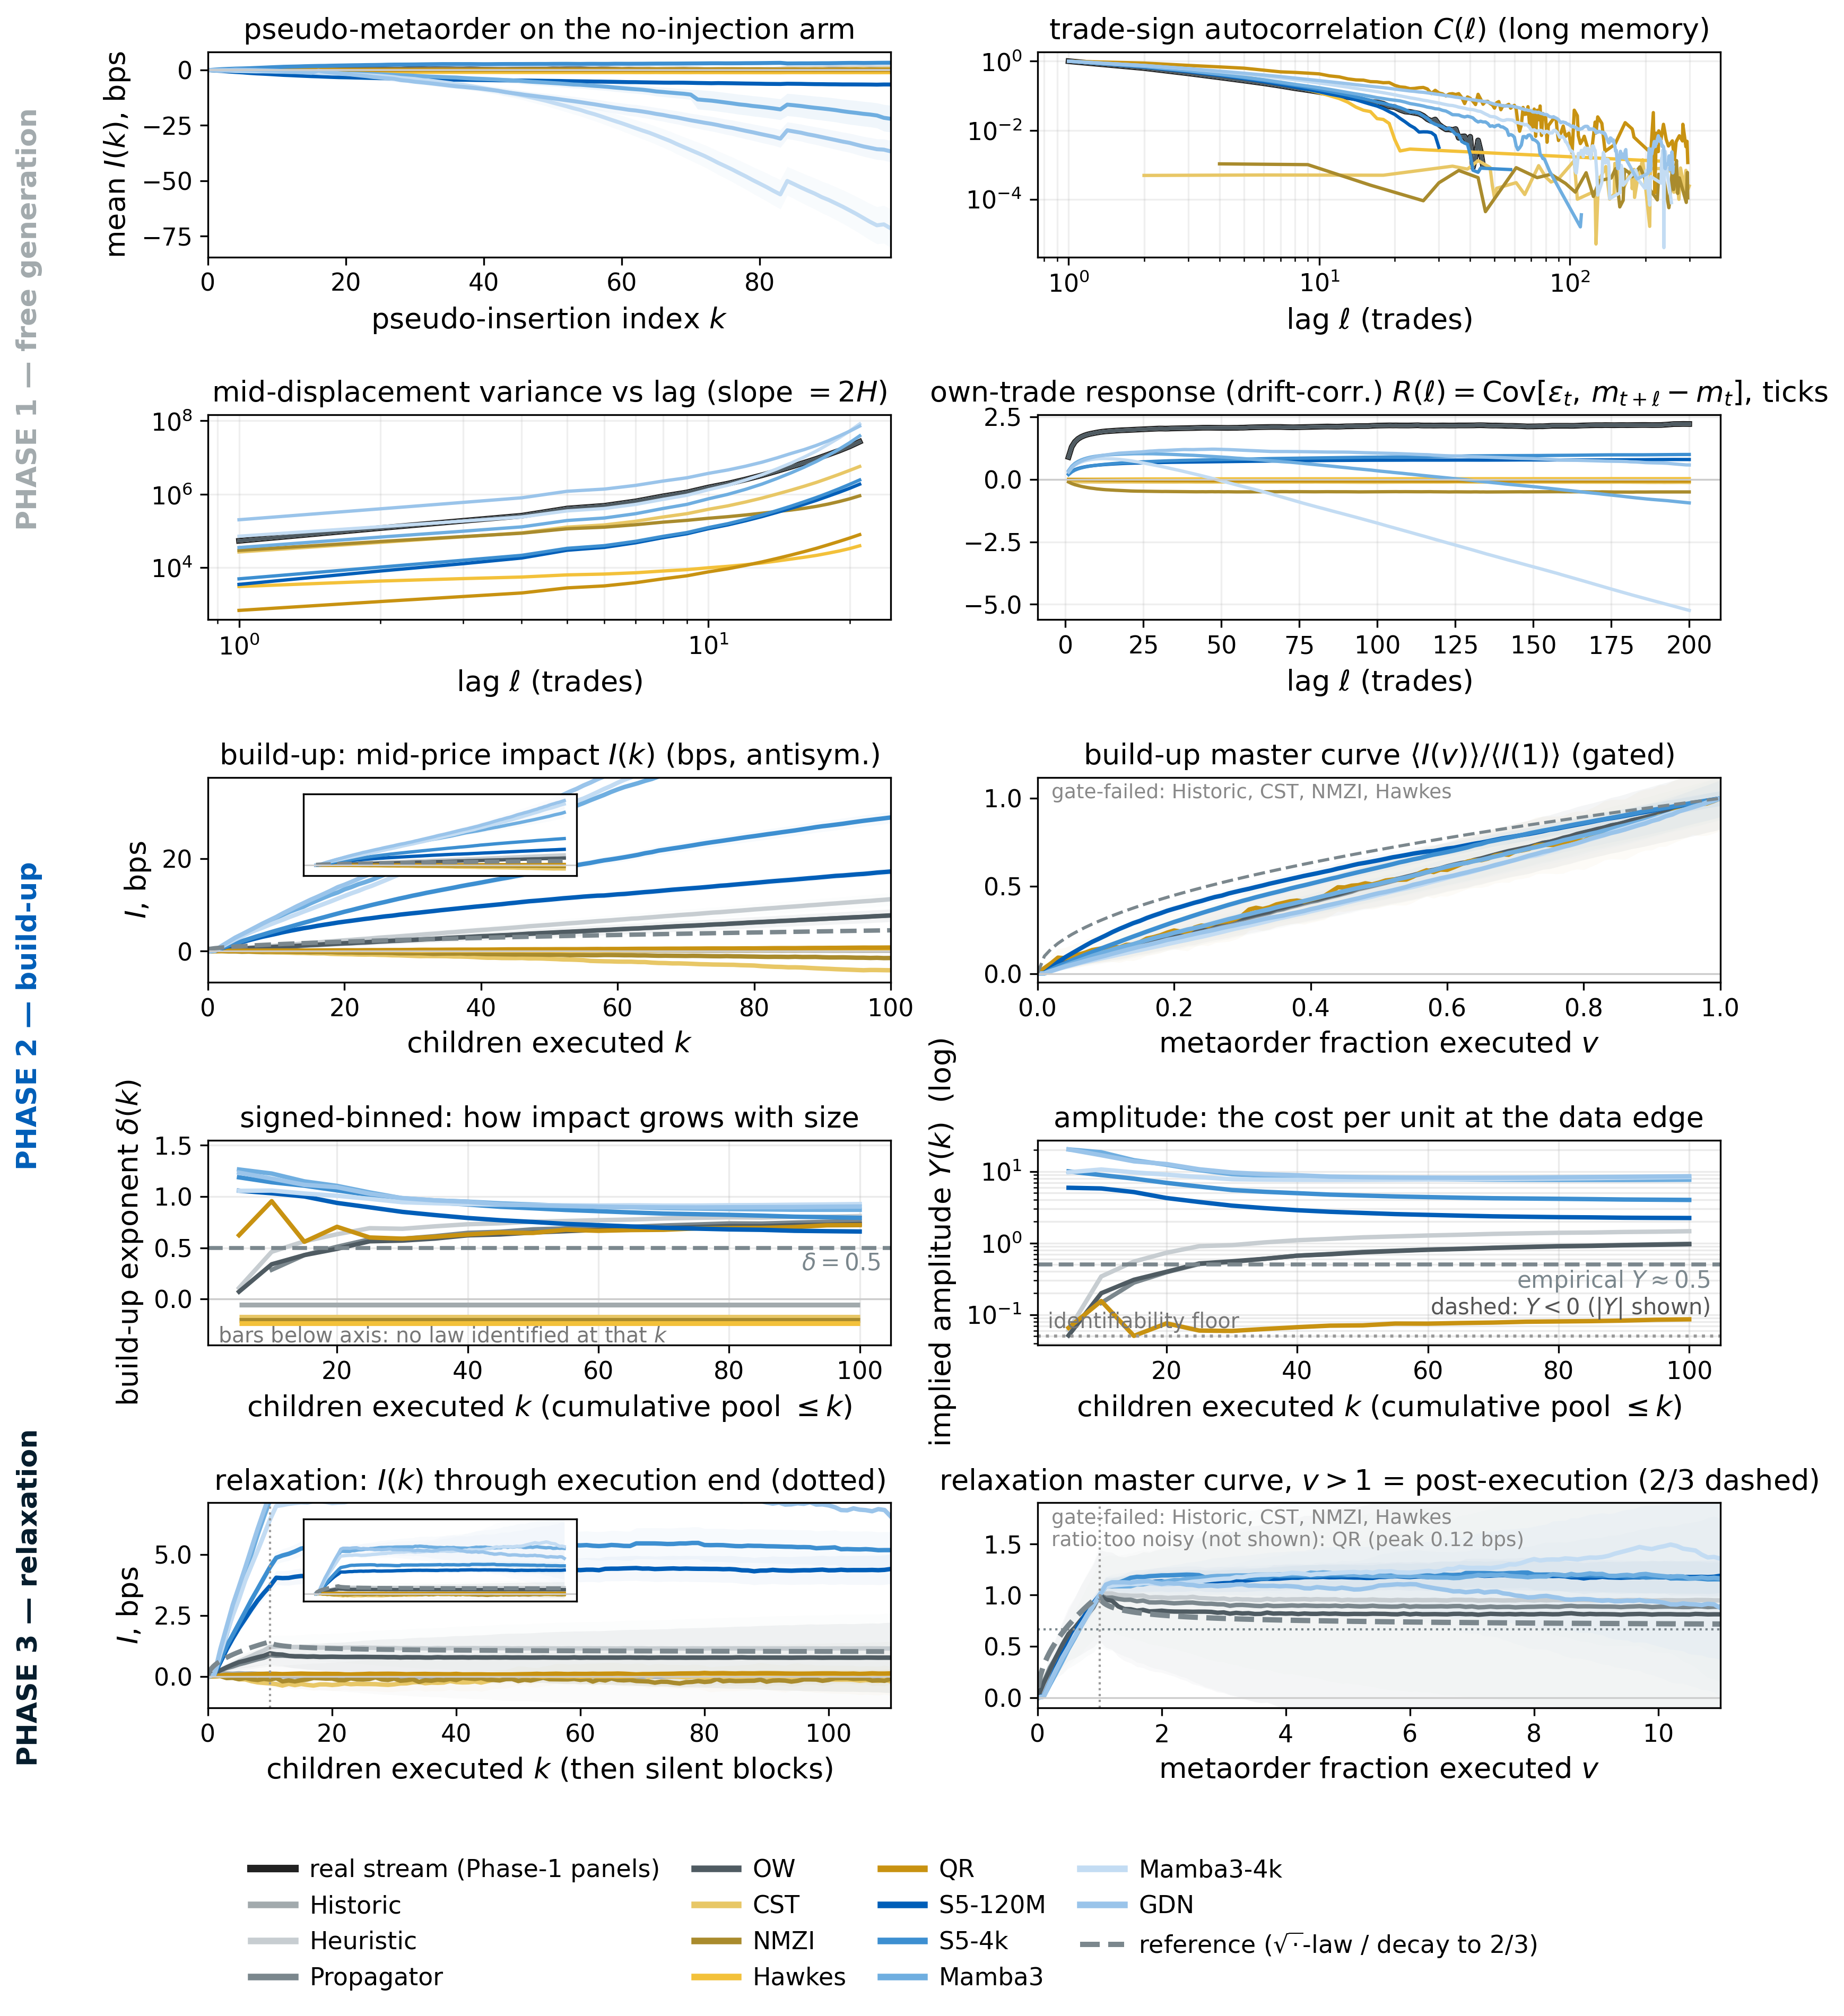
1단계 — 그냥 두고 지켜보기. 시뮬레이터를 아무것도 넣지 않고 굴립니다. 여기서 두 가지 균형을 봅니다. 하나는 주문 흐름의 '관성' — 방금 나온 매도 주문 다음에도 매도가 이어지는 경향(지속성)입니다. 다른 하나는 가격이 얼마나 흔들리는가(확산성)입니다. 실제 시장은 묘한 균형 상태입니다. 주문 방향은 강하게 이어지는데 가격은 마치 술래잡기하듯 무작위로 보일 만큼 확산적으로 움직입니다. 주문이 계속 밀어도 가격이 무한정 트렌드로 가지 않는 것은, 밀릴 때마다 시장이 흡수하고 되돌아오기 때문입니다. 지속성은 강한데 가격이 슈퍼확산적이면, 그 시장은 "공짜 점심"(수익 기회가 저절로 생기는 비현실)을 내장한 셈입니다.
2단계 — 큰 주문을 실제로 넣기. 실제 데이터로 조건을 맞춘 뒤, 시뮬레이터 흐름 속에 작은 아기 주문(child order) 100개를 일정한 간격으로 끼워 넣습니다. 이건 실제 기관 실행과 같은 모양입니다 — 실제 메타오더도 평균 96~100개의 아기 주문으로 이루어지니까요. 주문 간격은 "실행 시간 동안 시장 주문의 10%를 내가 먹는다"는 목표 참여율에 맞춰 종목별로 자동 계산합니다(AMD처럼 주문이 잦은 종목은 한 번의 메타오더에 약 4만 개의 메시지를 생성해야 해서 계산 비용이 7배까지 차이 납니다). 이렇게 만든 충격 곡선을 보고 두 가지를 읽습니다: 가격이 주문량의 몇 제곱으로 밀리는가(지수 δ), 그리고 얼마나 세게 밀리는가(진폭 Y).
여기서 연구진이 넣은 장치가 블라인드 대조 실험입니다. 같은 시간 창, 같은 난수 시드로 두 번 굴립니다. 한 번은 주문을 넣고 모델도 그 주문을 '보게' 하고(공개 실행), 한 번은 주문은 체결되지만 모델의 입력에는 철저히 숨깁니다(블라인드 실행). 숨긴 실행에서 생긴 충격은 오로지 '호가장에서 가격대를 소거한 기계적 효과'이고, 공개 실행이 여기를 얼마나 넘어서느냐가 바로 모델이 배운 시장 반응입니다.
3단계 — 실행을 멈추고 지켜보기. 짧은 주문을 넣고 갑자기 멈춘 뒤, 가격이 돌아오는지 봅니다. 실제 시장에서는 충격이 피크의 약 2/3까지 내려앉고, 시간이 더 흐르면 절반 가까이 되돌아옵니다. 이 '되돌아옴'(복원력)이 없으면 시장은 한 번 밀린 가격에 영원히 머무르게 됩니다.
측정 대상은 뉴럴 네트워크 생성기 5종(구조는 다르지만 모두 "다음 메시지 예측"만으로 학습)과, 비교용 기준 모델 8종이었고, NASDAQ 종목 5개(EA, NVDA, MSFT, AMD, GOOG)에서 진행해 뉴럴 모델-종목 조합 25개 전부를 검사했습니다. 평가용 데이터(2026년 1월)는 학습에서 뺀 달이라 "학습 데이터 외우기"도 막았습니다.
결과 — 무엇을 알아냈나
첫째, 놀라운 소식: 시장충격은 '저절로' 나옵니다. 아무도 가르치지 않았는데, 다음 토큰 예측만으로 학습한 인공지능 생성기 25개 전부가 주입된 메타오더에 뚜렷한 충격 법칙으로 반응했습니다. 반면 실제 과거 데이터를 그대로 틀어 주는 재생(replay) 기반 모델은 아무 반응도 하지 않았습니다. 즉 시뮬레이터가 진짜로 '내 주문에 대한 반응'을 만들어 내고 있다는 뜻입니다.
둘째, 나쁜 소식: 그 충격의 모양이 틀렸습니다. 실제 시장의 제곱근 지수는 0.5인데, 모델들이 학습한 지수는 전부 더 가팔랐습니다. 종목별로 0.631.21. AMD에서 개별 모델별로 보면 0.66(가장 현실에 가까운 모델)에서 0.93까지, 모두 0.5에서 통계적으로 뚜렷이 벗어났습니다(95% 신뢰구간이 0.5에 닿는 모델은 하나도 없음). 진폭도 실제 시장의 경험값(약 0.5)보다 훨씬 커서, 학습에 쓰인 종목에서는 29배, 처음 보는 종목(EA)에서는 12~50배까지 커졌습니다. 학습하지 않은 종목에서도 법칙 자체는 살아남지만 보정이 완전히 무너지는 셈입니다.
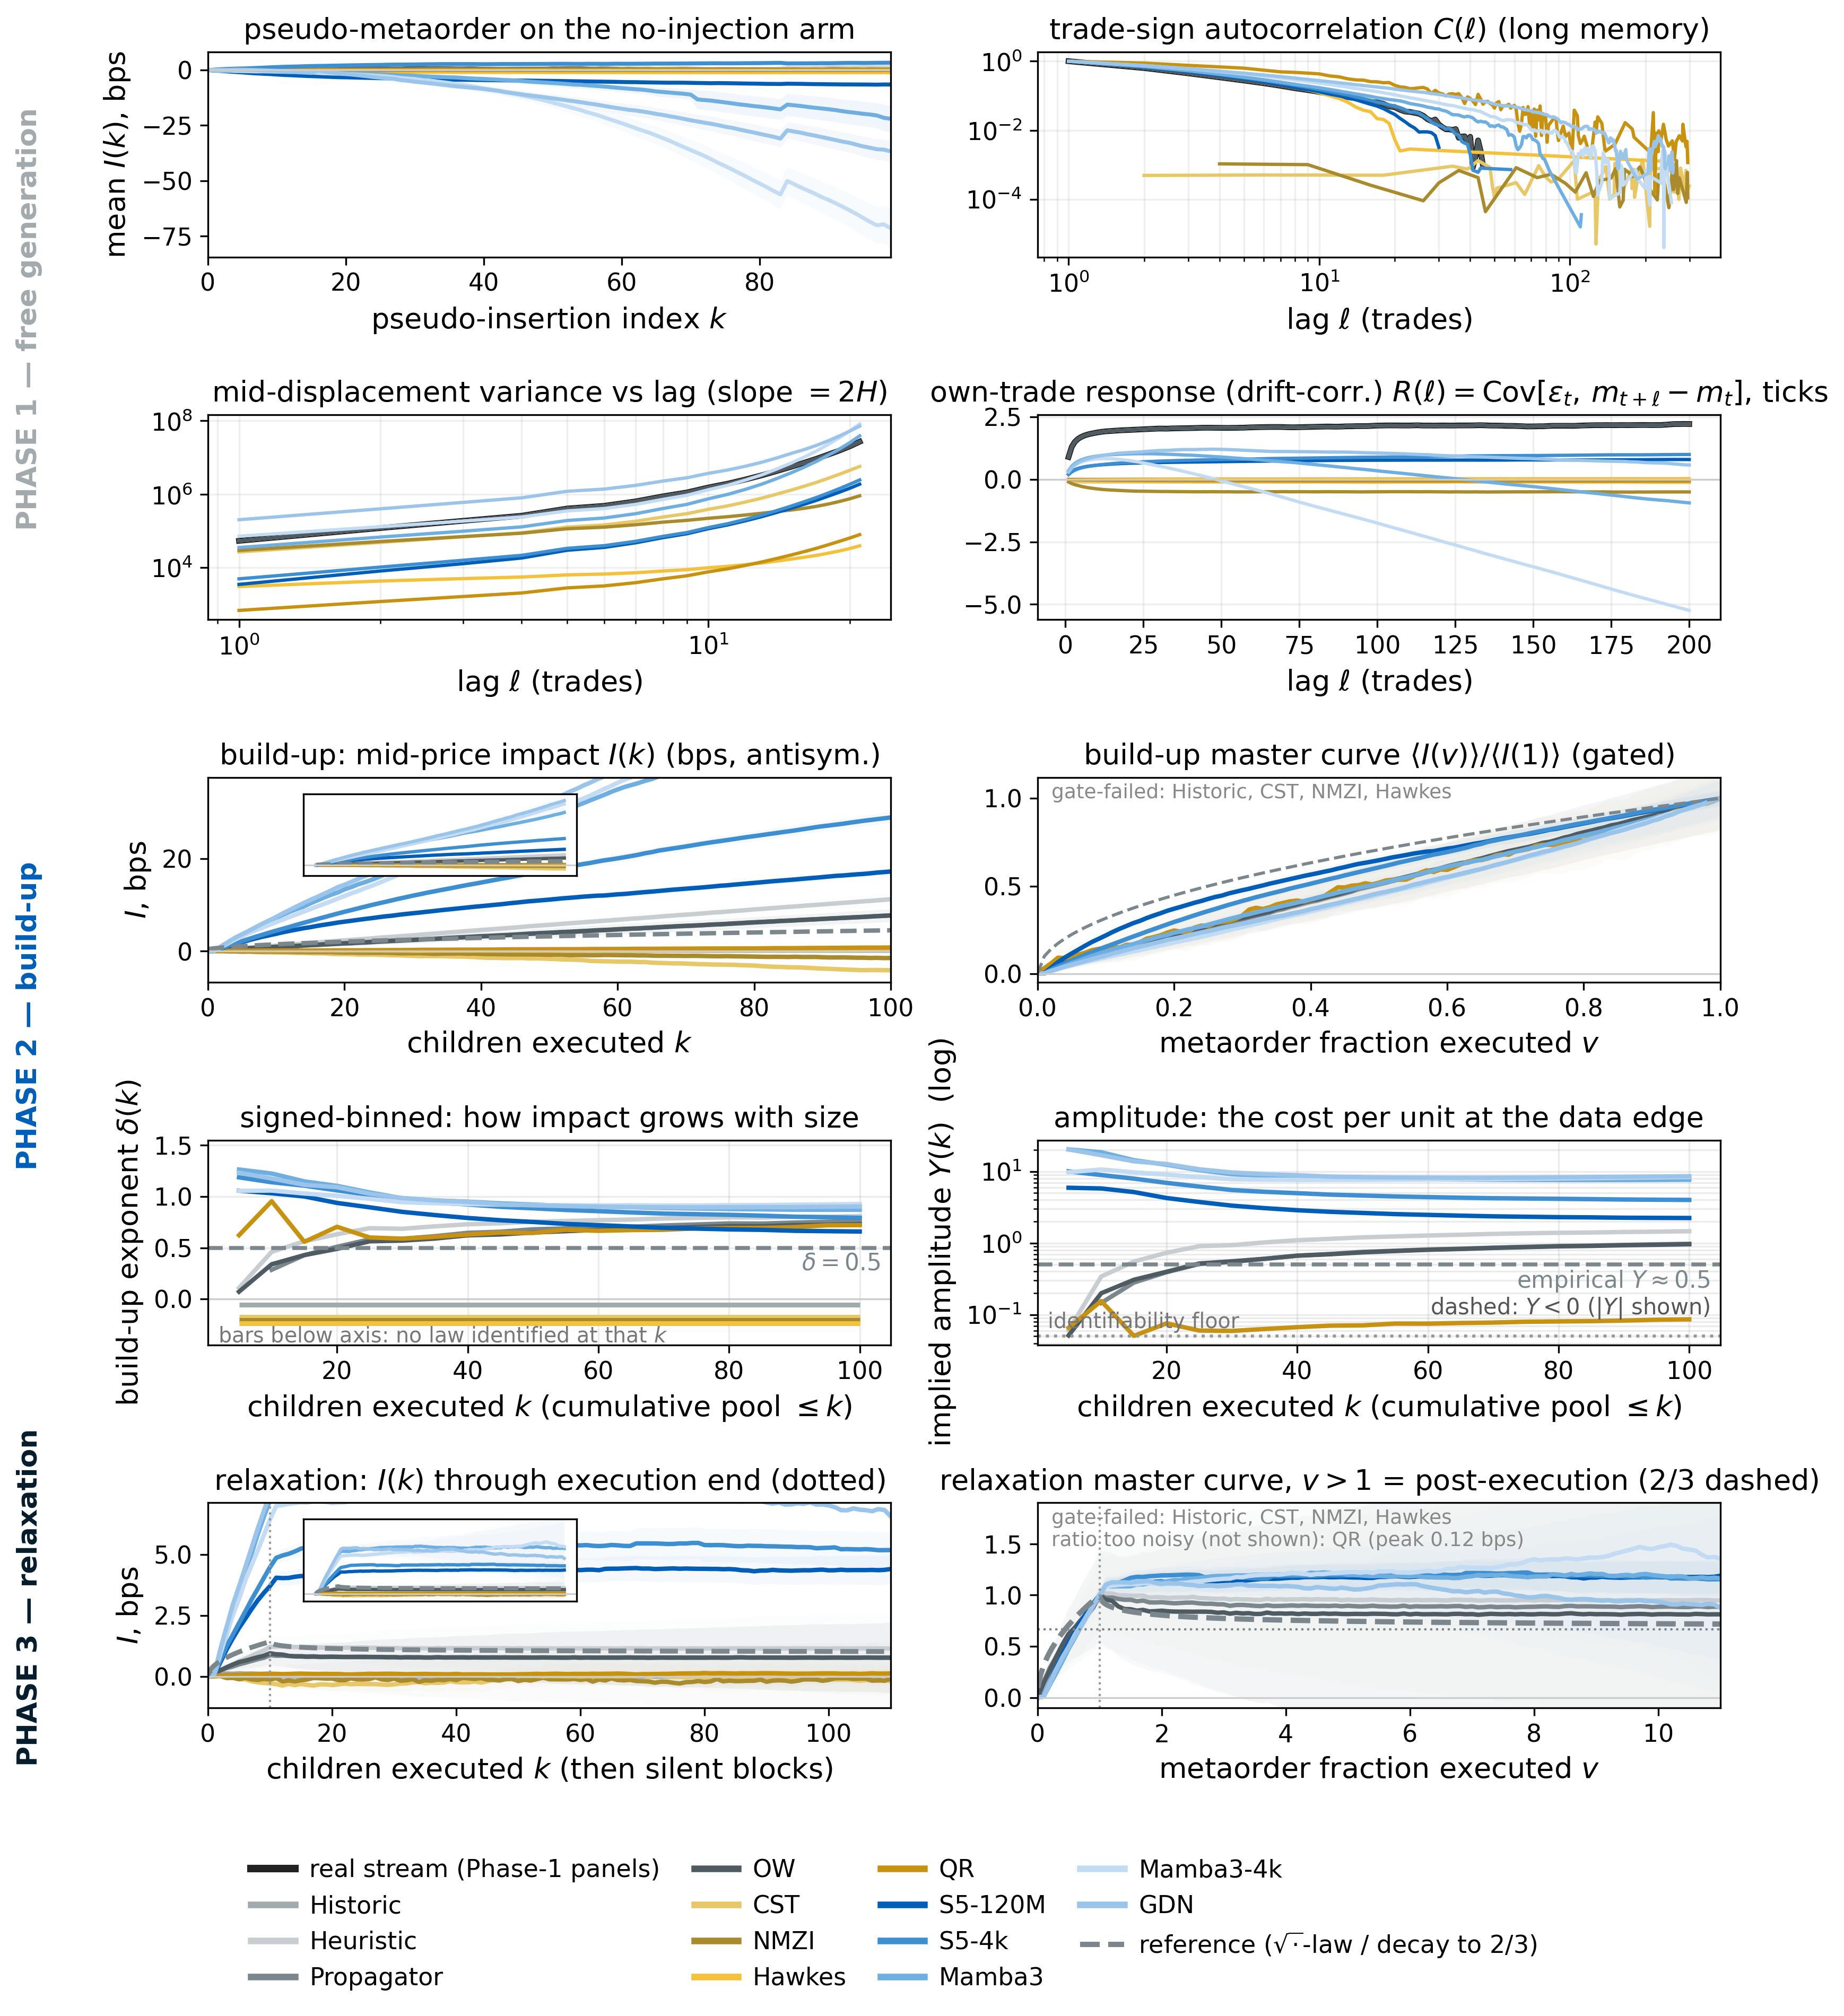
셋째, 충격이 돌아오지 않습니다. AMD에서 실행을 멈춘 뒤 가격을 피크 대비로 보면, 5개 모델이 각각 1.19, 1.15, 1.16, 1.36, 0.88배에서 끝납니다. 5개 중 4개는 주문이 끝났는데도 가격이 계속 같은 방향으로 더 움직입니다. 유일하게 피크 아래로 내려온 모델도 그건 복원력이 아니라 모델 자체가 가진 강한 하락 편향(드리프트) 때문으로 판명됐습니다. 실제 시장의 "2/3 되돌아오기"에 도달한 뉴럴 모델은 하나도 없습니다.
넷째, 그럴듯한 외모와 현실적인 반응은 별개입니다. 분포 지표(LOB-Bench)로는 구별하기 어려운 모델들이 충격 측정에서는 크게 달랐고, 오히려 분포를 더 잘 흉내 낸 모델이 충격 법칙에서 더 멀어지는 경우도 있었습니다. "예쁘게 그린 레이싱 게임"과 "정확한 차량 역학"이 별개인 것과 같습니다.
왜 이런 일이 생길까? 연구진의 해석은 '유동성 재보충(replenishment)의 부족'입니다. 실제 시장에서는 한 아기 주문이 가격을 밀어도 다음 주문이 오기 전에 그 밀림이 일부 흡수되면서, 100번의 밀림이 100배가 아니라 10배(제곱근) 수준으로만 쌓입니다. 그런데 모델들은 주문 흐름의 관성은 강하게 학습하면서 이 흡수·복원은 배우지 못했고, 결과적으로 충격이 가팔라지고 돌아오지 않는다는 것입니다. 근본 원인으로는 '긴 시간 기억'의 한계를 지목합니다 — 충격이 돌아오려면 "이 큰 주문이 시작되기 전의 가격"을 기억해야 하는데, 지금 모델들의 컨텍스트 창은 너무 짧다는 것입니다(학습 창은 500개 메시지, 측정에는 4만 개 메시지가 필요).
한계와 주의점
- 상세 보고는 AMD 한 종목이며, 나머지 4종목은 요약 표로만 제시됩니다. 측정 조건도 하나입니다 — 참여율 10%, 특정 아기 주문 크기, 공격적 주문, 한 거래소의 한 달(2026년 1월). 충격 지수는 이 조건에 의존하므로, 다른 시장·다른 실행 방식에서는 값이 달라질 수 있습니다.
- '긴 시간 기억 부족이 원인'이라는 설명은 저자들도 "잠정적(tentatively)"이라고 못 박았습니다. 확정된 인과 관계가 아니라, 다음 실험에서 검증할 가설입니다.
- 한 달 데이터 자체가 표본입니다. 평가 월이 평소보다 한 표준편차쯤 비정상적이면 지수 추정이 흔들릴 수 있다는 점을 저자들이 명시합니다.
- 좋은 소식은 재현성입니다. 프로토콜·캘리브레이션·추정기·보고 규칙 전체가 오픈소스로 공개되어 있고(논문에 저장소 주소 명시), 사용자는 평가할 모델과 LOBSTER 형식의 한 달 데이터만 준비하면 같은 검사를 돌릴 수 있습니다.
그래서 투자/실무엔?
이 논문은 "AI 시뮬레이터가 틀렸다"고 선고하는 데서 멈추지 않고, 틀린 곳을 정량으로 찾아내는 검사 절차를 남겼다는 점에서 실무 가치가 큽니다.
- 시뮬레이터에서 전략을 학습하거나 백테스트할 때: 만들어 낸 데이터가 실제와 비슷해 보인다는 보장은, "내 주문이 시장을 어떻게 움직이는지"가 현실적이라는 보장과 다릅니다. 충격이 과대평가되고 돌아오지 않는 시뮬레이터에서는, 실제 시장이라면 벌을 받을 매매 스케줄에 보상이 돌아갈 수 있습니다. 자체 시뮬레이터를 쓴다면 분포 지표만 보지 말고, 이 논문의 메타오더 주입 실험(특히 블라인드 대조)을 검증 절차로 도입하는 것이 좋습니다.
- 실행 비용 모델링: 최적 실행 알고리즘은 충격 곡선의 모양·크기·복원 속도를 입력으로 받습니다. 이 셋 중 하나라도 틀리면 전체 스케줄이 틀립니다. 논문은 이 셋을 모델·종목별로 정량 측정하는 틀을 제공합니다.
- 모델 개발자라면: 개선 방향도 구체적입니다. 주문 흐름의 관성을 꺾는 것이 아니라(그렇게 하면 균형이 편법으로 복원됩니다), 유동성 재보충을 배우도록 — 그리고 체크포인트마다 1단계 지표(흐름 지속성·확산성)로 진단하라는 것입니다.
요약하면, "가짜 시장"의 품질 기준이 '얼마나 닮았는가'에서 '얼마나 올바르게 반응하는가'로 바뀌어야 한다는 제안입니다. 레이싱 게임의 그래픽이 아니라 타이어 마찰력을 검사해야 하는 이유입니다.
더 알아보기
- 원문: LOB-Impact Benchmark: Emergent Market Impact in Generative Limit Order Book Models (arXiv:2610.27100) — 옥스퍼드 대학(컴퓨터과학과) 주도, UKRI·EPSRC 지원, 평가 패키지 오픈소스 공개.
- OHSE AI Lab KB 5차원 점수 (composite 80.9, S등급): 새로움 78 · 적용성 76 · 엄밀성 84 · 재현성 86 · 통찰 82 — 재현성 86은 공개 프로토콜·코드에 따른 높은 점수입니다.
- 관련 논문 (KB 공유 엔티티 기준):
- JAX-LOB: A GPU-Accelerated Limit Order Book Simulator (arXiv:2308.13289) — 이 벤치마크가 주문장 재구성·체결에 사용한 엔진.
- Can Large Language Models Trade? Testing Financial Theories with LLM Agents (arXiv:2504.10789) — 에이전트 관점의 보완 연구.
- Interpretable ML for High-Frequency Execution (arXiv:2307.04863) — 실행 전략 측면의 관련 연구.
관련 글
 강화학습 포트폴리오
가상 시장을 만들어 연습시킨 AI 포트폴리오 매니저 — vine copula 시뮬레이션과 강화학습이 거래비용을 41.5% 줄인 비결
투자는 미래가 한 번뿐이라 연습할 수 없다. 이 논문은 자산 간 관계를 배워 가상 시장을 찍어내고, 그 가상 세계에서 강화학습 매니저를 훈련시켜 22개월 실전에서 연 34.13%, 샤프 2.31을 기록했다. 시뮬레이션 연습이 거래비용을 41.5% 줄인 과정과, '모형을 믿어도 되는가'를 수학적으로 따진 점을 쉽게 정리한다.
 알고리즘 트레이딩S
강화학습 주문집행이 실전에서 실패하는 이유: 2023년 일반화 거래집행 RL
백테스트에서는 완벽했던 강화학습 주문집행 알고리즘이 실전에서 무너지는 이유를 이론과 실험으로 규명한 2023년 연구를 쉽게 풀어 설명합니다. 과적합의 구조적 원인, 컨텍스트 압축 해법, 그리고 실전 적용 시사점을 다룹니다.
 포트폴리오 최적화A
TimeGAN 합성 시나리오 포트폴리오: 가짜 데이터 투자는 어디까지 통할까?
인공지능이 만든 가짜 주식 시나리오로 ETF 포트폴리오를 짜면 실제 수익이 나을까? 12개 ETF로 TimeGAN 시나리오를 대체·보충 투입해 거래비용까지 반영한 실험을 쉽게 풀어 설명하고, 합성 데이터 투자 도입 전 점검할 항목을 정리합니다.