
Data-Driven Dynamic Portfolio Selection with Vine Copula Simulation and Reinforcement Learning
Gabriël M. J. Gelissen, Fengyi Yuan
게임 시뮬레이터로 백 번 연습한 뒤 실제 경기에 나가는 프로게이머처럼, 이 연구는 '가상 시장'을 만들어 AI 포트폴리오 매니저를 훈련시켰다. 결과는 22개월 실전 평가에서 연 34.13% 성장률, 샤프 비율 2.31, 그리고 거래비용 41.5% 절감이었다.
들어가며
운전면허 학원을 생각해 보세요. 도로 주행 연습을 처음부터 실제 차량과 실제 교차로에서만 한다면 어떨까요? 사고가 날 수 있고, 연습할 기회도 적습니다. 그래서 우리는 시뮬레이터에서 반복 연습을 하고, 어느 정도 익숙해진 뒤에 실제 도로로 나갑니다.
투자에는 이런 시뮬레이터가 없습니다. 시장의 미래는 딱 한 번 일어나고, 그 한 번의 결과로 전략의 좋고 나쁨을 판단해야 합니다. 게다가 시장에는 '다른 차들' — 서로 영향을 주고받는 여러 자산들이 있습니다. 주식이 빠질 때 채권이나 금은 어떻게 움직일까? 이 관계는 평소엔 느슨하다가 위기가 오면 갑자기 강해지기도 합니다.
2026년 10월 공개된 이 논문(Data-Driven Dynamic Portfolio Selection with Vine Copula Simulation and Reinforcement Learning)은 바로 이 문제를 두 가지를 함께 해서 풀려고 했습니다. 첫째, 자산 간 관계를 배워 '가상 시장'을 대량으로 찍어내는 것. 둘째, 그 가상 세계에서 AI 포트폴리오 매니저를 훈련시키는 것. 그리고 하나 더 — 가상 시장이 실제와 다르면 결과가 얼마나 달라지는지를 수학적으로 계산해 두기까지 했습니다.
무엇이 문제였나
기존 접근법에는 세 가지 아픈 지점이 있었습니다.
1. 자산 간 관계는 변하는데, 많은 모형은 '고정 관계'를 씁니다. 전통적인 포트폴리오 이론은 자산들이 평소처럼 움직인다고 가정합니다. 하지만 2020년 3월처럼 모든 자산이 동시에 추락하는 날에는 평소의 관계가 통하지 않습니다. 표를 보면 알 수 있습니다: 이 논문이 사용한 7개 자산(미국 주식 지수 3개, 중국 ETF 3개, 금 ETF 1개)의 일간 수익률은 모두 왼쪽으로 심하게 치우친 분포(음의 왜도)와 두꺼운 꼬리(초과 첨도 8.8~22.1)를 보입니다. 평균과 상관만으로는 설명되지 않는, 드물지만 큰 움직임이 자주 일어나는 데이터라는 뜻입니다.
2. 강화학습 매니저는 연습 데이터가 적으면 '과거 암기'로 빠집니다. AI에게 10년치 데이터만 주고 포트폴리오를 배우게 하면, 그 AI는 그 10년에만 최적화된 매매를 합니다. 문제는 잦은 매매입니다. 매번 사고팔 때마다 비용이 나가는데, 학습 데이터가 적으면 시장의 소음까지 반응해 매매가 늘어납니다.
3. "이 모형을 믿어도 되는가?"에 대한 보증이 없습니다. 어떤 모형이든 과거 데이터에는 어느 정도 맞습니다. 진짜 질문은 "모형이 조금 틀렸을 때 내 돈이 얼마나 위험해지는가"인데, 이에 대한 답을 주는 모형은 드뭅니다.
핵심 아이디어 — 가상 시장을 찍어내고, 그 안에서 매니저를 훈련하기
1단계: 자산 간 관계를 '부품'으로 분해해 배우기 (vine copula)
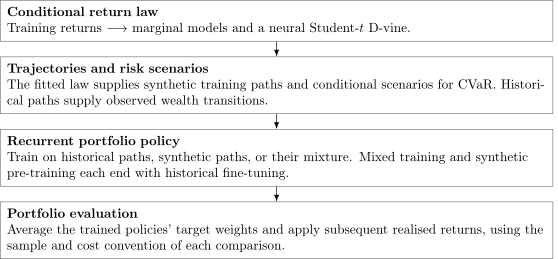
copula라는 도구는 "각 자산이 어떻게 움직이는가"와 "자산들이 어떻게 함께 움직이는가"를 따로 분리해서 표현합니다. vine copula는 여기서 한 발 더 나아가, 7개 자산의 복잡한 관계를 2개씩 짝지은 관계(쌍(pair) 단위)의 사슬로 쪼갭니다. 쉽게 말하면 프랑스 요리사가 복잡한 소스를 만들 때 각 재료의 궁합을 두 개씩 레시피로 정리해 두는 것과 같습니다. 나중에 어떤 재료 조합이든 이 부품들을 조립해 원래의 맛(자산 간 관계)을 재현할 수 있습니다.
특히 이 논문은 조건부 vine 모형을 써서, "어제 시장이 이렇게 움직였다면"이라는 조건 아래 다음 달 관계가 달라지도록 했습니다. 고정 상관 행렬의 한계를 그대로 극복한 부분입니다.
2단계: 가상 시장 대량 생산
추정된 vine 모형은 두 가지를 찍어 냅니다. 하나는 리스크 측정용 결합 시나리오(CVaR — "평소엔 괜찮지만 최악의 5% 날에는 얼마나 잃는가"를 재는 지표 — 계산용), 다른 하나는 강화학습용 가상 가격 경로입니다. 요리로 치면 "실제 손님에게 내놓을 요리"와 "연습용으로 대량 생산한 요리"를 같은 레시피로 만드는 셈입니다.
3단계: 가상 세계에서 훈련하는 순환 강화학습 매니저
매니저(AI)는 LSTM 기반의 순환 신경망입니다. 과거 30일의 가격 흐름을 기억한 채, 다음 달 자산 비중을 결정합니다. 학습 알고리즘은 TD3라는 최신 강화학습 방법이고, 10개의 매니저를 각각 독립적으로 훈련한 뒤 평균을 내서 앙상블로 운용합니다. 투자자는 위험 회피 성향(CRRA 계수 2)을 가정하고, 수익을 극대화하되 한 달 손실의 CVaR에 페널티(수준 0.95, 가중치 0.05)를 부과합니다. 거래비용 0.1%, 자산별 포지션 한도 −20%~+60% 같은 현실적인 제약도 들어 있습니다.
4단계: "믿어도 되는가"에 대한 수학적 보증
이 논문의 진짜 차별점은 여기입니다. vine 모형의 부품(쌍 copula) 매개변수가 조금 틀렸다면, 최종 포트폴리오 성과는 얼마나 달라질까요? 연구진은 이 오차가 전파되는 경로를 추적해, 오차 에 대해 약 차수로만 결과가 흔들린다는 안정성 경계를 증명했습니다. 더 실용적인 부분은, "모형을 믿고 선택한 전략이 진짜 시장에서 잃을 금액"의 상계를 다섯 가지 오차로 분리한 것입니다 — 주변 분포 오차(자산 하나하나의 모형 오류), 구조 오차(자산 간 관계의 모형 오류), 매개변수 추정 오차, 시뮬레이션 오차, 수치 최적화 오차. 어느 쪽이 병목인지 알면 개선 우선순위가 보입니다.
결과 — 가상 연습이 실전에서 통했나
데이터는 미국 주식 지수 3개(S&P 500, 나스닥, 다우), 중국 ETF 3개(SSE50, 배당, ChiNext), 금 ETF 1개의 2013년 12월 ~ 2026년 7월, 2,946일치 종가입니다. 평가는 마지막 24개월(2024년 7월 ~ 2026년 6월)을 학습에서 아예 빼 두고, 이 완전히 새로운 구간에서 월간 리밸런싱 22회로 진행했습니다.
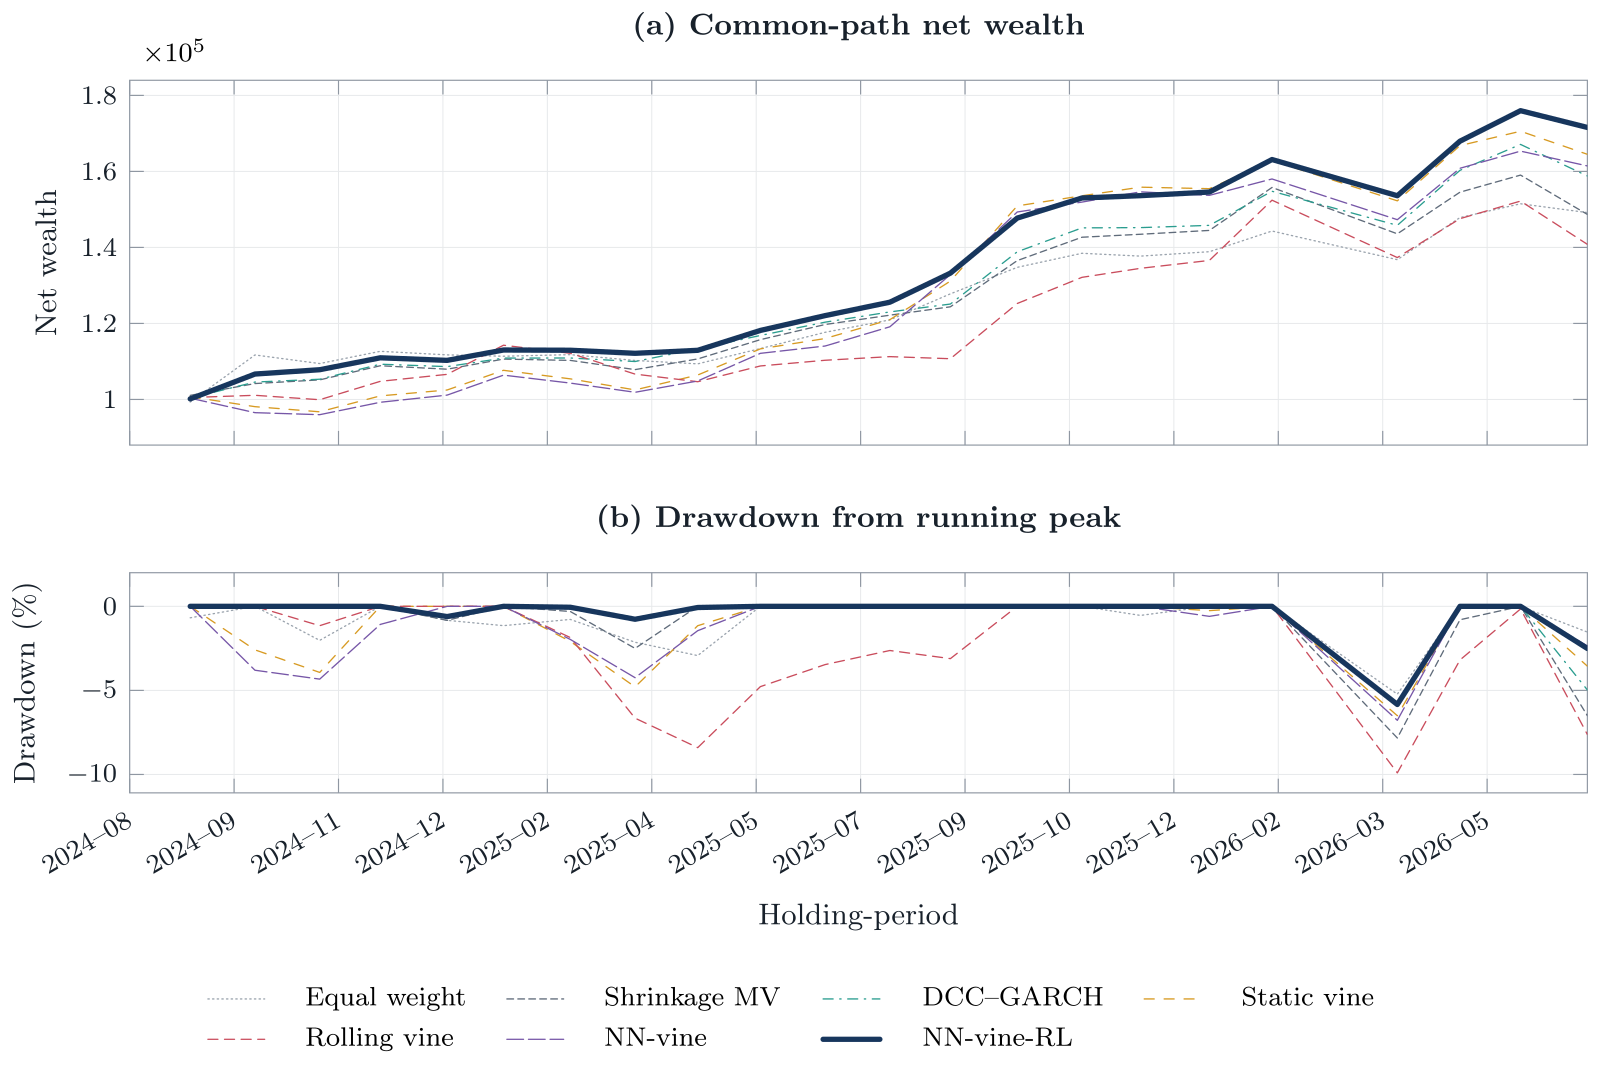
같은 기간, 같은 거래비용 규칙으로 6개 벤치마크와 겨룬 결과입니다.
| 전략 | 누적 수익 | 연 성장률(CAGR) | 샤프 비율 | 최대 낙폭 | 월 회전율 |
|---|---|---|---|---|---|
| 등가중(그냥 나눠 담기) | 49.16% | 24.37% | 1.70 | 5.22% | 0.00 |
| 축소 평균분산 | 48.69% | 24.16% | 1.61 | 7.83% | 0.05 |
| DCC-GARCH | 58.79% | 28.69% | 1.94 | 5.79% | 0.15 |
| 정적 vine | 64.50% | 31.19% | 1.70 | 6.51% | 1.05 |
| 롤링 vine | 40.81% | 20.52% | 1.08 | 9.90% | 1.24 |
| NN-vine(강화학습 없이) | 61.44% | 29.86% | 1.68 | 6.78% | 1.09 |
| NN-vine-RL(이 논문) | 71.57% | 34.13% | 2.31 | 5.84% | 0.35 |
세 가지가 눈에 띕니다.
첫째, 성장률 1위이면서 변동성은 낮았습니다. 연 성장률 34.13%에 연 변동성 13.22%로, 적극적으로 최적화한 모든 벤치마크보다 변동성이 낮았고 "그냥 나눠 담기"(13.42%)와 비슷했습니다. 샤프 비율(수익을 변동성으로 나눈 효율 지표) 2.31은 2위인 DCC-GARCH(1.94)를 확실히 앞섭니다.
둘째, 매매를 확 줄였습니다. 월 회전율 0.35 — 목표 비중이 한 달에 0.35배씩 바뀌었다는 뜻입니다. 매매가 잦은 벤치마크들이 1.05~1.24인 것과 비교하면 3분의 1 수준입니다. 여기서 재미있는 발견이 나옵니다.
셋째, 거래비용 절감의 비결은 '가상 연습'이었습니다. 연구진이 학습 방식만 바꿔 비교했는데 — (1) 과거 데이터만으로 학습, (2) 가상 경로 + 과거 데이터 혼합 학습 — 혼합 학습이 CAGR 33.05% → 34.13%로 오히려 조금 높아지면서 회전율은 0.600 → 0.351로 41.5% 감소했습니다. 시뮬레이터 연습이 "시장의 소음에 덜 반응하는 매니저"를 만든 셈입니다. 다만 주의할 점: 가상 데이터만으로 학습하면 성과가 크게 무너졌습니다(확실등가 지표 23.55%로 떨어짐). 가상 데이터는 실제 데이터를 대체하는 것이 아니라 보조 연습재일 때만 효과가 있었습니다.
단, 정직하게 말하면 최대 낙폭은 등가중 전략이 5.22%로 가장 양호했고(이 논문 전략은 5.84%), 과거 데이터 단독 학습이 변동성·샤프에서 약간 더 나았습니다. "모든 지표의 압승"이 아니라 "성장과 비용에서의 우위"라는 점을 구분해서 봐야 합니다.
한계와 주의점
- 평가 기간이 22개월뿐입니다. 월간 결정 22회라는 표본은 운이 좋은 진입 시점의 결과일 수 있습니다. 완전한 표본 외 검증이긴 하나, 시장 전체가 상승하던 국면이 포함되어 있어 약세장에서의 견고함은 이 데이터만으로 판단할 수 없습니다.
- 자산이 7개뿐이고 통화 문제가 있습니다. 미국 지수 3개 + 중국 ETF 3개 + 금 ETF라는 좁은 유니버스이고, 배당·환율·헤지를 반영하지 않은 현지 통화 수익률입니다. 미·중 시장 마감 시각이 달라 비동기 문제도 남아 있습니다.
- 수학적 보증에는 가정이 붙습니다. 안정성 경계는 "모든 국소에서 미분이 일정하게 억제된다"는 균일 상계 가정 위에 서 있고, 연구진 자신이 더 날카로운 경계와 가정 검증을 후속 과제로 남겼습니다. 정책 학습 알고리즘 자체의 오차는 아직 정량화되지 않았습니다.
- 재현성 점수는 KB 기준으로 낮게 잡혀 있습니다(10점). 다만 이는 초록 중심 자동 평가의 결과이고, 전문을 확인해 보니 R + PyTorch 구성과 학습 하이퍼파라미터가 부록에 전면 공개되어 있어 실제 재현 난이도는 점수보다 낮을 것으로 보입니다. 반대로 이론적 엄밀성 점수(25점)는 "증명이 부실하다"기보다 "이론 결과의 검증 사례가 아직 적다"에 가깝게 읽어야 합니다.
그래서 투자/실무엔?
- "합성 데이터 = 비용 절감 장치"라는 관점이 유용합니다. 합성 학습 데이터는 보통 "데이터가 적을 때 쓰는 대용품"으로 여겨지지만, 이 연구는 다른 각도를 줍니다 — 시뮬레이션 경로에서 연습한 매니저가 더 차분하게 매매해 거래비용이 41.5% 줄었습니다. 전략 개발 시 합성 데이터의 가치를 "정확도"가 아니라 "매매 안정성"으로도 평가해 볼 만합니다.
- 단, 혼합 비율이 생명입니다. 가상 데이터만 쓰면 성과가 무너지는 것이 확인되었으므로, 실무에서는 합성:실제 비율을 튜닝하는 실험이 필수입니다.
- 리스크 문서의 표준이 될 수 있는 프레임. "모형이 틀리면 얼마나 잃는가"를 다섯 가지 오차로 분해해 상계를 제시하는 방식은, 전략 제안서나 리스크 관리 문서의 양식으로 그대로 이식할 수 있습니다. 단일 성과 수치보다 이 분해가 이 논문의 가장 큰 기여입니다.
- 앙상블이 실전 트릭으로 확인됨. 10개 정책의 평균으로 노이즈를 줄이는 단순한 방법이 현실적인 포지션 한도와 거래비용 아래에서 잘 작동했습니다. 강화학습 전략의 시드 불안정성이 고민이라면 검토할 만한 수단입니다.
더 알아보기
- 원문: Data-Driven Dynamic Portfolio Selection with Vine Copula Simulation and Reinforcement Learning (arXiv:2610.20037)
- 5차원 점수(KB 기준, 참고): 참신성 62 · 적용성 68 · 엄밀성 25 · 재현성 10 · 통찰 48 — composite 47.4, C등급. 적용성은 높게(실전 지향 파이프라인), 이론적 엄밀성·재현성은 낮게 잡힌 전형적인 "실전형 초안" 점수입니다. 본문에서 언급했듯 전문 기준으로는 재현 자료가 상당히 공개되어 있어, 점수와 실제 사이의 간극을 염두에 두세요.
- 함께 보면 좋은 오늘의 논문: Regime Detection in Latent Factor Models (arXiv:2610.20366) — "추정된 국면"이 아니라 "지금 행동할 때인가"를 베이지안 최적 정지 문제로 다룬 연구로, 오늘 논문의 '추정에서 행동까지' 흐름과 짝이 됩니다.
(이 글은 OHSE AI Lab의 일일 논문 리포트(2026-10-16 수집분)를 바탕으로 작성한 초안입니다. 발행 전 전문가 윤문이 추가될 예정입니다.)
관련 글
 포트폴리오 최적화A
CVaR를 이긴 엑스펙타일 포트폴리오: Wasserstein 강건 최적화로 따져보니
리스크 측도를 CVaR에서 엑스펙타일(expectile)로 바꾸고 분포 불확실성까지 반영한 포트폴리오 최적화가 FTSE 13년 실증에서 9개 조합 전부 이겼다. 엑스펙타일의 백테스트 가능성, 지름자 선택, 퇴화 임계값까지 쉽게 풀어 설명한다.
 포트폴리오 최적화A
포트폴리오 최적화, 어렵게 풀 필요 없이 LASSO 한 번으로 — 효율적 프런티어의 놀라운 등가성
머신러닝에서 흔히 쓰는 변수 선택 도구 LASSO가 마코위츠의 효율적 프런티어를 그대로 그려 준다는 연구를 쉽게 풀어 설명합니다. 포트폴리오 최적화 계산이 왜 수십 배 빨라지는지, 그리고 주의할 한계까지 정리합니다.
 포트폴리오 최적화A
KellyBoost: 머신러닝으로 최적 포트폴리오를 직접 만드는 새로운 방법
그래디언트 부스팅 트리로 켈리 기준 성장 최적 포트폴리오를 직접 학습하는 KellyBoost 방법론을 소개합니다. 예측과 최적화를 분리하는 기존 방식의 한계를 넘어, 목표 함수를 직접 최적화하는 엔드투엔드 접근법의 가능성과 한계를 살펴봅니다.