Mimicking Volatilities under Marginal Constraints via $q_x$-Bass Martingales: A Parallel Computing Approach
Antonio Marini
오늘은 옵션 시장의 오래된 고민 하나를 수학으로 정면 돌파한 이론 논문을 가져왔습니다. "시장에서 보이는 옵션 가격과 어긋나지 않으면서, 우리가 믿는 변동성 패턴도 최대한 지키는 모형을 어떻게 만들 수 있을까?" 이 질문에 대한 대답이 마팅게일 최적수송(martingale optimal transport)이라는 최근 수학 도구로 깔끔하게 정리된 이야기입니다.
수식은 최대한 빼고, 비유와 직관으로 따라가 보겠습니다.
들어가며 — 시장의 가격과 나의 모형, 둘 다 믿고 싶을 때
옵션을 매매해 본 사람이라면 한 번쯤 이런 경험을 합니다. 내가 만든 변동성 모형으로 옵션 가격을 계산해 보니, 시장에서 실제 체결되는 가격과 살짝 어긋납니다. 그럼 어떻게 할까요?
- 시세를 믿는 쪽: 시장 가격에 딱 맞도록 모형을 억지로 끼워 맞춥니다(이게 흔한 '캘리브레이션'). 그런데 이러면 모형의 변동성 패턴이 시장 가격에 이리저리 끌려다니며, 때로는 말이 안 되는 모습으로 망가지기도 합니다.
- 모형을 믿는 쪽: 내가 설정한 변동성 모형(Heston 같은 확률변동성 모형 등)을 지키려 하면 이번에는 시장 가격과 어긋나서, 실제 거래에서 손해를 볼 수 있습니다.
마치 지도에는 없는 길로 가야 하는데, 내비게이션(모형)과 실제 도로(시장) 중 무엇을 믿을지 정하기 애매한 상황과 같습니다. 이 논문은 둘 사이에서 "양쪽 모두에서 최대한 벗어나지 않는 경로"를 찾는 문제를, 아주 엄밀한 수학 언어로 정의하고 풀이 방법까지 제시합니다.
무엇이 문제였나 — 기존 캘리브레이션의 두 가지 약점
전통적인 캘리브레이션은 대개 이런 방식입니다. 모형에 몇 개의 숫자(파라미터)를 넣고, 이 숫자들을 조절해 시장 옵션 가격과의 오차를 최소화합니다. 잘 쓰이는 방법이지만 두 가지 약점이 있습니다.
- 모양이 미리 정해져 있다. 예를 들어 Heston 모형을 골랐으면 가격의 움직임은 어디까지나 Heston 식구들의 모습만 할 수 있습니다. 시장이 그 틀 밖에서 움직이면 억지로 끼워 맞추느라 왜곡이 생깁니다.
- '변동성의 성격'이 희생된다. 가격에만 맞추다 보면 모형의 변동성(가격이 흔들리는 정도)이 현실과 전혀 다르게 나올 수 있습니다. 예를 들어 평소엔 잠잠했다가 충격이 오면 폭발하는 '변동성의 군집성' 같은 특징이 사라질 수 있죠.
반면 최적수송(optimal transport) 계열의 접근은 이렇게 묻습니다. "시장 가격과 맞는 모형은 수없이 많습니다. 그중에서 내가 원하는 기준(reference) 모형의 변동성 성격과 가장 덜 멀리 떨어진 모형은 무엇일까요?" 즉, 미리 정한 모양에 끼워 맞추는 대신, '기준 모형과의 거리'를 최소화하는 모형을 통째로 찾아내는 방식입니다.
여기서 쓰이는 거리 개념이 마팅게일 최적수송입니다. 쉽게 말하면, "가격이 오르내릴 수는 있지만(마팅게일 조건 — 공정한 도박의 규칙) 그 움직임의 패턴이 기준 모형과 최대한 비슷하도록" 조건부 확률을 배분하는 문제입니다.
핵심 아이디어 — 세 단계로 따라가 보기
논문이 한 일을 세 단계로 정리하면 이렇습니다.
1단계. '변동성과의 거리'를 비용 함수로 정의하기
이 논문이 다루는 문제는, 옵션 시장 가격을 만족하는 모든 마팅게일 모형(가격 경로 모형) 중에서 그 모형의 순간 변동성과 기준 모형의 변동성 차이의 제곱을 시간에 걸쳐 더한 값이 최소가 되는 모형을 고르는 것입니다.
흥미로운 점 하나: 기준 모형의 변동성은 후보 모형이 실제로 방문할 가능성이 높은 가격 영역에서 평가합니다. 쉽게 말하면 "우리 모형이 자주 가는 동네의 변동성이 기준과 비슷하게" 유도하는 것이죠. 모형이 거의 가지 않는 먼 미래의 가격 영역까지 일치시키려 애쓰지 않으니, 관측되지 않는 영역에 대한 억측이 줄어듭니다.
2단계. 연속 시간을 '만기 격자' 문제로 쪼개기
가격 경로는 초 단위로 끊임없이 움직이는데, 옵션 가격은 정해진 만기(3월물, 6월물…)에서만 관측됩니다. 논문은 만기 시점들만 남긴 격자 문제로 문제를 단순화합니다. 즉,
- 만기마다 가격 분포를 정하고(옵션 가격 제약을 만족하도록),
- 만기와 만기 사이는 '기준 모형과 가장 비슷한' 마팅게일 전이로 이어 붙이고,
이 두 가지를 동시에 고르는 문제입니다. 이 '이어 붙이기'에 쓰이는 도구가 q_x-Bass 마팅게일이라는 특수한 확률과정입니다. 이름이 어렵지만 개념은 직관적입니다: 두 만기 사이의 가격 분포를 연결하는 수많은 방법 중에서, 기준 모형의 전이 패턴과 가장 가까운 길을 고르는 '가장 자연스러운 연결 경로'입니다.
3단계. 이산 문제의 해가 진짜 답에 가까움을 증명하기
격자 문제를 풀면 만기별 분포가 나오고, 이를 이어 붙여 연속 시간 모형을 만들 수 있습니다. 논문의 핵심 정리(Theorem 3.3)는 이렇게 말합니다:
격자를 촘촘히 쪼갤수록(만기 사이 간격이 좁아질수록), 격자 문제에서 얻은 모형의 비용은 진짜 최적 모형의 비용에 가까워진다. 오차 상한은 격자 간격의 제곱근에 비례한다.
쉽게 말하면 "만기 사이를 2배, 4배 촘촘히 나누면 근사가 꾸준히 좋아진다"는 것을 수학적으로 보장한 것입니다. '그럴 것 같다'가 아니라 '증명했다'는 점이 이 논문의 핵심 가치입니다.
또한 이 문제가 볼록 최적화(그래서 '이 답이 진짜 최적 답'임을 확신할 수 있는 좋은 성질)임도 함께 증명합니다. 계산 결과가 초기값에 따라 달라지는 불안한 문제가 아니라는 뜻입니다.
결과 — 무엇을 알아냈나
이 논문은 시장 데이터 실험 논문이 아니라 이론 논문이라서, "수익률이 몇 % 올랐다" 같은 실증 수치는 없습니다. 대신 세 가지 의미 있는 결과를 냅니다.
첫째, 계산을 병렬로 나눌 수 있습니다. 만기가 10개면 원래는 10개 만기의 분포를 동시에 맞춰야 하는 거대한 문제인데, 이 논문은 각 '만기 사이 구간'의 계산이 독립적임을 증명했습니다(Remark 4.1). 그래서 여러 대의 컴퓨터에 구간을 나눠 맡기는 병렬 계산이 자연스럽습니다. 논문 제목의 'A Parallel Computing Approach'가 바로 이 점을 강조하는 것입니다.
둘째, '옵션 가격만으로' 캘리브레이션할 수 있습니다. 기존 여러 방법은 만기별 가격 분포 전체를 알아야 했지만, 이 논문의 수치 방법은 관측된 콜 옵션 가격 몇 개만 있으면 제약을 구성할 수 있습니다. 실무에서는 만기별 전체 분포를 구하기 어렵고(주어진 행사가 몇 개의 가격만 보이죠), 옵션 가격만으로 끝낼 수 있다는 점은 꽤 실용적인 진전입니다.
셋째, 시장 가격이 '완전히 깔끔하지 않아도' 됩니다. 실제 체결 가격에는 노이즈가 있고, 때로는 옵션 가격들끼리 서로 모순되기도 합니다(그래서 어떤 모형도 전부 맞출 수 없는 경우가 있습니다). 이때는 제약을 억지로 지키는 대신 '어긋난 만큼 벌점(페널티)'을 매기는 완화된 문제(Example 5.1)로 바꿔 풀 수 있으며, 이 경우에도 볼록성이 유지되어 같은 알고리즘을 씁니다.
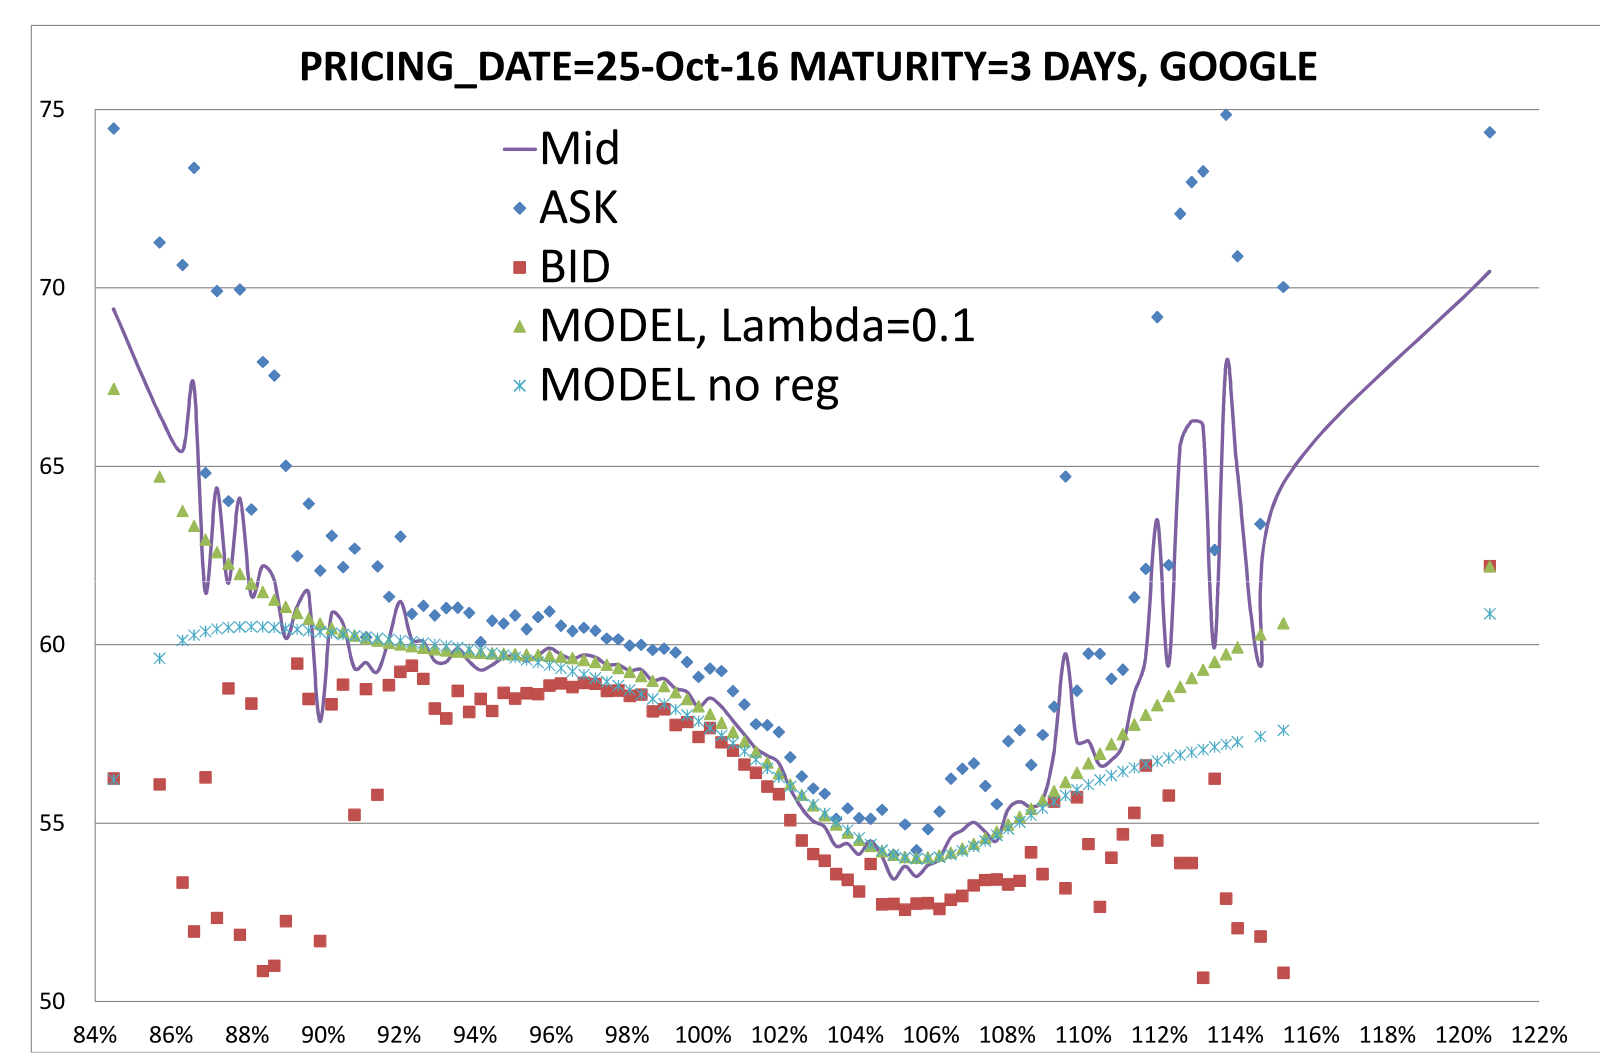
참고로 아래 그림은 시장 옵션 가격(점)에 모형(선)을 맞추는 작업이 어떤 결과를 내는지 보여 주는, 같은 마팅게일 최적수송 계열 연구(1902.04456)의 결과 그림입니다. 대상 논문(2610.31825)은 그림이 수식 다이어그램뿐이라, 개념 전달을 위해 다른 논문의 그림으로 대체했습니다(대상 논문에는 실증 결과 그림이 없습니다).
이 그림에서 점들은 시장에서 관측된 옵션 가격에서 유도된 변동성이고, 선은 모형이 맞춘 변동성입니다. 오늘 소개한 논문의 목표도 본질적으로 같습니다 — 시장의 점들을 지나가면서도, 우리가 원하는 변동성 성격을 잃지 않는 선을 찾는 것입니다. 다만 오늘 논문은 "그 선을 찾는 절차의 최적성을 수학적으로 증명"했다는 점에서 한 단계 더 나아갑니다.
한계와 주의점 — 솔직하게
좋은 이야기만 있는 것은 아닙니다. 이 논문을 읽을 때 알아 두어야 할 한계가 분명합니다.
- 실증 검증이 없습니다. 이론과 알고리즘 설계까지가 논문의 범위입니다. 실제 시장 데이터로 캘리브레이션해 본 결과, 계산 시간, 기존 방법(Heston 캘리브레이션, 국소변동성 모형 등) 대비 우수성은 이 논문에서 확인되지 않습니다. '좋다'가 아니라 '잘 정의된 문제이며 풀 법한 문제다'까지가 이 논문이 주는 선물입니다.
- 증명에 조건이 붙습니다. 기준 모형의 전이 확률에 대한 수학적 조건(적분 가능성, 비퇴화성 등)과 '최적해가 문제 영역 내부에 존재한다' 같은 가정이 필요합니다. 차원이 높아지면(자산을 여러 개 동시에 다루면) 이 조건들이 만족되기 어렵습니다.
- 오차 상한 ≠ 실제 오차. '격자 간격의 제곱근에 비례하는 상한'은 이론적 보장이지, 실제 계산에서 오차가 그 값이라는 뜻은 아닙니다. 상수의 크기도 논문에서 명시하지 않습니다.
- 공개 코드를 확인하지 못했습니다. 원문에 구현 코드·데이터 공개 언급이 없어, 실무에 쓰려면 알고리즘 설명대로 직접 구현해야 합니다.
그래서 투자/실무엔?
당장 돈을 버는 전략은 아니지만, 파생상품을 다루는 팀에게는 방향을 알려 주는 논문입니다.
- 리스크 시나리오 모델링: 시장 옵션 가격과 어긋나지 않으면서도 '말이 되는' 변동성 구조를 가진 모형이 필요할 때(예: 헤지 시나리오 생성), 이 프레임워크가 설계도면이 될 수 있습니다.
- 데이터 요구가 가볍다: 만기별 전체 분포가 아니라 바닐라 옵션 가격만으로 문제를 세울 수 있어, 데이터가 빈약한 시장(개별주 옵션, 신흥국 옵션)에서도 적용 여지를 남깁니다.
- 병렬 계산 친화적: 구간별 독립 계산 구조라 만기가 많은 옵션 체인을 다루는 인프라에 잘 맞습니다.
- 노이즈에 대한 현실적 대응: '모순되는 시장 가격'을 페널티로 다루는 완화 캘리브레이션은 실전 데이터의 불완전함을 정면으로 인정하는 설계라, 실무 구현 시 채택할 만한 아이디어입니다.
개인 투자자에게는 '옵션 가격을 맞추는 모형에도 최적화 이론이 이렇게 깊이 들어간다'는 사실 자체가 흥미로운 부분일 것입니다. 시세가 모형과 어긋날 때 그 틈을 메우는 작업이 단순한 곡선 맞추기가 아니라 최적의 확률 경로를 찾는 수학 문제라는 관점이, 파생 매매의 본질을 이해하는 데 도움이 됩니다.
더 알아보기
- 원문: arXiv:2610.31825 — Mimicking Volatilities under Marginal Constraints via q_x-Bass Martingales: A Parallel Computing Approach (Antonio Marini, ETH Zürich, 2026년 10월 게재)
- 5차원 점수 (참고): 참신성 75 / 적용성 69 / 엄밀성 77 / 재현성 38 / 통찰 73 — 종합 68.0 (A등급)
- 함께 보면 좋은 논문 (KB 기준 관련 논문):
- Deep Learning Volatility (1901.09647) — 딥러닝으로 변동성 모형을 빠르게 계산하는 접근
- Building arbitrage-free implied volatility: Sinkhorn's algorithm (1902.04456) — 위 그림의 출처 논문으로, 시장 변동성을 무차익 가격에 맞춰 구성하는 방법
- Distributionally Robust Martingale Optimal Transport (2106.07191) — 마팅게일 최적수송에 불확실성까지 고려한 확장
- Multi-Period Martingale Optimal Transport (2601.05290) — 여러 시점의 제약을 동시에 다루는 이론 정리
이 글은 OHSE AI Lab의 금융 AI 논문 모니터링 파이프라인이 작성한 초안입니다(draft). 등급과 점수는 자체 평가 기준이며, 투자 조언이 아닙니다.
관련 글
 LLM 트레이딩 에이전트A
자기진화형 LLM 투자 에이전트를 안전하게 가두는 법: Steward 5개월 실운용
스스로를 고치며 투자하는 LLM 에이전트는 어디까지 고치게 둬야 할까? 5개월 실운용 기록으로 검증한 자기진화형 투자 AI 'Steward'의 설계를 쉽게 풀어 설명한다. 불변 리스크 코어, 프롬프트 인젝션 방어, 리플레이 검증까지.
 알고리즘 트레이딩A
Polymarket 80만 건 분석: 상장 순간의 계약서가 거래량과 분쟁을 말한다
예측시장 Polymarket의 해결 계약 802,863건을 분석한 연구. 상장 시점의 계약서 텍스트만으로 거래량과 분쟁 위험을 예측했고, 무엇이 신호인지와 시대가 바뀌면 모델이 무너지는 이유까지 밝혔다. 금융 NLP와 시장 설계 관점에서 정리.
 시장 미시구조S
LOB 시뮬레이터 시장충격 벤치마크: AI 트레이더가 배우는 가짜 충격
가짜 주문장(LOB) 시뮬레이터에서 훈련한 AI 트레이더가 실제 시장에서 실패하는 이유를 다룬 벤치마크 논문 해설. 메타오더 주입 실험으로 생성형 LOB 모델의 시장충격이 제곱근 법칙에서 벗어나고 이완되지 않음을 밝힌다.