What Prediction-Market Contracts Reveal at Launch: Trading Volume and Dispute Risk
Ahmed Mahrous, Roberto Di Pietro
계약서 한 장만 보고 "이 상품은 흥할까, 말다툼으로 끝날까"를 미리 안다면? 80만 건의 예측시장 계약을 뒤진 연구가 "꽤 많이 맞힌다"고 답하면서도, 동시에 "그런데 그건 시대가 안 바뀔 때 얘기"라는 냉정한 경고를 던진다.
들어가며
자신이 잘 아는 것을 내기로 겨루는 시장을 예측시장(prediction market)이라고 합니다. "2024년 미국 대선에서 A 후보가 이길까?" 같은 질문을 하나의 상품으로 만들어 사고파는 거죠. 대표적인 곳이 Polymarket이라는 플랫폼인데, 2024년 미국 대선 관련 시장 하나에서만 거래액이 36억 달러(약 4조 7천억 원, 대략 환산)를 넘었다고 합니다.
하지만 그 화려함 뒤에는 다른 얼굴이 있습니다. 이번 연구가 조사한 2023년 1월~2026년 5월의 해결된 계약 802,863개를 보면, 거래액 상위 1%의 시장이 전체 거래액의 62.4%를 가져갑니다. 나머지 대다수 시장은 조용히 묻힙니다. 시장 하나의 거래액 중앙값은 3,542달러 수준이고, 평균은 84,404달러 — 평균이 중앙값의 20배가 넘는다는 것은 그만큼 소수의 인기 시장이 쏠려 있다는 뜻입니다.
그럼 플랫폼 입장에서 궁금한 게 하나 생깁니다. 계약을 막 출시한 순간, 아직 아무도 거래하지 않았을 때, 이 계약이 나중에 흥할지 말지를 알 수 있을까?
무엇이 문제였나
예측시장의 계약은 특이합니다. 그냥 설명문이 아니라 "무엇을 사고파는 상품인지"를 직접 정의하는 문서예요. "비트코인이 10월 23일 오후 3시에 7만 달러 위일까?"라는 질문 하나, 그 아래에 "해석 기준은 이 거래소의 이 데이터 피드를 따른다"는 식의 정산 규칙이 붙습니다.
기존 연구는 대체로 거래가 시작된 다음을 봤습니다. 가격이 정보를 모으는지, 유동성이 충분한지 같은 문제죠. 그런데 정작 플랫폼이 겪는 문제는 그 이전에 있습니다.
- 어떤 계약은 터지고, 어떤 계약은 썰렁한데, 왜 그런지 출시 전에는 모른다.
- 아주 드물지만, 정산을 두고 말다툼(분쟁)이 터지는데, 이게 터지면 비용이 크다. 데이터상 분쟁이 있었던 시장은 0.31%에 불과하지만, 이들이 전체 거래액의 5.8%를 쥐고 있다.
출시 시점에 남은 유일한 정보는 계약서 자체입니다. 제목, 설명문, 정산 규칙, 해석 출처. 과연 이 문서들이 시장의 미래를 담고 있을까?
핵심 아이디어
연구진은 손에 넣을 수 있는 모든 계약(802,863개, 391,955개의 "이벤트"로 묶음)에 대해, 출시 시점에만 있는 정보로 두 가지를 예측했습니다. 하나는 평생 거래액, 다른 하나는 나중에 분쟁이 붙는가입니다. 가격이나 참여자 수처럼 거래가 시작돼야 아는 정보는 철저히 제외했습니다.
계약서에서 뽑아낸 정보는 크게 네 묶음입니다.
- 구조적 정보 — 예정된 시장 운영 기간, 정산 설정, 출처 종류 같은 메타데이터.
- 주제 — "이 시장이 무엇에 관한 것인가". 문서에서 뽑은 단어 기반 토픽 40개와 문장 임베딩 군집 40개.
- 문구 — 질문의 길이, 구체적인 숫자·날짜 앵커가 있는가, 모호한 표현("유의미한", "신뢰할 수 있는 보도")을 썼는가.
- 규칙 설계 — 예외 상황(연기, 취소, 무승부, 출처 불능)을 미리 적어 뒀는가, 조건문이 많은가, 정산 문단이 별도로 있는가, 읽기 난이도는 어떤가, 출처가 검증 가능한 유형인가.
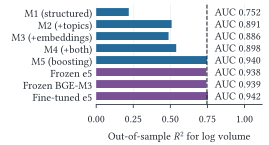
그다음 "정보가 어디에 모여 있는지"를 보기 위해 모델을 계단식으로 쌓았습니다. 기본 정보만 쓰는 단순 모델에서 출발해, 주제를 넣고, 문구와 규칙을 넣고, 마지막에 그래디언트 부스팅(LightGBM)으로 상호작용까지 허용하는 식이죠. 그리고 대조군으로 딥러닝 텍스트 모델(문장 임베딩, 그리고 끝까지 학습시킨 인코더)을 같은 조건으로 돌렸습니다.
평가도 꼼꼼했습니다. 한 경기의 여러 시장처럼 "가족"인 계약들은 학습과 시험에 절대 섞이지 않도록 나눴고, 반복되는 제목 템플릿(예: "15분 후 비트코인 오르내림" 같은 대량 상품)을 통째로 제거해 보는 견고성 검사까지 돌렸습니다.
결과 — 무엇을 알아냈나
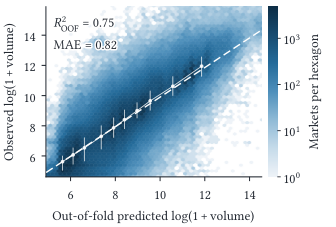
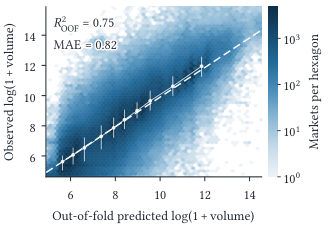
1. 거래액은 계약서만으로 꽤 잘 예측된다. 최종 모델은 실제 거래액 변동의 약 75%(R² = 0.747)를 설명했고, "거래액 1,000달러를 넘는가"라는 질문에는 AUC 0.940을 기록했습니다. 쉽게 말하면, 흥한 시장 하나와 조용한 시장을 무작위로 뽑았을 때 흥한 쪽에 더 높은 점수를 줄 확률이 94%라는 뜻입니다.
2. 신호의 대부분은 "무엇에 관한 시장인가", 즉 주제에 있다. 기본 계약 정보만으로는 설명력이 0.220 수준이었는데, 여기에 주제를 넣자 0.289가 덧붙어 거의 두 배가 됐습니다. 문구는 +0.021, 규칙 설계는 +0.006. 비유하자면, 중고차 판매글에서 "문장이 매끄러운가"보다 "어떤 차종인가"가 훨씬 중요하다는 겁니다. 실제로 반복되는 상품 유형별로 "1,000달러 돌파율"이 크게 갈립니다. 일일 기온 시장은 88.2%가 돌파하는데, 테니스 세트-게임 시장은 24.1%에 그칩니다.
3. 화려한 딥러닝이 딱히 못 한 것도 주목할 만하다. 같은 계약서를 문장 임베딩으로 읽힌 모델이나, 80만 건을 통째로 학습시킨 인코더나, 해석 가능한 단순 특징 + 부스팅을 넘지 못했습니다(성능 차이 +0.007). 작은 인코더(3,300만 개 매개변수)와 큰 인코더(5억 6,800만 개)도 거의 같았고요. "계약서라는 문서는, 사람이 읽을 수 있는 특징으로 거의 다 설명된다"는 인상적인 결론입니다.
4. 같은 특징이라도 주제에 따라 의미가 완전히 다르다. 예정 운영 기간이 길수록 거래액이 늘어나는 기울기는 비트코인 단타 시장에서 +2.92인데, 농구 경기 시장에서는 −0.03입니다. 즉 "기간이 길면 좋다" 같은 규칙은 통하지 않고, 주제를 알고 봐야 합니다.
5. 그런데 시대가 바뀌면 모델이 무너진다 — 이 연구의 진짜 묘미. 같은 기간 안에서 시험하면 94%의 정확도를 내던 모델이, 과거 데이터로 학습하고 미래를 예측하게 하자 57.7%로 추락했습니다. 앞뒤 뒤집어 생각하면 동전 던지기 수준이죠. 무엇이 망가졌을까?
- 2026년에 플랫폼은 15분 단위 암호화폐 시장 같은 "템플릿 대량 상품"을 쏟아냈고, 표본의 74.3%가 2026년에 만들어졌습니다.
- 시험 문제의 76.9%가 학습 때 한 번도 본 적 없는 새로운 질문 형태였습니다. 이쪽에서는 예측력이 거의 0에 가깝고, 본 적 있는 형태에서는 77.8%로 그럭저럭 버팁니다.
- 재미있는 것은 못 맞히는 새 형태 시장들이 오히려 거래액이 크다는 점입니다. 모델이 가장 못 하는 대상이 가장 중요한 상품인 셈이죠.
6. 왜 무너졌는지 분해한 결과가 실무적으로 값지다. 모델의 지식은 "문서를 읽는 법"과 "특징이 수요와 어떻게 연결되는지"의 두 부분입니다. 연구진은 각각을 최근 데이터로 다시 배우게 해 보니, 문서 읽는 법만 다시 배우면 0.011 → 0.249로 조금 회복하는데, 특징–수요의 관계만 다시 추정하면 0.011 → 0.772로 거의 회복했습니다. 즉 언어가 변해서가 아니라, 같은 계약 특성이 이제 다른 수요를 끌기 때문입니다. 실제로 예측값을 통째로 올리는 간단한 보정은 전혀 도움이 안 됐고(순위가 망가졌기 때문), 처방은 "분기마다 다시 학습하라"입니다.
7. 분쟁은 "예측"이 아니라 "위험군 나누기"로. 분쟁은 529,408건 중 1,634건(0.31%)으로 극히 드뭅니다. 모델의 위험 점수는 우연보다 훨씬 잘 정렬하지만(AUC 0.78), 기저율이 0.31%라 개별 예측은 의미가 없습니다. 대신 위험 상위 5%를 사람 검토에 넘기면 분쟁률이 약 1.7%로 농축됩니다. 자동 거절이 아니라 검토 우선순위 도구로 쓰라는 뜻입니다.
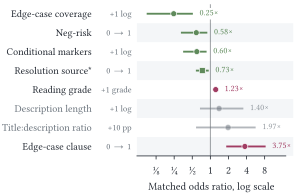
그런데 어떤 계약이 분쟁에 잘 걸리는지는 꽤 또렷합니다. 동일 주제·시기·출처 유형의 건강한 계약과 짝지어 비교한 결과:
- 읽기 어려울수록 말다툼이 늘어난다. 규칙의 읽기 난이도(미국 학년 기준)가 한 단계 오를 때마다 분쟁 위험 23% 증가. 이 연구에서 가장 안정적인 발견입니다.
- 출처가 애매하면 위험하다. 기계적으로 읽히는 데이터 피드를 쓰는 계약 대비, 출처가 아예 식별되지 않는 계약은 분쟁 위험이 약 5배(오즈비 4.93). 출처 유형별 분쟁률은 거의 50배까지 벌어집니다. 숫자를 바로 보여주는 온체인 오라클은 0.08%, 언론 보도를 해석해야 하는 엔터테인먼트 시장은 3.79%.
- 예외 상황 조항은 양날의 검. 애초에 예외 조항이 있는 계약은 분쟁 위험이 3.8배 높은 대신, 조항이 있는 계약 안에서는 촘촘하게 쓸수록 오히려 위험이 낮습니다. "제작자가 말다툼을 예감하고 조항을 넣었다"는 해석이죠.
한계와 주의점
정직하게 적어 두면:
- 단일 플랫폼 연구입니다. Polymarket의 상장 방식, 참여자, 규칙에 맞춰진 결과라 다른 예측시장(예: Kalshi)으로 그대로 옮길 수 있는지는 확인되지 않았습니다.
- 연관이지 인과가 아닙니다. "읽기 어렵게 쓰면 분쟁이 난다"가 아니라 "읽기 어렵게 쓰인 계약에 분쟁이 모인다"입니다. 계약의 특성들은 창작자가 한꺼번에 고르기 때문이죠.
- 거래액 예측은 시대에 따라 반드시 다시 학습해야 합니다. 이 연구가 가장 강력하게 말하는 것이 바로 이겁니다. 한때 94%의 정확도도, 플랫폼이 새 상품 형태를 쏟아내면 동전 던지기로 떨어질 수 있습니다.
- 분쟁 분석은 분쟁 이력이 남은 시장(전체의 65.9%)만 대상입니다.
- "디테일한 예측"과 "위험군 정렬"은 다른 도구입니다. 분쟁 점수를 개별 계약의 자동 거절에 쓰면 대부분 헛다리입니다.
그래서 투자/실무엔?
일반 독자 눈높이에서 남는 교훈 몇 가지:
- 문서가 상품을 말한다. 출시 시점의 문서가 이후 성과를 꽤 담고 있다는 사실은, 예측시장뿐 아니라 어떤 "문서 기반 상품"(펀드 명세서, 공모 문서, 대출 약관)에도 통하는 관찰입니다. 무엇에 관한 상품인가가 어떻게 쓰였는가보다 중요하다는 점도요.
- "읽기 쉽게 쓰기"는 리스크 관리다. 복잡한 문장이 말다툼을 부른다는 결과는 계약·상품 설계에서 명료함이 곧 품질이라는 평범한 진리를 데이터로 뒷받침합니다.
- 과거 성적표는 시대가 바뀌면 무효. 자동화된 스크리닝이나 투자 모델을 굴린다면, "새로운 유형이 들어오는 비중"을 경보등으로 두고 주기적으로 다시 학습시켜야 합니다. 이 연구의 원인 분해처럼, "모델이 못 읽어서"인지 "세상이 변해서"인지 구분하는 습관이 유용합니다.
- 자기자본 운용 관점에서는, 신규 시장(예측시장 계약 포함)의 상장 우선순위를 매기는 사전 스크리너로 재현 가능한 접근입니다. 단, 분기 재학습 규칙을 전제로.
더 알아보기
- 원문: What Prediction-Market Contracts Reveal at Launch: Trading Volume and Dispute Risk (arXiv:2610.29578) — ACM ICAIF '26(2026년 11월, 밀라노) 채택, 데이터·코드는 Zenodo 공개.
- KB 5차원 점수 (참고): 새로움 68 · 적용성 67 · 엄밀성 86 · 재현성 85 · 통찰 77 (종합 76.0, A등급).
- 관련 논문 (KB 기준):
- OpenMarket: Polymarket–Binance 동기화 고빈도 데이터셋 (arXiv:2607.26245)
- Settlement Manipulation in Prediction Markets (arXiv:2606.31675) — 정산 규칙이 조작에 어떻게 악용되는지 (계약 설계 연구의 그림자).
- Arbitrage Analysis in Polymarket NBA Markets (arXiv:2605.00864)
- Unravelling the Probabilistic Forest: Arbitrage in Prediction Markets (arXiv:2508.03474)
관련 글
 시장 미시구조A
예측시장에서 돈을 벌 수 있을까? 7억 행 데이터로 확인한 놀라운 결론
Polymarket 예측시장과 Binance 암호화폐 거래소의 밀리초 단위 동기화 데이터셋을 분석한 결과, 고빈도 트레이딩으로 예측시장에 진입하는 것이 왜 어려운지를 보여주는 흥미로운 연구입니다.
 시장 미시구조A
예측시장에서 돈을 벌 수 있을까? 7억 행 데이터로 확인한 놀라운 결론
Polymarket 예측시장과 Binance 암호화폐 거래소의 밀리초 단위 동기화 데이터셋을 분석한 결과, 고빈도 트레이딩으로 예측시장에 진입하는 것이 왜 어려운지를 보여주는 흥미로운 연구입니다.
 통계 차익거래A
Polymarket 조합 차익거래: 모순되는 베팅 가격에서 250만 달러를 찾은 방법
논리적으로 연결된 예측시장 베팅들의 가격이 서로 모순될 때 '무조건 남는 조합'이 생긴다는 사실을, 25만 5천 개 계약과 약 190만 개 논리 관계로 추적해 실제 체결과 수수료까지 검증한 대규모 연구를 일반인 눈높이로 정리합니다. 정수계획법, 호가장 재생, 다중 레그 체결까지 쉽게 설명합니다.