The end-of-month option in futures contracts and the Gittins index of holding the underlying
Erhan Bayraktar
"가격은 이미 정해졌는데, 언제 넘길지는 내가 고른다" — 이 작은 선택권의 값을 얼마로 매겨야 할까? 이 논문은 20년간 풀리지 않던 이 문제를 '슬롯머신을 언제 그만둘까'라는 오래된 아이디어(Gittins 지수)로 풀어 냅니다.
들어가며
농산물 시장을 생각해 보세요. 사과 농부가 도매상과 이런 계약을 맺습니다. "다음 달 말까지, 정해진 가격에 사과를 넘길게. 다만 정확히 어느 날 넘길지는 내가 정해." 농부에게는 작은 자유가 생깁니다. 창고에 사과를 두고 며칠 더 기다리면 시장 상황에 따라 더 유리한 날에 넘길 수 있습니다. 반대로 말하면, 이 '언제 넘길지 정하는 권리'에는 값이 있다는 뜻입니다.
실제 금융시장에는 이런 계약이 여전히 남아 있습니다. 선물(futures) 계약의 월말 인도 선택권(end-of-month option)이 바로 그것입니다. 인도 가격은 미리 고정되어 있고, 매도자(숏 포지션)가 인도 기간 안에서 인도 시점을 고릅니다. 1980년대 옥수수 선물 시절의 유물 같지만, 이 선택권이 선물 가격에 얼마만큼 녹아 있는지, 매도자가 언제 인도해야 최적인지에 대한 깔끔한 답은 오랫동안 없었습니다.
2026년 10월 미시간 대학의 Erhan Bayraktar가 공개한 이 논문은 그 답을 Gittins 지수로 제시합니다. 쉽게 말해, "슬롯머신을 언제 그만둘까"를 수학으로 푸는 지수로 선물 인도 문제를 바꿔 보니, 20년 묵은 문제가 한 방에 정리된 것입니다. 원문에는 "2007년에 Tomas Björk가 이 문제를 알려 주었고, 아직 풀리지 않았다는 걸 알고 다시 돌아왔다"는 헌사가 적혀 있습니다.
무엇이 문제였나
매도자의 관점을 수식 없이 말하면 이렇습니다. 인도 가격이 으로 정해져 있고, 기초자산 가격이 로 움직일 때, "가장 좋은 날에 인도해서 을 챙기는" 것이 목표입니다. 문제는 '가장 좋은 날'을 고르는 것이 미래를 봐야만 안다는 점입니다. 오늘 넘기면 내일 가격이 빠질 위험을 피하지만, 반대로 내일 오를 기회를 잃습니다.
더 까다로운 것은 계약 가격 자체가 이 선택권에 달려 있다는 점입니다. 공정한 선물 가격 는 "이 계약의 가치가 0이 되는 지점"으로 정의되는데, 계약 가치는 최적 인도 전략에 따라 달라집니다. 결국 는 "여러 전략별로 계산한 두 값의 비율" 중 최선의 형태가 되어 버립니다. 비율의 최적화는 표준 최적정지(optimal stopping) 문제로 바로 환원되지 않습니다. 이 구조적 걸림돌 때문에 문제는 오래 미해결로 남았습니다.
핵심 아이디어
논문의 해법은 세 단계로 요약됩니다.
1단계 — 문제를 '멈춤 시점 선택'으로 다시 씁니다. 매도자는 "가격이 정해진 프로젝트"를 운영하는 사람으로 봅니다. 기초자산을 들고 있으면 편의수익률(보유의 편익, 예: 원자재의 스토리지 편익)이라는 '보상 흐름'을 계속 받고, 인도하는 순간 프로젝트를 '은퇴'시키고 상금 을 받는 구조입니다.
2단계 — '멈춤 지수'가 존재함을 증명합니다. 여기서 마술이 일어납니다. 강화학습과 밴딧(bandit) 이론에는 Gittins 지수라는 오래된 결과가 있습니다. 슬롯머신 여러 대가 있을 때 "각 기계의 현재 가치"를 하나의 숫자로 매기고, 그 숫자가 더 큰 기계를 계속 돌리다가, 지수가 상금(은퇴 보상) 아래로 떨어지는 순간 그만두면 그것이 최적이라는 정리입니다. 논문은 선물 인도 문제에서 이 지수를 명시적으로 계산하는 공식(Bank–El Karoui 표현)을 세웁니다. 인도 규칙은 놀랍도록 단순해집니다:
지수가 인도 가격 아래로 떨어지는 첫 순간에 인도하라. 그런 순간이 없으면 만기에 인도하라.
3단계 — 가격 를 계산 가능하게 만듭니다. 비율 최적화를 Dinkelbach라는 기법으로 "표준 최적정지 문제의 연속 풀기"로 바꿉니다. 그리고 반복 계산이 수렴을 보장한다(수축률 )는 이론적 상계를 증명합니다. 실무적으로 인상적인 함의: 인도 기간이 1주일이고 금리가 연 5% 이하라면, 최적정지 문제를 딱 한 번만 풀어도 오차가 전체 가격 격차의 1,000분의 1 안으로 들어옵니다.
결과
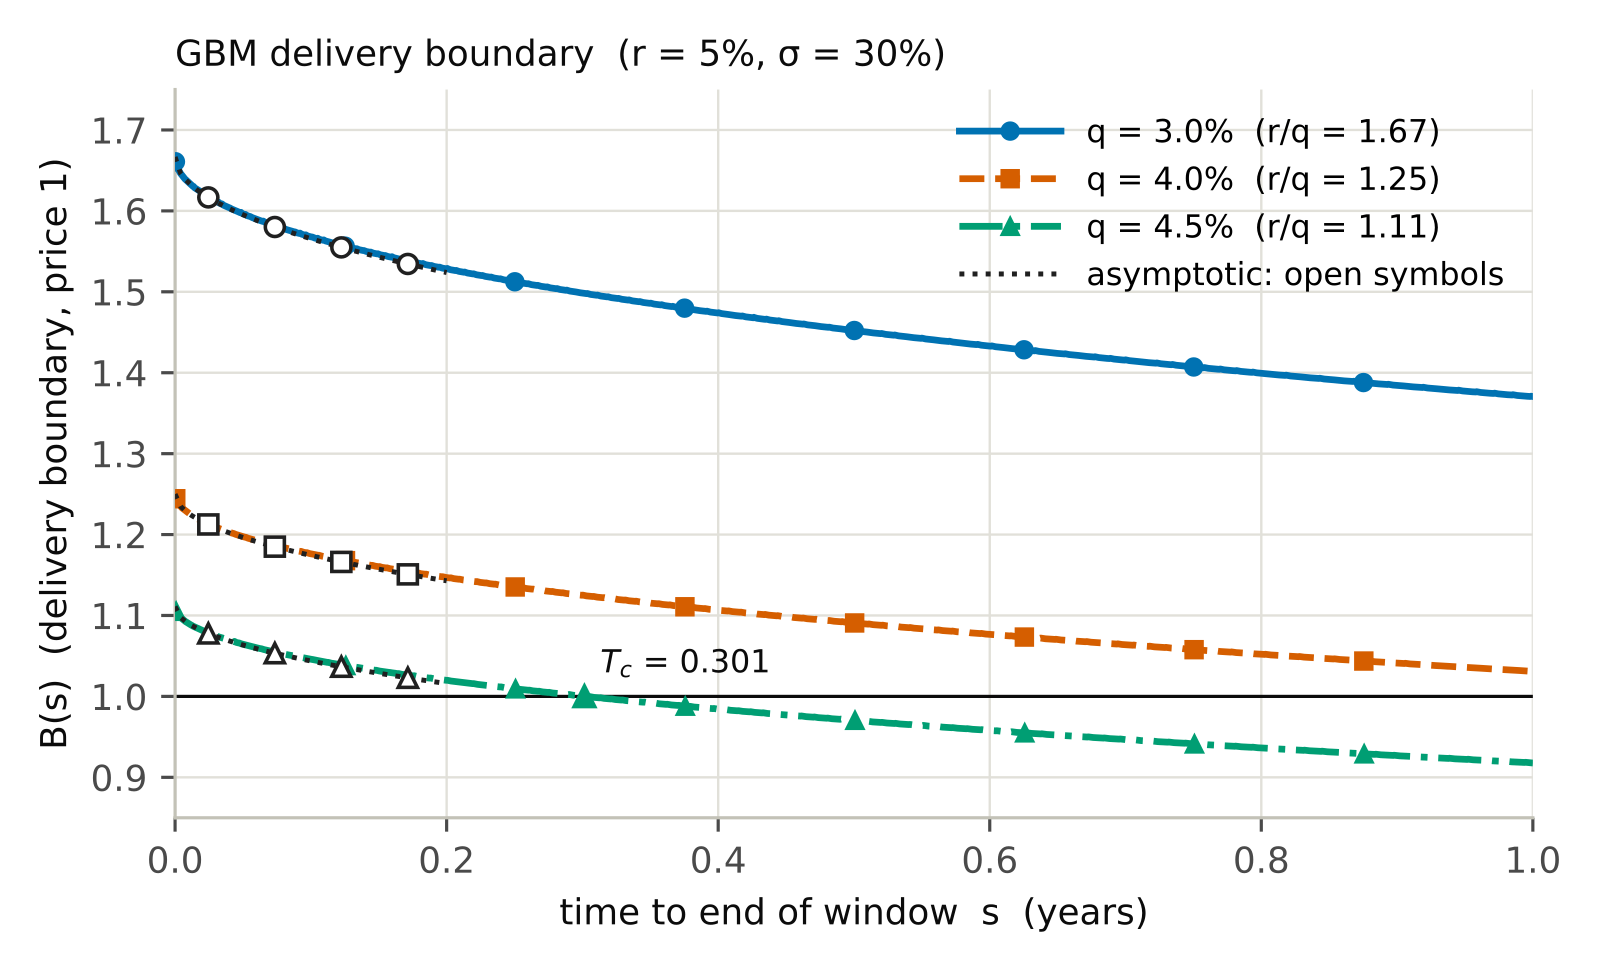
"선물 가격이 현물과 같은 순간"이 정확히 계산됩니다. 기하 브라운 운동(가장 표준적인 가격 모형)에서 선물 가격은 현물의 일정 비율 가 됩니다. 그리고 , 즉 할인이 없을 조건이 명확합니다 — 편의수익률이 0 이하이거나, 0보다 크더라도 금리보다 낮고 인도 기간이 임계 지평 보다 짧을 때입니다. 편의수익률이 있는 자산을 '미루며 보상'을 받을 수 있는데 인도 기간이 짧으면 그 보상이 작아서, 미룰 이유가 사라지는 원리입니다.
임계 지평의 근사식도 나옵니다. 형태로, 편의수익률 가 금리 에 가까워질수록 임계 기간이 급격히 짧아집니다. 여기 등장하는 상수 는 별도의 '브라운 운동 비(ratio) 문제'의 값으로 밝혀졌고, 수치 실험에서 계산된 값(0.62~0.65)이 이론과 일치합니다.
확률적 편의수익률 모형(깁슨-슈워츠)으로 실제 원유 파라미터를 넣으면:
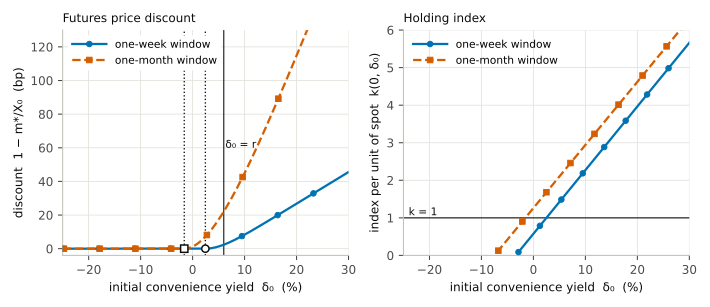
- 인도 기간이 1주일이면 임계 편의수익률은 연 2.5% — 이보다 낮으면 선물 가격이 현물과 같습니다.
- 1개월이면 임계값은 연 −1.6%로 내려갑니다. 기간이 길수록 '기다림의 보상'이 커져서 할인이 생기기 쉽습니다.
- 편의수익률이 금리(6%)와 같을 때, 선물 가격의 현물 대비 할인은 1주 2.4 bp(1 bp = 0.01%), 1개월 22 bp. 편의수익률이 20%까지 올라가면 1개월 할인이 115 bp(약 1.15%)까지 커집니다.
계산 방법의 수치 검증도 꼼꼼합니다. 몬테카를로 40만 경로로 최적 인도 규칙을 돌려 보니 이론 예측(계약 가치 0)과 통계적으로 구분되지 않았고(0.0004 ± 0.0003), 뉴턴 반복을 한 번만 돌려도 가격을 소수점 6자리까지 복원했습니다(실제 수축률 0.0007, 이론 보장치 0.049보다 훨씬 좋음).
한계와 주의점
- 실증 데이터가 없는 이론 논문입니다. 검증은 표준 모형(기하 브라운 운동, 깁슨-슈워츠)에 대한 수치 실험까지입니다. 실제 선물 시장의 인도 데이터와 대조한 연구는 후속 과제입니다.
- 경계 구조 자체의 선행이 있습니다. 외환의 '오픈 포워드' 계약 연구(Hok–Tse)가 유사한 경계와 제곱근 점근을 이미 다뤘습니다. 이 논문의 새 기여는 계수의 의미 부여(브라운 운동 비 문제의 값), 내생 가격 의 결정, 임계 지평의 점근 분석입니다.
- 일부 수치 근사는 증명되지 않았습니다. 깁슨-슈워츠 모형의 임계값 근사식은 원문에 "증명하지 않았으며 점근적으로만 성립한다"고 명시되어 있습니다.
- 재현성 점수가 낮은 편입니다(40점). 공개 코드가 없어 재현하려면 유한차분 구현을 직접 해야 합니다.
그래서 투자/실무엔?
- 선물 롤오버 전략의 '기준 시계'를 얻습니다. 원자재·선물 전략에서 "언제 다음 계약으로 넘길까"는 매번 감으로 정하는 문제입니다. 이 논문은 그 판단을 지수 ≤ 인도 가격이면 넘기고, 아니면 보유라는 한 줄 규칙으로 환원합니다.
- 베이시스(선물-현물 가격차)의 '구조적' 성분을 이해할 수 있습니다. 편의수익률이 있으면 선물 가격이 현물보다 낮아지는 것이 모형 안에서 필연입니다(1주 2.4 bp, 1개월 22 bp, 편의수익률 20%에서 115 bp). 베이시스 트레이딩에서 이 성분을 '무엇이 설명하는 가격'으로 분리해 두면 해석이 쉬워집니다.
- 계산 비용이 작은 것이 실무적 무기입니다. 보장된 수렴으로 "최적정지 한 번 풀기"가 끝나는 구간(1주 창, 금리 5% 이하)이 있습니다. 실시간 인도/롤오버 의사결정에 넣기 쉬운 형태입니다.
- 반드시 짚을 것: 이 논문이 주는 것은 가격결정과 인도 시점의 이론이지, "이 전략이 수익을 낸다"는 검증이 아닙니다. 실제 적용 전에 자산별 편의수익률 추정이라는 앞단 작업이 그대로 남습니다.
더 알아보기
- 원문: The end-of-month option in futures contracts and the Gittins index of holding the underlying (arXiv:2610.21196)
- 5차원 점수(KB 기준): 새로움 78 / 적용성 69 / 엄밀성 87 / 재현성 40 / 통찰 78 (종합 72.3, A등급)
- 관련 논문(KB 기준):
- Long-Horizon Investment with Delayed Information in a Mean-Reverting Market (arXiv:2610.21447) — 정보가 늦게 도착할 때의 장기 투자 문제(같은 날 코호트).
- Fundamental Theorem of Discrete Asset Pricing (arXiv:2610.21442) — 이산 시장에서의 가격결정 기본정리(같은 날 코호트).
- Pricing American Commodity Options Under the Schwartz Two-Factor Model (arXiv:2610.21145) — 편의수익률이 있는 원자재 옵션 가격결정(같은 날 코호트).
관련 글
 강화학습 포트폴리오
가상 시장을 만들어 연습시킨 AI 포트폴리오 매니저 — vine copula 시뮬레이션과 강화학습이 거래비용을 41.5% 줄인 비결
투자는 미래가 한 번뿐이라 연습할 수 없다. 이 논문은 자산 간 관계를 배워 가상 시장을 찍어내고, 그 가상 세계에서 강화학습 매니저를 훈련시켜 22개월 실전에서 연 34.13%, 샤프 2.31을 기록했다. 시뮬레이션 연습이 거래비용을 41.5% 줄인 과정과, '모형을 믿어도 되는가'를 수학적으로 따진 점을 쉽게 정리한다.
 포트폴리오 최적화A
옵션 가격 모형의 무차익 보장: GROMM과 S&P 옵션 219만 건 검증
옵션 시장 모형이 '무차익'이라는 말을 증명하려면 무엇을 해야 할까. GROMM은 S&P 500 옵션 219만 개 호가로 가격표면을 맞추고, 5천 개 계약 전체에서 위험중립성을 검증했습니다. 국소변동성과 시나리오 생성의 시사점을 정리합니다.
 시계열 계량경제학A
유동성 배급이 정보의 가치를 바꾼다: AUC 0.80 모델이 0.70에 지는 이유
2020년 모기지 시장 위기에서 비은행 대출기관이 대출 매입을 미룬 이유를 190만 건 자료로 분석한 연구입니다. 유동성 제약이 투자 선택을 어떻게 왜곡하고, 예측 모델 평가(AUC)를 어떻게 바꾸는지 일반인 눈높이로 설명합니다.