
Mint-Agent: Introducing Finance-Native Agentic Foundation Models
Mint-Agent Team, B. Zhang, Yaze Geng, Lei Tang, Yaoyang Yi, Zonghan Wu 외 4명
AI에게 "이 회사 실적이 어때?"라고 물었을 때, 그럴듯한 대답 대신 '출처가 달린 대답'이 온다면? 금융 AI가 쓸모를 잃게 만드는 결정적 약점과, 이를 '근거 원장'이라는 아이디어로 정면 돌파한 연구를 소개합니다.
들어가며: 그럴듯하지만 믿을 수 없었던 AI의 답변
생성형 AI에게 회사 분석을 시켜본 사람이라면 한 번쯤 이런 경험을 했을 겁니다. 질문을 던지면 답이 매끄럽게 나옵니다. 문장도 그럴듯하고 숫자도 제법 구체적입니다. 그런데 "그 수치 어디서 나왔어요?"라고 되물으면 상황이 달라집니다. 출처가 애매하거나, 링크한 공시에는 다른 숫자가 있거나, 심지어는 존재하지 않는 분기를 인용하기도 합니다.
금융 투자에서 이 문제는 '귀찮은 단점'이 아니라 '치명적 결함'입니다. 내 돈을 걸어야 하는 의사결정인데, 답의 근거를 확인할 수 없다면 그 답은 사실상 쓸 수가 없죠. 더 큰 문제는 '긴 조사'입니다. 회사 하나를 제대로 분석하려면 공시를 읽고, 여러 문서의 숫자를 비교하고, 계산을 이어가고, 마지막에 결론을 내려야 합니다. 이 긴 과정에서 AI는 자주 길을 잃습니다. 분기를 착각하거나, 단위를 섞거나, 맞는 출처에서 틀린 숫자를 읽어 내기도 합니다.
2026년 8월에 나온 Mint-Agent 논문은 이 문제를 정면에서 다룹니다. 그리고 "금융 AI는 크게 키우면 된다"는 통념 대신, '근거를 남기는 설계'가 모델 크기보다 중요하다는 결론을 데이터로 보여줍니다.
무엇이 문제였나: 금융 AI의 두 가지 고질병
논문이 지적하는 금융 AI의 약점은 크게 두 가지입니다.
첫째, 근거 없는 그럴듯함. 기존 AI 에이전트는 '답이 맞았는가'만 평가받는 경우가 많습니다. 그런데 금융에서는 답이 우연히 맞아도, 근거가 틀리거나 출처가 권위 있는 자료가 아니면 곤란합니다. 예를 들어 "매출이 12% 늘었다"는 답이 맞더라도, 그 숫자가 어느 회계연도의 어느 보고서에서 왔는지 추적할 수 없다면 투자 판단에 쓸 수 없습니다.
둘째, 긴 조사에서의 길 잃기. "지난 3년간 이 회사의 수익성 변화 원인을 분석해줘"처럼 여러 단계를 거쳐야 하는 작업에서, 중간에 얻은 숫자를 잃어버리거나 시간 범위를 어긋나게 놓는 일이 빈번합니다. 눈앞의 한 단계는 그럴듯한데, 전체 연결 고리가 엉키는 거죠.
기존 연구들이 '금융 지식을 얼마나 아는지'를 키우는 데 집중했다면, Mint-Agent는 '어떻게 아는지를 증명할 수 있는지'를 모델 설계의 중심에 놓습니다.
핵심 아이디어: 데이터, 하네스, 알고리즘의 3단 설계
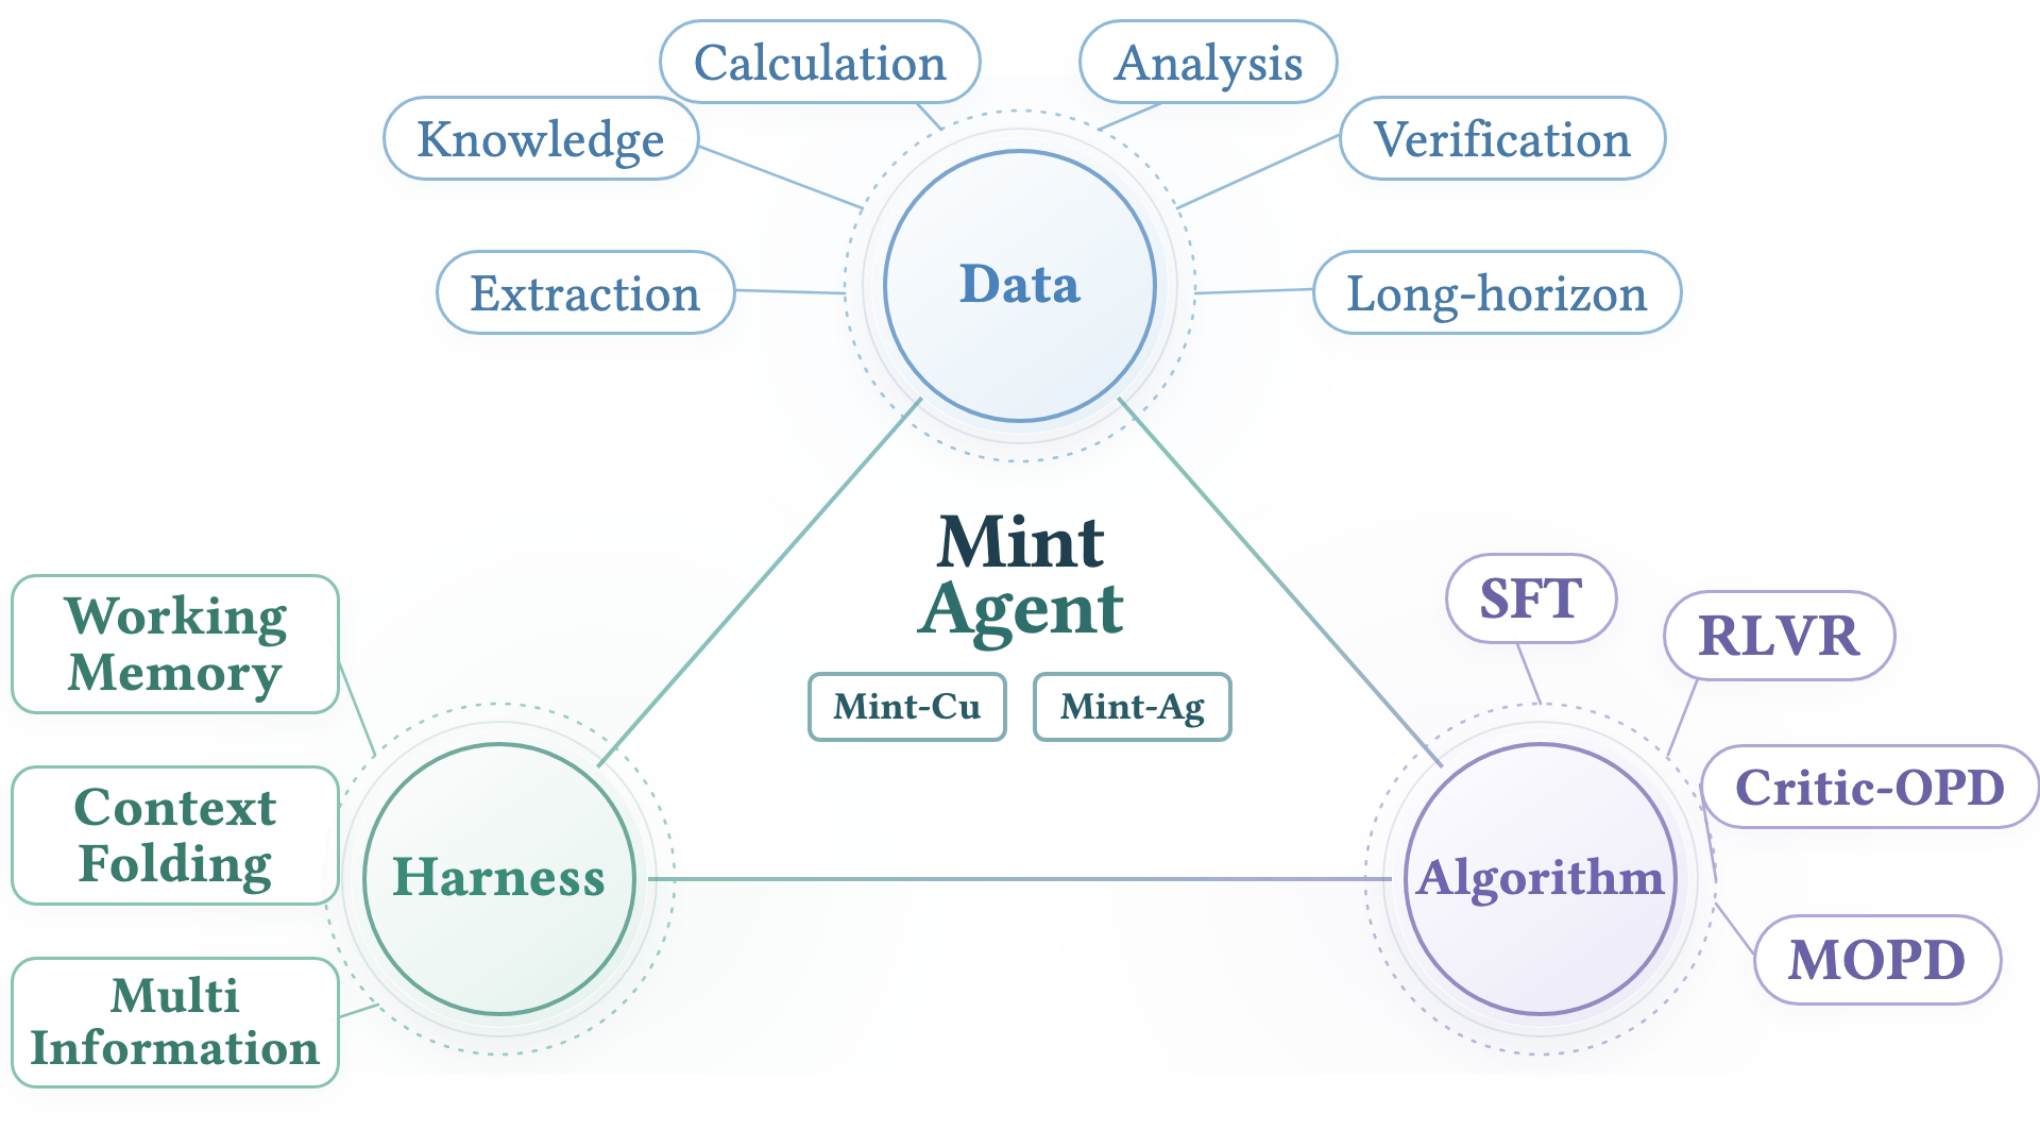
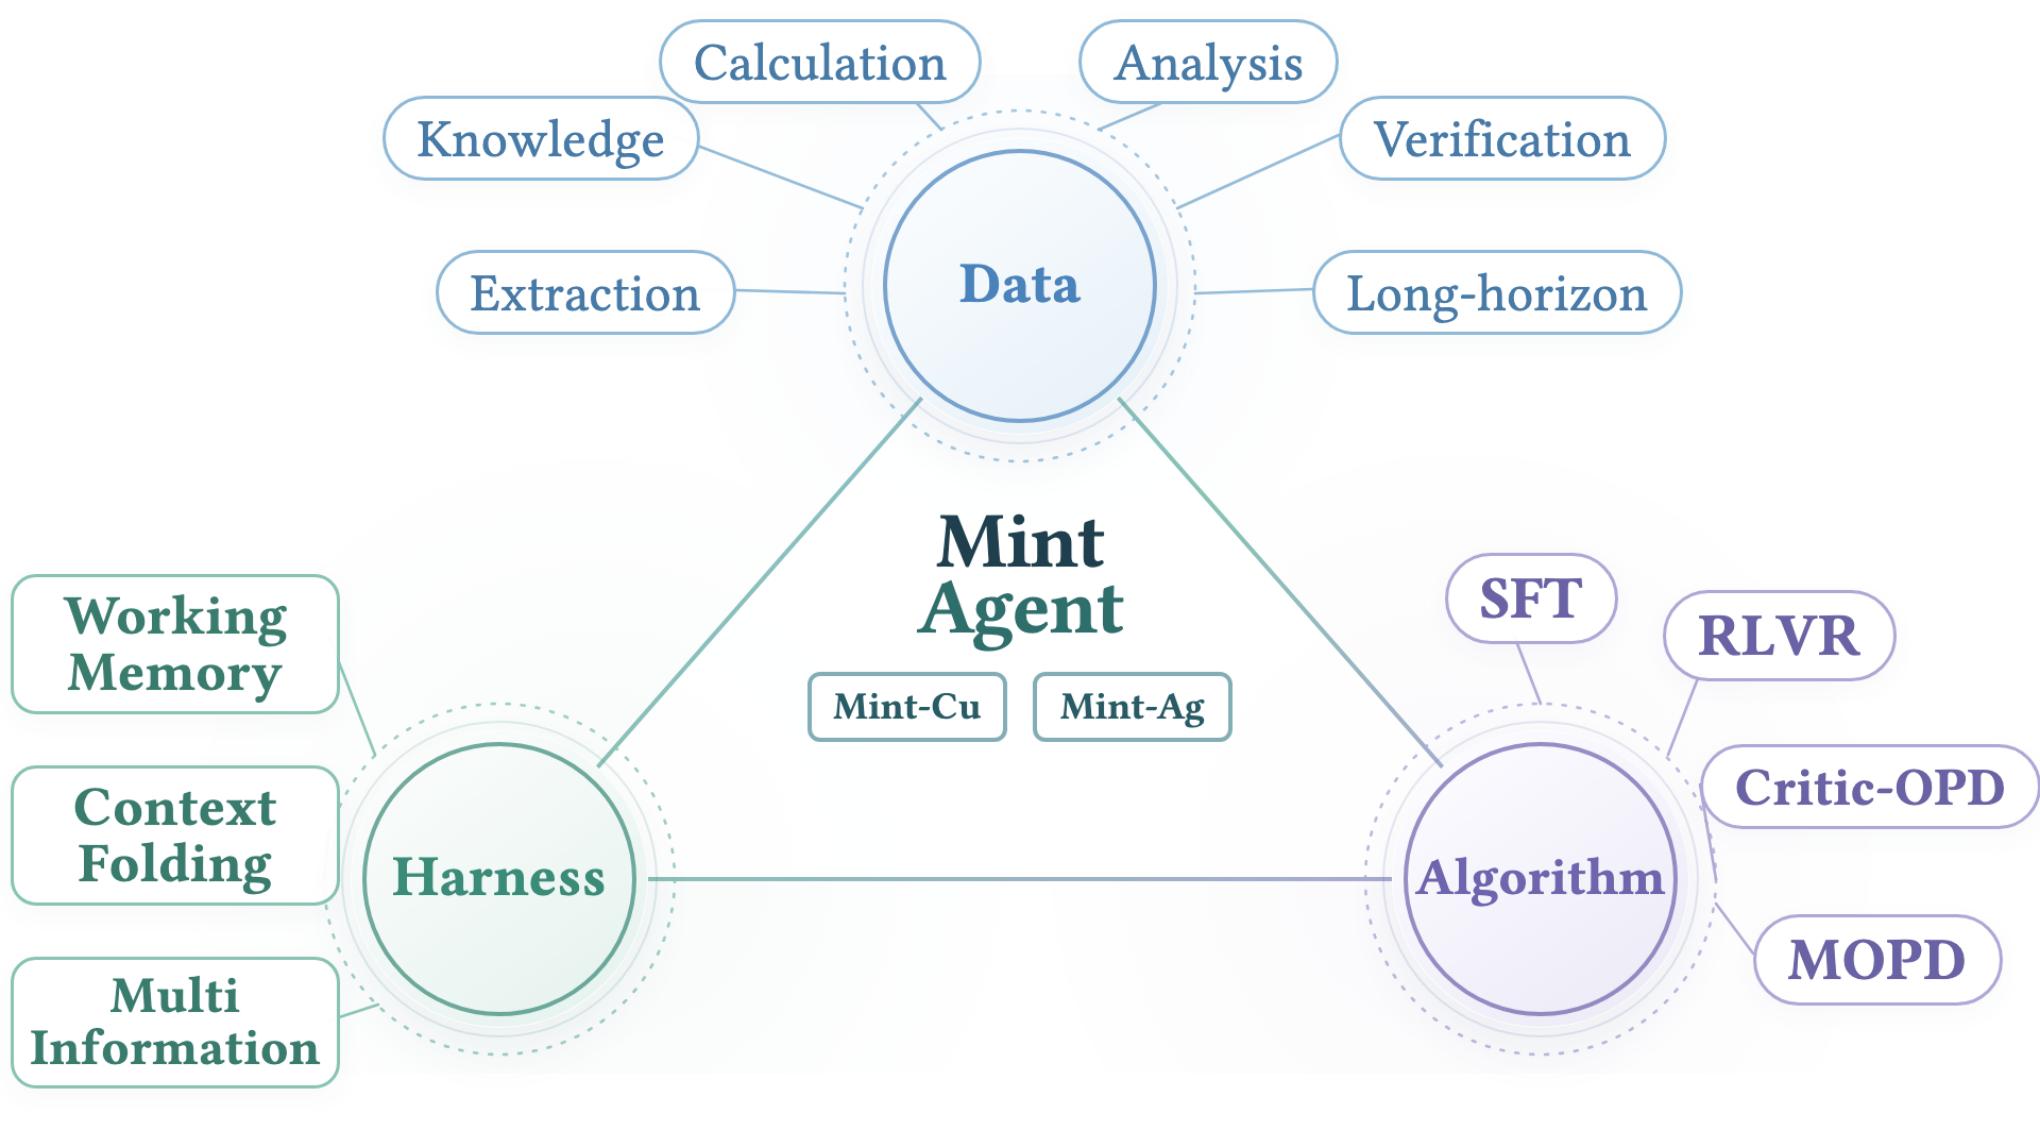
Mint-Agent는 세 개의 기둥 위에 서 있습니다. 하나씩 쉽게 풀어 보면 이렇습니다.
1. 데이터 엔진 — '출처가 달린 문제집' 만들기. 보통 AI는 인터넷에서 모은 텍스트로 학습합니다. Mint-Agent는 EDGAR(미국 공시 저장소), XBRL(공시의 정형 수치), 거래소 기록, FRED(거시 통계) 같은 1차 자료만 씁니다. 그리고 모든 사실에 '이 숫자는 어느 문서의 어느 부분에서 왔다'는 꼬리표를 붙입니다. 빵집에서 파는 빵마다 레시피와 재료 원산지를 적어 놓는 것과 비슷하죠. 문제도 그냥 만들지 않습니다. 지식·추출·계산·분석·검증 다섯 가지 능력 중 하나를 겨냥해 만들고, '근거가 뒷받침되는가', '계산을 다시 할 수 있는가', '답이 하나인가' 세 가지 검사를 통과한 것만 학습에 씁니다. 시험 문제가 아니라, 답안지에 출처 페이지가 인쇄된 문제집인 셈입니다.
장기 조사용 문제는 더 재미납니다. 에이전트에게는 '조사 목표'만 주고, 실제 자료 더미(소스팩)와 자료 간 연결 지도(근거 그래프)는 숨깁니다. 학생에게 답을 주지 않고 도서관만 열어 주는 것과 같죠. 에이전트가 직접 검색하고 읽고 계산해서 답을 찾아야 '진짜 조사 능력'이 훈련됩니다.
2. MintHarness — 근거를 잃지 않는 실행 환경. 아무리 좋은 모델도, 조사 과정을 제대로 기록하지 않으면 근거를 잃어버립니다. MintHarness는 에이전트가 행동할 때마다 근거 원장(Evidence Ledger)에 '무엇을 어떤 자료에서 봤는지'를 기록합니다. 회계사가 모든 거래를 장부에 남기는 것과 같은 원리입니다. 여기에 작업 기억과 컨텍스트 관리(긴 조사에서 중요한 내용을 압축해 유지하는 기술)가 더해져, 여러 단계를 지난 뒤에도 "이 결론은 이 근거에서 나왔다"를 되짚을 수 있게 합니다.
3. 학습 알고리즘 — 두 전문가를 하나로. 학습도 두 갈래로 나눕니다. 하나는 추론 전문가(공시 숫자 읽기, 계산, 검증 같은 정밀 작업), 다른 하나는 실행 전문가(여러 문서를 오가며 조사하는 장기 작업)입니다. 각각을 별도로 훈련시킨 뒤, TIES라는 모델 병합 기술과 멀티티처 온폴리시 정류화라는 증류 기술로 하나의 모델에 합칩니다. 회사에서 '숫자에 밝은 애널리스트'와 '자료 조사에 능한 리서처'를 따로 키운 뒤, 두 능력을 모두 가진 한 사람으로 키우는 셈입니다. 결과물은 두 모델 — Mint-Cu(90억 개 파라미터)와 Mint-Ag(270억 개 파라미터) — 입니다. 참고로 오늘날 최대 규모 모델은 수조 개 파라미터를 훌쩍 넘으니, 둘 다 '작은' 모델입니다.
결과 — 작은 모델이 범용 초거대 모델을 이겼다
논문이 7개 벤치마크에서 보고한 결과 중 눈에 띄는 것들만 골라 보면:
- 사실 검증: 근거 없는 금융 허위주장을 판별하는 RFC-Bench에서 Mint-Ag가 98.33%로, GPT-5.6-Sol보다 3.66점, Claude Opus 4.8보다 3.00점 앞섰습니다.
- 공시 질문답변: 재무제표 기반 질문에 답하는 FinanceBench 91.33%, 혼합 유형 비즈니스 분석 BizFinBench 55.71%(최강 외부 모델 대비 4.14점 차이).
- 장기 조사 실행: 인터넷 검색까지 동원해 답을 찾아야 하는 FinSearchComp T2 트랙에서 Mint-Ag는 89.04%, 그리고 놀랍게도 9B 소형 모델 Mint-Cu가 69.86%를 기록했습니다. 35B 경쟁 모델보다 22.83점이나 높은 점수입니다. 더 어려운 T3 트랙에서는 Mint-Ag가 최고 점수(54.07)와 동률을 이뤘습니다.
- 에이전트 벤치마크: FinanceAgentBench v1.1에서 76.00%(외부 최고 72.00%), v2에서 60.49%(외부 최고 56.79%).
여기에 하나가 더 있습니다. 바로 비용입니다. 연구진은 질문 하나를 풀 때 드는 비용과 정확도를 함께 그렸습니다.
- v1.1에서 Mint-Cu는 질문당 **0.090(약 117원)**에 최고 정확도 76.0%를 기록했습니다. 비교 모델들의 평균 비용이 질문당 $0.327(약 425원)이니, 가장 정확하면서 비용은 72.5%나 낮습니다.
- v2에서는 Mint-Ag가 질문당 **0.959(약 1,250원)인 GPT-5.6-Sol보다 정확도는 3.70점 높고 비용은 77.8% 낮았습니다. 두 모델 모두 정확도-비용 그래프의 '파레토 프런티어'(어떤 모델도 이보다 싸면서 정확할 수 없는 최적선) 위에 놓였습니다.
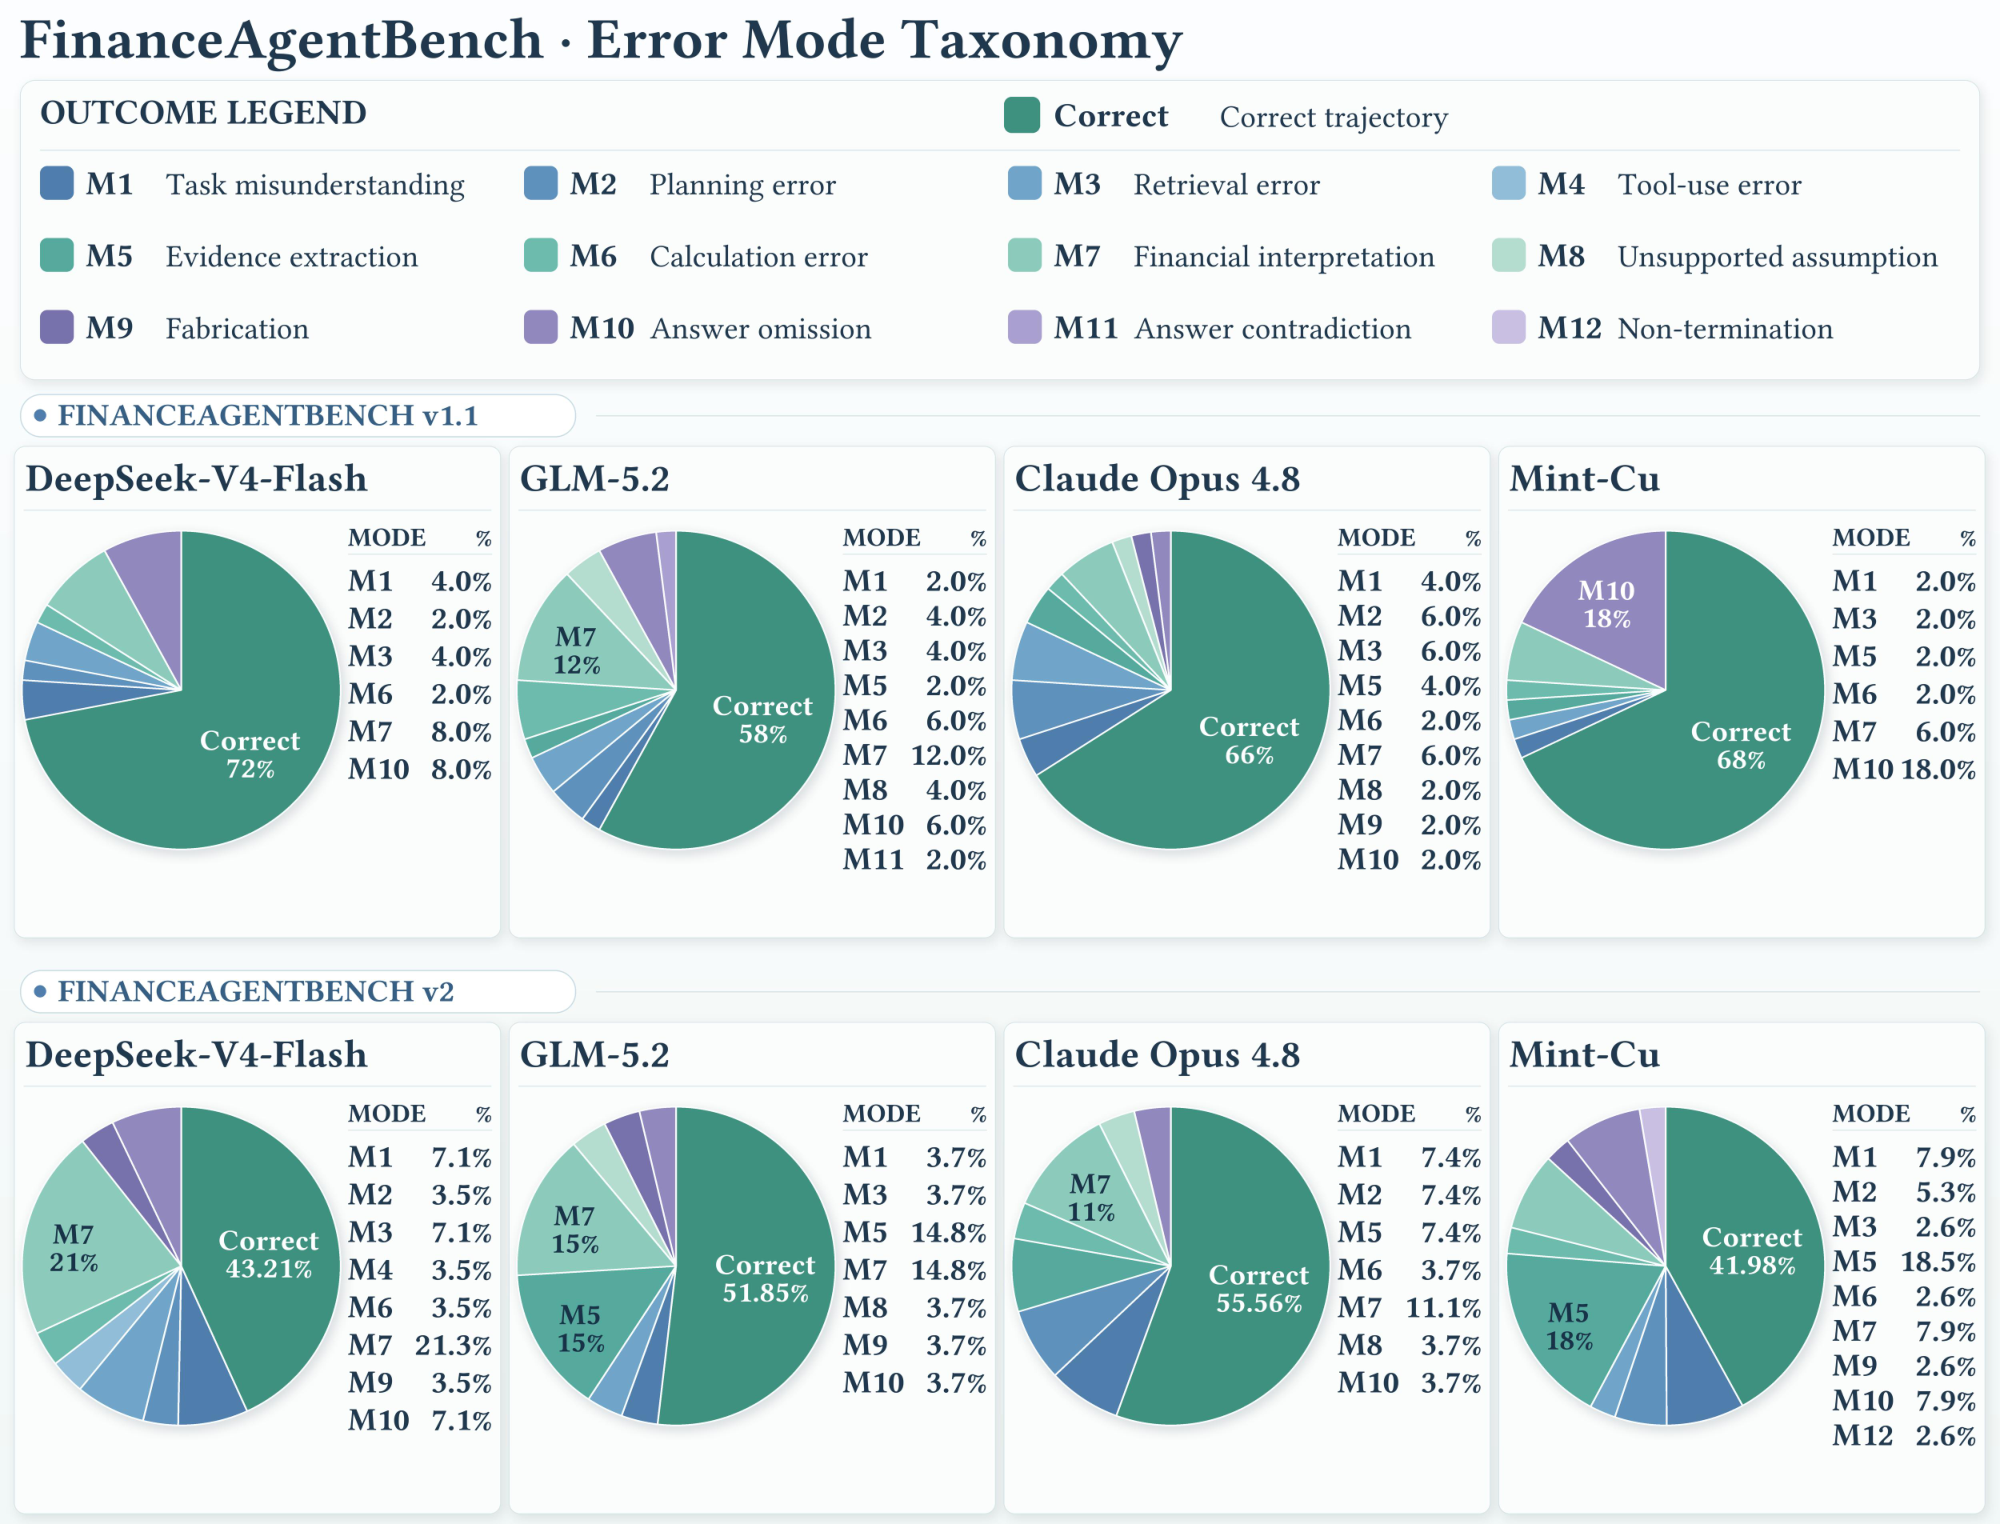
마지막으로 이 논문의 백미는 실패 분류학입니다. 금융·AI 배경의 박사 연구진이 모든 조사 과정을 직접 검토해 '가장 먼저 결정적인 오류가 어디서 발생했는지' 라벨링했습니다. 그 결과, 쉬운 v1.1에서 남은 실패의 대부분은 '답을 아예 쓰지 않음(18%)'이었고, 더 어려운 v2에서는 '근거 추출 실패(18.5%)'가 최대 병목으로 떠올랐습니다. 자료를 찾는 것보다, 찾은 자료를 '범위가 정확한 완결된 근거'로 만드는 게 더 어렵다는 뜻입니다. 성공률만 보여주는 연구가 흔한 가운데, "우리 모델은 여기서 진다"를 구체적으로 밝힌 점은 눈여겨볼 만합니다.
한계와 주의점 — 정직하게 읽어야 할 것들
- 트레이딩 수익을 검증한 논문이 아닙니다. 벤치마크는 금융 질문답변과 리서치 조사 능력을 측정합니다. 이 모델이 실제 투자 수익을 낸다는 뜻은 아니며, 포트폴리오 성과 검증은 별도 연구가 필요합니다.
- 어려운 벤치마크에서는 절반 이하. v2 정확도가 41.98%에 그칩니다. '완성된 금융 AI'라기보다 '현저히 개선된 현재 수준'으로 보는 편이 정확합니다.
- 비용은 'API 등가' 추정치입니다. 로컬에 돌린 모델에 베이스 모델 가격을 적용해 계산한 것이어서, 실제 서빙 비용·속도·운영 비용은 다를 수 있습니다. 비용 비교는 측정 조건에 좌우된다는 점을 유의하세요.
- 재현성에 물음표. 모델 가중치 공개 여부, 학습 데이터 규모, 보상 설계 상세가 제한적으로만 공개되어 있어 독립 재현은 부분적입니다. 벤치마크 중 일부는 연구진이 직접 만든 것도 있어 교차 검증이 필요합니다.
- 평가 관점에서도 우리 KB 기준 엄밀성 55, 재현성 40으로 상대적으로 낮습니다(아래 점수 참조). 개념과 적용성은 높게 평가된 논문입니다.
그래서 투자·실무엔?
일반 투자자와 실무자 관점에서 이 연구가 남기는 메시지는 세 가지입니다.
- AI 리서치 도구를 고를 때 '출처 추적'을 1순위로. 화려한 답변보다 "이 결론의 근거를 보여줘"라고 요구했을 때 문서 위치까지 되짚어 주는지가 핵심입니다. 이 논문의 근거 원장 패턴은 지금 나오는 AI 리서치 도구를 평가하는 체크리스트가 될 수 있습니다.
- 작고 싼 모델이 충분할 수 있다. 9B 모델이 조사 벤치마크에서 35B 모델을 크게 이긴 사실은, '무조건 큰 모델 API를 써야 한다'는 상식에 대한 반례입니다. 잘 만든 데이터와 실행 환경이 모델 크기보다 중요할 수 있습니다.
- '실패 지도'가 있는 시스템을 신뢰하라. 좋은 AI 시스템은 성공률만 자랑하지 않고 어디서 실패하는지 알고 있습니다. 자체 실패 원인을 분류해 공개하는 팀의 결과물이 그렇지 않은 팀보다 신뢰할 만합니다.
더 알아보기
- 원문: Mint-Agent: Introducing Finance-Native Agentic Foundation Models (arXiv:2608.16386) — 2026년 8월 17일 제출, 8월 21일 v2 수정.
- 우리 KB 5차원 점수: 개념 78 / 적용성 82 / 엄밀성 55 / 재현성 40 / 통찰 75 (종합 69.2, A 티어). 아이디어와 실용성은 높지만 엄밀성·재현성은 아쉬운 편이라는 점을 점수에 그대로 반영했습니다.
- 관련 논문: 같은 '파운데이션 모델' 축의 Kronos: A Foundation Model for the Language of Financial Markets (arXiv:2508.02739), 금융 에이전트의 능력을 파고드는 Knowledge or Calculator? Decomposing the Skill Premium in Verifiable Financial Tasks (arXiv:2610.03564), 시장 시뮬레이션 엔진 MarS (arXiv:2409.07486)도 함께 보면 흐름이 잘 잡힙니다.
(이 글은 OHSE AI Lab 시스템 트레이딩 리서치 KB의 2026년 8월 19일 수집 논문(A 티어)을 바탕으로 작성한 초안입니다. 발행 전 사실 확인과 윤문을 거칩니다.)
관련 글
 📰 데일리
2026-09-15 일일 블로그 — 초안 생략
2026-09-15 데일리 수집 논문 중 S/A 등급이 없어 블로그 초안을 생략합니다.
 📰 데일리
2026-09-15 일일 블로그 — 초안 생략
2026-09-15 데일리 수집 논문 중 S/A 등급이 없어 블로그 초안을 생략합니다.
 팩터 투자A
팩터 신호 상관이 수익률 상관과 다른 이유 — 정확한 수학적 증명
투자 신호 간 유사성과 실제 수익률 간 상관이 왜 다른지 정확한 분해식으로 밝힌 연구를 쉽게 풀어 설명합니다. 팩터 포트폴리오를 구성하는 분들에게 꼭 필요한 진단 도구를 소개합니다.