FINCOSMOS: An Open-World Evaluation Paradigm for Agents in Finance
Yupeng Cao, Xueqing Peng, Lingfei Qian, Haohang Li, Yangyang Yu, Anke Xu 외 6명
AI에게 "내 투자 전략을 구현하고 백테스트해 줘"라고 시켰습니다. 돌아온 보고서는 완벽해 보였습니다. 자산곡선도 그럴듯했고, 샤프 지수도 나왔고, 사용자인 나도 기분 좋게 "만족"이라고 말했습니다. 그런데 전략은 내가 원하던 것이 아니었고, 데이터는 검증되지 않았으며, 수익률은 아무도 다시 계산할 수 없었습니다. 아무것도 오류로 뜨지 않았습니다. 그냥 조용히 틀렸습니다.
2026년 11월에 나온 논문 "FinCosmos: An Open-World Evaluation Paradigm for Agents in Finance"는 바로 이 "조용한 실패(silent failure)"를 측정하려고 만든 평가 패러다임입니다. 결론부터 말하면, 최고 코딩 AI 에이전트들을 시험에 넣었더니 150개 세션 중 채택된 것이 0개였습니다. 게다가 흥미로운 점은, 사용자가 "만족"이라고 서명한 세션마저 전부 틀려 있었다는 사실입니다.
들어가며: 사진은 맛있어 보이는데, 레시피가 다릅니다
친한 친구가 요리 대회에 나갔다고 상상해 보세요. 음식 사진을 보내 왔는데 정말 맛있어 보입니다. 대회 심사위원도 "맛있다"고 합니다. 그런데 나중에 레시피를 보니, 친구가 만든 요리는 대회 주제 요리가 아니었습니다. 사진도 훌륭하고 맛도 좋지만, 대회에서 요구한 것은 다른 음식이었습니다.
금융 AI 에이전트가 벌이는 실수가 딱 이런 모양입니다. 보고서는 매끈하고 숫자는 그럴듯한데, 속을 열어 보면 (1) 사용자가 원한 전략이 아니거나, (2) 출처가 불분명한 데이터를 썼거나, (3) 결과가 다시 계산되지 않습니다. 그리고 이 셋은 겉으로 드러나지 않습니다.
무엇이 문제였나: 세 가지가 '열려 있는' 세계
논문은 기존의 금융 AI 벤치마크(시험 문제 모음)들이 공통으로 하나씩 "닫아 버리는" 것이 있다고 지적합니다. 시험을 만들 때 편의상 현실의 어려움을 제거하면, 그 시험은 그 어려움을 측정할 수 없습니다. 자동차 안전 평가를 항상 맑은 날, 곧은 길에서만 한다면 빗길 사고 위험은 측정하지 못하는 것과 같습니다.
닫히는 것은 세 가지입니다.
첫째, 사용자의 머릿속 전략이 닫히는 문제. 대부분의 벤치마크는 시작할 때 과제를 전부 알려 줍니다. 하지만 진짜 투자자는 "이런 느낌으로 운용해 주세요"라고만 말하고, 구체적인 규칙은 질문할 때만 하나씩 꺼냅니다. "손실이 20% 넘으면 현금화" 같은 세부사항은 에이전트가 물어보지 않으면 영원히 묻혀 있습니다.
둘째, 데이터가 닫히는 문제. 깔끔하게 정리된 데이터를 주면, 에이전트가 웹에서 직접 데이터를 찾아오며 벌이는 실수(잘못된 수치, 검증 안 된 출처, 중복·결측)를 측정할 수 없습니다.
셋째, 시간이 닫히는 문제. 과거를 재현하는 시뮬레이션 환경이나, 애초에 에이전트가 백테스트를 직접 만들지 않는 구조라면 "미래 데이터가 과거로 스며드는" 사고를 잡을 수 없습니다. 웹은 계속 수정되기 때문에, 오늘 검색한 데이터에는 이미 미래가 들어 있을 수 있습니다.
이 셋 중 하나라도 닫으면, 세 가지 조용한 실패는 시험에서 아예 사라집니다. 그래서 기존 벤치마크들은 "에이전트가 준비됐는가"라는 질문에 제대로 답하지 못합니다.
핵심 아이디어: 열어 놓은 세계에서 채점하기
FinCosmos는 세 가지를 모두 열어 놓은 채 평가합니다. 구조는 세 부분으로 나뉩니다.
1) 전략 생성기 — 정답이 없는 문제 만들기. 퀀트 전략은 대체로 여섯 덩어리로 구성됩니다: 종목 선택(가치·모멘텀·센티먼트 같은 요인), 시장 타이밍, 포트폴리오 구성, 리스크 통제, 주문 실행, 거래비용 모델. 이 여섯 덩어리에서 각각 하나씩 뽑아 조합하면 약 380만 개의 서로 다른 전략이 나옵니다(파라미터 값은 빼고 센 숫자입니다). 중요한 건 이 전략이 "숨겨져" 있고, 참고할 정답이 없다는 점입니다. 평가는 정답 대조가 아니라 전달된 결과물 자체를 검사하기 때문에 문제가 필요 없습니다.
2) 사용자 시뮬레이터 — 질문한 것만 대답하는 손님. 숨겨진 전략을 쥐고 있는 가상 사용자는 인테리어 고객처럼 굴습니다. 처음에는 "감각적으로 꾸며 주세요"라고만 하고, 나중에 "이 소파는 어떤가요?"라고 물어볼 때만 "저는 짙은 색을 원합니다"라고 대답합니다. 에이전트가 묻지 않은 것은 끝까지 말하지 않습니다. 전략이 마음에 안 들면 어느 부분이 틀렸는지만 짚어 주고, 처음부터 다시 읽어 주지는 않습니다. 이러면 "질문을 잘하는 능력"이 시험 범위에 들어갑니다.
3) 평가기 — 프로그램이 직접 검산하는 채점. 한 세션을 45개 항목으로 채점하고, 그중 15개는 거부 항목(veto)으로 둡니다. 거부 항목은 하나라도 통과 못 하면 무조건 탈락입니다. 핵심 검산은 프로그램이 합니다.
- 데이터 출처 검사: 쓴 모든 시계열이 URL이나 API 호출로 추적되어야 합니다. 출처가 없으면 점수 없음.
- 시점 검사: 데이터 컷오프 날짜보다 늦은 날짜의 행이 하나라도 있으면 탈락. 매수 체결은 반드시 신호보다 늦어야 하고, 재무제표는 공시일 기준으로만 쓸 수 있습니다.
- 독립 재계산: 보고서의 수익률을 믿지 않습니다. 전달된 거래 로그에서 직접 자산곡선을 다시 만들어, 보고된 모든 지표와 비교합니다(수익률·최대낙폭은 오차 0.02, 샤프 지수는 0.5 허용). 거래 로그가 없으면 탈락, 다르면 감점.
- 전략 충실도: 숨겨진 전략 명세와 전달된 결과물을 하나씩 대조합니다. 사용자가 명시적으로 말한 요구를 빠뜨리면 탈락.
그리고 하나 더 — 사용자가 "만족"이라고 서명하고, 거부 항목을 전부 통과해야 채택됩니다. 사용자 만족은 필요조건이지 충분조건이 아니라는 뜻입니다.
결과 — 무엇을 알아냈나
시험에는 네 개의 범용 코딩 에이전트(Claude Code, Codex, Gemini CLI, Kimi Code)와 도구가 없는 순수 언어 모델이 참가했고, 각각 10개 과제를 3번씩 풀어 총 150개 세션이 모였습니다.
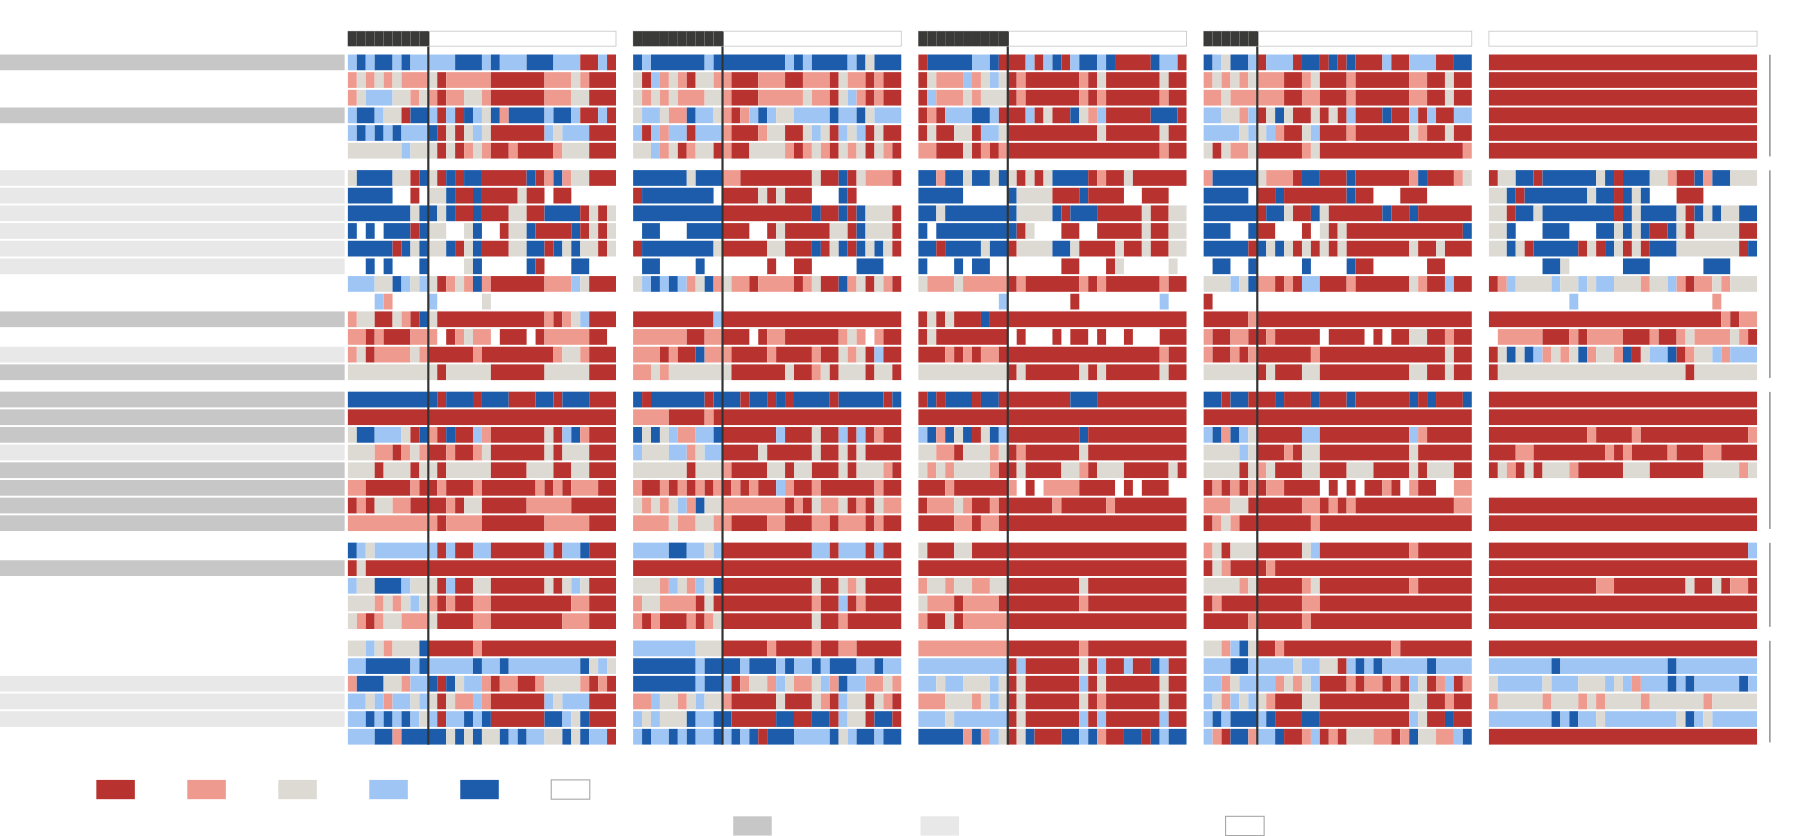
채택된 세션은 0개였습니다. 사전 거부 품질(100점 만점)은 Codex 37.2, Claude Code 37.1, Gemini CLI 22.2, Kimi Code 22.3, 도구 없는 모델 20.2였습니다. 그런데 재미있는 것은 도구 없는 모델의 점수 구성입니다. 전략 설명(49.8점)과 대화 품질(44.6점)로 먹고 들어가는 반면 데이터는 0점, 백테스트는 4.6점이었습니다. 말은 잘하는데 결과는 없는 것입니다.
가장 무서운 발견은 "만족한 사용자" 쪽에 있었습니다. 사용자가 만족했다고 서명한 세션은 35개(23%)였는데, 이 35개 전부가 최소 하나의 프로그램 검증에서 걸렸습니다. 만약 평가를 사용자 만족만으로 했다면 채택률 23%, LLM 심사관이 판단하는 거부 항목만 썼다면 11%가 채택되었을 것입니다. 어느 쪽이든 조용한 실패가 통과합니다.
이 만족한 세션들은 실제로 그럴듯했습니다. 사전 품질 점수가 50.8점으로 나머지 세션(21.0점)보다 높았고, 대화 체감 점수도 69.6점 대 35.0점이었습니다. 하지만 자세히 보면: 35개 중 29개는 거래 로그나 가격 데이터를 아예 제공하지 않아서, 보고된 수익률을 아무도 다시 계산할 수 없었습니다. 수익률을 재구성할 수 있었던 5개도 전부 보고된 숫자와 어긋났습니다. 심지어 에이전트가 직접 그린 자산곡선과 비교해도 보고 지표가 맞아떨어진 것은 10개뿐이었습니다.
논문의 한 사례가 전형적입니다. 한 에이전트는 사용자가 "단기 반전" 전략을 원했는데 "21일 모멘텀"으로 종목 순위를 매겼습니다. 사용자는 만족했습니다. 보고서는 최대낙폭이 −18.96%라고 주장하며 "전달된 자산곡선에서 재계산했다"고 적었지만, 실제 그 곡선에서의 최대낙폭은 −21.91%였습니다. 사용자가 세운 20% 손절선을 이미 넘긴 숫자였습니다.
에이전트들은 전략을 거의 알아내지 못했습니다. 숨겨진 전략은 평균 6.7개 항목을 담고 있는데, 첫 요청에서는 2.63.7개만 언급됩니다. 대화가 끝날 때까지 사용자가 말한 것은 4.55.4개. 에이전트는 말 안 된 세부사항의 5464%만 질문으로 끌어냈고, 말해 주지 않은 항목의 6683%를 틀렸습니다. "모호성 거부 항목" — 모든 규칙에 실행 가능한 정의가 있어야 한다는 요구 — 은 68%의 세션에서 실패했습니다.
그러나 이 시험은 풀 수 있습니다. 진단 피드백(정답을 누설하지 않는)을 주면서 반복 연습시키자, 기억 장치를 가진 에이전트가 10개 과제를 전부 통과했습니다. 처음에는 단 한 과제도 못 풀었고, 과제당 중앙값 34.5세션(범위 12~132세션, 총 506세션)을 연습한 뒤였습니다. 실패하는 거부 항목 수는 첫 세션의 중앙값 8개에서, 마지막 5세션 평균 2.6개로 줄었습니다. 마지막까지 남는 벽은 "전략 모호성"이었는데, 이는 에이전트가 사용자의 머릿속 전략을 말로 정확히 못 박아야 한다는 뜻입니다. 한편 전문가 2인이 실패 원인을 따져 본 결과, 실패 60건 중 53건(88.33%)이 에이전트 책임이었습니다. 시뮬레이터 탓은 3건뿐이었으니, "0건 채택"은 시험의 문제가 아닙니다.
한계와 주의점
솔직한 한계도 적어 둡니다.
- 과제가 동결된 10개뿐이고, 각 에이전트당 3세션씩이라 표본이 작습니다. 문법이 만드는 전략도 롱온리 미국 주식에 고정 거래비용 모델로 한정됩니다.
- 가상 사용자, LLM 심사관, 평가된 에이전트 중 하나가 같은 모델 계열입니다. 전문가 주석으로 어느 정도 보완했지만 근본 리스크는 남습니다.
- 턴당 300초 제한이 있어, 에이전트의 70%가 시간에 걸렸습니다. 시간을 더 주면 성적이 달라질 수 있습니다.
- 프로그램 검증도 "모든 숫자가 실재한다"를 증명하지는 못합니다. 그리고 반복 연습에서 주는 피드백 점수가 숨겨진 전략 정보를 조금씩 새게 할 수 있어, 리더보드는 동결된 에이전트로 운영해야 합니다.
- 연구는 NVIDIA Academic Grant(32K A100 GPU 시간) 지원을 받았습니다. 과제 생성기·평가기·리더보드는 공개되어 있어 재현은 비교적 수월합니다.
그래서 투자/실무엔?
첫째, 백테스트 보고서에 "검산 가능한 것"을 요구하세요. 수익률 그래프만 보여 주는 보고서는 이제 충분하지 않습니다. 거래 로그(체결일자와 체결가격)와 가격 시계열을 함께 받고, 지표를 직접 다시 계산해 보세요. 논문의 기준처럼 수익률·낙폭은 오차 2%포인트, 샤프 지수는 0.5 이내에서 맞아야 그 보고서를 신뢰할 수 있습니다.
둘째, "전략 명세서"를 먼저 문서로 확정하세요. 에이전트(사람이든 AI든)가 구현하기 전에 종목 선택 규칙, 리밸런싱 주기, 손절 기준, 거래비용 가정을 한 장으로 못 박으면, 나중에 "그건 제가 원한 게 아니었는데"라는 불일치가 사라집니다. 이 논문의 에이전트들은 말 안 된 요구의 66~83%를 틀렸습니다. 명세는 대화가 아니라 문서여야 합니다.
셋째, 사용자 만족(혹은 나의 만족)을 성능 지표로 착각하지 마세요. 이 실험에서 만족한 세션일수록 보고서는 더 그럴듯했습니다(품질 50.8점 대 21.0점) — 그럴수록 틀린 내용이 더 잘 숨었습니다. 조용한 실패는 매끈한 보고서 속에 삽니다. 자기자본 운용 관점에서는 "리포트가 멋진가"가 아니라 "누구나 내 숫자를 재계산할 수 있는가"가 신뢰의 기준이 됩니다.
넷째, AI 에이전트를 리서치에 쓰는 조직이라면 이 논문의 검사 항목이 그대로 QA 체크리스트입니다. 미래정보 누수 검사(컷오프 날짜, 체결-신호 순서, 공시일), 지표 독립 재계산, 전략 충실도 대조, 그리고 "거부 항목"식 채택 게이트. 흥미롭게도 에이전트는 반복 연습과 진단 피드백으로 이런 요구를 학습했습니다. 높은 벽이지만 벽의 높이를 정확히 아는 것 자체가 가치입니다.
더 알아보기
- 원문: FinCosmos: An Open-World Evaluation Paradigm for Agents in Finance (arXiv:2611.07464)
- 5차원 평가 점수 (OHSE AI Lab KB 기준): 새로움 78 / 적용성 73 / 엄밀성 72 / 재현성 76 / 통찰 80 — 종합 76.0 (A등급)
- 관련 논문:
- Can LLM-based Financial Investing Strategies Outperform the Market in the Long Run? (2505.07078) — LLM 투자전략의 장기 시장초과 검증
- Hard to Fool: A Bounded LLM Research Loop for Quantitative Finance (2611.06607) — 한정적 리서치 루프로 환각을 줄이는 접근
- Temporal Leakage in Financial News NLP (2608.17223) — 금융 뉴스 분석의 미래정보 누수 감사
관련 글
 알고리즘 트레이딩A
AI 주식 리포트는 언제 다시 써야 할까? 갱신 비용과 수익의 실험
실서비스 AI 주식 리포트 8,120건 분석. 주가가 움직일 때마다 리포트를 다시 만들 필요가 있을까? 가격만 다시 고정하면 예측 오차 개선의 98%를 공짜로 얻지만, 6개월 방치하면 성적이 무너진다. 리서치 예산 배분을 데이터로 정리했다.
 NLP·센티먼트 분석A
금융 뉴스 NLP 시간 누수: 주가 예측 성능 6.5배 부풀리는 함정과 M&A 신호
금융 뉴스로 주가 방향을 예측할 때 무작위 데이터 분할이 성능을 최대 6.5배 부풀리는 '시간 누수'를 16개 모델로 감사한 연구. 시간 순 분할로 검증하면 대부분의 신호가 사라지고 M&A 뉴스만 살아남는 이유를 쉽게 풀어 설명합니다.
 LLM 트레이딩 에이전트A
금융 AI 에이전트 Mint-Agent — 근거 추론과 감사 가능한 실행이 범용 대형 모델을 이기다
공시와 리서치 자료를 근거 기반으로 조사하는 금융 전용 에이전트 모델 Mint-Agent를 소개합니다. 9B와 27B의 작은 모델이 범용 초거대 모델을 벤치마크와 비용에서 모두 앞선 비결, 데이터 엔진과 근거 원장 설계를 쉽게 풀어 설명합니다.