When Is Fresh AI Stock Analysis Worth It? Allocating a Limited Research Budget Across Price Updates, Deep Forecast Refreshes, and Editorial Reviews of Top Stock Picks
Russlan Ramdowar
AI가 써 주는 주식 리포트, 주가가 조금만 움직여도 다시 써야 할까요? 이 질문에 대해 "대부분은 안 해도 된다. 하지만 완전히 방치하면 큰일 난다"고 데이터로 답한 연구가 나왔습니다.
요즘 투자 리서치 세계에서는 AI 에이전트가 기업을 분석하고 목표 주가를 매긴 리포트를 대량으로 생산합니다. 문제는 비용이에요. 리포트 하나를 새로 만들려면 여러 AI가 자료를 찾고, 계산하고, 토론하고, 정리해야 합니다. 이걸 주가가 움직일 때마다 수백 개 종목에 반복하면? "리포트 갱신에 쓴 돈이 그 리포트로 번 돈보다 많아지는" 상황이 옵니다.
오늘 소개할 논문은 실서비스에서 생성된 8,120건의 AI 주식 리포트를 아카이브로 모아, "언제 다시 분석하고, 언제 그냥 두는가"의 비용 대비 효과를 처음으로 정밀 측정했습니다.
들어가며: 새 차를 살까, 오일만 갈까?
생각해 보세요. 내비게이션 앱이 매일 새 버전으로 갱신된다고 해서, 네비를 매일 새로 사는 사람은 없습니다. 목적지가 안 바뀌었다면 지도만 업데이트하면 되니까요. 하지만 갑자기 도로가 막히거나 우회로가 생기면(큰 사건!), 그때는 제대로 된 새 정보가 필요합니다.
AI 투자 리서치도 비슷합니다. 한 기업에 대한 "1년 뒤 목표 주가 120달러"라는 분석은, 지금 주가가 100달러에서 110달러로 올랐다고 해서 하루아침에 쓸모없어지지는 않습니다. 그런데 6개월이 지나 시장 상황이 완전히 달라지면? 그때는 이야기가 달라집니다.
이 논문은 이 "언제까지 옛 분석이 살아 있는가"를 — 연구진이 논지 반감기(thesis half-life)라고 부르는 문제입니다 — 실데이터로 저울질합니다.
무엇이 문제였나: "다시 만들기"는 생각보다 비쌉니다
iPulse AI라는 실제 투자 리서치 플랫폼(이 논문의 연구진이 만든 시스템입니다)은 여러 AI 에이전트가 협업해 종목 리포트를 만듭니다. 연구진은 이 플랫폼의 실제 생산 기록을 아카이브했어요:
- 동일한 203개 종목에 대해 4개 배치에 걸쳐 생성된 8,120건의 리포트
- 7개 투자 프레임워크, 10개 일치하는 에이전트 구성
- 리포트 생성에 쓴 토큰만 약 1억 개
이 리포트들을 두고 네 가지 "갱신 정책"을 비교했습니다.
- 구 목표 유지 + 현재가 반영: 예전에 매긴 목표 주가를 오늘 주가에 맞춰 다시 계산만 합니다. (예: "목표 120달러, 현재가 110달러 → 남은 상승 여력 9.09%")
- 충격 가드 포함 재고정: 같은 방식인데, 주가가 폭락·폭등해 원래 논지가 깨진 종목은 감시 표시를 붙입니다.
- 기계적 경로 재정박(reset): AI 추론 없이, 예전에 예측한 "성장 곡선"을 오늘 주가 위치에 그대로 옮겨 붙입니다.
- 전면 재생성: 멀티 에이전트에게 리포트를 처음부터 다시 씁니다. (가장 비쌉니다)
성과는 간단한 방법으로 봤습니다. 리포트가 예측한 1년 뒤 수익률 상위 Top 10 종목을 같은 비중으로 사서 들고, 거래비용(0.1%)과 리서치 비용(전체 유니버스 1회 실행에 3,000달러 — 30만 달러 계좌의 1%, 약 390만 원)을 뺀 나머지를 비교한 거예요.
핵심 아이디어: "가격만 다시 고정"하면 어디까지 버틸까
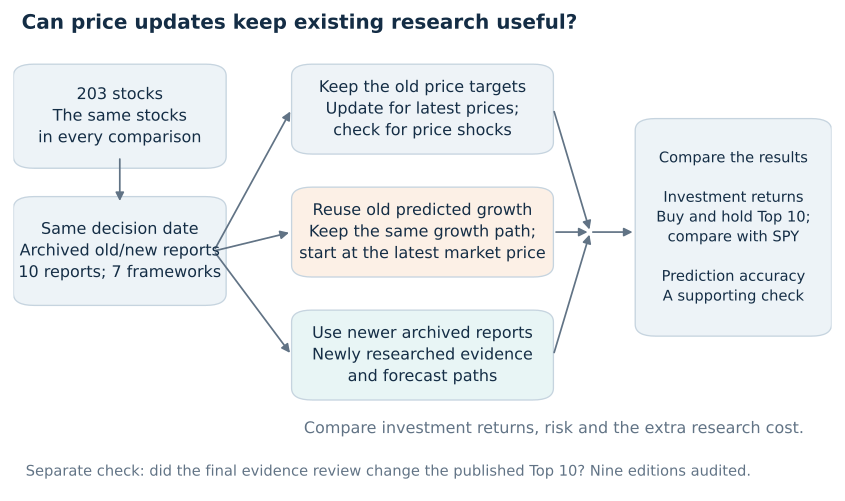
핵심 질문은 이겁니다. "새로 분석하는 것"의 가치 중에서, "가격 숫자만 업데이트하는 것"으로 공짜로 얻을 수 있는 부분이 얼마나 되는가?
이걸 분리해 보려면 예측 오차를 자세히 봐야 합니다. 논문은 90일 뒤 분기 수익률 예측의 평균 절대 오차(MAE)를 측정했는데, 수치가 아주 재밌습니다.
- 옛 목표 그대로 두기: 오차 15.26%p
- AI가 리포트를 새로 생성: 오차 13.51%p (1.75%p 개선!)
- 가격만 기계적으로 재정박: 오차 13.55%p
읽어 보세요. AI가 밤새워 리포트를 새로 써서 얻은 예측력 개선의 98%를, 계산기 두드려 가격만 다시 고정하는 것으로 공짜로 재현할 수 있다는 뜻입니다. 잔여 격차는 0.04%p에 불과해요.
잠깐, 그러면 리포트를 새로 쓸 필요가 없는 거 아닌가요? 여기에 이 논문의 진짜 묘미가 있습니다.
결과 — 무엇을 알아냈나
1) 3개월 보유라면 "구 리포트 + 가격 갱신"이 충분했습니다
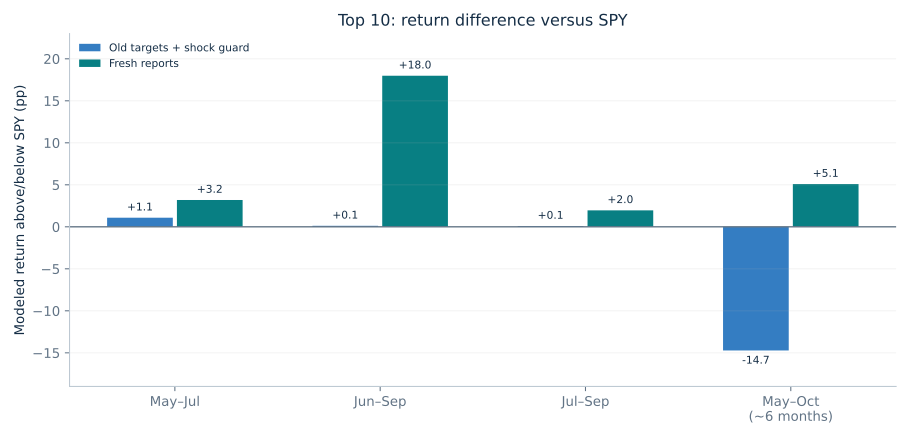
동일 모델로 만든 두 배치 구간에서 평균을 보면:
| 정책 | 3개월 보유 수익률 |
|---|---|
| 구 목표 + 충격 가드 (추론 비용 0원) | 2.25% |
| SPY (시장 전체) | 1.66% |
| 신규 리포트 생성 (비용 차감 후) | 4.24% |
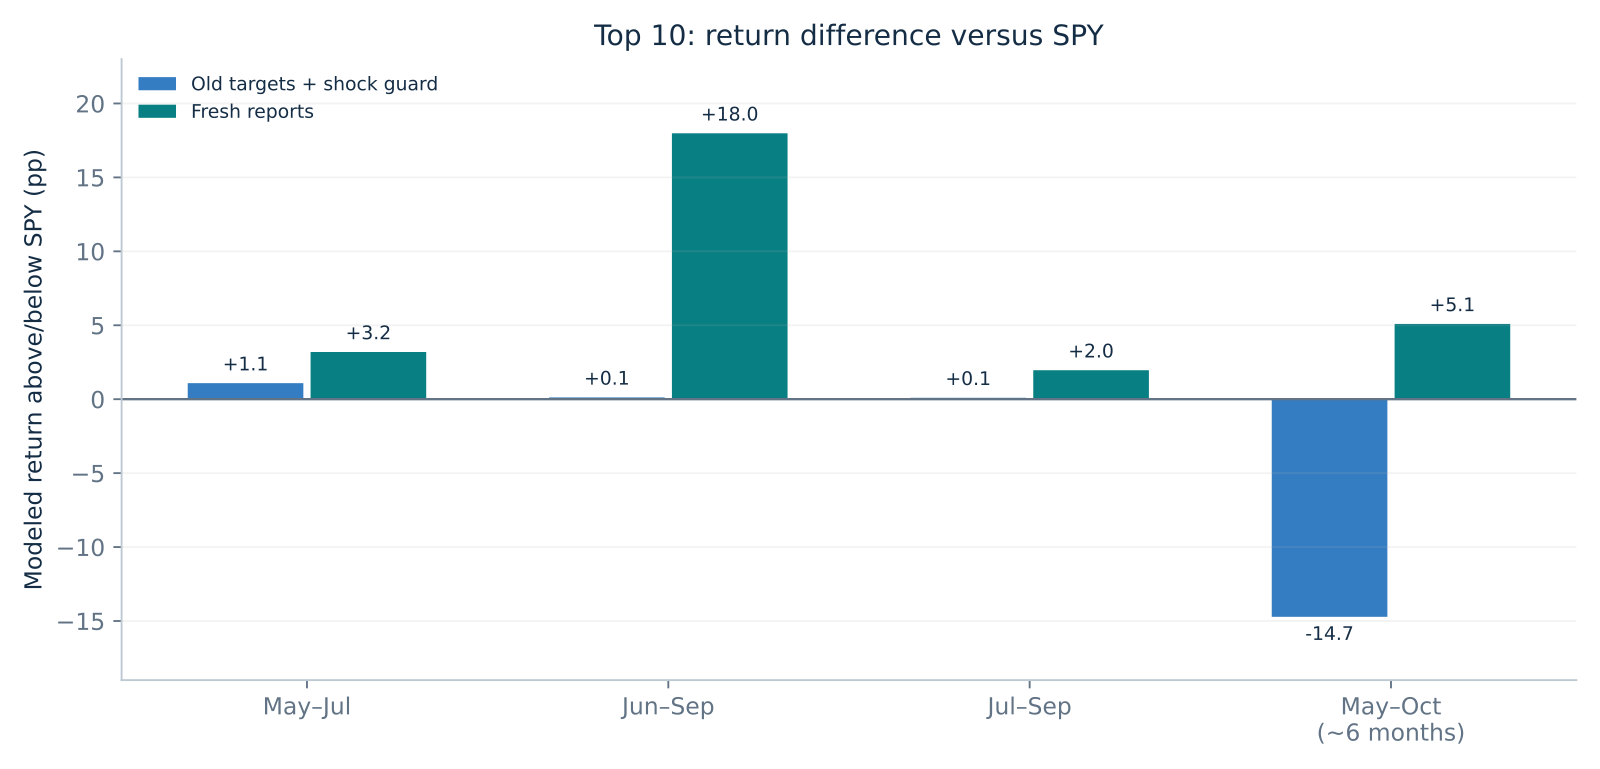
가드된 구 목표는 세 개의 3개월 구간 전부에서 SPY를 이겼습니다(2.44% vs 1.36%, 4.59% vs 4.47%, 2.06% vs 1.97%). 추가 AI 추론 비용은 단 한 푼도 안 쓰고요. 신규 리포트가 더 높은 건 사실이지만(4.24%), 그건 3,000달러 리서치 비용을 계좌에서 빼고도 남는 값이에요.
2) 하지만 6개월 방치는 재앙이었습니다 — "논지 반감기"
5월에 만든 리포트로 고른 Top 10을 6개월(176일) 동안 아무 갱신 없이 들고 가면:
- 구 목표 + 충격 가드: -11.26%
- 신규 리포트로 갱신: +8.55%
- SPY: +3.46%
무려 20%p 가까운 격차입니다. 3개월까진 "그냥 두고 가격만 고정"이 답이었는데, 6개월이 되면 상황이 완전히 뒤집힙니다. 이게 바로 논지 반감기예요. 리포트라는 자산도 유통기한이 있다는 뜻입니다.
3) "평균 오차는 같은데 종목은 완전히 다르다" — 정확도와 선택의 역설
가장 흥미로운 발견입니다. 새로 쓴 리포트와 가격만 재정박한 것의 예측 오차는 0.04%p로 거의 같은데, 둘이 고르는 Top 10 종목이 1~4개만 겹쳤습니다(10개 중 1개, 4개, 4개). 예측을 종목별로 쭉 세워 보면 순위 상관이 0.59~0.73에 그치거든요.
평균 오차는 통계적 요약일 뿐, 포트폴리오는 "가장 위쪽 꼬리"에서 종목을 고릅니다. 아주 작은 예측 차이가 선택 결과를 완전히 뒤바꿀 수 있어요. 그래서 Top 10 대신 Top 30으로 넓히면 결과가 또 뒤집힙니다 — 이 경우엔 구 목표 재사용이 4.17%로 신규 리포트(1.37%)를 이깁니다. 또한 첫 구간에서 신규 Top 10 포트폴리오의 최대 낙폭은 16.8%로, SPY(4.5%)보다 훨씬 깊었습니다. 한두 종목의 대박(이 데이터에선 MRNA)에 성적이 매달리는 구조예요.
4) 그러면 주기적으로 새로 만들면? — 비용의 벽
전체 유니버스 리포트 1회 생성은 3,000달러(약 390만 원), 계좌의 1%입니다. 주간(weekly)으로 돌리면 비용이 눈덩이처럼 쌓여 실현 수익을 훨씬 넘어섭니다. 월간으로 돌리면 갱신의 실현 가치에 겨우 근접하는 수준. 연구진이 제안하는 답은 "무조건 주기적으로"가 아니라 "증거가 있을 때만"입니다.
한계와 주의점
솔직하게 말씀드려야죠.
- 회고적 연구입니다. 리포트 생성 자체는 시장 결과가 나오기 전에 이루어진 실기록이지만, 비교 실험 설계는 사후에 짰습니다.
- 관측 기간이 짧습니다. 2026년 5~7월의 세 번 갱신 시점에 집중되어, 다른 시장 국면(예: 강세장 전환)에서도 같은 결론이 나올지는 모릅니다.
- 203종목, 단순 포트폴리오. 등가중 매수 후 보유라는 단순한 규칙으로 실험했고, 실제 운용의 리스크 스코어링·슬리피지·주문 임팩트는 반영하지 않았습니다. 한 마디로 "이상적으로 간소화한 실험실 조건"입니다.
- 3,000달러라는 리서치 비용도 실제 청구서가 아니라 계획용 가정치입니다.
- "논지 반감기가 6개월이다"라는 보편 법칙으로 읽으면 곤란합니다. 이 데이터에서 6개월 방치가 나빴다는 것이지, 최적 주기를 공식으로 제시한 게 아닙니다.
그래서 투자/실무엔?
일반 독자분들이 가져가실 메시지는 이겁니다.
- "매번 다시 분석"이 기본값은 아닙니다. AI 리서치를 운영할 땐, 분석을 자산처럼 모아 두고 가격만 꾸준히 갱신하는 편이 3개월 시계에서는 유리했습니다. 요즘 서비스들이 "매일 AI 리포트 갱신!"을 자랑해도, 그게 항상 투자자에게 이득인지는 별개 문제라는 뜻이에요.
- 다만 방치는 위험합니다. 리포트에도 유통기한이 있습니다. 장기 보유 전에는 최소한 한 번은 제대로 다시 봐야 한다는 교훈.
- 리포트 갱신이 필요하다는 "증거"를 모으세요. 논문의 처방은 우아합니다. 주가 충격, 실적 발표, 큰 뉴스 같은 사건이 있을 때만 심층 재분석을 트리거하고, 나머지 때는 가격 감시만으로. 그리고 사람(에디터)의 역할은 "다시 쓰기"가 아니라 "증거 검사" — 논지가 깨졌는지 확인하는 일입니다.
- AI 투자 리포트의 정확도를 맹신하지 마세요. 평균 예측 오차가 개선된다고 그 리포트가 고르는 종목이 나아지는 건 아닙니다. 이 논문의 "정확도–선택 역설"은 AI 리서치 서비스를 평가할 때 반드시 물어봐야 할 질문입니다.
더 알아보기
- 원문: When Is Fresh AI Stock Analysis Worth It? (arXiv:2611.04348)
- KB 5차원 점수 (참고): 새로움 68 / 적용성 79 / 엄밀성 72 / 재현성 78 / 통찰 76 — 종합 75.6 (A등급). 특히 "적용성"과 "재현성"이 높은, 실무 검증형 연구입니다.
- 함께 읽기 좋은 논문:
- The Alpha Illusion: Reported Alpha from LLM Trading Agents (arXiv:2605.16895) — LLM 트레이딩 에이전트가 보고하는 수익률을 어떻게 의심해야 하는가
- Time Travel is Cheating: Going Live with DeepFund (arXiv:2505.11065) — 실시간 투자로 나아가는 AI 펀드 에이전트의 현실 점검
- The Cost of Misspecifying Price Impact (arXiv:2306.00599) — 백테스트에서 거래비용을 잘못 잡으면 얼마나 왜곡되는가
관련 글
 LLM 트레이딩 에이전트A
금융 AI 에이전트 벤치마크 FinCosmos: 만족한 사용자, 틀린 백테스트
사용자는 만족했지만 백테스트는 틀렸다. 금융 AI 에이전트 평가 벤치마크 FinCosmos가 150개 세션에서 드러낸 '조용한 실패'와, 미래정보 누수·전략 불일치·재현 불가 보고서를 잡아내는 백테스트 검증 방법을 쉽게 정리합니다.
 알고리즘 트레이딩A
LLM 퀀트 전략 발굴, 거짓 발견을 막는 '속기 어려운' 연구 루프
자동 전략 발굴 루프가 백테스트 과적합과 룩어헤드 편향을 양산하는 이유. LLM은 아이디어만 제안하고 고정된 코드가 판정하는 퀀트 연구 루프가 약 24개 캠페인에서 무엇을 발견하고 무엇을 거절했는지, QQQ 0DTE 전략의 몰락 사례와 함께 정리했습니다.
 시계열 계량경제학A
백테스트는 언제 멈출까? AI가 전략을 쏟아내는 시대의 합격 게이트
AI 리서치 에이전트가 쏟아내는 매매 전략 후보를, 데이터에 기대어 아무 때나 들여다봐도 거짓 '합격' 확률을 영구히 통제하는 PROMOTE 프로토콜을 쉽게 풀어 설명합니다. 무보정 반복 검정은 94.5%에서 거짓 승격을 만드는 반면 이 방법은 0.0%라는 놀라운 실험 결과까지.