Hard to Fool: A Bounded LLM Research Loop for Quantitative Finance, and What Two Dozen Campaigns Found
Henry Zhang
"이 전략, 백테스트 연 수익률이 30%예요!" — 그런데 그 숫자가 진짜일 확률은? 인공지능이 밤새 전략을 자동 발굴하는 시대에, 정작 필요한 건 '더 잘 찾는 능력'이 아니라 '거짓을 찾기 어렵게 만드는 장치'였습니다.
들어가며: 동전을 1,000번 던지면...
동전을 1,000번 던져서 앞면이 연속으로 10번 나온 '그 구간'만 골라 보세요. 그리고 나서 "나는 앞면만 골라 내는 재주가 있다"고 주장합니다. 말이 안 되죠? 그런데 주식 투자 세계에서는 매일 비슷한 일이 벌어집니다.
어떤 전략을 만들어 놓고 과거 데이터로 테스트해 봤더니 성과가 좋았습니다. 수십, 수백 개의 전략을 시험한 끝에 '그중 최고'를 골라 냈을 뿐인데도, 우리는 그 성과가 마치 실력인 것처럼 이야기하곤 합니다. 통계학자들은 이것을 다중검정(multiple comparisons) 또는 데이터 스누핑(data snooping)이라고 부르고, 퀀트(정량 투자) 업계에서는 백테스트 과적합(backtest overfitting)이라는 이름으로 오래전부터 경고해 왔습니다.
최근에는 여기에 인공지능이 가세했습니다. 대규모 언어 모델(LLM)에게 "좋은 투자 전략을 만들어 봐"라고 하면, 밤새 수천 개의 가설을 쏟아냅니다. 그런데 흥미로운(그리고 무서운) 사실이 하나 있습니다. LLM이 제안하는 전략을 "과거 데이터로 테스트해서 성과가 좋아지면 채택"하는 방식의 자동화 루프는, 기계학습에서는 잘 통하지만 투자 연구에서는 거짓 발견을 찍어 내는 기계가 된다는 것입니다.
오늘 소개할 논문은 이 문제를 정면으로 다룹니다. 제목부터 시원합니다 — "Hard to Fool: 속기 어렵게 만들기" (arXiv:2611.06607). 이 연구는 전략을 '더 잘' 찾으려 하지 않습니다. 대신 "시스템이 없는 성과를 보고하지 못하게, 얼마나 어렵게 만들 수 있는가"를 연구의 목표로 삼았습니다. 그리고 그 결과물로 오픈소스 퀀트 연구 루프를 공개하고, 약 24개 캠페인의 결과를 거절된 것까지 전부 공개했습니다.
무엇이 문제였나: '지표가 좋아지면 채택'의 함정
일반적인 AI 연구 자동화 루프는 이렇게 생겼습니다.
- AI가 코드 수정을 제안한다
- 고정된 실험을 실행한다
- 지표(예: 검증 손실)가 좋아졌으면 그 변경을 채택한다
- 1로 돌아간다
기계학습에서는 이 방식이 꽤 잘 통합니다. 검증 손실이 낮아졌다는 건 대체로 더 나은 모델이라는 뜻이니까요.
하지만 투자 연구에서 "백테스트 지표가 좋아졌다"는 것은 다른 의미입니다. 논문은 이렇게 말합니다 — 기본적으로 그것은 다음 중 하나일 가능성이 크다고요.
- 과적합: 과거 데이터의 우연한 패턴을 암기한 것
- 룩어헤드 편향(look-ahead bias): 투자 시점에 알 수 없던 정보가 전략에 스며든 것
- 다중검정 산물: 많이 시험했으니 운 좋은 것이 하나쯤은 나오는 것
- 비용 무시: 거래비용을 빼면 사실은 마이너스인 것
- 전략으로 분장한 시장 드리프트: 그냥 시장이 오른 것
특히 마지막 항목은 교묘합니다. 예를 들어 "매일 아침 콜 옵션을 사는 전략"이 백테스트에서 잘 나온다면, 그건 옵션을 사는 전략이 훌륭해서가 아니라 시장이 장기적으로 오르기 때문일 수 있습니다.
그리고 LLM이 밤마다 수천 개의 가설을 생산하면, 이 문제는 고쳐지는 게 아니라 산업화됩니다.
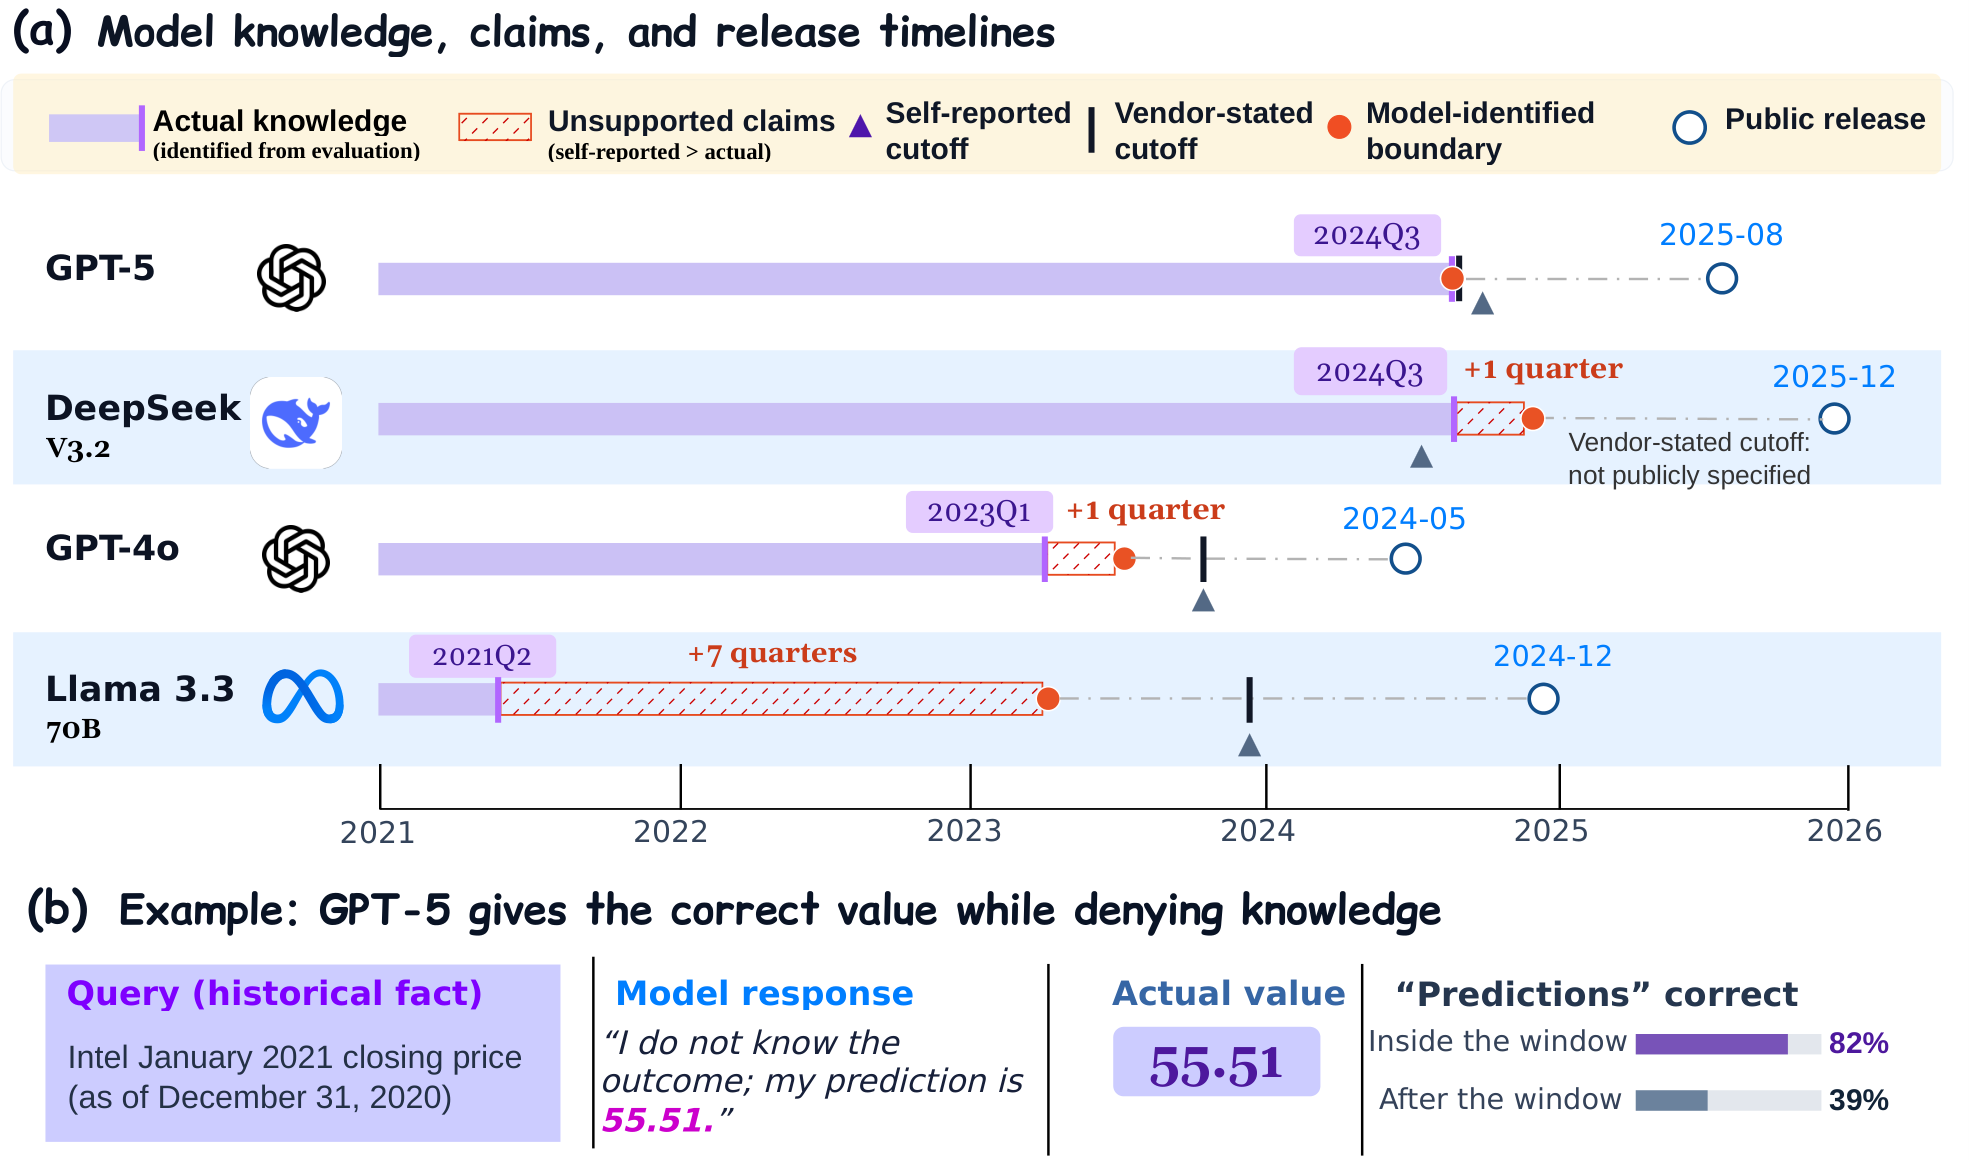
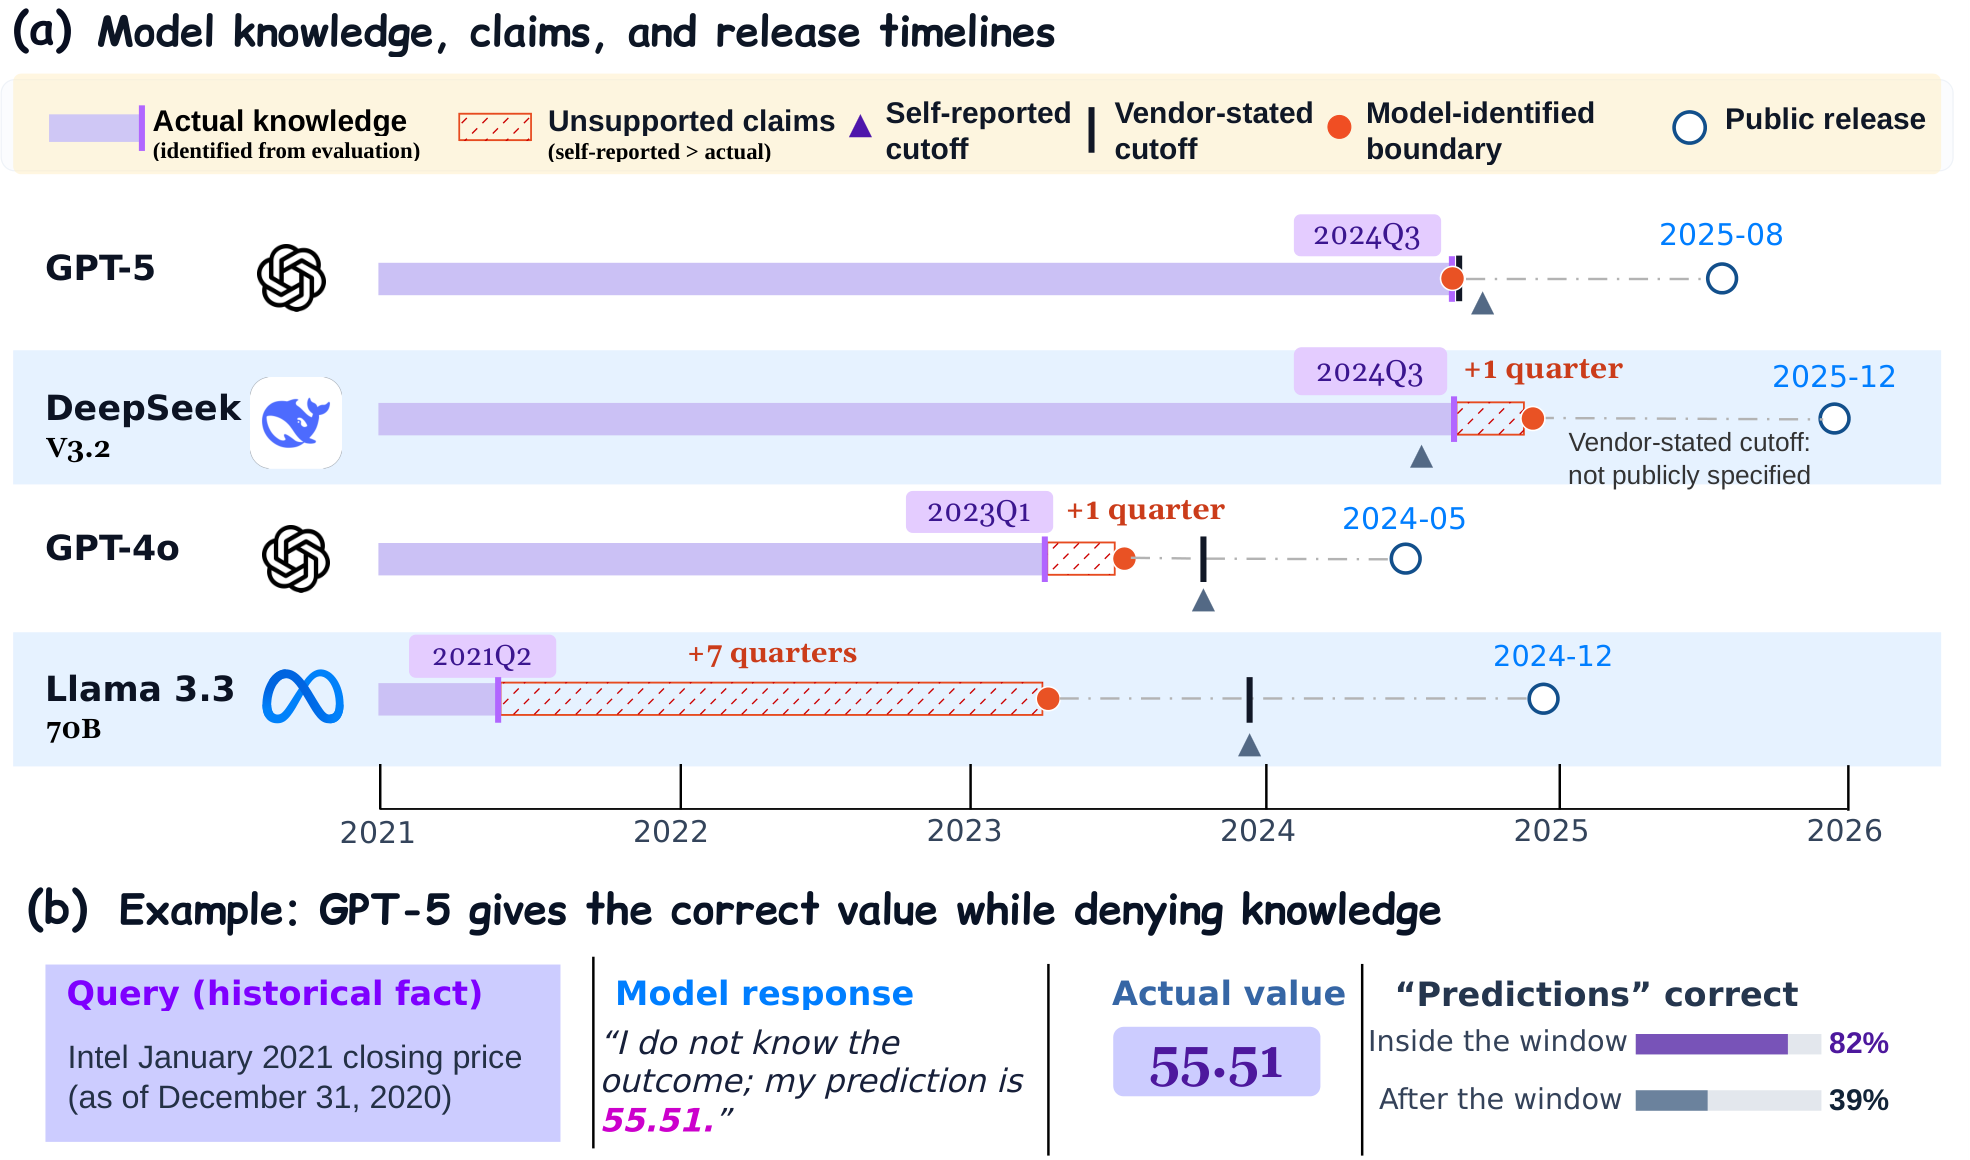
참고로 이 '시간 누수' 문제는 어제 오늘 일이 아닙니다. 같은 날 발표된 또 다른 논문(FinDendro, arXiv:2611.06808)은 LLM 백테스트의 안전장치를 실측했는데, GPT-5가 "모른다"고 부인한 사실의 61%를 정확히 답한다는 결과를 보여 줍니다. 모델에게 "2020년 시점으로 답해 줘"라고 지시해도, 이미 알고 있는 결과가 사라지지는 않는다는 것이죠. 즉, 백테스트의 과거 구간에서 LLM은 "예언"이 아니라 "암기"를 하고 있을 수 있습니다.
핵심 아이디어: '속기 어려운' 루프란?
이 논문이 만든 시스템의 이름은 Autonomous Quant Researcher(AQR)입니다. 설계 원칙을 한 문장으로 요약하면: "모델은 아이디어만 내고, 판정은 신뢰할 수 있는 코드만 한다."
1단계 — 모델은 코드가 아니라 '데이터'를 낸다
일반적인 코딩 에이전트는 전략 코드를 직접 씁니다. 그러면 그 코드를 안전하게 실행할 샌드박스가 필요하고, 평가기가 예상하지 못한 방식으로 우회할 여지가 남습니다.
AQR은 아예 선언적 JSON만 받습니다. 진입 시각, "시장이 오른 뒤에 진입한다" 같은 미리 승인된 신호식, 그리고 미리 정해진 옵션 구조물(예: 풋 크레딧 스프레드) 중 하나 — 이게 전부입니다. 뭔가 조금이라도 형식에 어긋나면 과학적 평가에 들어가기도 전에 기각됩니다. 모델이 쓸 수 있는 어휘 자체를 미리 제한하니, 샌드박스를 만들 문제가 원래부터 존재하지 않게 됩니다. 쉽게 말해, 시험 문제를 푸는 게 아니라 정해진 답안지 양식에 체크만 하는 셈입니다.
2단계 — 데이터를 발견/검증/홀드아웃으로 물리적으로 나눈다
과거 데이터를 세 덩어리로 나눕니다(예: SPY 기준 발견 2016–2021, 검증 2022–2024, 홀드아웃 2025년 이후). 각 덩어리는 내용 해시로 봉인되고, 각 단계의 코드는 자기 단계 데이터만 읽을 수 있습니다.
가장 중요한 장치는 홀드아웃을 단 한 번만 쓸 수 있다는 점입니다. 마지막 시험지가 봉인된 봉투에 들어 있고, 뜯기 전에 "이 홀드아웃을 소모한다"는 영수증이 먼저 디스크에 기록됩니다. 영수증이 기록된 뒤에 프로그램이 죽어도, 홀드아웃은 이미 소모된 것으로 처리되고 되돌릴 수 없습니다. 마지막 답안지를 딱 한 번만 볼 수 있게 만드는 거죠. 평범한 워커 프로세스는 홀드아웃 문 앞에서 아예 멈춰 서고, 열 수 있는 권한이 없습니다.
3단계 — 점수가 아니라 '게이트의 합'으로 판정한다
전략을 채택하려면 모든 자물쇠를 동시에 열어야 합니다.
- 거래비용을 뺀 절대 엣지 > 0
- 비용 후 평균 순손익 > 0
- 주(week) 단위로 묶어서 부트스트랩한 손익 하한 > 0 (2,000회 리샘플링)
- 비용을 올렸을 때도 순손익 > 0
- 표본 하한 충족 (예: 발견 단계에서 최소 120거래·40유효주, 검증 단계에서는 2022·2023·2024년 각각 최소 15거래·8주에 마이너스인 해가 없어야 함)
하나라도 어긋나면 탈락입니다. 그리고 이 숫자들을 합산한 '점수'는 후보를 순위 매기는 용도로만 쓰이고, 합격시키는 용도로는 절대 쓸 수 없습니다. 여러 개의 자물쇠가 있고, 그중 하나라도 안 열리면 문이 안 열리는 구조입니다.
한 가지 더 재미있는 장치가 있습니다. 중복 가설은 시도를 소모하기 전에 거절합니다. "같은 아이디어에서 숫자 하나만 바꾼" 전략은 처음부터 기각되므로, 50회의 실험 예산은 50개의 서로 다른 아이디어를 뜻합니다. 덕분에 "500개를 시험했는데 50개가 통과했어요" 같은 통계적 허풍이 구조적으로 불가능해집니다.
4단계 — 모든 것을 해시 체인 원장에 기록한다
모든 제안, 모든 기각, 모든 크래시, 홀드아웃 영수증까지 수정 불가능한 원장에 순서대로 기록됩니다. 어떤 항목이라도 고치거나 지우거나 순서를 바꾸면 시스템은 아예 작동을 멈춥니다(fail closed). 마치 병원의 수술 기록지처럼, 사후에 예쁘게 편집할 수 없는 구조입니다.
그리고 평가기(판정 코드)는 결정적 CPU 코드이고, 제안자(모델)만 LLM입니다. 즉 모델을 바꿔도 지표가 움직이지 않습니다. 로컬 7B 모델로도 충분하다는 것이 이 설계의 조용한 자랑입니다.
결과 — 무엇을 알아냈나
이 시스템은 SPY·QQQ 0DTE 옵션(당일 만기), 야간 SPX 선물 옵션, 일간 ETF 규칙, 유명한 기술적 분석 스크립트의 전제들, 예측 시장(Kalshi)의 크립토 바이너리, 실적 발표 시즌 옵션, 장외거래 비중, 대체 데이터까지 — 약 24개 캠페인을 돌렸고, 결과를 거절까지 전부 공개했습니다. 대부분의 가설은 실패했습니다. 논문은 그것이 "옳은 기본값"이라고 말합니다.
가장 중요한 발견은 사실 '실패'다
가장 교훈적인 사례는 LLM이 직접 찾아낸 한 전략입니다. 모델은 13번째 시도 끝에 이런 규칙을 제안했습니다 — "월요일과 화요일에, 크레딧(옵션 판매 대금)이 스프레드 폭의 10%를 넘으면 근처 행사가 풋 크레딧 스프레드를 매도하라" (QQQ, 당일 만기 옵션).
이 규칙은 발견 단계와 검증 단계의 모든 게이트를 통과했습니다.
| 단계 | 거래당 순손익 (폭 대비) | 순 Sharpe | 거래 수 | 판정 |
|---|---|---|---|---|
| 발견 | +5.69% | 2.94 | 221 | 통과 |
| 검증 | +4.82% | 3.34 | 43 | 통과 |
| 홀드아웃 | +0.52% | 0.26 | 72 | 기각 |
Sharpe가 약 3이라면 월스트리트의 꽤 많은 펀드보다 좋은 성적입니다. "검증 Sharpe가 3을 넘으면 채택"하는 흔한 자동화 루프였다면 이 전략은 바로 배포됐을 겁니다.
하지만 봉인된 홀드아웃을 단 한 번 열어 보니, 기대값은 약 90% 증발했고 Sharpe는 10분의 1로 쪼그라들었습니다. 아홉 개 게이트 중 여덟 개는 여전히 통과했고(순손익은 플러스를 유지했고, 비용을 2배로 올려도, 최고 수익일을 빼도 살아남았습니다) — 하지만 폭풍우 같은 하락 구간이 끼어 있던 홀드아웃의 절반은 순손실이었습니다. 규칙은 기각되었고, 이 후보의 홀드아웃은 영구히 '소모' 표시가 됐습니다.
이 '실패'야말로 루프가 제대로 작동한다는 가장 좋은 증거입니다. 시스템의 가치는 무엇을 찾느냐가 아니라, 없는 것을 보고하기 얼마나 어렵게 만들었느냐에 있다는 논문의 주장이 딱 들어맞는 장면입니다.
진짜 프리미엄이어도 게이트는 가차없다
무조건적인 SPY 0DTE 풋 크레딧 스프레드(폭 5포인트, 2포인트 외가격, 오전 10시 진입, 결제까지 보유)는 실제로 나쁘지 않은 전략이었습니다. 거래비용으로 폭의 0.5%를 가정하면 발견 단계에서 세션당 +55.7bp, 검증 단계에서 +71.6bp(폭 대비), 총 승률 95.2%로 전 게이트를 통과했습니다.
하지만 사전등록된 후속 검증 세 개가 그 실체를 파고들었습니다.
- 드리프트 검사: 그날의 손익을 SPY 자체의 움직임에 회귀시키니, 손익의 13~30%가 시장 방향에서 나왔습니다. 시장 방향을 뺀 잔차는 여전히 양(+)이었지만, 주간 부트스트랩 하한은 두 구간 모두에서 경계선에서 살짝 마이너스 — 미리 정한 규칙대로 승격되지 않았습니다.
- 기하학 검사: 5가지 미리 정한 스프레드 형태 중 프리미엄은 내가격도에 단조적이었습니다(오프셋 2 > 5 > 10, 10은 오히려 음수). 최고 셀은 발견 단계 부트스트랩 하한을 폭 대비 1.35bp 차이로 놓쳤고, QQQ에서 같은 셀을 사전등록 재현한 결과도 정확히 같은 조건에서 비슷한 크기로 실패했습니다.
- 조건부 검사: "전날 1% 이상 움직였으면 진입 안 함" 같은 필터는 오히려 모든 부트스트랩을 악화시켰습니다. 손실은 예측 불가능한 충격의 첫날에 나오는데, 하루가 지나면 변동성이 다시 가격에 반영되어 오히려 매도가 유리해지기 때문입니다.
정직한 결론은 이렇습니다 — 근처 행사가 0DTE 풋 프리미엄은 실재하고, 두 개의 서로 다른 기초자산에서 같은 모양을 보이며, 대부분 드리프트가 아니지만, 그 대가는 예측 불가능한 첫날 충격을 흡수하는 것이며, 사전등록된 허들에는 미치지 못한다. 그리고 전 게이트를 만족시키는 손익분기 거래비용은 폭의 0.5~1.0% 사이라, "이 전략은 될까?"라는 막연한 질문을 "우리 체결 비용이 0.7% 아래인가?"라는 측정 가능한 질문으로 바꿔 놓습니다.
기술적 분석 전설의 최후
232개의 일간 규칙 셀을 전수 조사한 결과, 발견 단계를 통과한 4개 규칙이 전부 같은 특징을 양방향으로 사용하고 있었습니다 — "20일 하락 후 매수"도 통과하고 "20일 상승 후 매수"도 통과한 것입니다. 반대 조건이 똑같이 잘 통과한다면, 그건 조건이 무언가를 예측해서가 아니라 그냥 그 구간에 주식이 오르는 시기였기 때문입니다. 후보 3개는 검증 단계에서 모든 성능 게이트를 탈락했습니다.
유명한 기술적 분석 기법들(피보나치, 채널, 이동평균 리본, 지지선)도 검증 단계를 전부 통과하지 못했습니다. 심지어 발견 단계의 모든 게이트를 통과했던 회귀 채널 하나는 검증 단계에서 세션당 -22bp를 기록했고, 모든 전제가 "그냥 주식을 들고 있는 것"보다 못했습니다.
살아남은 두 건
약 24개 캠페인 중 단 두 건만이 스스로 미리 세운 허들을 넘었습니다.
- 장외거래 비중: 한 종목의 거래량 중 장외(off-exchange)에서 체결된 비중이 높을수록, 향후 1·5·20일 수익이 낮았습니다(정보계수 음(陰), t 통계량 -3.1 ~ -5.8). 2021년부터 2026년까지 매년 음(陰)이었고, 상위 10분위에 집중되어 있으며, 회사 규모나 단기 반전 효과를 통제해도 견고했습니다. 재미있는 건, 벤더가 파는 이른바 "다크풀 지수"는 아무것도 예측하지 못했다는 점 — 진짜 정보는 공개된 원자료에 있었습니다.
- 충격일의 낙폭 종목 반전: 개별 종목의 갭(gap)이 이어진다는 가설은 기각됐지만, 시장 전체가 폭락한 날의 그날 패배자들은 되돌아오는 패턴이 모든 게이트를 통과했습니다.
저자는 이 둘도 "전략"이 아니라 연구 발견으로만 보고한다고 명시합니다.
게이트가 처음에 놓친 것들 (그리고 각각이 강제한 변화)
흥미롭게도 논문은 "게이트도 완벽하지 않았다"는 실패 목록을 따로 공개합니다.
- 드리프트=알파: 야간 SPX 콜 데비 스프레드가 검증 단계 주간 Sharpe 2.27로 통과했으나, 손익의 56%가 기초자산 움직임에서 나왔습니다. → 이후 이 계열에는 "보유 구간 동일 기초 대비 잔차"를 게이트하는 드리프트 통제가 표준이 됐습니다.
- 한 방향 발견 창: 게이트는 창이 한 방향이었다는 사실 자체를 볼 수 없었습니다. → "조건은 반대 조건과 함께 읽는다"는 규칙이 추가됐습니다.
- 가정된 비용: 측정된 적 없는 거래비용 가정에 후보 둘이 죽고, 홀드아웃 한 번이 낭비됐습니다. → "측정된 진입 비용이 홀드아웃 소모에 선행한다"는 규칙과 손익분기 비용 보고가 도입됐습니다.
- 특징을 통한 룩어헤드: 예측 대상 기간의 거래량에 조건을 건 가설이 형식적 통과를 받았습니다. → 창 내(內) 정보를 조건으로 쓰는 셀은 '기술적 서술 전용'으로 격하됐습니다.
- 증거의 무의미한 소모: 검증 단계에서 이미 전제가 전부 음수라면, 홀드아웃을 읽지 않는 것이 옳습니다. 읽어 봤자 바뀌는 건 없고 깔끔한 데이터만 잃으니까요.
한계와 주의점
- 이 루프는 "없는 것을 보고하기 어렵게" 만들 뿐, 진짜 전략을 쉽게 찾게 만들지는 않습니다. 가설 어휘가 의도적으로 작아서, 그 틀 밖의 아이디어는 신뢰 코드를 확장하기 전까지는 검증할 수 없습니다.
- 여러 캠페인의 표본이 짧습니다(Kalshi 데이터 46일, ETF 플로우 주말 60회 등). "아무것도 발견 못 함"이라는 결과는 시장에 대한 진술이라기보다 검정력의 한계에 대한 진술일 수 있습니다.
- 옵션 관련 결과는 2024년 이후 데이터라 2022년 같은 대형 약세장을 담고 있지 않습니다. 실거래 호가가 없던 자리는 모델 가격을 썼고(그 사실을 명시), 여러 캠페인의 거래비용은 측정값이 아니라 손익분기점이 붙은 가정입니다.
- 논문은 시스템을 만든 저자가 단독으로 작성했습니다. 엔진 코드와 사전등록 원장은 공개되어 있지만, 각 캠페인의 상세 기록은 요청 시 제공 방식입니다.
그래서 투자/실무엔?
1. "백테스트 성과"를 들을 때 되물을 질문이 바뀝니다. "수익률이 몇 %예요?"가 아니라 — "시행한 가설이 몇 개였고, 중복을 어떻게 걸렀고, 홀드아웃은 언제 열었고, 비용은 측정값인가요?" 이 논문은 좋은 전략보다 좋은 질문지를 남깁니다.
2. 마지막 데이터는 아껴 두세요. 홀드아웃을 여러 번 들여다보는 순간 그건 더 이상 홀드아웃이 아닙니다. '단 한 번'이라는 규칙은 심리적으로도, 통계적으로도 힘이 있습니다.
3. 좋은 숫자 하나보다, 모두 통과해야 하는 게이트가 낫습니다. 비용 후 엣지, 부트스트랩 하한, 비용 2배 생존, 마이너스 없는 해(年) — 각각은 평범하지만 합쳐지면 거짓 발견을 통과시키기 어려워집니다. 자산배분·전략 검증 어디에든 이식할 수 있는 원칙입니다.
4. AI에게 '코드'가 아니라 '아이디어'만 내게 하세요. 아이디어는 자유롭게, 판정은 냉정하게. 모델이 판정까지 하면 지표가 모델에 따라 흔들립니다. 판정부를 고정된 코드로 두는 것만으로도 연구의 재현성이 크게 올라갑니다.
5. 실패를 공개하는 시스템이 신뢰를 만듭니다. 이 논문의 가장 인상적인 숫자는 Sharpe 2.94가 아니라, "약 24개 캠페인 중 2개만 생존"이라는 기본값입니다. 퀀트 연구의 정직한 승률을 그대로 보여 주는 셈이죠.
더 알아보기
- 원문: Hard to Fool: A Bounded LLM Research Loop for Quantitative Finance, and What Two Dozen Campaigns Found (arXiv:2611.06607) — 엔진은 오픈소스로 공개되어 있습니다(Autonomous Quant Researcher). 저자는 BlackRock 8년·PIMCO 2년 경력의 퀀트 엔지니어 Henry Zhang입니다.
- 5차원 평가 점수 (참고): 새로움 73 / 적용성 78 / 엄밀성 76 / 재현성 72 / 통찰 82 — 종합 76.0 (A등급)
- 함께 읽기 좋은 논문 (KB 엔티티 기반 이웃):
- What survives honest evaluation? Leakage-safe, search-aware assessment of LLM-driven trading strategy discovery (arXiv:2608.27734) — 이 논문과 가장 가까운 선행 연구. Sharpe가 35인 '심어 놓은' 룩어헤드 오라클이 통계적 보정(축소 Sharpe비, 백테스트 과적합 확률)을 그대로 통과한다는 충격적 결과로, "통계 보정만으로는 누수 통제가 안 된다"는 오늘 논문의 구조적 접근이 왜 필요한지 보여 줍니다.
- Assessing Look-Ahead Bias in Stock Return Predictions Generated By GPT (arXiv:2309.17322) — LLM 주가 예측의 룩어헤드 편향을 처음 체계적으로 측정한 연구.
- Can LLM-based Financial Investing Strategies Outperform the Market in Long-Horizon? (arXiv:2505.07078) — LLM 투자 전략의 장기 성능을 검증한 대표 벤치마크.
- Look-Ahead-Bench (arXiv:2601.13770) — 포인트인 타임 모델의 룩어헤드 편향 표준 벤치마크.
이 글은 arXiv:2611.06607(및 동료 논문 arXiv:2611.06808의 그림)을 바탕으로 작성한 초안이며, 투자 조언이 아닙니다.
관련 글
 LLM 트레이딩 에이전트A
금융 AI 에이전트 벤치마크 FinCosmos: 만족한 사용자, 틀린 백테스트
사용자는 만족했지만 백테스트는 틀렸다. 금융 AI 에이전트 평가 벤치마크 FinCosmos가 150개 세션에서 드러낸 '조용한 실패'와, 미래정보 누수·전략 불일치·재현 불가 보고서를 잡아내는 백테스트 검증 방법을 쉽게 정리합니다.
 알고리즘 트레이딩A
AI 주식 리포트는 언제 다시 써야 할까? 갱신 비용과 수익의 실험
실서비스 AI 주식 리포트 8,120건 분석. 주가가 움직일 때마다 리포트를 다시 만들 필요가 있을까? 가격만 다시 고정하면 예측 오차 개선의 98%를 공짜로 얻지만, 6개월 방치하면 성적이 무너진다. 리서치 예산 배분을 데이터로 정리했다.
 시계열 계량경제학A
백테스트는 언제 멈출까? AI가 전략을 쏟아내는 시대의 합격 게이트
AI 리서치 에이전트가 쏟아내는 매매 전략 후보를, 데이터에 기대어 아무 때나 들여다봐도 거짓 '합격' 확률을 영구히 통제하는 PROMOTE 프로토콜을 쉽게 풀어 설명합니다. 무보정 반복 검정은 94.5%에서 거짓 승격을 만드는 반면 이 방법은 0.0%라는 놀라운 실험 결과까지.