Can We Stop the Backtest Yet? Anytime-Valid Promotion Tests for Adaptive Financial Research Agents
Eric Benhamou, Jean-Jacques Ohana, Beatrice Guez, Ethan Setrouk, Chamyl Saadi, Thomas Jacquot
과거 데이터에 완벽하게 맞는 매매 전략을 만드는 일은, 이제 AI에게는 하룻밤이면 끝나는 작업입니다. 진짜 문제는 "그 전략이 앞으로도 잘 맞을까"보다 앞서, "지금 이 전략을 합격시켜도 되는 걸까"라는 더 근본적인 질문입니다. 이 글은 그 질문에 수학적으로 답하려 한 흥미로운 연구를, 수식 없이 풀어 쓴 이야기입니다.
들어가며: 요리 시합의 비밀
수천 명이 참가하는 요리 시합을 상상해 보세요. 규칙은 간단합니다. 참가자들은 각자 레시피를 만들어 심사위원에게 내고, 심사위원은 "이 레시피는 과거에 인기 있던 음식과 얼마나 비슷한가"를 봅니다.
이제 한 참가자가 이런 전략을 씁니다. 레시피를 하나가 아니라 수천 개 만들고, 과거 인기 음식 데이터에 가장 잘 맞는 것 하나만 제출하는 겁니다. 심사위원 눈에는 "천재적인 레시피"가 보이지만, 실은 아무 정보도 없는 레시피를 수천 번 던져서 우연히 맞은 것에 불과할 수 있습니다.
퀀트 투자에서 전략을 개발할 때도 똑같은 일이 벌어집니다. 백테스트(과거 데이터로 전략 성과를 시험하는 일)를 반복하다 보면 어떤 전략이든 "과거에는" 잘 맞는 버전이 반드시 나옵니다. 문제는 그 전략이 진짜인지, 아니면 과거 데이터의 우연에 레시피를 맞춘 것인지 구별하기가 어렵다는 점입니다.
그리고 지금, AI 리서치 에이전트가 이 "레시피 대량 생산"을 사람보다 훨씬 빠른 속도로 하고 있습니다.
무엇이 문제였나: 자동화된 전략 공장의 구멍
전통적인 통계 검정은 이런 상황을 전제합니다. "검사할 가설을 미리 정해 놓고, 딱 한 번 검사한다." 약을 개발할 때 임상시험 계획을 사전에 등록하는 것과 같은 이치입니다.
그런데 AI 에이전트가 운영하는 전략 공장은 전혀 다릅니다.
- 후보가 데이터에 의존한 시점에 등장합니다. 어제 데이터를 보고 오늘 새 전략을 만들어 내고, 내일 또 만듭니다. 언제 몇 개를 검사할지 미리 정해져 있지 않습니다.
- 약한 후보는 조용히 폐기됩니다. 안 되는 전략은 기록도 없이 사라지고, 결과적으로 "살아남은 전략"만 보고서에 남습니다.
- 유망한 후보는 임계값을 넘길 때까지 계속 들여다봅니다. "조금만 더 돌려보자" — 멈추는 시점 자체가 결과에 따라 정해집니다.
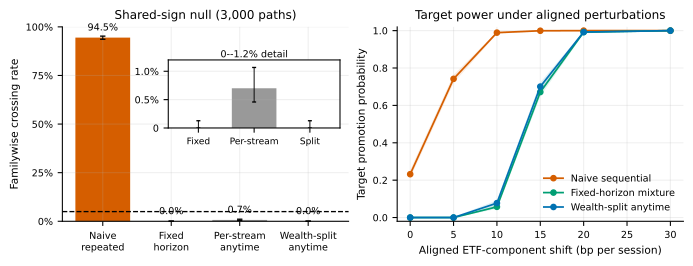
이 세 가지가 합쳐지면 벌어지는 일이, 요리 시합 비유의 "수천 번 던져서 하나 고르기"입니다. 통계학에서는 이를 다중검정 문제라고 부르고, 검정을 거듭할수록 거짓 "합격"이 나올 확률이 무섭게 올라간다는 것이 잘 알려져 있습니다. 오늘 논문의 실험에서 이 확률은 94.5%에 달했습니다. 전략 20개쯤을 자유롭게 들여다보는 보통의 연구 환경에서도, "과거에 잘 맞는다"는 결과가 열에 아홉은 거짓 신호일 수 있다는 뜻입니다.
핵심 아이디어: 전략마다 '검정 자금'을 나눠 주기
논문이 제안하는 프로토콜의 이름은 PROMOTE입니다. 이름 그대로 "전략을 승격시키는" 절차인데, 핵심은 크게 세 가지입니다.
첫째, 후보가 태어나는 순간 검정 자금(testing wealth)을 배분합니다. 매 전략 후보는 "출생 신고"와 함께 일종의 보증금을 받습니다. 이 보증금은 그 전략이 앞으로 증명에 쓸 수 있는 유일한 자원입니다. 전략을 아무리 오래 들여다봐도, 추가 자금은 한 푼도 받지 못합니다.
둘째, 저울은 '언제 멈춰도 공평한' 저울을 씁니다. 전통적 검정은 "정해진 표본 수에 도달한 뒤" 판정해야 공평합니다. 반면 e-프로세스(e-process)로 불리는 이 저울은 언제 결과를 들여다보든, 중간에 멈추든 "이 전략은 실제로는 아무 능력이 없다(조건부 평균이 0 이하)"라는 가설이 거짓으로 판정될 확률을 상한으로 묶어 줍니다. 관측을 멈추는 시점이 결과에 따라 정해져도 상관없습니다. 게다가 거래 비용을 반영한 수익률만으로 저울이 움직이기 때문에, "수수료 빼면 남는 게 없는 전략"이 통과되는 일은 원천적으로 막힙니다.
셋째, 모든 후보의 보증금 합계를 1 이하로 묶습니다. 이 한 줄의 조건이면(가중 Ville 부등식이라는 오래된 수학이 담보합니다), 후보가 서로 의존적이든 출생 시각이 데이터에 따라 달라지든 무한히 계속 모니터링하든, "진짜 능력이 없는데 합격하는 전략"이 나올 확률 전체가 100%를 넘지 않습니다. 후보를 많이 만들면 개별 전략의 검정 자금이 얇아져 검정력이 떨어지는 대신, 거짓 합격의 총량은 끝까지 통제됩니다 — 공짜 점심이 없는, 정직한 거래입니다.
한 가지 더 재미있는 장치가 있습니다. 규칙이 없는 아이디어는 아예 자금을 받지 못합니다. "결정론적으로 실행 가능한 규칙"을 문서화해야만 후보로 등록됩니다. 그리고 등록·배분·기각의 모든 기록이 원장에 남습니다.
결과: 거짓 합격 94.5% vs 0.0%
논문은 두 가지 실험으로 이 프로토콜을 감사(audit)했습니다.
첫 번째 실험: 되돌아보는 심사(replay). 공개 ETF와 산업 데이터를 써서, 실제와 같은 조건에서 24개의 전략-패널 가설을 세우고, "아무 능력이 없는" 가짜 경로 3,000개를 만들어 그 위에서 연구 과정을 그대로 재연했습니다.
- 무보정 반복 검정(그냥 계속 들여다보는 방식): 가짜 경로의 94.5%에서 "가족 전체가 거짓으로 승격"되는 참사가 발생했습니다.
- PROMOTE: 같은 조건에서 거짓 승격 0.0%.
- 진짜 능력을 가진 전략이 섞였을 때도 검정력은 괜찮았습니다. ETF 구성 수익률을 15bp(0.15%p)만큼 정렬된 방향으로 흔들어 대안을 주입하자, 목표 전략을 잡아내는 확률이 70.1%였고 승격까지 걸린 시간은 중앙값 2,327 거래 세션이었습니다. 거짓 합격을 막느라 "진짜도 못 알아보는 무능한 심사관"이 된 것은 아니라는 뜻입니다.
두 번째 실험: 악의적인 에이전트를 상대로. 이 실험에서는 에이전트가 과거 점수를 보고 후보의 정체와 출생 시각까지 마음대로 고를 수 있습니다. 요리 시합 비유로 치면 "심사 기록을 모두 열람한 뒤에 레시피를 고르는" 최악의 상황입니다. 그런데도 자금이 배분된 게이트에서 거짓-가족 승격률은 3,000개 프로그램 중 1.77%에 그쳤습니다.
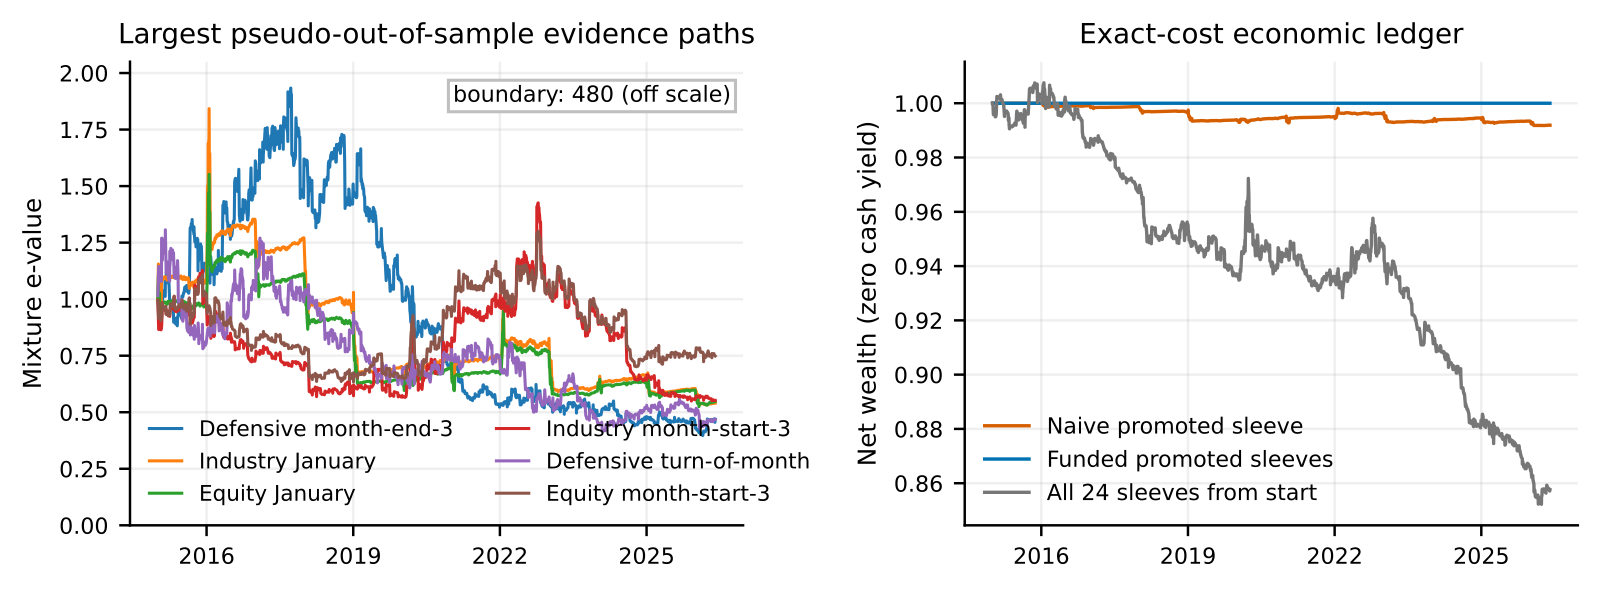
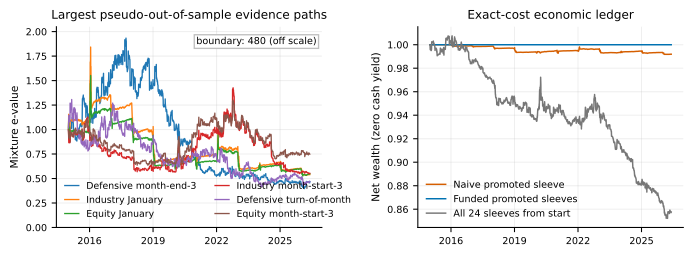
세 번째: 실제 시장 데이터. 2015년 1월부터 2026년 5월까지의 경제적 리플레이에서는, 달러당 5bp의 정확한 일방향 거래 비용을 반영한 뒤 어떤 전략도 승격되지 않았습니다(0건). 게이트의 자산 곡선은 끝까지 1에 머물렀습니다. 화려한 결론은 아니지만, 오히려 그래서 신뢰할 만합니다 — 이 데이터에서 "살아남을 전략이 없었다"는 결론을, 확률적 오류 없이 내린 것입니다.
한계와 주의점
이 연구는 의도적으로 "겸손한 주장"만 합니다. 그 겸손함의 범위를 정확히 알아 두는 것이 중요합니다.
- 이 인증서가 보장하는 것은 "과거의 거짓 승격 통제"뿐입니다. "과거에 엣지가 있었던 전략이 앞으로도 수익을 낼 것"은 전혀 보장하지 않습니다 — 논문이 결론에서 스스로 명시하는 사항입니다. 합격증이 아니라 면접 초대장인 셈입니다.
- 거래 비용 모형이 단순합니다. 5bp 회전비용만 명시적으로 반영했고, 자금조달 비용, 차입 수수료, 호가 스프레드, 시장 충격, 세금, 수용량(capacity)은 빠져 있습니다. 산업 데이터로 쓴 French 산업 포트폴리오는 실제 거래가 불가능한 구성이기도 합니다.
- 설계와 평가 기간을 사후에 골랐습니다. 실험이 "진짜 감사(audit)"이지 라이브 성과 주장이 아니라고 논문이 정직하게 밝힙니다.
- 후보가 서로 비슷한 변형을 많이 내면 통제가 보수적이 됩니다. 이 경우 어떤 발견 시스템은 거짓발견율(FDR) 통제를 선호할 수 있습니다.
- 원고 준비에 AI 코딩 도구(OpenAI Codex)가 사용되었다는 공시가 있습니다. 주제 자체가 "AI 에이전트의 연구 과정 감사"라는 점에서 시의적절하면서도, AI 도구 의존성이 연구의 주 대상이라는 점을 함께 읽어야 합니다.
그래서 투자/실무엔?
평범한 투자자에게 "e-프로세스"라는 단어는 낯섭니다. 하지만 이 연구의 교훈은 전략을 직접 짜지 않는 사람에게도 유효합니다.
- "백테스트가 잘 나온 전략"이라는 말 자체에 함정이 있다는 사실을 기억하세요. 몇 개를 얼마나 오래, 언제 멈추고 골랐는지가 밝혀지지 않은 백테스트는, 94.5%라는 숫자가 말하듯 거짓 신호일 가능성이 상당합니다. 전략을 제안받을 때 "전체 시도한 전략이 몇 개였나요?"를 묻는 것만으로도 질문의 질이 달라집니다.
- AI가 전략을 대량 생산하는 시대일수록, '합격 절차'의 가치가 올라갑니다. 전략을 만드는 비용이 0에 가까워지면, 남는 희소 자원은 "이 전략을 믿어도 되는가에 대한 증명"입니다. 이 논문은 그 증명을 산업적 속도로 만드는 방법을 처음으로 제시했습니다.
- 실무 팀에게는, 전략 승격을 '주문'이 아니라 '승인 요청'으로 설계하라는 논문의 운영 원칙이 특히 실용적입니다. 승격 게이트를 통과해도 데이터 가용성, 체결 가능 여부, 스프레드·충격, 집중도, 중복 익스포저를 확인하는 별도의 사전 거래 게이트가 있고, 위험 킬스위치는 노출을 멈출 수 있을 뿐 이미 쓴 검정 자금을 되돌려 주지 않습니다. "증거의 관리"와 "운영의 안전"을 분리하라는, 시스템 트레이딩 팀이라면 새겨들을 조언입니다.
더 알아보기
- 원 논문: Can We Stop the Backtest Yet? Anytime-Valid Promotion Tests for Adaptive Financial Research Agents (arXiv:2611.03384) — 2026년 11월 3일 게재.
- OHSE AI Lab 5차원 점수: 신규성 76 / 적용성 82 / 엄밀성 78 / 재현성 72 / 통찰 79 — 종합 78.0 (A등급). "적용성"이 높은 이유는 전략 탐색 파이프라인의 승격 게이트로 바로 옮길 수 있는 구체적 설계가 논문에 있기 때문입니다.
- 같은 날 수집된 관련 논문:
- Penalize the Common Trade (arXiv:2611.03453) — 여러 학습 모델이 같은 방향으로 몰릴 때 생기는 '신호 충돌'을 포트폴리오 구성 단계에서 줄이는 아이디어. 전략을 만든 뒤 리스크를 다스리는 쪽의 연구입니다.
- Learning AI Agents, Market Makers, and Stress in Automated Markets (arXiv:2611.01799) — 학습 에이전트가 지배하는 자동화 시장에서, 변동성·VaR 같은 흔한 지표로는 시장의 불안정 신호를 잡아낼 수 없다는 경고.
관련 글
 알고리즘 트레이딩A
LLM 트레이딩 전략 자동 최적화 — '나쁜 시기'를 견디는 전략이 살아남는 이유
LLM에게 전략 코드를 고쳐 가게 맡기면 백테스트 성적은 잘 나오는데 실제 시장에서 무너지는 일이 흔합니다. 텍스트 그래디언트로 전략을 개선하고 '가장 약한 시기'만 보고 학습한 TradeGrad 연구를 일반인 눈높이로 풀어 설명합니다.
 포트폴리오 최적화A
구조화상품 고차 그리스 계산, 텐서 트레인이 몬테카를로를 이기는 조건
멀티자산 오토콜러블의 3차 그리스와 잠재 미래 익스포저를 몬테카를로 대신 함수형 텐서 트레인으로 계산하는 JPMorgan 연구를 쉽게 풀어 설명합니다. 정밀도와 관측 빈도에 따라 계산 도구의 승자가 바뀐다는 실용적 결론까지.
 시계열 계량경제학A
VaR·ES 백테스트, 표본이 적은 게 아니라 '초과 사건'이 적은 것이다
리스크 모델 두 개를 비교할 때 우리는 2년치 데이터를 쥐고 '표본이 넉넉하다'고 생각합니다. 이 논문은 진짜 표본 크기가 '초과 사건' 몇 개뿐임을 수학으로 보이고, 왜 표준 검정이 더 겁 없는 모델을 잘못 이겼다고 하는지, 그리고 확실하게 비교하는 방법은 무엇인지 알려 줍니다.