Functional Tensor Trains for High-Order Greeks and Exposure Tails of Multi-Asset Structured Products
Javier Lopez-Piqueres, Atithi Acharya, Yue Sun, Niraj Kumar
은행이 판매하는 복잡한 금융상품 뒤에는 매일 밤 돌아가는 대규모 계산 전쟁이 있습니다. 이 글은 그 전쟁에서 "샘플링 대신 텐서"라는 새로운 무기를 들고 나온 흥미로운 연구를, 수식 없이 풀어 쓴 이야기입니다.
들어가며: 가장 약한 친구가 모든 것을 결정하는 상품
주식 연계 구조화상품 중에 '오토콜러블(autocallable)'이라는 것이 있습니다. 쉽게 말하면 이런 상품입니다. 예금과 옵션을 섞은 것인데, 만기까지 쿠폰(이자)을 챙겨 주는 대신, 투자자는 은행에게 주식이 떨어지면 손해를 감수하겠다는 약속을 합니다. '워스트-오브(worst-of) 오토콜러블'은 그중에서도 재미있는 변형입니다. 삼성전자, 애플, 테슬라처럼 서로 다른 여러 주식을 기초자산으로 삼되, 가장 약한 친구 하나가 모든 것을 결정합니다. 가장 약한 주식이 일정 수준 위에 있으면 쿠폰이 나오고, 일찍 조기 상환되기도 하고, 맨 아래까지 떨어지면 투자자가 원금을 잃습니다.
이 상품은 작지 않은 시장입니다. 전 세계적으로 연간 발행 규모가 1,000억 달러(약 130조 원) 이상으로 알려져 있고, 미국에서만 2019~2023년에 연평균 280억 달러(약 36조 원)가 발행되어, 10년 전보다 9배로 늘었습니다.
그런데 이 상품을 판 은행의 처지를 생각해 봅시다. 가장 약한 자산의 움직임에 쿠폰, 조기 상환, 손실이 모두 걸려 있으니, 은행은 매일 이 상품의 가치가 주식 가격에 얼마나 민감한지 계산해야 합니다. 이 민감도가 바로 '그리스(Greeks)'입니다. 헤지를 어떻게 할지, 자본을 얼마나 쌓아야 할지, 거래 상대방이 부도나면 얼마나 잃을지가 전부 이 숫자에 달려 있습니다.
문제는 이 계산이 어렵고, 비싸고, 매일 반복된다는 것입니다.
무엇이 문제였나: 몬테카를로의 두 가지 고질병
지금까지의 표준 도구는 몬테카를로 시뮬레이션입니다. 미래의 주가 경로를 수만~수백만 개 만들어 놓고, 그 경로들에서 상품 가치를 평균 내는 방식이죠. 직관적이고 어떤 모델에도 쓸 수 있는 좋은 도구입니다.
하지만 이 연구가 집중한 두 가지 계산에서 몬테카를로는 고질적인 약점을 보입니다.
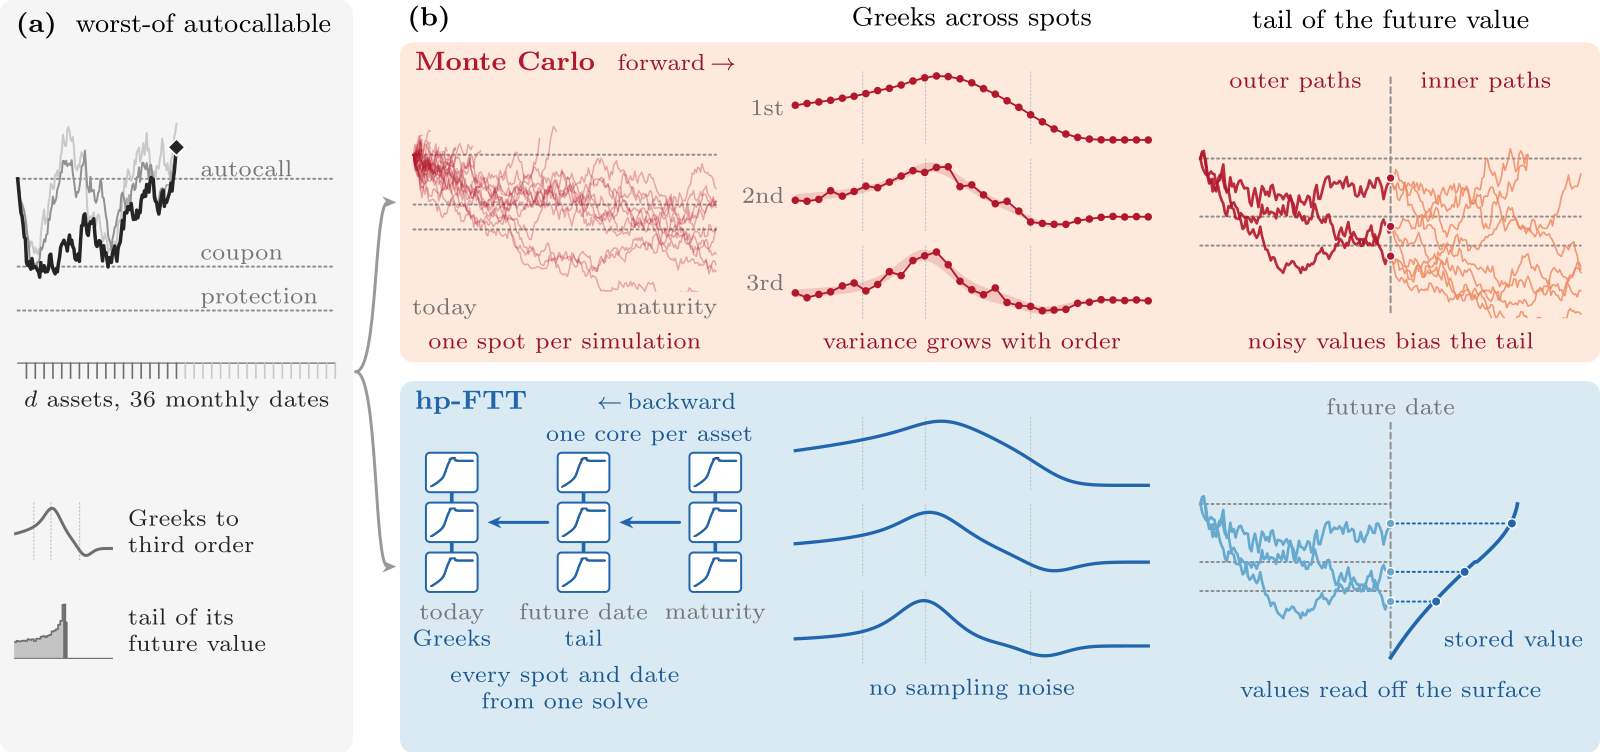
첫째, 미분을 한 번 할 때마다 소음이 폭증합니다. 'delta(1차 민감도)' 정도는 몬테카를로로 계산할 수 있지만, 'gamma'(2차), 그리고 'speed', 'cross-speed'(3차)로 갈수록 상황이 나빠집니다. 쉽게 말하면 흔들리는 저울로 무게를 재는 것과 같습니다. 무게만 재면 어느 정도 되지만, 흔들림이 얼마나 빨리 변하는지(2차), 그 변하는 속도가 얼마나 빨리 변하는지(3차)를 재려면 저울의 미세한 떨림이 측정을 삼켜 버립니다. 논문에 따르면 3차 미분에서 정밀도를 소수점 한 자릿수만 더 높이면 계산 비용이 약 3만 배로 뛸 수 있습니다. 그리고 이 상품은 배리어(일정 가격 아래로 떨어지면 조건이 바뀌는 경계)가 있어서, 경로에서 조건이 '턱' 하고 바뀌는 순간 미분 계산은 더 꼬입니다. 공개된 몬테카를로 기법 중 3차 그리스까지 제대로 처리하는 방법이 없을 정도입니다.
둘째, 미래 노출 계산에서 편향이 생깁니다. 은행은 거래 상대방이 부도났을 때 잃을 금액을 관리해야 하는데, 그 핵심 지표가 '잠재 미래 익스포저(PFE)'입니다. 미래 어느 시점에 이 상품의 가치가 높아질 '꼬리'(상위 2.5% 정도의 나쁜 경우)가 얼마인지 묻는 것이죠. 이걸 몬테카를로로 계산하려면 미래 시점의 각 시나리오마다 안쪽에서 또 시뮬레이션(중첩 시뮬레이션)을 돌려 그 상태의 상품 가치를 추정해야 합니다. 안쪽 시뮬레이션의 잡음이 분위수(꼬리 경계)를 한쪽 방향으로 밀어 올리는 편향으로 누적됩니다. 추측 게임 안에 추측 게임이 들어 있는 격이죠.
두 약점의 뿌리는 같습니다. 몬테카를로는 경로들의 현금흐름만 평균낼 뿐, "각 미래 시점에서 주식 가격의 함수로서의 남은 가치"(계속 가치, continuation value)를 한 번도 들고 있지 않습니다. 이 표면을 들고 있으면, 미분 가중치를 그 표면에 적분만 하면 Greeks가 나오고, 미래 시나리오마다 표면을 들여다보면 노출이 나옵니다. 소음도, 편향도 없이요.
핵심 아이디어: 미래의 값을 표면으로 저장해 두다
JPMorgan 연구진의 답은 명확합니다. "경로를 샘플링하지 말고, 계속 가치를 함수로 저장해 둔 역방향 계산을 하자."
만기에서 오늘로 거꾸로 풀어 가면서(역방향 가격 재귀), 각 미래 시점의 계속 가치를 'hp 함수형 텐서 트레인(hp functional tensor train)'이라는 자료구조에 담습니다. 이름이 어렵지만 아이디어는 우아합니다.
- 텐서 트레인: 자산이 여러 개인 '다변수 함수'를, 자산별 작은 부품(코어)의 연결로 쪼개어 저장하는 방식입니다. 물리학의 양자 다체 문제에서 지수적 벽을 우회할 때 쓰는 기법이 금융에 들어온 것입니다. 저장 공간이 자산 수에 선형으로만 늘어납니다. 부품 사이 연결의 굵기를 '랭크'라고 하는데, 이게 곧 "자산들이 얼마나 강하게 얽혀 있는가"의 척도입니다. 워스트-오브 상품은 모든 자산이 얽혀 있어 랭크가 커질까 걱정이지만, 세 가지 특성이 이 문제를 다루기 쉽게 만듭니다.
- 배리어를 정확하게 처리: "가장 약한 자산이 배리어 위에 있다"는 사건은 "모든 자산이 각각 배리어 위에 있다"는 사건들의 곱과 같습니다. 그래서 다항식 조각의 경계를 배리어 위치에 딱 맞춰 놓으면, 이 복잡한 이벤트가 '랭크 1'의 초저렴한 연산으로 정확하게 적용됩니다. 계단 경계에 딱 맞춰 종이를 자르면 계단이 흐려지지 않는 것과 같습니다.
- 자산 사이의 얽힘이 실제로는 얕다: 주식 수익률의 상관 구조를 뜯어보면 시장 전체 요인 하나와 섹터 요인 몇 개가 대부분을 설명합니다(무작위 행렬 이론이 뒷받침하는 관찰). 공통 요인을 빼놓으면 자산들은 거의 독립적으로 움직여, 계산이 자산별로 쪼갤 수 있습니다.
- 정밀도가 싸다: 각 조각을 다항식으로 표현하는데, 가우시안 확산에서는 필요한 다항 차수가 정밀도가 10배 올라가도 조금만 늘어납니다(로그 수준). 몬테카를로가 정밀도 10배에 비용 100배를 치르는 것과 대비됩니다.
이제 두 가지 고질병이 어떻게 해소되는지 봅시다.
- Greeks는 거의 공짜로: 첫 스텝의 확률 밀도를 미분해 얻는 가중치(몬테카를로도 쓰는 표준 기법)를, 노이즈 가득한 경로들의 평균이 아니라 저장된 값 표면에 적분합니다. 샘플링이 없으니 분산이 없고, 미분 차수가 올라가도 소음이 폭증하지 않습니다. 한 번의 계산으로 어떤 스팟에서든, 어떤 차수의 Greeks든 읽어낼 수 있습니다.
- 노출 꼬리도 공짜로: 미래 어느 시점의 가치 표면이 이미 저장되어 있으니, 그 시점의 시나리오마다 안쪽 시뮬레이션 없이 표면을 들여다보기만 하면 됩니다. 중첩 시뮬레이션의 편향이 사라지는 이유입니다.
결과 — 무엇을 알아냈나
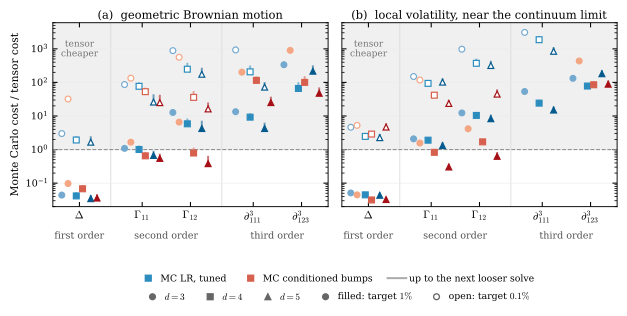
연구진은 자산 3~5개, 월간 관측(3년, 36회)의 워스트-오브 오토콜러블을 두고, 몬테카를로 쪽에서는 가장 잘 튜닝된 공개 추정량들(likelihood-ratio 추정량, 조건부 bump-and-reprice 등)을 동원해 정밀도를 맞춘 대결을 벌였습니다. 그리고 모델은 기하 브라운 운동과 국소변동성 두 가지를 썼습니다.
핵심 결과는 "승자가 하나가 아니고, 조건이 정한다"입니다.
- 정밀도 1% 수준: delta(1차)는 몬테카를로가 10배 이상 저렴합니다. 2차는 엇갈리고(경우에 따라 몬테카를로가 최대 3배 저렴), 3차는 텐서가 전부 승리 — speed는 약 10배, cross-speed는 10~100배 저렴합니다.
- 정밀도 0.1% 수준: 텐서가 확인 가능한 모든 그리스에서 승리합니다. delta는 몇 배, 나머지는 10~1,000배까지 저렴합니다.
- 국소변동성 모델에서도 결론은 거의 그대로이고, 가장 정밀한 텐서 계산은 깊은 몬테카를로와 가격·그리스 전부에서 통계 오차 안에서 일치합니다(서로 검증한 셈).
노출(PFE) 쪽에서는: 97.5% 분위수의 잠재 미래 익스포저를 만기 18개월차에 대해 계산했을 때, 정밀도 1%에서는 표면을 처음부터 만들어야 하는 비용까지 치르면 중첩 몬테카를로가 약 10배 더 저렴합니다. 하지만 정밀도 0.1%에서는 뒤집히고(교차점은 0.3% 부근), 그리스 계산을 위해 이미 만들어 둔 표면을 재사용하면 0.3%에서 최소 10배, 0.1%에서 70배 이상 저렴합니다. 계산을 한 번 해두고 여러 용도로 쓰는 구조가 얼마나 값어치가 있는지 보여 주는 대목입니다.
언제 몬테카를로가 계속 이기는가: 논문은 정직하게 세 가지 영역을 남겨 둡니다. ① % 수준 정밀도의 저차 그리스, ② 관측이 몇 번뿐인 계약(관측 6회에서는 23차도 몬테카를로가 유리 — 관측이 늘수록 격차는 100배 이상 벌어짐), ③ 자산이 많을 때(자산이 하나 늘 때마다 텐서 계산은 25배 비싸지고, 5개에서는 2차 마저 몬테카를로로 넘어가며, 10개 자산의 풀 계산은 약 1,000 코어-초).
이 모든 것을 한 문장으로 요약하면 이렇습니다.
샘플링은 미분 차수마다 분산으로, 텐서는 자산마다 랭크로 지불한다.
한계와 주의점
- 단일 코어 CPU 비교입니다. 몬테카를로는 병렬화와 GPU에 매우 유리하므로, 실제 운영 환경의 시간 단축으로 따지면 격차가 달라질 수 있습니다(논문도 명시한 사항).
- 시장 가격에 캘리브레이션하지 않은 모델 비교입니다. 국소변동성은 오토콜러블의 스마일 움직임을 본래 맞추지 못하는 모델이라, 실전 다음 검증 대상은 stochastic local volatility라는 것이 저자들의 견해입니다.
- 지금 계산한 그리스는 전부 주식 가격에 대한 민감도입니다. 변동성·상관에 대한 민감도(vega, vanna)는 계산 구조가 달라 별도 작업입니다. 흥미롭게도 저자들은 이 민감도야말로 텐서 솔버의 유망한 응용처라고 지적합니다(헤지 부정캐리의 원인으로 지목되는 vanna 추적 등).
- 저장된 표면은 계약 조건과 모델 파라미터가 고정돼 있을 때만 유효합니다. 재사용의 이점(스팟별 밀리초 단위 재조회)이 실제로 얼마인지는 워크로드에 따라 다르며 이 논문에서 벤치마크하지 않았습니다.
- 본 비교에서 자산 3~5개, 월간 관측이 중심입니다. 자산이 많은 포트폴리오나 관측이 드문 계약은 여전히 몬테카를로의 영역입니다.
- 저자 전원이 JPMorgan 연구조직 소속입니다. 실무 시스템을 만드는 쪽의 문제의식이 반영된, 실용성이 높은 연구인 동시에 "결정론적 솔버로 옮기자"는 방향에 이해관계가 있을 수 있다는 점을 함께 읽어야 합니다.
그래서 투자/실무엔?
평범한 투자자 입장에서는 "텐서 트레인"이 일상에서 쓸 기술은 아닙니다. 다만 이 연구가 주는 교훈은 일반적입니다.
- 복잡한 상품일수록 리스크 계산의 품질이 상품의 품질을 좌우합니다. 쿠폰이 후한 구조화상품을 고를 때, 판매자가 리스크를 정확하게 측정·헤지하고 있는지는 결국 그 상품이 오래 버티는가와 직결됩니다.
- "더 정확한 계산"은 사치가 아니라 돈입니다. 배리어 근처에서 3차 민감도가 틀리면 헤지가 새고, 그 비용은 쿠폰 이자를 뛰어넘을 수 있습니다. 이 연구는 그 정확도를 어떤 조건에서 얼마의 비용으로 얻을 수 있는지 처음으로 정량화했습니다.
- 파생상품 리스크, 헤지, 상대방 리스크(CVA/PFE 계열)를 다루는 팀이라면, "모든 것을 몬테카를로로"라는 기본값을 의심해 볼 만한 근거가 생겼습니다. 관측이 잦고 자산이 적으며 고차 민감도·꼬리 위험이 필요한 문제에서는 결정론적 계산이 압도적으로 낫고, 그 외에는 샘플링이 여전히 왕입니다. 어떤 도구를 어디에 쓸지에 대한 '선택 지도'가 생겼다는 점이 이 논문의 진짜 기여입니다.
더 알아보기
- 원문: Functional Tensor Trains for High-Order Greeks and Exposure Tails of Multi-Asset Structured Products (arXiv:2610.42119) — Javier Lopez-Piqueres 외 3인, JPMorgan Chase Global Technology Applied Research, 2026년 10월 30일.
- KB 5차원 점수 (참고): 새로움 82 / 적용성 78 / 엄밀성 84 / 재현성 42 / 통찰 80 — 종합 75.1, A등급. 재현성이 낮은 이유는 공개 코드가 없기 때문입니다.
- 관련 논문 (KB 엔티티 기반):
- Unbiased Monte Carlo Greeks for Discontinuous Payoffs (arXiv:2609.06137) — 끊어진 페이오프의 몬테카를로 그리스 편향 문제를 직접 다룬 논문. 오늘 글의 "첫 번째 고질병" 쪽 해결 시도를 비교해 볼 수 있습니다.
- Path Shadowing Monte-Carlo (arXiv:2308.01486) — 경로 샘플링 자체를 개선하는 다른 방향의 접근.
- Randomized Neural Networks for estimation of exposure profiles (arXiv:2606.24309) — 오늘 글의 두 번째 주제인 노출 프로파일 추정을 신경망으로 접근한 연구.
관련 글
 시계열 계량경제학A
VaR·ES 백테스트, 표본이 적은 게 아니라 '초과 사건'이 적은 것이다
리스크 모델 두 개를 비교할 때 우리는 2년치 데이터를 쥐고 '표본이 넉넉하다'고 생각합니다. 이 논문은 진짜 표본 크기가 '초과 사건' 몇 개뿐임을 수학으로 보이고, 왜 표준 검정이 더 겁 없는 모델을 잘못 이겼다고 하는지, 그리고 확실하게 비교하는 방법은 무엇인지 알려 줍니다.
 시장 미시구조S
예치를 늘렸는데 이자가 줄었다? 대출 풀 금리곡선의 숨은 규칙
가상자산 대출 시장에 예금을 더 넣었더니 이자 수입이 오히려 줄어드는 일이 실제로 벌어집니다. 이 논문은 '언제 예치가 독이 되는가'를 하나의 부등식으로 답하고, 실제 솔라나 시장 데이터에서 큰 예치자들이 시간의 약 10분의 1 동안 이런 위험에 놓여 있었음을 보여 줍니다.
 강화학습 포트폴리오A
강화학습 트레이딩 보상 정합성 인증: AI가 진짜 투자 목표를 따르는지 검증하기
포트폴리오 강화학습 에이전트가 보상을 정확히 최대화해도 다른 투자 선호를 구현할 수 있습니다. 잔차 인증서로 보상 오정의와 학습 오차를 분리해 검증한 2026년 최신 연구를, 432개월 실증 결과와 한계까지 쉽게 풀어 설명합니다.