
Trading Strategy Optimization via Textual Gradient
Chaoqun Yang, Qian Wang, Fengbin Zhu, Xinyu Lin, Bingsheng He, Roger Zimmermann 외 1명
잘 나가는 투자 전략을 자동으로 만들어 주는 AI가 있다면? 그런데 그 AI가 만든 전략이 백테스트에서는 대박, 실제 시장에서는 손실이라면? 이 논문은 AI가 전략을 고쳐 나가는 방식 자체를 바꿔, "시장이 나빴던 시기에도 버텨 내는 전략"만 살아남게 만든 방법을 제안합니다.
들어가며
요즘에는 "AI한테 전략을 짜 달라고 하면 된다"는 이야기를 자주 듣습니다. 실제로 "이동평균선 돌파 전략을 파이썬으로 만들어 줘"라고 요청하면, 언어 모델(LLM)은 그럴듯한 코드를 바로 내놓습니다. 백테스트(과거 데이터로 시뮬레이션)를 돌려 보면 수익률도 꽤 그럴듯하게 나오죠.
하지만 투자 경험이 있는 분들은 아실 겁니다. 과거 데이터에서 너무 잘 나온 전략일수록 미래에는 잘 안 통하는 아이러니. 통계학에서는 이걸 "과최적화(overfitting)"라고 부르는데, 쉬운 비유로 "지난 시험 문제를 외워서 만점을 맞은 학생"과 같습니다. 지난 시험(백테스트)에서는 완벽한데, 문제 조금만 바뀌면(미래 시장) 점수가 곤두박질치는 거죠.
자동 전략 생성 연구도 같은 함정에 자주 빠집니다. AI가 수백 번 전략을 수정해 가며 "과거 성적"을 올리는 데는 능숙한데, 그 개선이 미래까지 이어지지 않는 경우가 많습니다. 오늘 소개할 논문 "Trading Strategy Optimization via Textual Gradient"(텍스트 그래디언트를 이용한 트레이딩 전략 최적화)는 이 문제를 두 가지 아이디어로 정면 돌파합니다. 하나는 AI의 '수정 조언'을 축적된 경험과 연결하는 것, 다른 하나는 성적이 좋았던 시기가 아니라 가장 약했던 시기만 보고 전략을 고르는 것입니다.
무엇이 문제였나
전략을 자동 생성하는 기존 방법들의 한계를 세 가지로 정리하면 이렇습니다.
첫째, AI의 기억이 짧습니다. LLM에게 "이 전략을 개선해 달라고" 하면, 보통 지금 보고 있는 전략 한두 개만 놓고 고칩니다. 지난 50번의 시도에서 "이런 조건은 항상 실패했다"는 소중한 경험이 사라진 채, 매번 처음부터 헤매는 셈입니다. 마치 매일 아침 기억을 잃은 채 출근하는 요리사가 "소금 두 번 넣기" 실패를 매일 반복하는 것과 같습니다.
둘째, '전체 평균'이 함정입니다. 전략의 과거 성적을 하나의 숫자(평균 수익률 등)로 합산하면, 특정 시기에 몰린 수익이 다른 시기의 큰 손실을 감춥니다. "작년에 대박 쳤지만 나머지 3년은 손실"인 전략이 좋은 점수를 받는 구조입니다. 실제로 자동 생성 전략들은 잘 나온 구간에 성적이 몰려 있다가, 보지 않은 시기에서 손실을 내는 패턴이 반복됩니다.
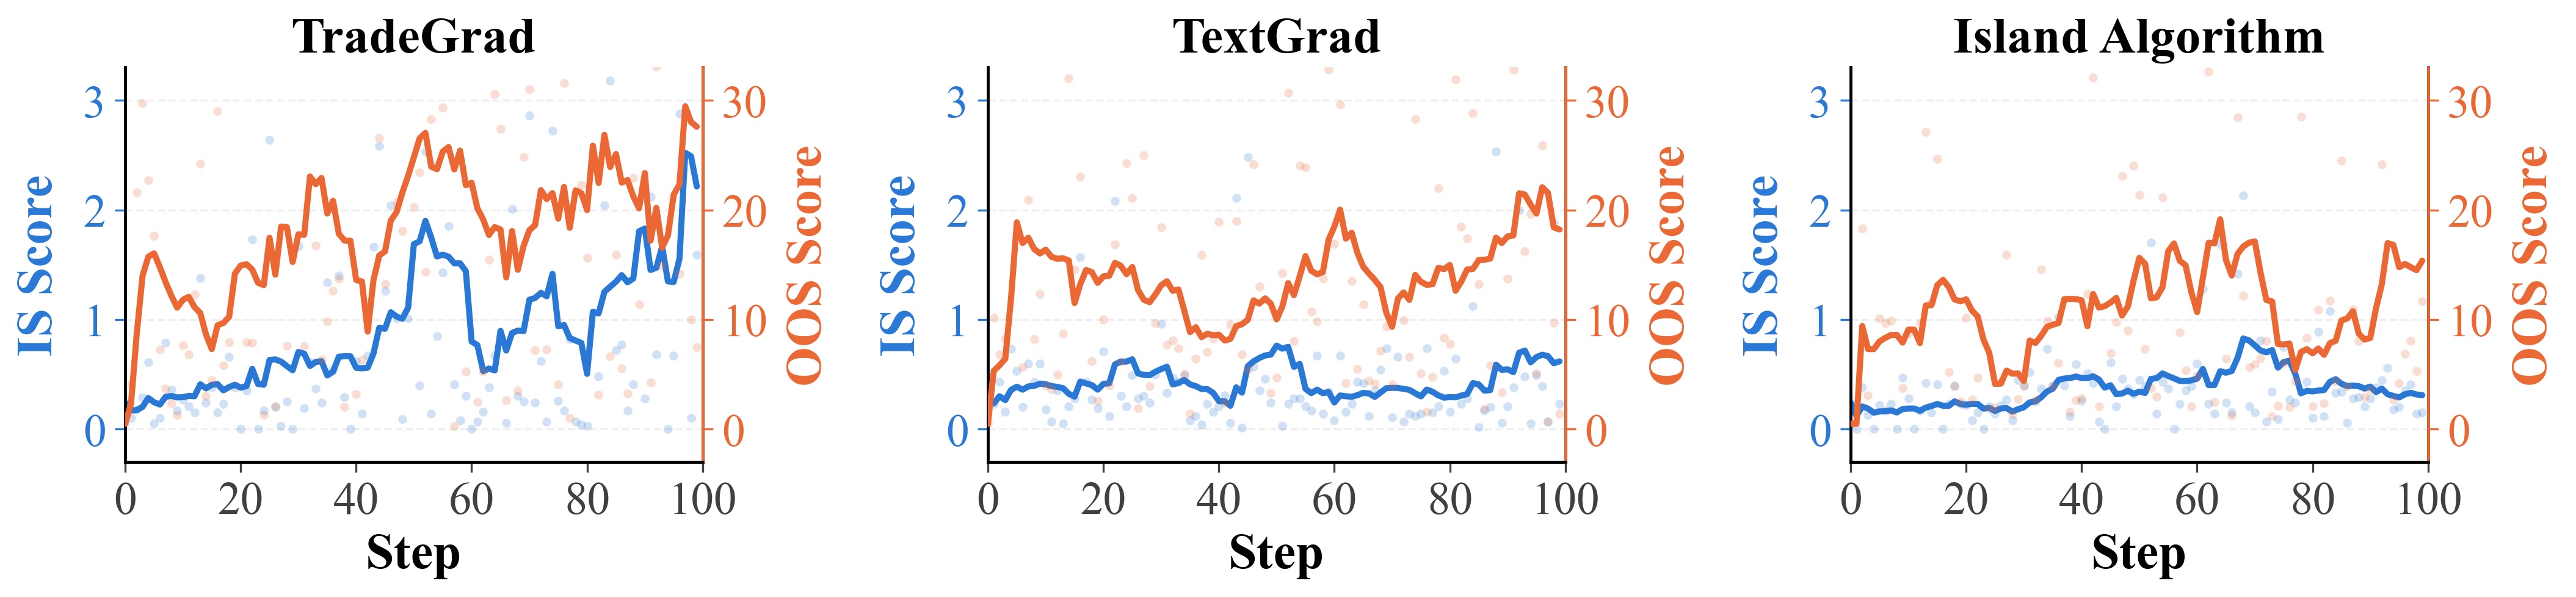
셋째, 자동 생성 방법 자체가 불안정합니다. LLM에게 전략 코드를 '진화'시키는 방법(좋은 전략끼리 섞고 변형하는 방식)이나, 단순히 "개선점 알려줘"라고 묻는 텍스트 피드백 방식은, 기존 연구들에서 보면 오히려 전략 성적을 망치는 경우가 많습니다. 이 논문의 실험에서도 이런 자동화 베이스라인들은 과거 데이터에서는 성적이 올라가다가도, 미래 구간에서 손실로 돌아서는 일이 비일비재했습니다.
핵심 아이디어
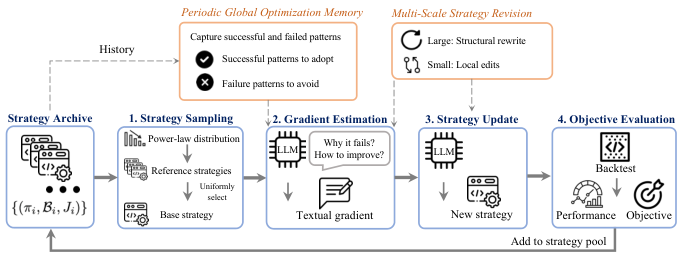
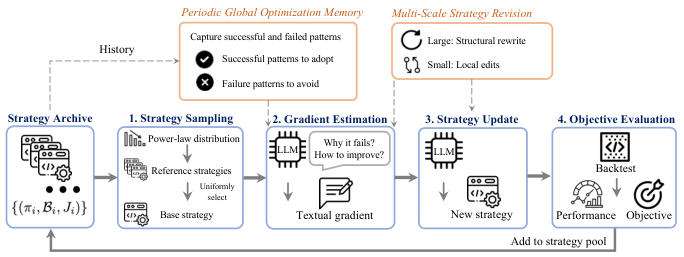
논문이 제안하는 TradeGrad는 "전략 = 실행 가능한 코드"로 보고, AI가 코드를 반복 수정해 가는 최적화 과정을 세 가지 장치로 업그레이드합니다.
장치 1 — 실패 노트를 모으는 '글로벌 메모리'. TradeGrad는 지금까지 시도한 모든 전략과 그 결과를 아카이브에 쌓고, 일정 간격마다 "무엇이 통했고 무엇이 실패했는지"를 요약해 두는 메모리를 만듭니다. 이후 수정할 때마다 이 메모리를 참고 자료로 함께 보여 주므로, AI가 지난 50번의 실패를 되풀이하지 않습니다. 소거 실험에서 이 메모리가 가장 결정적이었습니다 — 메모리를 빼자 성과가 크게 무너졌습니다.
장치 2 — '텍스트 그래디언트'로 수정 방향 잡기. 기존의 텍스트 피드백 방식은 전략 하나만 보고 "이걸 고쳐 보세요"라고 말합니다. TradeGrad는 아카이브에서 성적이 좋은 전략 여러 개를 뽑아 나란히 비교시켜 줍니다. "A 전략은 변동성 장에서 잘 버텼고 B 전략은 추세 장에서 강했는데, 기본 전략인 C는 둘 다 못 버텼다"는 식의 비교 분석이 바로 텍스트 그래디언트입니다. 확률 배분도 교묘해서, 참고할 전략은 상위권에서 뽑되(좋은 예시를 많이 보여 주되) 수정 대상은 의도적으로 다양한 등급에서 고릅니다. 훌륭한 학생의 답안지뿐 아니라 평범한 답안지의 실수까지 참고해야 교정이 빨라지는 원리입니다.
장치 3 — 크게 고칠 때와 작게 고칠 때를 섞기. 전략 수정에는 "핵심 로직을 통째로 다시 짜는" 큰 수정과 "특정 조건 하나만 다듬는" 작은 수정이 있습니다. TradeGrad는 확률로 이 둘을 섞습니다. 실험에서 큰 수정만 하거나 작은 수정만 하면 성과가 떨어졌고, 혼합이 가장 좋았습니다. 시야를 넓게 돌리는 것과 디테일을 다듬는 것을 오가는 셈입니다.
그리고 가장 흥미로운 부분, 전략을 고르는 기준을 바꿉니다. 과거 데이터를 여러 구간으로 나눈 뒤 각 구간에서 점수를 매기고, 가장 성적이 나빴던 하위 30% 구간의 평균만 봅니다. 잘 나온 구간의 대박이 못 나온 구간의 손실을 절대 만회할 수 없게 만드는 겁니다. 마치 "체력이 가장 약해지는 순간의 모습"으로 선수를 평가하는 것과 같습니다. 여기에 "거래가 너무 적은 전략은 벌점"이라는 장치도 더해, 데이터에 딱 붙어 앉아 아무것도 안 하는 전략이 높은 점수를 받는 것을 막습니다.
결과 — 무엇을 알아냈나
실험은 중국 주식(CSI 300 구성 종목)과 미국 주식(S&P 500 구성 종목)에서 각각 진행했습니다. 2018년부터 2025년까지의 일봉 데이터를 "최적화에 쓰는 구간"과 "한 번도 보여 주지 않는 검증 구간"을 3대 1로 나누고, 후보 전략 100개를 만드는 동일한 예산 안에서 방법들을 공정하게 비교했습니다. 거래비용(매매당 0.05% 슬리피지와 0.05% 수수료, 중국 주식은 증권세 0.1% 추가)을 수익률에 직접 반영했고, 모든 결과는 3회 실행의 평균입니다.
눈에 띄는 결과부터 말하면, "백테스트에서 좋은 전략을 찾는 능력"과 "미래 구간에서 잘하는 능력"이 함께 올라간 방법은 TradeGrad뿐이었습니다. 네 가지 설정(두 시장 × 종목별 포트폴리오/지수 거래) 전부에서 최적화 구간과 검증 구간 성적 모두 1위였습니다.
- 중국 종목 포트폴리오: 연 27.99% 수익에 최대 낙폭 12.19%, 샤프 비율 1.63. 비교 대상 중 연수익이 가장 높았습니다.
- 미국 종목 포트폴리오: 연 6.05% 수익에 최대 낙폭 3.93%로, 비교 대상 중 가장 낮은 낙폭이었습니다. 한 번도 보여 주지 않은 검증 구간에서 방어적으로 수익을 냈다는 점이 인상적입니다.
- 미국 지수 거래: 이동평균선 전략이 연 24.09%로 수익은 더 높았지만, 최대 낙폭이 33.54%나 됐습니다. TradeGrad는 연 12.39%에 낙폭 7.79%, 샤프 비율 1.32로, "덜 흔들리면서 버티는" 전략이 나왔습니다.
반면 자동 생성 베이스라인들은 참담했습니다. 전략 코드를 '진화'시키는 두 방법과 텍스트 피드백 방식은 중국·미국 종목 포트폴리오에서 검증 구간 손실(연 −5.59% ~ −12.74%)을 냈습니다. 백테스트 성적은 올라가는데 미래 구간에서 무너지는, 앞서 말한 "기억을 잃은 요리사" 증상이 그대로 관측된 겁니다. 재미있게도 고전적인 투자 전략(변동성 기준 전략, 그리드 매매 등)은 의외로 꽤 강했습니다. 이는 "AI가 항상 이긴다"가 아니라 "잘 설계된 탐색 절차가 중요하다"는 점을 분명히 보여 줍니다.
핵심 장치들을 하나씩 빼 보는 실험도 명확했습니다. 경험 메모리를 빼자 미래 구간 점수가 65.65에서 35.62로, 여러 전략을 비교하지 않고 하나만 보게 하자 46.72로 떨어졌습니다. 전략 고르는 기준을 "가장 약한 구간 평균"에서 "전체 평균"으로 바꾸자 23.37로, 전체 합산으로 바꾸자 35.63으로 급락했습니다. 거래 빈도 벌점을 빼면 샤프 비율이 1.63에서 0.73로 반토막 났습니다. 즉, 좋은 성과가 어느 한 장치가 아니라 경험 축적 + 비교 분석 + 약한 시기 중심 평가의 조합에서 나온다는 뜻입니다.
한계와 주의점
솔직한 한계도 짚어야 합니다.
- 실험 범위가 넓지 않습니다. 주식 2개 시장, 일봉 데이터, 후보 100개라는 예산, 3회 실행 기준의 결과입니다. 자산군(채권·외환·파생), 고빈도 거래, 더 큰 예산에서는 이야기가 달라질 수 있습니다. 저자들도 이를 미래 과제로 명시합니다.
- 완전한 백테스트 연구입니다. 실거래 검증은 없고, 거래비용도 단순 비율로만 모델링되어 시장 충격이나 유동성 제약은 반영하지 않았습니다.
- '미래 구간'은 여전히 과거입니다. 검증 구간은 최적화 때 보지 않은 데이터라 과최적화를 크게 줄여 주지만, 진짜 미래 시장의 분포 변화(새로운 위기, 규제 변화)까지 보장하지는 않습니다.
- AI 모델에 의존합니다. 전략은 LLM이 생성하므로, 쓰인 모델의 코딩 능력이 전략의 품질 상한을 만듭니다. 결과는 저자가 사용한 특정 LLM 기준입니다.
그래서 투자/실무엔?
퀀트 전략 개발을 직접 하시는 분이라면, 이 논문의 교훈을 "AI 도입법"보다 "평가 기준 설계"로 읽으시는 게 좋습니다.
첫째, 전략 후보를 고를 때 '가장 약했던 구간'을 보세요. 평균 수익률 하나로 후보를 줄 세우면 좋은 시기에 의존하는 전략이 상위권을 차지합니다. 구간별 성적을 나누고 하위 꼬리(예: 최악 30% 구간 평균)를 승인 기준으로 삼으면, 이런 전략이 걸러집니다. 이건 AI 없이 수동 전략 개발에도 그대로 적용되는 원칙입니다.
둘째, 실패 기록을 자산으로 만드세요. 전략 탐색을 자동화한다면, 매 시도의 결과를 "무엇이 통했고 무엇이 실패했는지"의 형태로 메모리에 남기고 다음 수정에 반영하는 구조를 설계하세요. 이 논문에서 가장 성과 기여가 컸던 장치가 바로 이겁니다.
셋째, 수정은 비교로 하세요. 전략 하나의 단점만 지적하는 피드백보다, 잘 된 전략과 안 된 전략을 나란히 놓고 비교하는 피드백이 훨씬 효과적이었습니다. 리뷰 프로세스를 짤 때도 참고할 만한 원리입니다.
물론 이 방법이 "손실 없는 전략"을 보장하지는 않습니다. 다만 "백테스트 대박의 함정"을 통계적으로 줄이는 구체적인 설계를 제시했다는 점에서, 전략 자동 생성을 진지하게 고민하는 팀에게는 꼭 읽어 볼 만한 연구입니다.
더 알아보기
- 원문 논문: Trading Strategy Optimization via Textual Gradient (arXiv:2610.03128)
- OHSE AI Lab 5차원 평가 (신규성/활용성/엄밀성/재현성/통찰력): 72 / 70 / 62 / 78 / 68 — 재현성이 78로 높은 편(코드·데이터 공개, 실험 설정 상세 기술)이고, 엄밀성(62)은 다소 아쉽습니다(실험이 2개 시장·3회 실행에 한정).
- 관련 논문:
- TriAgent: Divergence-Aware Multi-Agent Committees for Cost-Efficient Financial Trading (arXiv:2607.19794) — LLM 다중 에이전트 트레이딩
- Time Travel is Cheating: Going Live with DeepFund for Real-Time Fund Investment (arXiv:2505.11065) — 실시간 펀드 운용 에이전트
- StockBench: Can LLM Agents Trade Stocks Profitably In Real-world Markets? (arXiv:2510.02209) — LLM 에이전트의 실제 시장 거래 검증
관련 글
 LLM 트레이딩 에이전트A
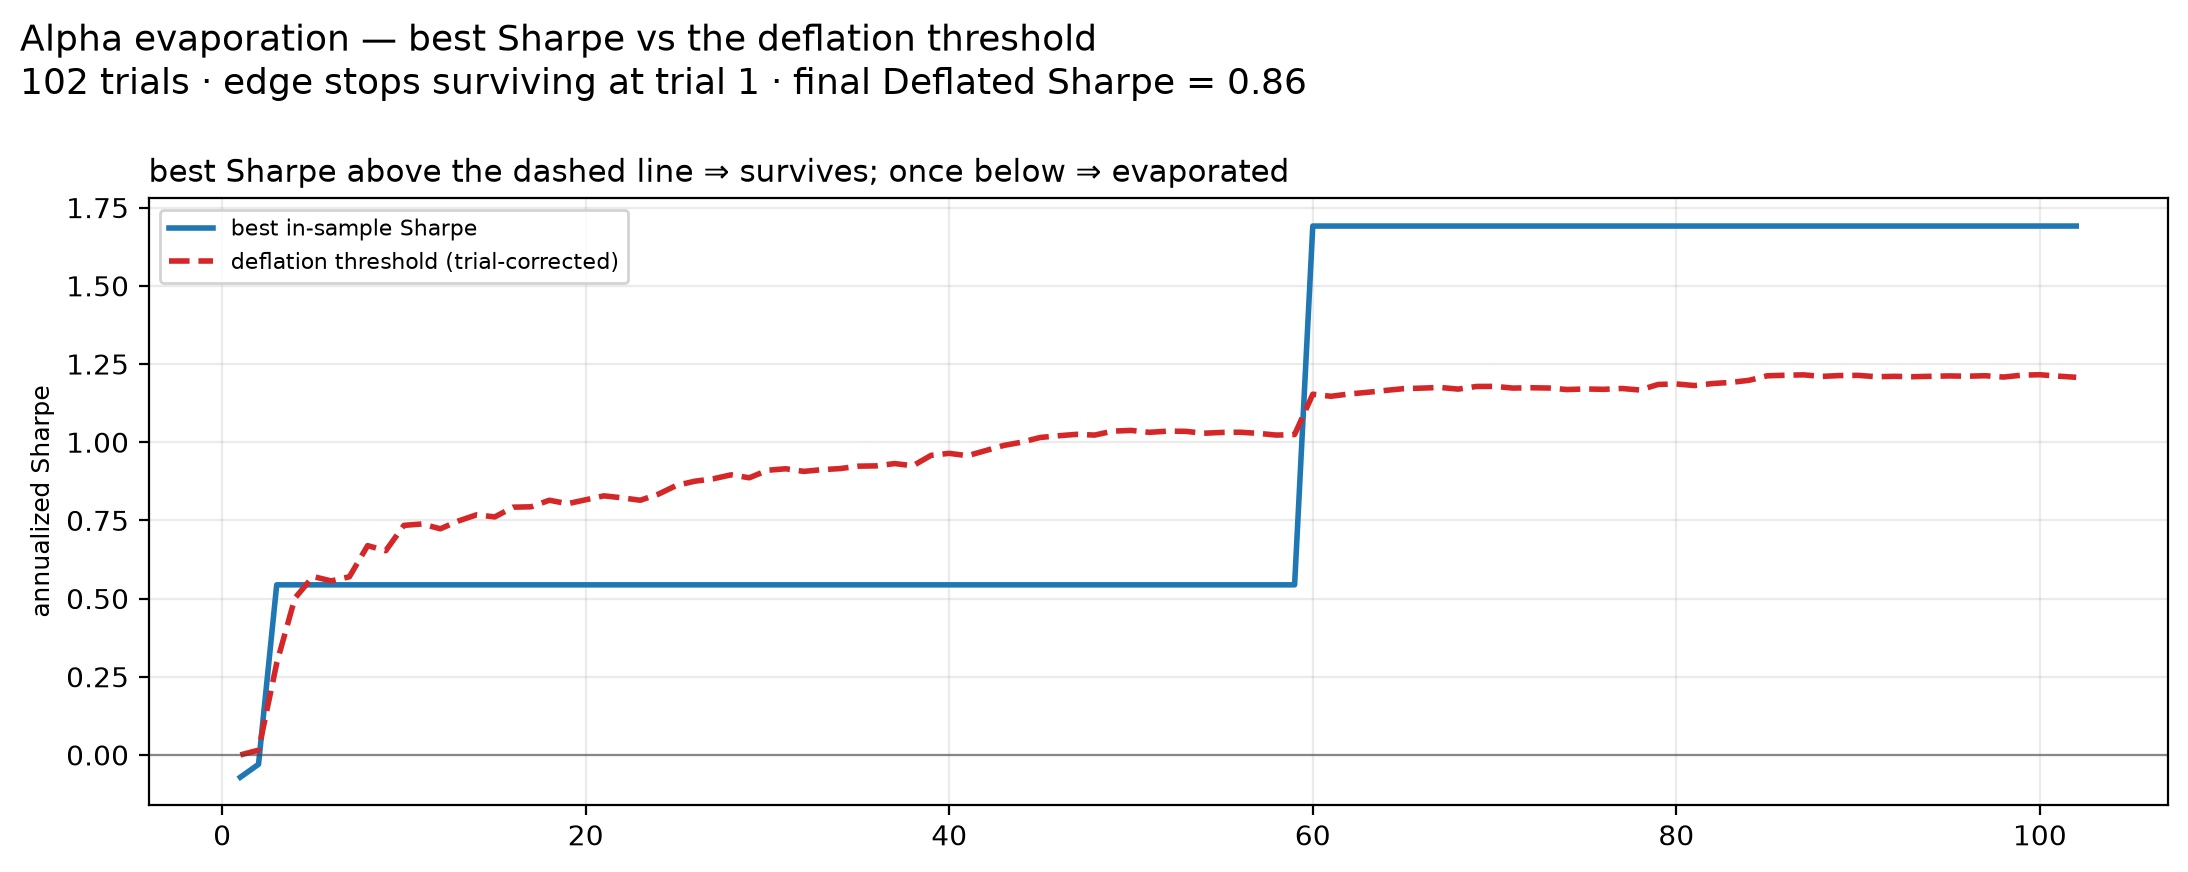
LLM 트레이딩 전략 100개 자동 발굴, 정직한 평가를 통과한 것은?
AI가 트레이딩 전략을 대량으로 만들어 그중 최고 성적만 보고하는 시대. 데이터 누수 차단과 탐색 횟수 보정으로 100개 후보를 정직하게 시험한 연구가 무엇을 남겼는지, 백테스트 과대평가의 함정부터 쉽게 풀어 설명합니다.
 강화학습 포트폴리오
가상 시장을 만들어 연습시킨 AI 포트폴리오 매니저 — vine copula 시뮬레이션과 강화학습이 거래비용을 41.5% 줄인 비결
투자는 미래가 한 번뿐이라 연습할 수 없다. 이 논문은 자산 간 관계를 배워 가상 시장을 찍어내고, 그 가상 세계에서 강화학습 매니저를 훈련시켜 22개월 실전에서 연 34.13%, 샤프 2.31을 기록했다. 시뮬레이션 연습이 거래비용을 41.5% 줄인 과정과, '모형을 믿어도 되는가'를 수학적으로 따진 점을 쉽게 정리한다.
 포트폴리오 최적화A
옵션 가격 모형의 무차익 보장: GROMM과 S&P 옵션 219만 건 검증
옵션 시장 모형이 '무차익'이라는 말을 증명하려면 무엇을 해야 할까. GROMM은 S&P 500 옵션 219만 개 호가로 가격표면을 맞추고, 5천 개 계약 전체에서 위험중립성을 검증했습니다. 국소변동성과 시나리오 생성의 시사점을 정리합니다.