
Temporal Leakage in Financial News NLP: A Multi-Architecture Audit with a Regime-Specific M&A Signal
Chenhao Xue, Raslen Guesmi, Siwei Feng, Yucheng Gong, Jacob Xavier Sundram, Jordan Pang 외 2명
뉴스 제목만 보고 내일 주가 방향을 맞히는 AI, 믿으시겠어요? 그런데 그 성능의 대부분이 "시험 문제를 미리 외운" 결과라면?
들어가며: 공정한 시험 vs 문제를 미리 아는 시험
수능 모의고사에서 90점을 맞은 학생이 있다고 해봅시다. 대단하죠. 그런데 알고 보니 이 학생, 공부를 잘한 게 아니라 "출제 경향이 겹치는 같은 달의 기출 문제를 외운" 학생이었습니다. 진짜 시험(다음 달, 새로운 출제)에서는 60점도 못 맞춥니다.
금융 AI 세계에서 매일 일어나는 일이 바로 이겁니다. 뉴스 기사로 주가 방향을 예측하는 연구들은 흔히 "정확도 60% 돌파!" 같은 흥미로운 결과를 내놓습니다. 그런데 그 성능 측정을 "데이터를 무작위로 섞어서" 했다면, 모델은 사실 다음 주가를 예측한 게 아니라 "같은 시장 분위기 속의 어휘와 패턴을 암기한" 것일 수 있습니다.
2026년 8월 arXiv에 올라온 이 논문은 이 문제를 16개 모델 조합으로 대규모 감사하고, "그렇다면 진짜로 남는 신호는 무엇인가?"까지 끝까지 추적합니다. 결론부터 말하면, 대부분의 신호는 사라지고 딱 하나, M&A(인수합병) 뉴스에서만 약하지만 실재하는 신호가 남았습니다.
무엇이 문제였나: "시간"이 빠진 데이터 나누기
AI 모델을 훈련할 때는 데이터를 '훈련용'과 '시험용'으로 나눕니다. 이때 두 가지 방법이 있습니다.
- 무작위 분할(random split): 전체 데이터를 섞어서 70%는 훈련, 30%는 시험. 편하고 흔한 방법입니다.
- 시간 순 분할(chronological split): 과거 데이터는 훈련, 미래 데이터는 시험. 현실과 같은 방식입니다.
금융 뉴스에서는 이 차이가 치명적입니다. 왜냐하면 뉴스 문구, 기업 이름, 시장 분위기(국면), 주가 수익률이 모두 시간적으로 함께 움직이기 때문입니다. 2025년 상반기 'AI 랠리' 시절의 뉴스를 무작위로 반으로 쪼개면, 훈련셋과 시험셋이 같은 랠리의 이야기를 담고 있게 됩니다. 모델은 "AI 관련 단어가 나오면 오른다"는 그 시절의 분위기를 암기하고, 시험에서도 같은 분위기의 기사를 만나니 성공하는 것이죠. 문제는 이 모델이 다음 국면(예: 금리 인하 시기)에서는 완전히 무너진다는 것입니다.
논문 저자들은 이걸 시간 누수(temporal leakage)라고 부릅니다. 미래의 정보(같은 국면의 지식)가 과거의 예측에 몰래 새어 들어간다는 뜻입니다. 백테스트에서 "미래 정보가 과거에 쓰이는" 룩어헤드 바이어스와 사촌뻘인 함정입니다.
핵심 아이디어: 16개 모델로 "부풀림"을 재다
논문의 접근은 단순하고 강력합니다. 같은 데이터, 같은 모델로 분할 방법만 바꿔서 성능을 비교한 것. 그것도 하나가 아니라 16개 조합으로요.
- 데이터: 전 세계 64개 거래소의 금융 뉴스 56,409건(2020년 5월~2025년 8월). 이 중 중립적이거나 수익률이 거의 없는 기사를 빼면 49,799건. 이벤트 종류만 203가지.
- 예측 목표: 기사가 나온 뒤 주가가 오를지 내릴지(UP/DOWN). 성능 지표는 MCC라는 것인데, 쉽게 말하면 "예측이 실제와 얼마나 맞물렸는가를 −1(반대 방향)부터 1(완벽)까지 나타낸 점수"입니다. 0이면 동전 던지기 수준입니다.
- 모델 라인업: 단순한 단어 세기 방식(TF-IDF)부터, 문장 이해에 특화된 금융 전용 언어모델(FinBERT), 거대 언어모델 파인튜닝(RoBERTa, DeBERTa)까지 총망라.
- 공정한 시험 준비: 시간 순 분할도 철저하게 — 2025년 4월 이전(21,654건)으로 훈련, 2025년 4~5월(10,866건)로 조정, 2025년 6월 이후(17,279건)는 딱 한 번만 열어보는 시험셋.
결과 — 무엇을 알아냈나
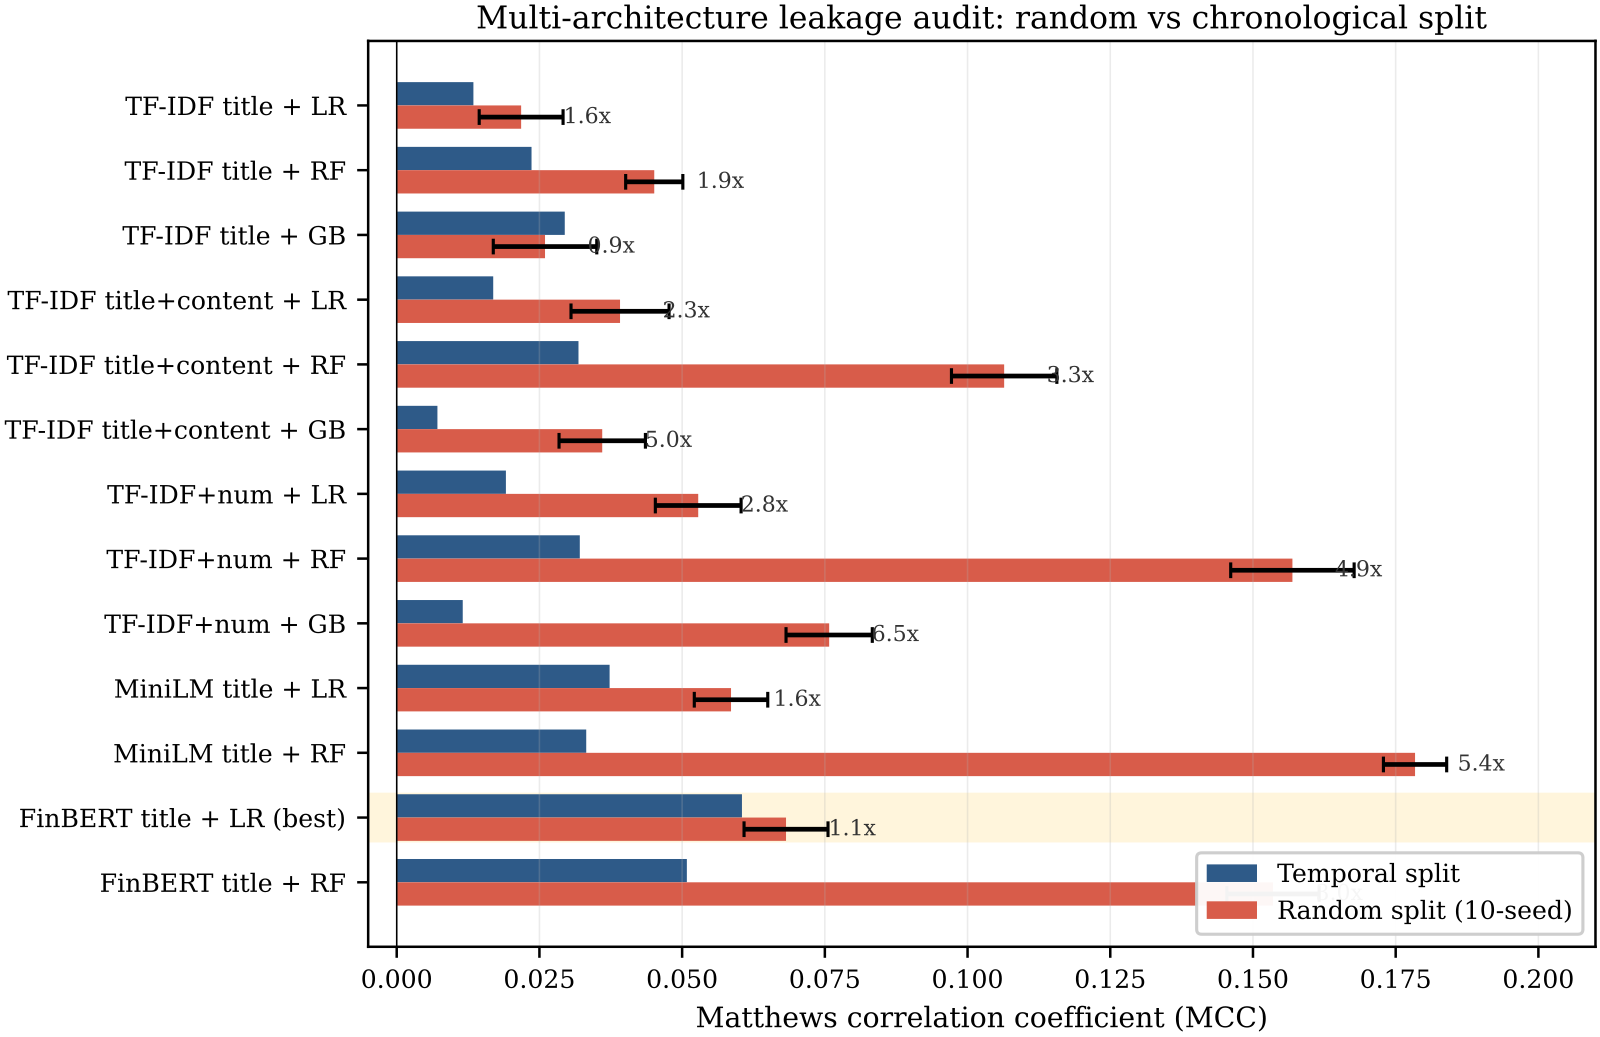
1. 부풀림은 실재했고, 최대 6.5배였다
무작위 분할 성능이 시간 순 분할보다 1.1배에서 6.5배까지 높게 나왔습니다. 뚜렷한 패턴이 있습니다.
| 모델 조합 | 무작위 분할 MCC | 시간 순 분할 MCC | 부풀림 배수 |
|---|---|---|---|
| TF-IDF + 수치 특징 + 그래디언트 부스팅 | 0.076 | 0.012 | 6.5배 |
| MiniLM + 랜덤 포레스트 | 0.178 | 0.033 | 5.4배 |
| TF-IDF + 수치 특징 + 랜덤 포레스트 | 0.157 | 0.032 | 4.9배 |
| FinBERT 파인튜닝 | 0.174 | 0.064 | 2.7배 |
| FinBERT + 로지스틱 회귀 | 0.068 | 0.060 | 1.1배 |
쉽게 말하면 "모델이 똑똑하고 특징이 많을수록 더 잘 속았다는 뜻입니다. 복잡한 모델일수록 "외울 거리"를 더 잘 외웁니다. 반대로, 금융에 특화된 임베딩(FinBERT)을 그대로 얼려두고 간단한 분류기를 얹은 조합이 가장 정직했습니다.
흥미로운 점: 가장 성능이 좋아 보였던 대형 모델 파인튜닝(RoBERTa-large)은 시간 순 분할에서는 아예 "무조건 오른다"고만 예측하는 모델로 붕괴(MCC 0.000)했습니다. 무작위 분할에서는 0.174라는 그럴듯한 점수를 받았지만요.
2. 그래서 진짜 신호는? — "일반 뉴스"는 거의 무작위 수준
시간 순 분할로 정직하게 시험을 보면, 뉴스로 주가 방향을 예측하는 성능은 MCC 0.06 안팎에 그칩니다. 동전 던지기(0)보다 조금 나은 수준입니다. 문헌에 오르던 "정확도 60%"대 결과들은 상당수가 분할 방식의 산물이었다는 씁쓸한 확인입니다.
3. 단 하나 살아남은 신호: M&A 뉴스
다만 논문은 "전부 허구"라는 식으로 끝내지 않습니다. 203가지 이벤트 유형 중 인수합병(M&A) 뉴스만 시간 순 락 테스트에서 실재하는 신호를 보였습니다.
- 성능: MCC 0.138 (테스트 786건, 2025년 6~8월). 3개월 각각 +0.126, +0.135, +0.171로 매월 양수.
- 통계적 견고함: 라벨 10,000번을 무작위로 섞어 만든 '가짜 성능 분포'와 비교하면 z값 3.81, 양측 p값 0.001 미만. 주 단위 블록 부트스트랩 95% 신뢰구간도 [+0.066, +0.205]로 0을 확실히 벗어납니다.
- 우연이 아님의 추가 증거: 날짜 기준을 ±7일, ±14일 흔들어도 MCC [+0.115, +0.156] 범위. 6개월로 시험 기간을 넓혀도 +0.133으로 거의 동일합니다.
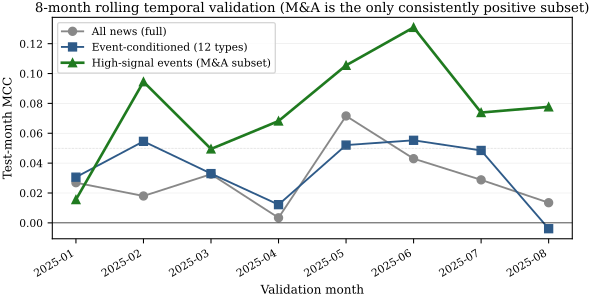
그리고 이 신호가 "이벤트가 많아서 생긴 착시"가 아님을 확인하는 대조 실험도 있었습니다. 같은 파이프라인을 다른 대형 이벤트 유형에 돌려본 결과: 실적 발표 −0.039, 경영진 변동 −0.074, 임상 연구 0.000. M&A만 +0.123이었습니다. 또한 시장 전체 움직임을 뺀 '초과수익' 기준으로 라벨을 바꾸자 성능이 오히려 올라가고(검증 MCC 0.092 → 0.146), 기사 본문 없이 날짜·거래소 같은 메타데이터만 쓰면 성능이 사라지는 것으로 보아, 신호가 글 자체에 있다는 것도 확인했습니다.
4. 신호의 실체: "산다(매수자)"는 말이 담긴 기사
무엇이 이 신호를 만드는지 조사해 보니, 인수를 진행하는 회사(매수자) 관련 기사에서 신호가 강하게 나타났습니다. 예를 들어 "A사가 B사를 인수한다"는 뉴스에서 A사의 반응이 더 예측 가능했다는 것입니다. 다만 이 부분은 표본이 작아(84~125건) 통계적 확정은 못 하고, 여러 방법이 같은 방향을 가리키는 정성적 단서로만 보고했습니다.
5. 중요한 함정: 이 신호도 "그 시절, 그 지역" 한정
저자들은 정직하게 한계를 밝힙니다. 이 M&A 신호는 2024~2025년 유럽 중심의 M&A 관행에 묶여 있습니다. 미국 2009~2020년 뉴스 데이터셋(FNSPID)에서 똑같이 시험해 보니 신호가 깨끗하게 사라졌습니다(성능 −0.011). 다른 데이터셋(EDT)에서는 M&A 정의를 좁게 잡았을 때만 약하게 재현되었고, 정의를 넓히면 사라졌습니다.
한계와 주의점
- 데이터의 81%가 2025년에 몰려 있습니다. 시험 기간도 훈련 종료 직후 3개월이라, 완전히 다른 시장 국면에서 통하는지는 검증되지 않았습니다. 저자들도 "2025년 국면 한정"이라는 단서를 붙입니다.
- M&A 신호의 크기는 작습니다. MCC 0.138은 "돈을 벌어다 준다"가 아니라 "동전 던지기보다는 낫다" 수준입니다. 거래비용을 넣은 시뮬레이션의 Sharpe 비율 상위 4분위 +2.62는 시험셋에서 임계값을 고른 상한치이며, 전량 매매 기준선은 +0.52에 불과합니다.
- 인과 관계가 아닙니다. "M&A 뉴스를 읽어서 주가를 예측할 수 있다"이지 "인수가 주가를 움직인다"가 아닙니다.
- 매수자 편향은 미확정: 통계적 유의성을 넘지 못한 정성적 발견입니다.
- 재현성 절반: 데이터셋·코드·프롬프트가 공개되어 있고 재현 계획까지 명시되어 있지만, 핵심 뉴스 코퍼스 자체는 상용 데이터 제공자 것입니다.
그래서 투자/실무엔?
- 성능 수치를 볼 때 가장 먼저 "데이터를 어떻게 나눴나"를 물어보세요. 무작위 분할 성능이라면, 최대 6.5배까지 부풀려져 있을 수 있습니다. 이 논문의 감사 방법(같은 모델을 두 분할로 비교)은 누구나 30분 안에 따라 할 수 있습니다.
- "AI가 뉴스로 주가를 예측한다"는 주장은 대부분 과대평가되어 있습니다. 정직한 시간 순 검증에서는 성능이 0.06 남짓입니다. 상용 시그널을 도입할 때는 판매자의 백테스트가 어떤 분할인지 꼭 확인해야 합니다.
- 약한 신호라도 "무엇에 대한" 신호인지 아는 것이 중요합니다. 이 연구에서 남은 것은 "전체 뉴스"가 아니라 "M&A, 특히 매수자 기사"라는 좁은 신호였습니다. 시장 전체가 아니라 사건 유형별로 쪼개어 검증하는 습관이 실전에서 유용합니다.
- 국면 한정 단서를 항상 붙이세요. 2025년 유럽에서 통한 신호가 미국 과거 시장에서는 통하지 않았습니다. 전략을 이식할 때는 반드시 그 시장·그 시절에 다시 시험해야 합니다.
더 알아보기
- 원문: Temporal Leakage in Financial News NLP: A Multi-Architecture Audit with a Regime-Specific M&A Signal (arXiv:2608.17223)
- KB 5차원 점수 (참고): 새로움 75 / 적용성 76 / 엄밀성 74 / 재현성 30 / 통찰 82 — 재현성 점수는 초록 기준이며, 실제로는 데이터셋·코드·프롬프트가 공개되어 있어 상향 여지가 있습니다.
- 함께 읽기 좋은 논문:
- FNSPID: A Comprehensive Financial News Dataset in Time Series (arXiv:2402.06698) — 이 논문이 교차 검증에 사용한 대표 뉴스 데이터셋
- Trillion Dollar Words: A New Financial Dataset, Task & Market Analysis (arXiv:2305.07972) — 뉴스 단어와 시장 반응을 연결한 고전적 데이터셋 연구
- Sentiment trading with large language models (arXiv:2412.19245) — LLM 센티먼트 트레이딩의 성능을 검증하는 또 다른 시각
- From Financial Sentiment Classification to Return Predictability (arXiv:2608.04200) — 감정 분류가 수익률 예측으로 이어지는지 되묻는 최근 연구
관련 글
 📰 데일리
2026-09-15 일일 블로그 — 초안 생략
2026-09-15 데일리 수집 논문 중 S/A 등급이 없어 블로그 초안을 생략합니다.
 📰 데일리
2026-09-15 일일 블로그 — 초안 생략
2026-09-15 데일리 수집 논문 중 S/A 등급이 없어 블로그 초안을 생략합니다.
 팩터 투자A
팩터 신호 상관이 수익률 상관과 다른 이유 — 정확한 수학적 증명
투자 신호 간 유사성과 실제 수익률 간 상관이 왜 다른지 정확한 분해식으로 밝힌 연구를 쉽게 풀어 설명합니다. 팩터 포트폴리오를 구성하는 분들에게 꼭 필요한 진단 도구를 소개합니다.