
Uniform Inference and Certified Capacity at a Reflexive Stability Boundary
Alejandro Rodriguez Dominguez
"확실하지 않으면, 확실한 척하지 말고 한도를 줄여라."
이것이 이 논문의 핵심 메시지입니다. 조금 심심하게 들리시나요? 그런데 이 문장 하나를 지키는 데 필요한 수학이 얼마나 깊은지, 그리고 이 문장을 무시하면 어떤 일이 벌어지는지를 시뮬레이션 6만 번으로 증명한 논문이 2026년 9월에 나왔습니다. 오늘 소개할 논문은 "Uniform Inference and Certified Capacity at a Reflexive Stability Boundary"(반사적 안정성 경계에서의 균일 추론과 인증된 용량)입니다.
들어가며: 흐린 날의 운전자와 애매한 엑스레이
날씨가 흐린 날, 도로가 젖었을 때 우리는 자연스럽게 속도를 줄입니다. "아마 괜찮을 것 같지만" 확신이 없으니까요. 여기서 중요한 건, 흐린 날의 운전자가 "내가 지금 잘 모른다"는 사실 자체를 정보로 쓴다는 점입니다. 확신이 없으면 확신 있는 척하며 그대로 달리는 대신, 사고 비용이 줄어드는 쪽(속도 감소)을 선택합니다.
의사의 경우도 비슷합니다. 엑스레이 판독이 애매할 때 좋은 의사는 "아마 양성일 것"이라며 단정하지 않습니다. 대신 추가 검사를 하거나, 한동안 지켜보거나, 보수적으로 치료를 시작합니다. 확신이 없는 구간에서 무리하게 결론을 내리지 않는 것 — 이게 바로 이 논문이 금융 시장에 적용하려는 태도입니다.
그런데 금융 쪽에서는 어떤가요? "이 시장은 안정적인가, 불안정적인가?", "내 포트폴리오를 지금 얼마나 더 늘려도 되는가?" 같은 질문에 대해, 흔히 쓰이는 방법은 데이터를 넣고 점 추정 하나를 얻은 다음 "안정적!" 또는 "불안정!" 하고 딱 잘라서 답하는 것입니다. 이 논문은 그 딱 잘라서 답하는 방식이 얼마나 위험한지, 그리고 어떻게 하면 "모른다"는 답까지 포함해서 정직하게 답할 수 있는지를 수학적으로 다룹니다.
무엇이 문제였나: 시장에 피드백이 있을 때 생기는 위험
내 주문이 시장을 흔들면?
큰 자금으로 주식을 사면 가격이 오릅니다. 그리고 그 가격 상승은 다시 내 포트폴리오의 기대수익을 바꿉니다. 이런 현상을 교차충격(cross-impact)이라고 부릅니다. "내가 A 주식을 사는 주문이 B 주식 가격까지 흔들 수 있다"는 뜻입니다.
이것이 왜 중요한가요? 포지션이 커질수록 내 거래가 시장에 영향을 주고, 그 영향이 되돌아와서 다시 내 결정을 바꾸는 재귀 고리(feedback loop)가 생깁니다. 어떤 크기까지는 이 고리가 안정적으로 수렴합니다 — "내가 시장을 약간 흔들어도 다시 제자리로 돌아온다". 하지만 고리가 특정 크기를 넘어서면 발산하기 시작합니다 — "흔들림이 스스로 증폭된다". 이 경계선이 바로 논문 제목의 안정성 경계(stability boundary)입니다.
문제는 이 경계선의 위치를 데이터로 계산해야 한다는 점입니다. 경계선 위치는 세 가지에 달려 있습니다.
- 조건부 리스크(Q) — 시장이 얼마나 흔들리는가
- 교차충격(K) — 내 주문이 시장에 얼마나 영향을 주는가
- 위험부담능력(c) — 내가 실제로 감당할 수 있는 크기는 얼마인가
이 세 값은 모두 시장 데이터에서 추정해야 합니다. 그리고 추정에는 오차가 있습니다. 이 사실을 잊으면 어떤 일이 벌어질까요?
"표본 오차를 무시하면" 벌어지는 일
경계선 근처에서 "지금은 안정적이다"라고 선언했는데, 사실은 데이터의 요동 때문에 경계선 반대편에 있었던 것이라면? 그 선언을 근거로 포지션을 더 키웠다면? 논문이 시뮬레이션으로 보여주듯, 추정 오차를 무시하고 점 추정으로 확정 선언을 내리는 방식(이 논문은 이를 '플러그인' 분류기라 부릅니다)은 전체 실험의 34.863%에서 잘못된 판정을 내렸습니다. 3번 중 1번 넘게 틀린 겁니다.
더 까다로운 상황도 있습니다. 경계선의 위치를 계산하는 수학에서 고유값(eigenvalue)이라는 것이 핵심 역할을 하는데, 이 고유값들이 서로 충돌하는 구간(정확히 같은 값이 되거나, 구별할 수 없을 만큼 가까워지는 구간)에서는 흔히 쓰이는 통계 근사가 통째로 무너집니다. 논문의 반례에 따르면, 명목 95% 신뢰구간이 이런 충돌 구간 근처에서는 실제로는 약 84.0%만 커버합니다. 표준 오차 계산을 아무리 잘해도(심지어 오차를 정확히 안다고 가정해도) 근사 자체가 깨지는 겁니다.
핵심 아이디어: 한 점이 아니라 "원"을 통과시키기
그럼 어떻게 해야 할까요? 논문의 해법은 크게 네 가지입니다.
1. 세 값을 따로 보지 말고, 한 번에 추정하라
조건부 리스크, 교차충격, 위험부담능력은 서로 연관되어 있습니다. 시장이 흔들릴수록 주문도, 감당 능력도 같이 움직입니다. 논문은 이 세 값을 하나의 실험에서 동시에 추정해서, 값들 사이의 상관관계(장기 교차공분산)까지 통째로 보존합니다. 따로따로 추정하면 이런 상관관계가 사라져서 불확실성을 과소평가하게 됩니다.
2. 추정 오차를 "원(타원체)"로 다루고, 통째로 경계에 통과시켜라
이것이 논문의 가장 우아한 부분입니다. 보통은 "리스크가 1.23이다" 같은 점 하나를 얻어서 경계선에 대입합니다. 대신 이 논문은 "리스크는 아마 1.0에서 1.5 사이 어딘가" 같은 신뢰영역(원 모양의 범위)을 먼저 만듭니다. 그리고 그 원 전체를 안정성 경계 계산기에 통째로 밀어 넣어, 그림자가 어디에 놓이는지를 봅니다.
쉽게 말하면, 지도에서 "내 위치는 이 원 안 어딘가"일 때, 목적지까지의 거리를 "정확히 5km"가 아니라 "4km에서 7km 사이"로 계산하는 겁니다. 원이 경계선에 걸쳐 있으면 "글쎄, 잘 모르겠다"가 정답이고, 원이 통째로 한쪽에 있으면 그때야 "안정적이다" 또는 "불안정적이다"를 말할 수 있습니다.
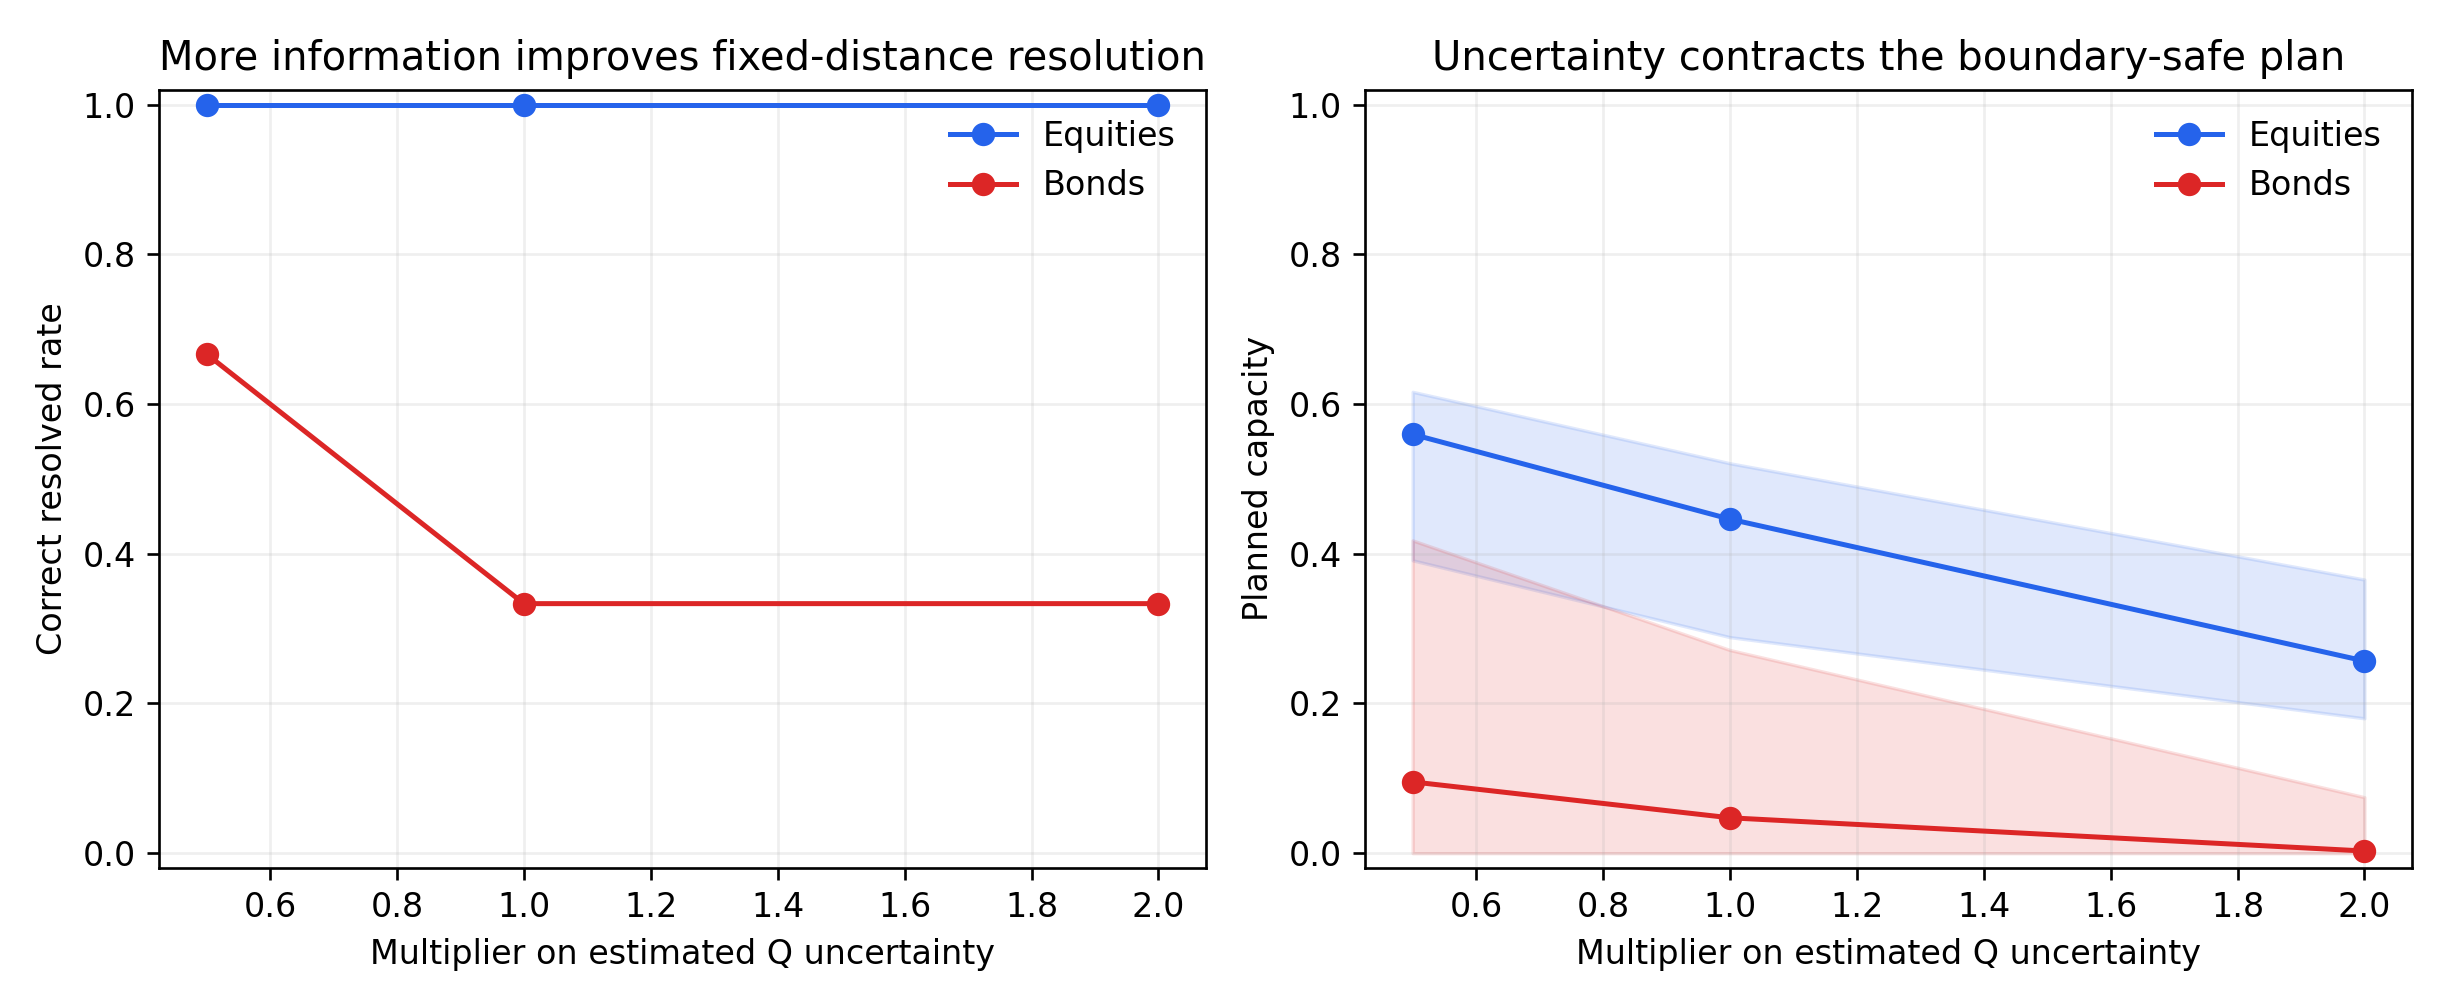
이 "원을 통과시키기" 방식(신뢰영역의 투영, projection)은 고유값이 겹치든 말든 상관없이 항상 같은 보장을 줍니다. 겹치는 구간에서 근사가 깨지는 바로 그 문제를 피하기 위해, 아예 근사를 쓰지 않는 겁니다.
3. 답을 세 가지로 하라: 위험, 안전, 그리고 "모름"
이 논문의 판정은 두 가지가 아니라 세 가지입니다.
- 준임계(SUB): 신뢰영역이 통째로 안정 쪽 → 계획한 한도 안에서 집행해도 됨
- 초임계(SUP): 신뢰영역이 통째로 불안정 쪽 → 한도를 줄이고 별도의 감축 분석 시작
- 판단 유보(UNR): 신뢰영역이 경계선에 걸쳐 있음 → 결론을 내리지 않고, 일측 상한만 사용
놀라운 것은 이 "판단 유보"가 결함이 아니라 필수 장치라는 점입니다. 논문은 증명으로 보여줍니다: 경계선에 바짝 다가가 있는 상황에서는, 오류를 없애면서도 매번 결정을 내리는 절차가 수학적으로 존재하지 않습니다. "모른다"는 답을 허용하지 않으면, 그 대가로 틀린 확정 선언을 감수해야 합니다. 앞에서 본 34.863%가 그 대가의 예시입니다.
4. 불확실할수록 한도를 줄여라 — 그리고 그것을 "인증"하라
마지막으로, 같은 신뢰영역에서 투자 한도를 계산합니다. 공식의 의미는 단순합니다: "확인된 최악의 붕괴 강도와 완충 지수, 실행 시 초과분을 감안했을 때, 이 한도를 넘지 않으면 안정성이 무너질 확률이 유명 수준(통상 5%) 이내로 유지된다." 논문은 이것을 인증(capacity certification)이라고 부릅니다. 추측이 아니라, 증명된 상한에 근거한 한도인 겁니다.
여기에는 한 가지 정직한 전제가 붙습니다. 계산을 아무리 잘해도, 교차충격을 데이터로 식별할 수 없거나(도구변수의 배제 조건), "용량"의 단위 환산을 설득력 있게 설명할 수 없다면 한도 권고를 아예 내리지 않는 것이 이 프레임워크의 규칙입니다. 계산이 가능하다는 것과 권고를 내릴 자격이 있다는 것은 다르다는 뜻입니다.
결과 — 무엇을 알아냈나
논문은 시뮬레이션 60개 설계 셀에 각각 1,000번, 총 60,000번의 추론 실험을 사전에 고정된 설계로 수행했습니다(결과를 보고 설계를 바꾸지 않았다는 점을 명시적으로 강조합니다).
점 추정 대신 신뢰영역을 쓰면?
| 방법 | 커버리지 | 잘못된 확정 선언 | 판단 유보 |
|---|---|---|---|
| 흔한 근사(점근 델타법) | 86.510% | 4.523% | 51.900% |
| 극도로 보수적인 결정론적 경계 | 100.000% | 0.000% | 91.948% |
| 이 논문의 투영 인증 방식 | 99.992% | 0.003% (2건) | 60.170% |
- 커버리지(coverage)란 "진짜 값이 계산된 범위 안에 들어올 확률"이고, 높을수록 좋습니다.
- 잘못된 확정 선언은 "틀린 쪽으로 확신에 차서 선언한 비율"로, 낮을수록 좋습니다.
- 이 논문의 방식은 흔한 근사보다 커버리지를 크게 올리면서, 틀린 확정 선언을 4.523%에서 0.003%(60,000번 중 2번)로 줄였습니다. 극도로 보수적인 경계 방식은 절대 틀리지 않지만 91.948%나 유보해서 사실상 거의 답을 못 합니다. 이 논문의 방식은 그 중간에서 훨씬 실용적인 지점을 찾습니다.
흥미로운 세부 사항: 틀린 확정 선언 2건은 모두 정확히 경계선 위의 실험에서 발생했고, 수치 오차로 0%로 반올림해 버리지 않고 건수를 그대로 공개합니다. 이런 투명성은 이 논문의 태도를 잘 보여줍니다.
그러면 투자 한도는 어떻게 되나?
| 정책 | 평균 집행 용량 | 경계 위반률 | 평균 후회 |
|---|---|---|---|
| 전지적 정답(오라클) | 0.857 | 0.000% | 0.000 |
| 이 논문의 안전 정책 | 0.541 | 0.000% | 0.104 |
| 결정론적 경계 | 0.342 | 0.000% | 0.196 |
| 흔한 근사 | 0.666 | 1.758% | 0.066 |
| 플러그인(점 추정) | 0.758 | 6.233% | 0.083 |
| 무조건 원하는 만큼 | 1.000 | 58.333% | 1.673 |
정직하게 읽어야 합니다. 위반을 절대 허용하지 않는 정책들 사이에서는 이 논문의 안전 정책이 가장 많은 용량(0.541)을 유지하면서도 위반 0%를 기록합니다. 다만 위반을 약간 감수하는 정책(흔한 근사)은 후회가 오히려 조금 낮을 수 있습니다(0.066 대 0.104). 그러나 위반 비용이 큰 환경(높은 손실 비용 캘리브레이션)에서는 순서가 뒤집힙니다. 이 논문의 안전 정책은 후회 0.107로, 흔한 근사(0.120)와 플러그인(0.271)보다 낮습니다. 즉, 무조건적 승자가 아니라 "안전을 사는 비용 대비 효과"의 문제입니다. 아무튼 "무조건 원하는 만큼" 투자하면 경계 위반이 58.333%라는 결과는 확실합니다.
정보가 부족하면 어떻게 해야 하나? — 이 논문의 실용적 핵심
실제 주식·채권 데이터에서 뽑은 리스크 추정치를 가지고 "추정의 불확실성"을 인위적으로 조이는/푸는 실험(522회 인증 런)이 있습니다. 결과가 인상적입니다.
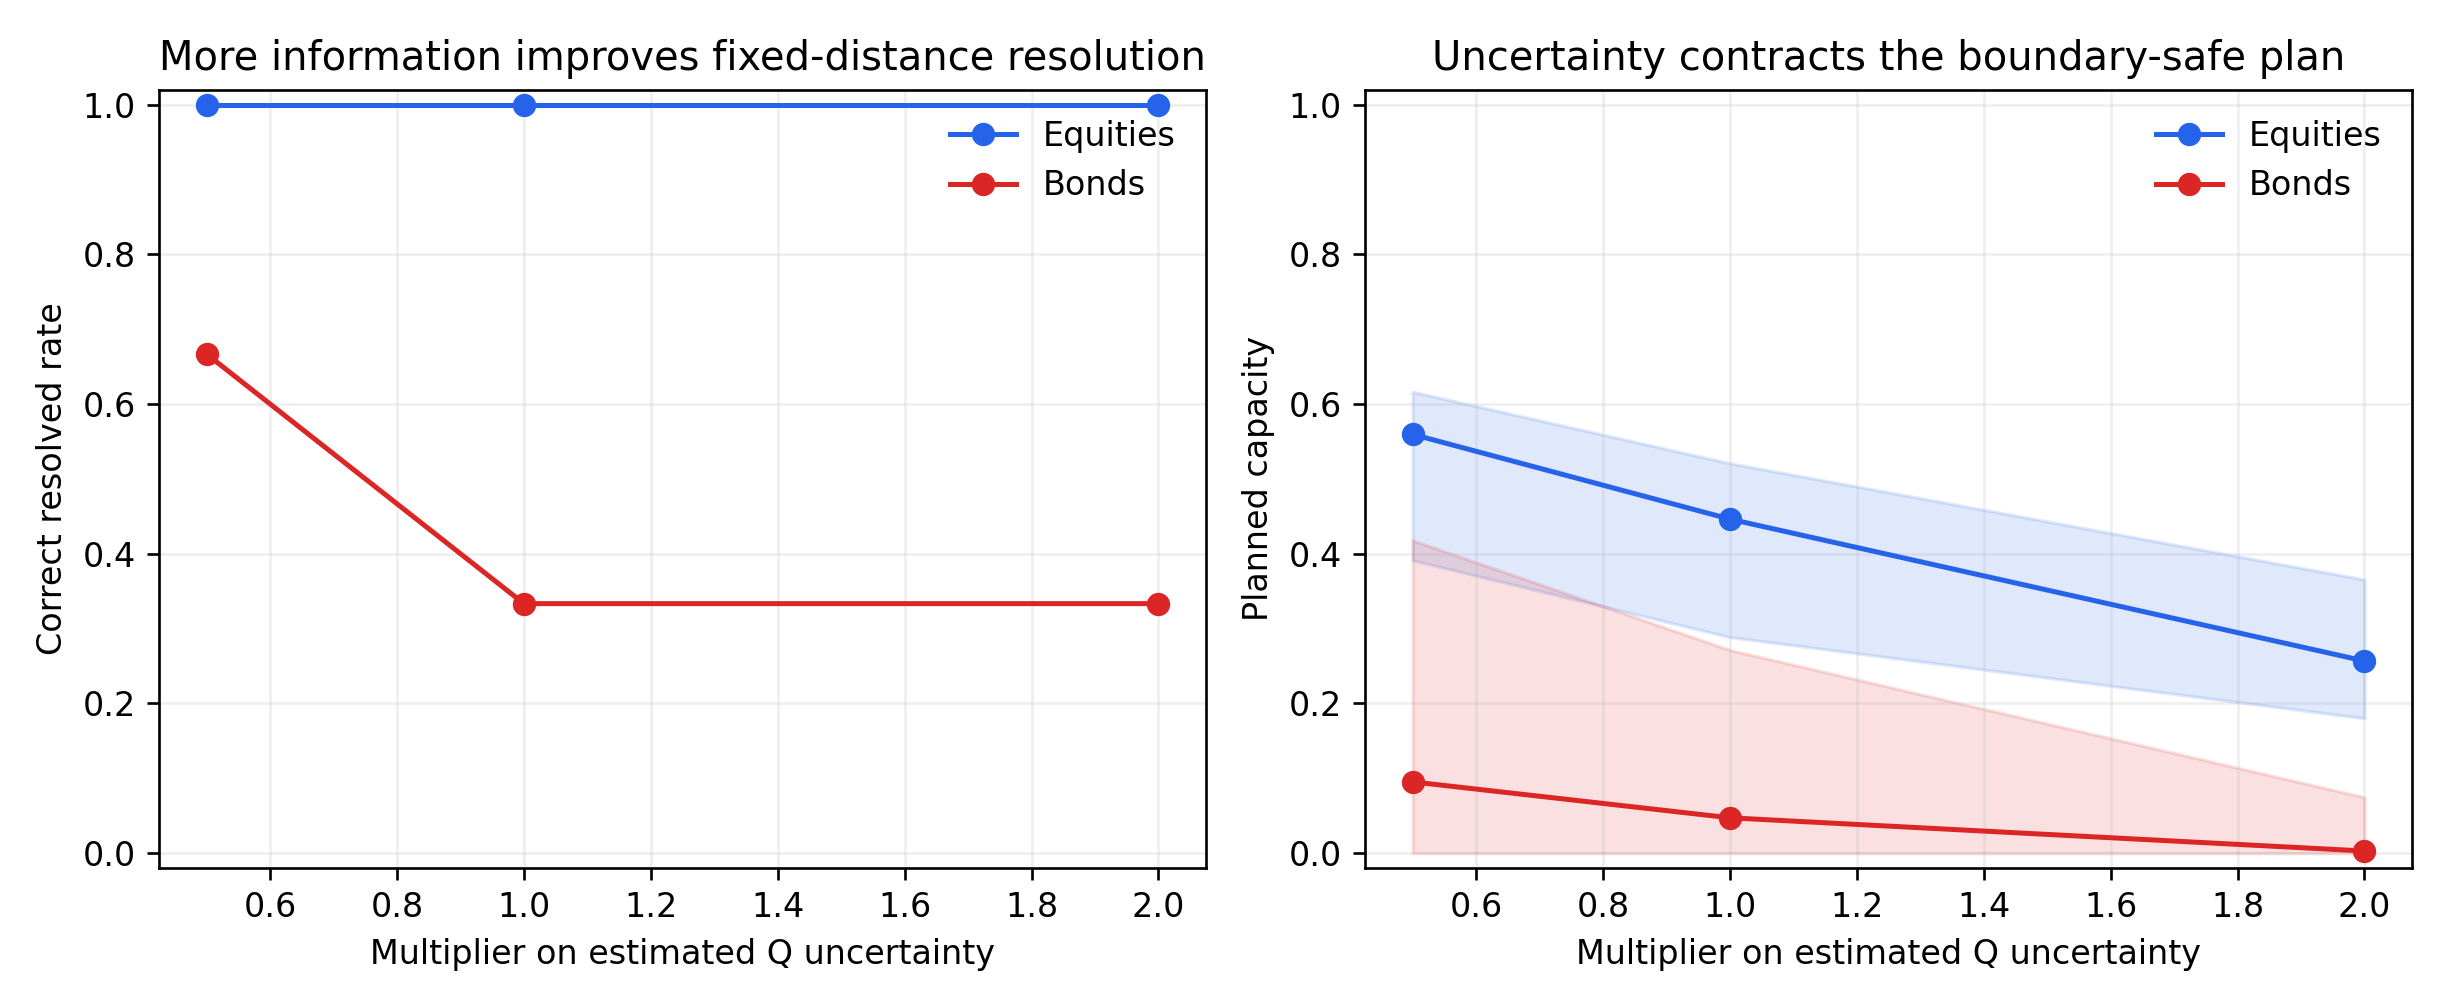
- 불확실성이 0.5배에서 2배로 커지면, 채권 케이스의 올바른 판정률은 0.667에서 0.333으로 떨어집니다.
- 경계선 위에서 계획되는 투자 한도의 중앙값은 주식에서 0.559 → 0.257로, 채권에서는 0.095 → 0.003으로 줄어듭니다.
즉, 정보의 질이 나빠지면 정답을 더 확신하는 게 아니라, 투자를 줄이고 더 자주 "모른다"를 선택한다는 것입니다. 흐린 날에 속도를 줄이는 것과 정확히 같은 대응입니다.
반면 계산 능력을 늘리는 것에는 한계가 있음을 별도 실험으로 보여줍니다. 탐색 예산을 50박스에서 200박스로 올리면 계산 미완료 비율은 1.000에서 0.078로 확 줄지만, 실제 판정률은 0.267에서 변화가 없습니다(400박스, 1,200박스에서도 동일). 한 번 충분한 계산량을 넘긴 후의 유보는 통계적 한계이지, 컴퓨터를 더 세게 돌린다고 해결되지 않습니다. "모름"을 계산 예산으로 덮어쓰면 안 된다는 뜻입니다.
실제 운영에서는?
논문이 제시하는 결정 맵의 작동 예시: 마진 범위가 0을 관통해서 판정이 "유보(UNR)"가 되자, 희망 투자 한도 1.000을 조건부 계획 0.441로 줄이고 안전 마진 0.050을 유지합니다. 이 숫자는 절차를 보여주기 위한 예시일 뿐 실제 포트폴리오의 한도가 아니라는 점을 논문이 명시합니다.
한계와 주의점
이 논문은 솔직하게 읽어야 합니다. 특히 다음은 반드시 함께 봐야 합니다.
- 실증 연구가 아닙니다. 모든 결과는 사전에 고정된 구조적 시뮬레이션(60,000회 추론 + 126만 회 정책 평가)에서 나왔습니다. 실제 시장 데이터로 안정성 경계를 검증하지 않았고, "실전에서 이 한도가 유효하다"는 주장을 하지 않습니다.
- 식별 전제가 선행합니다. 교차충격을 추정하려면 "가격에 영향을 주지 않는 순수한 주문흐름 변동" 같은 도구변수가 필요하고, "위험부담능력"의 단위 환산(대차대조표에서 시장 승수로)을 설득력 있게 설명할 수 있어야 합니다. 이 중 하나라도 실패하면 스펙트럼 계산이 가능해도 한도 권고를 내리지 않는 것이 규칙입니다.
- 2차원에 특화된 구현입니다. 검증 계산은 자산 2개, 흐름 2개 크기로 구현되었습니다. 고차원은 통계 이론이 아니라 별도의 구현 과제로 남아 있습니다.
- 정직한 공개들: 32비트 난수 시드 충돌 2건을 그대로 공개했고(영향은 최대 0.002%p), "원시 추정값 전체의 신뢰영역 커버리지"가 아니라 "투영된 마진의 커버리지"만 측정했다는 측정 한계도 명시했습니다.
- 후회의 조건부성: 앞서 말했듯, 위반을 감수하는 정책과의 비교에서는 상황에 따라 순위가 달라집니다. 논문이 "안전-성과 트레이드오프"라는 표현을 쓰는 이유입니다.
그래서 투자/실무엔?
비전공 독자분들을 위한 메시지로 정리하면 이렇습니다.
- "모른다"는 답변도 전략이다. 시장이 경계선 근처에 있을 때 확신에 차서 베팅을 키우는 대신 한도를 줄이는 선택은, 오랜 기간 볼 때 틀린 확정 선언의 비용(위반률 58.333%의 "무조건 원하는 만큼" 전략)을 피하는 길입니다.
- 불확실하면 더 적게. 리스크 추정이 흐려질수록 투자 한도를 줄이는 것이 이 프레임워크의 자동 대응입니다. 흐린 날의 운전자와 같습니다.
- 여러 값을 따로 보지 말고 함께 보라. 리스크, 시장충격, 감당 능력을 각각 다른 팀이 따로 추정하면 불확실성이 과소평가됩니다. 함께 추정해야 불확실성이 정직해집니다.
- 계산 능력이 정보를 대신하지 못한다. 더 큰 컴퓨터는 "모름"을 해결하지 못합니다. 필요한 건 더 나은 데이터와 식별 가능성입니다.
자기자본 운용 관점에서는, 주문집행 모델의 시장충격 파라미터와 포트폴리오 리스크 한도를 한 프레임워크에서 정직하게 묶어서 다루는 설계로 읽을 수 있습니다. 물론 이 논문의 숫자들은 시뮬레이션의 것이므로, 실전 적용에는 도구변수 식별과 용량 정규화를 우리 데이터로 방어하는 작업이 먼저입니다.
더 알아보기
- 원문: Uniform Inference and Certified Capacity at a Reflexive Stability Boundary (arXiv:2609.02535) — Alejandro Rodriguez Dominguez, 2026년 9월 2일 제출 (q-fin.PM).
- 5차원 점수 (참고): 새로움 78 / 적용성 66 / 엄밀성 72 / 재현성 25 / 통찰 76. 재현성 점수가 낮은 이유는 코드·데이터 공개 여부가 확인되지 않았기 때문입니다(다만 시뮬레이션 설계·파라미터·인증 알고리즘이 부록에 상세히 기술되어 있어 재현은 가능할 것으로 보입니다).
- 관련 논문 (KB 기준):
- Nonparametric Estimation of Self- and Cross-Impact (arXiv:2510.06879) — 교차충격을 데이터에서 어떻게 추정하는지에 대한 직접적인 이웃 주제.
- How to build a cross-impact model from first principles (arXiv:2004.01624) — 교차충격 모델이 만족해야 할 이론적 조건들.
- Statistical Learning of Value-at-Risk and Expected Shortfall (arXiv:2209.06476) — 조건부 리스크 추정 쪽의 고전적 접근.
이 논문의 가장 큰 선물은 새로운 수식이 아니라, "확신이 없을 때 확신 있는 척하지 않는 구조"를 수학과 코드로 만든 점입니다. 투자에서 가장 비싼 오류는 대개 "잘 모르는 상황을 아는 척한 순간"에 생기니까요.
관련 글
 강화학습 포트폴리오A
강화학습 포트폴리오는 왜 돈을 잃을까? — 마이opic 최적화의 역습
강화학습(RL) 기반 포트폴리오 전략이 실전에서 손실로 이어지는 이유를 이론적으로 분석한 논문을 소개합니다. 실행 비용과 청산 마찰을 무시한 RL이 마이opic 최적화에 왜 뒤처지는지, 그리고 투자자에게 어떤 시사점을 주는지 설명합니다.
 시계열 계량경제학A
전력 가격 예측 벤치마크 TRACE: 운영 공지 텍스트로 상방 위험을 줄인다
미국 전력 시장의 공식 운영 공지문을 예측 시점 기준으로 되살려 가격 데이터와 결합한 재현 가능 벤치마크 TRACE를 소개합니다. 텍스트가 전력 가격의 상방 위험 예측을 얼마나 개선하는지, 실험 설계와 한계를 일반인 눈높이로 설명합니다.
 포트폴리오 최적화A
포트폴리오 최적화, 어렵게 풀 필요 없이 LASSO 한 번으로 — 효율적 프런티어의 놀라운 등가성
머신러닝에서 흔히 쓰는 변수 선택 도구 LASSO가 마코위츠의 효율적 프런티어를 그대로 그려 준다는 연구를 쉽게 풀어 설명합니다. 포트폴리오 최적화 계산이 왜 수십 배 빨라지는지, 그리고 주의할 한계까지 정리합니다.