매달 arXiv에 쏟아지는 금융 연구 논문 중에서 가장 의미 있는 연구를 골라 정리합니다. 이번 글은 2017년 9월에 공개된 논문들을 지금의 눈으로 다시 읽은 회고 리뷰입니다.
한 줄 요약: "현실의 마찰을 모형 안으로 정직하게 들여보내라" — 거래비용을 최적화에 미리 넣으면 통계 정규화가 공짜로 따라오고, 위험 측정은 '최악의 날들이 며칠이면 비상금을 다 쓰는가'로 검증할 수 있으며, 한 기업의 부도는 경제 전체를 흔들어 되돌아옵니다.
들어가며: AI가 트레이딩을 점령하기 직전, "마찰"을 묻다
2017년 9월을 기억하시나요? 비트코인은 아직 만 달러를 넘지 못했고, "AI 트레이딩"이라는 말은 신문 기사에서나 볼 수 있었으며, arXiv의 금융 논문들은 여전히 연필과 종이로 증명하는 수학이 주류였습니다.
그런데 이 '구식' 논문들을 읽다 보면 2026년의 우리에게 그대로 던지는 질문들이 많습니다. 아무리 좋은 포트폴리오 이론이 있어도 거래비용이 이익을 다 먹어치우면 소용없고, 아무리 정교한 위험 측정을 해도 "그 측정을 믿을 수 있는가"를 검증하지 못하면 규제를 통과할 수 없으며, 한 회사의 부도가 금리와 담보 가치를 흔들면 다른 회사들의 부도 확률까지 바뀌니까요.
이번 달 코호트는 논문 84편(우리 기준 관련 논문 54편)이고, A등급 6편 중 4편이 포트폴리오 최적화·헤지링·리스크 계산에 모여 있습니다. 한마디로 "이론이 현실에서 깨지는 지점을 좁히는 작업"이 한창이던 달이었습니다. 다섯 개 테마로 정리했습니다.
테마 1: 거래비용이 곧 정규화다
이사를 자주 다녀 본 사람이라면 알 겁니다. 이사할 때마다 돈이 깨지니까, "살짝 더 좋은 집"이 보여도 안 옮기게 되죠. 그런데 의외의 결과가 생깁니다. 이사 비용이 아까워서 안 옮기다 보니, 애초에 이사 비용까지 감안해 신중하게 고른 집에서 오래 살게 되는 겁니다. 포트폴리오도 똑같습니다. 자주 리밸런싱하면 거래비용이 이익을 잠식하니, 좋은 투자자는 애초에 거래비용을 감안한 최적 포트폴리오를 짭니다.
2017년 9월의 최고 복합점수 논문(74.6점)은 이 직관을 수학으로 증명합니다.
대표 논문: Large-Scale Portfolio Allocation Under Transaction Costs and Model Uncertainty (1709.06296)
빈 대학의 Hautsch와 Voigt가 쓴 이 논문은 세 가지 난관 — 자산이 많아지면 추정치가 잡음투성이가 되는 문제, 모형이 시간에 따라 변하는 문제, 거래비용 문제 — 를 하나의 틀로 묶습니다.
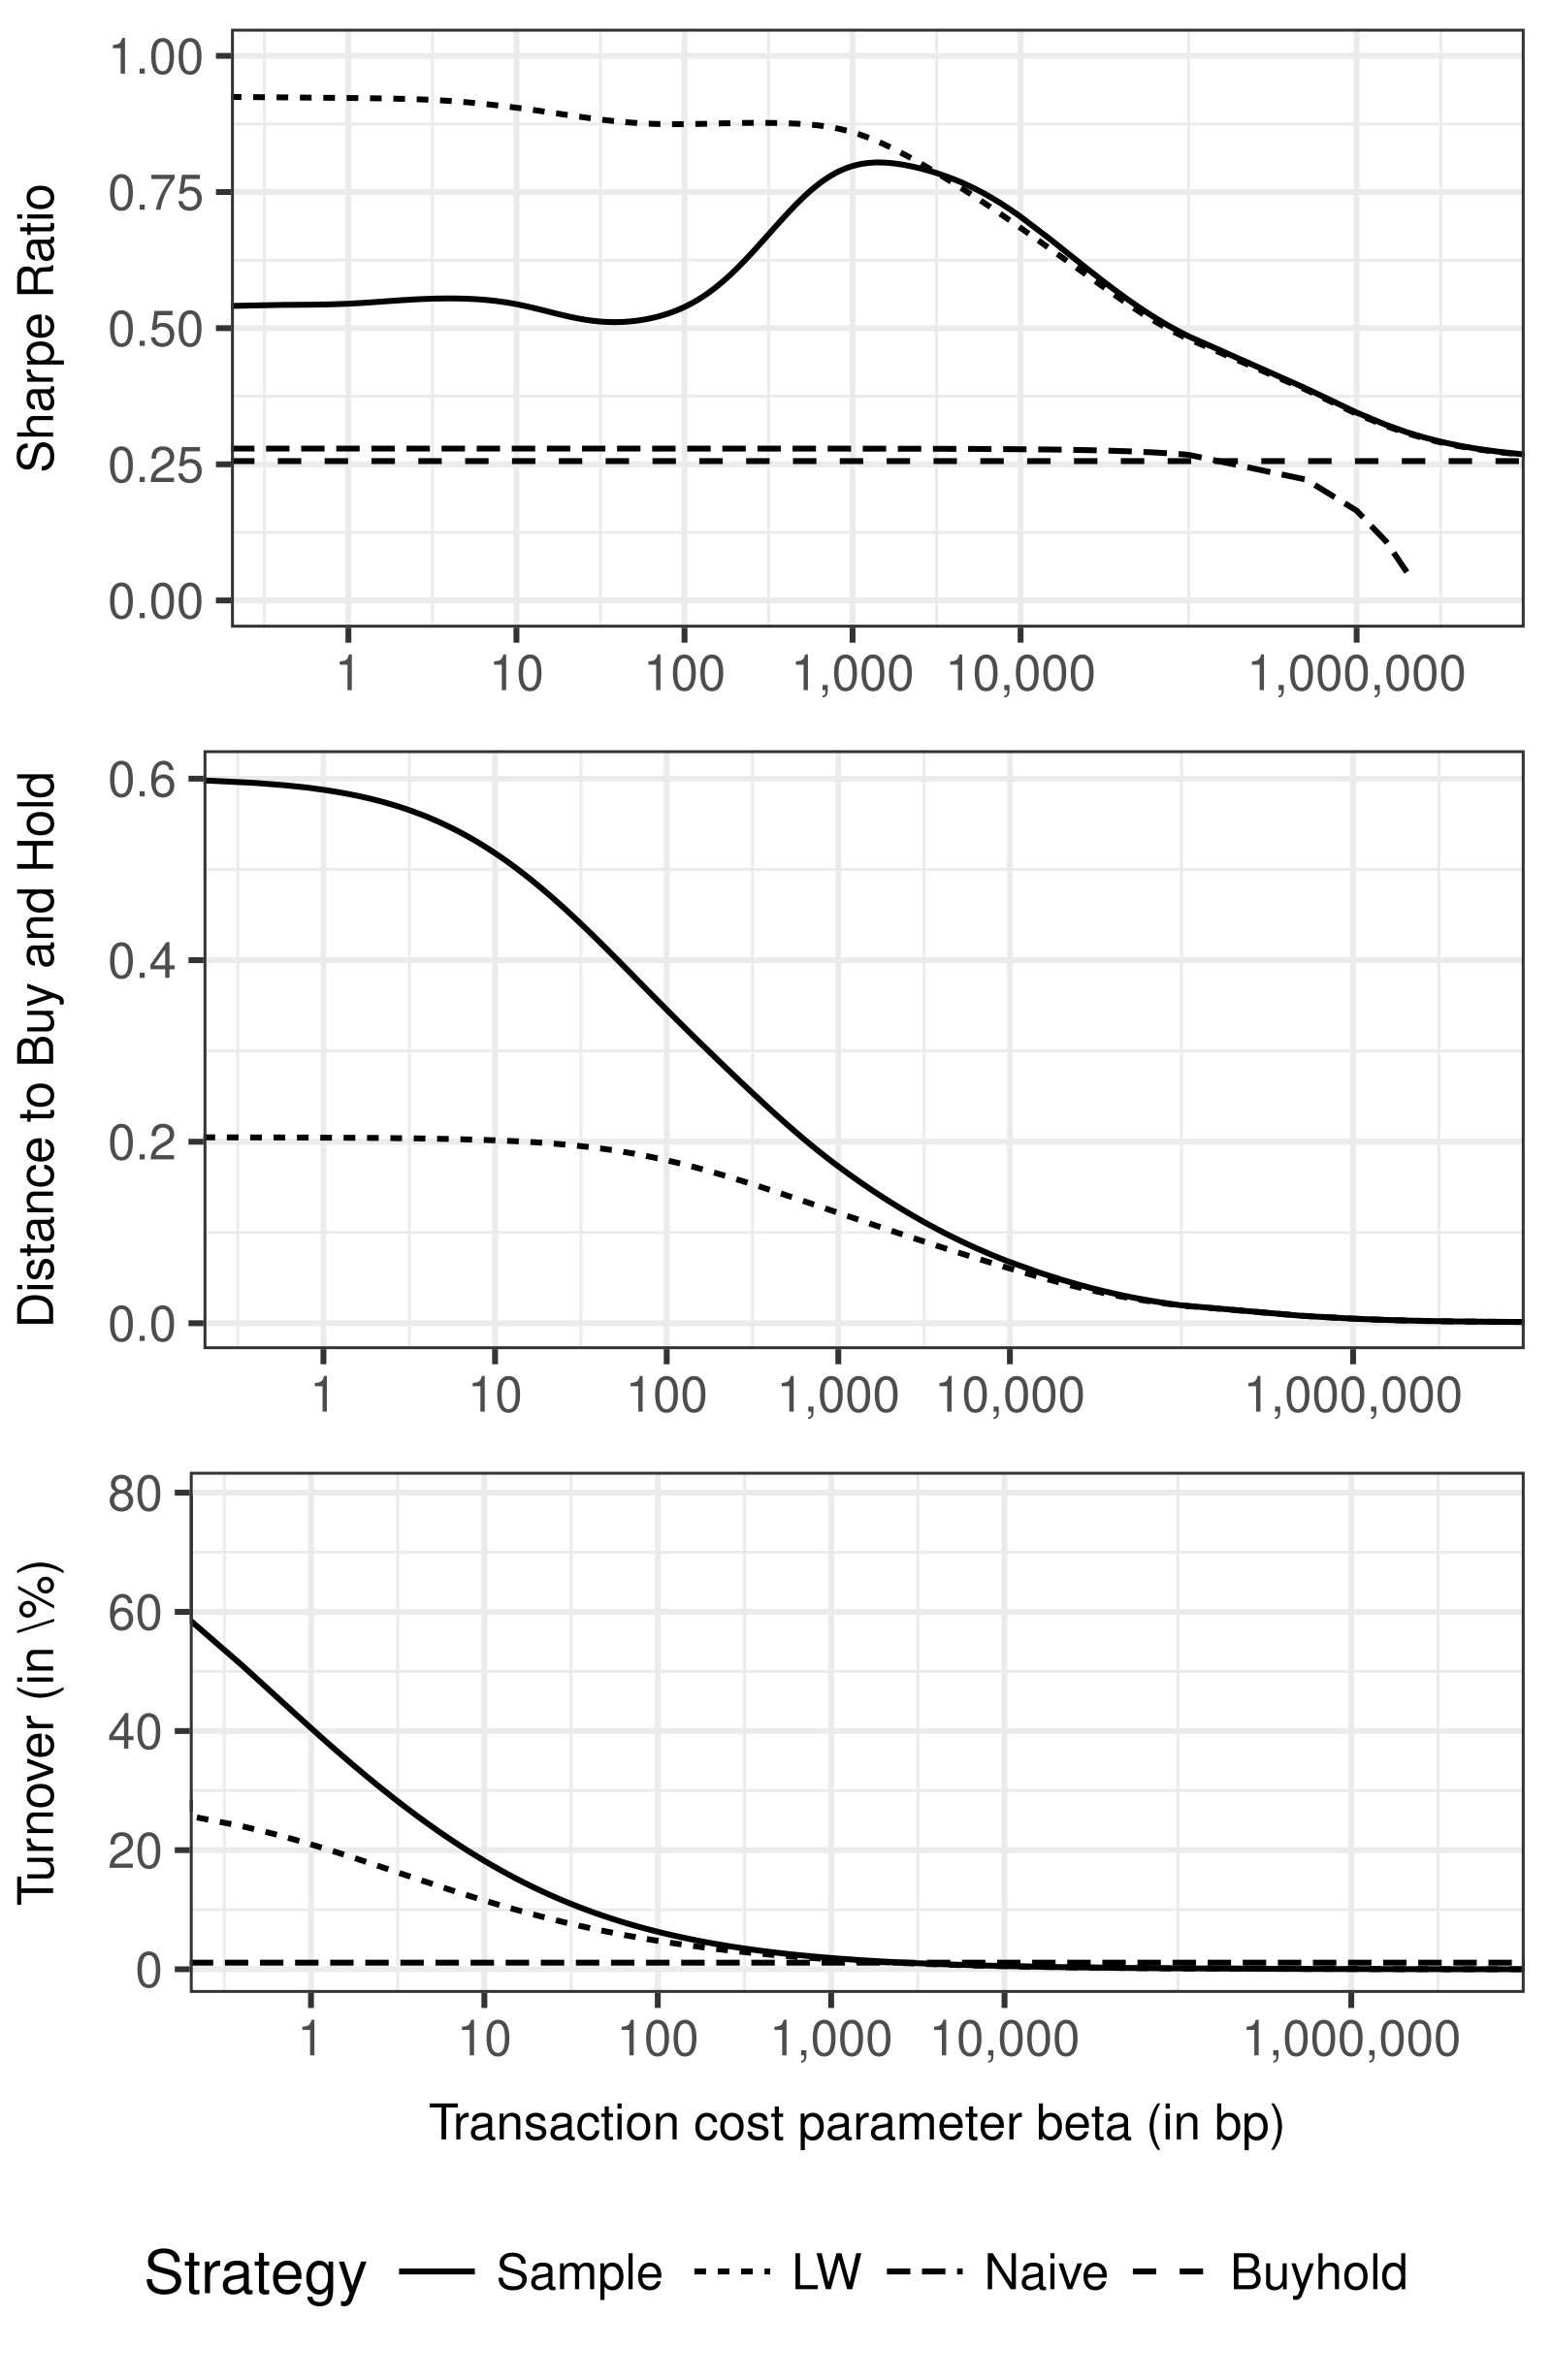
핵심 발견은 이렇습니다: 거래비용을 최적화에 사전 반영해 회전율을 억제하면, 그것이 공분산 행렬을 부드럽게 다듬는 '정규화'와 수학적으로 거의 같은 일이 된다. 거래비용이 비례 방식이면 Lasso형 페널티, 이차 방식이면 Ridge형 페널티가 나옵니다. 통계학에서 공분산 추정을 안정시키려고 임의로 골라 오던 정규화 강도를, 시장의 실제 거래비용이 대신 정해 준다는 뜻입니다.
실증 규모도 실합니다. Nasdaq 상장 308종목, 2007년 6월~2017년 3월, 700억 건 이상의 장중 거래 메시지를 사용했고, 250종목을 무작위로 뽑은 가상 투자자 200명(위험회피계수 4, 거래비용 50bp)으로 부트스트랩 평가했습니다.
- 거래비용을 사전에 반영하지 않으면 어떤 예측 모델도 양(+)의 샤프비율을 내지 못했습니다. 고빈도 데이터를 써도 마찬가지였습니다.
- 사전에 반영하면 성과가 크게 개선됐고, 오히려 예측 모델들 간의 격차가 줄었습니다.
- 그런데 고빈도와 저빈도 예측을 혼합하면 유의하게 더 좋은 결과가 나왔습니다. 각 모델의 예측 능력이 시간에 따라 변하기 때문입니다.
- 단순 균등배분, 최소분산 같은 벤치마크를 통계적·경제적으로 유의하게 상회했습니다.
한계도 분명합니다. 거래비용 50bp는 미국 시장의 보수적 근사치이고, Nasdaq 중심 유니버스라 다른 시장으로의 일반화에는 검증이 더 필요합니다. 그래도 "회전율 페널티가 통상의 shrinkage보다 효과적"이라는 결론은 리밸런싱 규칙 설계에 직접 와닿습니다.
공통 인사이트: 정규화 강도를 임의로 튜닝하지 말고, 시장의 거래비용이 정하게 두어라. 이론적 최적을 좇아 자주 갈아타는 것보다, 마찰을 감안한 포트폴리오가 실제로는 더 오래 살아남는다.
같은 테마에서, 공매도 금지 조건의 분산 최적화를 물리학의 replica 방법으로 해석적으로 풀어 "자산이 몇 개나 빠지는가"의 한계를 찾은 연구(1709.08755), 포트폴리오의 위험과 투자 집중도가 어떻게 맞물리는지 랜덤행렬 이론으로 분석한 연구(1709.04620), 거래비용과 분산 제약을 함께 고려한 다단계 최적거래 프레임워크(1709.07527)도 같은 문제의식을 공유합니다.
테마 2: 옵션 몇 개로 분산스왑을 헤지한다
비 오는 날을 완벽하게 대비하려면 하늘의 모든 구름을 추적해야 합니다. 하지만 실전에서 필요한 건 우산 몇 자루죠. 변동성 헤지도 비슷합니다. 이론상 '완벽한' 헤지는 행사가가 무한히 촘촘한 옵션 무한 개를 요구하지만, 시장에는 행사가가 몇 개씩 찍힌 옵션만 거래됩니다. 그러면 "옵션을 몇 개만 써서 어디까지 헤지할 수 있는가"가 실전의 질문이 됩니다.
대표 논문: Semi-Static and Sparse Variance-Optimal Hedging (1709.05519)
TU Berlin의 Di Tella, Haubold, Keller-Ressel 세 명이 쓴 이 논문(71.6점)은 분산스왑 헤지의 고전적 딜레마를 정면으로 다룹니다. 분산스왑을 헤지하는 유명한 공식(Neuberger, 1994)은 행사가 0부터 무한대까지의 풋·콜 옵션에 미소한 포지션을 넣어야 하는데, 실제로는 옵션이 21개밖에 없어요. (VIX 지수조차 이 공식을 몇 개로 잘라 쓰는 방식입니다.)
저자들의 접근은 세 단계입니다.
- 준정적 헤지 전략 — 주식은 실시간으로 관리하고, 옵션은 사서 들고 있는 조합 — 의 최적화 문제를 "주식 헤지(내부 문제)"와 "옵션 비중 고르기(외부 문제)"로 깔끔하게 쪼갭니다.
- 옵션을 소수만 쓰는 희소 선택 문제로 바꿔, 탐욕적 선택·정확 해(LASSO 포함) 세 방법을 비교합니다.
- Heston 변동성 모형에서 푸리에 적분으로 헤지 오차를 실제로 계산합니다.
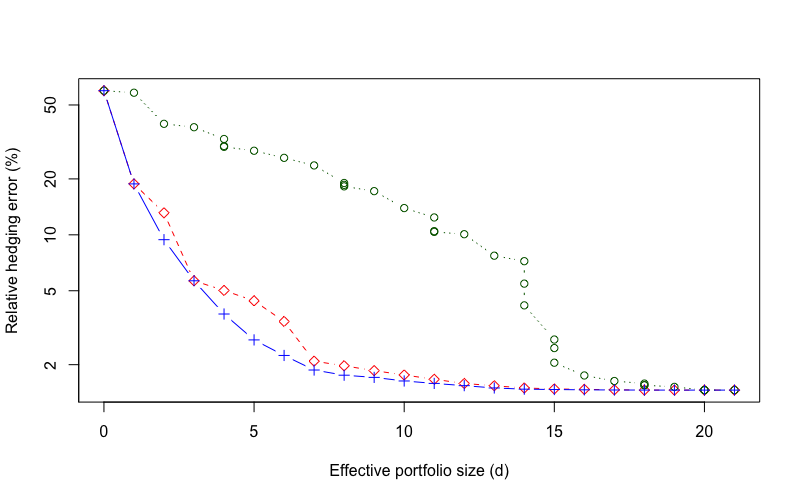
결과가 실무적입니다. 주가 100, 만기 1년, 행사가 50~150의 옵션 21개를 쓰는 실험에서:
- 유효 옵션 수가 늘수록 헤지 오차가 빠르게 줄었고, 옵션 3개만으로도 이론적 이상 포트폴리오의 구조(행사가가 커질수록 비중이 1/K²로 감소)와 합리적으로 일치했습니다.
- 포트폴리오는 현재가 부근(ATM) 옵션에서 시작해 옵션 수가 늘면 바깥쪽 행사가로 확장되며, 하락을 막는 OTM 풋에 더 큰 비중을 줍니다.
- 가끔 나오는 숏 포지션은 계산 찌꺼기일 가능성이 높아, 애초에 공매도 제약을 거는 편이 안전하다고 권고합니다.
- 놀라운 점: 주식과 변동성의 상관(ρ)은 이론적 가격에 영향을 주지 않으면서도, 희소 헤지의 실제 성과에는 결정적이었습니다. 상관이 클수록 시장이 불완전해져서, 소수 옵션 헤지의 오차가 반원 법칙(√(1−ρ²)) 형태로 커집니다.
한계: 실제 시장 캘리브레이션이 아니라 '스타일라이즈드' 실험이고, 푸리에 공식은 Heston 모형에 한정됩니다(같은 테마의 1709.05527이 더 일반적인 확률변동성 모형으로 확장합니다).
공통 인사이트: 헤지의 질은 옵션의 개수가 아니라 '어떤 옵션을 어떤 비중으로 고르는가'에 달려 있다. 무한한 완벽함을 좇기보다, 유한한 자원의 최적 배치가 실전의 답이다.
같은 테마에서, Dupire 공식처럼 만기별 가격 곡선 전체를 요구하지 않고 두 만기의 옵션 분포만으로 마팅게일 제약을 지키며 국소변동성을 복원하는 최적수송 접근(1709.08075)도 "모델을 덜 믿는" 방향의 연구입니다.
테마 3: "내 위험 측정을 믿을 수 있는가"를 검증하는 법
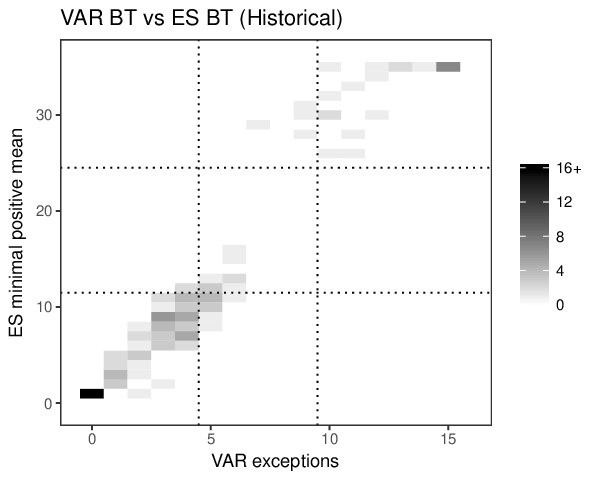
은행이 "우리는 하루에 최대 10억 원만 잃습니다"라고 말하면, 규제기관은 "정말인가?"를 확인해야 합니다. 그런데 확인 방법이 애매했습니다. 2017년은 바젤 시장위험 개편이 VaR(분위수)를 Expected Shortfall, ES(꼬리 평균)로 바꾸면서 "그럼 ES는 어떻게 검증하나"라는 근본 논쟁이 한창이던 해였습니다. ES는 수학적 성질이 달라서, 기존처럼 '초과 횟수'를 세는 방식이 맞지 않았거든요.
대표 논문: Backtesting Expected Shortfall: a simple recipe? (1709.01337)
HSBC의 Moldenhauer와 야기엘론 대학의 Pitera가 쓴 이 논문(70.1점)의 레시피는 놀랍도록 단순합니다.
- 확보 포지션을 만듭니다: 하루의 실제 손익과 그날 쌓아 둔 비상금(자본 충당금, ES 추정치)을 하나로 합칩니다. 통장 잔고와 금고의 비상금을 한 통장으로 보는 셈이죠.
- 이 포지션의 최악의 날들을 순서대로 더했을 때, 합이 마이너스가 되는 최대 며칠을 셉니다. "최악의 연속이 비상금을 다 까먹는 데 며칠 걸리는가"입니다. 그 값을 전체 일수로 나누면 검정 통계량 Gn이 됩니다.
고작 이 숫자 하나로, 규제의 트래픽라이트(초록/황색/적색)를 ES에 맞게 구성할 수 있습니다 (250 영업일 기준):
| 구역 | VaR는 초과 횟수로 | ES는 '합이 음수인 최악 시나리오 수'로 |
|---|---|---|
| 초록 | 0~4 | 0~11 |
| 황색 | 5~9 | 12~24 |
| 적색 | 10+ | 25+ |
올바른 모델이라면 최악 67개 부근에서 음수가 시작되고, 초록 구역에 들어올 확률이 약 90%입니다. Fama-French 25개 포트폴리오(20052015년, 2,500일)와 여러 시뮬레이션 데이터로 VaR 백테스트와의 정합성을 검증했습니다.
이 방법의 미덕은 (1) 모델 독립적이고, (2) 복잡한 결합 추정이나 벤치마크 모델이 필요 없고, (3) R로 한 줄이면 구현된다는 점입니다: mean(cumsum(sort(y))<0). 저자들은 "단순해서 조작이 쉽게 드러난다"고 강조합니다.
주의점도 있습니다. 변동성 폭발기가 있으면 확보 포지션을 변동성으로 나누는 정규화가 권장되고, VaR와 공유하는 구조적 한계도 일부 남습니다. 그래도 "ES 백테스트는 불가능하다"는 회의론에 대한 실무적 답변으로는 인상적입니다.
공통 인사이트: 위험 측정의 신뢰도는 측정값 자체가 아니라, 그 측정을 검증하는 절차에서 나온다. 검증이 단순할수록 조작은 어렵다.
같은 테마에서, 주변분포가 불확실할 때 리스크 지표가 놓일 수 있는 범위를 최적수송으로 구해 모델 없는 리스크 관리의 토대를 다진 연구(1709.00641), 유럽 주식시장 간 극단 손실의 동조화가 시간에 따라 변한다는 사실을 추정한 연구(1709.01198)도 "모델이 틀릴 방식 자체"를 정직하게 다룹니다.
테마 4: 디폴트가 경제로 넘쳐흐를 때
도미노를 생각해 보세요. 한 개가 넘어지면 바로 옆 도미노를 쓰러뜨리고(직접 전염), 그 도미노들이 또 다음을 쓰러뜨립니다. 그런데 실제 금융위기는 도미노만으로 설명이 안 됩니다. 큰 기업이 무너지면 바닥 자체가 흔들리기 때문입니다. 금리가 움직이고, 담보 가치가 떨어지고, 원자재 가격이 출렁입니다 — 그 흔들림이 다시 남은 기업들의 부도 확률을 높입니다.
2017년 9월의 신용 리스크 논문들은 이 '바닥의 흔들림'을 모델 안으로 들어오게 합니다.
대표 논문: A default system with overspilling contagion (1709.09255)
취리히 대학의 Coculescu와 취리히 연방공대의 Visentin이 쓴 이 논문(65.2점)은 디폴트 군집화의 원인을 세 갈래로 정리합니다.
- 순환적 상관: 금리·경기 같은 공통 요인이 여러 채무자를 함께 움직이게 하는 것 (기존 모형이 이미 다룸)
- 직접 전염: 한 채무자의 부도가 거래상대방의 부도 확률을 직접 높이는 것 (기존 모형이 이미 다룸)
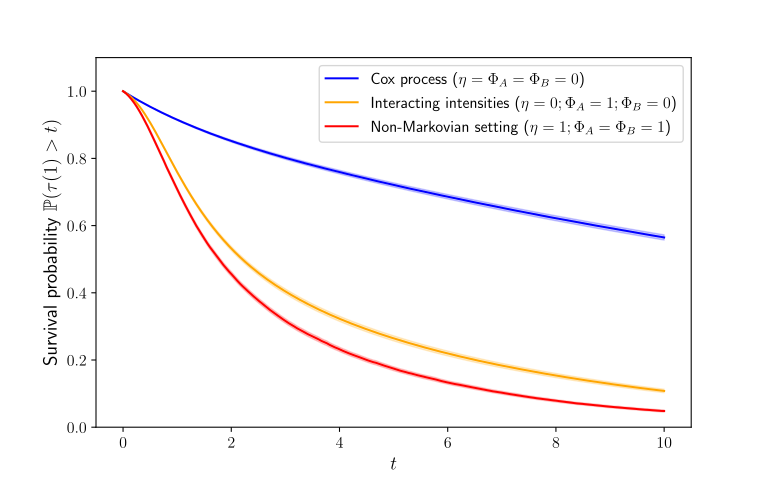
- 넘침(overspilling) 전염 — 이 논문의 제안: 디폴트 사건이 환경으로 흘러넘쳐 환경을 바꾸고, 바뀐 환경이 다시 시스템에 되먹임되는 것
기존 모형들은 "환경이 주어지면 디폴트가 마르코프 과정"이라는 가정을 썼는데, 이건 환경이 부도 이력에 영향받지 않는다는 뜻이라 세 번째 경로를 담을 수 없었습니다. 저자들은 비마르코프 구조(과거 부도가 환경에 남긴 상처가 미래 부도 확률에 남는)와 여과 확장이라는 확률과정 수학으로 이를 구현합니다.
수치 결과가 강렬합니다. 단일 기업 CDS의 공정 스프레드를 몬테카를로(10,000회, 무위험 금리 2%, 부도 지급률 60%)로 계산하면:
| 설정 | 공정 스프레드 |
|---|---|
| 전염 없음 (Cox 과정) | 18.19 ± 0.20 bp |
| 직접 전염만 | 80.09 ± 0.82 ~ 85.77 ± 0.92 bp |
| 넘침 전염까지 (비마르코프) | 109.13 ± 0.93 ~ 131.73 ± 1.23 bp |
전염만 넣어도 스프레드가 4~5배, '바닥의 흔들림'까지 넣으면 최대 7배로 벌어집니다. 체계적으로 중요한 대형 기업의 부도가 다른 기업들의 신용 스프레드에 미치는 영향을 모델 안에서 가격으로 볼 수 있다는 점이 실무적입니다. (참고: 이 논문은 2017년에 나온 뒤 2023년까지 다듬어졌습니다.)
한계는 명확합니다. 실제 시장 데이터로 모수를 맞추는 작업과 대규모 계산 검증이 남아 있고, 비마르코프 구조상 수학이 무겁습니다.
공통 인사이트: 신용 위험은 개별 채무자의 확률이 아니라 관계의 문제다. 전염 경로 하나를 빠뜨리면 스프레드가 7배까지 달라진다 — 리스크 관리에서 '모델에 무엇을 넣지 않았는가'가 곧 가격이다.
같은 테마에서, 거래상대방 신용한도(CCL)라는 제도 장치가 실제 FX 거래 가격에 비용으로 남는 흔적을 실거래 자료로 분석한 연구(1709.08238), 모델을 못 믿는 극한에서 효용 무차별 가격이 가장 보수적인 초복제 가격으로 수렴함을 증명한 연구(1709.09465)도 "불확실성을 가격에 넣는" 작업입니다.
테마 5: 머신러닝이 푸는 100차원, Hawkes가 그리는 주문 흐름
자산이 10개면 포트폴리오 경우의 수가 이미 머리가 아픈데, 100개면 어떨까요? 자산마다 위험과 상관이 얽힌 '고차원' 문제는 계산량이 자산 수에 대해 지수적으로 폭발합니다. 2017년 9월의 연구자들은 이 벽에 새로운 도구 — 심층 신경망과 자기흥분 확률과정 — 를 들이댑니다.
대표 논문: Machine learning approximation algorithms for high-dimensional fully nonlinear PDEs (1709.05963)
금융 공학의 많은 문제가 편미분방정식(PDE)으로 귀결됩니다: 파생상품 가격, 신용 가치조정(CVA), 포트폴리오 최적화의 가치함수. 문제는 이 PDE들이 자산 수만큼 차원이 높고(자산 100개 = 100차원), 거래비용·디폴트 리스크·변동성 불확실성을 넣으면 완전 비선형이 된다는 점입니다. 기존 수치기법은 차원이 커지면 사실상 포기해야 했습니다.
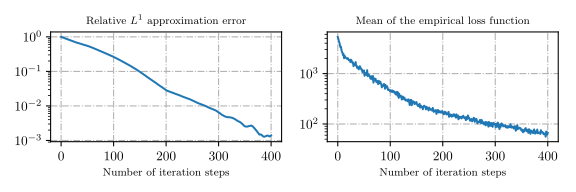
Beck, E, Jentzen 세 명이 제안한 deep 2BSDE 방법의 요지는 "고차원 함수를 신경망이 대신 기억하게 하자"입니다. 완전 비선형 PDE를 확률미분방정식(2BSDE)과 연결해 시간축으로 풀어 내려가면서, 각 시점의 고차원 함수값을 심층 신경망으로 근사하고 SGD로 학습시킵니다.
결과는 시원합니다 (Python + TensorFlow, 노트북급 CPU 기준):
- 100차원 Black-Scholes-Barenblatt 방정식(변동성 불확실성 모델)을 400회 반복만에 상대 오차 약 0.14%로 풀었습니다. 실현당 약 700초 걸렸습니다.
- 100차원 Hamilton-Jacobi-Bellman 방정식(포트폴리오 가치함수), 50차원 Allen-Cahn 방정식, 100차원 G-브라운 운동의 비선형 기대값에서도 작동했습니다.
- 소스 코드를 논문 부록에 공개해, 이 달 A등급 중 재현성 점수(75)가 가장 높습니다.
한계: 표준 벤치마크 방정식 기반의 실험이라 실제 시장 모델 보정은 별도 과제이고, 오차 상한의 완전한 이론화도 남아 있습니다. 그래도 "자산 100개짜리 비선형 가치함수 계산"이라는 문을 연 연구입니다.
공통 인사이트: 데이터가 많아지고 복잡해질수록 병목은 '아이디어'가 아니라 '계산 도구'다. 차원의 저주와 자기흥분 데이터라는 벽 앞에서, 머신러닝과 확률과정 이론이 실무의 새 언어가 되기 시작했다.
같은 테마에서, Hawkes 과정의 적합도 검정이 통계적으로 유의해도 인과성을 입증하지 못할 수 있음을 시간 역전 검정으로 보여 주며 '시간의 화살표 검증'을 요구한 연구(1709.08516), 자기흥분 주문 흐름이 만드는 호가장의 가격·거래량 동역학을 하나의 극한으로 연결한 연구(1709.01292), 호가장 정보로 미시구조 잡음을 설명할 수 있는지 검정한 연구(1709.02502), 청산 시점을 모른 채 최적 실행 속도를 짜는 문제(1709.05837)가 이 계열을 이룹니다.
월 전체 Big Picture: "현실의 마찰"을 모형 안으로
2017년 9월 코호트를 관통하는 메시지는 하나입니다: 현실의 마찰을 모형 안으로 정직하게 들여보내는 작업. 거래비용을 최적화에 미리 넣어 정규화를 대신 얻고(테마 1), 무한한 옵션 대신 유한한 옵션의 최적 선택으로 헤지를 실현 가능하게 하고(테마 2), 위험 측정 자체를 검증하는 절차를 간단하게 만들고(테마 3), 디폴트가 환경으로 넘쳐흐르는 되먹임을 가격으로 모델링하며(테마 4), 차원의 저주와 자기흥분 데이터라는 계산의 벽에 새 도구를 들이대는(테마 5) — 다섯 갈래 모두 "이론이 현실에서 깨지는 지점"을 좁히는 접근입니다.
흥미로운 점은, 이 '구식' 연구들이 다루는 문제가 바로 요즘 AI 트레이딩이 결국 마주치는 문제들과 정확히 겹친다는 사실입니다. 딥러닝으로 아무리 정교한 예측을 만들어도 거래비용 앞에서 회전율이 크면 무너지고, 리스크 모델을 아무리 잘 만들어도 검증 절차가 없으면 규제를 통과할 못하며, 한 기업의 부도가 시스템 전체를 흔드는 되먹임을 빠뜨리면 가격이 틀립니다. A등급 6편 중 4편이 포트폴리오·헤지·리스크 계산에 모여 있다는 점이 이 달의 성격을 상징적으로 보여 줍니다.
한계와 주의점
- 시대의 한계: 이 코호트에는 강화학습·LLM 기반 트레이딩 연구가 사실상 없습니다(딥러닝·강화학습 분과 합계 3편). 예측 기법은 통계 모형 중심이지만, 그 뒤의 어떤 AI 연구도 여기 다룬 문제들(거래비용, 불확실성, 위험의 검증, 전염, 계산)을 피할 수 없었습니다.
- 실험의 조건: 대표 논문들의 실증은 각각 조건부입니다. 거래비용 연구는 Nasdaq·50bp 가정, 헤지 연구는 스타일라이즈드 Heston 시장, ES 백테스트는 Fama-French 포트폴리오 기반입니다. "항상 그렇다"보다 "이 조건에서 그렇다"로 읽어야 합니다.
- 재현성 점수: 이 달 A등급 논문들의 재현성 점수는 38~75로 분포가 넓습니다. 머신러닝 PDE 논문(75)만 코드를 공개했고, 나머지는 수학이 훌륭하다는 뜻이지 코드가 있다는 뜻은 아닙니다.
- 수치의 맥락: CDS 스프레드 18bp vs 131bp는 '전염을 넣느냐'에 따른 이론적 예시값이며, 실제 시장 스프레드와의 정합은 별도 보정이 필요합니다. 헤지 오차 비율도 Heston 파라미터 구성에 좌우됩니다.
- 논문의 개정: 신용 전염 논문(1709.09255)은 2017년 v1 이후 2023년까지 개정됐습니다. 원문 링크는 최신 버전을 보여 줍니다.
그래서 투자/실무엔?
- 리밸런싱 규칙에 거래비용을 '미리' 넣으세요. 사후평가가 아니라 최적화 자체에 넣어야 하며, 정규화 강도는 통계 튜닝이 아니라 시장의 거래비용에서 나오게 두는 편이 유리합니다.
- 헤지는 '몇 개로 어디까지'를 따져 보세요. 옵션 3~6개의 소수 포트폴리오로도 헤지 오차의 대부분을 줄일 수 있고, ATM에서 시작해 바깥쪽 행사가로 넓히며 풋에 더 무게를 주는 구성이 실용적입니다.
- 위험 측정은 검증 절차와 세트로. "최악의 날들이 비상금을 며칠 만에 다 쓰는가"라는 단순한 통계량이 ES 백테스트의 실무 해법입니다. 구현이 한 줄이라 리스크 파이프라인에 바로 붙일 수 있습니다.
- 신용 리스크에는 전염 경로를 빠짐없이. 직접 전염만 모델링하면 스프레드를 수 배 과소평가할 수 있습니다. '대형 부도가 금리·담보 가치를 흔드는' 되먹임을 스트레스 시나리오에 넣으세요.
- 계산이 병목이면 도구를 바꾸세요. 자산이 많은 포트폴리오의 비선형 가치함수·CVA 계산에서 차원의 저주에 부딪혔다면, 2BSDE+신경망 계열이 실마리를 줍니다.
더 알아보기
이 글에서 다룬 A등급 논문 6편의 arXiv 링크와 5차원 평가 점수입니다(참신성 / 실용성 / 엄밀성 / 재현성 / 통찰, 복합점수 기준 내림차순).
| 논문 | 복합점수 | 5차원 점수 |
|---|---|---|
| Large-Scale Portfolio Allocation Under Transaction Costs and Model Uncertainty (1709.06296) | 74.6 | 76 / 82 / 78 / 48 / 80 |
| Semi-Static and Sparse Variance-Optimal Hedging (1709.05519) | 71.6 | 68 / 77 / 79 / 52 / 73 |
| Backtesting Expected Shortfall: a simple recipe? (1709.01337) | 70.1 | 68 / 82 / 73 / 45 / 72 |
| Machine learning approximation algorithms for high-dimensional fully nonlinear PDEs and 2BSDEs (1709.05963) | 68.0 | 78 / 57 / 69 / 75 / 68 |
| A default system with overspilling contagion (1709.09255) | 65.2 | 76 / 57 / 75 / 43 / 72 |
| Analytic approach to variance optimization under an ℓ1 constraint (1709.08755) | 65.0 | 72 / 62 / 72 / 38 / 75 |
이 외에도 테마별 보석 같은 논문들(최적수송 국소변동성 보정, Hawkes 인과성 검정, 무작위 청산 시점의 최적 실행 등)은 각 테마 섹션의 링크에서 확인하세요.
📚 이 글에서 다룬 논문 (18편)
- ALarge-Scale Portfolio Allocation Under Transaction Costs and Model Uncertainty
Nikolaus Hautsch, Stefan Voigt
- ASemi-Static and Sparse Variance-Optimal Hedging
Paolo Di Tella, Martin Haubold, Martin Keller-Ressel
- ABacktesting Expected Shortfall: a simple recipe?
Felix Moldenhauer, Marcin Pitera
- AA default system with overspilling contagion
Delia Coculescu, Gabriele Visentin
- AAnalytic approach to variance optimization under an $\ell_1$ constraint
Imre Kondor, Gábor Papp, Fabio Caccioli
- BRandom matrix approach for primal-dual portfolio optimization problems
Daichi Tada, Hisashi Yamamoto, Takashi Shinzato
- BA posteriori multi-stage optimal trading under transaction costs and a diversification constraint
Mogens Graf Plessen, Alberto Bemporad
- BSemi-Static Variance-Optimal Hedging in Stochastic Volatility Models with Fourier Representation
Paolo Di Tella, Martin Haubold, Martin Keller-Ressel
- BLocal Volatility Calibration by Optimal Transport
Ivan Guo, Grégoire Loeper, Shiyi Wang
- BMarginal and dependence uncertainty: bounds, optimal transport, and sharpness
Daniel Bartl, Michael Kupper, Thibaut Lux 외 2명
- BTime-Varying Extreme Value Dependence with Application to Leading European Stock Markets
Daniela Castro Camilo, Miguel de Carvalho, Jennifer Wadsworth
- BCounterparty Credit Limits: The Impact of a Risk-Mitigation Measure on Everyday Trading
Martin D. Gould, Nikolaus Hautsch, Sam D. Howison 외 1명
- BConvergence of utility indifference prices to the superreplication price in a multiple-priors framework
Romain Blanchard, Laurence Carassus
- BTesting the causality of Hawkes processes with time reversal
Marcus Cordi, Damien Challet, Ioane Muni Toke
- BOptimal Liquidation Problems in a Randomly-Terminated Horizon
Qing-Qing Yang, Wai-Ki Ching, Jia-Wen Gu 외 1명
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2017-10 월간A
2017년 10월 금융 논문: 결정을 학습하는 AI, 모델 없는 옵션 가격, 희소 포트폴리오
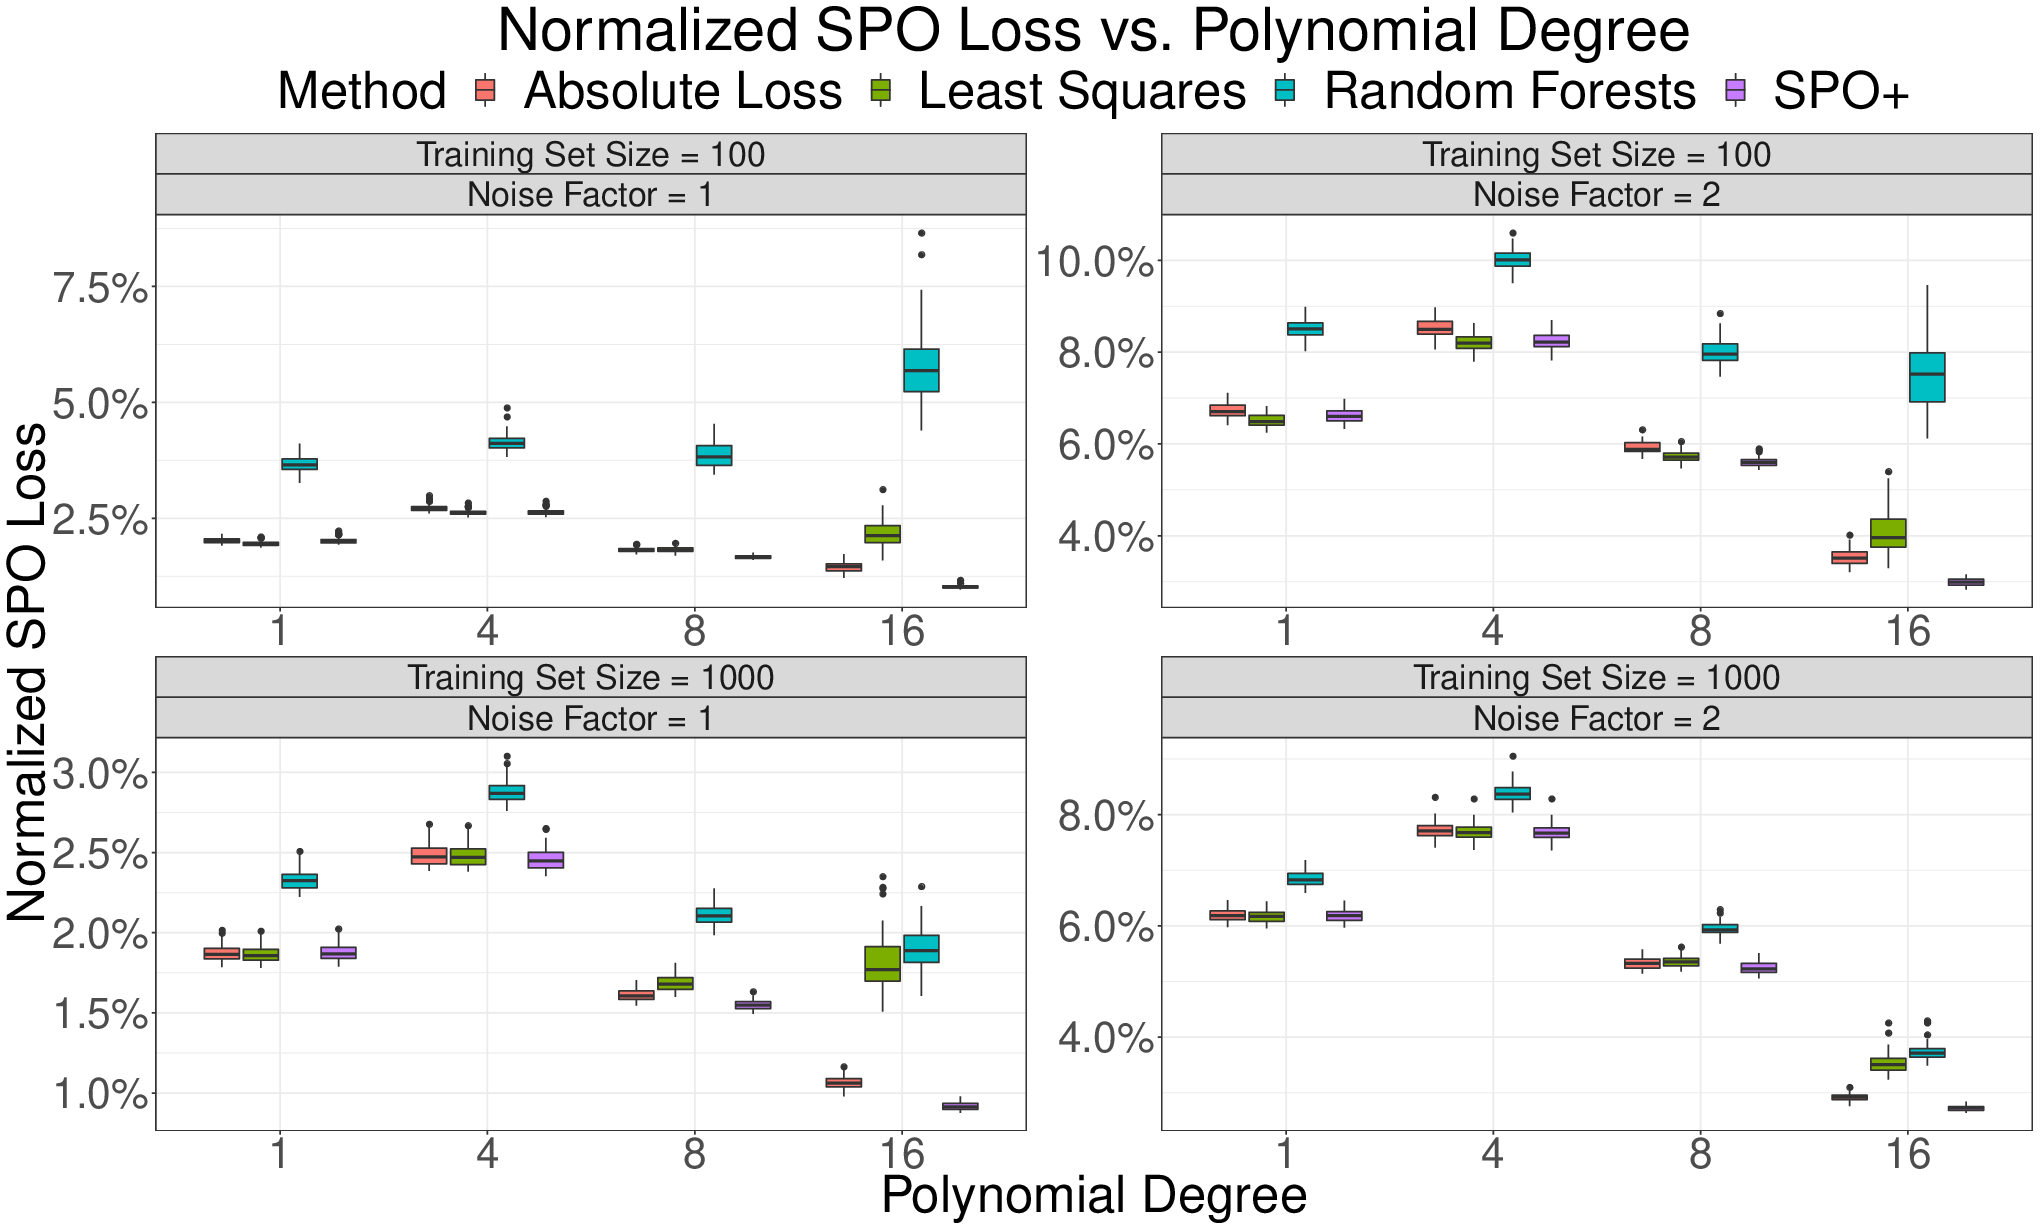
2017년 10월 arXiv 금융 연구 47편을 5개 테마로 정리했습니다. 예측이 아니라 결정을 학습하는 SPO, 모델 없이 가격 범위를 구하는 마팅게일 최적수송, 자산을 묶어 고르는 SLOPE 포트폴리오, 다크풀 체결의 확률, 옵션 계산을 지키는 단조성까지.
 📊 2026-09 월간
2026년 9월의 금융 AI 연구: 측정이 통념을 뒤집고, 검증이 창의성을 압도하다
2026년 9월 arXiv에 공개된 금융 AI 연구를 5개 테마로 정리했습니다. 1년치 CME 실측 데이터로 HFT 설계 원칙을 뒤집은 S티어 논문, 수천 개 LLM 에이전트의 프로덕션 현실, anytime-valid 심판으로 팩터 거짓발견을 5~11배 줄이는 방법, 매직 스트라이크로 분산 계약을 정밀 산정하는 수학, drawdown을 강건하게 제어하는 포트폴리오 이론까지 — 측정과 검증이 창의성을 압도하는 달이었습니다.
 📊 2026-08 월간
2026년 8월의 금융 AI 연구: 이론과 실전의 간극이 좁혀지는 달
2026년 8월 arXiv에 공개된 금융 AI 연구를 4개 테마로 정리했습니다. 포트폴리오 최적화의 실전화, LLM 에이전트 벤치마크 전쟁, 변동성 표면의 수학적 통일, 뉴스 NLP의 시간 누수 감사 — 이론이 실제로 작동하는 도구로 변하는 순간을 포착했습니다.