
매달 arXiv에 쏟아지는 수백 편의 금융 AI 논문 중에서 가장 의미 있는 연구를 골라 정리합니다. 9월은 좀 특별했습니다 — 수십 년간 불변이던 설계 원칙이 1년치 실측 데이터 앞에서 무너졌고, 수천 개의 AI 에이전트가 실제 돈을 굴리면서 보여준 현실은 냉정했으며, 팩터를 만드는 AI에게 "네가 만든 걸 네가 평가하지 마"라고 말하는 새로운 방법론이 등장했습니다.
들어가며: 9월에 무슨 일이 있었나
2026년 9월, arXiv에는 330편의 금융 AI 논문이 올라왔습니다. 그중 179편이 '관련' 기준을 통과했고, 1편이 최상위 S티어, 22편이 A티어를 받았습니다.
숫자만 보면 전월(457편, A 33편)보다 줄어든 것처럼 보이지만, 내용의 밀도는 오히려 높아졌습니다. 이 달의 연구를 관통하는 키워드를 하나만 꼽자면: "측정과 검증이 창의성을 압도한다".
수십 년간 "단일 스레드가 최고"라고 믿어온 고빈도 트레이딩(HFT) 세계에, CME 선물 시장의 1년치 데이터를 패킷 단위로 추적한 연구가 나타나 그 통념을 뒤집었습니다. 한편으로는 실제 돈으로 운용된 수천 개의 LLM 트레이딩 에이전트를 6개월간 관찰한 결과, "변동성을 무시하고 레버리지를 걸면 어떻게 되는지"라는 기본적인 질문에 대한 답이 나왔습니다. 팩터 연구에서는 AI가 만든 팩터를 AI가 아닌 통계 심판이 평가하는 시스템이 제안되었고, 옵션 수학에서는 소수의 '마법 가격점'만으로 복잡한 계약을 정밀하게 산정하는 새로운 프레임워크가 나왔습니다.
5개 테마로 정리했습니다.
테마 1: HFT의 오래된 규칙이 무너지다
왜 흥미로운가
고빈도 트레이딩(HFT)은 초당 수만 건의 주문을 처리해야 하는 극한의 기술 영역입니다. 이 분야에서 수십 년간 불변의 법칙처럼 지켜온 규칙이 하나 있었어요: "단일 스레드 이벤트 루프를 써라". 스레드를 하나만 쓰면 스레드 사이를 오가는 데 드는 시간(수백 나노초~수 마이크로초)을 아낄 수 있으니까요. 마치 공장에서 제품을 한 사람이 처음부터 끝까지 만드는 게, 여러 사람이 손을 거치는 것보다 빠를 거라는 믿음이었습니다.
9월에 나온 이 논문은 그 믿음을 1년치 실제 시장 데이터로 검증했고, 결과는 예상과 달랐습니다.
대표 논문: CME 데이터 1년치로 HFT 설계를 다시 쓰다
이 연구의 핵심은 단순합니다: "실제로 측정해 봤더니 규칙이 달랐다"는 겁니다.
연구진은 CME(시카고상업거래소)의 나스닥100 선물(NQ) 앞월물에 대해 1년 이상의 모든 패킷과 매칭 엔진 트랜잭션을 추적했습니다. 거래소가 시장 데이터를 발행하는 두 개의 타임스탬프를 따라가면서, 각 패킷이 언제 어디서 생성되어 언제 도착하는지를 정밀하게 기록했어요.
핵심 발견을 일상 비유로 풀어보겠습니다. 편의점에서 손님이 계산대에 오는 패턴을 상상해 보세요:
예상했던 패턴: 손님이 랜덤하게 온다 (포아송 과정). 한 명 오고, 잠시 쉬고, 또 한 명 오고...
실제 패턴: 손님이 무리 지어 온다 (자기흥분 과정). 한 명이 오면 뒤이어 두세 명이 연달아 오고, 그러다 한동안 뜸하고... 이 무리의 크기와 타이밍은 계산대의 처리 속도에 의해 결정된다.
CME의 매칭 엔진(주문을 체결하는 컴퓨터 시스템)도 비슷했습니다. 연속된 거래를 마이크로초 단위의 아주 짧은 간격으로 처리하지만, 시장 데이터를 밖으로 보내는 퍼블리셔는 최소 약 7.5마이크로초마다 한 번만 보낼 수 있어요. 그러니까 거래가 폭주해도 밖에서 보는 데이터는 한 템포씩 끊겨서 도착합니다.
이 측정이 HFT 설계에 던지는 메시지는 명확합니다:
-
서비스 시간이 7.5마이크로초 이내라면: 단일 스레드가 여전히 최적입니다. 아무리 거래가 몰려와도 큐잉 없이 처리할 수 있거든요.
-
서비스 시간이 7.5마이크로초를 넘기면: 이야기가 달라집니다. 큐잉 꼬리가 나타나는데, 이때 처리 체인을 두 단계로 나눠서 별도의 스레드에 배치하면 꼬리 지연의 대부분을 없앨 수 있습니다. 대신 평균 지연에 스레드 전환 하나가 추가되죠.
-
핵심은 "가장 느린 단계를 빠르게 만드는 것": 멀티스레드로 나누는 것 자체보다, 나눈 뒤의 가장 느린 처리 단계를 최적화하는 것이 중요합니다.
-
임계값 바로 아래에서는 다른 레버가 작동합니다: 메시지당 처리 비용과 서비스 시간의 편차를 줄이는 것이 스레드 수를 늘리는 것보다 효과적입니다.
이 논문은 123페이지, 36개의 그림, 31개의 표로 이루어진 방대한 분석이고, 분석적 프레임워크('버스트-한계 처리량 항등식'과 탠덤 큐잉 모델의 정확한 병목 서버 축약)까지 제공합니다. 코드도 Kaspar-HFT로 공개되어 있어요.
이 발견이 의미하는 것
이 연구가 특별한 이유는 실증적이라는 점입니다. "이론적으로 단일 스레드가 좋을 것 같다"가 아니라, "1년치 실제 데이터를 분석해보니 서비스 시간이 특정 임계값을 넘으면 멀티스레드가 확실히 낫더라"라는 결론이에요. HFT 시스템을 설계하는 엔지니어들에게는 측정 기반의 구체적인 기준점을 제공합니다.
테마 2: 수천 개의 AI 에이전트, 실제 돈으로 6개월간 굴렸더니
왜 흥미로운가
AI가 주식이나 암호화폐를 대신 사고팔아 준다는 이야기, 한 번쯤 들어보셨을 겁니다. "AI 트레이딩 봇이 수익을 낸다"는 식의 마케팅도 많죠. 그런데 궁금한 게 있습니다: 수천 개의 AI 에이전트가 실제 돈으로 장기간 거래하면, 실제로 어떤 일이 일어날까요?
9월에 나온 이 논문은 그 질문에 답합니다. 그것도 실험실이 아니라 실제 시장에서, 실제 사용자의 돈으로, 6개간 관찰한 결과를요.
대표 논문: LLM 트레이딩 에이전트의 프로덕션 보고서
두 개의 시스템에서 데이터를 모았습니다:
첫 번째 시스템 (DX Terminal Pro): 3,505개의 사용자 자금 금고(vault)가 실제 이더리움(ETH)으로 Base 블록체인의 밈코인 시장에서 21일간 거래했습니다. 2026년 2~3월의 일입니다.
두 번째 시스템 (DXAP Live Alpha Fleet): 500599개의 사용자 생성 에이전트가 Hyperliquid의 무기한 선물(perpetual futures)에서 거래했습니다. 2026년 68월, 항상 91~117개가 동시에 활성 상태였어요.
총 규모: 약 6개월, 750만 회의 AI 모델 호출, 약 30만 회의 온체인 거래, 14,596회 체결. 이 정도면 "population-scale"이라고 부를 만합니다.
무엇을 발견했나
결과를 솔직하게 정리하면, 네 가지입니다.
첫째, 전략보다 시스템 설정이 더 중요합니다. 에이전트가 어떤 전략 텍스트를 가지고 있느냐보다, 시스템의 리스크 슬라이더 같은 운용 계층이 에이전트의 행동을 더 크게 결정했습니다. 리스크 슬라이더가 한 단계 올라갈 때마다 레버리지가 평균 0.425배 증가했고, 에이전트 개개인의 고정 효과(fixed effect)가 전체 분산의 60%를 설명했어요. 쉽게 말해, "어떤 전략을 쓰느냐"보다 "시스템이 어떻게 설정되어 있느냐"가 결과를 더 많이 좌우했다는 뜻입니다.
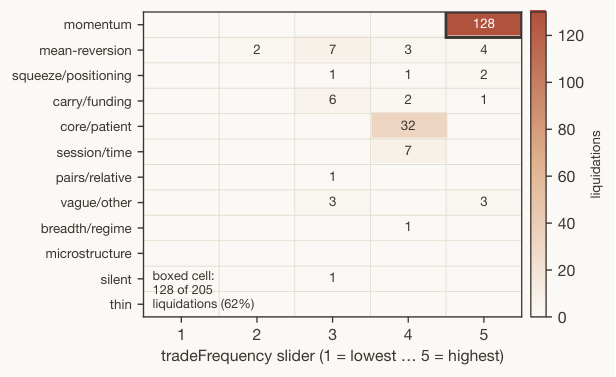
둘째, 변동성을 완전히 무시한 사이징. 이건 좀 충격적인 발견입니다. 시장 변동성이 높든 낮든, 에이전트의 중간 레버리지는 항상 5.0배였습니다. 변동성이 높을 때는 레버리지를 줄여야 하는데, 에이전트는 그걸 신경 쓰지 않았어요. 그리고 하나의 포스처(position) 설정 셀 — 전체 장부의 11%에 불 이야 — 이 전체 청산의 62%를 차지했습니다.
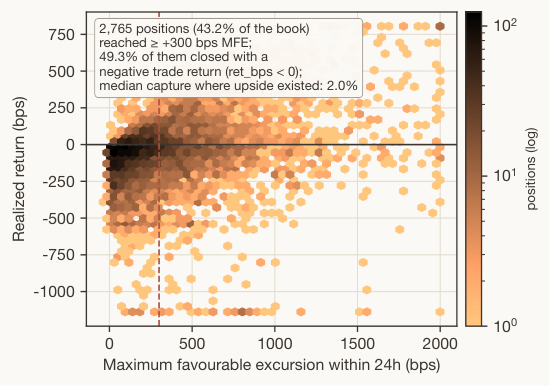
셋째, 유리한 움직임을 잡지 못합니다. 포지션의 43.2%가 24시간 내에 +300bps(3%) 이상 올랐습니다. 하지만 그중 49.3%가 결국 음수 수익으로 청산됐어요. 기계적으로 손절과 목표가를 설정하기만 해도 포지션당 평균 +39.0bps를 회수할 수 있었을 거라고 분석했습니다. 쉽게 말해, "올랐을 때 팔지 못하고, 결국 손해 보고 나온다"는 거예요.
넷째, 방향성 엣지가 없습니다. 두 함대 모두 수익이 나지 않았습니다. DXAP 함대는 비슷한 조건의 일반 거래자 벤치마크보다 못했어요 (라운드트립 승률 41% vs 50%). 프론티어 AI 모델들끼리 416개의 실제 시나리오를 가지고 대결시켜 보니, 의사결정 품질은 통계적으로 구분할 수 없었지만, 선택의 안정성은 모델 계열에 따라 크게 달랐습니다.
이 발견이 의미하는 것
이 연구가 던지는 메시지는 명확합니다: "AI 에이전트가 전략을 짜는 것보다, 에이전트가 어떻게 운용되는지를 관리하는 것이 훨씬 중요하다". 변동성에 따른 동적 레버리지 조절, 손절·목표가 자동화, 그리고 리스크 슬라이더 같은 운용 파라미터의 설계가 전략 텍스트 자체보다 결과에 더 큰 영향을 미친다는 거예요. AI 트레이딩에 관심이 있다면, "어떤 AI 모델이 더 똑똑한가"보다 "시스템이 리스크를 어떻게 관리하는가"를 먼저 살펴봐야 합니다.
함께 등장한 연구들
프롬프트 속의 편향 (2609.03218): 동일한 금융 문서를 LLM에게 보여주되, 역할 프롬프트("당신은 공격적 투자자입니다" vs "당신은 보수적 투자자입니다")를 바꾸면 분석 결론이 어떻게 달라지는지 12개 모델로 검증했습니다. SEC 문서 3,575건에 대해 실험한 결과, 역할 프롬프트·검색 조건·메모리 상태에 따라 동일한 증거에 대한 결론이 체계적으로 달라지는 것으로 나타났습니다. AI 투자 리서치를 도입하려는 기관에게는 프롬프트 설계와 모델 선택이 리스크 관리 대상이라는 점을 시사합니다.
자기진화의 한계 (2609.33524): 알파 리서치 에이전트가 "시간이 지나면 스스로 좋아진다"는 주장을 검증한 연구입니다. 동일한 포트폴리오 상태에서 에이전트의 기억과 역량을 교체하는 실험을 통해, 통상적인 자기진화 주장에 부정적인 증거를 제시했습니다. AI 에이전트의 "학습"과 "발전"이라는 마케팅 문구를 냉정하게 평가해야 한다는 메시지입니다.
알파 탐색의 다양성 (2609.29014): 외부 API 의존 없이 로컬에서 알파 연구를 수행하는 에이전트와, 연구 경로의 다양성을 최적화하는 방법을 결합했습니다. 팩터 발굴에서 "비슷한 팩터만 반복 찾기" 문제를 정면으로 다룬 연구입니다.
테마 3: 옵션 수학의 새로운 도구 — 매직 스트라이크
왜 흥미로운가
옵션은 "미래의 특정 시점에 특정 가격으로 살 수 있는 권리"입니다. 옵션의 가격을 매기려면 미래의 변동성을 예측해야 하는데, 이 변동성은 strike 가격(행사가)에 따라 다르게 나타나요 — 이것을 '변동성 스마일'이라고 부릅니다. 변동성 스왑(variance swap)이나 감마 스왑 같은 특수한 계약은 이 스마일 전체의 정보를 필요로 하기 때문에 가격 산정이 까다롭습니다.
9월에 나온 이 논문은 그 까다로운 문제를 스마일 전체를 쓰지 않고, 몇 개의 특별한 가격점만으로 풀어내는 방법을 제시합니다.
대표 논문: 소수의 '마법 가격점'으로 분산 계약을 산정하다
이 논문의 핵심 아이디어를 비유로 설명해 보겠습니다.
카페에서 음료 가격을 책정한다고 상상해 보세요. 메뉴가 100개인데, 100개 전부를 조사하지 않아도 특정 3~5개의 대표 메뉴 가격만 알면 나머지 가격을 꽤 정확하게 추정할 수 있다면? 그 대표 메뉴가 바로 '매직 스트라이크(magic strike)'입니다.
수학적으로 말하면, 옵션 스마일의 내재 총분산(implied total variance)을 소수의 특별한 행사 가격에서의 값만으로 고차 정확도로 근사할 수 있다는 겁니다. 분산 스왑이나 감마 스왑 같은 계약의 공정가치를 이 소수의 값만으로 계산할 수 있어요.
이 연구가 기존 방법과 다른 점은 두 가지입니다:
-
Strike inversion이 필요 없습니다. 기존 방법들은 시장 데이터에서 특정 strike를 역추출해야 해서 수치적 불안정성이 있었어요. 이 방법은 시장 스마일에 보간된 데이터를 직접 사용할 수 있습니다.
-
모든 확장 차수에서 근사가 존재합니다. 1차 근사, 2차 근사... 어떤 차수에서든 매직 스트라이크의 수는
2×(차수의 절반 올림)+1개로, 계산 비용이 선형적으로만 증가합니다.
검증 결과, Heston 모형(가장 널리 쓰이는 변동성 모형 중 하나)과 rough Bergomi 모형(더 정교한 모형) 모두에서 강하게 왜곡된 스마일에서도 좋은 정확도를 보였습니다. 이 논문은 Jim Gatheral이 참여한 연구로, Gatheral은 스마일 이론의 세계적 권위자입니다.
흥미로운 발견 하나: 변동성 계약의 경우, 만기 시점의 스마일만으로는 Rolloos-Arslan 근사의 선행 보정을 결정할 수 없다는 새로운 통찰을 제시합니다. 기존 근사의 한계를 정확히 규명한 거예요.
이 발견이 의미하는 것
SPX( S&P500 옵션) 같은 지수 옵션 시장에서 분산 스왑이나 감마 스왑의 가격을 매기는 실무자들에게는 계산 효율성과 정확도를 동시에 높이는 도구를 제공합니다. 스마일 전체를 쓰지 않아도 되니까, 실시간 가격 결정에도 적용할 수 있어요.
테마 4: 손실폭을 강건하게 제어하는 새로운 포트폴리오 이론
왜 흥미로가
투자에서 가장 고통스러운 순간은 "_MAXIMUM 손신폭(drawdown)_을 경험할 때입니다. 100만 원이 70만 원이 되면 30% 손신폭이에요. 이 손신폭을 미리 정해둔 한도 안에서 제어하려면 어떻게 해야 할까요? 변동성이 커지면 레버리지를 줄이고, 작으면 늘리는 식의 조절이 필요합니다.
문제는 "모든 가능한 시나리오에서" 이 한도를 지키겠다는 보장을 어떻게 확보하느냐입니다. 특정 시나리오만 고려하면, 예상치 못한 상황에서 한도가 깨질 수 있거든요.
대표 논문: 손신폭을 보장하는 강건한 제어 이론
이 논문은 수학적으로 매우 우아한 결과를 제시합니다.
핵심 정리를 쉽게 풀어보겠습니다. 포트폴리오의 손신폭을 제어하려면, 현재 남아 있는 '쿠션'(최대 손신폭 한도까지 남은 여유)과 투자 방향을 곱하는 형태로 제어해야 한다는 겁니다. "모든 강건하게 안전한 제어는 손신폭-변조(drawdown-modulated) 형태를 가진다: 현재 쿠션 × 정규화된 투자 방향".
이게 왜 중요한가 하면, 이렇게 하면 어떤 수익률이 실현되더라도 원하는 최대 손신폭을 보장할 수 있기 때문입니다. 특정 분포를 가정하지 않고, 모든 가능한 시나리오에 대해 성립하는 보장이에요.
더 실용적인 결과도 있습니다. 단계별로 독립적인 수익률(하루하루의 수익이 이전과 독립적이라는 가정) 하에서, 이 강건 안전한 정책들 중 최적을 찾는 문제가 1차원 벨만 재귀(Bellman recursion)로 축약됩니다. 벨만 재귀는 동적 프로그래밍의 기본 도구인데, 보통 다차원 문제에서 쓰이거든요. 이걸 1차원으로 줄일 수 있다는 건 계산이 크게 쉬워진다는 뜻입니다.
그리고 기존의 간단한 선형 시불변(LTI) 정책보다 엄격하게 더 높은 기대 수익을 보장합니다. 최소 2단계(예: 이틀) 이상의 시간 구간에서 개선이 성립하죠.
이 발견이 의미하는 것
자기자본을 운용하는 투자자에게 drawdown 제어는 "생존"의 문제입니다. 이 논문은 모든 시나리오에서 원하는 손신폭을 보장하면서, 동시에 기대 수익까지 개선하는 이론적 프레임워크를 제공합니다. 1차원 벨만 재귀로의 축약 덕분에 실제 구현도 비교적 용이해요.
함께 등장한 연구들
교차영향 최적화 (2609.04712): 주식을 살 때 그 주식 가격만 오르는 게 아니라, 관련 주식 가격도 영향을 받습니다 — 이것이 '교차영향(cross-impact)'이에요. 이 논문은 자기영향만 고려하던 기존 거래비용 모델을 교차영향과 영향의 시간 감쇠까지 포함하는 볼록 최적화 문제로 확장합니다. 원자재나 매크로 상대가치 전략에서 미세한 알파를 잠식하는 거래비용을 정밀하게 모델링할 수 있어요.
Wasserstein 불확실성과 포트폴리오 (2609.23571): "내가 추정한 분포가 틀렸을 때 어떻게 하지?"라는 질문에 답하는 연구입니다. Wasserstein 불확실성 집합에서 평균-분산 위험함수의 최악·최선값을 무한차원 최적화에서 스칼라 방정식으로 축약합니다. 참조분포의 평균과 분산만으로 강건한 포트폴리오 최적화를 할 수 있어요.
온라인 윈도우 선택 (2609.29887): 투자 전략에서 "며칠치 데이터를 볼 것인가"(룩백 윈도우)는 중요한 선택입니다. 이 논문은 시장 국면 변화에 따라 최적 관측창을 온라인으로 선택하고, 거래비용까지 포함해 동적으로 포트폴리오를 조합하는 프레임워크를 제시합니다.
테마 5: 팩터를 만드는 AI에게 "네가 평가하지 마"
왜 흥미로운가
'팩터(factor)'는 주식 수익률을 예측하는 신호입니다. 예를 들어 "저평가된 주식이 앞으로 오른다"는 게 밸류 팩터죠. 최근에는 LLM(AI)이 새로운 팩터를 자동으로 제안하고, 백테스트하고, 선별하는 시스템이 등장했습니다. 문제는 뭘까요? AI가 만든 팩터를 AI가 평가하면, 데이터 누수와 선택편향이 생기기 쉽습니다. "이 팩터가 과거에 잘 됐다"는 결과가 진짜 예측력인지, 아니면 우연히 맞아떨어진 것인지 구별이 안 되거든요.
대표 논문: 제안은 AI가, 판단은 동결된 심판이
이 논문이 제안하는 해법은 아름답게 단순합니다: "역할을 분리하라".
- 에이전트의 역할: 새로운 투자 팩터를 제안한다. 이것만 해요.
- 심판의 역할: 에이전트가 건드릴 수 없는 동결된 통계 심판(frozen referee)이 제안된 팩터를 평가한다. 심판은 제출 이후에 드러난 시장 결과만으로 채점합니다.
심판이 '베팅(betting)'이라는 수학적 도구를 사용하는데, 이게 핵심입니다. 베팅 방식의 평가는 어떤 제안 정책에 대해서든 모든 시점에서 거짓발견 보장(false-discovery guarantee)이 성립합니다. "에이전트가 아무리 많은 팩터를 쏟아내도, 가짜 팩터가 진짜로 통과할 확률은 통제된다"는 뜻이에요. 이것을 'anytime-valid' 보장이라고 합니다.
실험 결과는 인상적입니다:
-
심판의 영향: 동결 심판은 누설된(leaky) 심판보다 5~11배 적은 가짜 팩터를 허용했습니다. 어떤 에이전트도 이 격차를 좁히지 못했어요. "누가 판단하는가"가 결과를 압도적으로 결정한다는 뜻입니다.
-
에이전트의 영향: 에이전트는 좋은 팩터의 "수확량"에 영향을 줬습니다. LLM 에이전트는 스크립트(단순 규칙)를 이기고, 밴딧(강화학습)과 대등했어요. 하지만 LLM만의 고유한 능력이 하나 있었습니다: 자체 진단 프로브(diagnostic probes)를 작성하는 것. "이 팩터가 왜 작동하는지"를 설명하는 도구를 스스로 만들어내는 능력이죠.
-
인증의 대가: 이 시스템의 가격은 시간입니다. 진정한 팩터가 인증을 받기까지 약 500거래일 — 거의 2년 — 이 걸립니다. 그동안 인증된 포트폴리오의 샤프 비율은 비게이트(ungated) 포트폴리오보다 낮아요.
논문의 결론을 한 문장으로 요약하면: "판단은 절차에 속하고, 제안과 도구 제작은 에이전트에 속한다".
이 발견이 의미하는 것
AI가 투자 팩터를 만들어내는 시대에서, "진짜 실력"과 "운"을 구별하는 것은 생존의 문제입니다. 이 논문은 AI의 창의성(팩터 제안)과 검증의 엄밀성(통계 심판)을 분리하는 구체적인 프레임워크를 제공합니다. 자기자본 전략을 운용하는 기관에게는 팩터 발굴 파이프라인에 독립적인 거짓발견 통제 장치를 붙이는 것이 과적합 리스크를 줄이는 핵심이라는 점을 시사합니다.
함께 등장한 연구들
신호 상관의 진실 (2609.09588): 투자 신호들 사이의 상관관계가 높으면 "중복된 정보 아니야?"라고 생각하기 쉽습니다. 이 논문은 신호 간 횡단면 상관이 시간축 PnL(손익) 상관의 불완전한 대리변수임을 정확한 분해식으로 보여줍니다. 팩터 포트폴리오를 구성할 때 "상관이 높으니 하나 빼자"는 단순한 접근이 항상 옳지 않을 수 있다는 통찰이에요.
알파 신호의 구조적 한계 (2609.17609): 알파 신호 라이브러리를 구면 공간의 패킹 문제로 정식화했습니다. 쉽게 말해, "비상관 알파 신호를 얼마나 많이 모을 수 있는가"에 대한 수학적 상한선을 제시한 거예요. 신호가 많아지면 결국 중복이 생기고, 이 중복의 한계를 구조적으로 이해할 수 있게 해줍니다.
월 전체 Big Picture
2026년 9월의 금융 AI 연구를 관통하는 메시지는 "더 똑똑해지는 것보다 더 정직해지는 것이 중요해지고 있다"는 것입니다.
HFT에서는 1년치 실측 데이터가 수십 년된 단일 스레드 통념을 뒤집었고, LLM 에이전트에서는 수천 개의 프로덕션 에이전트가 변동성 무시 사이징과 방향성 엣지 부재라는 냉정한 현실을 보여주었습니다. 팩터 연구에서는 anytime-valid 통계 심판이 에이전트의 자기평가를 5~11배 더 엄격하게 만들었고, 옵션 수학에서는 소수의 매직 스트라이크만으로 분산 계약을 정밀하게 산정하는 새로운 프레임워크가 등장했습니다. 포트폴리오 최적화에서는 drawdown을 강건하게 제어하면서 기대수익까지 개선하는 1차원 벨만 축약이 제시되었습니다.
9월은 금융 AI가 '될 수 있는 것'에서 '실제로 작동하는 것'으로, '더 빠른 것'에서 '더 정확한 것'으로, '더 창의적인 것'에서 '더 검증된 것'으로 방향을 튼 달이었습니다.
더 알아보기
이 글에서 다룬 논문들의 arXiv 링크입니다:
- Packets, Transactions and Queues — S티어, 복합점수 83.7
- Propose, Don't Judge — A티어, 복합점수 77.4
- Magic Strikes — A티어, 복합점수 77.3
- LLM Trading Agents in Production — A티어, 복합점수 74.2
- The Analyst in the Prompt — A티어, 복합점수 72.5
- EverMine — A티어, 복합점수 72.2
- AlphaDiverse — A티어, 복합점수 72.0
- On Control of Drawdown — A티어, 복합점수 70.9
- Nyström Attention — A티어, 복합점수 70.8
- Signal Correlation, IC, and PnL — A티어, 복합점수 70.2
전체 S/A 논문 23편의 목록과 테마별 상세 분석은 백필 리포트 2609에서 확인할 수 있습니다.
ohselab은 금융 AI 연구를 체계적으로 수집·평가·공유합니다.
📚 이 글에서 다룬 논문 (10편)
- APropose, Don't Judge: An Anytime-Valid Referee for LLM Agents That Mine Investment Factors
Bo Qu, Mingguang Chen, Licheng Wang
- AMagic strikes for variance and gamma contracts, and other attainable claims
Florian Bourgey, Jim Gatheral
- AWhat LLM Trading Agents Actually Do in Production: A Six-Month, Population-Scale Record from Two Fleets
T. J. Barton, Chris Constantakis, Patti Hauseman 외 4명
- AThe Analyst in the Prompt: Role, Retrieval, and Memory Biases in LLM Financial Analysis
Ahmed Asaad, Amr Mohamed, Yang Zhang 외 1명
- AEverMine: Dissecting the Self-Evolution of Research Capabilities in Long-Horizon Alpha Research
Siyuan Li, Jiangfeng Zhang, Rui Yao 외 3명
- AAlphaDiverse: Post-Training Local Quantitative Research Agents for Diverse Exploration in Alpha Factor Mining
Qingzhuo Wang, Zikun Wei, Zhihua Wei 외 1명
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2026-04 월간
AI가 진짜 돈을 움직이기 시작했다 — 2026년 4월 금융 AI 연구 하이라이트
2026년 4월 금융 AI 연구 동향. LLM 에이전트가 실제 자본으로 온체인 거래를 시작하고, 백테스트의 허상이 대규모 실증으로 검증된 달의 핵심 논문들을 살펴봅니다.
 📊 2021-11 월간
공분산을 깨끗하게, 헤징을 안정적으로 — 2021년 11월 금융 AI 연구 탐구
2021년 11월 arXiv에 올라온 금융 AI 연구 중 주목할 만한 논문 다섯 편을 살펴봅니다. 공분산 행렬 정제, 리스크 측도 추정, 딥헤징의 안정성, end-to-end 포트폴리오 최적화, 팩터 간 인과구조 분석까지 — 이론과 실전 사이의 간극을 좁히는 연구들을 쉽게 풀어 설명합니다.
 📊 2020-04 월간
팬데믹이 금융 이론을 다시 쓰게 한 달 — 2020년 4월 금융 AI 연구 하이라이트
2020년 4월 금융 AI 연구 동향. 코로나19 팬데믹 직후, 교차영향 모델링과 포트폴리오 비중 직접 예측, 비지도 학습 기반 변동성 국면 탐지 등 전통적 금융 이론의 가정을 재검토하는 핵심 논문들을 살펴봅니다.