매달 arXiv에 쏟아지는 수백 편의 금융 AI 논문 중에서 가장 의미 있는 연구를 골라 정리합니다. 10월은 한마디로 "정말 그대로 동작하는가?"를 묻는 달이었습니다. 가짜 시장에서 훈련한 AI가 진짜 시장처럼 반응하는지, AI가 작성한 트레이딩 코드가 우리가 요청한 전략인지, 투자 목표를 AI에게 번역해 줬더니 목표가 바뀌지 않았는지 — 예측을 더 잘하는 이야기가 아니라, 설계한 것과 실행된 것 사이의 격차를 측정하는 이야기들이 쏟아져 나왔습니다.
들어가며: 10월에 무슨 일이 있었나
이번 달 코호트는 10월에 arXiv에 공개된 논문 660편(그중 우리 기준 관련 논문 257편)으로, 역대 최대 규모였습니다. 그중에서도 최고 등급인 S등급 2편과 A등급 75편이 나왔는데, 이 논문들을 훑어보면 공통된 무늬가 하나 보입니다.
바로 "믿었던 지표가 사실을 말해 주지 않는다"는 것입니다.
- 생성형 주식시장(LOB 시뮬레이터)은 분포 통계 점수가 높은데, 정작 큰 주문을 넣으면 실제 시장과 완전히 다르게 반응했습니다.
- AI가 작성한 트레이딩 코드는 잘 컴파일되고 백테스트도 그럴듯한데, 요청한 전략의 핵심 로직이 조용히 빠져 있었습니다.
- 투자 목표를 보상 함수로 번역해 준 순간, AI는 "완벽하게" 다른 목표를 달성하고 있었습니다.
이제 테마별로 하나씩 살펴보겠습니다.
테마 1: 가짜 시장에서 훈련한 AI, 진짜 시장처럼 반응할까
왜 흥미로운가
레이싱 게임으로 연습한 사람이 실제 서킷에 오면 어색해지는 이유가 뭘까요? 게임의 차가 실제 차처럼 밀리지 않기 때문입니다. 핸들을 아무리 정교하게 돌려도, 실제 레이싱에서는 "차가 무게를 실고 미끄러지는" 반응이 학습에 꼭 필요한데 게임이 그걸 못 재현하면 연습이 헛돌죠.
AI 트레이딩에서도 비슷한 일이 벌어지고 있습니다. AI 에이전트를 훈련시키려고 인공으로 만든 주식시장(호가장 시뮬레이터)을 쓰는데, 이런 "가짜 시장"이 실제 시장과 비슷해 보이는지는 주로 가격 분포 통계로 확인해 왔어요. 스프레드가 비슷하고, 거래량이 비슷하고, 주문 도착 간격이 비슷하면 "현실적"이라고 본 거죠.
그런데 정작 중요한 질문이 빠져 있습니다: AI가 큰 주문을 넣으면, 시장이 실제처럼 밀릴까요?
대표 논문: LOB-Impact Benchmark — 분포는 비슷한데 충격은 엉터리
10월의 첫 S등급 논문은 이 질문을 체계적으로 측정하는 벤치마크를 제안합니다. LOB-Impact Benchmark(복합점수 80.9)가 바로 그 논문이에요.
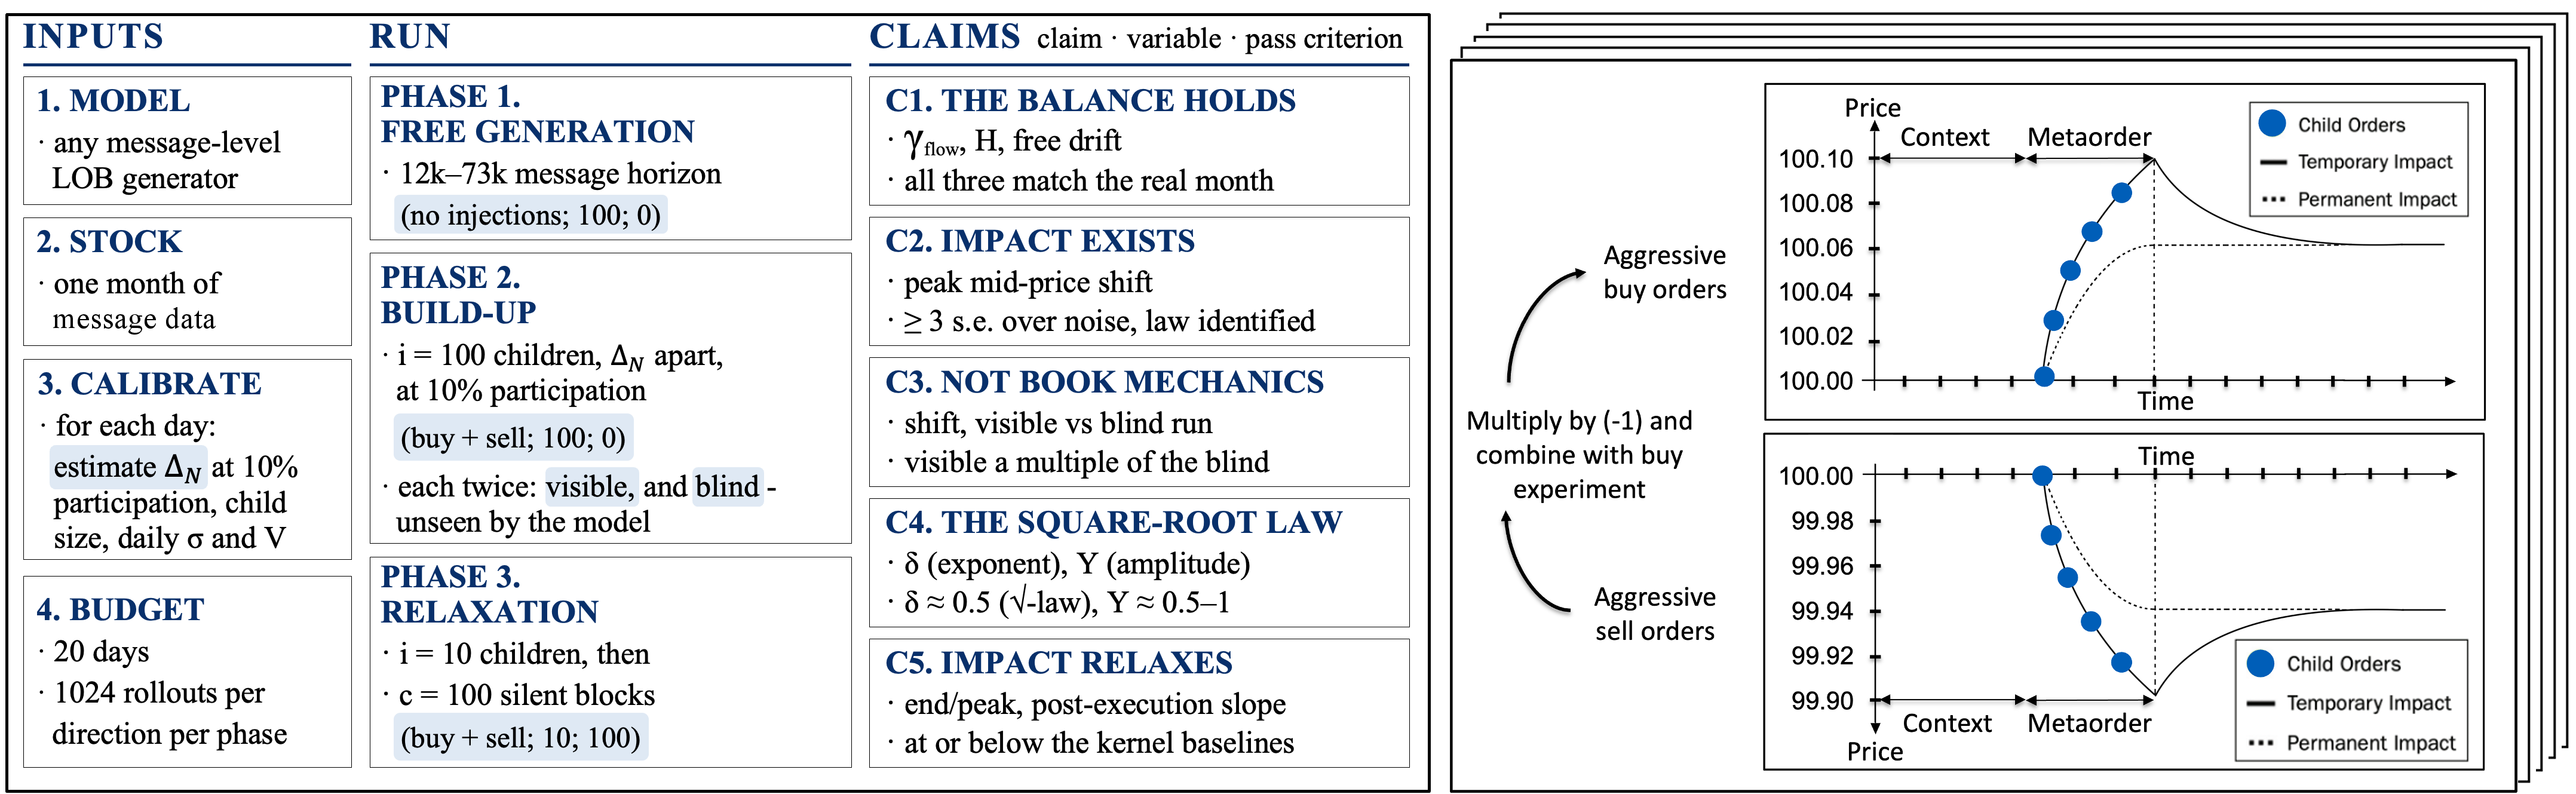
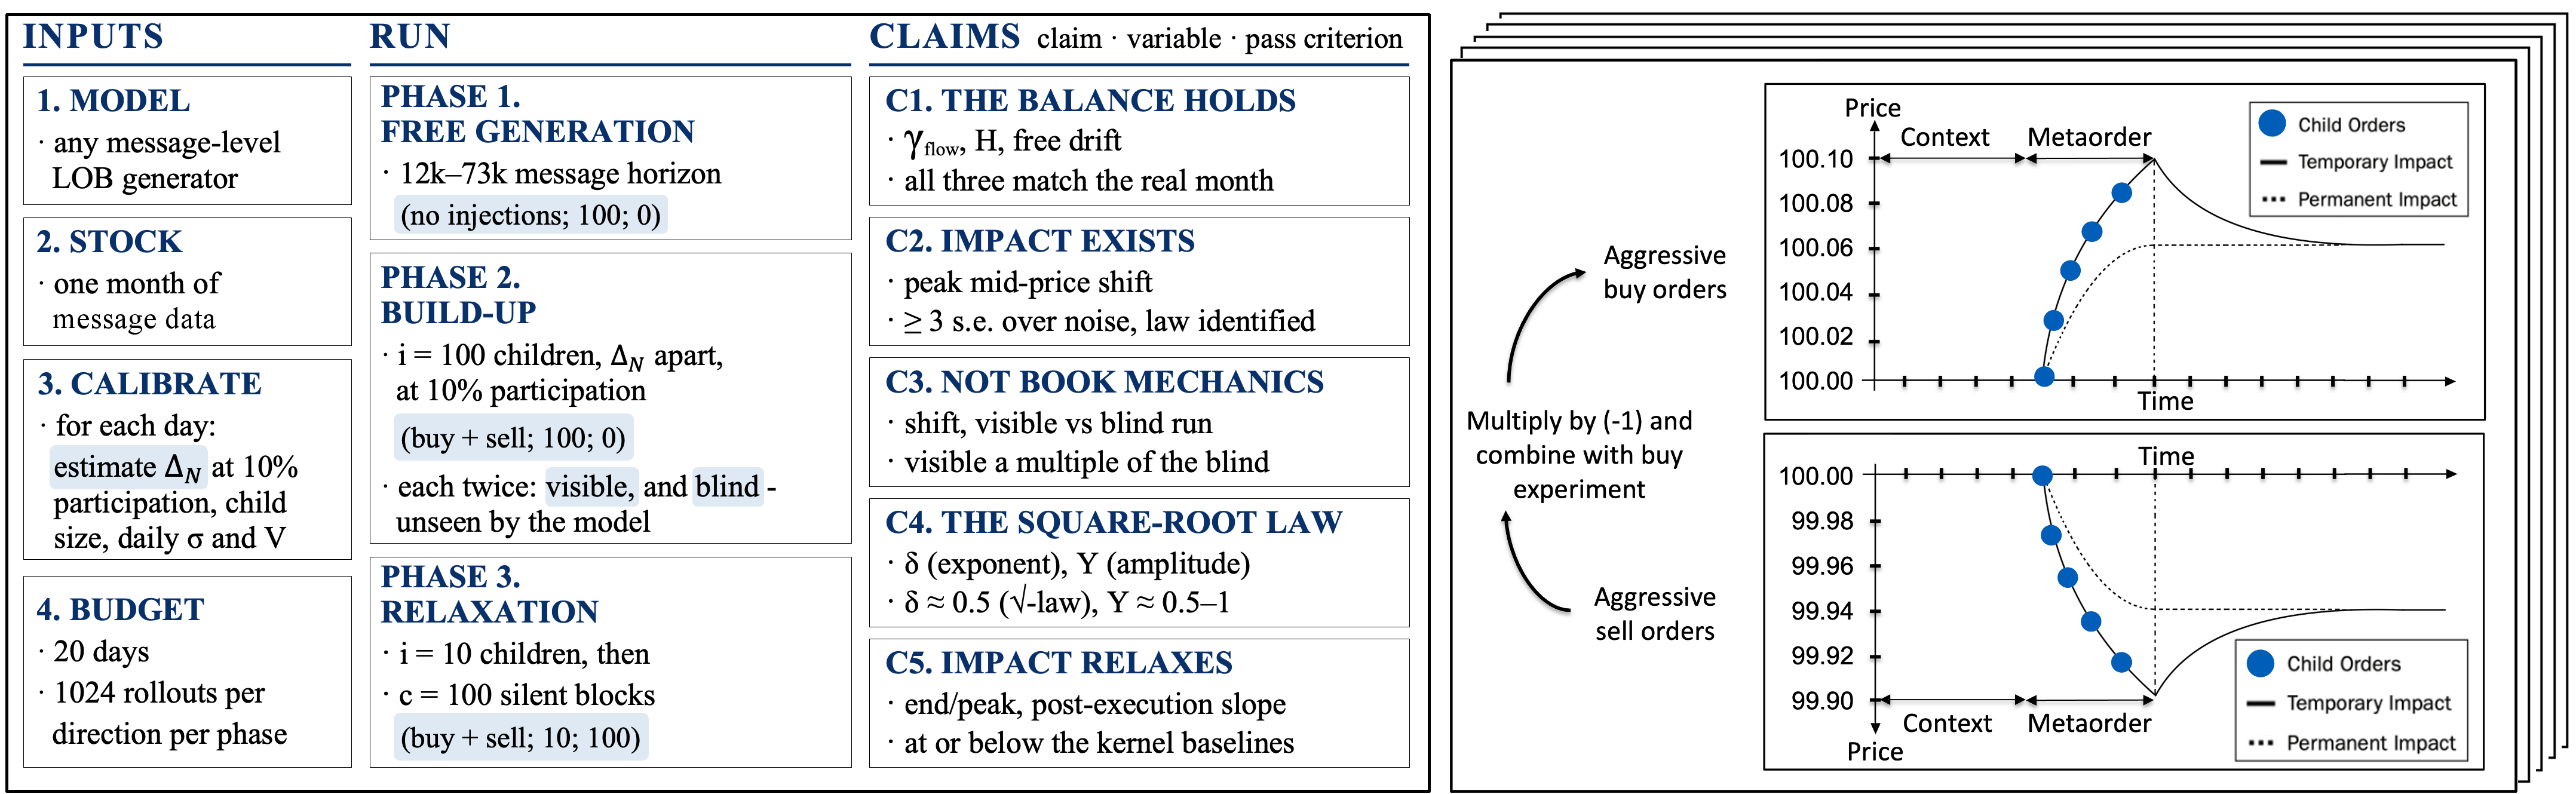
연구진은 다섯 개의 최신 신경망 시장 모델(S5, Mamba3, GDN 계열)과 다섯 개 종목(AMD, 엔비디아, 마이크로소프트, 구글, EA)을 조합해 25개 조합 전부를 시험했습니다. 방법은 세 단계입니다:
- 자유 생성: 아무것도 하지 않고 시장이 돌아가게 두고, 가격의 방향성과 주문 흐름의 지속성을 측정합니다.
- 큰 주문 주입: 실제와 같은 비율(참여율 10%)로 100개의 분할 주문을 넣고, 가격이 얼마나 밀리는지 측정합니다.
- 회복 관측: 주문이 끝난 뒤 가격이 원래 자리로 돌아오는지 지켜봅니다.
여기에 하나의 재치 있는 장치가 더해집니다. 블라인드 대조라는 건데요, 똑같은 시뮬레이션을 두 번 돌리되 한 번은 "주문을 시장에 넣되 AI 모델에게는 숨기는" 방식입니다. 이렇게 하면 '주문 때문에 변한 가격' 중에서 '다른 참가자들의 반응'만 골라내 볼 수 있어요. 마치 학생이 없는 줄 알고 시험지를 훔쳐보는지 확인하려고 거울을 설치하는 것과 비슷하죠.
무엇을 발견했나
결과는 솔직히 냉정했습니다.
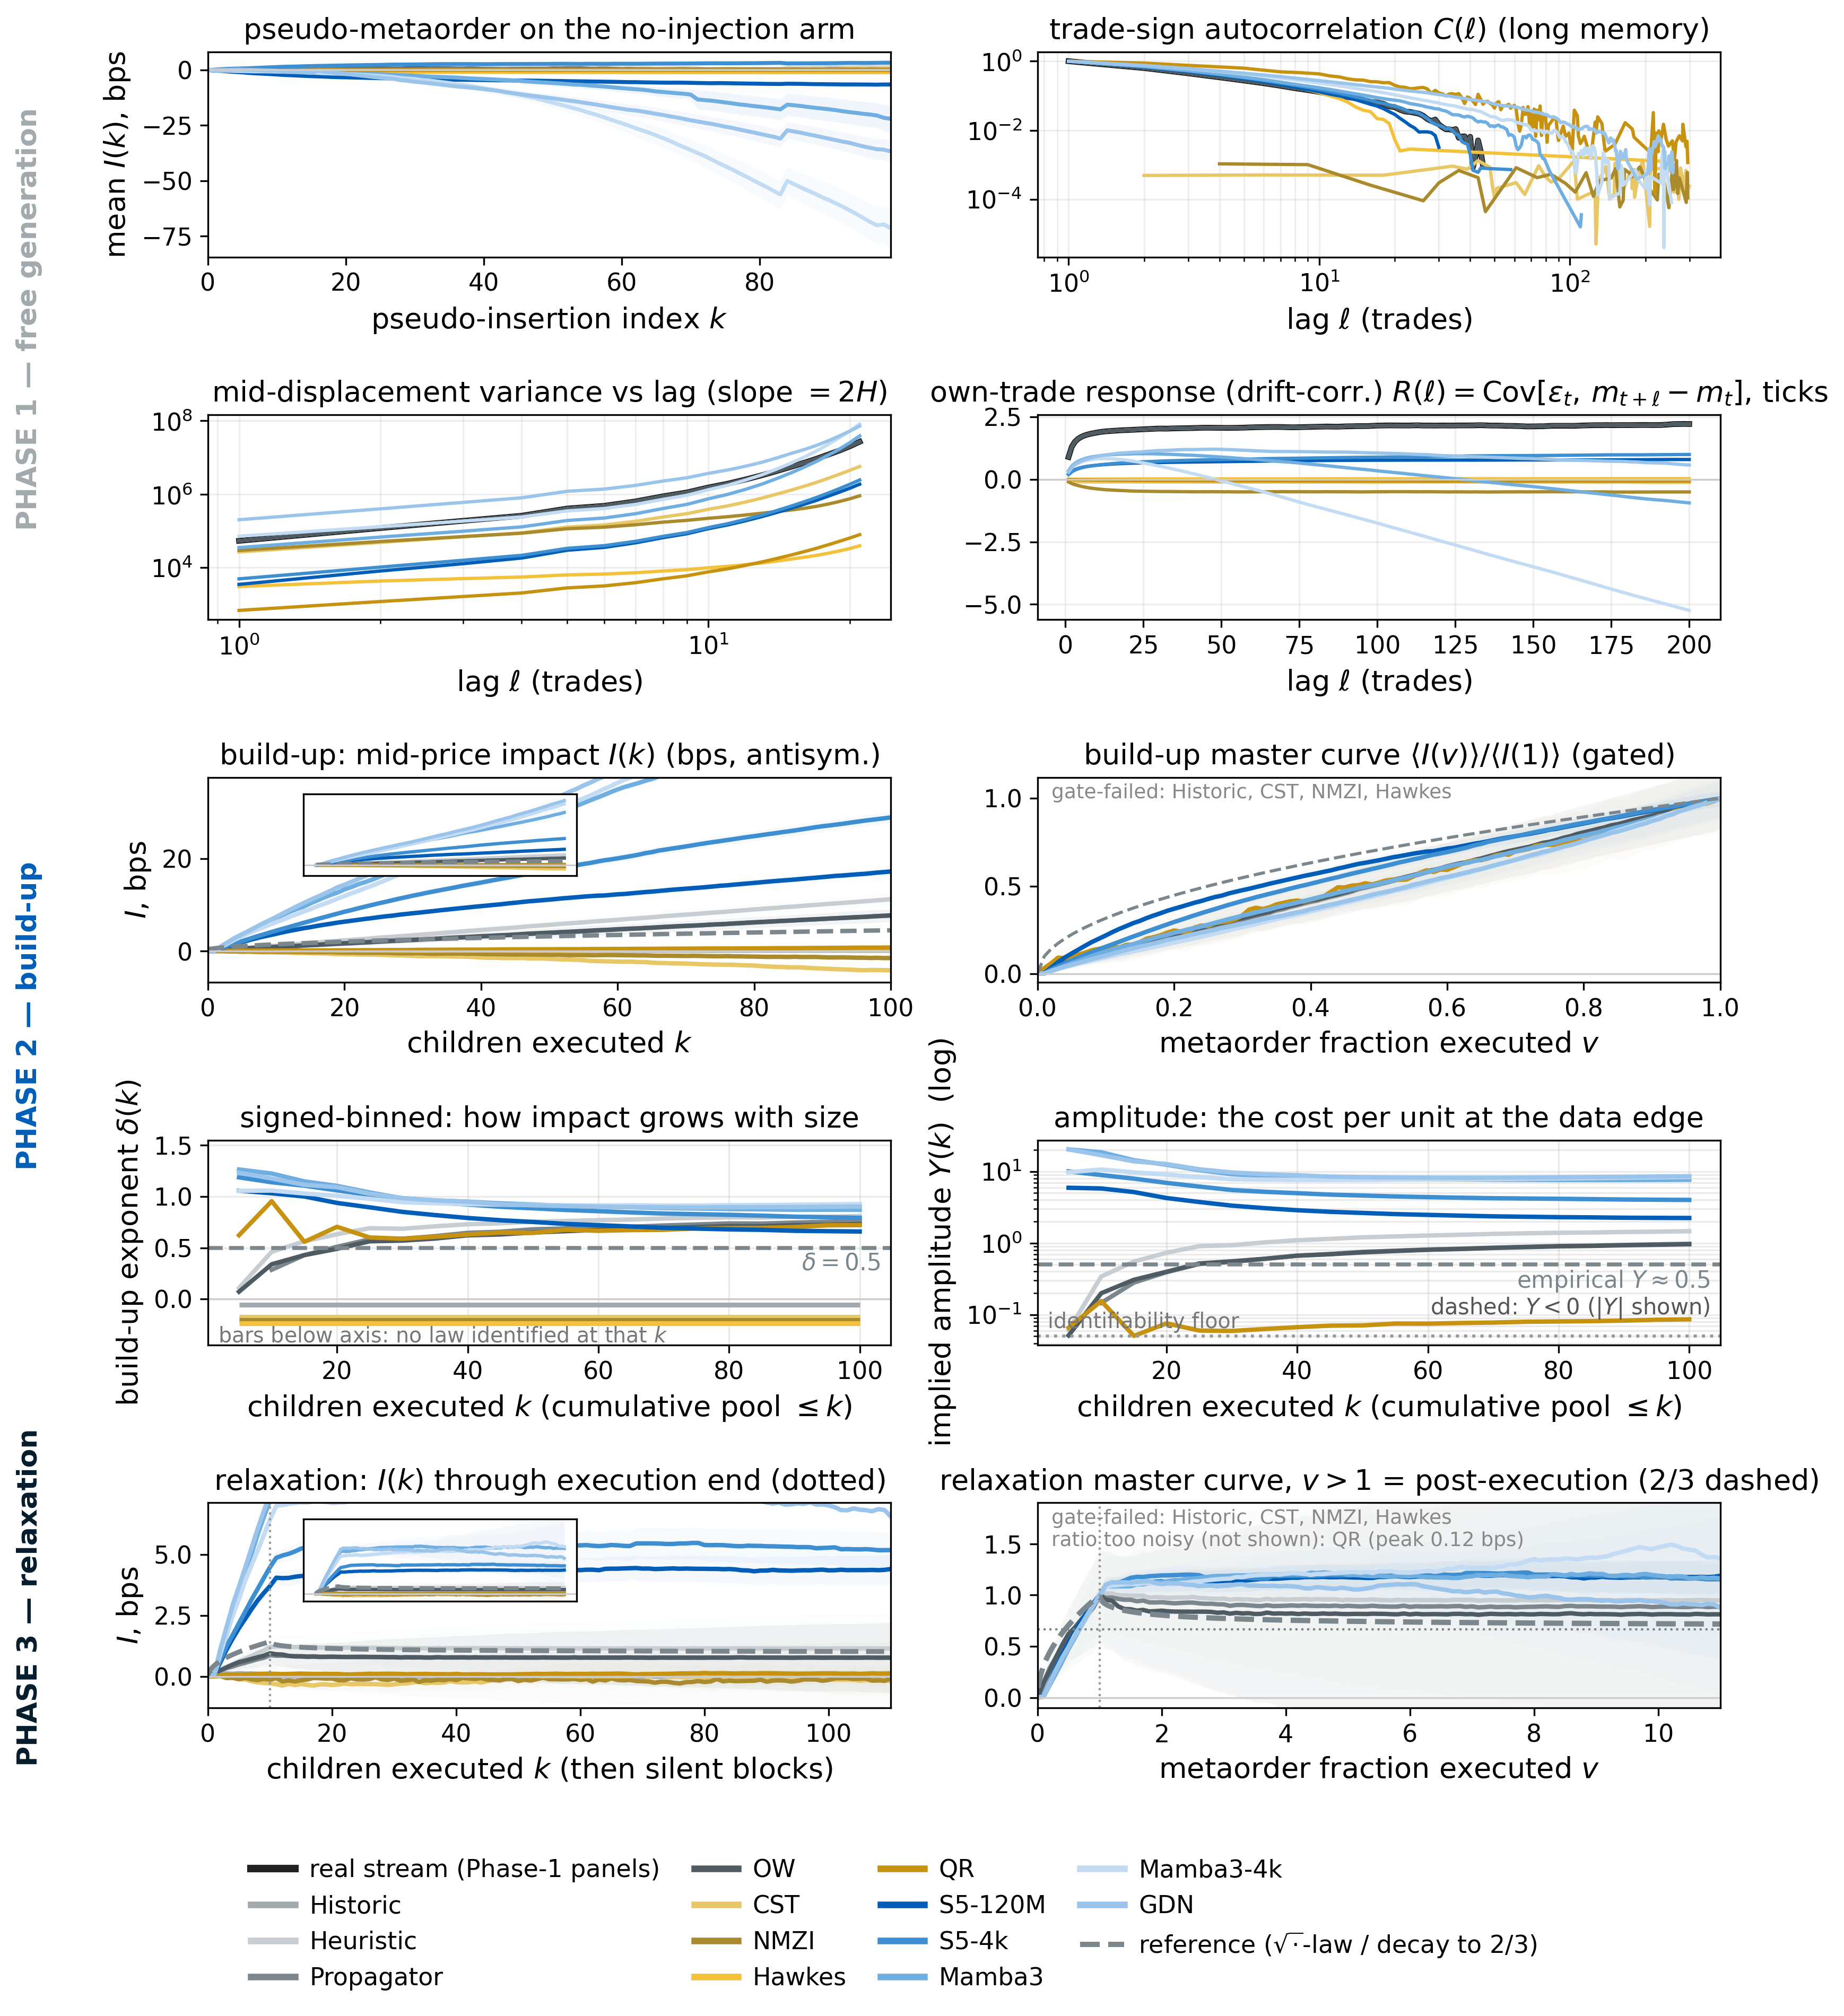
- 충격은 있었습니다: 25개 조합 전부에서 "큰 주문이 가격을 민다"는 사실 자체는 재현됐습니다. 다행히 AI 시장이 아예 무반응인 것은 아니었어요.
- 하지만 형태가 달랐습니다: 실제 시장은 주문량이 2배로 늘면 충격이 약 1.4배(제곱근 법칙) 늘어나는데, 모델들은 0.63~1.21의 지수를 보였습니다. 실제와 통계적으로 확실히 달랐어요(25개 조합 전부에서 실제 값의 95% 신뢰구간을 벗어남).
- 충격이 지나치게 컸습니다: 진폭은 실제 시장의 4~17배. 100개 분할 주문이 모의 시장 가격을 17~70 베이시스포인트(0.17~0.70%) 밀어젖혔는데, 실제 시장에서 비슷한 규모의 충격은 훨씬 작습니다. 모의 시장이 "유리창처럼 깨지기 쉬운" 거예요.
- 회복이 없었습니다: 실제 시장은 주문이 끝나면 충격의 약 2/3가 1~2일 내에 되돌아오는데, 모델들은 되돌아오기는커녕 같은 방향으로 계속 움직였습니다.
- 가장 쓰라린 발견: 분포 통계 점수(LOB-Bench)와 충격 사실성의 순위 상관이 종목에 따라 +0.54에서 −0.71까지 흔들렸습니다. 즉 "분포가 비슷하다"는 점수가 "충격이 사실적이다"와 전혀 별개라는 뜻입니다.
이 테마의 공통 인사이트
이 테마의 논문들이 함께 말하는 것은 "시장 모델은 '생김새'가 아니라 '반응'으로 평가해야 한다"는 것입니다. 시장 충격을 "내가 거래하지 않았다면 가격이 어떻게 됐을까"라는 반사실적 질문으로 정의해야 측정할 수 있고(2610.12537), 실제 시장 궤적에는 시간의 화살이 있어 시뮬레이터가 이 방향성을 재현하지 못하면 메커니즘을 읽을 수 없다는 연구(2610.16151)도 같은 결론에 닿아 있습니다.
함께 등장한 연구들
Market Impact Estimation via Causal Foundation Models (2610.12537): 큰 주문의 시장 충격을 "내가 거래하지 않았다면 가격이 어떻게 됐을까"라는 반사실적 질문으로 정의하고, 방대한 시장 데이터로 미리 학습한 모델로 그 차이를 추정합니다. "가격이 얼마가 될까"가 아니라 "내가 없었다면 얼마였을까"를 묻는 것이 충격 측정의 본질이라는 점을 분명히 합니다.
Neural Estimation of Irreversibility (2610.16151): 시장 궤적을 앞에서 뒤로 재생하든 뒤에서 앞으로 재생하든 구별할 수 없다면, 그 궤적에는 "무엇이 무엇의 원인인지"를 읽을 수 있는 정보가 없다는 아이디어입니다. 실제 호가장 데이터와 시뮬레이터를 같은 잣대로 비교하는 진단 도구로 쓸 수 있습니다.
테마 2: AI가 작성한 트레이딩 코드, 정말 그 전략일까
왜 흥미로운가
요리 레시피를 말로 불러주고 대신 요리해 달라고 맡긴 적이 있나요? 대부분 그럴듯한 요리가 나오지만, 자세히 보면 원래 레시피와 다른 점이 하나둘 있습니다. "센 불에 볶다가"가 "중불에 익힘이" 되고, "마지막에 소금 간"이 아예 빠지고요.
AI에게 트레이딩 전략을 설명하면 코드를 작성해 주는 시대가 왔습니다. 그런데 여기서의 실패는 요리와 달리 조용하게 일어납니다. 코드는 실행되고 백테스트 그래프도 그럴듯하게 나오는데, 정작 손절(stop-loss)이 전혀 움직이지 않거나 쿨다운(재진입 대기 시간)이 매 막대마다 초기화되는 식이죠. 눈에 띄는 오류 메시지가 없으니 아무도 모르고 지나갑니다.
대표 논문: MintEval — "실행된다"와 "맞다"는 다르다
이 문제를 처음으로 체계적으로 측정한 벤치마크가 MintEval(A등급, 74.5)입니다.
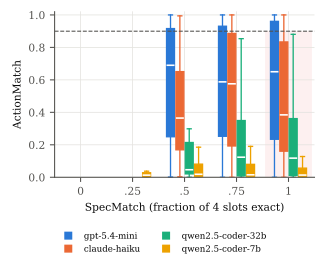
연구진의 방법은 단순하면서도 정확합니다. 먼저 신호, 필터, 포지션 사이징, 리스크 관리 블록을 조합해 정답 전략을 프로그램으로 생성합니다. 그리고 이를 "5% 상승 돌파 시 진입하고, 손절은 진입가 기준 −2%에서 걸어 둬" 같은 사람이 쓰는 자연어 메시지로 바꿉니다. AI는 이 메시지와 인터페이스 설명서만 보고 코드를 다시 작성합니다.
그리고 결정적인 비교: 정답 코드와 AI 코드를 똑같은 데이터, 똑같은 수수료(6 베이시스포인트)로 실행해서, 막대(bar)마다의 목표 포지션이 일치하는지 비교합니다. 수익률이 아니라 행동을 비교하는 거예요. 지는 전략을 완벽하게 재현해도 만점을 받고, 돈을 버는 전략을 다르게 구현하면 감점을 받습니다.
무엇을 발견했나
- 저비용 모델은 절반 이상이 조용히 틀렸습니다: GPT-5.4-mini의 막대 일치율(ActionMatch)은 0.544, 침묵 실패율(문제없이 실행되지만 행동이 다른 비율)은 72.9%였습니다.
- 최고 모델도 네 건 중 하나는 틀립니다: Claude Opus 5.5조차 ActionMatch 0.889, 침묵 실패 27.5%.
- 이해와 구현은 별개였습니다: 전략 명세를 읽고 답한 이해도는 0.938로 거의 완벽했습니다. 그런데 명세를 완벽히 이해한 것으로 판정된 실행들 중 79.2%가 실제 행동에서 이탈했습니다. "알아듣는 것"과 "구현하는 것"이 다른 거예요.
- 길게 기억해야 할수록 어려웠습니다: 손절가 갱신, 쿨다운 시계처럼 여러 막대에 걸쳐 상태를 기억해야 하는 로직이 길어질수록 성능이 떨어졌습니다(기억 길이가 10배 늘 때마다 일치율 0.03~0.09 하락).
- AI 심판은 이걸 못 잡았습니다: 코드를 읽고 채점하는 LLM 심판을 그대로 쓰면, 최고 모델의 침묵 실패 55건 전부가 통과했습니다.
이 테마의 공통 인사이트
이 테마의 논문들이 공통적으로 지적하는 것은 "돌아간다"는 사실이 "맞다"는 뜻이 아니라는 것입니다. AI 에이전트의 성과가 전략 덕분인지 단순한 선택 덕분인지 분리해 감사해야 하고(2610.04040), 전략 탐색 자체가 통계적 운을 실력으로 포장할 수 있으므로 "발견"과 "검증"을 분리해야 하며(2610.07701), 백테스트의 체결 가정 하나가 AI 에이전트들의 순위까지 뒤바꾼다는 연구(2610.05077)도 같은 맥락입니다. 공통 처방은 하나예요: 평가를 실행 가능한 행동의 대조로 옮길 것.
함께 등장한 연구들
Agent Policy-Value Audit (2610.04040): AI 에이전트의 수익 차이를 "어떤 사건을 골랐는가"(이벤트 선택)와 "선택한 뒤 어떻게 행동했는가"(전환 구성)로 분해해, 전략의 진짜 가치와 선택 편향을 각각 측정하는 감사 방법을 제안합니다.
On the Boundary of Admission Gates (2610.07701): 전략 연구에는 두 가지 문제가 섞여 있습니다 — 수익 나는 규칙을 '찾는 것'과, 그 발견이 단순한 '탐색 운'이 아님을 '확립하는 것'. 이 논문은 정답을 미리 심어 둔 주입 진실 실험으로, 통계적 검문소(admission gate)들이 가짜 발견을 얼마나 걸러내는지 측정합니다.
How Execution Assumptions Change Sharpe Rankings (2610.05077): LLM 트레이딩 에이전트 백테스트가 흔히 쓰는 "전량 종가 체결" 가정을 현실적인 실행 조건(지연, 호가 스프레드, 시장 충격)으로 바꾸면 보고된 수익뿐 아니라 에이전트 순위 자체가 달라진다는 실증입니다.
테마 3: AI에게 목표를 알려 줬더니, 목표가 바뀌었다
왜 흥미로운가
"건강해지고 싶다"고 트레이너에게 말했는데, 트레이너가 세운 목표가 "체중만 줄이기"였다면 어떨까요? 체중은 확실히 줄지만 근육도 빠지고, 정작 원했던 '체력'은 나아지지 않을 수 있습니다. 의도를 목표 함수로 번역하는 순간, 번역 과정에서 의도가 바뀔 수 있다는 뜻이죠.
강화학습(RL) 기반 포트폴리오 운용도 같은 구조입니다. 투자 지침서는 "수익과 위험의 균형, 거래 비용 고려" 같은 선호를 규정하는데, 이를 AI가 최적화할 수 있는 '보상 점수'로 바꿔야 합니다. 이때 분산 대신 수익의 제곱을 쓰면 수익을 이중으로 벌점화하고, 자산 간 상관을 무시하면 헤지가 사라지고, 비용을 잘못 스케일하면 매매 회전율 선호가 달라집니다.
대표 논문: Certifying Reward Alignment — 보상이 원래 선호를 얼마나 왜곡하는가
Certifying Reward Alignment in Portfolio Reinforcement Learning(A등급, 77.5)은 이 왜곡을 인증 가능한 숫자로 분리해 측정하는 프레임워크를 제시합니다.
핵심 아이디어는 오차를 세 갈래로 나누는 것입니다:
- 보상 오차: 목표를 번역하는 과정에서 생긴 선호 왜곡
- 행동 오차: AI가 의도한 결정에서 실제로 이탈한 정도
- 가치 추정 오차: 미래 가치를 추정하는 과정의 오류
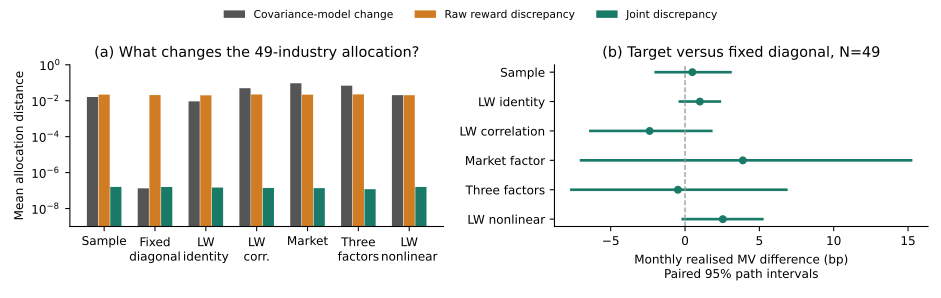
이 세 가지를 섞지 않고 각각 상한을 계산하면, "이 AI 정책에서 행동 하나를 바꾸면 얻을 수 있는 최대 이득"(일탈 이득)이 특정 범위를 넘지 않는다는 인증서를 발급할 수 있습니다. 감사용 데이터는 사전에 고정된 정책으로만 모으고, 통계 구간이 애매하면 "판정 불가"로 기권하는 안전장치도 넣었습니다.
무엇을 발견했나
- 학습 오차는 확실히 줄었습니다: 통제 환경(9개 시장 × 20개 시드)에서 이 방법은 기존 접근 대비 정책 이탈 거리 59.2% 감소, 일탈 이득 81.4% 감소를 달성했습니다. PPO 알고리즘에서도 각각 33.3%, 49.8% 감소했고요.
- 그러나 가장 중요한 결과는 이겁니다: 실제 35년치 미국 산업 포트폴리오 데이터(1990~2025년, 432개월)로 검증한 결과, 보상 교정은 각 목표를 정확하게 보존했지만 실제 투자 성과는 개선하지 못했습니다. 18개 비교 전부에서 통계적 차이의 신뢰구간이 0을 포함했어요.
- 오히려 단순한 최소분산 포트폴리오가 21개 시험 전부에서 가장 좋은 실현 위험 대비 성과를 기록했습니다.
이건 실패가 아니라 오히려 중요한 정직한 발견입니다: "AI가 원하는 대로 하고 있다"와 "투자 성과가 좋아진다"는 별개의 지표라는 것을 대규모로 보여줬거든요.
이 테마의 공통 인사이트
포트폴리오 연구들이 공통적으로 다루는 것은 "설계한 목표"와 "실제로 최적화된 것" 사이의 간격입니다. 최악의 경우 리스크를 분포가 아니라 분위수로 표현할 때 계산이 복록적으로 정리된다는 이론 결과(2610.29652), 생성 AI가 만든 합성 시나리오를 포트폴리오에 넣는 방식(교체 대 보충)에 따라 투자 결과가 달라진다는 실증(2610.24544)도, 모두 "목표와 실행의 정합성"을 다룹니다.
함께 등장한 연구들
Distributions or Quantiles? (2610.29652): "최악의 경우를 얼마나 걱정해야 하는가"를 계산할 때, 확률 분포 전체를 쓰는 것과 분위수(상위 몇 %)를 쓰는 것 중 어느 쪽이 이론적으로 깔끔한지 정리한 연구입니다.
Rachev-Ratio Portfolio Optimization with TimeGAN Scenarios (2610.24544): 시계열 생성 AI(TimeGAN)가 만든 가상의 미래 시나리오를 포트폴리오 최적화에 쓸 때, 실제 데이터를 대체하는 방식과 보충하는 방식이 투자 결과를 어떻게 다르게 만드는지 ETF 데이터로 비교합니다.
테마 4: 선물 옵션 가격의 정밀도는 "무엇을 관측하는가"가 결정한다
왜 흥미로운가
날씨 예보에서 기온만 보는 것과 기온·습도·바람을 함께 보는 것은 다릅니다. 후자가 훨씬 정확한 예보를 만들죠. 파생상품 가격 모델도 비슷합니다. 개별 선물 옵션 가격만 보는 모델은 "선물들 사이의 관계"라는 중요한 정보를 놓칩니다.
원유 같은 원자재에는 앞월물, 뒷월물이 쭉 있고, 그 차이(스프레드)를 대상으로 한 옵션도 거래됩니다. 이 캘린더 스프레드 옵션은 두 선물이 함께 움직이는 정도 — 쉽게 말해 "두 달 사이의 저장 비용 리스크" — 에 대한 정보를 담고 있어요. 그런데 이 옵션을 모델에 넣으면 정말로 가격이 달라질까요?
대표 논문: Arithmetic Models for Commodity Futures and Options — 스프레드 옵션이 알려 주는 것
이 논문(A등급, 77.2)은 뉴욕상업거래소(NYMEX)의 서부 텍사스산 원유(WTI) 선물·옵션 일일 정산가 342,637개(선물 36,530개, 바닐라 옵션 235,277개, 캘린더 스프레드 옵션 70,830개, 2013~2024년의 2,810영업일)를 하나의 모델로 함께 추정했습니다.
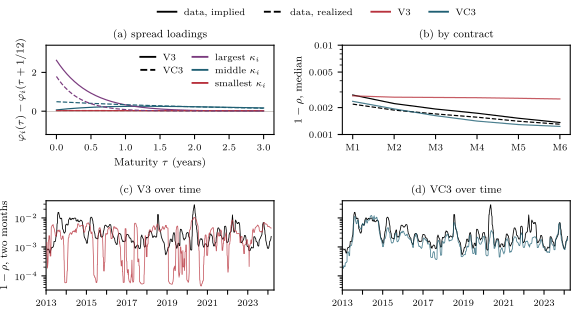
핵심은 두 가지입니다. 첫째, 변동성이 가격에 비례하는 기존 방식(기하 모델) 대신 가격에 비례하지 않는 산술 모델을 쓰면 상태 변수가 줄고 옵션을 빠르게 계산할 수 있습니다 — 2020년 4월 원유 가격이 마이너스가 된 극단 상황도 자연스럽게 처리됩니다. 둘째, 캘린더 스프레드 옵션 가격은 "변동성이 만기별로 어떻게 배분되는가"에 민감하게 반응해, 바닐라 옵션만으로는 알 수 없던 선물 간 의존구조를 식별시킵니다.
무엇을 발견했나
- 스프레드 옵션을 빼면 가격이 왜곡됐습니다: 선물과 바닐라 옵션만으로 모델을 추정하면 선물 간 움직임의 연관성을 가까운 만기에서 1.2배, 먼 만기에서 1.8배나 과대추정했습니다. 그 결과 스프레드 옵션이 9%(가까운 만기)~35%(먼 만기)까지 고평가됐어요.
- 넣으면 정확도가 올라갔습니다: 스프레드 옵션을 포함한 모델은 가격 오차(MAE)가 0.529에서 0.293으로 줄었고, 모델이 계산한 의존구조와 실제 데이터의 순위 상관이 0.13에서 0.92로 올라갔습니다.
- 헤지 관점에서도: 선물만으로는 일일 위험 분산의 10%도 제거하지 못했는데(효과 0.09), 요인 수만큼 옵션을 쓰면 위험의 거의 전부를 없앴습니다(3개 옵션 효과 0.97).
- 산술 모델이 기하 모델을 이겼습니다: 동일 조건 비교에서 기하 모델의 오차가 행사가격 근처에서 19%, 바깥 쪽 풋 옵션에서 45% 더 컸습니다.
이 테마의 공통 인사이트
파생상품 연구들이 공통적으로 말하는 것은 모델의 복잡성보다 관측 정보의 선택이 정밀도를 좌우한다는 것입니다. 소수의 옵션 견적으로 전체 변동성 곡선을 무차익 조건을 지키며 재구성하는 방법(2610.25671), 무차익 옵션 시장 모델의 수학적 안정성을 증명한 연구(2610.16732)도 같은 방향입니다.
함께 등장한 연구들
Arbitrage-Free Implied Volatility Surface Reconstruction (2610.25671): 견적이 몇 개 없는 시장에서 옵션 가격표를 그릴 때, "무료 점심"(무차익 기회)이 없도록 보장하면서 곡선을 복원하는 방법입니다.
The end-of-month option in futures contracts (2610.21196): 선물 매도자는 만기월에 언제 물건을 인도할지 선택할 수 있는데, 이 '선택권'이 선물 가격에 어떻게 반영되는지 최적 정지 이론으로 풀어냅니다. 시장의 미시 규칙이 가격에 정확히 들어가야 함을 보여주는 연구입니다.
테마 5: 새로운 시장의 틈 — 예측시장과 DeFi 금리의 숨은 함정
왜 흥미로운가
새로 문을 연 시장에는 아직 "가격이 이렇게 만들어져야 한다"는 규범이 덜 자리 잡아 있습니다. 그래서 구조적 틈이 남아 있고, 그 틈을 수학으로 정확히 짚어낼 수 있습니다.
예측시장(정치·스포츠 결과에 베팅하는 시장)을 예로 들어 볼까요. "A 후보 당선"과 "A 후보 낙선" 두 계약을 사서 무조건 1달러를 받을 수 있다면, 두 계약 가격의 합이 1달러보다 작아야 합니다. 그런데 논리적으로 연결된 계약이 수백 개라면? 그 틈의 구조는 훨씬 복잡하지만, 정수계획(integer programming)이라는 수학 도구로 전부 찾아낼 수 있습니다.
대표 논문: 더 예치했는데 이자가 줄어든다고? — DeFi 금리 곡선의 덫
이번 달의 두 번째 S등급 논문은 DeFi(탈중앙 금융) 대출 풀의 아주 기초적인 질문을 다룹니다: Depositing More Should Not Earn Less(복합점수 81.8). 제목 그대로 "더 많이 예치하면 더 적게 벌어서는 안 된다"는 이야기입니다.
DeFi 대출 풀은 "빌려간 비율(이용률)이 높을수록 차입 금리를 올리는" 곡선을 씁니다. 그런데 이상한 일이 벌어질 수 있어요. 예치자가 돈을 더 넣으면 이용률이 내려가고, 금리가 내려가는데, 그 낮아진 금리가 예치자의 통장 전체에 적용되기 때문입니다.
논문의 예시를 보면: 1,000만 달러 풀에 830만 달러가 빌려진 상태에서, 지분 10%인 예치자가 375,000달러를 추가로 넣습니다. 잔액은 37.5% 늘었는데 이자 소득은 159,775달러에서 55,000달러로 66% 줄었습니다. 오히려 약 302,000달러를 빼면 소득이 188,300달러로 늘어납니다. 넣으면 손해, 빼면 이익인 구간이 실재한다는 뜻이죠.
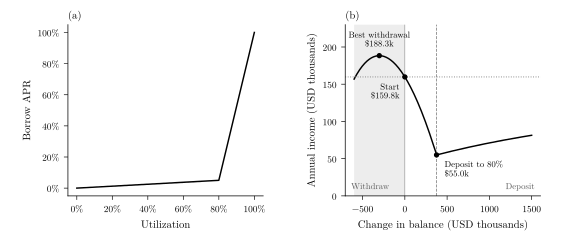
연구진은 이 문제가 언제 생기는지 딱 한 줄의 부등식으로 정확히 규명합니다. 내 지분이 α이고, 차입 금리가 이용률에 얼마나 민감하게 반응하는지(탄력성)가 η라면, "더 넣어도 손해가 없으려면" α(1+η) ≤ 1이면 충분하고 필요합니다. 쉽게 말하면 "금리가 빠르게 오르는 곡선일수록 큰 지분은 위험하다"는 것이고, 이 조건을 이용하면 "우리 프로토콜은 지분 몇 %까지는 보호하겠다"는 약속을 금리 곡선의 설계 제약으로 바꿔 계산할 수 있습니다.
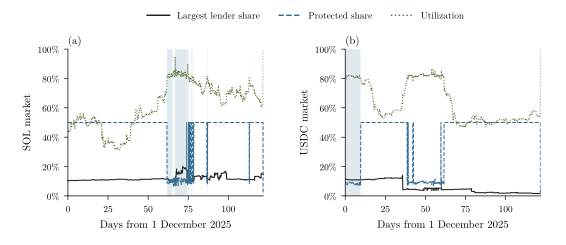
실제 데이터도 확인했습니다. 솔라나 블록체인의 대형 대출 프로토콜 Drift의 온체인 기록(2024년 11월~2026년 4월)에서, 대형 예치자들이 지분이 안전선을 넘은 위험 상태에 머문 시간이 SOL 시장에서 11.4%, USDC 시장에서 7.9%에 달했습니다. 특히 금리가 급변하는 구간(키크) 위에서는 USDC 시간의 36.6%가 위험 상태였어요.
이 테마의 공통 인사이트
새로운 시장의 가격·유인 구조에는 공식적으로 검증 가능한 설계 결함이 남아 있습니다. 예측시장에서 논리적으로 연결된 계약들의 가격이 허용 영역 밖에 있으면 실제 호가장 깊이와 수수료를 감안해도 실행 가능한 차익 포트폴리오를 만들 수 있고(2610.23517), DeFi 금리 곡선에는 위에서 본 역보상 구간이 있을 수 있습니다. 이 틈은 곧 새로운 시장의 리스크이자, 잘 들여다보는 사람에게는 기회입니다.
함께 등장한 연구들
Combinatorial Arbitrage in Prediction Markets (2610.23517): 논리적으로 연결된 예측시장 계약을 대규모로 복원해(예: "A 당선"과 "A의 득표율 50% 초과"는 연결되어 있죠), 가격이 무차익 영역(볼록 껍질) 밖에 있는 조합을 정수계획으로 찾아냅니다. 실제 호가장 깊이와 수수료까지 반영해 "실행 가능한" 수익만 측정한 점이 실용적입니다.
What Prediction-Market Contracts Reveal at Launch (2610.29578): Polymarket에서 해결된 시장 802,863건을 전수 조사해, 시장이 막 열릴 때의 제목·설명만으로 장차 거래량과 정산 분쟁 위험을 예측할 수 있는지 검증합니다. 새로운 시장의 '상장 심사' 정보에 대한 연구입니다.
월 전체 Big Picture
2026년 10월의 금융 AI 연구를 관통하는 메시지는 "의도와 실행의 격차를 측정하라"는 것입니다.
가짜 시장은 분포는 그럴듯한데 충격이 실제의 4~17배이고 회복이 없었습니다. AI가 작성한 트레이딩 코드는 명세를 완벽히 이해하고도 행동의 79%에서 이탈했고, 최고 모델도 네 건 중 하나는 조용히 틀렸습니다. 투자 목표를 보상 함수로 번역한 순간 AI는 "완벽하게" 다른 목표를 최적화했고, 그 인증을 받았다고 해서 수익이 좋아지지는 않았습니다. 원자재 파생상품에서는 안 보던 정보(캘린더 스프레드 옵션)를 넣는 것만으로 30%대의 가격 왜곡이 사라졌습니다. DeFi 금리 곡선에는 "더 넣으면 덜 번다"는, 수학으로 정확히 계산할 수 있는 덫이 숨어 있었습니다.
9월이 "더 정직해지는 것"이 화두였다면, 10월은 그 정직함을 측정 가능한 형태로 만드는 도구들이 등장한 달이었습니다. 다음 달에도 '더 좋은 예측'보다 '더 정확한 실행'의 연구가 이어질지 지켜보시죠.
더 알아보기
이 글에서 다룬 논문들의 arXiv 링크입니다:
- Depositing More Should Not Earn Less — S등급, 복합점수 81.8
- LOB-Impact Benchmark — S등급, 복합점수 80.9
- Combinatorial Arbitrage in Prediction Markets — A등급, 복합점수 78.3
- Certifying Reward Alignment in Portfolio RL — A등급, 복합점수 77.5
- Arithmetic Models for Commodity Futures and Options — A등급, 복합점수 77.2
- Market Impact Estimation via Causal Foundation Models — A등급, 복합점수 77.0
- Rachev-Ratio Portfolio Optimization with TimeGAN — A등급, 복합점수 76.5
- What Prediction-Market Contracts Reveal at Launch — A등급, 복합점수 76.0
- Arbitrage-Free IV Surface Reconstruction — A등급, 복합점수 75.8
- Speculative Imbalance Positions in Electricity Markets — A등급, 복합점수 75.4
참고하면 좋을 관련 연구: LOB-Impact 벤치마크가 쓰는 시장 시뮬레이터의 원형격인 JAX-LOB(2023), DeFi 유동성 인출을 예측한 Forecasting Liquidity Withdraw(2025) 등이 KB의 공유 엔티티로 연결되어 있습니다.
전체 S/A 논문 77편의 목록과 테마별 상세 분석은 백필 리포트 2610에서 확인할 수 있습니다.
📚 이 글에서 다룬 논문 (13편)
- SLOB-Impact Benchmark: Emergent Market Impact in Generative Limit Order Book Models
George Nigmatulin, Valentin Mohl, Sascha Frey 외 6명
- A
- ACertifying Reward Alignment in Portfolio Reinforcement Learning
Matin Tavakoli, Seyedreza Tavakoli, Faezeh Salmani 외 4명
- AArithmetic Models for Commodity Futures, Vanilla, and Calendar Spread Options
Malthe Rauh Johansen, Nina Lange, David Skovmand
- AMarket Impact Estimation via Causal Foundation Models
Dennis Thumm, Ying Chen
- AWhat Prediction-Market Contracts Reveal at Launch: Trading Volume and Dispute Risk
Ahmed Mahrous, Roberto Di Pietro
- AArbitrage-Free Implied Volatility Surface Reconstruction via Additive Martingales
Haochen Luo, Sifan Lin, Xiaolong Luo 외 3명
- AJAX-LOB: A GPU-Accelerated limit order book simulator to unlock large scale reinforcement learning for trading
Sascha Frey, Kang Li, Peer Nagy 외 5명
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2018-11 월간A
2018년 11월 금융 AI 논문: 800만 건의 주문이 밝힌 시장 충격의 법칙과 1/N 앞에 멈춘 포트폴리오 이론
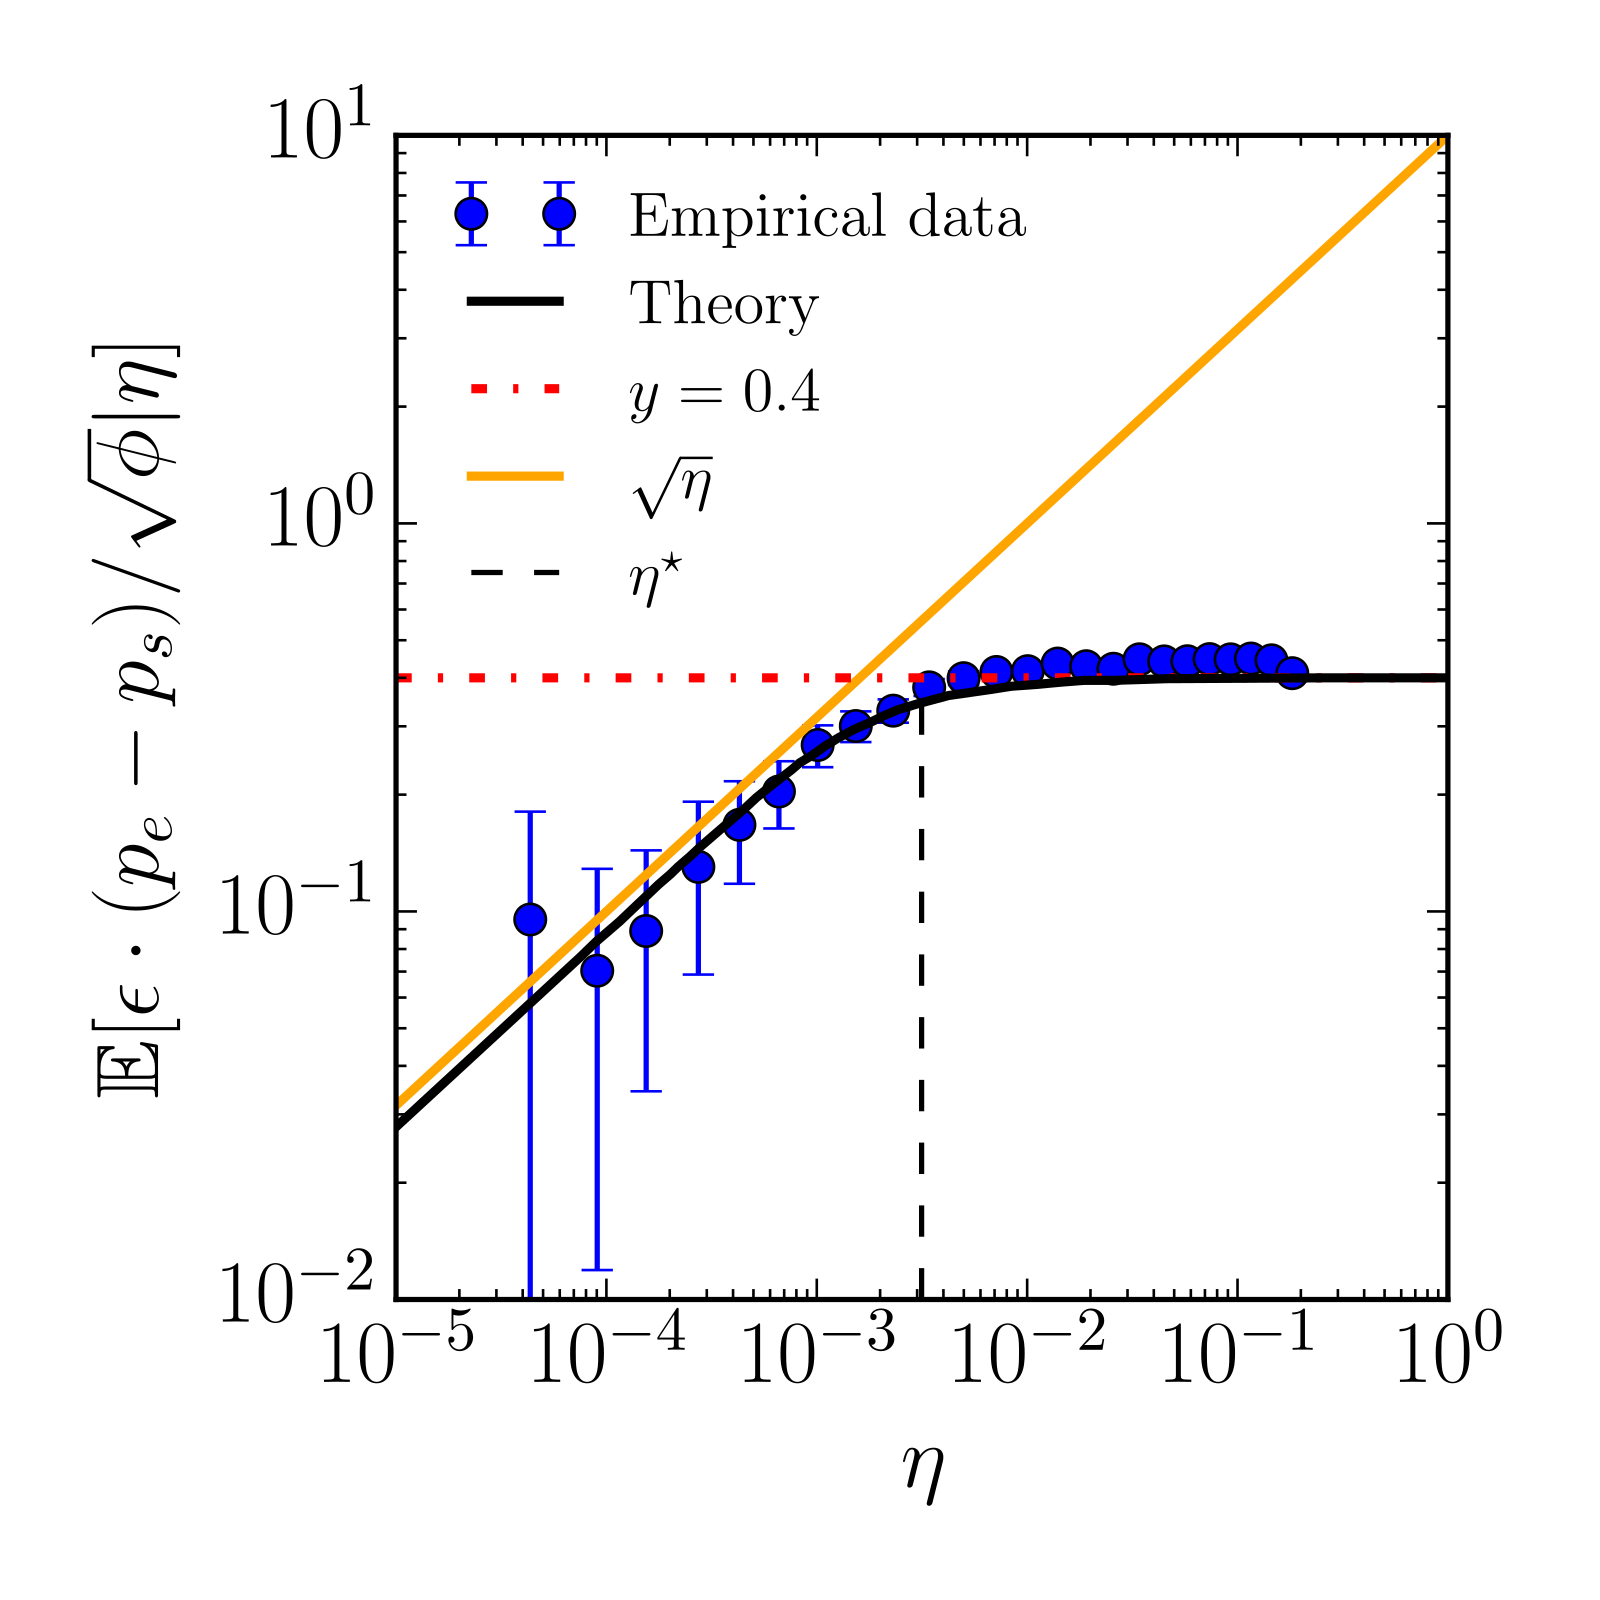
2018년 11월 arXiv 금융 AI 연구를 5개 테마로 정리했습니다. 800만 건 기관 주문으로 확인된 시장 충격의 제곱근 법칙, 유럽 옵션 가격에서 변동성과 점프를 동시에 추출하는 보정, 아무것도 1/N을 이기지 못한 포트폴리오 전략 실증, 텔레그램 펌프앤덤프 412건 해부까지 담았습니다.
 📊 2026-09 월간
2026년 9월의 금융 AI 연구: 측정이 통념을 뒤집고, 검증이 창의성을 압도하다
2026년 9월 arXiv에 공개된 금융 AI 연구를 5개 테마로 정리했습니다. 1년치 CME 실측 데이터로 HFT 설계 원칙을 뒤집은 S티어 논문, 수천 개 LLM 에이전트의 프로덕션 현실, anytime-valid 심판으로 팩터 거짓발견을 5~11배 줄이는 방법, 매직 스트라이크로 분산 계약을 정밀 산정하는 수학, drawdown을 강건하게 제어하는 포트폴리오 이론까지 — 측정과 검증이 창의성을 압도하는 달이었습니다.
 📊 2026-08 월간
2026년 8월의 금융 AI 연구: 이론과 실전의 간극이 좁혀지는 달
2026년 8월 arXiv에 공개된 금융 AI 연구를 4개 테마로 정리했습니다. 포트폴리오 최적화의 실전화, LLM 에이전트 벤치마크 전쟁, 변동성 표면의 수학적 통일, 뉴스 NLP의 시간 누수 감사 — 이론이 실제로 작동하는 도구로 변하는 순간을 포착했습니다.