대형 주문을 내면 가격이 밀리는 건 누구나 안다. 그런데 얼마나 밀릴까? — 800만 건의 실제 기관 주문이 말해 준 답은 "주문이 작을 때는 비례하고, 커지면 제곱근으로 자라다가 멈춘다"였다. 같은 달, 포트폴리오 이론의 화려한 전략 16개가 '1/N 그냥 나누기' 앞에서 무릎을 꿇었고, 옵션 가격만 보고 변동성과 점프를 함께 뽑아내는 수학이 나왔으며, 텔레그램에서 조직된 펌프앤덤프 412건이 첫 해부대에 올랐다. 2018년 11월의 금융 AI 연구, 다섯 이야기를 따라가 보자.
들어가으며: 2018년 늦가을, 수학과 데이터가 나란히 달리던 시기
시장에 큰 주문을 내는 사람의 고민은 단순하다. "내가 팔면 가격이 빠질 텐데, 그럼 나는 더 싼 값에 파는 셈이 되지 않을까?" 이 고민을 수학으로 옮기면 '시장 충격(market impact)'이라는 문제가 된다. 그런데 이 충격을 계산하는 데 쓰던 두 공식이 서로 달랐다 — 하나는 "주문이 두 배면 충격도 두 배"라는 단순한 선형 공식, 다른 하나는 "충격은 주문의 제곱근만큼만 자란다"는 실증 법칙. 둘 다 현장에서 쓰이던 참에, 어느 쪽이 맞는지 대규모 데이터로 판가름한 논문이 나왔다.
2018년 11월은 이런 "현실의 확인"이 여러 곳에서 동시에 일어난 달이다. 포트폴리오 이론의 복잡한 전략들이 진짜 돈 앞에서 얼마나 좋은지 냉정하게 재검증했고, 옵션 가격을 맞추는 수학은 한층 정교해졌으며, 비트코인 시장의 어두운 면(조작)이 처음으로 학술적으로 해부되었다. 이 달의 코호트는 arXiv에 게시된 113편 중 75편이 우리 기준을 통과했고, 그중 7편이 A등급을 받았다. 다섯 개의 이야기로 묶어 보았다.
테마 1: 포트폴리오 선택 — 이상적인 수학과 현실의 벽
왜 흥미로운가
요리로 치면 "최고의 레시피"를 찾는 문제다. 자산을 어떤 비율로 섞어야 가장 맛있게(수익은 크게, 위험은 작게) 먹을 수 있을까? 1950년대 마코위츠(Markowitz) 이후 70년 동안 수많은 레시피가 나왔지만, 결정적인 난관이 하나 있다 — 레시피가 '앞으로의 수익률'을 미리 알아야 계산되는데, 아무도 그걸 모른다. 2018년 11월의 이 테마는 바로 이 난관의 양쪽을 동시에 다룬다. 한쪽에서는 "추정이 틀려도 무너지지 않는" 수학을, 다른 한쪽에서는 "그렇게 만든 레시피가 실제로 1/N을 이기나?"라는 차가운 질문을 던진다.
대표 논문: 근사해도 안 무너지는 최적화의 수학
이 연구(1811.01420, 이달 전체 1위, 종합점수 70.0)는 Erhan Bayraktar, Yan Dolinsky, Jia Guo 세 명이 발표했다. 다루는 질문은 놀랍도록 기초적이다 — "모형을 대충 근사해도, 최적화의 답이 대충 근사되는가?"
실제 시장은 너무 복잡해서 그대로 계산할 수 없다. 그래서 우리는 격자나 시뮬레이션 같은 근사 모형을 쓴다. 문제는 근사로 바꾸면 최적 전략의 '가치'도 바뀐다는 것. 이 논문은 세 단계로 답한다.
- 조건을 최대한 넓게 증명한다. 자산가격 과정이 '분포상 수렴'(통계적 모습이 점점 닮아감)할 때, 효용 최적화 문제의 가치도 수렴하는 충분조건을 — 가능한 한 약한 조건으로 — 정립했다.
- 전략 자체의 수렴까지 다룬다. 가치뿐 아니라 최적 전략이 만들어 내는 최종 부(wealth)가 수렴한다는 결과도 함께 세웠다.
- 실제 계산에 붙인다. 유명한 변동성 모형(Heston)에서 '최소 기대손실(shortfall risk)'을 격자 근사로 계산하는 사례에 이 이론을 적용했다.
쉽게 말하면, "요리 대충 하면 맛이 어떻게 달라지는지"를 수학적으로 보장하는 문서를 만든 셈이다. 엄밀성 점수 87은 이 달 최고 수준이다. 다만 재현성 47 — 공개 코드가 없는 순수 이론 연구라, 실무에 쓰려면 직접 구현해야 한다.
다음 논문: '모르는 상태'에서 투자하는 법
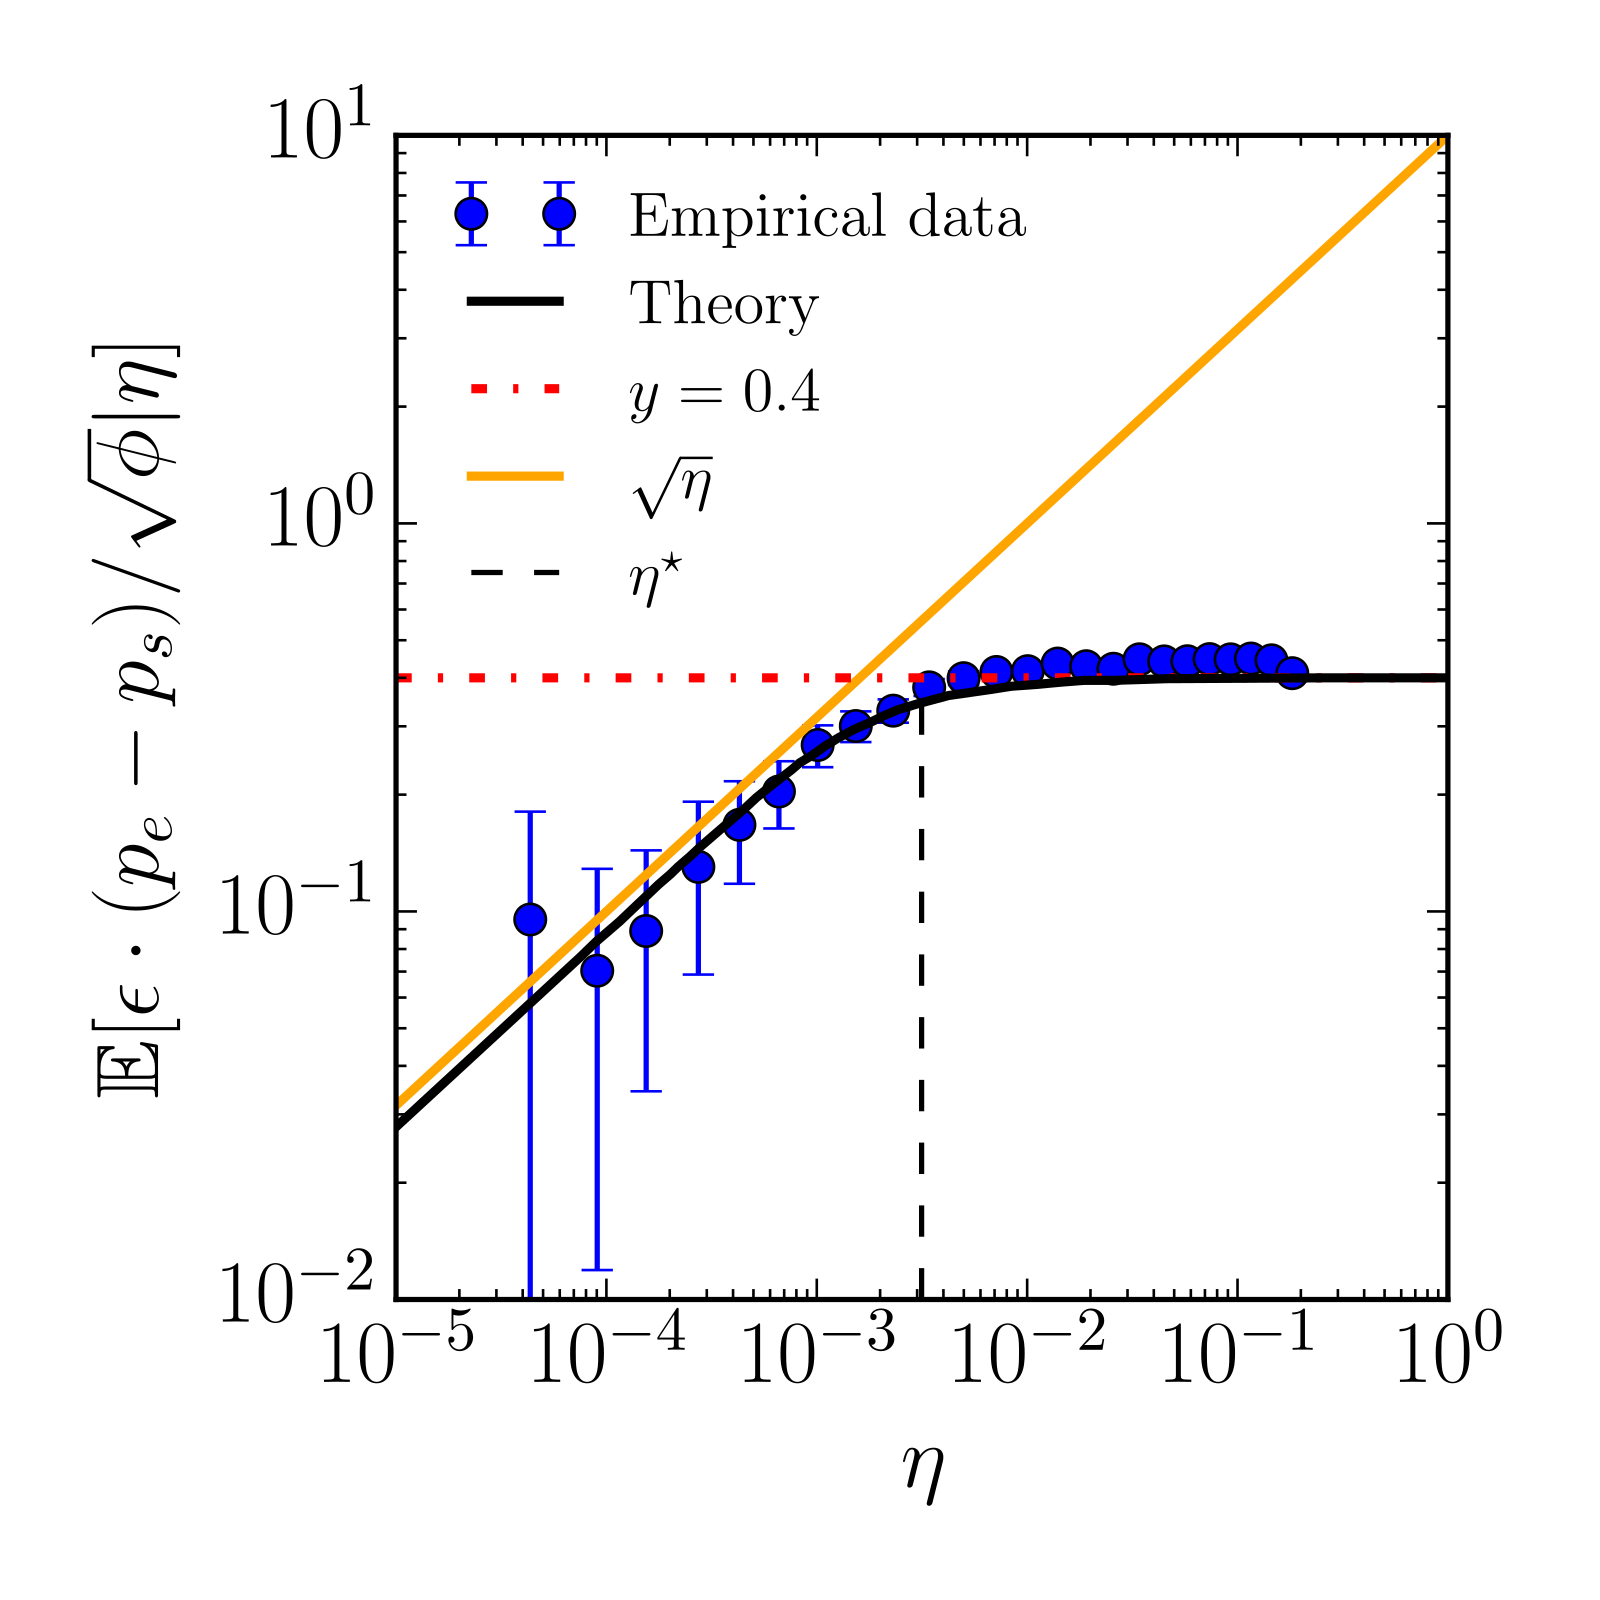
같은 테마의 A등급 논문 1811.06893(종합점수 69.7, 이달 2위)은 정반대 방향에서 같은 문제를 공략한다. 마코위츠 최적화는 "기대수익률을 안다"고 전제하는데, 이 연구는 그 전제 자체를 없애고, "나는 모른다"는 불확실성을 확률로 표현한 뒤 시장 데이터를 보며 조금씩 배워 나간다(베이지안 필터링). 그리고 결정적인 질문에 값을 매긴다 — "배우며 투자하는 것"이 "모르고 고정된 수익률로 투자하는 것"보다 얼마나 나은가? 저자들은 이 '정보의 가치'를 정량적으로 측정하고, 어떤 상황에서 학습이 더 중요한지를 보여 준다. 추정이 틀릴 수 있다는 사실을 전략 안에 넣으면 얼마나 나아지는지, 값으로 확인한 것이다.
여기에 실전의 찬물을 끼얹는 논문(1811.08255)이 있다. 2009년의 유명한 연구 이후 제안된 분산화 전략 16개를 6개 실증 데이터셋에서 재검증했는데, 결론은 "아무것도 1/N(무지성 균등 분산)이나 최소분산 전략을 샤프 비율·확정등가수익·회전율에서 일관되게 이기지 못한다"다. 원인은 앞의 논문들이 지적한 바로 그 문제 — 기대수익률 추정 오차가 너무 크다. 정교한 레시피가 '아무 재료나 반씩 넣기'를 못 이기는 현실. 이 테마의 논문들이 함께 말하는 것은 이것이다: 최적화 이론의 진짜 적은 계산이 아니라 추정 오차다. 추정 오차를 전제로 한 강건한 접근(예: 1811.00304의 신경망 기반 강건 리스크 집계)이 이론과 실전을 잇는 다리다.
테마 2: 시장 충격과 유동성 — "얼마나 크게 움직이면 가격이 얼마나 튀는가"
왜 흥미로운가
큰 주문은 시장을 움직인다. 수조 원을 굴리는 펀드가 주식을 팔면, 자기 물량 때문에 가격이 밀려 더 싼 값에 팔게 된다 — 마치 큰 배가 지나가면 주변 물결이 요동치는 것과 같다. 그래서 큰 손들은 주문을 쪼개서 천천히 내놓는데, 여기서 핵심 질문이 나온다. "쪼갠 조각이 커지면 충격은 얼마나 커지는가?" 오랫동안 두 답이 공존했다 — "크기에 비례한다"(선형)와 "제곱근만큼만 자란다"(제곱근 법칙). 2018년 11월, 800만 건의 실제 기관 주문 데이터가 이 논쟁에 종지부를 찍었다.
대표 논문: 선형에서 제곱근으로, 전환점을 찾아내다
이 연구(1811.05230, 종합점수 68.9, 이달 3위)는 Frédéric Bucci, Michael Benzaquen, Fabrizio Lillo, Jean-Philippe Bouchaud가 발표했다. 앞서 본 그 질문에, 미국 주식 시장에서 실행된 800만 건의 기관 주문으로 답한다.
핵심 발견은 하나의 곡선이다.
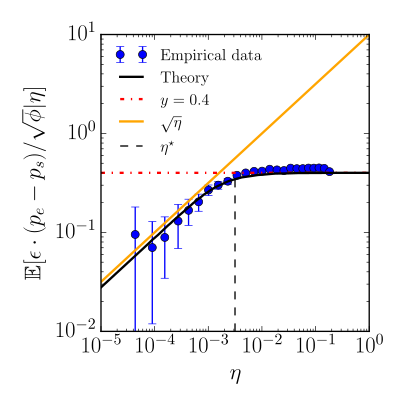
이 그림의 가로축은 '참여율' — 내 주문이 그날 시장 거래량에서 차지하는 비율이다. 세로축은 충격의 크기다. 정확히 읽어 보면 이렇다.
- 주문이 작을 때(참여율이 낮을 때): 충격은 참여율의 제곱근으로 자란다. 주문을 두 배로 키워도 충격은 두 배가 아니라 약 1.4배 — 그래서 작은 조각으로 쪼개면 효율이 좋다.
- 주문이 커지면(참여율이 높아지면): 충격은 더 이상 자라지 않고 대략 0.4 수준에서 포화한다. 아무리 밀어붙여도 충격이 무한히 커지지는 않는다는 뜻이다.
- 선형은 어디에도 없다. 적어도 이 데이터에서는 "크기에 비례한다"는 공식이 성립하는 영역이 없었다.
저자들은 여기서 멈추지 않고, 유동성의 동역학을 설명하는 최근의 이론이 예측한 곡선과 실제 데이터를 대조했다 — 놀랍도록 잘 들어맞았다. 그 이론의 핵심 가정은 "유동성에는 빠른 성분과 느린 성분이 최소 두 가지 있다"는 것. 거래가 빨리 끝나는 주문과 오래 끄는 주문을 나눠 보면 전환점이 달라지는 것도 이 예측과 일치했다.
한계와 조심할 점
- 이 데이터는 미국 주식 시장의 기관 주문 기준이다. 소매 주문이나 다른 시장에도 그대로 적용하기는 검증이 더 필요하다.
- 충격 곡선의 '정확한 위치'는 시장과 시기, 주문 유형에 따라 달라진다 — 곡선의 형태를 얻었지 만능 상수표를 얻은 것은 아니다.
- 재현성 점수 38. 기관 주문 데이터는 비공개 상업 데이터셋이라 외부에서 같은 실험을 반복하기 어렵다.
다음 논문: 주식은 혼자 움직이지 않는다
같은 테마의 A등급 논문 1811.05524(종합점수 68.2)는 시선을 '종목 하나'에서 '포트폴리오 전체'로 옮긴다. S&P500 종목들의 일중 거래량을 보면, 예상과 다른 '거래량 서프라이즈'가 종목 사이에서 서로 상관되고, 그 상관이 장중 마지막 몇 시간에 특히 강해진다 — ETF와 패시브 투자의 성장으로 '묶음 거래'가 늘었기 때문이다. 저자들은 이를 반영해 종목들이 서로에게 미치는 '교차충격'을 모델링하고, 놀라운 결론을 내놓는다 — 대형 포트폴리오를 청산할 때 종목별로 따로 VWAP(거래량 가중 평균가)를 맞추는 게 아니라, 종목들을 묶어 함께 집행하는 스케줄이 오히려 싸다. 하루 뒤에 몰리는 포트폴리오 유동성을 함께 활용하기 위해서다. 그럴듯한 모수를 가정한 최악 분석에서 비용 절감은 최대 6%까지. "주문을 쪼갠다"는 전략이, 800만 건의 곡선과 만나면 "어떻게 묶고, 언제 몰릴 것인가"의 문제로 바뀐다는 점이 이 두 논문의 공통 인사이트다.
같은 달 1811.03766은 미국·영국·일본·홍콩의 300개가 넘는 종목, 5년치 데이터로 유동성 변수(거래량, 스프레드, 변동성, 호가창 잔량)가 스스로 자기상관을 갖는다는 사실을 문서화했다. 유명한 최적 거래 프레임들이 흔히 가정하는 '독립 동일 분포'가 실제 데이터에서 깨진다는 실증 반론이다.
테마 3: 변동성과 점프의 정밀 계량 — 맞추고, 검출하고, 판단하고
왜 흥미로운가
옵션 가격을 계산하려면 '앞으로 가격이 얼마나 흔들릴지'(변동성)를 알아야 한다. 그런데 실제 가격은 매끈하게 흔들리지 않고 갑자기 뛰기도 한다(점프) — 발표, 사고, 청산 같은 사건들. 변동성만 맞추면 점프가 변동성에 숨어 모형이 왜곡되고, 점프만 잡으면 변동성이 어긋난다. 2018년 11월의 이 테마는 "두 마리를 동시에 잡는" 수학부터, 모형 자체의 수학적 정합성을 따지는 연구, 점프 검출의 정밀도를 높이는 계량까지 — 파생상품 데스크의 일상 고민을 정면으로 다룬다.
대표 논문: 옵션 가격만 보고 변동성과 점프를 동시에 뽑아내기
이 연구(1811.02028, 종합점수 68.8, 이달 4위)는 Vinicius Albani와 Jorge Zubelli가 발표했다. 시장에 나와 있는 유럽 옵션의 호가 가격만 가지고, 두 가지를 동시에 추정한다 — 가격대·시점별로 변하는 국소변동성 표면, 그리고 점프 크기의 분포.
방식은 '문제를 쪼개고, 안정시키고, 증명한다'는 세 단계다.
- 분할(splitting) 전략. 점프-확산 모형의 옵션 가격을 계산하는 방정식(Dupire형 부분적분-미분방정식)으로 "모수 → 가격"의 대응 관계를 만든 뒤, 변동성과 점프 분포를 서로 교대로 추정한다.
- 정규화로 안정화. 두 개의 큰 자유도를 관측 가격만으로 추정하는 문제는 '잘 정의되지 않은 역문제(ill-posed)'라, 아무렇게 풀면 답이 날아간다. Tikhonov형 볼록 정규화로 수치적 안정성을 확보했다.
- 이론 붙이기. 알고리즘의 수렴과 안정성을 증명했다 — 직관에 의존한 휴리스틱이 아니라 이론이 뒷받침된 절차다.
합성 데이터와 실제 데이터(DAX 옵션) 모두에서 방법이 견고하게 작동함을 확인했다. 시사점은 단순하다 — "변동성만 맞추면 점프가 변동성에 흡수되어 모형이 왜곡된다. 보정 대상을 어떻게 나누느냐가 모형 품질을 결정한다." 재현성 48로 공개 코드는 없지만, 구현 절차가 자세히 기술되어 있다.
다음 논문: '거친 변동성' 모형의 숨은 전제를 검사하다
같은 달의 A등급 논문 1811.10935(종합점수 66.2)은 파생 실무에서 인기 있던 '거친 변동성(rough volatility)' 모형, 그중 rough Bergomi의 내부 정합성을 검사한다. 아무리 시장 가격을 잘 맞추는 모형도, 내부에 모순이 있으면 가격결정 자체가 성립하지 않는다. 저자 Paul Gassiat는 증명한다 — 주식 가격이 진정한 마르팅게일(가격결정이 논리적으로 성립)이 되려면, 주식과 변동성을 구동하는 충격의 상관(ρ)이 0 이하여야 한다. ρ가 양수면 모형 내부에서 가격의 기대가 어긋난다. 게다가 ρ < 0일 때 모멘트가 무한히 커지는 경계(m > 1/(1-ρ²))까지 명시해, 이 모형이 만드는 꼬리 위험의 크기를 정확히 표시했다. 엄밀성 86의 이론 연구지만 실무 함의는 명확하다 — rough 변동성 모형의 상관은 그냥 손으로 돌리는 손잡이가 아니라, 가격결정의 성립 조건이다.
한편 1811.07499는 "점프인지 아닌지"를 판정하는 임계값을, 오분류의 기대 횟수를 최소화하는 방향으로 수학적으로 최적화했다 — 점프 검출의 정밀도를 계량 문제로 푼 것이다. 이 테마의 논문들은 함께 말한다: 파생 모형의 디테일(점프의 분해, 상관의 부호, 임계값의 선택) 하나하나가 가격과 리스크에 직결한다.
테마 4: 신호와 실행 — "언제, 얼마나 빨리"의 과학
왜 흥미로운가
"무엇을 살지" 정해졌다면, 이제 남은 문제는 "어떻게 사고 팔지"다. 트레이딩 알고리즘은 흔히 신호(signal)를 쓴다 — "호가창의 매수/매도 잔량 비율이 7 대 3을 넘으면 매수 속도를 올려라" 같은 규칙. 그런데 신호에는 잡음이 있고, 임계값을 넘나들면서 보유량(재고)이 예상 밖으로 흔들린다. 그 흔들림이 곧 돈이다. 2018년 11월의 이 테마는 "신호를 실행으로 옮기는 과정"의 불확실성을 수학으로 다룬다.
대표 논문: 신호의 임계값이 만드는 불확실성, 처음으로 계산하다
이 연구(1811.03718, 종합점수 65.0, 이달 7위)는 Hadrien De March와 Charles-Albert Lehalle이 발표했다. 다루는 문제는 놀랍도록 실무적이다 — "신호에 임계값을 걸어 제어할 때, 내 재고가 얼마나 흔들릴 수 있는가?" 이 불확실성을 설계 단계에서 계산할 수 있는 수학이 거의 없었고, 이 논문이 처음으로 정면 공략한다.
세 가지 발상이 있다.
- IAB 정리(Inventory Asymptotic Behaviour). 오래된 확률과정 이론(Benveniste-Priouret 정리)을 빌려, 시간 연속으로 이상화한 트레이딩에서 어느 시점에서든 재고의 전체 분포를 주는 정리를 유도했다. 평균이 아니라 분포 전체다 — "재고가 100주를 넘을 확률" 같은 질문이 바로 답해진다.
- 근사안 비교. 이 제어 문제에는 닫힌 해가 없다. 그래서 여러 근사 방식을 제시하고 실제로 성능을 비교한다.
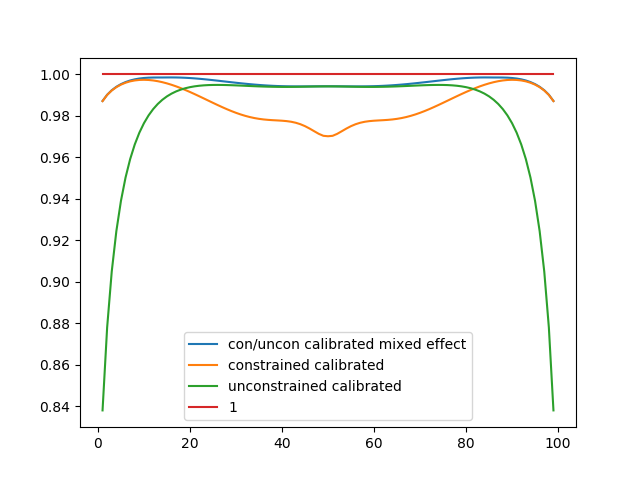
- 사후 적용. 결정적으로, 이 정리는 신호의 불확실성을 제어하지 않더라도 기존 트레이딩 알고리즘에 그대로 적용할 수 있다 — 알고리즘을 바꾸지 않고 진단만 얹는 셈이라 도입 장벽이 낮다. 저자들은 실제 호가창 불균형 신호(General Electric 1억 건, HSBC 5억 9천만 건 관측)를 예시로 근사 방식들의 성능을 비교했다.
다음 논문: 정적으로 짜인 계획 vs 그때그때 바꾸는 전략
1811.11265(종합점수 60.4)는 더 근본적인 비교를 한다 — 단기 가격 예측 신호를 보며 거래할 때, 처음에 짜 둔 고정 계획(static)과 신호를 보며 갱신하는 적응형(adaptive) 전략 중 어느 쪽이 싼가? 답은 분명하다. 순간 시장충격에서는 적응형 전략의 거래비용이 크게 낮고, 일시적 충격 환경에서는 신호를 유한 번만 관찰하는 것만으로도 정적 최적 전략의 비용이 극적으로 줄어든다. "계획대로 하라"는 실행 데스크의 격언에, "신호가 있다면 계획을 계속 고쳐라"는 조건이 붙는 셈이다.
한편 1811.09312(종합점수 63.9)은 데이터의 질 문제를 다룬다. 고빈도 데이터에는 미시구조 노이즈(호가의 미세한 오염)가 끼어 있어, 평균회귀(Ornstein-Uhlenbeck) 과정의 파라미터를 추정하면 크게 틀어진다. 저자들은 이 노이즈에 강건한 최대우도 추정기를 제안하고, 7대 오일 기업의 일중 페어 트레이딩에서 노이즈를 고려한 추정이 수익성을 높인다를 실증했다. 이 테마의 공통 인사이트 — "신호가 좋다고 끝이 아니다. 신호를 어떻게 제어로 바꾸고, 어떤 데이터로 추정하느냐가 실적을 가른다."
테마 5: 새로운 자산, 새로운 데이터 — 크립토와 텍스트의 진입
왜 흥미로운가
2018년 11월, 비트코인은 한 해 전 고점의 약 5분의 1 수준으로 떨어진 뒤였다. 시장은 폭락했지만 연구는 반대로 폭발했다 — "이 새로운 시장은 도대체 어떻게 굴러가는가?"라는 질문과 함께. 같은 달, 주식에서 검증된 '팩터 모형'을 암호화폐에 이식하려는 시도와, 텔레그램에서 조직된 시세 조종 412건을 첫 해부한 실증이 나왔다. 한편으로는 연례보고서의 글과 소셜 미디어의 말투를 금융 예측에 붙이는 실험도 본격화된다 — 숫자 밖의 정보와, 제도 밖의 시장이 동시에 연구 대상이 된 달이다.
대표 논문: 암호화폐에도 '팩터'가 있을까
이 연구(1811.07860, 종합점수 63.8, 이 테마 1위)는 Zura Kakushadze가 발표했다. 주식 투자에서 '팩터 모형'이란 수천 개 종목의 수익률을 몇 개의 공통 요인(시장 전체의 움직임, 규모, 가치 등)으로 분해하는 접근이다. 이 논문은 그 틀을 암호화폐의 일일 수익률 횡단면에 그대로 적용한다.
- 거래소 데이터가 있는 모든 암호화폐·디지털 자산(코인과 토큰)을 포괄해, 일일 수익률의 횡단면 팩터 모형을 제안한다.
- 데이터 다운로드, 리스크 팩터 계산, 아웃오브샘플 백테스트까지 소스 코드를 공개했다 — 재현성 점수 75는 이 달 전체에서 손꼽히는 수준이다(이론 논문들이 보통 40~50대인 것과 대조적).
- 실증으로 일일 수익률에 강하게 기여하는 '지배적 팩터'를 식별했다.
결론은 조건부다 — "효율적 실행과 공매도(shorting)가 가능하다면", 암호화폐의 횡단면 통계차익거래가 가능할 수 있다. 이 조건이 빠지면 안 된다. 2018년 당시 다수 거래소는 공매도·대차가 제한적이었고 체결 품질도 들쭉날쭉했다. 새 시장에 레시피를 옮길 때는 레시피와 함께 주방(인프라)도 봐야 한다는 교훈이다.
다음 논문: 펌프앤덤프 412건의 해부
같은 달의 1811.10109(종합점수 61.8)는 이 '새 시장'의 어두운 면을 첫 상세 실증으로 기록했다. 펌프앤덤프란, 값싼 코인을 미리 사두고 가격을 끌어올린(펌프) 뒤 남에게 팔아치우는(덤프) 고전적 조작이다. 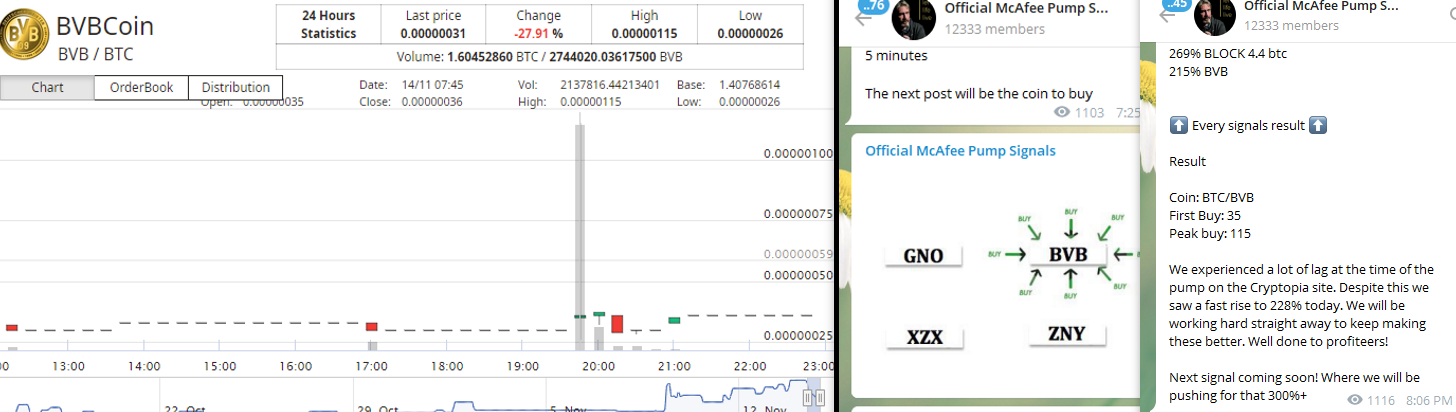
텔레그램 채널에서 조직된 2018년 6월 17일부터 2019년 2월 26일까지의 412건을 조사한 저자들은, 조작의 패턴이 학습 가능함을 보이고 펌프가 일어나기 전에 가능성을 예측하는 모형을 만들었다. 모형은 높은 정밀도와 강건성을 보였고, 이를 활용한 단순한 전략이 소액 소매투자에서 2개월 반 만에 최대 60% 수익을 냄을 실증했다(저자들은 이를 전략적 크립토 트레이딩의 개념 증명이자, 기계학습 기반 범죄 탐지의 응용 사례로 제시한다).
이 연구의 진짜 가치는 수익률이 아니라 "조작은 반복되고, 반복은 예측된다"는 사실의 확인이다. 한계도 정직하게 — 텔레그램 데이터 수집의 재현이 어렵고(재현성 43), 특정 시기·채널 표본에 의존하며, "60% 수익"의 계산에 실제 거래비용과 유동성 한계가 얼마나 반영되었는지는 별도의 검증이 필요하다. 윤리적으로도 이 모형의 목적은 조작의 참여가 아니라 탐지와 회피여야 한다.
같은 테마의 다른 실험들도 흥미롭다. 1811.05270은 연례보고서 안의 글(감사보고서와 경영진 진술)을 합성곱-순환 신경망으로 읽어 부도를 예측했는데, 숫자만 쓰는 모형보다 통계적으로 유의하게 나았고 특히 대기업에서 효과가 컸다. 흥미로운 세부 결과 — 감사보고서가 경영진 진술보다 정보가 많고, 둘을 합쳐도 감사보고서 단독보다 나아지지 않았다. 1811.10195는 소셜 미디어가 변동성 예측에 유익한 조건을 군집화로 찾아냈다 — 강세 감성이 약세를 압도할 때, 메시지 수가 적어도 소셜 신호가 변동성에 유익했다(NYSE·NASDAQ 500개 종목에서 확인). 이 테마의 논문들이 함께 말하는 것: 새 데이터는 기존 숫자 변수를 대체하지 않고 보완하며, 새 시장은 기존 이론의 가정을 시험대에 올린다.
월 전체 Big Picture
2018년 11월의 다섯 이야기는 하나의 문장으로 모인다 — "정밀함과 정직함: 이론은 더 깊게, 실증은 더 냉정하게, 데이터는 더 넓게." 시장 충격의 곡선은 800만 건의 데이터 앞에서 선형 법칙을 폐기하고 제곱근-포화의 형태로 확정되었으며(테마 2), 포트폴리오 이론의 화려한 전략들은 1/N 앞에서 겸손해졌다(테마 1). 옵션 보정은 변동성과 점프를 동시에 잡는 단계로 나아갔고(테마 3), 매매 실행의 불확실성은 처음으로 계산 가능한 형태가 되었다(테마 4). 그리고 새로운 시장과 새로운 데이터가 연구의 무대에 올랐다(테마 5).
이 달이 특별한 이유는 양쪽이 나란히 서 있기 때문이다. 한쪽에서는 rough Bergomi 모형의 마르팅게일 성질처럼 모형의 수학적 정합성을 끝까지 따지는 연구가, 다른 한쪽에서는 펌프앤덤프 412건처럼 새로운 시장의 현실을 그대로 해부하는 실증이 동시에 진행되었다. 2018년 말, 비트코인이 급락하던 시기에 나온 이 논문들은 우리에게 이렇게 말하는 듯하다 — 투자의 기본기는 화려한 예측이 아니라, 충격의 곡선을 알고, 추정의 오차를 겸손하게 다루며, 계획을 데이터 앞에서 고칠 줄 아는 태도라고.
더 알아보기
원문 링크와 5차원 평가 점수
이 글에서 다룬 논문들의 원문과, 우리 지식 베이스가 매긴 5차원 점수입니다(신규성 / 적용성 / 엄밀성 / 재현성 / 통찰, 종합점수는 이들의 가중 합).
| 논문 | 티어 | 종합 | 신규성 | 적용성 | 엄밀성 | 재현성 | 통찰 |
|---|---|---|---|---|---|---|---|
| 1811.01420 효용 최적화의 연속성 | A | 70.0 | 74 | 63 | 87 | 47 | 72 |
| 1811.06893 베이지안 마코위츠 학습 | A | 69.7 | 74 | 70 | 84 | 43 | 68 |
| 1811.05230 시장 충격의 제곱근 법칙 | A | 68.9 | 70 | 82 | 79 | 38 | 83 |
| 1811.02028 점프-확산 모형 보정 | A | 68.8 | 72 | 65 | 82 | 48 | 70 |
| 1811.05524 일중 유동성과 교차충격 | A | 68.2 | 74 | 80 | 72 | 43 | 77 |
| 1811.10935 rough Bergomi의 마르팅게일 성질 | A | 66.2 | 72 | 48 | 86 | 45 | 76 |
| 1811.03718 신호 기반 최적 매매 | A | 65.0 | 74 | 76 | 69 | 39 | 73 |
| 1811.09312 노이즈 강건 OU 추정 | B | 63.9 | 66 | 74 | 66 | 40 | 65 |
| 1811.07860 암호화폐 팩터 모형 | B | 63.8 | 62 | 68 | 53 | 75 | 65 |
| 1811.08255 분산화 전략 재검증 | B | 63.1 | 42 | 76 | 68 | 43 | 72 |
| 1811.07499 점프 검출의 최적 임계값 | B | 63.1 | 68 | 56 | 78 | 43 | 65 |
| 1811.10109 크립토 펌프앤덤프 해부 | B | 61.8 | 72 | 67 | 58 | 43 | 76 |
| 1811.07792 합성 시계열 현실성 평가 | B | 61.9 | 70 | 60 | 62 | 38 | 72 |
| 1811.10195 소셜 감성과 변동성 | B | 60.4 | 63 | 57 | 48 | 72 | 62 |
| 1811.11265 정적 vs 적응형 최적 실행 | B | 60.4 | 61 | 69 | 67 | 42 | 67 |
| 1811.00304 신경망 강건 리스크 집계 | B | 59.8 | 72 | 62 | 55 | 30 | 76 |
| 1811.06766 기술적 분석과 오탐률 통제 | B | 59.7 | 65 | 68 | 66 | 42 | 61 |
| 1811.05270 연례보고서 텍스트 부도 예측 | B | 59.6 | 65 | 72 | 55 | 30 | 63 |
| 1811.03766 일중 유동성의 내생 동학 | B | 59.3 | 64 | 68 | 65 | 35 | 72 |
| 1811.00200 온라인 학습 통계차익거래 | B | 58.4 | 68 | 62 | 58 | 28 | 70 |
우리 지식 베이스에서 함께 읽을 논문
- 시장 충격·실행 계열: Optimal execution with deterministically time varying liquidity, When is cross impact relevant?, Slow decay of impact in equity markets, Deep Hedging with Market Impact
- 파생 보정·변동성 계열: Calibration of Local Volatility Models with Stochastic Interest Rates, Detecting and repairing arbitrage in traded option prices, Fast reliable pricing and calibration of the rough Heston model
- 포트폴리오·효용 최적화 계열: Robust utility maximization with nonlinear continuous semimartingales, Optimal Portfolio Using Factor Graphical Lasso, Uncertainty-Aware Lookahead Factor Models for Quantitative Investing
- 알고리즘 트레이딩 계열: Informed trading, limit order book and implementation shortfall, Taking Over the Stock Market: Adversarial Perturbations Against Algorithmic Traders
이 글은 2018년 11월 arXiv 백필 코호트(전체 113편, 관련 75편)의 평가 결과를 바탕으로 작성했습니다. 모든 수치는 원문 논문에서 인용했으며, 블로그 성격상 일부 이론적 세부사항은 생략했습니다. 심층 분석은
analysis/reports/backfill/1811.md를 참고하세요.
📚 이 글에서 다룬 논문 (32편)
- AContinuity of Utility Maximization under Weak Convergence
Erhan Bayraktar, Yan Dolinsky, Jia Guo
- ABayesian learning for the Markowitz portfolio selection problem
Carmine De Franco, Johann Nicolle, Huyên Pham
- ACrossover from linear to square-Root market impact
Frédéric Bucci, Michael Benzaquen, Fabrizio Lillo 외 1명
- AA Splitting Strategy for the Calibration of Jump-Diffusion Models
Vinicius Albani, Jorge Zubelli
- ACross-Sectional Variation of Intraday Liquidity, Cross-Impact, and their Effect on Portfolio Execution
Seungki Min, Costis Maglaras, Ciamac C. Moallemi
- A
- BRobust risk aggregation with neural networks
Stephan Eckstein, Michael Kupper, Mathias Pohl
- BEndogeneous Dynamics of Intraday Liquidity
Mikołaj Bińkowski, Charles-Albert Lehalle
- BOptimal Iterative Threshold-Kernel Estimation of Jump Diffusion Processes
José E. Figueroa-López, Cheng Li, Jeffrey Nisen
- BStatic vs Adaptive Strategies for Optimal Execution with Signals
Claudio Bellani, Damiano Brigo, Alex Done 외 1명
- B
- BThe Anatomy of a Cryptocurrency Pump-and-Dump Scheme
Jiahua Xu, Benjamin Livshits
- BPredicting Distresses using Deep Learning of Text Segments in Annual Reports
Rastin Matin, Casper Hansen, Christian Hansen 외 1명
- BBull Bear Balance: A Cluster Analysis of Socially Informed Financial Volatility
Jonathan Manfield, Derek Lukacsko, Thársis T. P. Souza
- BTechnical Analysis and Discrete False Discovery Rate: Evidence from MSCI Indices
Georgios Sermpinis, Arman Hassanniakalager, Charalampos Stasinakis 외 1명
- BThe ETS challenges: a machine learning approach to the evaluation of simulated financial time series for improving generation processes
Javier Franco-Pedroso, Joaquin Gonzalez-Rodriguez, Maria Planas 외 3명
- AOptimal execution with deterministically time varying liquidity: well posedness and price manipulation
Gianluca Palmari, Fabrizio Lillo, Zoltan Eisler
- AWhen is cross impact relevant?
Victor Le Coz, Iacopo Mastromatteo, Damien Challet 외 1명
- ASlow decay of impact in equity markets: insights from the ANcerno database
Frédéric Bucci, Michael Benzaquen, Fabrizio Lillo 외 1명
- ADeep Hedging with Market Impact
Andrei Neagu, Frédéric Godin, Clarence Simard 외 1명
- BCalibration of Local Volatility Models with Stochastic Interest Rates using Optimal Transport
Benjamin Joseph, Gregoire Loeper, Jan Obloj
- ADetecting and repairing arbitrage in traded option prices
Samuel N. Cohen, Christoph Reisinger, Sheng Wang
- AFast reliable pricing and calibration of the rough Heston model
Svetlana Boyarchenko, Marco de Innocentis, Sergei Levendorskiĭ
- ARobust utility maximization with nonlinear continuous semimartingales
David Criens, Lars Niemann
- AOptimal Portfolio Using Factor Graphical Lasso
Tae-Hwy Lee, Ekaterina Seregina
- AUncertainty-Aware Lookahead Factor Models for Quantitative Investing
Lakshay Chauhan, John Alberg, Zachary C. Lipton
- ATaking Over the Stock Market: Adversarial Perturbations Against Algorithmic Traders
Elior Nehemya, Yael Mathov, Asaf Shabtai 외 1명
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2022-04 월간
2022년 4월의 AI 금융 연구: 통계적 함정을 피하고, 실행을 최적화하고, 암호자산의 비밀을 풀다
2022년 4월 arXiv에 공개된 AI 금융 연구 중 가장 주목할 만한 논문들을 살펴봅니다. 팩터 투자의 통계적 함정, 딥러닝 기반 최적 실행, 암호화폐 펌프앤덤프 탐지, 웨이블릿을 이용한 변동성 분석, 그리고 NMF 기반 포트폴리오 최적화까지.
 📊 2026-09 월간
2026년 9월의 금융 AI 연구: 측정이 통념을 뒤집고, 검증이 창의성을 압도하다
2026년 9월 arXiv에 공개된 금융 AI 연구를 5개 테마로 정리했습니다. 1년치 CME 실측 데이터로 HFT 설계 원칙을 뒤집은 S티어 논문, 수천 개 LLM 에이전트의 프로덕션 현실, anytime-valid 심판으로 팩터 거짓발견을 5~11배 줄이는 방법, 매직 스트라이크로 분산 계약을 정밀 산정하는 수학, drawdown을 강건하게 제어하는 포트폴리오 이론까지 — 측정과 검증이 창의성을 압도하는 달이었습니다.
 📊 2026-08 월간
2026년 8월의 금융 AI 연구: 이론과 실전의 간극이 좁혀지는 달
2026년 8월 arXiv에 공개된 금융 AI 연구를 4개 테마로 정리했습니다. 포트폴리오 최적화의 실전화, LLM 에이전트 벤치마크 전쟁, 변동성 표면의 수학적 통일, 뉴스 NLP의 시간 누수 감사 — 이론이 실제로 작동하는 도구로 변하는 순간을 포착했습니다.