시장의 변동성은 마치 날씨와 닮았다. 멀리서 보면 평온해 보여도, 자세히 들여다보면 작은 소용돌이가 끊임없이 이어진다. 2018년 10월의 금융 연구자들은 이 "소용돌이의 거칠기"를 수학으로 정확히 묘사하는 데는 성공했지만, 정작 그 모형은 너무 느려서 실무에서 쓰기 어려웠다. 이 달의 대표 논문은 그 정확함을 20배 빠른 계산으로 되돌려 받는 묘기를 부린다. 같은 달, 헤지펀드 연구진은 "같은 투자 아이디어라도 어떻게 담느냐에 따라 수익률이 3배 넘게 벌어진다"는 냉정한 보고서를 냈고, 마켓메이커의 호가를 공식 하나로 쓸 수 있게 만든 수학, 그리고 아직 이름이 알려지지 않았던 딥러닝이 주식 호가창을 읽기 시작한 기록이 함께 쌓였다. 2018년 10월의 다섯 이야기를 따라가 보자.
들어가며: "정확한 모형"을 "계산 가능한 모형"으로 바꾸던 가을
2018년 10월은 금융 공학에서 조용하지만 중요한 전환점이었다. 2년 전쯤 시작된 이른바 "거친 변동성(rough volatility)" 혁명은 "변동성의 움직임은 우리가 알던 것보다 훨씬 거칠다"는 사실을 밝혀 옵션 가격 모형의 판도를 바꿨다. 그런데 문제는 하나 있었다 — 정확해진 만큼 계산이 느려졌다는 것. 이 달의 연구들은 이 계산 비용을 아이디어로 되갚는 방법을 내놓는다. 한편에서는 포트폴리오를 "어떻게 담는가"라는 지루해 보이는 공정이 실제 수익을 좌우한다는 장기 실증이 나왔고, 다른 한편에서는 시장의 "진짜 가격"을 통계로 추정하는 문제, 잡음 섞인 고빈도 자료에서 변동성을 추정하는 문제, 그리고 이제 막 금융에 발을 들인 딥러닝의 과제들이 각자의 자리를 다지고 있었다.
테마 1: 파생 가격결정 — 완벽한 모형을 '계산 가능한' 모형으로
왜 흥미로운가
옵션(특정 시점에 특정 가격으로 살 수 있는 권리)의 가격은 "앞으로 시장이 얼마나 흔들릴 것인가"라는 예측에 달려 있다. 그런데 실제 시장의 옵션 가격을 들여다보면, 만기가 짧을수록 가격이 얼마나 기울어져 있는지(가격이 조금만 움직여도 옵션값이 크게 변하는 정도)가 수학 모형이 예측하는 것보다 훨씬 심하게 나타난다. 마치 일기예보 모형이 "며칠 뒤의 폭풍"은 잘 맞추면서 "한 시간 뒤의 돌풍"을 놓치는 것과 비슷하다. 2018년의 해법은 "변동성 자체가 소용돌이처럼 거칠게 움직인다"는 모형이었지만, 이 모형은 계산이 너무 느렸다.
대표 논문: Heston 모형 '들어올리기' — 20개 팩터로 거친 변동성 따라잡기
이 달 1위 논문인 Lifting the Heston model(Eduardo Abi Jaber, 종합점수 75.5)의 질문은 단순하다. "30년간 표준이던 빠른 모형(Heston)과, 정확하지만 느린 모형(rough Heston)을 하나로 합칠 수는 없을까?"
핵심 아이디어는 건물 층수를 늘리는 것과 비슷하다. 변동성을 움직이는 요인을 하나가 아니라 여러 겹(팩터)으로 쌓되, 각 층이 서로 다른 속도로 원래 자리로 돌아오게(평균회귀) 만든다. 빠른 층은 순간의 요동을, 느린 층은 오랜 흐름을 담당한다. 놀라운 점은 이 구조의 양 끝단이다 — 층을 1개만 두면 정확히 고전 Heston이 되고, 무한히 많으면 rough Heston이 된다. 즉 오래된 모형과 새로운 모형을 한 지붕 아래 매끄럽게 이어 붙인 것이다.
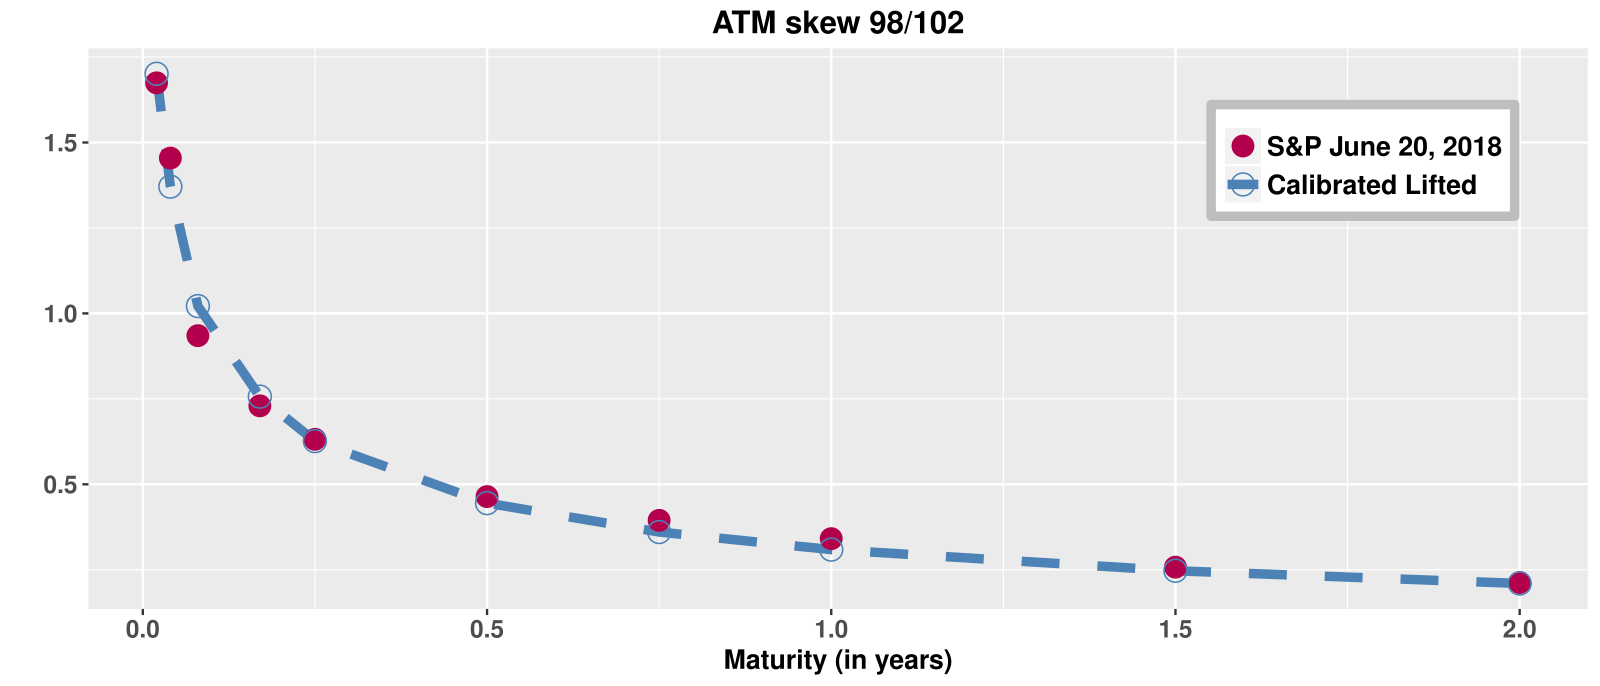
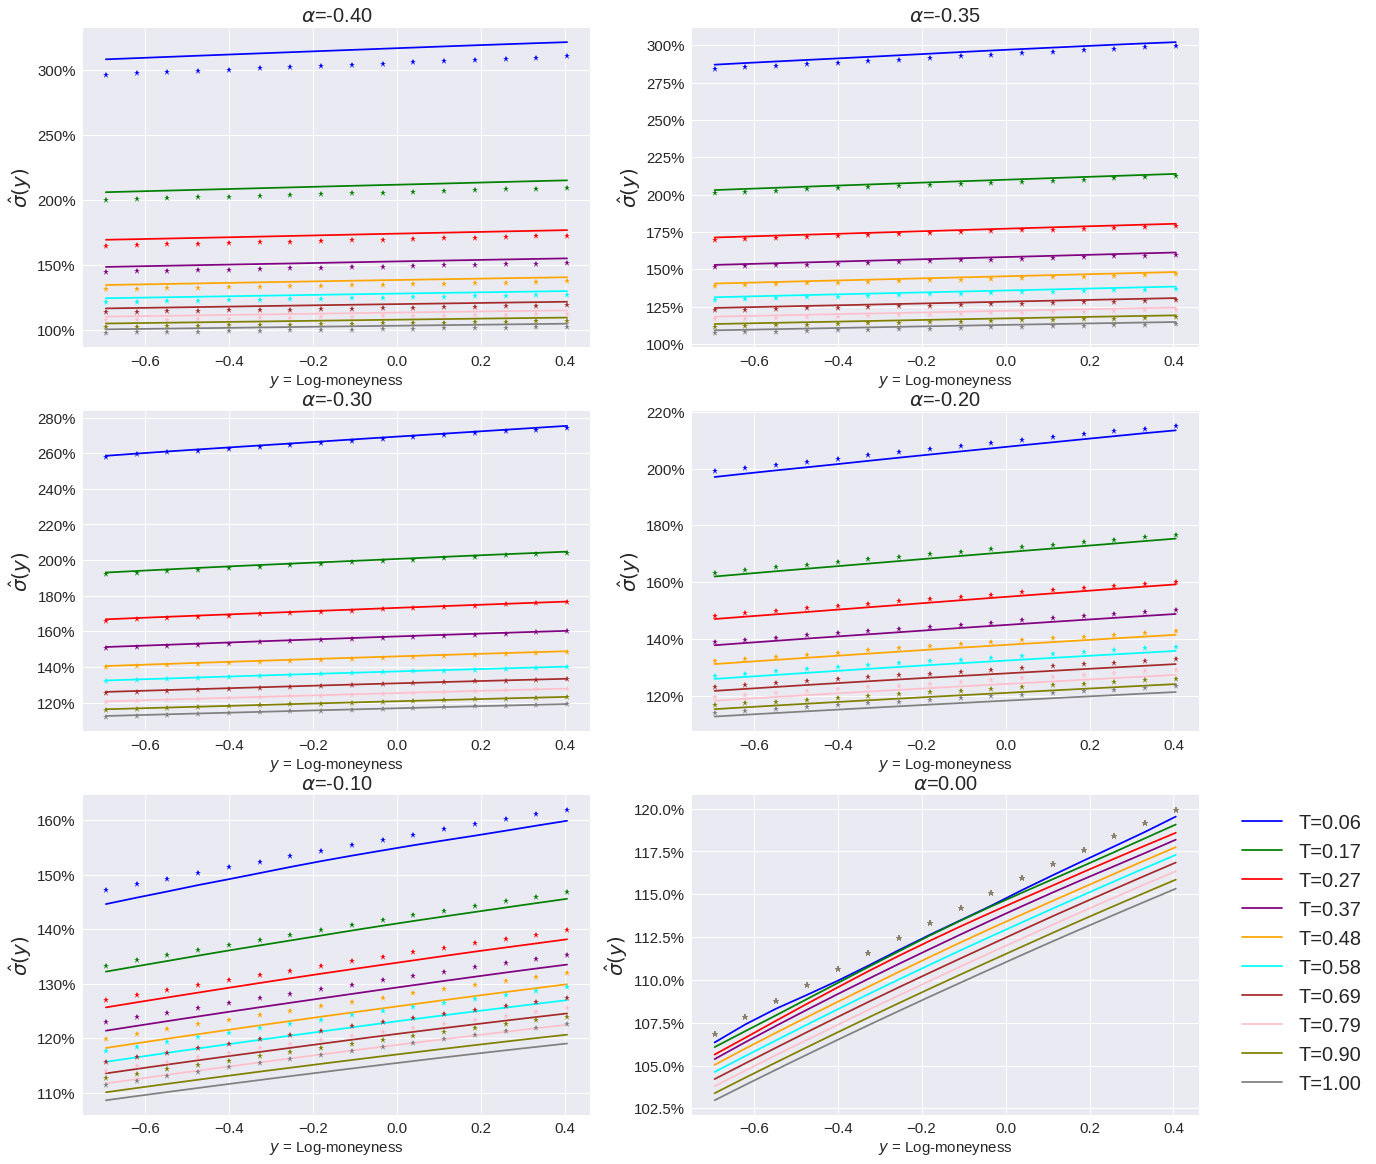
실제 성과를 숫자로 보자. 변동성의 거칠기를 담당하는 조건을 조절하면, 20개 팩터 모형은 "거친" 참 모형과의 오차(평균제곱오차)가 0.000185에서 0.00000364로 — 약 50배 — 줄어든다. 이후 시장 데이터에 맞춰 보정까지 마치면 오차는 약 0.0000004 수준으로, 1주에서 2년에 이르는 만기 전 구간에서 두 곡선을 눈으로 구분할 수 없다. 위 그림이 바로 그 결과다 — 빨간 점(실제 시장) 위에 파란 선(모형)이 정확히 얹혀 있다.
더 재미있는 부분은 통계 검증이다. 저자들은 이 모형이 마르코프(즉, "과거를 몰라도 현재만 알면 미래를 계산할 수 있는") 구조라는 점을 감추지 않으면서도, 실제 통계 추정기로 측정하면 실제 시장의 거친 변동성과 구별되지 않는 수치(허스트 지수 약 0.19)가 나온다고 보고한다. 10분 이상의 타임스케일에서는 일관되게 이 값이 유지되고, 10분 미만 초단기에서만 부드러운 모형 특성(0.5)으로 되돌아온다. 게다가 보정 시간은 느린 모형 대비 약 20배 빠르다.
한계와 조심할 점
공개된 구현 코드가 없어(재현성 점수 52) 직접 만들고 검증해야 한다. "거칠게 보이는" 마르코프 모형이지 분수 브라운 운동(rough 변동성의 원래 수학) 자체는 아니다. 20개 팩터, 조건값 2.5 같은 선택은 실무적 절충이므로 다른 시장·만기 범위에서는 재조정이 필요할 수 있다.
다음 논문들: 신경망이 옵션 계산을 대신하는 두 가지 방법
같은 테마의 다른 논문들도 같은 방향을 가리킨다. Unbiased deep solvers for linear parametric PDEs(종합점수 72.3)는 옵션 가격을 푸는 편미분방정식을 신경망으로 근사하면서, 신경망 근사가 만드는 편향을 통계적으로 제거하는 기법을 제안한다 — 덕분에 최대 100차원의 복잡한 옵션 문제에서도 계산이 안정된다. Deep calibration of rough stochastic volatility models(68.9)는 거친 변동성 모형에서 가장 계산이 많이 드는 부분을 신경망이 대신하게 해 보정을 빠르게 만든다. 한편 Leave-one-out least squares Monte Carlo(70.4)는 조기 행사가 가능한 옵션(Bermudan 옵션) 가격에서, "내가 쓴 데이터가 내 결과에 영향을 주는" 자기영향 편향을 시뮬레이션을 2배로 늘리지 않고 없애는 우아한 방법을 제시한다. 금리 시장의 다중 곡선을 다루는 이론 연구(1810.09882, 65.0)도 같은 달에 나왔다.
이 테마의 공통 인사이트
모형의 정확도와 계산 효율은 반드시 트레이드오프가 아니다. 편향이 어디에서 생기는지 정확히 이해하면(신경망 근사이든, 자기영향이든, 유한 개수 근사이든), 그것을 통계적으로 제거하거나 구조적으로 흡수해 "정확하면서도 빠른" 계산을 만들 수 있다. 2018년 10월의 파생 가격결정 연구가 남긴 교훈이다.
테마 2: 포트폴리오 구축 — '무엇을 사는가'보다 '어떻게 담는가'
왜 흥미로운가
투자 전략을 만들 때 사람들은 대부분 "무엇을 살까" — 어떤 종목이 오를지, 어떤 신호가 좋은지 — 에 시간을 쓴다. 그런데 실제 펀드에서는 "좋은 신호"를 어떻게든 찾아낸 뒤에도, 그 신호를 각 종목의 실제 비중으로 번역하는 과정이 남는다. 이 번역이 얼마나 중요한지, 대부분은 과소평가한다. 같은 요리 재료를 쓰더라도 손질과 순서에 따라 맛이 완전히 달라지는 것과 같다.
대표 논문: 같은 신호, 다른 포트폴리오 — 샤프 비율 0.34 대 1.19
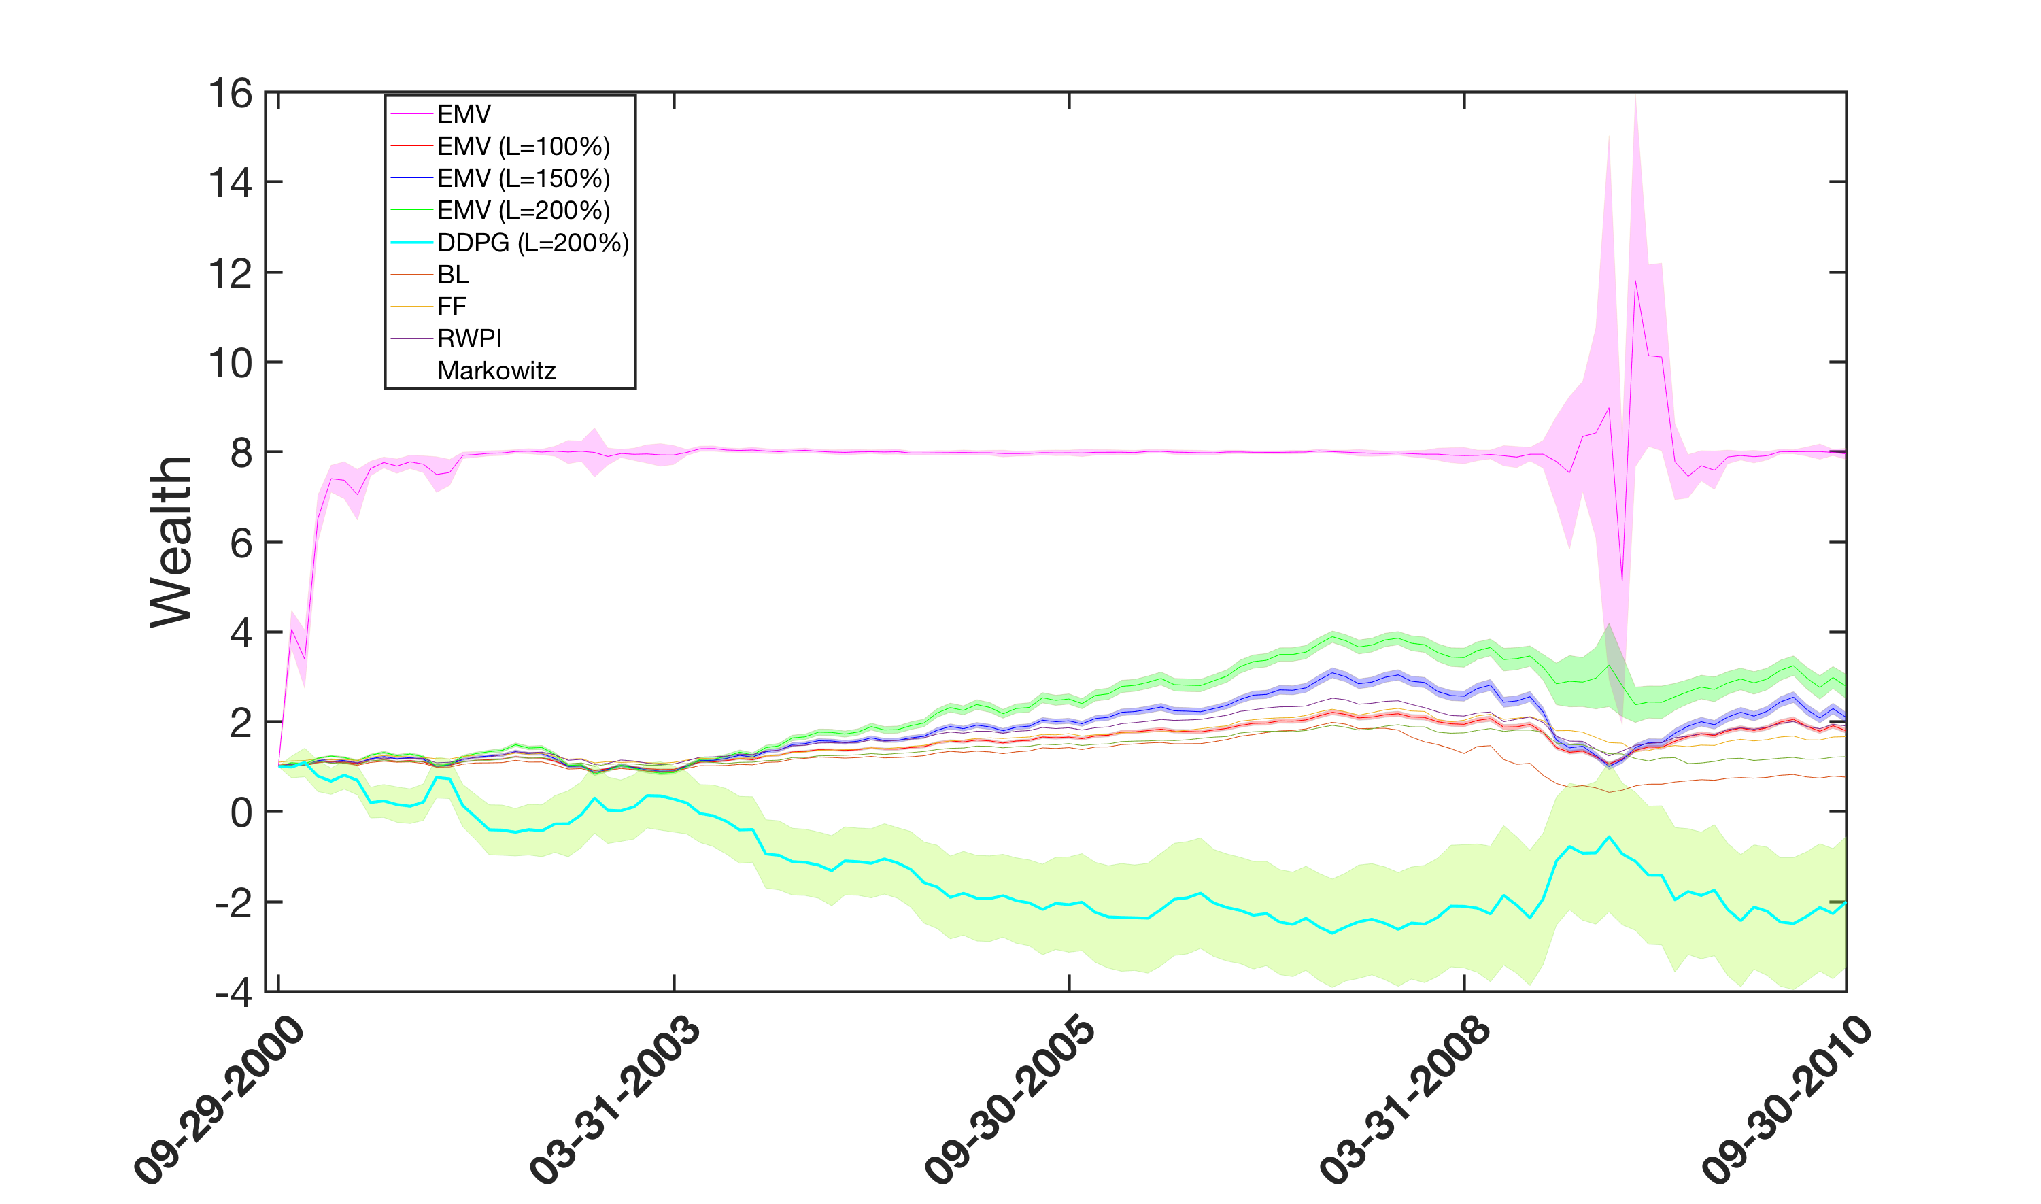
Portfolio Construction Matters(Capital Fund Management, 종합점수 63.6)는 이 문제를 가장 직접적으로 보여 준 논문이다. 저자들은 유명한 투자 팩터인 모멘텀(최근 오른 종목은 계속 오르는 경향을 쫓는 전략) 하나를 정해 두고, 신호를 포지션으로 바꾸는 방식만 바꿔 가며 전 세계 주식에서 20년, 미국 주식에서 1927년부터 2016년까지의 초장기 백테스트를 돌렸다.
결과는 충격적이다. 신호 크기에 비례해 단순히 나눠 담는 방식(FF)은 샤프 비율 0.34(수익의 변동성 대비 보상이 낮은 수준이며, 통계적 유의성 기준에도 미달)에 그친 반면, 종목 간 상관 구조를 정제해 반영한 Markowitz 방식은 샤프 비율 1.19를 기록했다 — t-통계량 3을 넘는, 통계적으로 확실한 성과. 미국 1927–2016년 백테스트에서도 거의 같은 숫자가 나왔다.
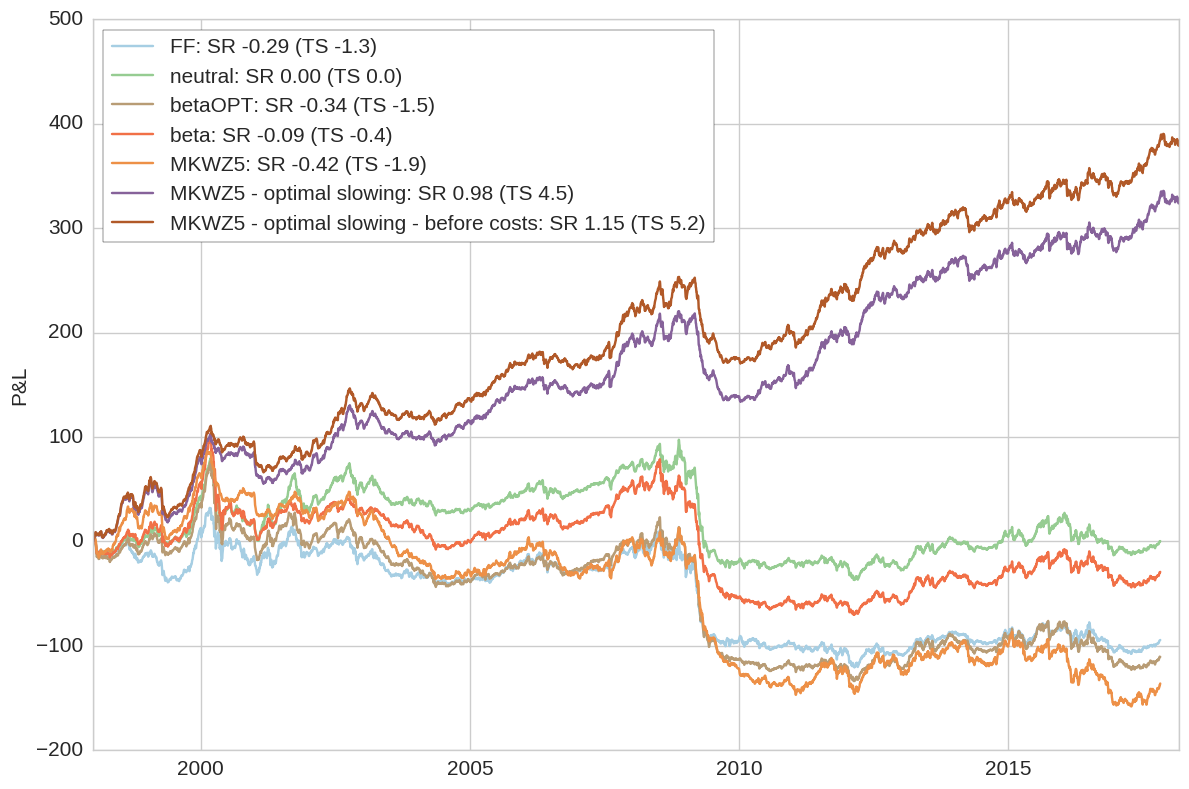
여기서 끝이 아니다. 저자들은 거래 비용(수수료, 매수·매도 호가 차이)을 반영하면 모든 방식이 무너진다는 사실도 정직하게 보여 준다 — 비용을 고려하지 않으면 매매가 지나치게 잦아지기 때문이다. 위 그림의 앞쪽 곡선들이 완전히 꺾이는 이유다. 다만 비용을 계산식 안에 넣어 최적화한 방식(예측 신호를 적당히 "느리게" 만들 최적의 속도를 스스로 찾는)은, 비용 전 성과를 1.19에서 1.15로만 낮추면서 비용을 반영한 뒤에도 샤프 비율 1 수준을 지킨다.
한계와 조심할 점
데이터와 코드가 공개되지 않아(재현성 32) 정확한 수치 재현은 어렵다. "격차의 방향과 크기"로 읽어야 한다. 시장 충격(대량 주문이 가격을 밀리는 비선형 비용)은 의도적으로 뺐고, 사례의 축이 모멘텀 전략이다. 참고로 이 논문은 정량 헤지펀드(CFM) 소속 연구진이 실전 데이터로 작성했다 — 실무 밀착 연구라는 장점과, 독립적 재현이 어렵다는 단점이 함께 있다.
다음 논문들: '최적'의 기준을 다시 묻는 수학들
같은 달의 이론 연구들은 이 실증을 받치는 기초를 닦는다. Spanning Tests for Markowitz Stochastic Dominance(69.5)는 "이 후보 포트폴리오 모음이 투자 기회를 충분히 담고 있는가"를 검정하는 수학적 도구로, 사람마다 다른 손실 회피·이익 추구 성향까지 반영한다. 카디널리티 제약 최적화(64.2)는 "종목 수를 30개 이하로" 같은 현실적 제한이 붙은 최적화를 효율적으로 푸는 방법이다. 그리고 Best Rebalancing Rule in Hindsight(58.1)와 Best Pairs Trade in Hindsight(61.3)는 "과거 데이터에서 최적이었던 전략"의 성과를 수학적으로 정확히 정의해, 전략 평가의 기준선(benchmark)을 엄밀하게 만든다. 자산 가격 분포와 효율적 시장을 다시 쓴 이론(1810.12840, 68.4)도 눈에 띈다.
이 테마의 공통 인사이트
알파 신호는 포트폴리오 구축이라는 "번역 과정"을 거쳐야만 성과가 된다. 같은 신호라도 공분산 정제, 제약 처리, 거래 비용 반영에 따라 결과가 크게 달라지며, 이 차이가 펀드 매니저 간 성과 편차의 상당 부분을 설명한다. "무엇을 살까"보다 "어떻게 담을까"에 시간을 쓰라는, 지루하지만 가장 실용적인 조언이다.
테마 3: 시장 미시구조 — 보이지 않는 '진짜 가격'을 계산하다
왜 흥미로운가
"현재 주가가 얼마인가"라는 질문은 사실 대답하기 어렵다. 주식처럼 유동성이 많은 시장에서는 여러 거래소의 시세를 합치는 통합 시세가 "정답"처럼 보이지만, 그 통합 데이터에는 지연과 오류가 있다. 회사채처럼 거래가 드문 시장에서는 아예 "시장 가격"이라는 것이 직접 보이지 않아, 통계 모형으로 추정해야 한다. 마켓메이커(사겠다고 팔겠다고 양쪽에 호가를 내는 시장의 유동성 공급자)는 이 불확실한 가격 위에서 호가를 내야 한다.
대표 논문: 마켓메이킹의 호가를 '공식 하나'로 — 다자산 버전
Closed-form approximations in multi-asset market making(Bergault, Evangelista, Guéant, Vieira, 종합점수 67.5)는 마켓메이킹 이론의 고전인 Avellaneda–Stoikov 모형을 여러 자산으로 확장하면서 생기는 계산 병목을 푼다. 자산이 하나면 호가를 계산하기 쉽지만, 여러 종목을 동시에 호가하려면 종목 간 상관까지 고려한 최적 호가를 실시간으로 계산해야 해 수치 계산이 폭발한다.
저자들의 해법은 "근사를 잘 선택하면 방정식이 풀리는 형태로 변한다"는 것이다. 원래 문제를 이차 형태로 근사하면 Riccati 방정식(닫힌형으로 풀리는 유명한 방정식)과 선형 미분방정식 두 개로 줄어든다. 그 결과 손으로 쓸 수 있는 호가 공식이 나온다.
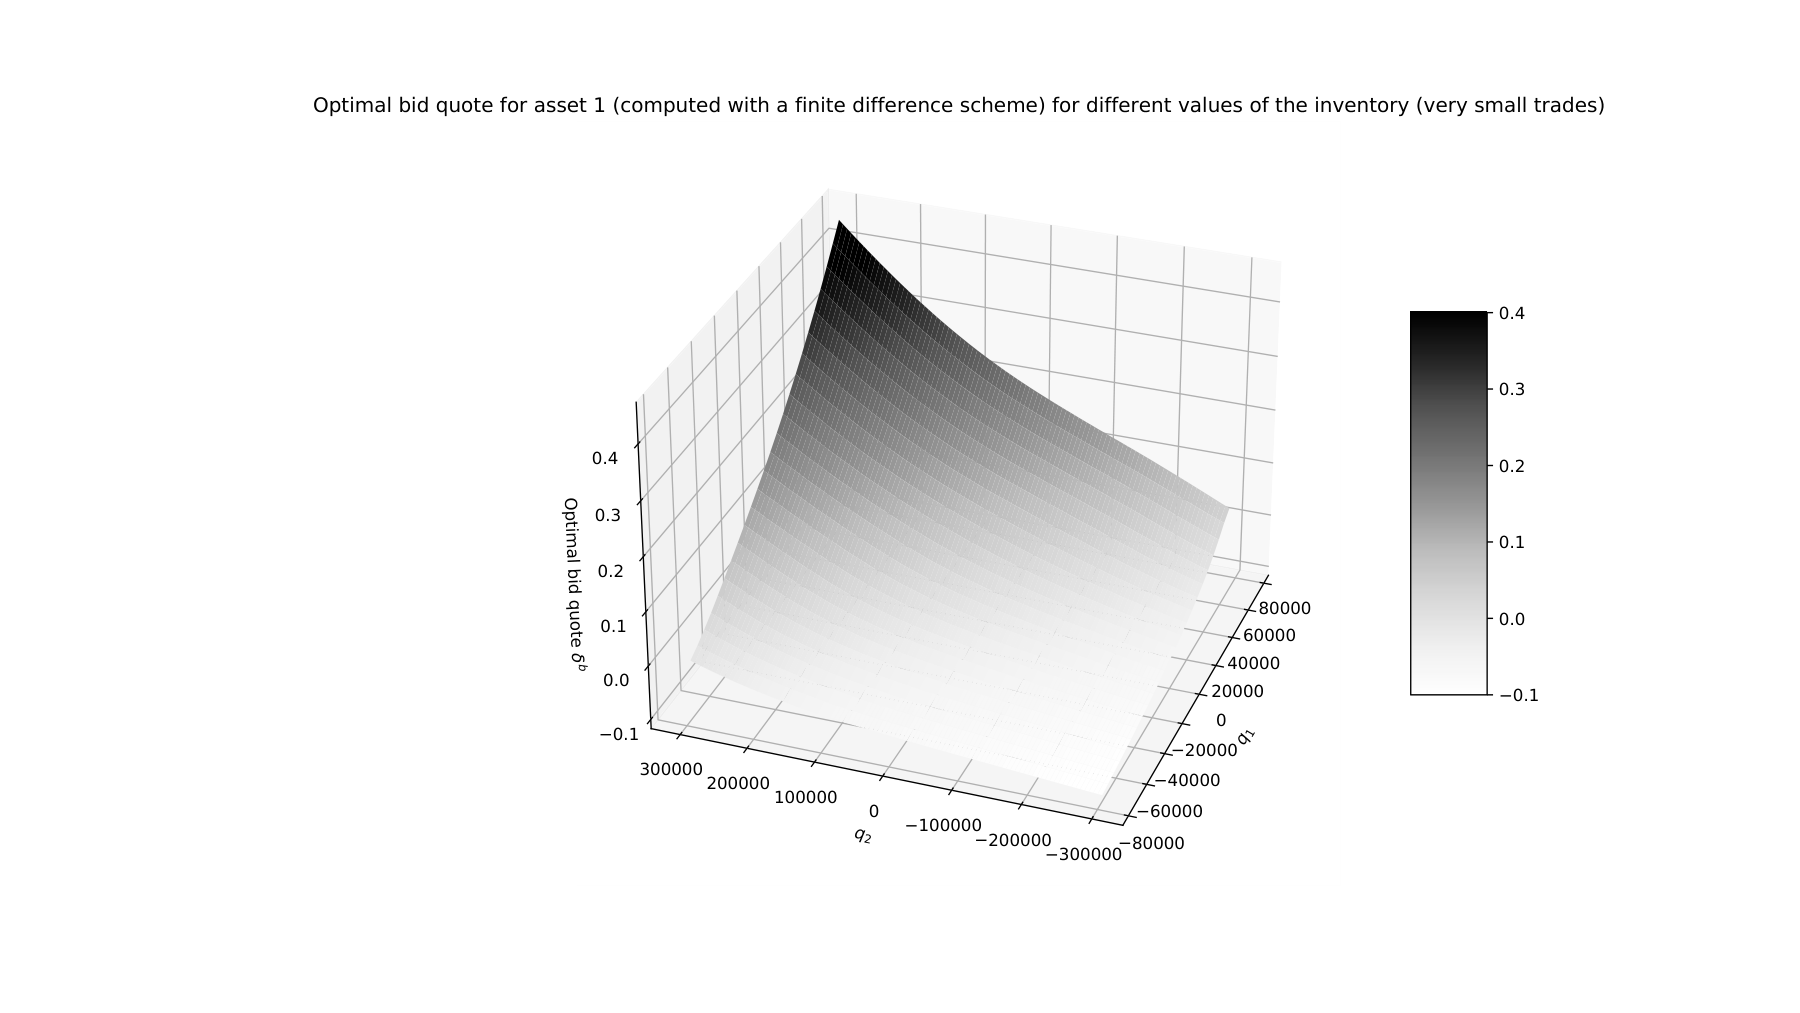
저자들은 2종목 실험(주가 100유로 2종목, 상관 0.5, 하루 거래 요청 30건, 평균 주문 규모 약 100만 유로 상당)으로 공식을 검증했다. 근사로 얻은 가치 평가는 정확한 수치 계산과 절대 수준은 조금 다르지만 형태가 일치하고, 여기서 뽑은 호가는 정밀 계산 기반 최적 호가에 가깝게 따라간다. 이 공식의 진짜 가치는 속도다 — 자산이 늘어도 실시간 호가 갱신이 가능하고, 강화학습으로 마켓메이킹을 배울 때 출발점(초기 가치함수)으로 쓸 수도 있다.
한계와 조심할 점
공개 코드가 없고(재현성 48), 근사의 "수준 차이"가 남아 있다 — 호가는 차분으로 얻으므로 괜찮지만, 가치 자체의 절대값이 필요한 용도에는 주의해야 한다. 실험이 2자산에, 단순한 체결 확률 구조에 머물러 있으며, 거래비용이나 경쟁 마켓메이커 같은 현실 요소는 대부분 밖에 있다.
다음 논문들: 가격을 '추정'해야 하는 시장들
유럽 회사채 중간 가격 추정(67.8)은 거래가 드문 장외 시장에서, 체결된 거래와 체결되지 않은 견적, 딜러 간 거래라는 파편적 정보를 입자 필터(시뮬레이션 기반 확률 추정 기법)로 합쳐 실시간 중간 가격과 불확실성까지 추정한다. 미국 주식 통합 시세(SIP)의 정확성(57.5)은 "빠른가"가 아니라 "정확한가"를 측정해 통합 데이터의 한계를 짚는다. 일시적 가격 충격과 초과복제 비용(56.8)은 주문이 가격을 일시적으로 밀릴 때 헤지 비용이 어떻게 변하는지를 연속시간 수학으로 연결한다.
이 테마의 공통 인사이트
시장의 "가격"은 주어지는 것이 아니라 계산의 대상이다. 기준 가격도, 최적 호가도, 헤지 비용도 — 모두 불완전한 정보와 시장 충격, 데이터의 품질을 전제로 설계되어야 한다. 미시구조 연구는 이 "불확실성 위의 계산"을 다루는 학문이다.
테마 4: 고빈도 데이터의 정밀 계량 — 잡음과 점프를 함께 다루기
왜 흥미로운가
초 단위로 쌓이는 거래 데이터에는 두 가지 오염이 있다. 하나는 미시구조 잡음 — 호가 단위의 반올림, 체결 시스템의 마이크로한 오차 같은 것이 가격에 섞여 들어오는 것. 다른 하나는 점프 — 뉴스나 충격으로 가격이 순간적으로 튀는 것. 변동성을 추정하려면 잡음을 줄여야 하고, 점프를 골라 내야 하는데, 이 둘이 서로를 부풀린다. 잡음을 줄이려고 이동평균을 쓰면 점프가 번지고, 점프를 자르면 잡음이 남는 식이다.
대표 논문: 잡음과 점프가 섞인 자료에서 변동성의 '함수'까지 추론하기
Inference for Volatility Functionals of Multivariate Itô Semimartingales Observed with Jump and Noise(Richard Y. Chen, University of Chicago, 종합점수 68.6, 엄밀성 89점으로 이달 최고)는 이 두 방해물을 동시에 다루는 일반 프레임워크를 세운다. 국소 이동평균으로 잡음을 완화하고(pre-averaging), 큰 점프를 잘라 내는 절단(truncation)을 겹친 뒤, 추정량의 편향을 수식으로 전개해 보정까지 한다.
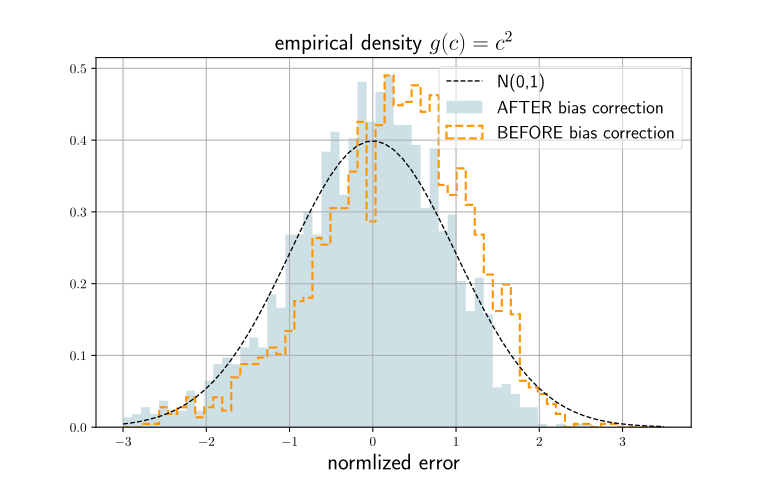
이 논문이 특별한 이유는 범위다. 변동성 "그 자체"만이 아니라 그것의 다양한 함수 — 제곱, 로그, 여러 자산의 공분산 조합 등 — 의 시간적분을 추정하는 이론을 한 번에 정리하고, 자주 쓰이는 지표들(실현 quarticity, 실현 라플라스 변환, 일반화 방법론, 연속시간 회귀, 주성분 분석)이 그 특수한 경우로 따라 나온다. 시뮬레이션(1초 간격 자료, 점프와 변동성 점프가 있는 환경)에서 추정량의 성능을 확인했다.
한계와 조심할 점
순수 이론 연구로 공개 코드가 없다(재현성 38). 저자 자신이 인정하듯 이 방법(이동평균 기반)은 통계적으로 "가장 좋은" 효율 하한에는 못 미치고, 유한 표본에서는 추정된 공분산이 깨질 수 있어 실무 조정이 필요하다. 실무 적용 전 자신의 데이터에서 유한표본 검증을 반드시 거쳐야 한다.
다음 논문들: 확률과정의 정밀 기술들
Lévy 과정의 극한값 시뮬레이션(68.5)은 점프를 포함한 가격 경로의 "최댓값과 그 도달 시간"을, 오차가 계산 비용 대비 기하급수적으로 줄어드는 방법으로 모의한다. Ornstein-Uhlenbeck 과정의 최초 도달 시간(58.8)은 평균회귀 자산이나 스프레드가 "언제 임계값에 닿는가"의 확률 밀도를 체계적으로 계산한다 — 페어트레이딩의 청산 시점, 바리어 옵션에 쓰인다. 암호화폐 수익률의 다변량 안정분포(58.0)는 2018년 암호화폐 시장의 두꺼운 꼬리 위험을 분포로 모형화한다.
이 테마의 공통 인사이트
위험 측정의 신뢰도는 예측 모형보다 먼저, 추정과 시뮬레이션 기초의 정밀도에서 결정된다. 데이터가 지저분할수록 잡음·점프·두꺼운 꼬리를 전제한 기초 수학이 그대로 실무 품질의 상한이 된다.
테마 5: 기계학습의 금융 진입 — 2018년의 조용한 초입
왜 흥미로운가
오늘날 "금융 AI"하면 떠오르는 딥러닝·강화학습이, 2018년 10월에는 아직 조용한 초입 단계였다. 이 달의 기계학습 논문들은 대단한 수익률 자랑 대신 "왜 금융에는 그대로 안 통하는가"를 정면으로 다룬다. 그 세 가지 장벽 — 데이터가 시간에 따라 변하는 문제(비정상성), 모델이 블랙박스인 문제(해석가능성), 그리고 "평균 수익"만 추구하면 위험에 무방비가 되는 문제(위험선호) — 는 사실 오늘날까지도 금융 AI의 핵심 과제로 남아 있다.
대표 논문: 가격 '수준' 대신 가격 '차이' — 호가창을 읽는 딥러닝
Using Deep Learning for price prediction by exploiting stationary limit order book features(Tsantekidis 외, 종합점수 57.6)는 가장 근본적인 벽인 비정상성에 도전한다. 주가의 절대 수준(5만 원, 6만 원)은 세월과 함께 이동하므로, 같은 숫자가 시점에 따라 다른 의미가 된다. 저자들의 해법은 단순하고 영리하다 — 호가창 안에서의 가격 "차이"를 학습하라. 호가창 깊이별 가격의 차이(스프레드의 분해)는 시간이 흘러도 분포가 거의 변하지 않는다.
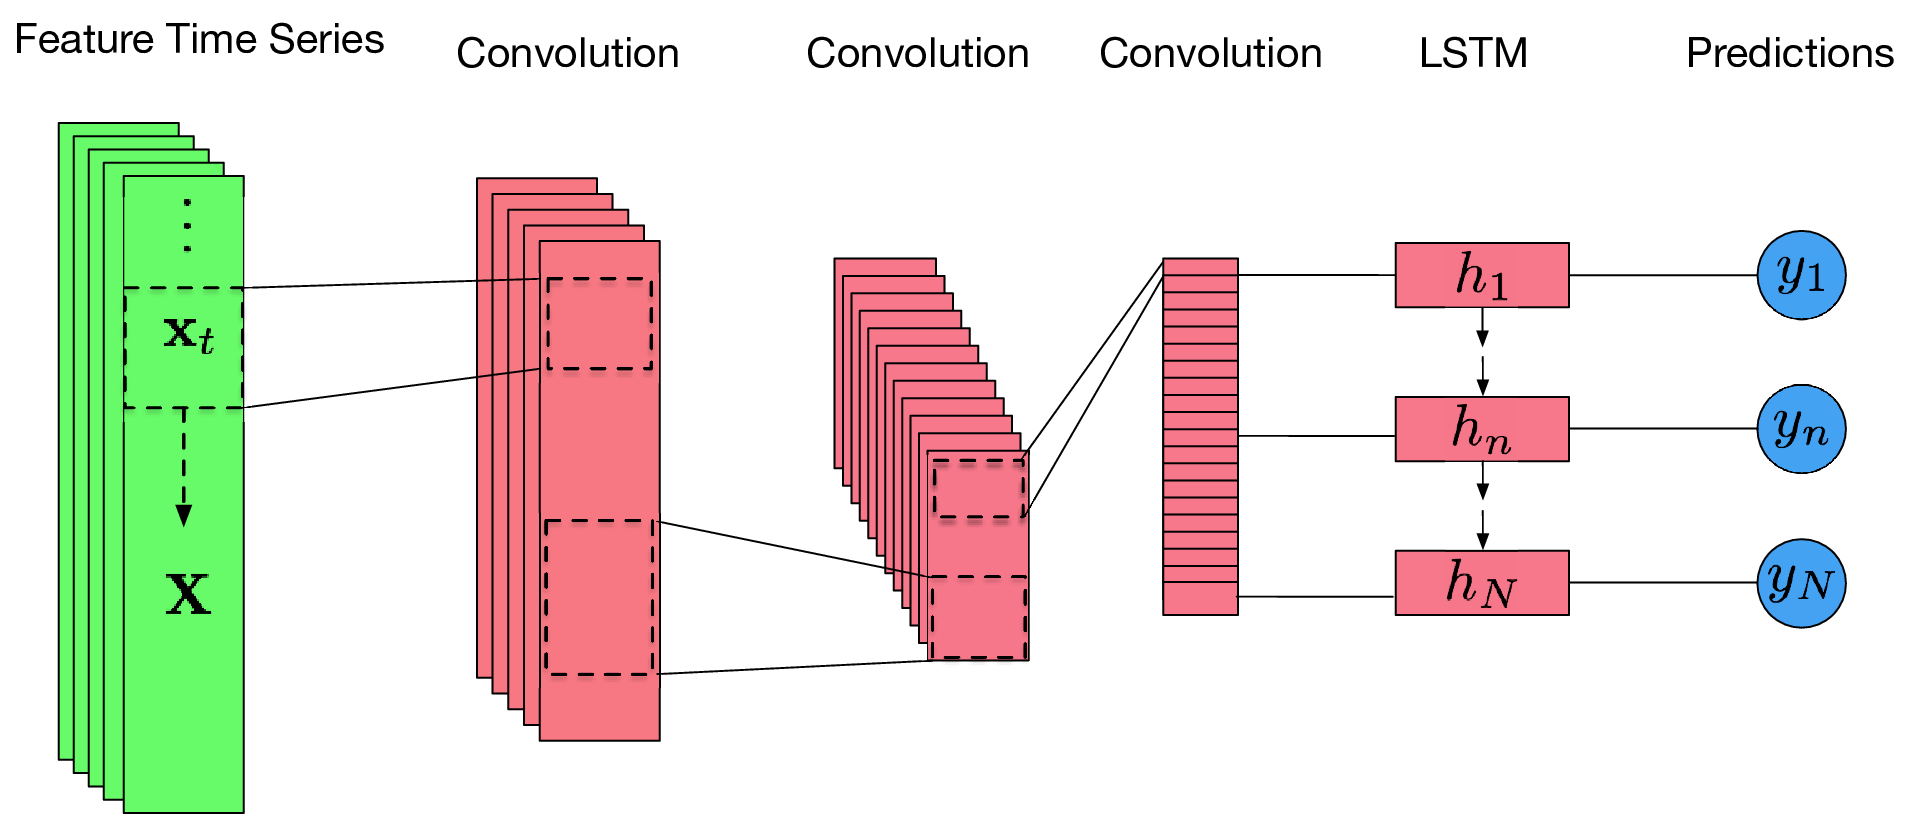
모델은 두 기술의 결합이다. CNN이 호가창의 공간적 패턴(호가 층들 사이의 관계)을 뽑아 내고, LSTM이 그 특징들의 시간 흐름을 읽는다(위 그림). 검증 데이터는 Nasdaq Nordic의 핀란드 상장 5개사 호가창 10일치. 예측 지평 100건의 이벤트 기준, 정상 특징 + CNN-LSTM은 F1 점수 0.48, 코헨 카파 지수 0.24로, 원시 가격 특징을 쓴 CNN(F1 0.37, 카파 0.12)을 확실히 앞선다. 그리고 모든 모델에서 "정상 특징 > 원시 특징"이라는 결론이 일관되게 나온다. 저자들은 또 LSTM이 관측 초기에는 예측이 불안정해 "시장을 익히는" 준비 구간(burn-in)이 필요하다는 실무적 발견도 함께 보고한다.
한계와 조심할 점
데이터가 극히 적다 — 5개 종목, 10일치. 딥러닝 실험으로는 표본이 협소해 일반화에 신중해야 한다. 거래 비용을 반영한 수익성 검증도 없다. 분류 지표(카파 0.2~0.25)가 통계적으로 의미 있어도 "돈이 되는 신호"인가는 별개 문제다. 재현성 35 — 공개 코드 없음.
다음 논문들: 해석가능성과 위험을 품은 학습
Deep Factor Model(57.4)은 딥러닝 예측에 "왜 이 예측을 했는가"를 설명하는 기법(LRP)을 붙여, 예측 모델과 요인별 위험 분석을 하나의 팩터 모형으로 통합한다. Risk-Sensitive Reinforcement Learning(59.0)은 강화학습의 목표를 "평균 수익 극대화"에서 "위험을 감안한 최적화"로 넓힌 이론 작업이다. Mean-Field Games with Differing Beliefs(62.2)는 같은 데이터를 봐도 모형을 다르게 믿는 수많은 거래자들이 서로 영향을 주며 거래할 때 어떤 균형이 생기는지, 대규모 게임 이론으로 모형화한다.
이 테마의 공통 인사이트
비정상성, 해석가능성, 위험선호 — 이 세 가지는 2018년 당시 이미 금융 기계학습의 벽으로 명확히 인식되어 있었다. 이후 8년간의 금융 AI 연구가 이 세 축을 파고들었다고 해도 과언이 아니다. 화려한 성과 주장이 아니라 문제의 정확한 진단에서 출발한, 그래서 오히려 신뢰할 수 있는 초기 기록이다.
월 전체 Big Picture
2018년 10월의 다섯 이야기는 한 문장으로 모인다 — "정밀함의 실무화: 좋은 모형을 빠르게, 좋은 신호를 올바르게 담아, 지저분한 데이터 위에서 정직하게." 거친 변동성의 정확함은 20개 팩터와 신경망을 통해 계산 가능한 형태가 되었고(테마 1), "좋은 신호"는 포트폴리오 구축이라는 번역을 거쳐야만 성과가 된다는 사실이 장기 데이터로 확인되었다(테마 2). 시장의 진짜 가격은 추정의 대상으로 다시 정의되었고(테마 3), 잡음과 점프 위의 추정 이론이 위험 측정의 기초를 다시 놓았다(테마 4). 그리고 기계학습은 자기 앞의 세 가지 벽을 정직하게 마주하고 있었다(테마 5).
이 달이 특별한 이유는 이론과 실무가 같은 방향을 가리키고 있다는 점이다. 통계 추정기까지 "속이는" 마르코프 모형을 만들면서도 실제 검증을 병행한 연구, t-통계량과 왜도, 거래 비용까지 들여다본 실증 — 2018년 10월의 논문들은 "더 정확한 모형"에서 "더 빠르고 정직한 구현"으로 무게 중심이 옮겨가던 순간을 기록한다. 투자의 기본기가 화려한 예측이 아니라, 계산의 편향을 알고, 포트폴리오를 담는 방식을 진지하게 따지며, 데이터의 한계를 겸손하게 다루는 태도라는 것을 — 이 2018년의 가을 논문들은 조용히 말해 준다.
더 알아보기
원문 링크와 5차원 평가 점수
이 글에서 다룬 논문들의 원문과, 우리 지식 베이스가 매긴 5차원 점수입니다(신규성 / 적용성 / 엄밀성 / 재현성 / 통찰, 종합점수는 이들의 가중 합).
우리 지식 베이스에서 함께 읽을 논문
- 파생 가격결정·변동성 계열: Reconciling rough volatility with jumps, Efficient option pricing in the rough Heston model using weak simulation, The quadratic rough Heston model and the joint S&P 500/VIX smile calibration, Deep calibration of the quadratic rough Heston model
- 포트폴리오 구축 계열: Distributionally Robust End-to-End Portfolio Construction, Machine Learning Classification and Portfolio Construction, Optimal trend following portfolios, Learning to Learn Financial Networks for Optimising Momentum Strategies
- 마켓메이킹 계열: Robust Market Making via Adversarial Reinforcement Learning, Deep reinforcement learning for market making in corporate bonds, Macroscopic Market Making, A closed-form solution for optimal mean-reverting trading strategies
- 고빈도 계량 계열: When Frictions are Fractional: Rough Noise in High-Frequency Data, Streaming Approach to Quadratic Covariation Estimation, A GMM approach to estimate the roughness of stochastic volatility, Kernel Estimation of Spot Volatility with Microstructure Noise
- 호가창 딥러닝 계열: HLOB: Information Persistence and Structure in Limit Order Books, Deep Learning for Market by Order Data, Price predictability in limit order book with deep learning model, Representation Learning of Limit Order Book
이 글은 2018년 10월 arXiv 백필 코호트(전체 110편, 관련 64편)의 평가 결과를 바탕으로 작성했습니다. 모든 수치는 원문 논문에서 인용했으며, 블로그 성격상 일부 이론적 세부사항은 생략했습니다. 심층 분석은
analysis/reports/backfill/1810.md를 참고하세요.
📚 이 글에서 다룬 논문 (46편)
- A
- AUnbiased deep solvers for linear parametric PDEs
Marc Sabate Vidales, David Siska, Lukasz Szpruch
- ALeave-one-out least squares Monte Carlo algorithm for pricing Bermudan options
Jeechul Woo, Chenru Liu, Jaehyuk Choi
- ADeep calibration of rough stochastic volatility models
Christian Bayer, Benjamin Stemper
- ATerm structure modeling for multiple curves with stochastic discontinuities
Claudio Fontana, Zorana Grbac, Sandrine Gümbel 외 1명
- ASpanning Tests for Markowitz Stochastic Dominance
Stelios Arvanitis, Olivier Scaillet, Nikolas Topaloglou
- AAsset Price Distributions and Efficient Markets
Ricardo T. Fernholz, Caleb Stroup
- AClosed-form approximations in multi-asset market making
Philippe Bergault, David Evangelista, Olivier Guéant 외 1명
- AGeometrically Convergent Simulation of the Extrema of Lévy Processes
Jorge Ignacio González Cázares, Aleksandar Mijatović, Gerónimo Uribe Bravo
- B
- BA Relaxed Optimization Approach for Cardinality-Constrained Portfolio Optimization
Jize Zhang, Tim Leung, Aleksandr Aravkin
- BPrice Discovery and the Accuracy of Consolidated Data Feeds in the U.S. Equity Markets
Brian F. Tivnan, David Slater, James R. Thompson 외 7명
- BScaling Limits for Super--replication with Transient Price Impact
Peter Bank, Yan Dolinsky
- BOn the First Hitting Time Density of an Ornstein-Uhlenbeck Process
Alexander Lipton, Vadim Kaushansky
- BMultivariate stable distributions and their applications for modelling cryptocurrency-returns
Szabolcs Majoros, András Zempléni
- BInverse Gaussian quadrature and finite normal-mixture approximation of the generalized hyperbolic distribution
Jaehyuk Choi, Yeda Du, Qingshuo Song
- BUsing Deep Learning for price prediction by exploiting stationary limit order book features
Avraam Tsantekidis, Nikolaos Passalis, Anastasios Tefas 외 3명
- B
- BRisk-Sensitive Reinforcement Learning via Policy Gradient Search
Prashanth L. A., Michael Fu
- BMean-Field Games with Differing Beliefs for Algorithmic Trading
Philippe Casgrain, Sebastian Jaimungal
- BOption market (in)efficiency and implied volatility dynamics after return jumps
Juho Kanniainen, Martin Magris
- BReconciling rough volatility with jumps
Eduardo Abi Jaber, Nathan De Carvalho
- AEfficient option pricing in the rough Heston model using weak simulation schemes
Christian Bayer, Simon Breneis
- AThe quadratic rough Heston model and the joint S&P 500/VIX smile calibration problem
Jim Gatheral, Paul Jusselin, Mathieu Rosenbaum
- BDeep calibration of the quadratic rough Heston model
Mathieu Rosenbaum, Jianfei Zhang
- ADistributionally Robust End-to-End Portfolio Construction
Giorgio Costa, Garud N. Iyengar
- AMachine Learning Classification and Portfolio Construction: Does the Loss Function Matter?
Yang Bai, Kuntara Pukthuanthong
- A
- ALearning to Learn Financial Networks for Optimising Momentum Strategies
Xingyue Pu, Stefan Zohren, Stephen Roberts 외 1명
- ARobust Market Making via Adversarial Reinforcement Learning
Thomas Spooner, Rahul Savani
- A
- AA closed-form solution for optimal mean-reverting trading strategies
Alexander Lipton, Marcos Lopez de Prado
- AWhen Frictions are Fractional: Rough Noise in High-Frequency Data
Carsten H. Chong, Thomas Delerue, Guoying Li
- AA GMM approach to estimate the roughness of stochastic volatility
Anine E. Bolko, Kim Christensen, Mikko S. Pakkanen 외 1명
- AKernel Estimation of Spot Volatility with Microstructure Noise Using Pre-Averaging
José E. Figueroa-López, Bei Wu
- AHLOB -- Information Persistence and Structure in Limit Order Books
Antonio Briola, Silvia Bartolucci, Tomaso Aste
- ADeep Learning for Market by Order Data
Zihao Zhang, Bryan Lim, Stefan Zohren
- BRepresentation Learning of Limit Order Book: A Comprehensive Study and Benchmarking
Muyao Zhong, Yushi Lin, Peng Yang
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2019-07 월간A
옵션 가격결정과 거친 변동성, 그리고 Quant GANs: 2019년 7월 금융 AI 논문
2019년 7월 arXiv 금융 AI 연구를 5개 테마로 정리했습니다. 모델 없이 옵션 가격 상한을 구하는 수학, 미시구조에서 태어나는 거친 변동성, 금융 시계열을 생성하는 Quant GANs, 로보 투자의 진짜 수혜자, 강화학습 자산배분 — 생성형 AI 이전의 기초 공사 현장을 다룹니다.
 📊 2019-03 월간A
2019년 3월 금융 AI 연구: 거친 변동성에서 감정 네트워크까지
2019년 3월 arXiv에 올라온 금융 AI 논문 56편을 5개 테마로 정리했습니다. 거친 변동성 옵션 가격의 근사 수학, 신경망 조건부 밀도 추정 벤치마크, 공분산 앙상블 리스크 모형, 시장조성 백테스트의 함정, 1,944개 암호화폐의 감정 네트워크까지 — 예측이 아니라 분포와 근사가 중심이던 시대의 연구입니다.
 📊 2025-12 월간
크립토 백테스트가 거짓말하는 이유, 그리고 2025년 12월 퀀트 연구의 다섯 가지 흐름
2025년 12월 arXiv에 올라온 금융 AI·퀀트 연구 중 주목할 만한 다섯 가지 흐름을 살펴봅니다. 크립토 백테스트의 과대평가 문제부터 팩터 알파의 수명까지, 실전에 가까워지는 퀀트 연구의 최신 동향을 쉽게 풀어 설명합니다.