시장에 주문이 쏟아질 때, 그 주문들은 대부분 "뉴스" 때문이 아닐 수 있다. 이번 달 연구자들은 주문이 주문을 부르는 폭발 현상이 호가창이 한쪽으로 기울어진 순간에만 강해진다는 사실을 1년치 고빈도 자료로 잡아 냈다. 같은 달, "모형을 너무 믿으면 투자가 위험해진다"는 수학적 증명, 변동성의 시간을 되돌리면 다른 모습이라는 미스터리를 푼 논문, 아무리 단순한 투자 전략도 지수를 이기는 이유의 정체가 '수학적 보너스'였다는 분석, 그리고 옵션 가격 계산을 100만 배 빠르게 만든 신경망 보고서가 함께 나왔다. 2018년 9월의 다섯 이야기를 따라가 보자.
들어가며: "모형이 틀릴 수 있다"를 정면으로 다룬 가을
2018년 9월은 약세장 한복판이었다. 비트코인은 연초 고점에서 크게 빠진 뒤였고, 주식시장도 요동쳤다. 그런데 이 달의 금융 연구 흐름은 놀랍도록 담담하다 — 화려한 수익률 예측 대신, "우리가 쓰는 모형과 계산이 과연 믿을 만한가"라는 기초 문제에 매달린 논문들이 상위권을 채웠다. 시장의 움직임은 외부 뉴스만이 아니라 시장 내부에서 스스로를 만들어 내고(테마 1), 그래서 어떤 계산도 "모형이 틀릴 수 있다"는 전제 위에 서야 하며(테마 2), 변동성 모형은 새로운 실증 사실을 설명해야 했고(테마 3), 투자 성과의 비결은 의외로 분산의 수학이었으며(테마 4), 마침내 계산 자체는 신경망이 대신할 수 있다는 보고가 나왔다(테마 5). 8년이 지난 지금 다시 읽어도, 이 달의 논문들은 "금융 AI"가 무엇을 향해 가는지 정확히 가리키고 있다.
테마 1: 시장 미시구조 — 호가창이 기울면 시장은 스스로를 흔든다
왜 흥미로운가
주가가 움직이면 사람들은 보통 "무슨 뉴스가 있었나"를 찾는다. 하지만 실제 거래소의 데이터를 자세히 들여다보면, 뉴스 없이도 주문이 폭발하는 순간이 있다. 마치 사람이 많은 좁은 골목에서 누군가 뛰기 시작하면 모두가 뛰는 것처럼, 주문 하나가 다음 주문을 부르는 '전염' 현상이 실제 시장에 존재한다. 문제는 이 전염의 강도가 항상 똑같지 않다는 것 — 2018년 9월의 1위 논문은 전염의 강도가 호가창의 상태에 따라 달라진다는 사실을 밝혀 냈다.
대표 논문: 주문의 전염과 호가창 상태의 양방향 결합
State-dependent Hawkes processes and their application to limit order book modelling(임페리얼 칼리지 런던, 종합점수 72.3 — 이달 1위)이 다루는 도구가 Hawkes 과정이다. Hawkes 과정은 쉽게 말해 "사건이 사건을 부르는" 확률 모형이다. 주문이 들어오면 그 주문이 다시 새로운 주문을 유발하고, 서로 다른 종류의 주문끼리도 영향을 주고받는다. 고빈도 거래 데이터에서 흔히 보이는 '주문이 몰려 나오는' 현상을 설명하는 표준 도구다.
그런데 기존 Hawkes 모형에는 맹점이 있었다 — 지금 호가창이 어떤 상태인지 전혀 모른다는 것. 정작 트레이더들은 "호가 수량이 한쪽으로 쏠리면 주문이 폭발한다"는 사실을 잘 알고 있었다. 저자들은 사건(주문)과 상태(호가창 모양)를 서로를 부르는 양방향 구조로 묶는다. 주문이 들어오면 호가창 모양이 바뀌고, 호가창 모양이 바뀌면 다음 주문의 강도가 달라진다 — 실재하는 피드백 루프를 그대로 수식으로 옮긴 것이다.
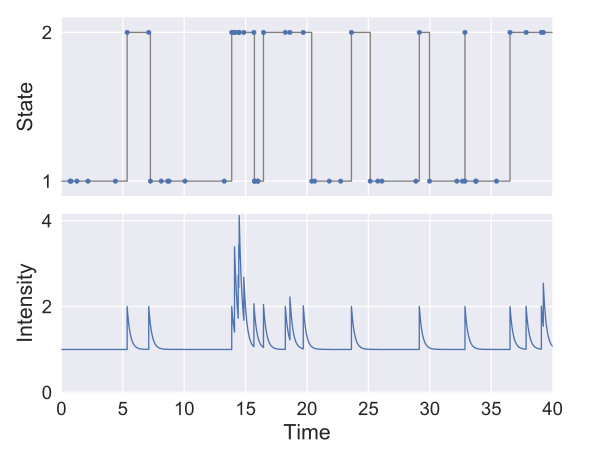
실증은 인텔(Intel) 주식의 1년치 고빈도 호가장 자료, 거래일 기준 250일에 대해 매일 추정하는 방식으로 이뤄졌다. 상태 변수는 두 가지를 시험했다 — (1) bid–ask 스프레드의 크기, (2) 호가 수량 불균형(queue imbalance, 사는 쪽과 파는 쪽 대기 물량의 쏠림). 결과는 뚜렷하다.
- 주문의 자기·교차 흥분 효과는 상태에 따라 강하게 달라진다. 호가창이 균형 잡혀 있을 때와 한쪽으로 기울어 있을 때, 주문이 나오는 패턴 자체가 다르다.
- 더 흥미로운 발견은 "시장 내생성"의 크기 자체가 상태 의존적이라는 점이다. 내생성이란 "시장 사건의 대부분이 외부 뉴스가 아니라 앞선 사건에 대한 반응이다"라는 개념(2012년 Filimonov와 Sornette가 'critical reflexivity'라 이름 붙인)인데, 이 논문은 그 정도가 불균형 상태에서만 급증함을 보여 준다. 스프레드가 넓은 상태에서는 내생성 지표가 체계적으로 임계값 1을 넘고, 수량이 극단으로 쏠린 상태에서는 절반의 날에 0.9를 넘으며 때때로 1을 초과한다.
- 저자들은 이 현상이 가격 움직임을 예상하고 달려드는 고빈도 트레이더의 활동과 관련되어 보인다고 해석한다(2019년 Nasdaq Stockholm의 거래 실명 자료 연구와도 일치한다).
한마디로 정리하면: "모든 시장이 항상 자기 자신에 의해 움직이는 것은 아니다 — 호가창이 불안정한 순간에만, 시장은 스스로를 강하게 흔든다." 소로스가 "반사적 과정은 간헐적으로만 나타난다"고 말한 것과 정확히 맞아떨어지는 결과다.
한계와 조심할 점
주문 전염의 감쇠 속도를 지수 함수로 단순화한 가정, 실증 자산이 인텔 단일 종목이라는 점은 확인이 필요하다. 그래도 이 분야에서 드물게 재현성 점수가 높은 편(72)이라, 미시구조 신호 연구의 기준선으로 삼기 좋다.
다음 논문들: 실험실 속의 거래소
BSE: A Minimal Simulation of a Limit-Order-Book Stock Exchange(종합점수 59.1)은 실제 거래소를 최소한의 규칙만 남긴 형태로 시뮬레이션하는 도구다. 주문 흐름의 피드백 같은 복잡한 현상을 통제된 환경에서 실험하려면 이런 "모형 거래소"가 필요하다. 자동매매 전략을 실제 돈으로 시험하기 전에 돌려보는 연습장인 셈이다.
이 테마의 공통 인사이트
주문 흐름은 뉴스만이 아니라 시장의 '상태'에서 나온다. 미시구조 신호를 읽을 때 "지금 무슨 정보가 있나"보다 "지금 호가창이 얼마나 불안정한가"를 함께 봐야 하는 이유다.
테마 2: 모형 불확실성 — "최적화"를 믿으면 위험해진다
왜 흥미로운가
투자에서 '최적 포트폴리오'라는 말을 자주 쓴다. 그런데 그 최적화는 과거 데이터로 추정한 기대수익과 상관관계를 집어넣어 계산한 결과다. 추정치는 틀릴 수 있다. 그러면 '최적'이라던 포트폴리오는 오히려 위험해진다. 이 달의 강건(robust) 최적화 연구들은 이 단순한 사실을 수학의 언어로 정면 돌파한다.
대표 논문: 투자자들이 종목을 적게 사는 진짜 이유
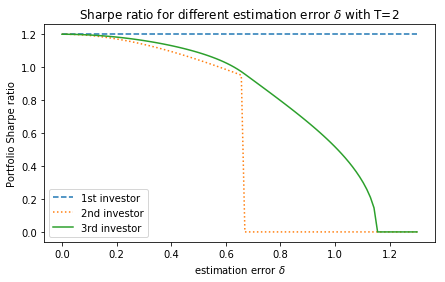
Portfolio diversification and model uncertainty(파리 대학·UC 버클리·싱가포르 국립대, 종합점수 70.4)의 출발점은 하나의 수수께끼다. 실증 연구들은 투자자들이 이론상 최적보다 훨씬 적은 종목에 투자하는 과소분산을 반복해서 보여 준다. 보통 "사람들이 비합리적이라서"라고 설명되는 현상이다. 저자들은 다르게 묻는다 — 추정치를 믿지 못하는 것이 합리적이라면, 적게 분산하는 것도 합리적이지 않을까?
핵심 아이디어는 "불확실성 집합"이다. 진짜 기대수익과 진짜 상관관계는 모르지만, "대략 이 범위 안에 있을 것"이라는 정보는 있다. 이 논문은 그 범위 안의 최악의 경우에 대비하는 투자자를 모형화하고, 연속 시간(초 단위처럼 끊임없는 시간) 설정에서 최적 전략을 구한다.
놀라운 결론이 두 가지 나온다.
- 기대수익 추정을 신뢰하지 못하면, 위험자산을 아예 들지 않는다. 현금이 최선이 되는 것이다.
- 상관관계의 불확실성이 크면, 위험자산 한 종목만 산다. 여러 종목을 분산해서 담는 대신 한 종목으로 집중한다.
즉 "종목을 적게 드는" 행동은 하나의 원인이 아니라, 어떤 불확실성이 큰가에 따라 전혀 다른 형태로 나타난다는 것이다. 저자들은 이를 "분리 원리"라는 정리로 일반화해, 최적 전략을 계산하는 실용적 절차를 제공한다.
한계와 조심할 점
공개 코드가 없어(재현성 43) 직접 구현해야 한다. 그리고 주변 변동성과 상관관계를 동시에 불확실하게 다루지는 못한다 — 이론적 근거(공분산의 볼록성)를 잃기 때문이라는 한계를 저자들이 솔직하게 밝힌다.
다음 논문들: 위험 측정 도구 자체를 의심하기
같은 달의 다른 논문들이 이 태도를 여러 층위로 확장한다. Robustness in the Optimization of Risk Measures(70.1)은 위험을 재는 도구(VaR, ES 같은 위험측도)로 최적화할 때 그 최적화 결과 자체가 얼마나 흔들리는가를 따진다. 결론은 명료하다 — VaR로 최적화한 포지션은 모델 오차에 취약한 반면, ES 같은 볼록한 위험측도는 대체로 튼튼하다. Model Risk Measurement under Wasserstein Distance(63.7)은 "모델이 틀렸을 때"의 위험을 거리 개념으로 정량화하고, On the quasi-sure superhedging duality with frictions(62.9)는 거래비용과 모델 불확실성이 함께 있는 시장에서의 헤지 가격을 다룬다. 신용 쪽에서는 1809.09889(68.2)이 부도확률 추정의 모델 리스크와 등급 하락의 관성(momentum)을 함께 모형화해, 이 태도가 주식만의 이야기가 아님을 보여 준다.
이 테마의 공통 인사이트
"최적"이라는 말 앞에 "추정 오차를 감안한"이라는 조건을 붙이는 작업이, 화려한 예측보다 실무의 안전에 더 결정적이다. 리스크 한도와 종목 수 제약을 규칙이 아니라 불확실성의 함수로 설계하라는 이야기다.
테마 3: 변동성의 미스터리 — 시간을 되돌리면 다르다
왜 흥미로운가
옵션(특정 시점에 특정 가격으로 살 수 있는 권리)의 가격은 "앞으로 시장이 얼마나 흔들릴 것인가"에 달려 있다. 그래서 변동성 모형은 금융 공학의 심장부다. 그런데 2000년대 초 연구자 Gilles Zumbach는 이상한 사실을 발견했다 — "과거의 큰 움직임이 미래의 변동성을 예측하는 힘"과 "과거의 변동성이 미래의 큰 움직임을 예측하는 힘"이 서로 다르다는 것. 시간을 되돌리면(어제와 내일을 바꾸면) 통계가 달라지는, 시간역전 비대칭이라는 현상이다. 문제는 Heston을 비롯한 모든 통상적 변동성 모형이 이 현상을 구조적으로 만들 수 없다는 것이었다. 실제 시장에 있는 현상이 표준 모형에 없는 셈이다.
대표 논문: 거친 변동성이 미스터리를 푸는 방법
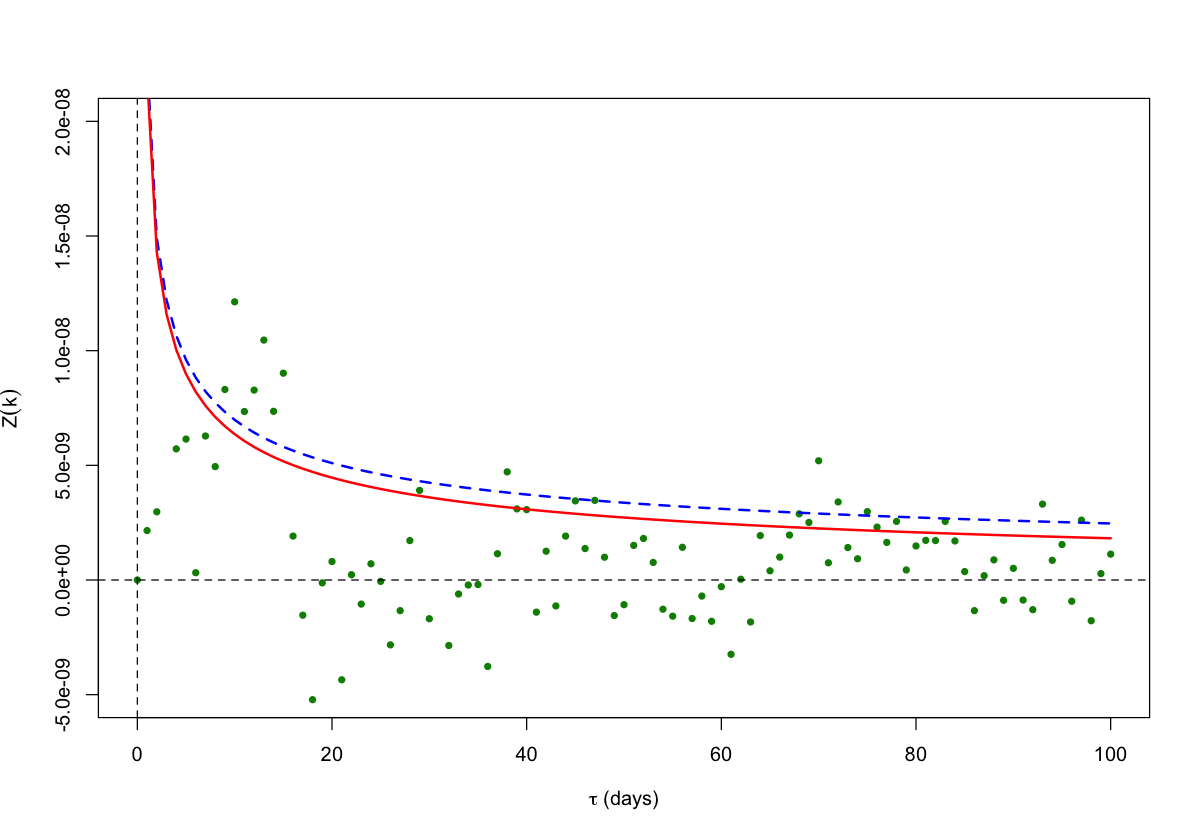
The Zumbach effect under rough Heston(에콜 폴리테크닉·바루크 칼리지, Jim Gatheral과 Mathieu Rosenbaum 등, 종합점수 67.0)은 이 수수께끼에 답한다. 저자들은 이 비대칭을 측정하는 통계량 Z(τ) — "τ일 전의 제곱 수익률과 오늘의 통합분산 사이의 관계"에서 시간을 뒤집은 관계를 뺀 값 — 를 정의하고, Oxford-Man Institute의 실현 변동성 자료(전 세계 지수 31개, 2000년 1월 3일부터 2018년 7월 25일)에서 이 값이 확실히 0이 아님을 확인한다.
그다음이 핵심이다. 2016년 이후 금융 공학을 뒤흔든 rough 변동성 모형 — 변동성이 우리가 알던 것보다 훨씬 거칠게(작은 Hurst 지수 H로) 움직인다는 모형 — 에서 Z(τ)를 해석적으로 계산한다. 시장 데이터에 맞는 파라미터(H = 0.05, 상관 −0.7 등)를 넣으면 모형이 계산한 비대칭이 실제 데이터의 추정치와 정성적·정량적으로 잘 들어맞는다.
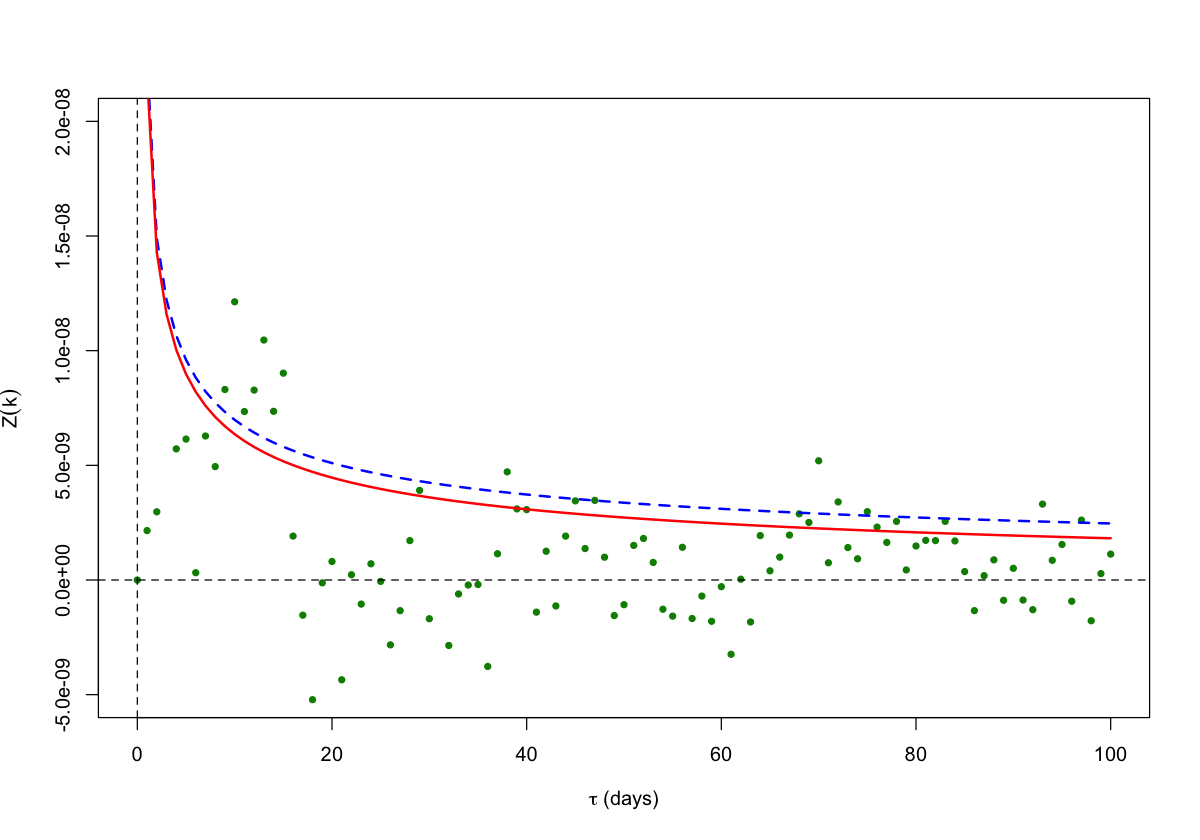
결정적인 반례 검증도 잊지 않았다. Hurst 지수를 1/2로 놓으면(즉 고전 Heston 모형으로 되돌리면) Zumbach 효과는 수치상 완전히 무시할 수준으로 사라진다. 효과의 크기가 간격의 δ^(2H) 제곱에 비례하기 때문에, 변동성이 거칠수록(H가 작을수록) 효과가 살아남고 부드러우면(H = 1/2) 소멸한다.
결론: "거친 변동성"은 스큐(옵션 가격의 기울기)를 맞추기 위한 임시 방편이 아니라, 시간역전 비대칭이라는 실증 사실까지 설명하는 필수 구조다. 이로써 rough 변동성 혁명(2016~2018)은 "실제 시장이 정말로 거칠다"는 결정적 증거를 하나 더 얻었다.
한계와 조심할 점
이 논문은 거래 전략이나 수익성을 제시하지 않는다 — 변동성 모형의 설명력을 검증하는 실증-이론 연구다. 모형 값이 실제 추정치보다 다소 높게 나오는데, 저자들은 위험중립 측정(가격결정용)과 실측 측정(실제 데이터)의 차이를 원인으로 꼽는다.
다음 논문들: 정확한 계산과 모델 없는 헤지
같은 테마의 다른 논문들은 "모형을 정확하게 풀기"와 "모형에 덜 의존하기" 두 방향으로 간다. Exact Solutions for a GBM-type Stochastic Volatility Model(69.0)은 변동성이 안정된 분포를 갖는 모형에서 옵션 가격을 특수함수로 정확히 계산하는 해를 제시한다. Long-time trajectorial large deviations(68.5)는 확률적 변동성 모형의 이론을 옵션 가격 몬테카를로 계산의 분산 줄이기(더 빠르게 수렴시키기)에 연결한다. 반면 Model-free trading and hedging(65.0)은 확률 모형 자체를 가정하지 않고 연속 가격 경로에 대한 헤지·복제를 구성하는 프레임워크를 제시하고, Derivatives pricing using signature payoffs(63.9)는 경로의 "지문"(시그니처)으로 복잡한 경로 의존형 파생상품의 가격을 계산한다. 미국형 옵션의 계산을 새 관점에서 푸는 연구(1809.07300, 57.7)와, 거친 변동성 아래에서의 포트폴리오 최적화(1809.10716, 59.8)도 같은 흐름에 놓인다.
이 테마의 공통 인사이트
파생 가격결정의 전선이 "어떤 모형이 맞나"에서 "모형이 틀려도 버티는 계산"으로 옮겨가고 있다. 모형을 정교하게 만드는 일과, 모형에 의존하지 않는 안전장치를 만드는 일이 나란히 진행 중이다.
테마 4: 포트폴리오 구축 — '놀라운 알파'의 정체는 분산이었다
왜 흥미로운가
2013년 금융 업계에 작은 충격이 있었다. "몰키엘의 원숭이" — 주식을 아무렇게나 골라 담아도, 심지어 무작위로 담아도, 유명한 시가총액가중 지수를 장기적으로 이긴다는 사실이었다. 보통 사람들은 "그 종목들이 더 잘 오르는 이유가 있을 것"(요인 노출의 이점)이라고 생각했다. 그런데 정말 그럴까?
대표 논문: 같은 성과, 다른 설명
Diversification, Volatility, and Surprising Alpha(Intech·런던 정치경제대학교(LSE), 종합점수 60.4)는 이 수수께끼에 아주 소박한 답을 제시한다. 저자들은 포트폴리오의 로그수익률을 두 부분으로 나눈다.
- 종목별 수익률의 가중평균 — "좋은 종목을 골랐는가"의 부분.
- 초과성장률(excess growth) — 포트폴리오를 분산해서 담는 것만으로 생기는 추가 수익. 이 항은 종목들의 분산과 공분산만으로 결정된다.
그다음 1964년부터 2012년까지 미국 시가총액 상위 1000개 종목을 매일 크기 순으로 줄 세우고, 순위별 수익률과 분산을 측정하는 대규모 실증을 돌린다.
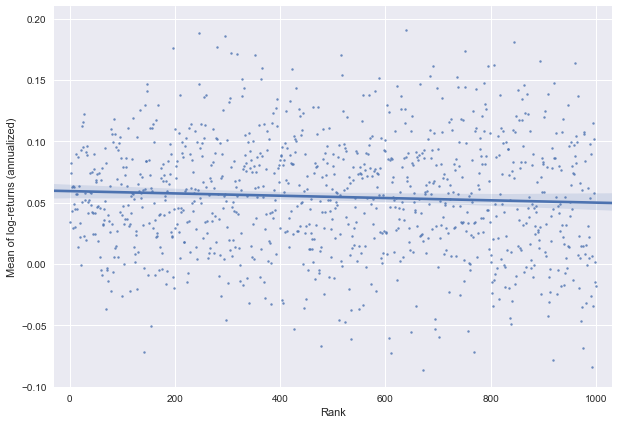
결과는 놀랍다.
- 첫 번째 항(종목별 수익률)은 모든 포트폴리오에서 거의 같다. 순위별 기대 수익률의 차이가 생각보다 작다. "좋은 종목을 골라서 이겼다"는 설명이 힘을 잃는 지점이다.
- 포트폴리오 간 격차는 두 번째 항(초과성장률)에서 거의 전부 나온다. 소형주 비중이 커서 더 분산된 포트폴리오일수록 초과성장률이 크고, 이것이 로그수익률을 끌어올린다.
한마디로: 동일가중 전략이 이기는 이유는 그 종목들의 기대수익이 본질적으로 높아서가 아니라, 분산이 만들어 내는 수학적 보너스가 크기 때문이다. 소형주일수록 변동성이 크고, 변동성이 큰 종목을 많이 섞을수록 이 보너스가 커진다. 저자들은 이렇게 요약한다 — "요인(factor)을 동원하지 않고도 '놀라운 알파'가 설명된다."
한계와 조심할 점
이 논문은 새 거래 전략을 제시하는 것이 아니라 성과의 원인을 재해석하는 연구다. 거래비용과 리밸런싱 비용은 이 분해에 포함되지 않으므로, 실제 전략 평가에서는 별도로 봐야 한다.
다음 논문들: '담는 수학'의 여러 층위
같은 달의 다른 논문들도 "무엇을 사는가"보다 "어떻게 담는가"에 무게를 둔다. Trading Strategies Generated Pathwise by Functions of Market Weights(66.1)은 시장비중이라는 관측 가능한 정보만으로 전략을 생성하는 이론을 확장하고, Optimal Dynamic Basis Trading(66.4)은 선물과 현물의 가격 차이(베이시스)를 노리는 거래의 최적 동적 전략을 위험선호도에 따라 명시적으로 도출한다. Diversity and Sparsity(62.5)는 지수 추종에서 "종목을 적게 담되(희소성) 서로 다르게 담는(다양성)" 두 목표를 하나의 최적화 문제로 묶는다.
이 테마의 공통 인사이트
수익률의 상당 부분은 종목 선택이 아니라 '담고 유지하는 수학'에서 나온다. 백테스트의 초과수익을 신호의 공으로 돌리기 전에, 분산 구조가 만드는 보너스를 먼저 분리해 제거해야 한다.
테마 5: 기계학습의 조용한 진입 — 예측기가 아니라 '계산기'로
왜 흥미로운가
"AI가 주가를 예측한다"는 이야기는 이제 흔하지만, 2018년 9월의 기계학습 연구들은 훨씬 실용적인 곳에 서 있었다. 당장 필요한 것은 대단한 예측이 아니라, 너무 느린 계산을 빠르게 바꾸는 일이었다.
대표 논문: 옵션 가격을 100만 배 빠르게
Deeply Learning Derivatives(캐나다 스코티아은행(Scotiabank)의 산업 연구, 종합점수 61.0)은 파생상품 가격 계산을 신경망으로 대체한다. 파생상품 평가는 결국 "시장 데이터 + 거래 조건 → 가격"의 함수이고, 이 함수는 보통 몬테카를로 시뮬레이션처럼 계산량이 큰 방법으로만 얻을 수 있다. 저자들은 이 함수를 심층 신경망이 대신하게 한다.
시험 문제는 의도적으로 까다로운 것을 골랐다 — 6개 종목 중 최저가에 연동된 콜옵션(worst-of 바스켓 유럽형 콜). 입력이 28차원이고 몬테카를로로만 평가할 수 있는 구조다. 숫자를 따라가 보자.
- 기준 데이터의 비용: 1센트 수준의 정확한 가격을 만들려면 몬테카를로 시뮬레이션을 1억 개 경로씩 돌려야 하고, 옵션 한 건에 약 300초가 걸린다. 테스트 데이터를 만드는 데만 24코어 서버로 일주일 넘게 걸렸다. 정확도를 5센트(100만 경로), 20센트(10만 경로)까지 허용하면 각각 약 1시간 45분, 약 10분으로 줄어든다.
- 신경망의 정확도: 학습된 신경망의 오차는 10만 개 시나리오를 쓴 몬테카를로와 비슷한 수준이다.
- 신경망의 속도: 그 10만 시나리오 몬테카를로가 CPU로 10분 넘게 걸린 계산을, 신경망은 그래픽카드(GPU)에서 6밀리초 미만에 끝낸다 — 더 싼 하드웨어에서. 작은 모델은 2만 건의 평가를 50마이크로초 안에, 큰 모델은 5만 건을 6밀리초 안에 처리한다. 원문 초록의 표현대로 전통 모델 대비 "약 100만 배" 빠른 처리량이다.
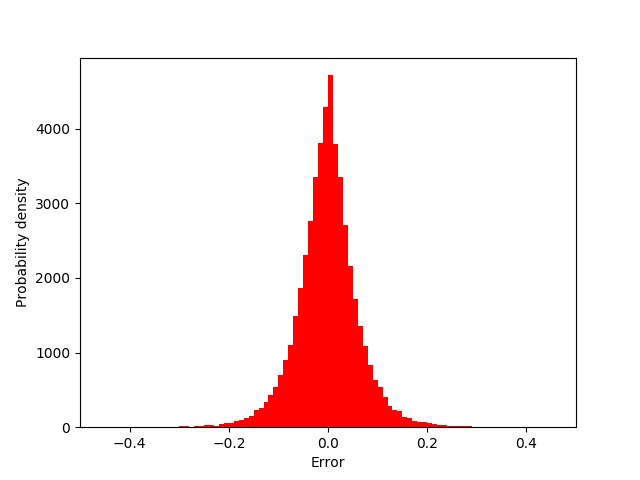
여기에 재미있는 부수 발견이 있다. 신경망을 학습시킬 때는 정확한 값이 아니라 노이즈가 섞인 몬테카를로 결과를 교재로 쓰게 되는데, 학습을 마친 신경망의 오차는 그 교재의 노이즈보다 작았다. 신경망이 몬테카를로의 무작위 오차를 평균 내어 배운 것이다. 반면 모델을 너무 키우면(층당 600노드) 과적합이 확실히 나타났다 — 학습 오차는 계속 내려가는데 검증 오차는 그대로였다.
한계와 조심할 점
학습한 범위 안에서만 신뢰할 수 있다. 입력(시장 상황)이 학습 데이터의 분포 밖으로 나가면 근사가 무너진다 — 오차가 큰 사례는 대체로 학습 분포의 경계에서 나왔다. 모니터링과 재학습이 필수다. 검증한 제품도 단일 구조(바스켓 옵션)이고, 공개 코드가 없어(재현성 38) 직접 구현해 확인해야 한다. 또한 스코티아은행 소속 연구라는 점 — 산업 현장의 계산 니즈에서 출발한 실무 밀착 연구라는 장점과, 상업적 맥락이 있다는 점을 함께 읽어야 한다.
다음 논문들: 예측의 신뢰성과 새로운 데이터
같은 달의 다른 기계학습 연구들은 '예측'보다 '예측의 신뢰성'과 '새로운 감각'에 가깝다. IPAD(64.5)는 수많은 변수 중 진짜 신호를 고를 때 거짓 발견의 비율(FDR)을 통계적으로 통제하는 안정적 예측 방법을 제안한다. 신경망이 고차원 편미분방정식(Black–Scholes 방정식)에서 "차원의 저주"를 극복함을 증명하는 이론 연구도 두 편(1809.02362, 1809.03062) 나왔다. 데이터 쪽에서는 비트코인의 온체인 거래 그래프가 단기 극단 변동성의 조기 경보가 될 수 있다는 연구(1809.07856, 58.6), 그리고 수학적 형태 분석(위상 데이터 분석)으로 암호화폐 시장의 임계전이 — 폭락 같은 급격한 상태 변화 — 를 조기에 인식하려는 시도(1809.00695, 58.0)가 있다.
이 테마의 공통 인사이트
기계학습은 먼저 "예측기"가 아니라 "계산기와 센서"로 금융에 들어왔다. 계산을 대체하고, 검증 가능한 신호를 만들고, 새로운 데이터 원천을 여는 일 — 화려한 알파 주장보다 먼저 와야 할 일들이다. 이 2018년의 기록은 이후 금융 AI가 실제로 어떤 방향으로 커졌는지 정확히 예고한다.
월 전체 Big Picture
2018년 9월의 다섯 이야기는 한 문장으로 모인다 — "시장은 스스로를 움직이고, 모형은 스스로를 의심하며, 계산은 대체될 수 있다." 호가창이 기울어진 순간에만 시장 내생성이 폭증한다는 실증(테마 1)은, 시장을 외부 정보만으로 읽을 수 없다고 말한다. 그래서 어떤 최적화도 추정 오차를 품은 '강건한' 형태여야 하고(테마 2), 변동성 모형은 시간역전 비대칭이라는 미스터리까지 설명해야 하며(테마 3), 투자 성과의 상당 부분은 분산의 수학에서 나오고(테마 4), 계산 자체는 신경망이 대신할 수 있다(테마 5).
이 달이 특별한 이유는 "우리가 아는 것의 한계"를 정면으로 다룬 논문들이 상위권을 채웠다는 점이다. 1위 논문은 "시장의 반사성이 항상이 아니라 간헐적으로만 작동한다"고 보고했고, 2·3위는 "최적화의 결과는 모형을 믿는 정도에 달렸다"고 증명했으며, '놀라운 알파'의 정체는 의외로 소박한 분산 수학이었다. 2018년 9월 — 약세장의 가을에, 수학금융이 자만을 내려놓고 "불확실성을 품은 정밀함"으로 한 걸음 옮기던 순간의 기록이다. 투자와 연구의 기본기가 화려한 예측이 아니라 자신의 모형이 틀릴 수 있음을 전제로 설계하는 태도라는 것을, 이 논문들은 조용히 말해 준다.
더 알아보기
원문 링크와 5차원 평가 점수
이 글에서 다룬 논문들의 원문과, 우리 지식 베이스가 매긴 5차원 점수입니다(신규성 / 적용성 / 엄밀성 / 재현성 / 통찰, 종합점수는 이들의 가중 합).
우리 지식 베이스에서 함께 읽을 논문
- Hawkes·미시구조 계열: Asymmetric excitation of left- and right-tail extreme events, The self-exciting nature of the bid-ask spread dynamics, Order Book Queue Hawkes-Markovian Modeling
- 강건 최적화 계열: Markov Decision Processes under Model Uncertainty, Data-driven Multiperiod Robust Mean-Variance Optimization, Portfolio Diversification and Concentration under Dependence Uncertainty, Robust Equilibrium Strategy for Mean-Variance Portfolio Selection
- 거친 변동성 계열: The quadratic rough Heston model and the joint S&P 500/VIX smile calibration, Short dated smile under Rough Volatility, From quadratic Hawkes processes to super-Heston rough volatility models
- 포트폴리오 구축 계열: Diversified reward-risk parity in portfolio construction, Asset and Factor Risk Budgeting, A return-diversification approach to portfolio selection
- 파생 가격 딥러닝 계열: Unbiased deep solvers for linear parametric PDEs, Deep Learning Volatility, Solving high-dimensional optimal stopping problems using deep learning
이 글은 2018년 9월 arXiv 백필 코호트(전체 115편, 관련 82편)의 평가 결과를 바탕으로 작성했습니다. 모든 수치는 원문 논문에서 인용했으며, 블로그 성격상 일부 이론적 세부사항은 생략했습니다. 심층 분석은
analysis/reports/backfill/1809.md를 참고하세요.
📚 이 글에서 다룬 논문 (43편)
- AState-dependent Hawkes processes and their application to limit order book modelling
Maxime Morariu-Patrichi, Mikko S. Pakkanen
- APortfolio diversification and model uncertainty: a robust dynamic mean-variance approach
Huyen Pham, Xiaoli Wei, Chao Zhou
- ARobustness in the Optimization of Risk Measures
Paul Embrechts, Alexander Schied, Ruodu Wang
- ACapturing Model Risk and Rating Momentum in the Estimation of Probabilities of Default and Credit Rating Migrations
Marius Pfeuffer, Goncalo dos Reis, Greig smith
- AThe Zumbach effect under rough Heston
Omar El Euch, Jim Gatheral, Radoš Radoičić 외 1명
- A
- ATrading Strategies Generated Pathwise by Functions of Market Weights
Ioannis Karatzas, Donghan Kim
- B
- BOn the quasi-sure superhedging duality with frictions
Erhan Bayraktar, Matteo Burzoni
- B
- BPortfolio Optimization in Fractional and Rough Heston Models
Nicole Bäuerle, Sascha Desmettre
- BTail probabilities for short-term returns on stocks
Henrik O. Rasmussen, Paul Wilmott
- BPricing American Options by Exercise Rate Optimization
Christian Bayer, Raúl Tempone, Sören Wolfers
- BDiversity and Sparsity: A New Perspective on Index Tracking
Yu Zheng, Timothy M. Hospedales, Yongxin Yang
- BA Block Coordinate Ascent Algorithm for Mean-Variance Optimization
Bo Liu, Tengyang Xie, Yangyang Xu 외 4명
- BMean-Field Leader-Follower Games with Terminal State Constraint
Guanxing Fu, Ulrich Horst
- BDiversification, Volatility, and Surprising Alpha
Adrian Banner, Robert Fernholz, Vassilios Papathanakos 외 2명
- B
- BIPAD: Stable Interpretable Forecasting with Knockoffs Inference
Yingying Fan, Jinchi Lv, Mahrad Sharifvaghefi 외 1명
- BA proof that artificial neural networks overcome the curse of dimensionality in the numerical approximation of Black-Scholes partial differential equations
Philipp Grohs, Fabian Hornung, Arnulf Jentzen 외 1명
- BInferring short-term volatility indicators from Bitcoin blockchain
Nino Antulov-Fantulin, Dijana Tolic, Matija Piskorec 외 2명
- BTopological recognition of critical transitions in time series of cryptocurrencies
Marian Gidea, Daniel Goldsmith, Yuri Katz 외 2명
- AAsymmetric excitation of left- and right-tail extreme events probed using a Hawkes model: application to financial returns
Matthew F. Tomlinson, David Greenwood, Marcin Mucha-Kruczynski
- AThe self-exciting nature of the bid-ask spread dynamics
Ruihua Ruan, Emmanuel Bacry, Jean-François Muzy
- BOrder Book Queue Hawkes-Markovian Modeling
Philip Protter, Qianfan Wu, Shihao Yang
- AMarkov Decision Processes under Model Uncertainty
Ariel Neufeld, Julian Sester, Mario Šikić
- AData-driven Multiperiod Robust Mean-Variance Optimization
Xin Hai, Gregoire Loeper, Kihun Nam
- BRobust Equilibrium Strategy for Mean-Variance Portfolio Selection
Mengge Li, Shuaijie Qian, Chao Zhou
- AThe quadratic rough Heston model and the joint S&P 500/VIX smile calibration problem
Jim Gatheral, Paul Jusselin, Mathieu Rosenbaum
- AShort dated smile under Rough Volatility: asymptotics and numerics
Peter K. Friz, Paul Gassiat, Paolo Pigato
- AFrom quadratic Hawkes processes to super-Heston rough volatility models with Zumbach effect
Aditi Dandapani, Paul Jusselin, Mathieu Rosenbaum
- ADiversified reward-risk parity in portfolio construction
Jaehyung Choi, Hyangju Kim, Young Shin Kim
- AAsset and Factor Risk Budgeting: A Balanced Approach
Adil Rengim Cetingoz, Olivier Guéant
- BA return-diversification approach to portfolio selection
Francesco Cesarone, Rosella Giacometti, Manuel Luis Martino 외 1명
- AUnbiased deep solvers for linear parametric PDEs
Marc Sabate Vidales, David Siska, Lukasz Szpruch
- A
- BSolving high-dimensional optimal stopping problems using deep learning
Sebastian Becker, Patrick Cheridito, Arnulf Jentzen 외 1명
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2024-07 월간A
2024년 7월 금융 AI 논문 리뷰: M6 우승 전략, 거친 변동성, 연준의 속마음
2024년 7월 arXiv 금융 논문 309편을 분석했습니다. M6 대회 우승의 하이퍼네트워크 포트폴리오, 거친 변동성 검정, 약한 팩터 이론, GPT-4가 읽는 연준 회의록의 이견, 지정가 체결의 음의 드리프트까지 5가지 테마로 정리합니다.
 📊 2019-07 월간A
옵션 가격결정과 거친 변동성, 그리고 Quant GANs: 2019년 7월 금융 AI 논문
2019년 7월 arXiv 금융 AI 연구를 5개 테마로 정리했습니다. 모델 없이 옵션 가격 상한을 구하는 수학, 미시구조에서 태어나는 거친 변동성, 금융 시계열을 생성하는 Quant GANs, 로보 투자의 진짜 수혜자, 강화학습 자산배분 — 생성형 AI 이전의 기초 공사 현장을 다룹니다.
 📊 2019-05 월간A
2019년 5월 금융 AI 논문: 시그니처 파생상품, 거친 변동성, 백테스트 과적합
파생상품 가격을 모델 없이 정하는 시그니처 기법, 변동성이 정말 거칠다는 통계적 재검증, 백테스트 과적합을 공분산 페널티로 보정하는 실증, 고빈도 공적분 검정의 재정식화까지. 2019년 5월 arXiv 금융 AI 연구를 5개 테마로 정리했습니다.