2018년 8월. 지금 우리가 "금융 AI"라 부르는 세계가 태어나기 직전이었다. 그 달에, 옥스퍼드의 연구자들이 주식 주문장(호가창)의 원시 데이터를 딥러닝으로 읽어 가격을 예측하는 논문 하나를 올렸다 — 오늘날 DeepLOB이라 불리는, 그 뒤 수년간 이 분야의 표준이 된 연구다. 그런데 그 달 논문 75편 중 압도적 다수는 AI가 아니라 수학금융의 기초 체력을 다듬는 글들이었다. 옵션 가격 곡선(스마일)의 수학, 미래 예측의 불확실성을 계산하는 공식, "모형이 틀렸을 때"를 상정한 위험 측정, 그리고 이 모든 것을 실무 속도로 돌리게 만드는 계산 기법. 오늘은 그 다섯 갈래 이야기를 차근차근 풀어본다.
들어가며: "금융 AI" 이전의 마지막 여름에 일어난 일
2018년 8월의 arXiv 금융 카테고리에는 75편의 논문이 올라왔고, 그중 55편이 우리 기준의 "관련 논문"이었다. 상위 7편이 A등급을 받았지만 S등급은 없었다 — 이 글의 끝에 "상대 등급"이라는 주의사항을 다시 짚을 텐데, 이건 "이 달 논문이 별로였다"는 뜻이 절대 아니다.
이 달의 분포를 보면 성격이 바로 드러난다. 시계열 계량경제학(변동성·예측 모형) 22편과 포트폴리오 최적화 19편이 관련 논문의 약 75%를 차지한다. 딥러닝·강화학습·자연어처리를 쓴 논문은 합쳐서 3편뿐이다. 즉 2018년 8월의 금융 연구란, 대략 이런 질문에 매달린 달이었다:
"가격·변동성·위험을 어떻게 하면 조금 더 정직하게 수학으로 표현할 수 있을까?"
그리고 그 정직한 수학의 한복판에, 우연처럼(아니, 필연처럼) 딥러닝 논문 한 편이 끼어 있었다. 다섯 갈래로 따라가 보자.
테마 1: 옵션의 "웃음곡선", 스마일의 수학
왜 흥미로운가
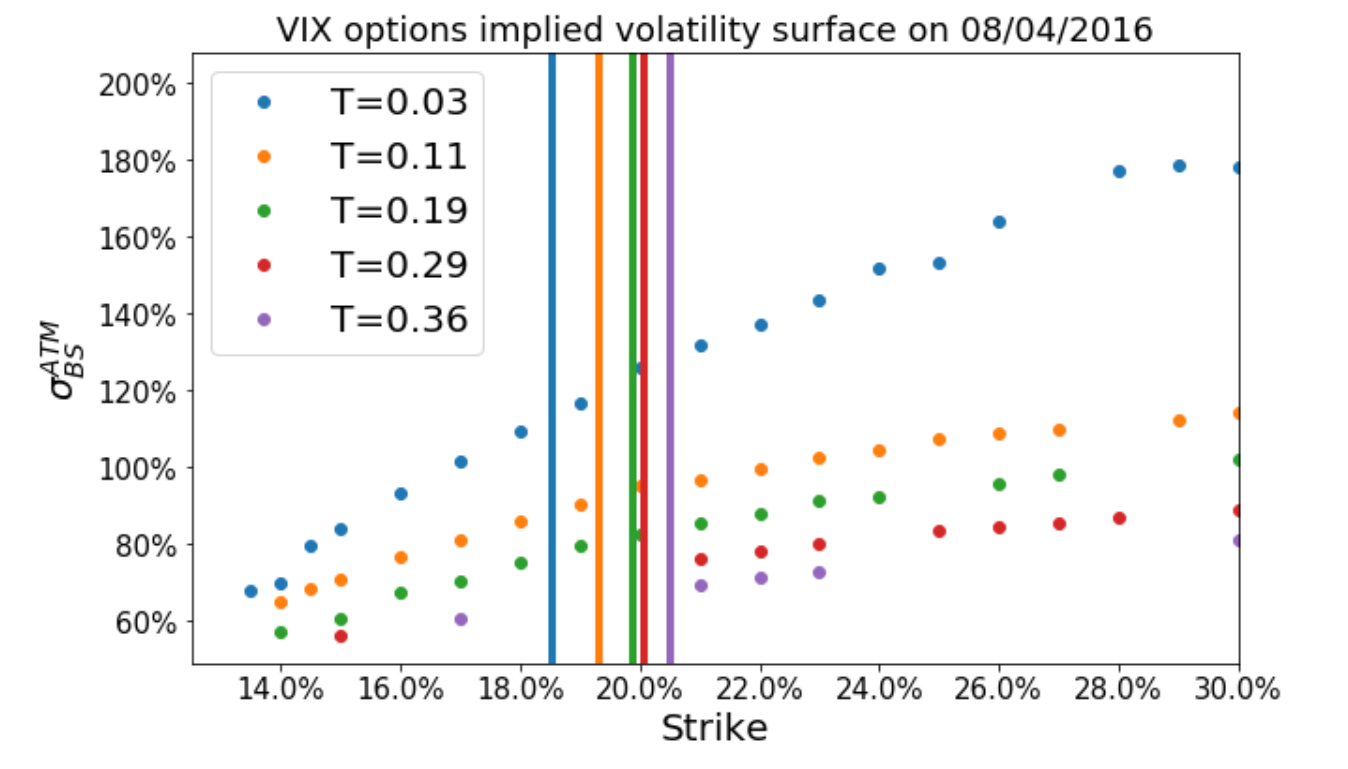
옵션 가격을 행사가격별로 늘어놓으면 내재변동성이란 숫자가 마치 살짝 웃는 입 모양처럼 배열된다 — 그래서 "스마일(smile)"이라 부른다. 쉽게 말하면 "얼마나 큰 폭등·폭락이 올지에 대한 시장의 평가가 행사가격마다 다르다"는 뜻이다. 문제는 이 곡선을 설명하는 모형이 여러 갈래로 갈라져 있어, 서로 다른 계약(예: 원유 선물 옵션)에 적용하면 서로 어긋난다는 점이다. 2018년 8월의 이 테마는 "스마일은 장식이 아니라, 모형의 성적표"라는 관점에서 출발한다.
대표 논문: 상품 시장의 스마일을 하나로 모으다 — Smile Modelling in Commodity Markets
이탈리아의 은행·연구소 공동 연구팀(Nastasi, Pallavicini, Sartorelli)이 낸 이 논문은, 원유 같은 상품 선물 옵션의 가격을 매기는 실무 문제를 정면으로 다룬다.
무엇이 문제였나
상품 시장에서는 선물이 제일 유동적이고, 옵션은 그 선물 가격에 대해 거래된다. 그런데 정작 시장에 호가되는 바닐라 옵션은 선물마다 보통 한두 개 만기뿐이다. 가격을 맞추는 데 쓸 재료가 극히 적은 셈이다. 거기에 상품 시장만의 제도 — 선물 만기의 인도 절차, 청산소가 매기는 증거금 절차 — 까지 가격에 관여한다. 곡선(만기별 가격 구조)과 스마일을 동시에, 그것도 시장이 열리는 속도에 맞춰 빠르게 보정하는 모형이 필요했다.
핵심 아이디어
세 가지를 겹쳤다.
- "정규화된 스팟"이라는 축약. 복잡한 인도 절차를 흡수한 하나의 가격 과정을 정의해, 선물 곡선 전체를 한 번에 다룬다.
- 고전 공식(Dupire 방정식)을 상품에 맞게 고쳐, 빠른 보정. 시장 데이터가 적어도 흔들리지 않게 파라미터를 절제하고, "가격을 맞추고 → 다시 맞추고"를 반복하는 계산을 앤더슨이란 수법으로 가속한다.
- 시장이 알려주는 답과 대조. 원유의 인접 선물 두 개 차이에 대한 옵션(캘린더 스프레드 옵션)이 암시하는 "변동성 하락분"을 실제 시장 호가에서 역산해, 모형의 평균회귀 속도를 맞췄다.
결과 — 무엇을 알아냈나
- 선물 옵션 가격과 확률분포를 한 번의 계산으로 함께 얻는 구조를 만들어, 곡선 전체를 실시간에 가깝게 다룰 수 있게 됐다.
- 실제 시장 검증: 시카고 상품거래소(CME)의 WTI 원유 캘린더 스프레드 옵션 호가(2018년 5월 23일 기준, 첫 18개 만기)를 놓고 보니 평균회귀 속도가 약 0.5일 때 시장 호가 대부분과 일치했다.
- 청산 증거금·담보 절차 같은 "제도적 사실"까지 가격화 틀 안에 넣었다 — 실무 청산 환경과 맞닿은 지점이다.
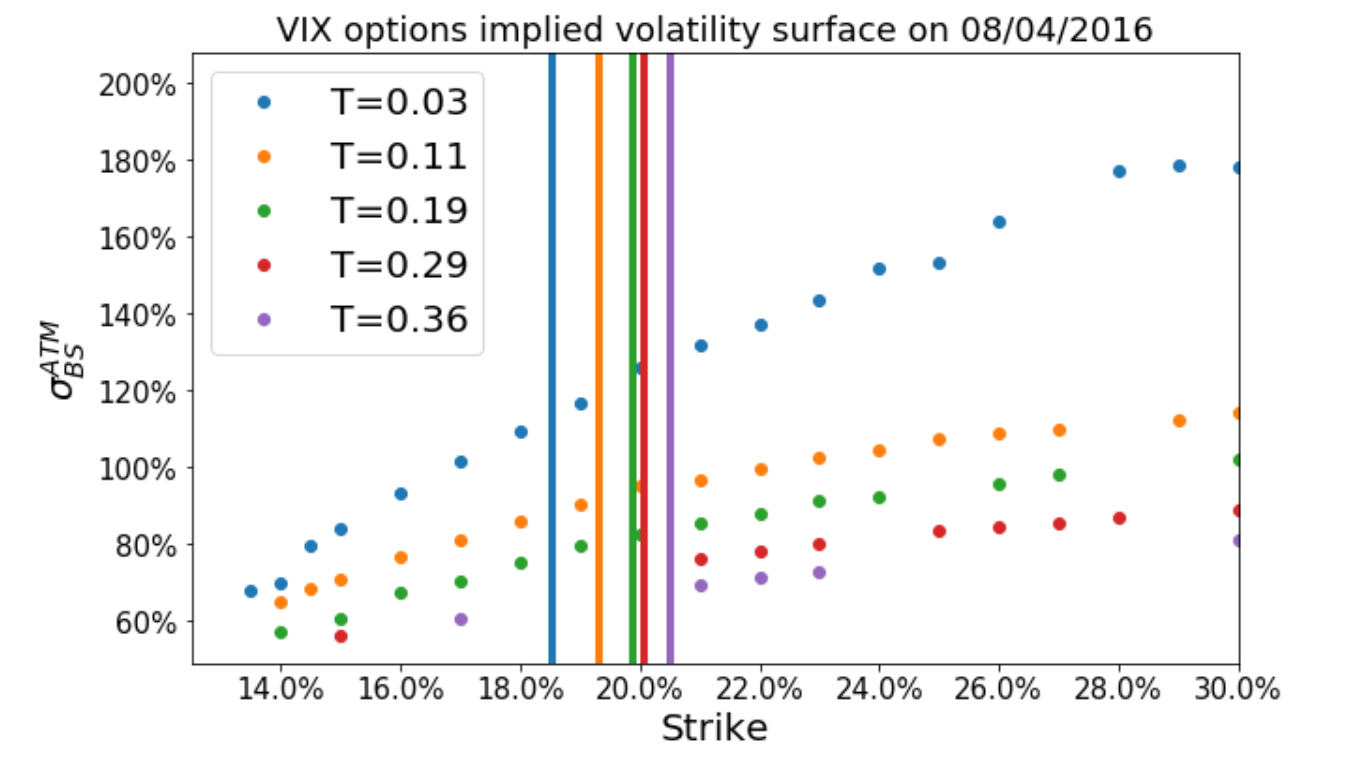
(그림 설명: 아래 그림은 같은 테마 논문(1808.03610)이 그린 VIX 옵션의 내재변동성 표면이다. 만기(오른쪽 축)와 행사가격(앞쪽 축)에 따라 변동성이 어떻게 굽어지는지 한눈에 보여 주는, 이 테마의 핵심인 "스마일의 얼굴"이다. 대표 논문 자체의 그림은 원문에서 캡션 정보를 제공하지 못해 같은 테마의 그림으로 대체했다.)
한계와 주의점
논문 스스로 밝히듯, 여러 요인을 모두 확률적으로 두는 최종 단계의 보정 절차는 미완이다(설계까지만 제시). 수치 예제가 원유 중심이고, 코드도 공개되어 있지 않다. "바로 쓸 수 있는 완성품"이라기보다 믿을 만한 출발점에 가깝다.
그래서 투자/실무엔?
원자재 파생상품을 다루는 팀이라면 "곡선과 스마일을 하나의 모형으로, 빠르게"라는 요구사항이 무엇을 뜻하는지 이 논문이 잘 보여 준다. 우리 같은 자기자본 운용 관점에서는, 덜 유동한 파생상품의 가격을 모형으로 때울 때 어떤 제도적 조건(증거금, 인도)을 반영했는지가 가격 차이를 만든다는 교훈이 남는다.
함께 읽을 논문
- VIX 스큐의 비밀 (1808.03610) — "공포지수" VIX 옵션의 스마일이 왜 이렇게 굽어 있는지를 고급 수학(말리아뱅 미적분)으로 설명하고, 어떤 변동성 조건에서 그 곡선이 만들어지는지 밝힌다. 통찰 점수 78로 이 달 최고.
- 모멘트가 폭발하는 모형 (1808.00421) — 변동성 함수가 너무 빠르게 커지는 모형에서는 자산가격의 고차 모멘트(극단 사태의 크기와 관련된 수치)가 아예 계산 불가능하게 "폭발"한다. 스마일의 꼬리가 어디서 오는지에 대한 극단적 경고.
- 확률 없이 옵션을 가격 매기기 (1808.09378) — 확률 가정을 전부 버리고 가격 경로 자체의 정보만으로 옵션을 복제·헤지하는 파격적 접근. 모형이 조금 틀려도 헤지가 부드럽게 유지된다는 점이 실무적 매력.
이 테마의 공통 인사이트
스마일 곡선은 "예쁘게 웃는 입"이 아니라 모형이 놓치고 있는 것의 보고서다. 로컬 변동성으로 설명하든, 확률 변동성으로 설명하든, 꼬리의 수학으로 설명하든 — 시장이 그려내는 곡선과 모형의 곡선이 어긋나는 지점이 곧 다음에 고쳐야 할 곳이다.
테마 2: 미래 예측의 "오차 표시" — 시뮬레이션 없이 분포 그리기
왜 흥미로운가
내일의 변동성을 예측해 보면 숫자 하나가 나온다. 예컨대 "내일 변동성은 1.2%". 그런데 그 예측 자체가 틀릴 확률은? 2일 뒤, 5일 뒤로 갈수록 예측은 퍼져야 정상이다. 이 "퍼짐"을 알려면 보통 컴퓨터로 수만 번 시뮬레이션을 돌려야 했다 — 느리고 비싸다. 2018년 8월의 이 테마는 "시뮬레이션 없이, 공식만으로 예측의 불확실성을 그리는" 방법과, 우리가 흔히 쓰는 성과 지표가 얼마나 흔들리는지를 정직하게 말하는 연구들로 채워져 있다.
대표 논문: GARCH 예측분포를 공식으로 — Analytic Moments for GARCH Processes
영국의 세 연구자(Alexander, Lazar, Stanescu)가 낸 이 논문은, 변동성 예측의 고전 모형인 GARCH 계열의 "예측이 퍼지는 정도"를 전부 공식으로 뽑아냈다.
무엇이 문제였나
GARCH 모형은 "변동성이 커졌다가 작아졌다"는 사실을 잘 잡는 유명한 모형이다. 다만 여기서 "5일 뒤 분산"을 물으면, 그 답은 하나의 숫자가 아니라 확률적으로 흔들리는 값이다. 이 흔들림을 무시하고 점 하나만 쓰면, 리스크 관리에서 꼬리(극단 손실)를 과소평가하게 된다. 그런데 이 흔들림을 알려면 시뮬레이션이 필요했고, 기존 연구는 모형별·차수별로 조각조각 나 있었다.
핵심 아이디어
- 모든 조건부 모멘트를 한꺼번에 해석적으로 유도. 평균·분산·왜도·첨도(1~4차 모멘트)를 미래 1시점과 여러 시점 누적에 대해 전부 공식으로 정리했다. 어떤 모양의 충격 분포(혁신분포)를 가정해도 성립하는 일반형이라, 기존의 특수한 공식들이 전부 안에 들어간다.
- "길게 보면 정규분포로 수렴"을 증명. 예측 지평이 길어지면 누적 수익률의 모멘트가 정규분포의 모멘트로 수렴한다는 조건을 정확히 밝혔다.
- 공식 → 분포. 구한 4개 모멘트로 잘 알려진 확률분포(Johnson SU 분포나 Edgeworth 전개)를 맞추면 분포 전체를 얻는다. 시뮬레이션 불필요.
결과 — 무엇을 알아냈나
- 왜도(좌우 비대칭)의 두 가지 축을 구분했다: 충격 분포의 비대칭성, 그리고 "떨어지는 충격에 변동성이 다르게 반응하는" 비대칭성. 여러 날을 누적하면 충격이 대칭이어도 결과가 한쪽으로 쏠릴 수 있다는, 직관과 살짝 다른 발견이다.
- 첨도(꼬리의 두께)의 두 가지 축: 충격 자체의 꼬리 두께 + 예측 변동성 자체의 불확실성. 1일 뒤 예측은 꼬리가 충격분포와 같지만, 2일 뒤부터는 "예측이 흔들린다"는 사실만으로 꼬리가 두꺼워진다. 쉽게 말하면 멀리 볼수록 예측은 낙관적으로 보이면 안 된다는 뜻이다.
- 실증 검증(미국 S&P 500 지수, 유로/달러 환율, 3개월 만기 미 국채금리): 공식으로 만든 예측분포가 시뮬레이션으로 만든 분포와 통계 검정에서 대부분 매우 잘 일치했다.
한계와 주의점
모수 추정이 잘 돼야 하고, 시장이 대체로 안정적(정상적)이라는 가정에 의존한다. 모형의 구조가 바뀌는 국면(위기, 규제 변화)은 이 공식의 밖이다. 공개 코드가 없어 재현성 점수는 45.
그래서 투자/실무엔?
리스크 한도·손실 한도(VaR, ES)를 빠르게 갱신해야 하는 환경에서, 시뮬레이션 대신 공식을 쓰면 계산 비용이 확 줄면서도 꼬리를 놓치지 않는다. 그리고 "2시점 이상 예측에서는 첨도가 커진다"는 결과는 분산의 점 예측만 쓰는 관행에 대한 직접적인 경고다.
함께 읽을 논문
- 샤프 비율은 얼마나 흔들릴까 (1808.04233) — 전략 성과의 표준 지표인 샤프 비율이 표본에서 어떻게 흔들리는지를 t-통계량과 연결해 계산한다. "샤프 1.2 vs 1.3"이 우연인지 아닌지 따질 때 필요한 기준.
- 유가의 난류 국면 (1808.09382) — 유가 시계열의 다중 스케일 구조를 파고들어 "난류처럼 돌변하는 국면"의 전환을 탐지한다.
- 고차원 데이터의 통계 함정 (1808.02953) — 종목이 많아지면(고차원) 표준 통계 기법이 왜 무너지는지, 공분산 추정·주성분 분석 등을 어떻게 고쳐야 하는지 정리한 글.
- 프라이버시를 지키면서 변화점 찾기 (1808.10056) — 데이터를 보호하면서도 분포가 바뀌는 지점을 찾아내는 방법의 이론적 한계를 제시한다.
이 테마의 공통 인사이트
이 논문들은 공통적으로 "점 추측을 그만두자"고 말한다. 예측이든 성과 지표든, 그 숫자가 서 있는 표본과 가정의 흔들림을 함께 보여 줘야 판단이 정직해진다. 그리고 가능하면 흔들림 자체를 수학으로 우회(시뮬레이션 없는 계산)해 실무 비용을 줄이라는 실용적 처방도 빠지지 않는다.
테마 3: 주문장에서 가격이 태어난다 — DeepLOB의 탄생
왜 흥미로운가
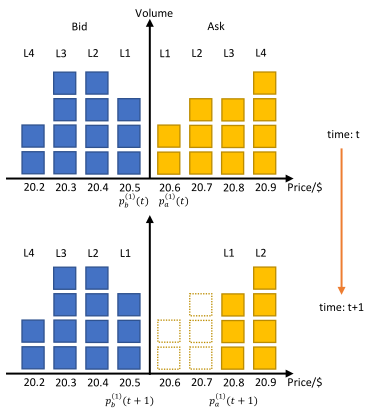
주식을 사려면 화면에 떠 있는 매수·매도 호가(주문장, limit order book)를 보게 된다. 이 호가창은 시시각각 바뀌는, 아주 고해상도의 "시장의 심전도"다. 이 심전도를 사람이 만든 규칙으로 읽기에는 너무 복잡하니, 그냥 신경망에게 원시 데이터를 통째로 주고 읽게 하자 — 2018년 8월에 옥스퍼드 맨 인스티튜트가 제안한, 지금은 당당한 표준이 된 접근이다.
대표 논문: DeepLOB — 주문장을 딥러닝으로 읽다
Zhang, Zohren, Roberts 세 명이 낸 DeepLOB은 이후 이 분야의 사실상 표준 참조점이 된 논문이다.
무엇이 문제였나
호가창은 매수·매도 각 10단계의 가격과 수량이 매 순간 바뀌는 고차원 데이터다. 기존 연구는 사람이 손으로 만든 지표(주성분 분석 같은 전처리)에 고전 시계열 모형을 얹었고, 성능 검증은 대부분 10일치로 줄여 놓은 공개 데이터셋(FI-2010)에 의존했다. 데이터도, 모형도, 검증도 모두 아쉬웠다.
핵심 아이디어
- 두 종류의 신경망을 겹친다. 합성곱 신경망(CNN)이 호가창의 공간 구조(가격·수량이 층층이 쌓인 모양)를 읽고, LSTM이라 부르는 순환 신경망이 시간의 흐름을 잡는다. CNN 부분은 인셉션 모듈로 감싸 여러 시간 지평의 단서를 동시에 본다.
- 끝까지 학습(end-to-end). 사람이 특징을 만들어 주지 않고, 원시 호가 데이터에서 "가격이 오를지/보합일지/내릴지"까지 한 번에 학습한다.
결과 — 무엇을 알아냈나
- 공개 벤치마크(FI-2010, 7일 학습·3일 검증)에서 기존 최고 기록을 모두 넘어섰다. 예측 시점이 10단계 앞일 때 정확도 84.47%, 균형 지표인 F1 점수 83.40%(직전 최고는 F1 77.63%). 예측 시점이 50단계 앞일 때도 정확도 80.51%.
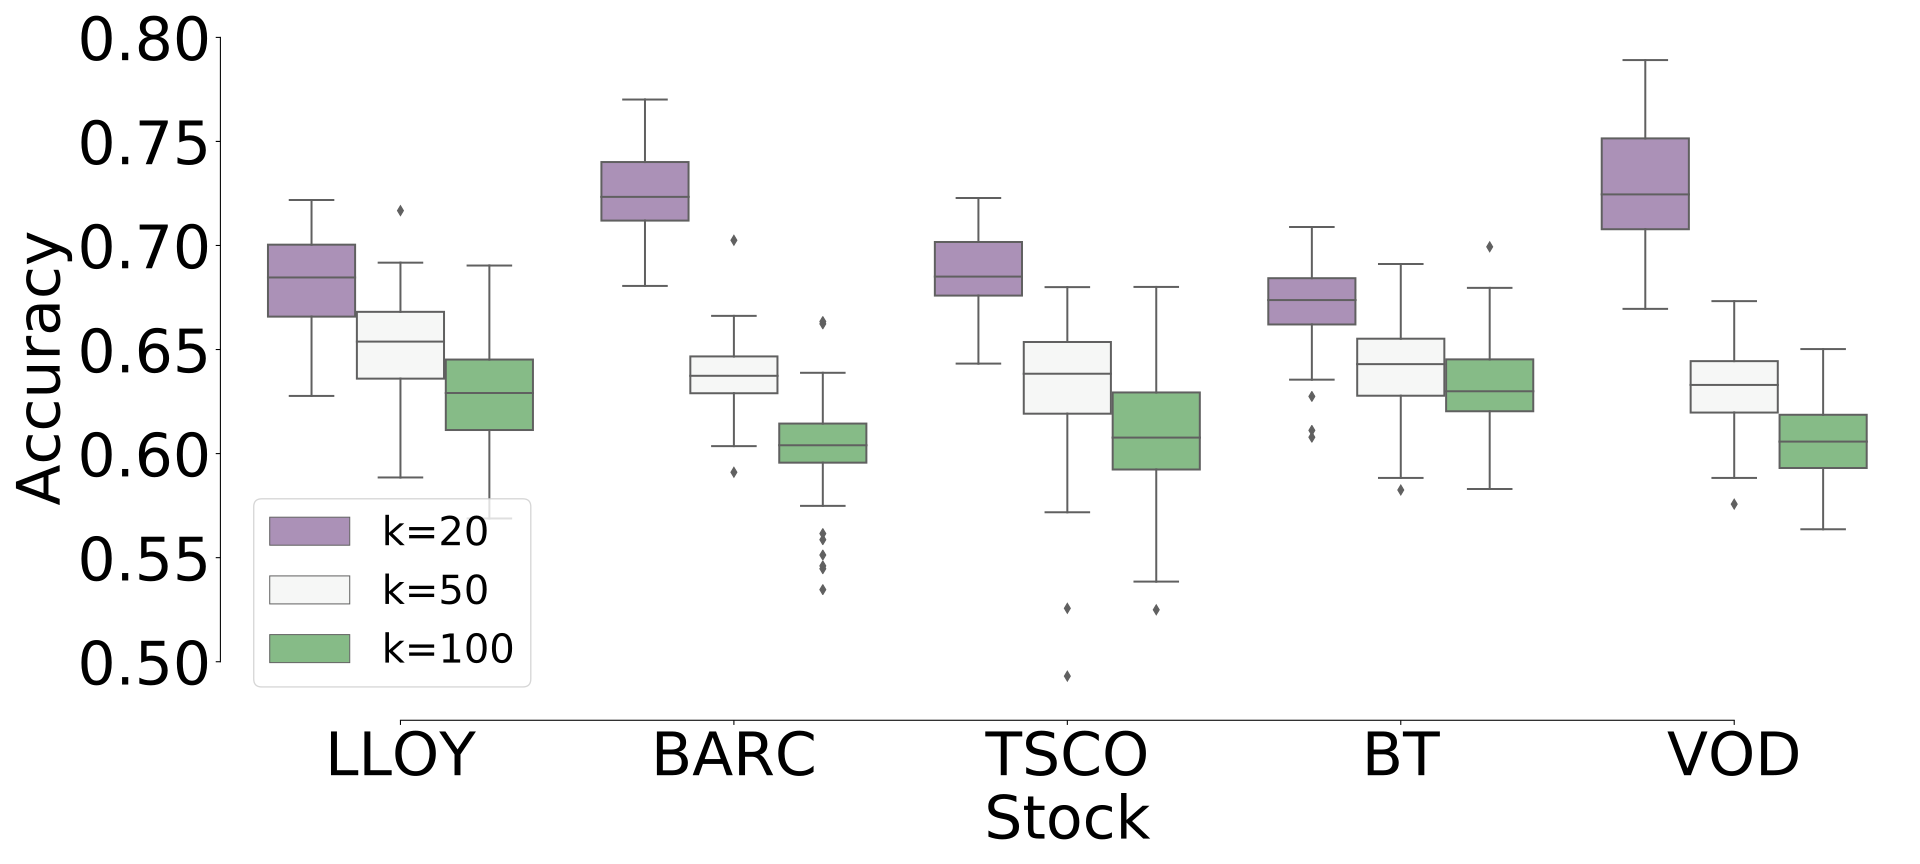
- 진짜 검증은 런던 증권거래소 실데이터. 2017년 한 해(Lloyds, Barclays, Tesco, BT, Vodafone 5개 고유동 종목)로 학습하고 3개월간 검증해, 20단계 앞 예측 정확도 70.17%를 기록했다. 데이터가 10일이 아니라 1년이라는 점이 중요하다.
- 가장 흥미로운 발견: 전이학습. 학습에 한 번도 쓰지 않은 5개 종목(HSBC, Glencore, Centrica, BP, ITV)에 그대로 적용했는데도 정확도 68.62%로 거의 떨어지지 않았다. 호가창에 종목을 넘나드는 "보편적" 가격 형성 신호가 숨어 있다는 뜻이다.
- 속도도 실전적이다: 예측 한 번에 0.253밀리초, 모델 파라미터는 6만 개뿐(비교 대상 CNN은 76만 개).
한계와 주의점
논문이 직접 밝히는 점이니 정직하게 전한다. 간단한 거래 시뮬레이션에서 이익이 나긴 했지만, 이건 중간 가격 가정에 거래 비용·시장 충격이 빠진 시뮬레이션이다. 저자들 스스로 "완결된 독립 트레이딩 전략이 아니라 예측 가능성의 증거"라고 못 박는다. 거래 비용을 반영한 독립 검증은 별도 과제다. 이 논문이 재현성 점수 76(코드 공개)으로 이 달 A등급 중 가장 높은 것도 눈여겨볼 만하다.
그래서 투자/실무엔?
호가창 데이터를 가진 시장이라면 단기 예측 신호의 프로토타입으로 삼기 좋다. "학습 안 한 종목에도 통한다"는 결과는 종목 확장 비용을 크게 줄인다. 다만 염두에 둘 것: 예측 정확도와 수익은 다르다. 거래 비용·체결 확률을 넣은 검증 없이 성능 수치만 보고 전략을 확정하면 안 된다.
함께 읽을 논문
- 고빈도 거래자의 재고 싸움 (1808.05169) — 여러 고빈도 거래자가 서로 경쟁할 때 최적 전략과 가격 충격이 어떻게 정해지는지 게임이론으로 푼다. 거래세가 유동성을 떨어뜨린다는 결론도 실무적으로 중요하다.
- 호가창의 미시에서 거시까지 (1808.07107) — 주문 하나하나의 도착·취소 모형이 여러 단계의 근사를 거쳐 "연속적인 곡선" 모형으로 이어지는 사다리를 정리했다.
- 잠재 유동성은 어떻게 드러나나 (1808.09677) — 화면에 보이지 않는 "숨은 유동성"이 실제 호가창에 어떻게 모습을 드러내는지 연결하는 메커니즘을 제안한다. 시장충격의 유명한 "제곱근 법칙"을 설명하는 모형을 실데이터 쪽으로 한 걸음 옮긴 연구.
이 테마의 공통 인사이트
데이터로 읽는 쪽(DeepLOB)과 이론으로 설명하는 쪽(게임이론, 확률과정)이 같은 현상 — 가격 형성 — 의 양쪽 끝에서 서로를 향해 가고 있다. 딥러닝이 "무엇이 예측되는지"를 보여 준다면, 미시구조 이론은 "왜 그런 신호가 생기는지"를 말해 준다. 둘을 함께 쓸 때 신호가 오래간다.
테마 4: "모형이 틀렸을 때"를 계산하는 리스크
왜 흥미로운가
은행과 운용사의 리스크 관리는 대개 "지난 데이터로 보면, 97.5% 확률로 이 정도 손실"이라는 숫자 하나로 요약된다. 그런데 2008년 금융위기는 그 숫자가 가정 위에 서 있다는 사실을 처절하게 보여 줬다. "분포가 아니라, 시나리오별로 물어보자 — 비상 상황에서는 얼마가 무너지는가?" 2018년 8월의 이 달 1위 논문이 바로 이 질문을 수학으로 다룬다.
대표 논문: Scenario-based Risk Evaluation — 위험을 "시나리오별"로 묻다
워털루 대학의 Ruodu Wang과 베른 대학의 Johanna Ziegel이 낸 이 논문은 이 달 복합점수 1위(72.6)다. 엄밀성 점수 88은 이 달 전체에서 가장 높다.
무엇이 문제였나
표준 위험 척도(VaR, ES)는 위험의 분포만 보고 숫자 하나를 만든다. 그러나 같은 분포를 가진 복권(한 방에 대박/대부분 소액 손실)과 보험계약(한 방에 큰 손실/대부분 소액 이익)은 전혀 다른 위험이다. 게다가 실제 리스크 관리에서는 이미 스트레스 테스트를 "나중에 덧붙이는" 식으로 쓰는데, 이렇게 덧붙인 숫자는 좋은 위험 척도가 갖춰야 할 성질(수학적 일관성)을 잃는다.
핵심 아이디어
- 시나리오 = 확률 분포의 집합. "평상시", "고변동성", "불경기" 같은 상황마다 위험의 분포를 따로 구해 둔다. 그리고 상식적인 공리를 세운다: 모든 시나리오에서 분포가 같다면 위험도도 같아야 한다.
- 이 공리 위에서 위험 척도를 다시 분류한다. 어떤 척도가 수학적으로 "좋은 성질"을 갖는지(일관성 등)를 증명하고, 은행 규제(Basel), 선물 거래소의 마진 산정, 신용등급 평가가 사실 이 틀 안에 있다는 것을 보인다.
- Max-ES라는 새 척도 제안. 여러 시나리오에서 손실을 구한 뒤 최악의 시나리오 값을 그대로 채택하는, 보수적이지만 강건한 계산법이다.
결과 — 무엇을 알아냈나
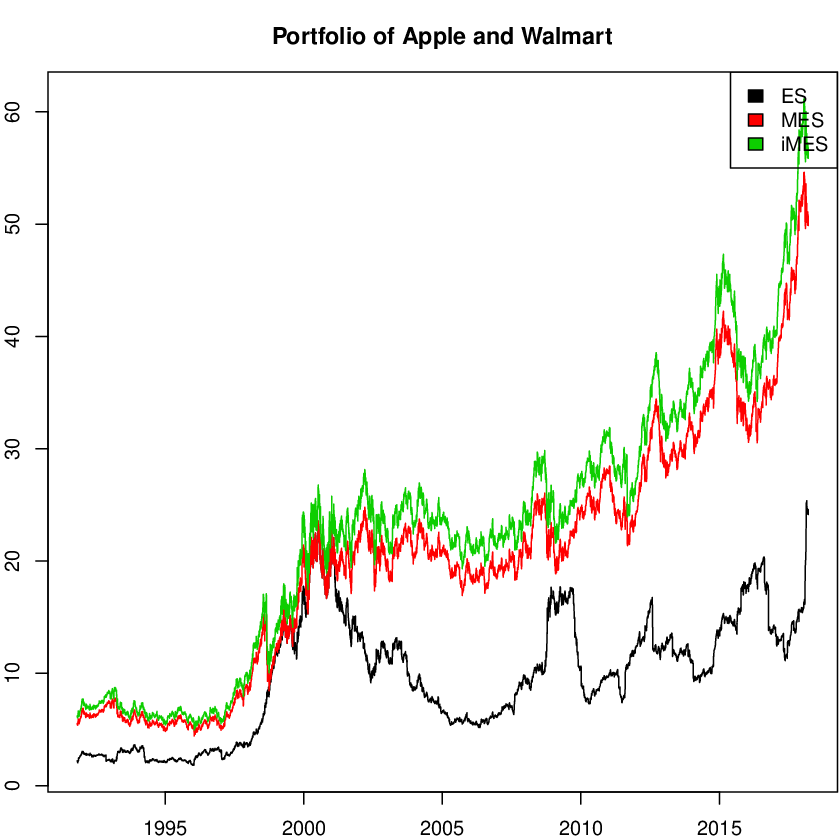
- 네 가지 경제 상황(변동성 높음/낮음 × 경기 좋음/나쁨, VIX와 S&P 500으로 구분)을 기준으로 NASDAQ·DAX·애플·BMW의 1991년부터 2018년까지 데이터를 분석했다. 결과: 경제가 평온할 때는 시나리오 기반 위험과 일반 위험이 비슷하지만, 스트레스기에는 크게 벌어진다.
- Basel 규제의 스트레스 조정을 그대로 재현한 계산(과거 10년의 12개월 구간 중 최악, 신뢰수준 97.5%): 포트폴리오 가치 대비 위험은 최악 시나리오 기준 척도가 안정적인 반면(구체적으로 MES 6
9%, iMES 710%), 일반 위험 척도는 2~9%로 크게 흔들렸다. 과거의 최악을 기준으로 삼으면 숫자가 훨씬 덜 춤춘다는 뜻이다. - 이 비율이 2000년대 초 침체와 2008년 위기를 질적으로 구분해 냈다는 점도 흥미롭다.
한계와 주의점
이 논문이 제안한 추정 방식의 통계적 성질(충분히 많은 데이터에서 진짜 값에 수렴하는지 등)은 별도 연구 과제로 남겨 두었다. 실증은 일별 수익률과 공개 데이터에 기반하며, 신뢰수준 90%(p=0.9)로 단순화했다. 코드 공개가 없어 재현성 점수는 40이다.
그래서 투자/실무엔?
포트폴리오 스트레스 테스트와 리스크 한도를 설계할 때 "분포가 아니라 시나리오별 분포"라는 관점을 그대로 이식할 수 있다. 특히 "과거 최악의 12개월"을 기준으로 삼는 Max-ES 방식은, 숫자가 시장 상황에 따라 춤추는 문제를 완화해 준다.
함께 읽을 논문
- 강건 모델링의 두 갈래를 하나로 (1808.06430) — 모형이 틀릴 것을 전제로 한 두 가지 접근법(경로 기반, 다중 분포 기반)이 사실 같은 결론을 낸다는 것을 증명한 이론 논문.
- 변동성을 모른다고 가정하면? (1808.03463) — 금리 모형에서 변동성 자체를 모르는 상황을 전제로 하면 기존 가격결정 방식이 무너지고, 이를 다시 세워야 한다는 연구.
- 은행 부도의 전염 (1808.05311) — 한 은행의 부도가 다른 은행으로 옮겨붙는 과정을 수학 방정식으로 모델링해 손실률을 계산한다.
이 테마의 공통 인사이트
위험 관리의 진짜 질문은 "얼마를 잃을까"가 아니라 "가정이 틀리면 얼마가 더 무너질까"다. 시나리오, 모형 불확실성, 최악의 과거 — 표현은 달라도 이 논문들은 모두 "우리가 모르는 것"을 숫자 안에 포함시키는 방법을 모색한다.
테마 5: 수학을 실무 속도로 — 계산을 빠르게 만드는 기술
왜 흥미로운가
아무리 훌륭한 이론이라도 계산이 30분씩 걸리면 실무에서는 못 쓴다. 옵션 가격 하나를 매기는 데 필요한 복잡한 계산(푸리에 적분)이 "수백만 번의 연산"을 요구하면, 시장이 열려 있는 동안에는 사실상 쓸 수 없다. 2018년 8월의 이 테마는 좋은 이론을 1초 안에 돌아가는 도구로 바꾸는 수치 기술들이다.
대표 논문: SINH-acceleration — 수백만 번의 계산을 수십 번으로
Boyarchenko와 Levendorskiĭ 두 명이 제안한 이 방법은, 이름 그대로 쌍곡사인(sinh) 함수를 이용해 계산을 가속한다.
무엇이 문제였나
옵션 가격과 확률분포는 대개 "푸리에 역변환"이라는 적분으로 계산된다. 그런데 널리 쓰이는 여러 모형에서 계산식이 너무 천천히 줄어들어(감쇠), 원하는 정확도에 도달하려면 격자점이 수십만~수백만 개 필요하다. 느린 게 아니라 실용적이지 않은 상태다.
핵심 아이디어
- 계산식이 복소평면의 특정 영역에서 "매끄럽다"(해석적이다)는 성질을 활용한다.
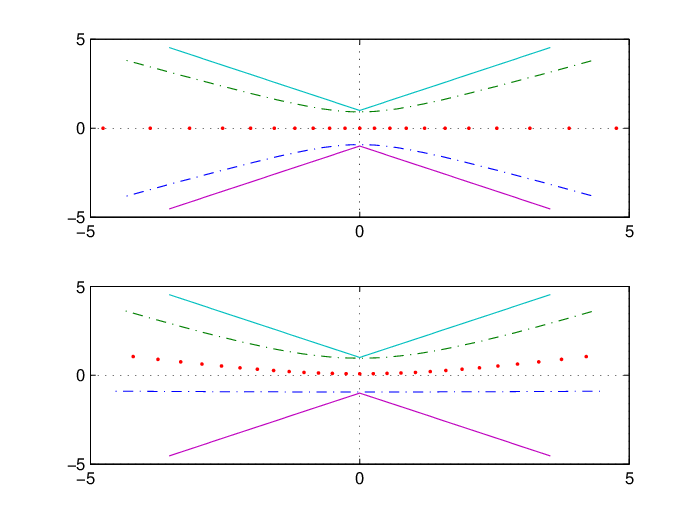
- 적분을 쌍곡사인 모양의 변수변환으로 바꾸면, 계산식의 감쇠 속도가 지수적으로 (심지어 이중 지수적으로) 빨라진다.
- 이렇게 "빠르게 감쇠하는" 계산에는 아주 오래된 적분법(사다리꼴 규칙)이 놀라울 만큼 정확하게 작동한다 — 오차가 격자 간격에 대해 지수적으로 줄어든다.
결과 — 무엇을 알아냈나 (원문 수치)
- 오차 10의 -7승 수준의 정확도에는 항 10개 미만이면 충분했다. 보통 50개 미만, 심지어 10의 -12승 같은 극한의 정확도에서도 항 100~150개면 됐다.
- 기존의 빠른 방법과 비교해 필요 항 수가 10~30배 줄고, 계산 시간이 약 5배 짧았다. 가장 기본적인 평면 계산법과 비교하면 격차가 더 극적인데, 평면 계산법은 항이 약 10만 개여도 오차 기준을 1,000만 배나 느슨하게 해야 간신히 맞고 계산 시간은 100배 든다.
- 확률분포 계산, 유럽형 옵션 가격(레비 모형·Heston 모형·CIR 모형 등), 몬테카를로 시뮬레이션용 난수 생성까지 두루 쓸 수 있는 범용 기법이다.
한계와 주의점
논문의 범위는 하나의 변수(1변량) 계산 중심이다. 여러 자산을 묶은 바스켓 옵션 같은 다변량 문제로의 확장은 숙제로 남겼다. 그리고 이건 계산을 빠르게 하는 기술이지, 모형 자체를 정확하게 만들어 주지는 않는다. 코드 공개가 없어(재현성 38) 직접 구현해야 한다.
그래서 투자/실무엔?
옵션 가격 엔진이나 모형 보정(calibration) 파이프라인에서 반복 호출되는 병목 계산을 줄이는 레이어로 쓸 수 있다. 실시간으로 그리스(옵션 민감도)를 갱신하거나, 시뮬레이션을 수만 번 돌려야 하는 작업에서 체감 속도가 완전히 달라진다.
함께 읽을 논문
- 최적정지 문제의 계산 안정화 (1808.04725) — 버뮤다식 옵션의 조기행사 시점 결정 같은 "언제 멈출까" 문제에서, 계산이 흔들리는 원인을 제거해 더 안정적이고 빠르게 푸는 방법.
- 격자 없는 고정확도 계산 (1808.02365, 1808.05890) — 미리 정해진 격자 대신 필요한 곳에만 계산점을 놓아 복잡한 파생상품 가격을 정확하게 구하는 기법.
- 공매도를 조절하는 포트폴리오 (1808.00982) — 포트폴리오 최적화에 "벌점" 항을 넣어 보유 종목 수와 공매도 노출을 직접 통제하는 실용적 방법.
- 장기 투자의 안정 궤도 (1808.04265) — 최적 투자·소비 계획이 시간이 길어지면 일정한 궤도로 수렴한다는 "turnpike" 성질이 성립하는 조건을 샤프 비율 등 세 가지 숫자로 정리했다.
이 테마의 공통 인사이트
이론과 실무 사이의 마지막 관문은 언제나 계산이다. 수치 불안정성, 느린 적분, 최적화의 병목 — 이런 것을 걷어내는 논문들은 화려하지 않지만, 없으면 아무리 좋은 아이디어도 실험실 밖으로 나가지 못한다. 이 달에는 그 "마지막 관문"을 여는 연구들이 A등급까지 올라왔다.
2018년 8월 전체를 관통하는 메시지
이 달의 다섯 갈래를 관통하는 문장 하나를 고르라면 이렇다: "불확실성을 모형 밖이 아니라 모형 안으로 끌어들이자." 옵션 스마일에서는 변동성 자체를 확률적으로 두어 곡선을 설명하고(테마 1), 예측에서는 미래 분산의 흔들림이 꼬리를 만든다는 사실을 공식으로 증명하며(테마 2), 주문장에서는 노이즈 가득한 데이터에서 가격 형성의 보편적 신호를 끌어내고(테마 3), 위험 측정에서는 모형이 틀린 상황 자체를 계산 대상으로 삼으며(테마 4), 마지막으로 이 모든 것을 실무 속도로 돌리게 만든다(테마 5).
그리고 이 달의 진짜 보물 하나: DeepLOB의 탄생. 2018년 8월의 논문 75편 중 기계학습 계열은 3편뿐이었고, 그중 실제로 시장을 읽는 연구로 남은 건 DeepLOB 한 편이었다. 바로 그 한 편이 이후 수년간 "금융 AI"의 표준 어휘가 되었다. 나머지 54편의 수학금융이 그 씨앗이 자라날 흙이었다고 해도 좋다. "더 똑똑한 예측"보다 "더 정직한 불확실성 처리"가 과제였던 그 여름 — 8년이 지난 지금도, AI가 시장을 읽는 시대에 그 기초 체력은 그대로 유효하다.
더 알아보기
원문 링크 (arXiv)
- DeepLOB: Deep Convolutional Neural Networks for Limit Order Books — 새로움 72 / 적용성 66 / 엄밀성 67 / 재현성 76 / 통찰 73
- Scenario-based Risk Evaluation — 새로움 78 / 적용성 70 / 엄밀성 88 / 재현성 40 / 통찰 77
- Smile Modelling in Commodity Markets — 새로움 68 / 적용성 78 / 엄밀성 76 / 재현성 48 / 통찰 70
- Analytic Moments for GARCH Processes — 새로움 72 / 적용성 68 / 엄밀성 82 / 재현성 45 / 통찰 72
- SINH-acceleration — 새로움 68 / 적용성 78 / 엄밀성 77 / 재현성 38 / 통찰 67
함께 읽으면 좋은 KB의 관련 논문
- 주문장 예측이 궁금하다면: Transformers for Limit Order Books, DeepFolio
- 위험 측정이 궁금하다면: Evaluating Range Value at Risk Forecasts, LLM으로 스트레스 시나리오 만들기
- 옵션 스마일이 궁금하다면: Stationary Heston 모형의 보정, Quintic Volatility Model
- GARCH가 궁금하다면: 그래피컬 코퓰라 GARCH, Asymmetric Long-Memory GARCH
- 계산 가속이 궁금하다면: SINH-acceleration for B-spline projection, rough Heston의 빠른 가격 계산
📚 이 글에서 다룬 논문 (36편)
- A
- ADeepLOB: Deep Convolutional Neural Networks for Limit Order Books
Zihao Zhang, Stefan Zohren, Stephen Roberts
- ASmile Modelling in Commodity Markets
Emanuele Nastasi, Andrea Pallavicini, Giulio Sartorelli
- AAnalytic Moments for GARCH Processes
Carol Alexander, Emese Lazar, Silvia Stanescu
- ASINH-acceleration: efficient evaluation of probability distributions, option pricing, and Monte-Carlo simulations
Svetlana Boyarchenko, Sergei Levendorskiĭ
- ADynamic programming for optimal stopping via pseudo-regression
Christian Bayer, Martin Redmann, John Schoenmakers
- AOn smile properties of volatility derivatives and exotic products: understanding the VIX skew
Elisa Alòs, David García-Lorite, Aitor Muguruza
- BOption pricing models without probability: a rough paths approach
John Armstrong, Claudio Bellani, Damiano Brigo 외 1명
- B
- BSemi-analytical solution of a McKean-Vlasov equation with feedback through hitting a boundary
Alexander Lipton, Vadim Kaushansky, Christoph Reisinger
- BThe value of a liability cash flow in discrete time subject to capital requirements
Hampus Engsner, Kristoffer Lindensjö, Filip Lindskog
- BRisk-based optimal portfolio of an insurer with regime switching and noisy memory
Rodwell Kufakunesu, Calisto Guambe, Lesedi Mabitsela
- BInventory Management for High-Frequency Trading with Imperfect Competition
Sebastian Herrmann, Johannes Muhle-Karbe, Dapeng Shang 외 1명
- BLimit order books, diffusion approximations and reflected SPDEs: from microscopic to macroscopic models
Ben Hambly, Jasdeep Kalsi, James Newbury
- BHow does latent liquidity get revealed in the limit order book?
Lorenzo Dall'Amico, Antoine Fosset, Jean-Philippe Bouchaud 외 1명
- BOptimal Trading with General Signals and Liquidation in Target Zone Models
Christoph Belak, Johannes Muhle-Karbe, Kevin Ou
- B
- BSome Statistical Problems with High Dimensional Financial data
Arnab Chakrabarti, Rituparna Sen
- BDifferentially Private Change-Point Detection
Rachel Cummings, Sara Krehbiel, Yajun Mei 외 2명
- BAdaptive l1-regularization for short-selling control in portfolio selection
Stefania Corsaro, Valentina De Simone
- BA High Order Method for Pricing of Financial Derivatives using Radial Basis Function generated Finite Differences
Slobodan Milovanović, Lina von Sydow
- B
- BDeepFolio: Convolutional Neural Networks for Portfolios with Limit Order Book Data
Aiusha Sangadiev, Rodrigo Rivera-Castro, Kirill Stepanov 외 5명
- AEvaluating Range Value at Risk Forecasts
Tobias Fissler, Johanna F. Ziegel
- BStationary Heston model: Calibration and Pricing of exotics using Product Recursive Quantization
Vincent Lemaire, Thibaut Montes, Gilles Pagès
- AGraphical copula GARCH modeling with dynamic conditional dependence
Lupe Shun Hin Chan, Amanda Man Ying Chu, Mike Ka Pui So
- AAsymmetric Long-Memory GARCH: Sign-Dependent Kernel Injection in a Two-Dimensional Markov Chain
Kennedy Titus Kayaki, Kyungsub Lee
- BSINH-acceleration for B-spline projection with Option Pricing Applications
Svetlana Boyarchenko, Sergei Levendorskiĭ, J. Lars Kirkby 외 1명
- AFast reliable pricing and calibration of the rough Heston model
Svetlana Boyarchenko, Marco de Innocentis, Sergei Levendorskiĭ
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2024-07 월간A
2024년 7월 금융 AI 논문 리뷰: M6 우승 전략, 거친 변동성, 연준의 속마음
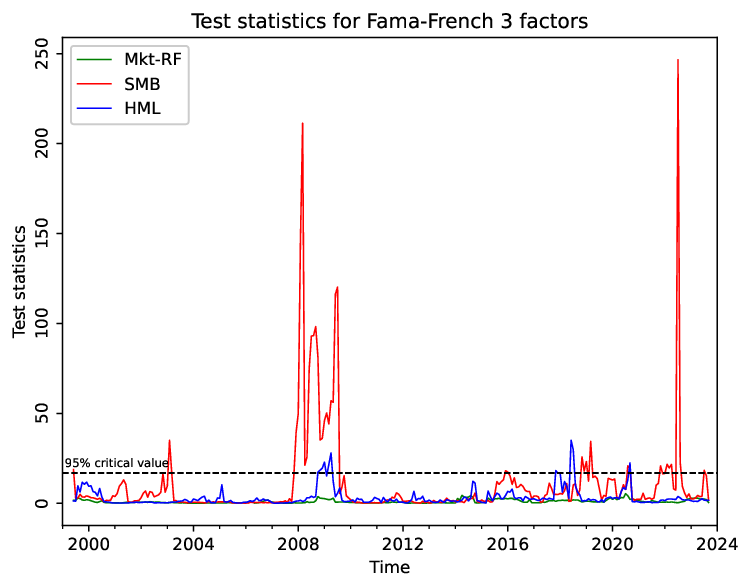
2024년 7월 arXiv 금융 논문 309편을 분석했습니다. M6 대회 우승의 하이퍼네트워크 포트폴리오, 거친 변동성 검정, 약한 팩터 이론, GPT-4가 읽는 연준 회의록의 이견, 지정가 체결의 음의 드리프트까지 5가지 테마로 정리합니다.
 📊 2023-11 월간A
2023년 11월 금융 AI 논문: LLM 트레이딩의 불안한 진실과 13만 개 전략의 승자
2023년 11월 arXiv 금융 AI 연구를 5개 테마로 정리했습니다. 13만 6천 개 전략을 한 번에 검증한 팩터 마이닝, 온도를 0으로 해도 흔들리는 LLM 감성 투자, 리스크 회피 성향을 배우는 강화학습, CVA 감마를 빠르고 안정적으로 계산하는 수치 기법, 전력 가격 시나리오를 통째로 만드는 생성 모델까지.
 📊 2019-10 월간A
강화학습 마켓메이킹, 상관행렬 GAN, VIX 선물 가격의 반전 — 2019년 10월 금융 AI 논문
2019년 10월의 금융 AI·계량경제학 논문을 일반인 눈높이로 정리한 월간 리뷰. 회사채 마켓메이킹의 강화학습 돌파, GAN으로 만드는 현실적 상관행렬, 국소변동성 모델이 못 맞추는 VIX 선물 가격, 딥러닝 횡단면 전략의 과적합 근절법까지.