2012년, 세계 최대 은행 중 하나인 JP모건은 "서로 헤지가 될 줄 알았던" 포지션들 때문에 62억 달러(약 8조 원)를 잃었다. 같은 해의 비극을 6년 뒤 한 논문이 수식으로 되짚었다 — "상관관계가 무너지는 시나리오를 미리 만들어 두면, 얼마가 무너지는지 알 수 있다"고. 2018년 7월의 금융 연구는 이처럼 가격이 아니라 '관계'를 다룬다. 종목들이 함께 움직이는 균형(공적분)으로 청산 비용을 줄이는 방법, 아무리 잘 만든 전략도 얹는 '기준 포트폴리오'가 성과를 가른다는 분석, 표본이 조금만 달라져도 헤지 가격이 요동치는 이유, 그리고 추세와 가치라는 두 상반된 투자법이 왜 한 시장에 함께 사는지에 대한 이야기다.
들어가며: "가격 예측" 말고 "관계의 수학"이 있던 여름
2018년 7월, 비트코인은 연초 고점의 3분의 1 수준까지 내려온 뒤였고 세계 금융시장은 무역 갈등 소식에 하루하루 요동쳤다. 그런데 이 달의 금융 연구 흐름은 놀랍도록 차분하다. 수익률을 예측하는 화려한 모형 대신, "우리가 당연하게 믿는 것들 — 상관관계, 유동성, 기준 포트폴리오, 표본 추정 — 이 사실은 믿을 만한가?" 라는 기초 질문에 매달린 논문들이 상위권을 채웠다.
이 달의 다섯 갈래 이야기를 한 줄씩 요약하면 이렇다.
- 포트폴리오를 지탱하는 상관관계가 무너지면 얼마나 잃을까? (테마 1)
- 종목들이 장기적으로 함께 움직이는 관계(공적분)를 알면 대량 매도 비용을 줄일 수 있다. (테마 2)
- 전략보다 기준 포트폴리오(벤치마크)를 어떻게 짜는가가 성과를 가른다. (테마 3)
- 과거 자료로 계산한 헤지 가격은 자료가 조금만 달라져도 흔들린다. (테마 4)
- 추세 추종과 가치 투자는 적이 아니라 서로의 형태를 만드는 짝이다. (테마 5)
8년이 지난 지금 다시 읽어도, 이 달의 논문들은 "금융 AI" 시대가 오기 직전 수학금융이 자기 전제를 점검하던 귀중한 기록이다.
테마 1: 상관 붕괴 스트레스 테스트 — 헤지가 무기가 되는 순간
왜 흥미로운가
분산투자의 기본 원리는 "달걀을 한 바구니에 담지 않는 것"이다. 서로 다른 종목을 같이 사면, 한쪽이 흔들려도 다른 쪽이 받쳐 주니 위험이 줄어든다. 헤지도 같은 원리다 — 완전히 똑같은 대체재가 아니라 "대체로 함께 움직이는" 자산으로 위험을 상쇄한다.
그런데 이 "대체로 함께 움직인다"는 믿음은 평상시의 이야기다. 시장이 크게 흔들리는 순간, 평소에는 상관이 낮았던 자산들이 동시에 떨어지면서 상관이 치솟는다. 헤지라고 믿었던 포지션이 사실은 같은 방향으로 베팅하고 있었던 셈이다. 문제는 "상관이 깨지면 얼마를 잃는가?"를 계산하는 방법이 마땅치 않았다는 점이다. 가격이 떨어지는 시나리오는 잘 만들면서, "함께 움직이던 관계가 깨지는" 시나리오는 만들기 어려웠다.
대표 논문: 런던 고래 사태를 상관 스트레스 테스트로 재현하다
1807.11381은 2012년 JP모건의 "런던 고래(London Whale)" 사건에서 출발한다. JP모건의 런던 사무소가 운영한 신용파생 포트폴리오는, 위험을 줄이겠다며 상관이 높은 상쇄 포지션을 대거 추가했는데, 정작 위기가 오자 이 포지션들이 서로의 헤지가 되지 못했다. 최종 손실은 62억 달러(약 8조 원).
저자들의 아이디어는 세 단계로 요약된다.
- 상관을 '경제적 위험 요인'의 함수로 만든다. "A와 B의 상관은 0.7"이라는 숫자 대신, 투자등급/하이일드 구분이나 지수 시리즈 같은 요인 간 거리로 상관을 결정하는 수식을 짠다. 그러면 "이 요인이 멀어지면 상관이 깨진다"는 시나리오를 만들 수 있다.
- 말이 되는 시나리오만 골라 낸다. 마할라노비스(Mahalanobis) 거리라는 통계 도구로 "과거 자료에서 본 범위를 크게 벗어나지 않는" 시나리오만 후보로 남긴다. 아무리 악랄한 상황이라도 일어날 법해야 의미가 있기 때문이다.
- 그 안에서 가장 나쁜 경우를 찾아 계산한다. 포트폴리오의 손실(VaR)이 최대가 되는 상관 붕괴 패턴을 직접 찾아, 그때의 손실을 계산한다.
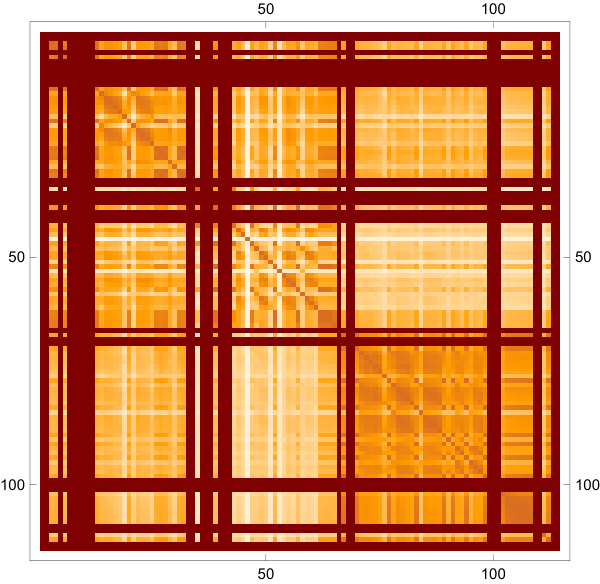
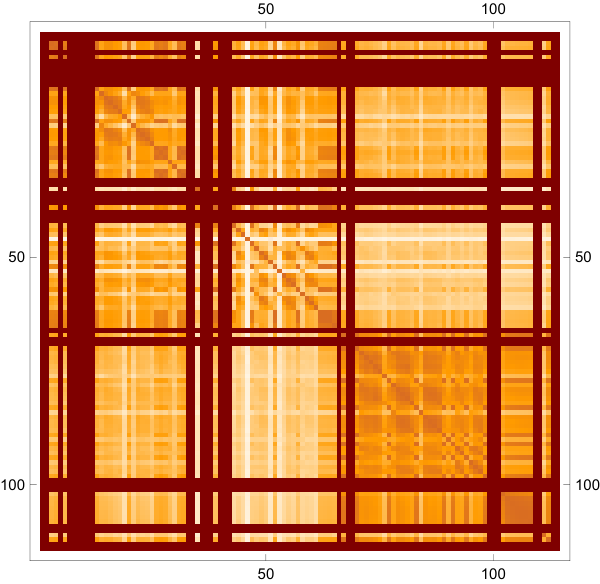
결과는 구체적이다. 공개 자료로 재구성한 포트폴리오는 93개 종목, 순액면 1,543억 달러(약 200조 원) 규모였다.
- 기본 상태의 1일 99% 손실 한도(VaR): 3억 3,931만 달러
- "일어날 법한 범위(99% 분위) 안에서 가장 나쁜 상관 시나리오": 3억 8,108만 달러 — 12.31% 증가
- 범위 제약을 아예 없앤 완전 최악: 6억 2,096만 달러 — 83.01% 증가
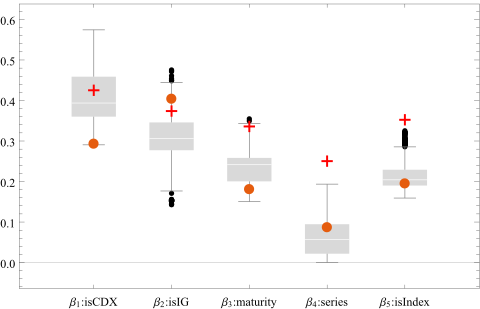
흥미로운 대목은 한계에 대한 정직한 고백이다. 저자들은 "역사적 자료 기준 최악 1% 시나리오에서도 손실 한도가 12% 이상 늘어나며 이런 일이 1년에 2~3회 올 수 있다"고 경고하면서도, 정작 실제 사건에서는 거래가 중단된 직후 지수들 사이의 상관이 진짜로 깨졌고(Cont와 Wagalath의 2015년 연구), 이 구조적 파단은 역사적 자료로는 예측할 수 없었다고 말한다. 실제 리스크는 "개연성 있게 보이는 범위"보다 최악 쪽에 가까웠다는 것이다.
한계와 조심할 점
- 이 계산은 상관만 움직이고 나머지(변동성 등)는 그대로라는 가정 위에 있다. 실제 위기에서는 변동성도 같이 튄다.
- 파라미터는 역사적 자료로 추정하며, 포트폴리오가 자기 스스로 시장에 미치는 충격까지 모형에 넣지는 않았다. 저자들은 오히려 "대형 포트폴리오일수록 자기 거래가 상관을 깨뜨릴 수 있다"고 지적한다.
- 공개 코드가 없어(재현성 점수 48) 직접 구현해야 한다.
다음 논문들: 리스크 숫자의 불안을 다루는 방법들
같은 달, 리스크 숫자 자체를 더 안정적으로 만드는 연구도 나왔다. 1807.02422는 고빈도 자료에서 뽑은 "실현 변동성" 측정치를 손실 한도(VaR)·기대손실(ES) 예측 모형에 넣어 꼬리위험 예측을 개선했고, 1807.08390은 표준 변동성 모형(GARCH)의 추정치에 대해 "분포 가정 없이도 정확한" 신뢰구간을 만드는 점수 순열 방법을 제안했다. 1807.01977은 여러 위험측도를 조합해도 좋은 성질이 유지되는 조건을 정리했고, 1807.05836은 시장 상태를 예측하는 지표를 제안했다.
이 테마의 공통 인사이트
리스크 관리는 점 추정이 아니라 "가정이 틀렸을 때 얼마가 무너지는가"의 문제다. 상관, 분포, 표본 — 어떤 가정에서 출발했든, 그 가정이 흔들릴 때의 손실을 함께 계산해야 숫자가 진짜 리스크가 된다.
테마 2: 가격충격과 최적 실행 — 대량 매도가 스스로 가격을 만든다
왜 흥미로운가
주식을 1만 주 파는 것과 100만 주 파는 것은 완전히 다른 일이다. 대량 주문은 호가장을 쓸어가면서 가격을 스스로 밀어 내린다 — 이른바 가격충격(price impact). 그래서 대형 기관은 하루에 몰아 팔지 않고 여러 시간대로 나눠 천천히 처분한다. 문제는 "얼마나 천천히?"다. 너무 느리면 가격이 저절로 움직이는(불리하게) 위험을 길게 안게 되고, 너무 빠르면 가격충격을 크게 받는다.
2018년 7월의 한 논문은 여기에 "종목들이 서로 균형 관계에 있다"는 정보를 추가한다.
대표 논문: 공적분 자산을 팔 때의 최적 속도
1807.01428이 다루는 공적분(cointegration)은 쉽게 말해 "각각은 흔들려도, 장기적으로는 끈으로 묶여 함께 움직이는" 관계다. 예를 들어 같은 산업의 두 주식이 각자 다른 뉴스에 오르내리면서도, 잠시 벌어졌던 가격 차이가 다시 좁혀지는 경향이 있다. 이 "벌어진 만큼 돌아온다"는 정보는 대량 매도의 타이밍에 쓸 수 있다.
저자들은 나스닥의 다섯 종목(인텔, 반도체 ETF, 파로, 넷앱, 오라클)에서 실제로 이 관계를 측정했다. 2014년 11월 3일의 밀리초 단위 주문 메시지로 호가장을 재구성하고, 60초 간격으로 하루 330개의 가격 자료를 만들었다. 통계 검정(요한센 검정)에서도 "공적분 요인 1개"가 선택되었다.
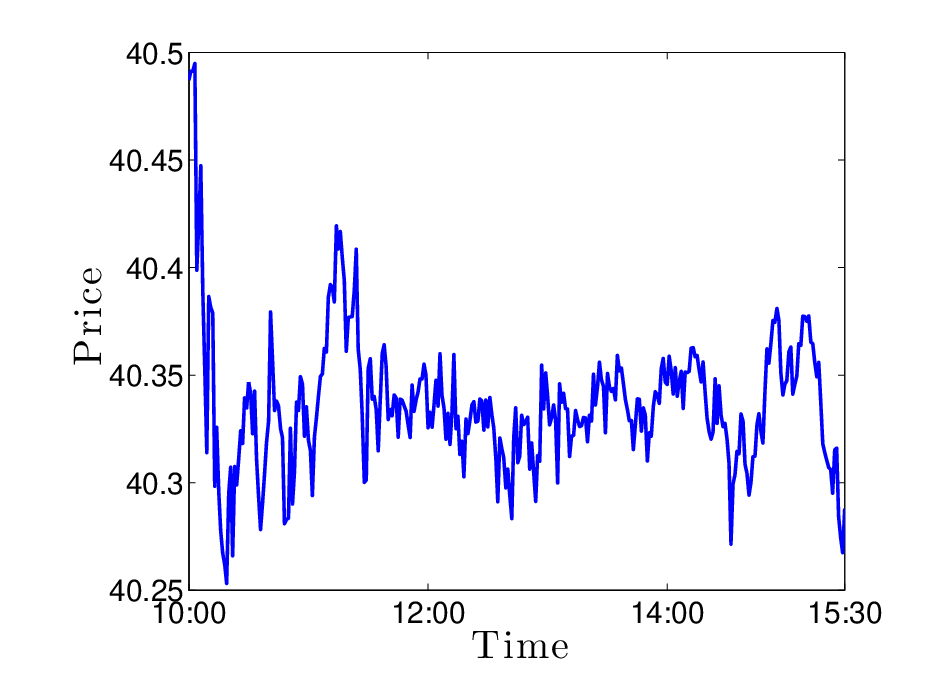
실험은 이렇게 설계했다. 인텔 4,600주와 반도체 ETF 900주를 1시간에 처분하는 상황에서, (1) 상관만 쓰는 기존 방식과 (2) 공적분 정보를 쓰는 방식을 비교했다.
- 공적분 정보를 쓰면 체결 비용이 4~4.5 베이시스포인트(bps) 절감되었다. (1bps = 0.01%)
- 다만 도중에 주식을 다시 사들여 가격 신호를 활용하는 "되사기(재매수)"를 금지하면 절감폭은 2.5~3.5 bps로 줄어든다.
4 bps는 작아 보이지만, 하루에 수천억 원을 굴리는 실행 데스크에서는 결코 작은 금액이 아니다. 게다가 이 개선은 "더 빠른 컴퓨터"나 "비밀 정보"가 아니라 이미 공개된 가격 자료의 관계 구조를 썼을 뿐이다.
한계와 조심할 점
- 파라미터 추정이 단 하루 자료 기반이고, 성과 비교는 시뮬레이션이다. 실거래 검증은 별도로 해야 한다.
- 일시적 가격충격 모형을 단순화했고, 자기 거래의 영구 충격은 의도적으로 껐다(정보의 가치를 분리하기 위한 설계).
- 공개 코드가 없어(재현성 42) 재현 비용이 크다.
다음 논문들: 유동성은 외부 조건이 아니라 시장이 만든다
1807.08278은 딜러들이 경쟁하는 시장에서 유동성 비용이 어떻게 균형으로 도출되는지를 모형화했다. 1807.03813은 리스크 회피 투자자들이 가격충격을 감수하며 주문 속도를 경쟁하는 게임을 풀었고, 1807.05917은 가격충격이 있는 시장에서 옵션을 실물결제할지 현금결제할지가 헤지 비용을 어떻게 바꾸는지 비교했다. 1807.02711은 가격충격이 금융 전염을 만들어 내므로 자본규제가 이를 감안해야 한다고 주장한다.
이 테마의 공통 인사이트
"얼마에 팔 수 있는가"는 주문의 크기와 속도가 스스로 만든다. 유동성과 가격충격을 외부에서 주어지는 조건이 아니라 시장의 내부 변수로 놓을 때, 실행·헤지·규제의 답이 모두 달라진다.
테마 3: 벤치마크의 수학 — 전략보다 '기준'이 성과를 가른다
왜 흥미로운가
"우리 펀드는 지수를 2% 이겼습니다." — 이 문장에서 가장 중요한 단어는 "2%"가 아니라 "지수"다. 기준점(벤치마크)을 어떻게 정하느냐에 따라 같은 전략도 훌륭해 보이기도, 초라해 보이기도 한다. 그런데 놀랍게도 "좋은 벤치마크를 어떻게 만드는가"는 잘 다뤄지지 않는 주제다.
흔한 선택지는 시가총액 가중 지수(코스피, S&P 500 같은)다. 다른 흔한 선택은 "최소분산 포트폴리오" — 변동을 최소화하는 조합. 그런데 후자에는 함정이 있다.
대표 논문: 반복 계산 없이 '양수' 벤치마크를 만드는 알고리즘
1807.09919은 최소분산 포트폴리오의 세 가지 문제를 지적한다.
- 계산이 깨질 수 있다. 종목 수에 비해 과거 자료가 부족하면 공분산 행렬이 계산 불가능(특이)해진다.
- 가중치가 요동친다. 종목 간 상관은 표본 밖에서 매우 불안정해서, 그 위에 만든 가중치도 불안정하다.
- 가중치가 음수가 될 수 있다. "롱온리"라는 현실에 맞지 않는다.
저자들의 대안은 다단계 산업분류(클러스터링)를 쓰는 다요인 위험모형이다. 업종–산업–섹터처럼 층위가 있는 분류 구조를 위험모형에 넣으면, 주성분 분석이나 반복 계산 없이도 가중치가 명시적으로 양(+)인 벤치마크를 닫힌 형태의 알고리즘으로 계산할 수 있다. 논문 부록에는 R 소스코드가 공개되어 있다(이 달 A등급 논문 가운데 재현성 점수가 유일하게 50을 넘는 이유다).
초과수익 전략은 이렇게 만든다. "벤치마크 + 달러 중립 포트폴리오". 시장 위험은 롱온리라면 어차피 지게 되니, 감수할 만한 시장 노출을 가진 벤치마크를 먼저 정하고, 그 위에 기대수익이 양(+)이면서 벤치마크와 상관이 낮은 달러 중립 조합을 얹는다. 단, 어떤 종목의 비중도 음수가 되지 않게 하한을 건다.
한계와 조심할 점
- 이 논문의 산출물은 "알고리즘과 코드"이지, "이 전략이 시장을 이겼다"는 실증은 아니다. 성과는 어디까지나 백테스트 설계에 달려 있다.
- 베타(종목별 시장 민감도) 값은 "제1원리로 유일하게 정해지지 않는다"는 점을 저자들이 솔직하게 인정한다. 관측 베타의 중앙값을 쓰고 이상값을 잘라 내거나, 표본 밖 백테스트로 고르라는 식의 실무 처방을 제시할 뿐이다.
- 산업분류 체계를 어떻게 만드느냐에 결과가 달라진다.
다음 논문들: '담는 수학'의 여러 층위
1807.09864는 샤프·트레이너 같은 성과비를 "한 종목을 더 담을 때 얼마나 좋아지는가"로 분해하는 방법을 정리했고, 1807.05265는 자금의 일정 비율을 유지하라는 켈리(Kelly) 원칙에서 리밸런싱을 얼마나 자주 해야 하는가를 제어이론으로 다뤘다. 1807.06449는 이상적인 시장 조건이 깨져도 로그 수익을 최대화하는 포트폴리오가 존재한다는 사실을 증명했고, 1807.05513과 1807.01979는 각각 보험사의 신용투자, 전력 내재시장이라는 특수한 문제에 같은 최적화 도구를 적용했다.
이 테마의 공통 인사이트
성과의 상당 부분은 "무엇을 사느냐"가 아니라 "어떤 기준 위에 어떻게 담느냐"에서 나온다. 벤치마크의 구조, 리밸런싱 주기, 비중의 하한 — 포트폴리오를 '관리'하는 장치들이 종목 선택만큼 결과를 좌우한다.
테마 4: 초헤징 가격 — 표본이 흔들리면 가격도 흔들린다
왜 흥미로운가
파생상품을 헤지하려면 "이 포지션을 완전히 커버하려면 얼마가 필요한가"라는 숫자가 필요하다. 그 고전적 답이 초헤징 가격(superhedging price) — 어떤 시나리오에서도 손해 보지 않도록 만드는 데 드는 최소 자금이다. 보수적이지만 확실한 기준이라 리스크 관리에서 사랑받는 개념이다.
문제는 이 숫자를 과거 자료에서 추정할 때 생긴다. 흔히 쓰는 방법은 "지난 N개월 수익률 자료로 계산하면 된다"는 식의 단순 추정(플러그인 방식). 그런데 이 방식에는 통계학의 고전적인 함정이 숨어 있다.
대표 논문: '지난 3년 자료'를 '지난 2년 반 자료'로 바꾸면?
1807.04211의 출발점은 불편한 질문이다 — "표본이 조금만 바뀌면 추정된 헤지 가격이 크게 요동치지 않는가?" 저자들은 먼저 "아니요"라고 증명한다. 단순 플러그인 추정량은 자료가 쌓이면 참값에 수렴하지만(일관성), 표본의 작은 변화에 대해 강건(robust)하지 않다. 자료 구간을 한 달 옮겼을 뿐인데 헤지 비용 추정치가 크게 달라질 수 있다는 뜻이다.
해결책은 두 가지 재료의 조합이다.
- 바세슈타인(Wasserstein) 공(볼). 관측된 자료 주위에 "이 정도는 표본 오차로 칠 수 있다"는 범위를 만든다. 이 범위 안에서 자료 분포가 어떻게 달라져도 계산이 흔들리지 않게 한다.
- 마팅게일 밀도 상한. 금융 이론의 기본 조건(무차익거래 — "공짜 점심 없음")을 유지하는 범위 안에서만 가격을 계산한다.
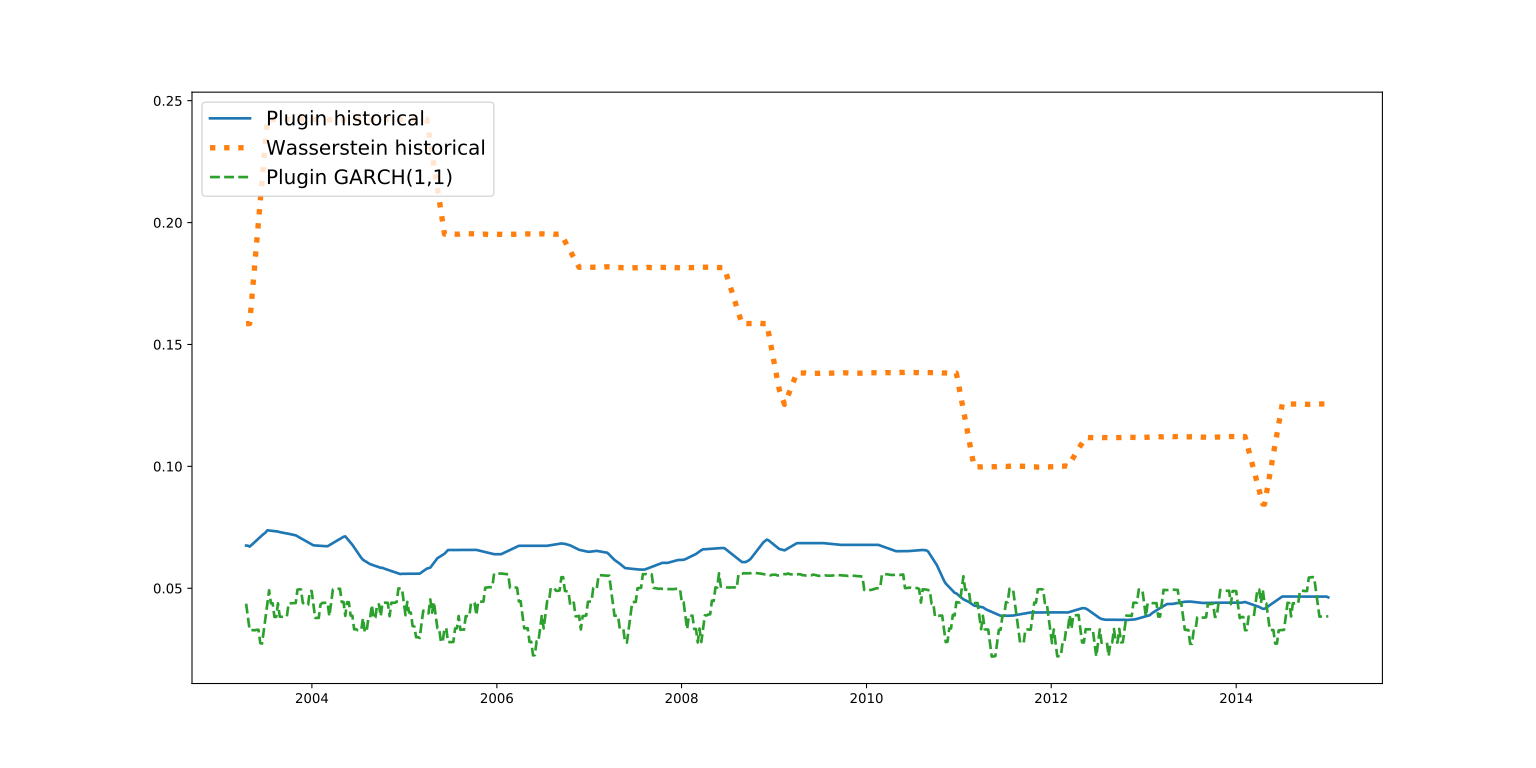
저자들은 이 개선 추정량이 (1) 자료가 쌓이면 참값에 수렴하고, (2) 표본 변화에 대해 통계적으로 강건하다는 것을 모두 증명했다. 수치 실험은 모의 자료(GARCH)와 실제 자료(애플 옵션, DAX 30 옵션)에서 단순 추정과 비교한다. 나아가 옵션이 거래되는 시장, 여러 번 거래하는(다기간) 상황으로 이론을 확장한다.
한계와 조심할 점
- 거래비용이 없는 시장을 기본 가정으로 한다. 현실의 마찰을 넣으면 추가 작업이 필요하다.
- "강건성"은 공짜가 아니다 — 보수적으로 계산되는 경향이 있고, 실무에서는 비용으로 받아들여야 한다.
- 이론 논문이라 공개 코드가 확인되지 않아(재현성 43) 실무 이식에는 자체 구현이 필요하다.
다음 논문들: 가격을 흔드는 요인들을 하나씩 다루다
1807.03882는 변동성 모형의 파라미터를 완전히 믿지 못할 때 유럽형 옵션을 어떻게 가격결정할지 다뤘고, 1807.06622는 신경망으로 고차원 파생 가격 계산(리보 시장모형의 베르무단 스왑션)을 대체해 차원의 저주를 완화했다. 1807.02227은 "언제 행사할까"라는 최적정지 문제를 일정 수준 정확도로 푸는 알고리즘이 이론적으로 다항 시간 안에 끝남을 증명했고, 1807.05396은 교환옵션 가격에서 행사가격 표기 관습의 선택이 내재변동성 해석을 어떻게 바꾸는지 짚었다.
이 테마의 공통 인사이트
가격의 숫자보다 "그 숫자가 얼마나 흔들리는가"가 헤지의 안전도를 결정한다. 모수를 믿지 않는 가격결정, 표본에 강건한 추정, 계산의 대체 — 모두 "숫자의 안정성"을 다루는 한 갈래다.
테마 5: 추세와 가치의 공존 — 시장을 움직이는 것은 '누가'다
왜 흥미로운가
투자 세계의 두 고전이 있다. 추세 추종 — 최근 오른 것은 앞으로도 오른다. 가치 투자 — 싼 것은 결국 오른다. 얼핏 정반대처럼 보이는 두 법칙이 동시에 실증적으로 검증되어 왔다. 더 흥미로운 사실은, 실증 연구들이 "추세 효과가 비단조적"이라는 미스터리를 보고했다는 점이다. 추세 신호가 약하거나 중간이면 잘 먹히다가, 신호가 아주 강해지면 효과가 사라지거나 뒤집힌다. 왜일까?
대표 논문: 추세 추종자와 가치 추종자는 서로를 만든다
1807.11751은 시장을 투자자 집단의 상호작용으로 본다. 이른바 이질적 에이전트 모형이다. 여기에 세 집단이 등장한다 — 차트를 보고 추세를 추종하는 사람, 가격이 내재가치에서 벌어지면 개입하는 가치 추종자, 그리고 뜻 없이 오가는 노이즈 트레이더.
이 모형의 묘미는 수요 함수의 모양에 있다. 추세 추종자의 수요는 신호가 커지면 포화되고(더 이상 쫓아가지 않음), 가치 추종자의 수요는 가격이 가치에서 멀어질수록 커진다. 이 두 모양이 만나면 자연스럽게 그 미스터리가 풀린다.
- 추세 신호가 중간 정도 → 추세 추종자가 주도 → 추세 효과가 나타난다.
- 추세 신호가 아주 강함 → 이미 가격이 가치에서 크게 벌어진 상태 → 가치 추종자가 대거 개입 → 평균회귀가 작동해 효과가 뒤집힌다.
저자들은 베이지안 필터링이라는 도구로 1800년 이후 여러 자산의 가격 자료를 모형에 맞추면서, 내재가치를 외부 모형 없이 직접 추정했다. "가치"를 가정하는 것이 아니라 자료에서 뽑아 낸 것이다.
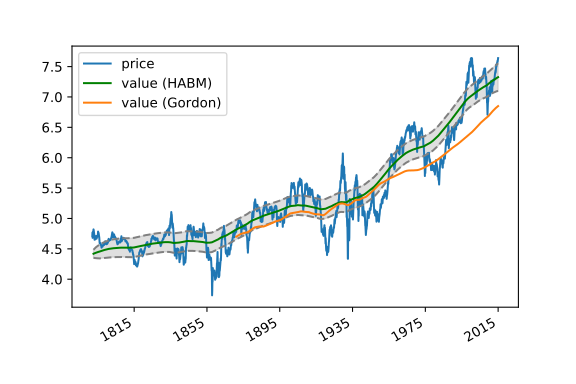
가장 눈에 띄는 발견은 이거다 — 추세 추종자의 활동이 오가격(가격과 가치의 괴리) 분포의 모양 자체를 바꾼다. 평소에는 "가치 주위에 모여 있는" 단봉 분포가, 추세 추종자가 활발하면 두 봉우리(쌍봉)로 갈라진다. 즉 어떤 시장은 꽤 오랫동안 고평가나 저평가 상태에 머물 수 있다. "가격은 항상 가치로 돌아온다"는 단순한 그림이 아니라는 뜻이다.
한계와 조심할 점
- 에이전트 기반 모형은 파라미터가 자료로 잘 고정되지 않는(식별 가능성) 문제가 있다. 추정 결과는 자료 구간과 사전 가정에 의존한다.
- "왜곡이 오래 간다"는 설명은 인상적이지만, 이 모형이 실제 수익을 냈다는 검증은 이 논문의 범위 밖이다.
- 이해상충 가능성: 공동 저자 중 한 명은 자본운용사(CFM) 소속이다. 산업계 자금이 관련된 연구일 수 있음을 밝힌다.
다음 논문들: 정보를 가진 참여자들
1807.00568은 "자주 내놓을수록 부정확해지는" 전문가 의견을 수학적으로 다루고, 1807.08222는 정보가 불완전할 때의 최적 결정을 후행 확률미분방정식으로 풀었다. 1807.07036은 누가 변동성을 만드는지 — 마켓메이커인지 방향성 매매자인지 — 를 호크스 과정으로 분해했고, 1807.00573은 파리 거래소의 개·장전 경매에서 벌어지는 전략적 행위를 실증 분석했다.
이 테마의 공통 인사이트
가격은 정보의 총량이 아니라, 정보의 분포와 참여자 구성이 만드는 산물이다. 누가 어떤 신호로, 얼마나 오래, 어떤 강도로 반응하는지가 가격의 구조를 결정한다.
월 전체 Big Picture
2018년 7월의 다섯 이야기는 한 문장으로 모인다 — "가격이 아니라 관계를 다루고, 숫자가 아니라 그 숫자의 흔들림을 다룬다." 포트폴리오를 지탱하는 상관이 무너지는 시나리오를 직접 만들어 손실을 계산하고(테마 1), 종목 간 균형 관계를 청산 타이밍에 써서 비용을 줄이며(테마 2), 성과의 기준선인 벤치마크를 어떻게 짜는지가 알파의 출발점이 되고(테마 3), 표본에서 뽑은 헤지 가격이 흔들리지 않게 통계적 장치를 붙이고(테마 4), 추세와 가치가 서로의 형태를 만든다는 것이 밝혀진다(테마 5).
이 달이 특별한 이유는 "우리가 쓰는 숫자는 가정 위에 서 있다"는 자각이 다섯 갈래로 나뉘어 전개되었다는 점이다. 상관 가정, 가격충격 가정, 위험모형 가정, 표본 가정, 참여자 가정 — 각 갈래에서 "가정이 틀리면?"이라는 질문을 정면으로 던진 논문들이 상위권을 채웠다. 기계학습이 금융 연구의 주류가 되기 직전의 마지막 여름에, 수학금융이 자기 전제를 점검하던 달의 기록이다. 투자와 연구의 기본기가 화려한 예측이 아니라 "내 모형이 틀릴 수 있다"를 전제로 한 설계라는 것을, 이 논문들은 조용히 말해 준다.
더 알아보기
원문 링크와 5차원 평가 점수
이 글에서 다룬 논문들의 원문과, 우리 지식 베이스가 매긴 5차원 점수입니다(신규성 / 적용성 / 엄밀성 / 재현성 / 통찰, 종합점수는 이들의 가중 합).
우리 지식 베이스에서 함께 읽을 논문
- 상관 스트레스 테스트 계열: Correlation scenarios and correlation stress testing, Multi Anchor Point Shrinkage for the Sample Covariance Matrix, Optimal Portfolio Using Factor Graphical Lasso
- 최적 실행 계열: Optimal Execution with Identity Optionality, Optimal Execution under Incomplete Information, Solving Optimal Execution Problems via In-Context Operator Networks
- 강건 추정·위험측도 계열: Distributionally robust portfolio maximisation and marginal utility pricing, Risk measures beyond frictionless markets, Deep Hedging: Learning to Remove the Drift under Trading Frictions
- 포트폴리오 구축 계열: Mesoscopic Structure of the Stock Market and Portfolio Optimization, Sparse Portfolio Selection via Topological Data Analysis based Clustering, Rethinking Beta: A Causal Take on CAPM
- 추세 추종 계열: The Science and Practice of Trend-Following Systems, Trend-Following Strategies via Dynamic Momentum Learning, Optimal trend following portfolios
이 글은 2018년 7월 arXiv 백필 코호트(전체 90편, 관련 56편)의 평가 결과를 바탕으로 작성했습니다. 모든 수치는 원문 논문에서 인용했으며, 블로그 성격상 일부 이론적 세부사항은 생략했습니다. 심층 분석은
analysis/reports/backfill/1807.md를 참고하세요.
📚 이 글에서 다룬 논문 (45편)
- AA factor-model approach for correlation scenarios and correlation stress-testing
Natalie Packham, Fabian Woebbeking
- A
- AA Semi-parametric Realized Joint Value-at-Risk and Expected Shortfall Regression Framework
Chao Wang, Richard Gerlach, Qian Chen
- A
- ATrading Cointegrated Assets with Price Impact
Alvaro Cartea, Luhui Gan, Sebastian Jaimungal
- BDiffusion Approximations for Expert Opinions in a Financial Market with Gaussian Drift
Jörn Sass, Dorothee Westphal, Ralf Wunderlich
- BLiquidity in Competitive Dealer Markets
Peter Bank, Ibrahim Ekren, Johannes Muhle-Karbe
- BPolynomial time algorithm for optimal stopping with fixed accuracy
David A. Goldberg, Yilun Chen
- BCo-existence of Trend and Value in Financial Markets: Estimating an Extended Chiarella Model
Adam Majewski, Stefano Ciliberti, Jean-Philippe Bouchaud
- BEuropean Option Pricing with Stochastic Volatility models under Parameter Uncertainty
Samuel N. Cohen, Martin Tegnér
- BSystems of ergodic BSDEs arising in regime switching forward performance processes
Ying Hu, Gechun Liang, Shanjian Tang
- BIncremental Sharpe and other performance ratios
Eric Benhamou, Beatrice Guez
- B
- B
- BOptimal investment and consumption with forward preferences and uncertain parameters
Wing Fung Chong, Gechun Liang
- BOptimal Portfolio in Intraday Electricity Markets Modelled by Lévy-Ornstein-Uhlenbeck Processes
Marco Piccirilli, Tiziano Vargiolu
- BHedging with physical or cash settlement under transient multiplicative price impact
Dirk Becherer, Todor Bilarev
- BOn SDEs with Lipschitz coefficients, driven by continuous, model-free martingales
Lesiba Ch. Galane, Rafał M. Łochowski, Farai J. Mhlanga
- BOptimal Credit Investment and Risk Control for an Insurer with Regime-Switching
Lijun Bo, Huafu Liao, Yongjin Wang
- BFailure of Smooth Pasting Principle and Nonexistence of Equilibrium Stopping Rules under Time-Inconsistency
Ken Seng Tan, Wei Wei, Xun Yu Zhou
- B
- BDisentangling and quantifying market participant volatility contributions
Marcello Rambaldi, Emmanuel Bacry, Jean-François Muzy
- BDeep Learning-Based BSDE Solver for Libor Market Model with Application to Bermudan Swaption Pricing and Hedging
Haojie Wang, Han Chen, Agus Sudjianto 외 2명
- BOn the optimal choice of strike conventions in exchange option pricing
Elisa Alòs, Michael Coulon
- BRebalancing Frequency Considerations for Kelly-Optimal Stock Portfolios in a Control-Theoretic Framework
Chung-Han Hsieh, John A. Gubner, B. Ross Barmish
- B
- ACorrelation scenarios and correlation stress testing
N. Packham, F. Woebbeking
- AMulti Anchor Point Shrinkage for the Sample Covariance Matrix (Extended Version)
Hubeyb Gurdogan, Alec Kercheval
- AOptimal Portfolio Using Factor Graphical Lasso
Tae-Hwy Lee, Ekaterina Seregina
- A
- AOptimal Execution under Incomplete Information
Etienne Chevalier, Yadh Hafsi, Vathana Ly Vath
- ASolving Optimal Execution Problems via In-Context Operator Networks
Tingwei Meng, Moritz Voß, Nils Detering 외 3명
- A
- ADeep Hedging: Learning to Remove the Drift under Trading Frictions with Minimal Equivalent Near-Martingale Measures
Hans Buehler, Phillip Murray, Mikko S. Pakkanen 외 1명
- AMesoscopic Structure of the Stock Market and Portfolio Optimization
Sebastiano Michele Zema, Giorgio Fagiolo, Tiziano Squartini 외 1명
- ASparse Portfolio Selection via Topological Data Analysis based Clustering
Anubha Goel, Damir Filipović, Puneet Pasricha
- AThe Science and Practice of Trend-Following Systems
Artur Sepp, Vladimir Lucic
- ATrend-Following Strategies via Dynamic Momentum Learning
Bruno P. C. Levy, Hedibert F. Lopes
- A
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2026-09 월간
2026년 9월의 금융 AI 연구: 측정이 통념을 뒤집고, 검증이 창의성을 압도하다
2026년 9월 arXiv에 공개된 금융 AI 연구를 5개 테마로 정리했습니다. 1년치 CME 실측 데이터로 HFT 설계 원칙을 뒤집은 S티어 논문, 수천 개 LLM 에이전트의 프로덕션 현실, anytime-valid 심판으로 팩터 거짓발견을 5~11배 줄이는 방법, 매직 스트라이크로 분산 계약을 정밀 산정하는 수학, drawdown을 강건하게 제어하는 포트폴리오 이론까지 — 측정과 검증이 창의성을 압도하는 달이었습니다.
 📊 2026-08 월간
2026년 8월의 금융 AI 연구: 이론과 실전의 간극이 좁혀지는 달
2026년 8월 arXiv에 공개된 금융 AI 연구를 4개 테마로 정리했습니다. 포트폴리오 최적화의 실전화, LLM 에이전트 벤치마크 전쟁, 변동성 표면의 수학적 통일, 뉴스 NLP의 시간 누수 감사 — 이론이 실제로 작동하는 도구로 변하는 순간을 포착했습니다.
 📊 2026-07 월간
7월의 AI 투자 연구: 더 큰 모델이 정답이 아니다
2026년 7월 시스템 트레이딩 연구 동향. LLM 에이전트 비용 최적화, DEX 라우팅 $2,400만 손실 계량화, 추세추종의 주파수 영역 해석, 포트폴리오 분포 불확실성 강건 최적화, 시계열 부트스트랩 실용화.