
"더 똑똑한 모델을 만드는 해가 아니라, 우리가 믿던 가정을 정직하게 검사하는 해." 2024년 7월의 금융 논문들을 이렇게 요약할 수 있을 것 같습니다.
들어가며: 2024년 7월, 어떤 달이었나
주식 투자를 해 보신 분이라면 한 번쯤 이런 경험을 하셨을 겁니다. 백테스트에서는 매년 20%씩 벌던 전략이, 실제 돈을 넣자마자 흔들리는 경험. "모델이 틀렸나?"라고 생각하기 전에, 사실은 모델이 딛고 서 있는 가정이 현실과 어긋나 있는 경우가 많습니다. 주문이 저절로 체결될 거라는 가정, 시장의 변동성이 매끈하게 흘러갈 거라는 가정, 회사가 속한 산업이 하나로 고정된다는 가정 같은 것들이요.
2024년 7월, arXiv에는 금융·퀀트 관련 논문 309편이 올라왔습니다. 저희 기준으로 실제 연구·실무에 의미 있는 관련 논문 157편을 골랐고, 그중 가장 뛰어난 에이(A) 등급 10편이 나왔습니다. 이 10편을 자세히 읽어 보니 하나의 흐름이 보이더군요. 화려한 새 모델을 내놓기보다, "우리가 여태 당연하게 여기던 것들이 사실은 아니었다"를 데이터와 증명으로 보여주는 연구가 이 달의 정상에 서 있었습니다.
이번 글에서는 다섯 가지 테마로 2024년 7월의 퀀트 연구 지형을 안내드립니다. 어렵게 느껴지는 개념은 일상의 비유로 풀어 설명할게요.
테마 1: 예측과 투자는 다르다 — M6 대회 우승자가 알려준 비밀
대회에서 1등을 한 전략은 "돈을 잘 버는 전략"이 아니었다
친구들끼리 골프 내기를 하는데, "내가 이기는 방법"이 "내가 가장 멀리 치는 방법"과 다르다는 걸 아시나요? 순위만 잘 보면 되는 내기라면, 앞선 사람의 공이 해저드에 빠지기를 기대하며 안전하게 치는 편이 오히려 유리할 수 있습니다. 바로 이 "경쟁의 역학"을 포트폴리오에 적용한 논문이 2024년 7월의 최고 점수를 받았습니다.
대표 논문: M6 경쟁 종합 1위, 하지만 저자는 "운이었다"고 말한다
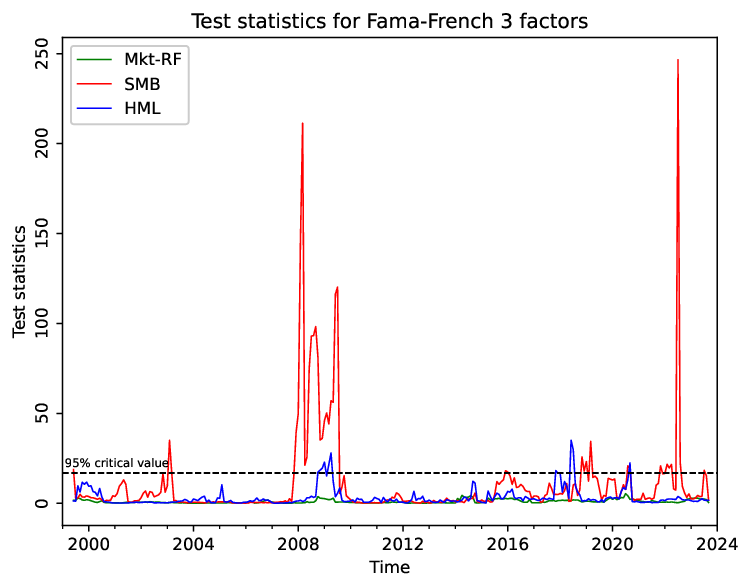
Designing Time-Series Models With Hypernetworks & Adversarial Portfolios (arXiv:2407.20352) — 이 논문은 2022년 3월부터 2023년 2월까지 1년간 진행된 M6 예측 경쟁의 결과를 정리한 것입니다. M6 대회는 S&P 500 종목 50개와 국제 ETF 50개, 총 100개 자산을 두고 두 가지 챌린지를 겨뤘습니다. 하나는 "앞으로 4주 뒤 이 자산의 수익률이 다른 자산들 사이에서 몇 등쯤 할까요?"를 5개 구간의 확률로 예측하는 것이고(예측 챌린지), 다른 하나는 실제 포트폴리오 비중을 제출해 리스크 대비 수익으로 겨루는 것입니다(투자 챌린지). 이 저자는 예측 4위, 투자 6위를 기록했지만 두 순위의 평균을 내는 종합(듀애슬론)에서 1위를 차지했습니다.
무엇이 승리를 가져왔을까요? 두 가지입니다.
첫째, 예측 챌린지에는 하이퍼네트워크(hypernetwork)라는 재미있는 구조를 썼습니다. 보통 인공지능은 "정답을 내놓는 기계"죠. 하이퍼네트워크는 한 단계 더 갑니다. "정답을 내놓는 기계를 만들어 주는 기계"인 겁니다. 자산 100개마다 시계열이 조금씩 다르니, 100개의 예측 모델을 따로 만들 수도 있지만 데이터가 적어서 어렵습니다. 그래서 "자산별로 조금씩 다르게 조정된 모델"을 자동으로 생성하는 상위 모델을 두고, 공통 패턴은 전체 데이터에서, 개별 차이는 자산별 파라미터에서 배우게 했습니다. 이 방법은 사인파 회귀라는 표준 테스트에서 기존의 최고 수준 메타러닝(모델이 빨리 적응하도록 가르치는 기법)을 이겼고, M4 시계열 대회 데이터에서도 기존 모델을 앞섰습니다.
둘째, 투자 챌린지에서는 남들이 하지 않는 것을 했습니다. 바로 적대적 포트폴리오(adversarial portfolio)입니다. 앞서 골프 비유에서 이야기했듯, 이 대회는 "절대 수익"이 아니라 "상대 순위"로 겨루니다. 그래서 저자는 제출 포트폴리오의 공매도 비율을 조절해, 내 수익률이 다른 참가자들과 같이 움직이거나(순위가 좋을 때, 방어) 정반대로 움직이게(순위가 나쁠 때, 도박) 만들었습니다. 시뮬레이션 결과 이 전략은 1위가 될 확률을 무작위의 약 3배까지 끌어올렸고, 20위 이내 확률은 약 1.5배였습니다. 심지어 스케일링 조정만으로 4주 구간당 리스크 조정 수익이 약 0.07 개선되기도 했죠(총 베팅 크기를 줄여 수익률의 극단값을 눌러 주면, 로그를 쓰는 채점 방식에서 유리해지기 때문입니다).
하지만 이 논문의 진짜 보물은 다음 한 문장입니다. "우리가 얻은 6위는 대회를 다시 열면 재현되지 않을 가능성이 높다." 적대적 전략이 순위를 올려 주는 대신 기대 수익은 오히려 음수였고, 저자 자신이 "상위 입상자들은 운이 좋은 사람들일 뿐"이라고 썼습니다. 뛰어난 전략을 쓰면서도 그 전략의 한계를 이렇게 정직하게 밝히는 논문은 드뭅니다.
이 테마의 공통 인사이트: 예측을 잘하는 것과 돈을 버는 것은 다른 기술입니다. 이 달의 다른 논문들도 "예측 → 포지션 → 실제 성과"를 하나의 통째로 된 설계 문제로 다뤄야 한다고 말합니다.
함께 볼 논문: 그래프 어텐션 네트워크로 자산 간 관계를 실시간으로 반영하는 대규모 포트폴리오 최적화(2407.15532), 베이지안 공적분으로 저변동성 포트폴리오를 만드는 방법(2407.10175)도 같은 고민에서 출발합니다.
테마 2: 변동성은 매끈하지 않다 — "거친 변동성"을 데이터로 판정하기
주가의 변동성, 현미경으로 보면 어떨까요?
바다 수면을 멀리서 보면 매끈해 보이지만, 가까이 가면 작은 잔물결이 끝없이 겹쳐 있죠. 금융에서 "변동성"(가격이 흔들리는 정도)도 마찬가지입니다. 고전적인 모델은 변동성이 그래도 비교적 매끈하게 흘러간다고 봅니다. 그런데 최근 각광받는 대안 가설은 "변동성은 사실 거칠다(rough)"입니다. 초 단위로 쪼개 볼수록 변동성이 미친 듯이 요동치며, 수학적으로는 "이차변량이 무한하다"는 극단적 상태까지 갑니다. 어느 쪽이 진실이냐에 따라 옵션 가격, 리스크 관리, 예측 모델의 성능이 크게 달라집니다.
지금까지 이 논쟁은 모델들끼리의 싸움이었습니다. 그런데 2024년 7월, 데이터로 판정하는 검정 방법이 나왔습니다.
대표 논문: 11년치 SPY 데이터가 말해 주는 것
A Nonparametric Test for Rough Volatility (arXiv:2407.10659)의 아이디어는 우아합니다. 변동성이 거칠다면, 고빈도 구간에서 "변동성이 방금 얼마나 변했는지"를 나타내는 증분들이 서로 반대 방향으로 흔들리는(음의 자기상관) 성질이 생깁니다. 마치 거친 모래사장의 높낮이가 올라갔다 내려갔다 번갈아 나타나는 것과 비슷하죠. 반대로 매끈한 변동성이라면 그런 패턴이 없어야 합니다. 저자는 이 성질을 검정 통계량으로 만들어, 점프가 아무리 많고 시장 데이터가 지저분해도(미시구조 잡음) 흔들리지 않는 검정을 수학적으로 증명했습니다.
실증 결과는 인상적입니다. S&P 500 추적 ETF인 SPY의 2012~2022년 5초 간격 데이터를 썼는데,
- 연도별로 검정하면 11년 중 5~7년이 "변동성은 거칠다"를 지지했고,
- 3년 이상 구간에서는 예외 없이 거친 변동성 쪽으로 판정이 났습니다(전체 기간 통계량 −5.27, 유의수준 5%에서 명백한 기각).
- 변동성 증분의 자기상관이 지연 1~7까지 전부 음수로 나온 것도 거친 변동성의 예상 패턴과 정확히 일치합니다.
흥미로운 점은 저자들의 정직한 고백입니다. 변동성이 거칠수록 "지금 이 순간의 변동성"을 정확히 잡는 일은 사실상 불가능에 가깝다고 말합니다. 대신 "짧은 구간의 평균 변동성"은 기존 도구로도 잘 추정된다는 것이 확인되었습니다. 측정할 대상을 지점에서 구간으로 바꾸면 실무가 가능해진다는, 아주 실용적인 결론이죠.
(이 논문은 원문에서 공식 그림 파일을 추출 도구로 받아 오지 못해 이 테마에는 그림을 넣지 않았습니다. 대신 논문의 핵심 그림은 원문 링크에서 직접 확인하실 수 있습니다.)
이 테마의 공통 인사이트: 옵션·변동성 연구가 "더 복잡한 모델"에서 "모델이 어디서 깨지는지 검사하고, 깨진 자리를 헤징으로 메우기"로 이동하고 있습니다. 함께 실린 논문들을 보면 같은 방향입니다.
함께 볼 논문: S&P 500 지수옵션 매도 전략에서 두 가지 헤징 모델을 1분 데이터로 비교한 연구(2407.13908), 내재변동성 곡면의 움직임을 반영해 딥 헤징을 개선한 연구(2407.21138), 블랙-숄즈 델타의 오차를 신경망이 대신 학습하는 딥 델타 헤징(2407.19367)이 대표적입니다.
테마 3: 팩터는 흔들린다 — 위기에 무너지는 투자 공식을 통계로 잡아내기
"규모가 작은 회사가 잘 오른다"는 공식, 언제나 진실일까요?
주식 투자 공식, 즉 팩터(factor)는 요리 레시피와 같습니다. "소형주", "가치주" 같은 재료를 정해진 비율로 넣으면 수익이 나온다는 믿음이죠. 그런데 레시피가 항상 통하지 않는 시기가 있습니다. 금융위기처럼 큰 충격이 오면 "소형주 팩터"가 통째로 작동을 멈추기도 합니다. 문제는 이런 고장을 사후에 발견한다는 데 있습니다.
2024년 7월의 대표 논문은 이 "고장"을 미리 통계로 감지할 수 있는 이론을 세웠습니다.
대표 논문: 약해 빠진 요인도, 통계로 잡을 수 있다
When Can Weak Latent Factors Be Statistically Inferred? (arXiv:2407.03616). 제목부터 "약한 요인(weak factor)"을 다룹니다. 전통 이론은 시장을 움직이는 보이지 않는 요인(잠재 요인)이 아주 강해서, 종목이 아무리 많아도 그 영향이 선명하게 드러난다고 가정했습니다. 마치 큰 스피커 소리가 수백 명의 속삭임을 압도하는 것처럼요. 하지만 현실의 요인은 약합니다. 스피커가 아니라 옆 사람 목소리 수준이죠. 게다가 개별 종목의 잡음(잔차)은 서로 엮여 있어서, 지금까지 쓰이던 수학 기법이 통하지 않았습니다.
이 논문은 요인이 약하고 잡음이 서로 얽힌, 현실에 가까운 조건에서도 PCA(주성분 분석, 데이터에서 숨은 패턴을 뽑는 표준 기법)로 요인을 추정하고 신뢰구간 같은 통계적 추론까지 성립함을 증명했습니다. 놀라운 것은 필요한 조건입니다. 기존 이론은 "종목 수가 늘어나면 신호가 엄청나게 강해져야 한다"고 요구했지만, 이 논문은 로그 수준의 성장만으로 충분하다고 보여 줍니다. 쉽게 말하면 "스피커를 더 키울 필요 없이, 조금만 오래 들으면 된다"는 뜻입니다.
이 이론으로 만든 검정을 실제 S&P 500 종목들의 월간 수익률(1995년~2024년 3월)에 적용한 결과가 재미있습니다.
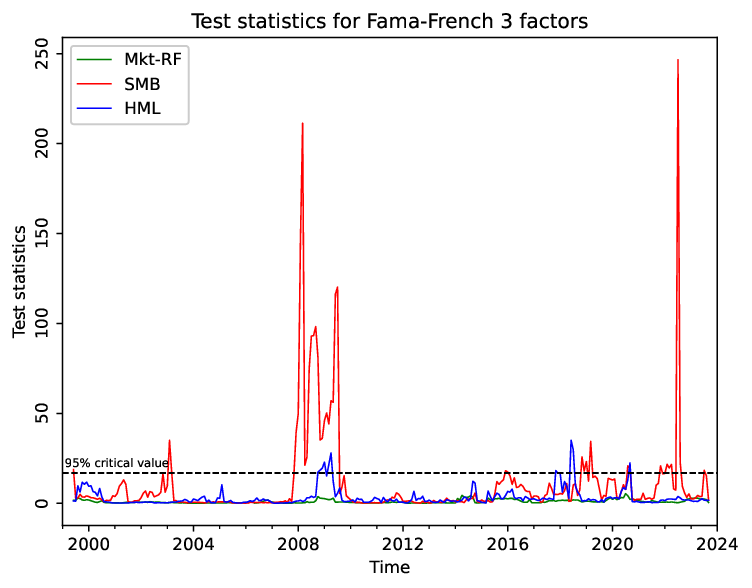
- 2007~2009 금융위기 동안 "소형주 요인(SMB)"이 데이터를 설명하지 못한다는 판정이 나왔습니다. 규모가 중요하지 않아진 게 아니라, 기존의 소형주 지표가 그 시기의 규모 효과를 담아내지 못했다는 뜻입니다.
- 가치 요인(HML)도 2009년 전후와 코로나 시기에 설명력을 잃었습니다. 2022년 초 러시아-우크라이나 전쟁 충격 때도 요인 검정에 스파이크가 생겼고요.
- 반면 시장 전체 요인(MKT)은 약 29년의 전 구간에서 설명력을 유지했습니다. 위기에도 꺼지지 않는 유일한 스피커였던 셈입니다.
이 테마의 공통 인사이트: 팩터 연구의 최전선은 "새 팩터 발굴"이 아니라 "요인이 흔들리는 순간을 통계로 감지하고, 흔들려도 성립하는 추론"으로 이동하고 있습니다. 함께 실린 논문들도 회사의 산업 분류를 하나가 아닌 여러 개의 확률로 보거나(2407.16437), 시간에 따라 나타났다 사라지는 희소 요인을 추출하거나(2407.09738), 같은 방향의 고민을 담고 있습니다.
테마 4: AI가 읽는 연준의 속마음 — 성명서에 없는 이견의 발견
회의실에서 벌어진 일과 발표문의 온도차
회사 회의를 생각해 보세요. 팀원들이 격렬하게 논쟁한 끝에 "전원 만장일치로 추진합니다"라는 공지가 나갑니다. 회의실의 공기는 전혀 만장일치가 아니었지만요. 중앙은행도 비슷합니다. 미국 연준(FOMC)은 회의 직후 성명을 내고, 3주 뒤에 회의록, 5년 뒤에 전체 녹취록을 공개합니다. 성명은 다듬고 다듬어 "단결된 목소리"만 남기죠.
2024년 7월의 한 논문은 GPT-4에게 이 문서들을 모두 읽게 했습니다.
대표 논문: GPT-4가 발견한, 성명에서 사라진 목소리들
GPT Deciphering Fedspeak (arXiv:2407.19110)의 연구진(프린스턴대 경제학자 Alan Blinder 포함)은 매파(금리 인상 선호)와 비둘기파(인하 선호)를 5단계 척도로 나누고, GPT-4로 1994~2016년 성명 3,728개 문장과 녹취록 5,691개 발화자 구간을 채점했습니다. 그리고 사람이 직접 만든 정답 라벨과 대조했는데, 여기서 재미있는 방법론적 교훈이 나옵니다. 문장을 하나씩 따로 채점하면(문장의 62%가 "중립"이라) 성명의 진짜 성향이 사라졌고, 성명 전체를 통째로 읽게 했을 때만 사람의 판정에 가깝게 나왔습니다. AI에게 문서를 줄 때 "문맥 전체"가 중요하다는, 지금도 유효한 교훈이죠.
핵심 발견은 이겁니다. 성명에 이견이 없다고 나오는 경우에도, 실제 녹취록의 69% 이상에서 이견이 발견되었습니다. 전체로 보면 성명은 47%만 이견을 담는 반면 녹취록은 82%가 이견을 담았습니다. 어떤 문서가 더 사실에 가까운지는 굳이 설명하지 않아도 되겠죠.
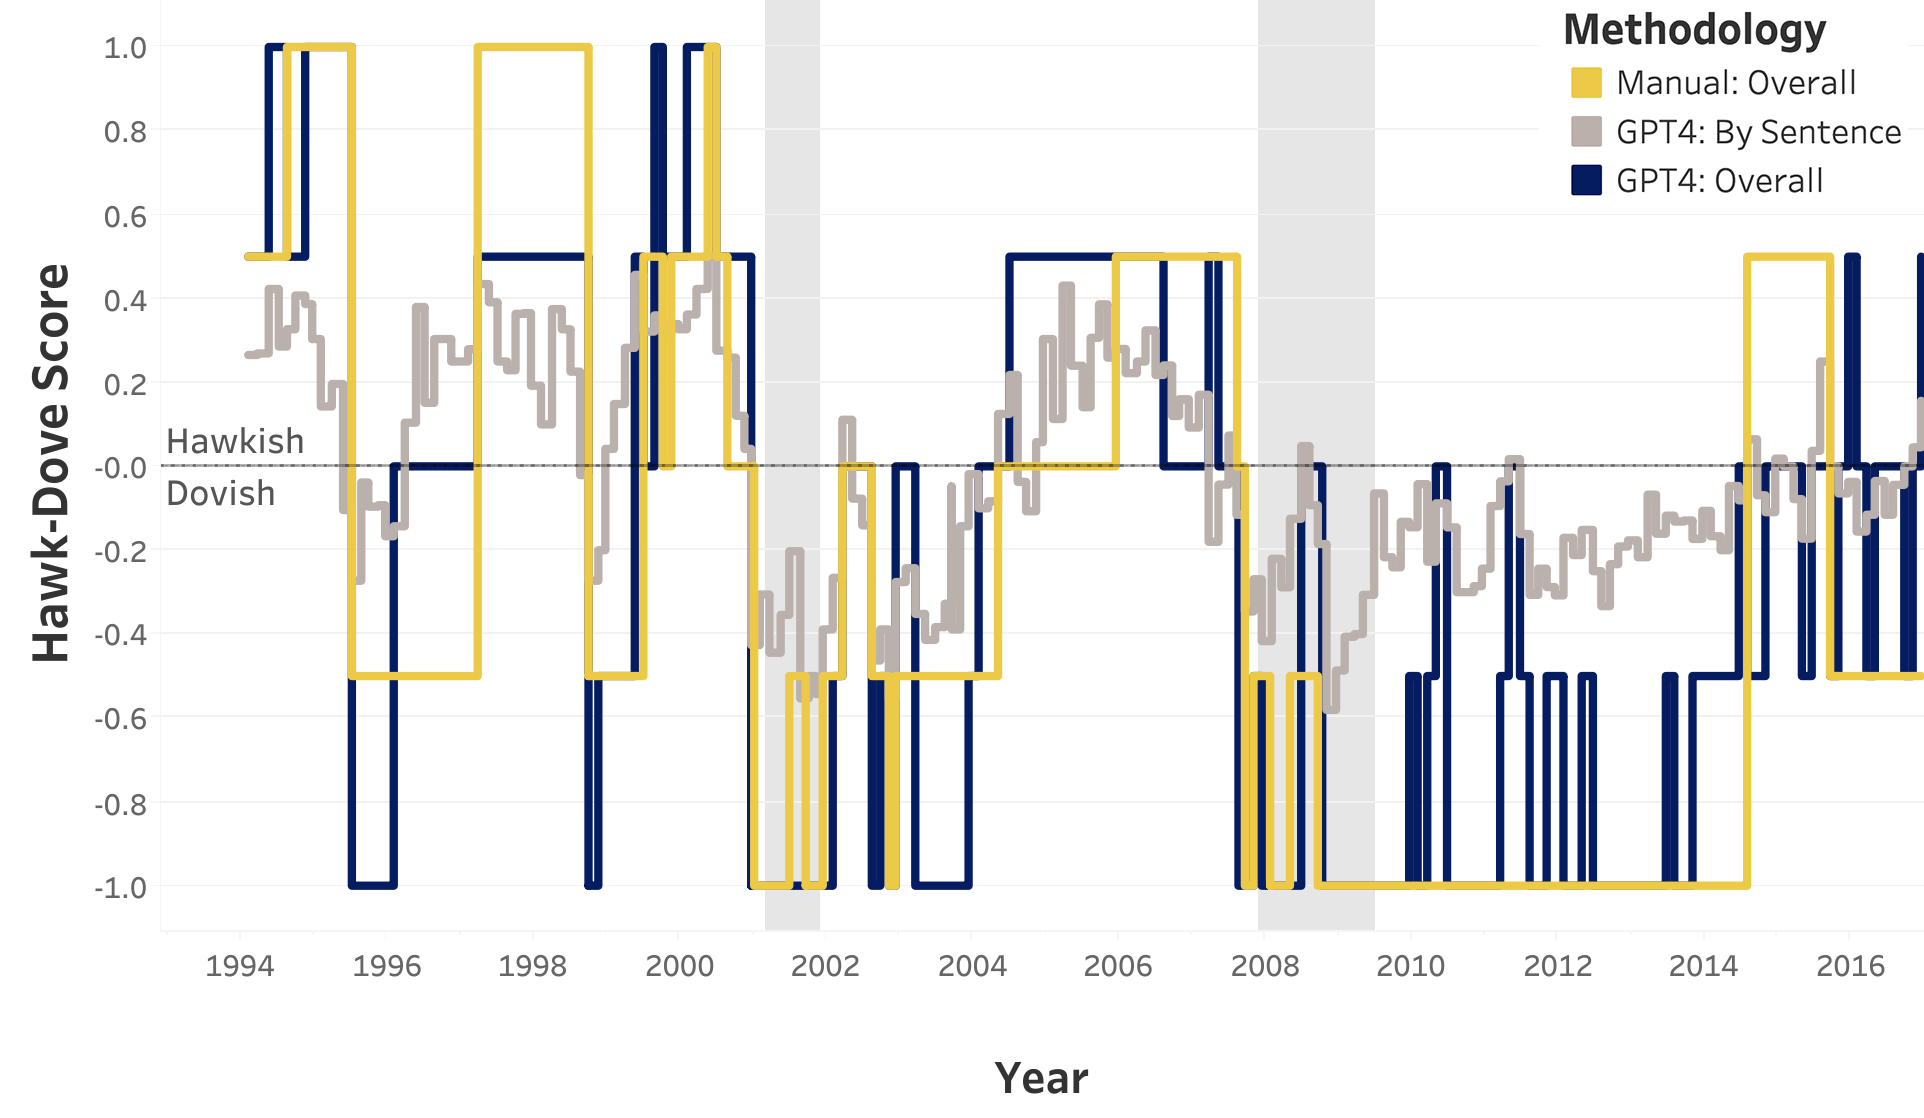
심지어 점수의 범위도 녹취록(−3.663.37)이 성명(−3.402.40)보다 넓었습니다. 연준이 회의실의 격한 목소리를 깎아 다듬어 "우리는 한목소리"라는 포장을 만든다는 것이 수치로 확인된 셈입니다. 2016년 1월 회의만 해도 그렇습니다. 물가 2% 목표를 두고 한 위원은 "합리적 확신이 있다"고, 다른 위원은 "오히려 의심이 늘었다"고 맞섰지만, 공개 성명에는 그 균열의 흔적이 전혀 없었습니다.
이 테마의 공통 인사이트: 금융 분야의 AI 활용이 "감성 점수 매기기"에서 "사람이 놓친 정성 정보의 정량화"로 이동했습니다. 동시에 사람이 만든 정답 라벨로 검증하는 태도가 결과의 신뢰도를 좌우한다는 것도 공통된 교훈입니다.
함께 볼 논문: GPT-4의 재무제표 분석이 인간 애널리스트의 이익 예측과 경쟁한다는 실증(2407.17866), 언어적 강화로 학습하는 LLM 멀티에이전트 투자 시스템 FinCon(2407.06567)도 이 흐름의 대표 주자입니다.
테마 5: 주문이 체결되는 순간, 당신은 이미 잃고 있다
"공짜로 체결되는" 지정가 주문의 진실
주식을 사려고 할 때 두 가지 방법이 있습니다. 지금 바로 시장가로 사는 것(빠르지만 수수료처럼 미끄러지는 비용이 있음)과, 원하는 가격에 지정가 주문을 걸어 기다리는 것(체결되면 비용을 아끼지만 안 팔릴 수도 있음). 많은 트레이딩 모델은 지정가 주문이 무작위로, 저비용으로 체결된다고 가정합니다. 기다리다 보면 언젠가 체결되니 거의 공짜에 가깝다고 보는 거죠.
2024년 7월의 마지막 대표 논문은 이 가정이 정확히 반대라고 말합니다.
대표 논문: 지정가 체결은 "불리한 순간"에만 일어난다
The Negative Drift of a Limit Order Fill (arXiv:2407.16527)의 논리는 이렇습니다. 내가 100원에 사겠다고 호가에 주문을 걸어 두면, 이 주문이 체결되는 경로는 사실상 하나입니다. 가격이 100원 아래로 떨어질 때 누군가 내게 100원에 팔기 때문입니다. 즉, 내 주문이 체결되는 그 순간은 이미 가격이 나에게 불리하게 움직인 순간이라는 뜻입니다. 체결은 선물이 아니라 선택적 악재인 셈이죠. 논문은 이 "지정가 체결의 음의 드리프트"를 이산 시장 모델로 증명하고, 실제 데이터로 확인했습니다.
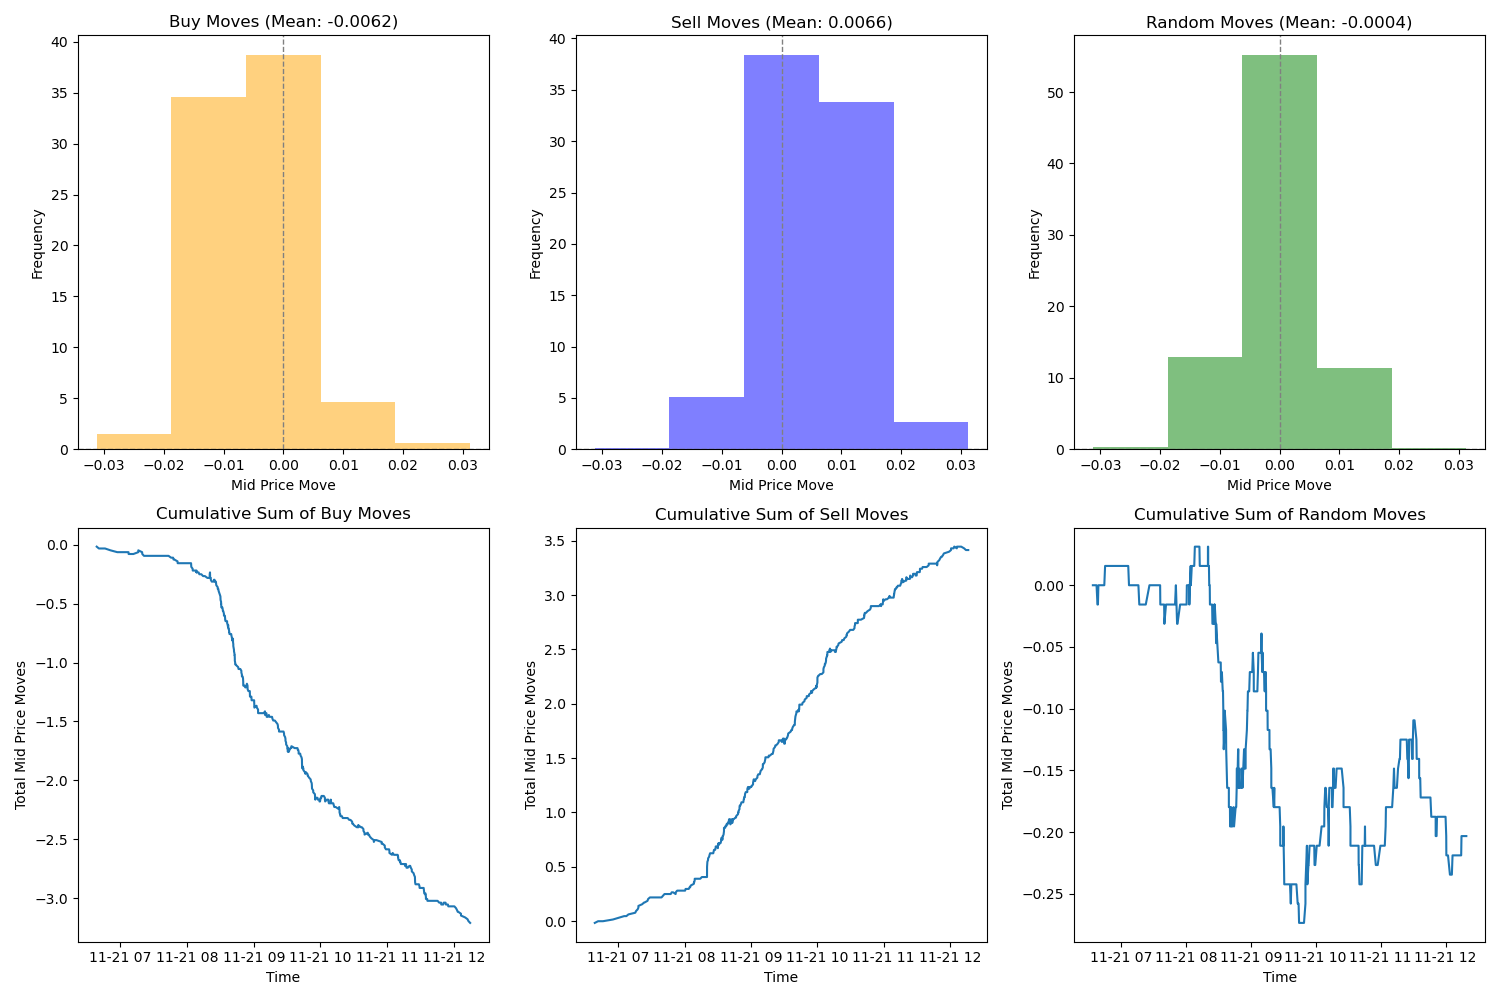
실증 대상은 세계에서 가장 많이 거래되는 상품 중 하나인 10년 만기 미국 국채 선물(TY)입니다. 매수 체결 뒤 100 이벤트 동안의 중간가격 움직임을 모아 보니(각 그룹 521개 표본), 매수 체결 뒤에는 뚜렷한 하락 드리프트, 매도 체결 뒤에는 상승 드리프트가 나타났고, 무작위 시점을 고른 대조군에는 거의 드리프트가 없었습니다. 평균 드리프트는 약 −0.0065로, TY 선물의 최소 가격 단위(틱, 1/64 = 0.015625)의 약 42%에 해당합니다. "시장가 주문은 1/2틱의 미끄러짐 비용이 드니 지정가로 아끼자"는 통념에 대해, 지정가 체결은 그 아낀 비용의 상당 부분을 드리프트로 되돌려 빼앗아간다는 계산입니다.
백테스트 비교는 더 실용적입니다. 같은 시장 데이터로 세 가지 시뮬레이션을 돌려 보니,
- "체결은 100% 저절로 된다"고 가정한 모델은 수익이 실제와 완전히 다른 스케일로 부풀었습니다(주문 13,935건 중 11,859건 체결).
- "체결 간격이 지수분포를 따른다"는 고전 가정도 틀렸습니다. 실제 체결 1,985건의 평균 간격은 11.9초인데, 짧은 간격과 아주 긴 간격이 지수분포보다 훨씬 많았습니다(두꺼운 꼬리).
- "불리한 순간 체결" 로직 + 실제에 맞춘 확률을 넣은 모델만이 실제(베이스라인)와 가장 가까웠습니다. 체결률도 65% 대 60%로 근접했고, 하루 중 급격한 손실 구간까지 재현했습니다.
저자들은 단기 예측 신호(오더플로, 기계학습 등)로 다음 가격 방향을 어느 정도 맞출 수는 있지만, 실제와의 상관이 15~25%에 그쳐 불리한 체결을 피하는 데는 한계가 있다고 말합니다. 그러니 음의 드리프트를 없애려 애쓰기보다, 기본값으로 깔아 놓고 전략을 평가해야 한다는 것이 결론입니다.
이 테마의 공통 인사이트: 거래비용과 유동성 마찰은 "나중에 빼는 수수료"가 아니라 모델 한복판에 놓아야 할 구조입니다. 거래비용을 다루는 점근 이론(2407.13547, 2407.07100)이나, 탈중앙화 거래소의 유동성 공급 손실을 옵션처럼 헤지하는 연구(2407.05146)도 같은 메시지를 전합니다.
월 전체 정리: 더 큰 모델이 아니라, 더 정직한 검증
2024년 7월의 다섯 테마를 하나의 문장으로 묶으면 이렇습니다. "가정이 깨지는 지점을 정직하게 찾아내고, 깨져도 성립하는 방법으로 다시 묻는다." 요인이 약해도 추론이 되는지 묻고(테마 3), 변동성이 거칠 수 있는지 데이터로 판정하며(테마 2), 주문이 공짜로 체결된다는 믿음을 반박하고(테마 5), 성명에 없는 이견을 찾아내고(테마 4), 심지어 대회 우승자가 "이 성과는 운이었다"고 스스로 밝힙니다(테마 1).
AI가 시장에 들어오는 시대일수록, 이런 태도는 더 중요해집니다. 모델이 복잡해질수록 우리가 확인해야 할 것은 모델의 똑똑함이 아니라 모델이 딛고 있는 가정의 튼튼함이니까요.
한계와 주의점
- 이 글의 논문들은 대개 1년 안팎의 특정 데이터로 검증되었으며, 어떤 것도 미래 수익을 보장하지 않습니다. 특히 M6 우승 전략(테마 1)은 저자 스스로 재현 가능성이 낮다고 밝혔습니다.
- 대표 논문들의 재현성 점수(코드·데이터 공개 정도)는 35~48점대로 낮은 편입니다. 아이디어는 훌륭하지만, 그대로 따라 하려면 독자적인 검증이 필요합니다.
- 지정가 체결 실험(테마 5)은 국채 선물 한 종목 기준이며, 틱 규모가 다른 시장에 그대로 적용하기는 어렵습니다.
더 알아보기
이번 달 대표 논문들의 원문과 5차원 평가 점수입니다(점수 순서: 혁신성 / 적용가능성 / 엄밀성 / 재현성 / 통찰).
- 2407.20352 — M6 우승 하이퍼네트워크 포트폴리오 (A, 종합 71.7 — 78/80/72/45/76)
- 2407.10659 — 거친 변동성 비모수 검정 (A, 종합 71.6 — 75/65/90/40/78)
- 2407.03616 — 약한 요인의 통계적 추론 (A, 종합 67.8 — 80/62/76/38/78)
- 2407.19110 — GPT-4가 읽는 연준 회의록 (A, 종합 66.5 — 72/68/61/48/76)
- 2407.16527 — 지정가 체결의 음의 드리프트 (A, 종합 65.4 — 72/78/68/35/82)
비슷한 주제를 더 파고 싶으시다면, 지식베이스에서 관련 논문도 찾아보실 수 있습니다. 예를 들어 거친 변동성 테마에는 Volatility has to be rough (arXiv:2002.09215), 미시구조 테마에는 No Tick-Size Too Small (arXiv:2410.08744)가 이어집니다.
📚 이 글에서 다룬 논문 (14편)
- BA nonparametric test for rough volatility
Carsten H. Chong, Viktor Todorov
- AWhen can weak latent factors be statistically inferred?
Jianqing Fan, Yuling Yan, Yuheng Zheng
- AGPT Deciphering Fedspeak: Quantifying Dissent Among Hawks and Doves
Denis Peskoff, Adam Visokay, Sander Schulhoff 외 3명
- BLarge-scale Time-Varying Portfolio Optimisation using Graph Attention Networks
Kamesh Korangi, Christophe Mues, Cristián Bravo
- BLow Volatility Stock Portfolio Through High Dimensional Bayesian Cointegration
Parley R Yang, Alexander Y Shestopaloff
- AConstruction and Hedging of Equity Index Options Portfolios
Maciej Wysocki, Robert Ślepaczuk
- BEnhancing Deep Hedging of Options with Implied Volatility Surface Feedback Information
Pascal François, Geneviève Gauthier, Frédéric Godin 외 1명
- BEnhancing Black-Scholes Delta Hedging via Deep Learning
Chunhui Qiao, Xiangwei Wan
- BFinancial Statement Analysis with Large Language Models
Alex Kim, Maximilian Muhn, Valeri Nikolaev
- BFinCon: A Synthesized LLM Multi-Agent System with Conceptual Verbal Reinforcement for Enhanced Financial Decision Making
Yangyang Yu, Zhiyuan Yao, Haohang Li 외 9명
- A
- ANo Tick-Size Too Small: A General Method for Modelling Small Tick Limit Order Books
Konark Jain, Jean-François Muzy, Jonathan Kochems 외 1명
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2026-04 월간
AI가 진짜 돈을 움직이기 시작했다 — 2026년 4월 금융 AI 연구 하이라이트
2026년 4월 금융 AI 연구 동향. LLM 에이전트가 실제 자본으로 온체인 거래를 시작하고, 백테스트의 허상이 대규모 실증으로 검증된 달의 핵심 논문들을 살펴봅니다.
 📊 2026-03 월간
AI가 주식을 예측할 수 있을까? — 2026년 3월 금융 AI 연구 리뷰
2026년 3월 금융 AI 논문 734편을 분석한 월간 종합. LLM의 시간 편향 문제, 백테스트 엔진의 숨겨진 오차, 포트폴리오 최적화의 새로운 수학, LOB 시뮬레이션의 현실화, 강화학습 트레이딩 시스템의 실전 전환까지 — 신뢰할 수 있는 금융 AI를 만드는 5가지 연구 테마를 살펴봅니다.
 📊 2026-01 월간
AI가 포트폴리오를 짜고, 뉴스를 조작하고, 블록체인에서 대량 매도한다 — 2026년 1월 금융 AI 연구 하이라이트
2026년 1월 arXiv에 올라온 금융 AI 연구를 5개 테마로 정리했습니다. 파라미터 불확실성을 포트폴리오에 반영하는 방법, LLM 에이전트의 결정 재현성 문제, DEX에서의 대량 매도 최적화, 연합학습으로 신용리스크를 예측하는 방법, 그리고 주문흐름과 변동성을 하나로 묶는 미시구조 이론까지.