
LENS: Large Pre-trained Transformer for Exploring Financial Time Series Regularities
2024년 8월에 나온 금융 AI 논문 중 가장 눈에 띄는 연구들을 골라 쉽게 풀어봅니다.
들어가며: "언제 팔까?"라는 영원한 질문
주식을 샀다면, 언제 팔아야 할까요? 이건 투자의 가장 기본적인 질문이면서도 가장 어려운 질문입니다. 수학적으로 말하면 '최적 정지(optimal stopping)' 문제인데요, 미래가 불확실한 상태에서 "지금이 바로 그 순간인가?"를 판단해야 합니다.
그런데 더 까다로운 문제가 있습니다. 시장이 어떻게 움직이는지 정확히 모르는 상태에서 이 결정을 내려야 한다는 점이죠. 2024년 8월, 이 근본적인 문제에 도전하는 흥미로운 논문이 나왔습니다.
1. 최적 정지, 하지만 모형 없이 — A등급 논문의 핵심 아이디어
논문: Learning to Optimally Stop Diffusion Processes, with Financial Applications (Min Dai 외 4인)
이 논문이 던지는 질문은 명확합니다: "시장의 움직임을 정확히 아는 상태에서 최적 타이밍을 계산하는 건 할 수 있다. 하지만 모형을 모르면 어떻게 할까?"
쉽게 말하면
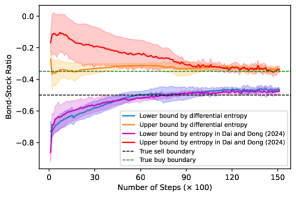
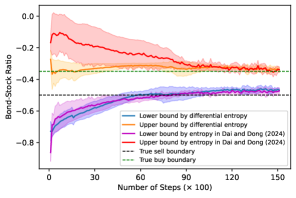
보통 최적 정지를 풀려면 '주가가 이런 확률분포를 따른다'는 가정이 필요합니다. 그런데 현실의 시장은 이 가정을 자주 어기죠. 이 논문은 강화학습(RL)을 활용해 모형 정보 없이도 최적 정지 타이밍을 학습하는 방법을 제안합니다.
구체적으로 이렇게 작동합니다:
- 문제 변환: '언제 멈출까?'라는 정지 문제를 '멈추기 vs 계속하기'라는 두 가지 행동 중 하나를 선택하는 제어 문제로 바꿉니다
- 랜덤화: 두 행동의 선택 확률을 베르누이 분포로 표현하고, 탐색을 위해 엔트로피 규율(entropy regularization)을 추가합니다
- 학습: 시장 데이터를 보면서 "멈추는 게 나았을까, 계속하는 게 나았을까?"를 반복적으로 학습합니다
어디에 쓸 수 있을까요?
이 프레임워크는 세 가지 금융 시나리오에서 효과를 검증했습니다:
- 미국식 옵션 행사 타이밍: 언제 풋옵션을 행사할지 결정
- 메르톤 포트폴리오 선택: 거래비용이 있을 때 언제 리밸런싱할지
- 고차원 최적 정지: 여러 자산에 동시에 적용 가능
특히 인상적인 건, 이 알고리즘이 가치함수와 자유경계(어떤 가격에서 행동을 바꿔야 하는지)를 높은 정밀도로 학습한다는 점입니다. 모형을 몰라도 모형을 아는 것에 버금가는 성능을 낸다는 뜻이죠.
한계도 솔직히: 이 논문은 연속시간 확률과정(diffusion process)을 전제로 합니다. 실제 시장의 점프·비정상성까지 다루지는 않아요. 하지만 "모형 없이도 최적 의사결정이 가능하다"는 방향을 처음 제시했다는 점에서 이론적·실용적 의의가 큽니다.
2. 수익률의 '분포 전체'를 예측한다 — 분위수 신경망
논문: Forecasting stock return distributions around the globe with quantile neural networks (2408.07497)
보통 주가 예측 하면 "내일 1.2% 오를 것이다"처럼 점 하나를 맞추려고 합니다. 하지만 투자자에게 더 중요한 건 "1% 오를 확률은?, 3% 떨어질 확률은?, 10% 폭락할 확률은?" 같은 분포 전체입니다.
이 논문은 분위수 신경망(quantile neural network)을 이용해 주가 수익률의 누적분포함수를 직접 학습합니다. 23개국 데이터로 검증했고요.
왜 유용한가?
- VaR·ES 계산: "99% 확률로 이 이상은 잃지 않는다"를 바로 뽑을 수 있습니다
- 꼬리 리스크: 극단적 하락 가능성을 직접 추정
- 시나리오 생성: 미래 수익률 분포에서 시나리오를 샘플링해 스트레스 테스트
점추정의 한계를 정면으로 넘어서려는 시도입니다.
3. 극단 손실을 직접 겨냥하는 헤지 — 분포적 강화학습
논문: EX-DRL: Hedging Against Heavy Losses with EXtreme Distributional Reinforcement Learning (2408.12446)
기존 강화학습 기반 헤지는 평균 손실을 최소화하는 방향으로 학습합니다. 그런데 실제 위기 상황에서는 평균이 아니라 극단적 손실 구간이 중요합니다.
EX-DRL은 CVaR(조건부 Value-at-Risk) 중심의 분포적 RL로, 손실 분포의 꼬리 영역을 직접 학습 목표로 삼습니다. 쉽게 말하면 "평소엔 괜찮아도 진짜 큰일 날 때만 집중적으로 학습"하는 셈입니다.
실전 의미: 옵션 헤지 전략에서 '평균적으로 1% 손실'보다 '5% 확률로 20% 손실'을 직접 관리할 수 있게 됩니다.
4. 과거로 돌아가서 시장을 다시 플레이하기 — 시간역행 마켓메이킹
논문: Consistent time travel for realistic interactions with historical data: reinforcement learning for market making (2408.02322)
마켓메이킹(호가를 양쪽에 걸고 스프레드를 버는 전략)을 RL로 학습하려면, 내 행동이 시장에 미치는 영향을 시뮬레이션해야 합니다. 그런데 과거 데이터만으로는 "내가 이 호가를 걸었으면 시장이 어떻게 반응했을지"를 알기 어렵죠.
이 논문은 익명 주문흐름 데이터를 이용해 과거 시장을 일관되게 '되감기'하는 프레임워크를 제안합니다. 시간을 거꾸로 돌리면서도 시장의 상호작용이 깨지지 않도록 보장하는 기법이 핵심입니다.
실전 의미: 실제 거래 데이터로 오프라인 RL 학습의 품질을 크게 높일 수 있습니다.
5. 금융에 특화된 기반모델의 등장 — LENS
논문: LENS: Large Pre-trained Transformer for Exploring Financial Time Series Regularities (2408.10111)
최근 시계열 예측에 대형 사전학습 모델(TimeGPT, Chronos 등)이 화제인데요, 이 논문은 금융 데이터에 특화된 사전학습 트랜스포머를 제안합니다.
금융 시계열은 범용 시계열과 성격이 다릅니다:
- 비정상성: 평균과 분산이 계속 변합니다
- 변동성 군집: 조용한 시기와 요란한 시기가 번갈아 옵니다
- 레짐 전환: 시장의 패턴 자체가 바뀝니다
LENS는 이런 금융 고유 특성을 반영한 구조와 사전학습으로, 가격예측·특징학습의 백본으로 쓸 수 있습니다.
한계와 주의점
이번 달 논문들도 몇 가지 공통 한계가 있습니다:
- 이론과 실전의 간극: 최적정지·게임이론 논문들이 수학적으로 우아해도, 실제 시장의 비정상성·점프·유동성 제약까지 다루지 않습니다
- 표본 외 검증 부족: 많은 논문이 특정 기간·특정 시장에서만 검증합니다
- 거래비용 미반입: 학술 논문의 수익률은 종종 수수료·슬리피지를 빼고 계산합니다
실전에 적용하려면 반드시 추가 검증이 필요합니다.
그래서 투자/실무엔?
2024년 8월 연구의 핵심 시사점을 정리하면:
- 모형 불확실성 하의 의사결정: 시장을 정확히 몰라도 RL로 근사 최적 결정을 내릴 수 있다는 방향이 점점 구체화되고 있습니다
- 분포 기반 리스크 관리: 점추정을 벗어나 분포 전체를 예측·관리하는 도구가 현실화되고 있습니다
- 금융 특화 AI: 범용 모델을 그대로 쓰기보다 금융 데이터 특성에 맞춘 모델이 필요하다는 공감대가 형성되고 있습니다
함께하기
이 글이 유익하셨다면:
더 알아보기
| 논문 | 등급 | 핵심 |
|---|---|---|
| 2408.09242 — 최적정지 RL | A (66.8) | 확산과정 최적정지 → RL 변환 |
| 2408.07497 — 분포 예측 | B (64.9) | 분위수 신경망으로 수익률 분포 전체 예측 |
| 2408.12446 — 극단 헤지 | B (64.7) | CVaR 기반 분포적 RL 헤지 |
| 2408.02322 — 마켓메이킹 | B (64.2) | 시간역행 일관 RL |
| 2408.10111 — LENS | B (64.0) | 금융 특화 사전학습 트랜스포머 |
📚 이 글에서 다룬 논문 (5편)
- BLearning to Optimally Stop Diffusion Processes, with Financial Applications
Min Dai, Yu Sun, Zuo Quan Xu 외 1명
- BForecasting stock return distributions around the globe with quantile neural networks
Jozef Barunik, Martin Hronec, Ondrej Tobek
- BEX-DRL: Hedging Against Heavy Losses with EXtreme Distributional Reinforcement Learning
Parvin Malekzadeh, Zissis Poulos, Jacky Chen 외 2명
- BLENS: Large Pre-trained Transformer for Exploring Financial Time Series Regularities
Yuanjian Xu, Anxian Liu, Jianing Hao 외 3명
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2025-10 월간
FR-LUX: Friction-Aware RL Portfolio Management
2025년 10월 arXiv에 올라온 AI 트레이딩 핵심 논문 5테마를 살펴봅니다. 헤지·포트폴리오·강화학습 실행·LLM 에이전트 검증·시장 미시구조까지, '백테스트 수익'을 '실전 수익'으로 바꾸기 위한 최신 연구 동향을 쉽게 풀어 설명합니다.
 📊 2023-06 월간
2023년 6월 양적 트레이딩 연구 동향: LLM이 금융에 들어오던 달
2023년 6월 arXiv에 공개된 양적 트레이딩·퀀트 투자 연구를 5개 테마로 정리합니다. 오픈소스 금융 LLM, 시너지 알파 자동 생성, 포트폴리오 모형 리스크, 메타학습 기반 주가 예측, RL 에이전트의 규범 학습까지 — 금융 AI가 빠르게 진화하던 시기의 핵심 연구를 살펴봅니다.
 📊 2023-04 월간
GPT가 뉴스를 읽고 주가를 맞힐 수 있을까? — 2023년 4월 AI 금융 연구 종합
2023년 4월, AI가 금융에 본격 침투하기 시작한 전환기. ChatGPT의 주가 예측 능력, 강화학습 트레이딩 인프라, 포트폴리오 최적화의 수학적 발전을 살펴봅니다.