
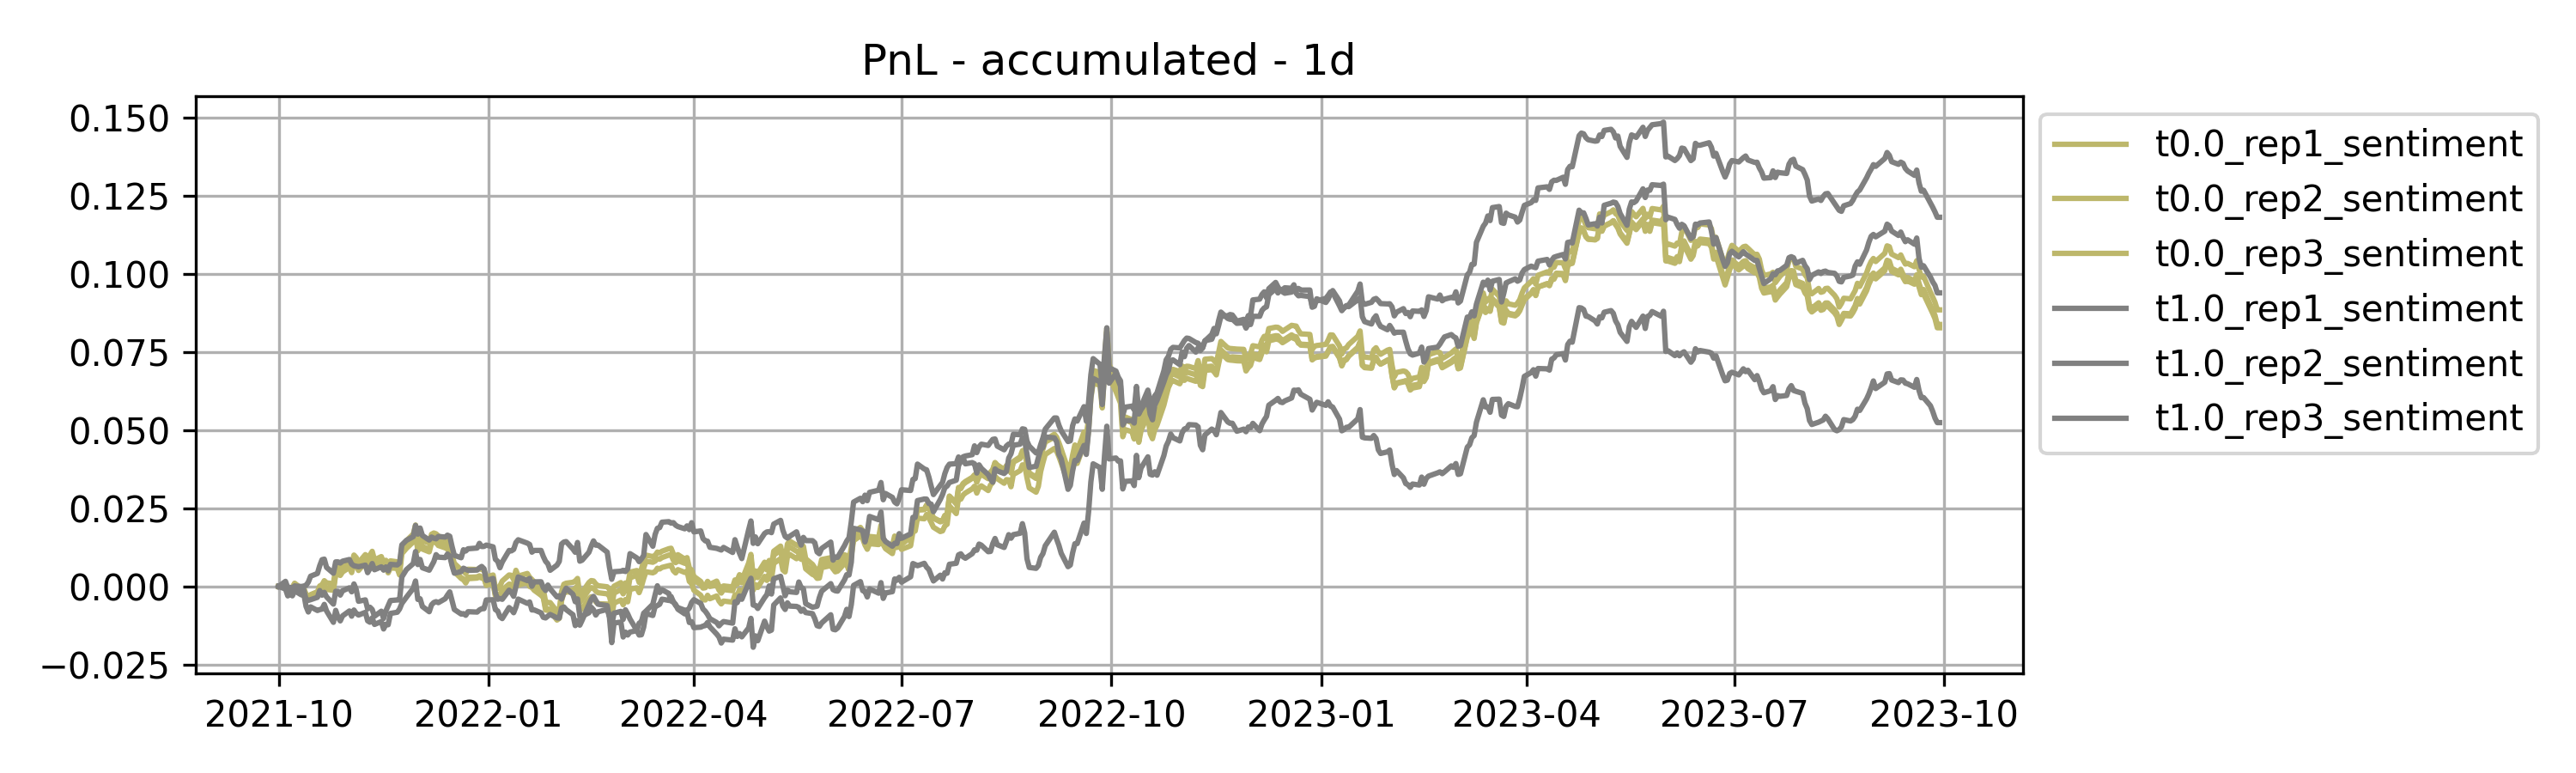
같은 질문에 세 번 물었더니 AI가 세 번 다른 대답을 했다면, 그 AI가 고른 종목을 믿을 수 있을까요? 2023년 11월의 금융 AI 논문들은 이 불편한 질문에서 출발합니다. 더 큰 모델을 만드는 대신, "우리가 아는 것이 정말 아는 것인지"를 정직하게 측정하는 연구들이 이 달의 주인공이었습니다.
들어가며: 2023년 11월, 무언가가 시작되려던 시점
2023년 11월은 챗GPT가 세상에 나온 지 약 1년이 된 시점이었습니다. 금융업계도 분주했습니다. "AI가 뉴스를 읽고 주식을 사면 어떨까?"라는 질문이 연구실 밖으로 나오기 시작하던 때죠.
이 달에 arXiv에 올라온 금융 관련 논문 237편 가운데 우리 기준으로 의미 있는 133편을 살펴보니, 하나의 큰 흐름이 보였습니다. 화려한 성능 주장보다, 측정과 검증에 대한 고민이 훨씬 많았습니다. 마치 새로 문을 연 식당에서 "맛있다"고 소리치기보다 "이 재료가 정말 신선한지, 위생 기준을 지켰는지"부터 확인하려는 요리사들처럼요.
이번 글에서는 2023년 11월의 연구를 다섯 개 테마로 나눠 정리합니다.
- LLM 금융 활용과 그 불안정성 — AI의 대답이 흔들리면 투자 수익도 흔들린다
- 위험선호를 반영한 포트폴리오 결정 — "나는 손실을 얼마나 견딜 수 있는가"를 AI가 배우게 하기
- 대규모 탐색의 검증 — 13만 개 전략 중 진짜를 가려내는 법
- 파생상품 가격결정의 계산 문제 — 복잡한 모델을 실시간으로 계산하기
- 생성 모델과 합성 시장 데이터 — 미래의 '가능한 모습'을 통째로 만들기
테마 1. LLM 트레이딩의 불안한 진실: 같은 질문, 다른 대답
뉴스 감성으로 투자한다는 것
"오늘 이 회사 관련 뉴스의 분위기가 밝다 → 주식을 사자." 이렇게 뉴스의 분위기(감성, sentiment)를 읽어 투자에 활용하는 아이디어는 꽤 오래됐습니다. 그런데 LLM(거대 언어 모델)이 등장하면서 판이 바뀌었죠. 사람처럼 문맥을 이해하는 AI가 뉴스 헤드라인의 뉘앙스까지 읽어 주니까요.
그런데 여기서 한 가지 미묘한 문제가 생깁니다. 같은 뉴스를 같은 AI에게 여러 번 물으면, 대답이 조금씩 다를 수 있습니다. 사람으로 치면 "이 리뷰, 호감인가 비호감인가?"라고 물었을 때 기분에 따라 "약간 긍정" 혹은 "보통"이라고 답하는 것과 비슷합니다.
대표 논문: 온도를 0으로 해도 흔들리는 AI의 감각
이 문제를 처음으로 정확하게 계량한 논문이 바로 Benchmarking Large Language Model Volatility(Boyang Yu, 뉴욕대, 2311.15180)입니다. ICAIF 2023 워크숍 논문으로 짧지만(7페이지), 질문이 예리합니다.
연구자는 S&P 500 종목과 관련된 뉴스 헤드라인 216,737개(2021년 10월~2023년 9월)를 준비했습니다. GPT-3.5와 LLaMA2-7B에게 각 헤드라인의 감성(긍정/중립/부정)을 물어봤죠. 여기서 중요한 점은, 같은 질문을 여러 번 반복했다는 겁니다.
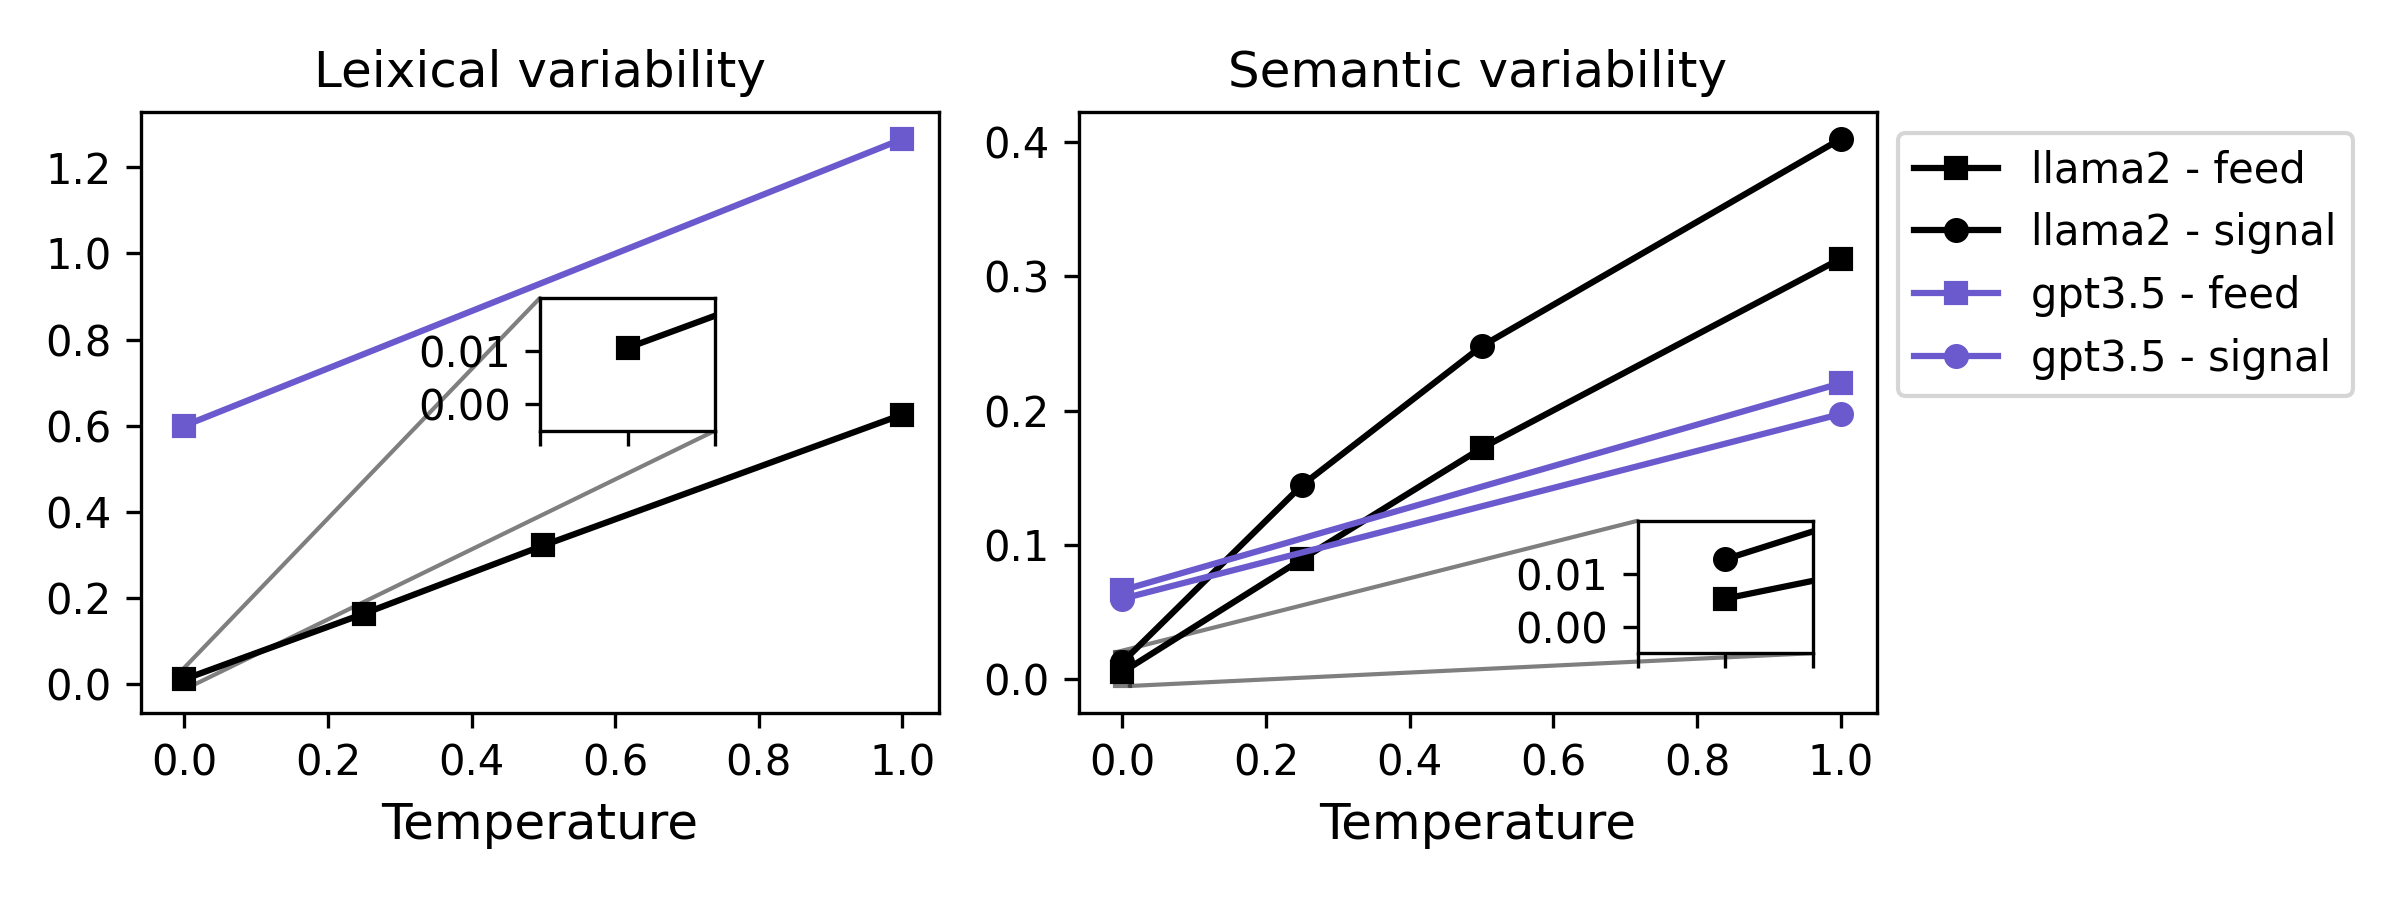
첫 번째 발견: '온도 0'은 만능이 아닙니다. LLM에는 '온도(temperature)'라는 설정이 있는데, 0으로 두면 결정적인(매번 같은) 답을 낸다고 알려져 있습니다. 실제로 연구자들도 대부분 온도 0을 씁니다. 하지만 실험 결과, 온도를 0으로 해도 실행마다 출력이 완전히 똑같지는 않았습니다. 단어 선택이 미세하게 달라지고, 감성 점수도 흔들렸습니다. (부동소수점 계산의 미세한 차이가 출력을 바꾸는 일이 실제로 일어납니다.)
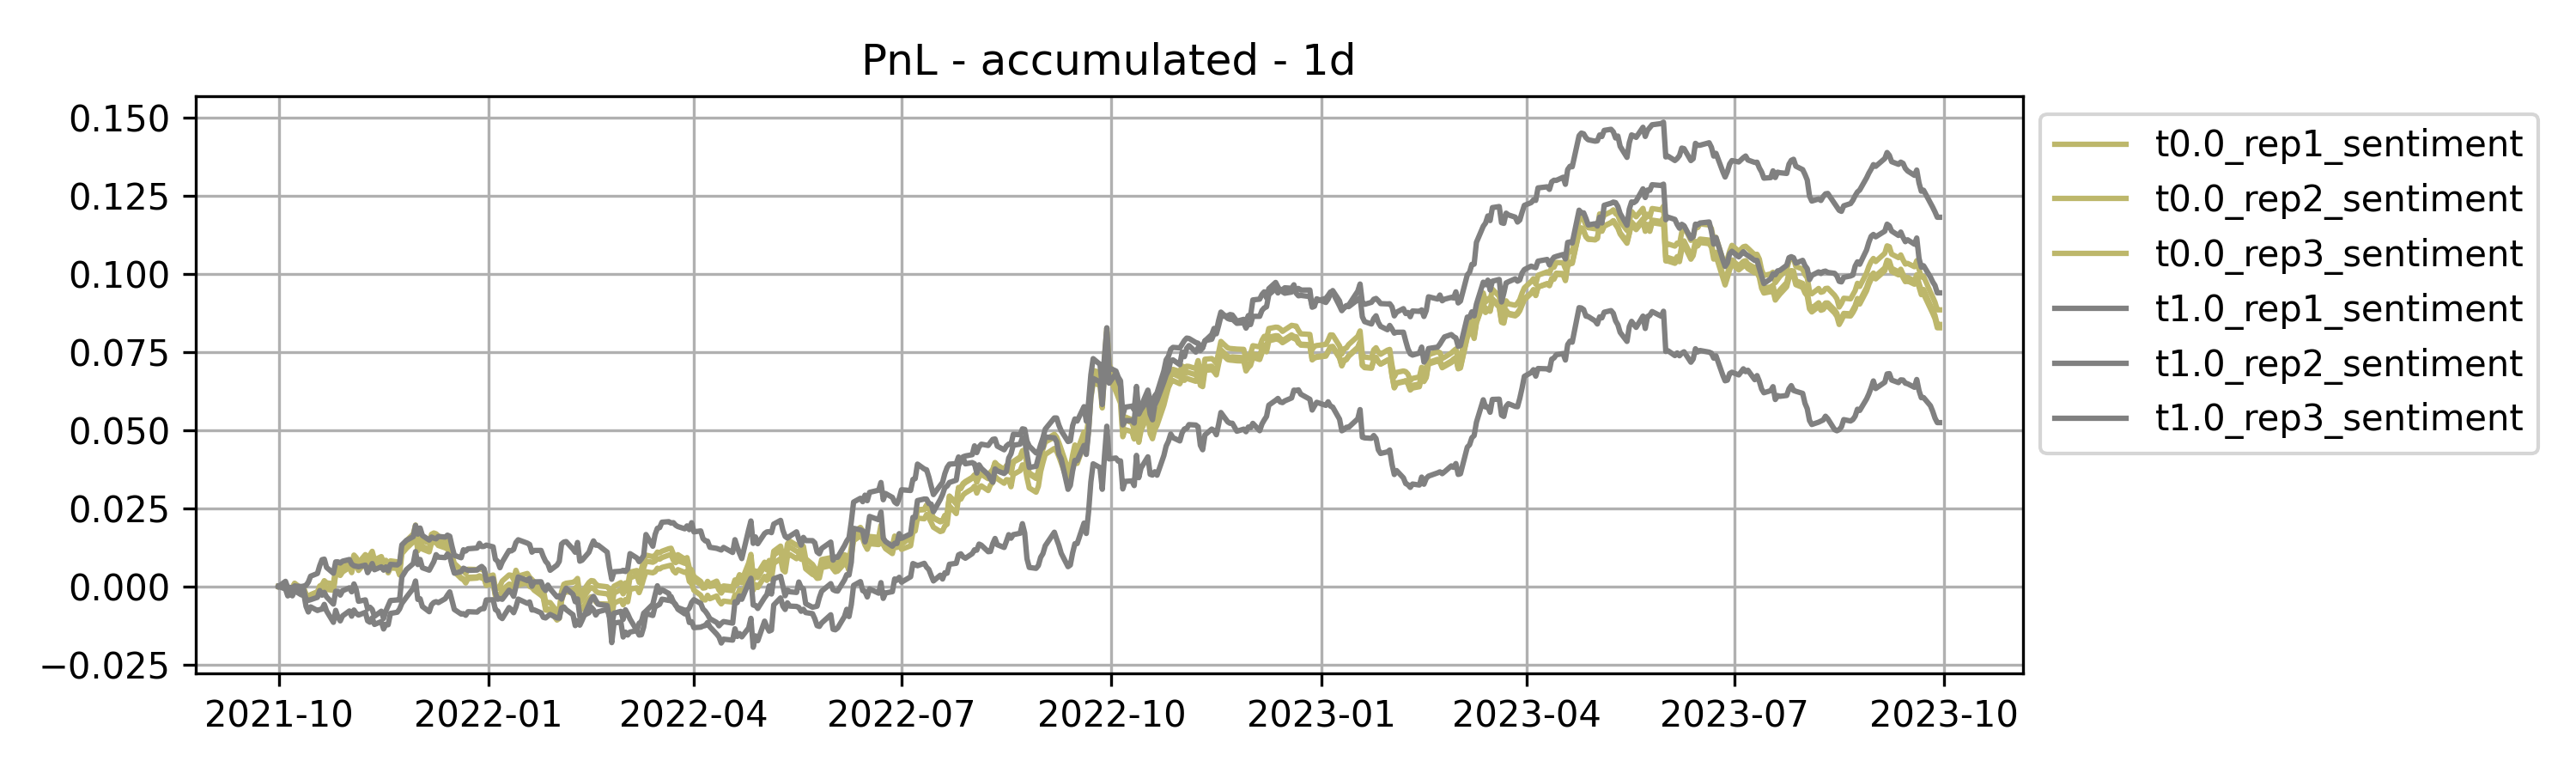
두 번째 발견: 이 흔들림이 포트폴리오까지 흔듭니다. 연구자는 감성 점수로 아주 단순한 롱숏 전략(긍정이면 사고, 부정이면 파는 일별 리밸런싱)을 만들어 백테스트했습니다. 결과는 다음과 같습니다.
| 모델 | 온도 0일 때 수익률 | 온도 0일 때 Sharpe | 온도 1일 때 수익률 | 온도 1일 때 Sharpe |
|---|---|---|---|---|
| LLaMA2-7B | 8.51% ± 0.25 | 1.41 ± 0.04 | 8.82% ± 2.72 | 1.46 ± 0.45 |
| GPT-3.5 | 6.13% ± 0.88 | 1.12 ± 0.13 | 7.53% ± 0.84 | 1.45 ± 0.17 |
(2021년 10월~2023년 9월 백테스트, 총수익률과 Sharpe의 평균 ± 표준편차. 온도 0.25·0.5 구간은 논문 표 참조)
표를 쉽게 읽으면 이렇습니다. 온도가 낮으면(0) 결과가 안정적이지만 약간 보수적이고, 온도가 높으면(1) 평균은 비슷하거나 조금 나은 대신 결과가 널뜁니다. 더 충격적인 숫자는 따로 있는데, 온도 1 설정에서 동일한 실험을 반복했을 때 가장 잘 나온 실행은 11% 수익, 가장 나쁜 실행은 5% 수익이었다는 점입니다. 같은 전략, 같은 데이터, 같은 설정인데 실행 한 번으로 6%p가 갈린 겁니다. 운용 실무에서 이 차이는 치명적일 수 있죠.
이 테마의 나머지 이야기
- FinMem(2311.13743, A 티어): 이 달에 나온 가장 유명한 논문일 겁니다. LLM 트레이딩 에이전트에 '계층형 메모리'를 달았습니다. 하루치 뉴스를 금방 잊어버리는 대신, 최근 소식(단기 기억)과 오래된 중요한 사실(장기 기억)을 층층이 나누어 저장해서 결정의 일관성을 높인 거죠. 사람으로 치면 매일 일기를 쓰면서도 중요한 교훈은 수첩에 옮겨 적는 투자자입니다.
- 금융 LLM의 환각 연구(2311.15548, B 티어): AI가 없는 사실을 지어내는 '환각(hallucination)'을 금융 과업에서 직접 측정했습니다. 투자 리서치에 AI를 쓰려면 성능보다 먼저 확인해야 할 지표입니다.
이 테마의 공통 인사이트
LLM을 투자에 쓸 때는 "정답을 잘 맞히는가"보다 "같은 질문에 항상 같은 답을 하는가"를 먼저 봐야 합니다. AI의 미세한 흔들림은 포트폴리오 수익의 큰 변동으로 증폭됩니다.
테마 2. "나는 손실을 얼마나 견딜 수 있는가"를 AI에게 가르치기
기대수익만 좇으면 생기는 문제
모든 투자 교과서의 출발점은 "기대수익을 최대화하라"입니다. 하지만 실제 투자자들은 다릅니다. 같은 연 10% 수익을 약속해도, "한 해에 30%씩 마이너스가 나도 참을 수 있는 사람"과 "10%만 떨어져도 잠을 못 자는 사람"이 있죠. 롤러코스터를 즐기는 사람과 두려워하는 사람의 차이입니다.
표준적인 강화학습(RL)은 이 차이를 모릅니다. 오직 '기대 보상의 합'만 키우도록 설계되기 때문입니다. 2023년 11월에는 이 간극을 메우는 이론 연구가 여러 편 나왔습니다.
대표 논문: 위험선호를 목표 함수에 그대로 넣는 강화학습
Risk-sensitive Markov Decision Process and Learning under General Utility Functions(Zhengqi Wu, Renyuan Xu, USC, 2311.13589, 41페이지)는 이 문제의 이론적 토대를 정리한 논문입니다.
핵심 아이디어는 두 단계입니다.
1단계: '최종 성적'을 상태에 넣기. 보통의 강화학습에서 상태는 "지금 시장이 어떤 상황인가"만 담습니다. 그런데 위험선호라는 것은 지금까지 얼마나 벌었고 잃었는가에 따라 달라집니다. 같은 상황이라도 이미 많이 번 상태에서는 안전하게 굴고, 많이 잃은 상태에서는 다르게 반응할 수 있으니까요. 그래서 논문은 누적 보수(지금까지의 총 성적)를 상태에 한 줄 추가합니다. 이렇게 하면 원래는 복잡하게 꼬여 있던 최적 결정 문제에서 벨만 방정식이라는 강력한 계산 도구가 다시 살아납니다.
2단계: '그물망'으로 문제를 잘게 쪼개기. 누적 보수는 연속적인 값이라 상태가 무한히 많아집니다. 논문은 누적 보수 축을 일정 간격의 그물망(ε-커버링)으로 쪼개 근사 문제를 만들고, 이 근사가 원래 문제를 얼마나 잘 대표하는지(가치함수의 '준-Lipschitz' 연속성)를 증명합니다.
결과(이론적 보장): 이 그물망 위에서 가치반복을 수행하는 알고리즘(VIGU)이 시뮬레이터가 있을 때 ε-최적 정책을 찾는 데 필요한 데이터 양(샘플 복잡도)이 Õ(H⁷SAκ²/ε²) 수준임을 보였습니다. 시뮬레이터가 없을 때는 상한신뢰도 탐험(UCB)을 더한 버전으로 regret(최적 대비 누적 손실) 경계를 확보했죠. 또한 일반 효용 함수라는 이 설정 자체에 대한 regret 하한(Ω(√(HSATκ̲²)))을 처음으로 제시했습니다. 쉽게 말해 "이런 문제는 이보다 훨씬 빨리 풀 수 없다"는 기준선을 그어 놓은 겁니다.
이 테마의 나머지 이야기
- 인출 성공 확률 최적화(2311.06665, B 티어): "수익을 얼마나 많이 내는가"가 아니라 "예정된 인출 계획을 끝까지 지킬 확률"을 최적화하자고 제안합니다. 은퇴 자금처럼 정해진 현금흐름이 필요한 투자자에게는 사실 이게 더 정직한 목표입니다.
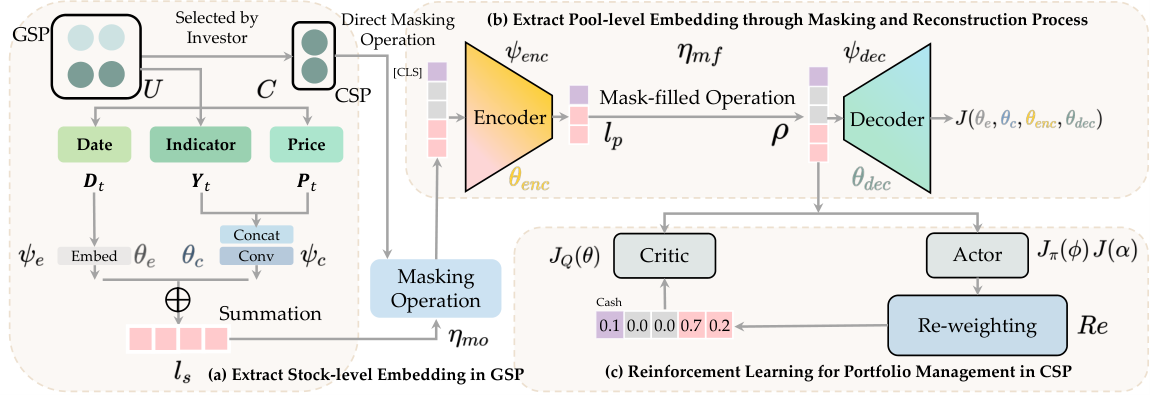
- 마스킹 가능한 주식 표현(2311.10801, B 티어): 종목 유니버스가 바뀔 때마다 AI를 처음부터 다시 학습시키면 비용이 큽니다. 이 논문은 '가림막(masking)'을 씌워 종목을 넣고 빼면서 재학습 없이 대응하는 구조를 제안합니다.
이 테마의 공통 인사이트
투자자의 위험선호는 '사후에 조정하는 보정치'가 아니라 학습 목표 자체에 넣어야 할 설계 조건입니다. 인출 계획, 정보 지연, 경쟁자 존재까지 — 실전의 제약을 목적함수와 상태에 직접 반영하는 이론이 이 달에 뚜렷해졌습니다.
테마 3. 13만 개 전략의 수레바퀴에서 진짜를 찾아내기
"시험 문제를 13만 개 풀고 가장 잘 맞춘 것만 자랑한다면?"
상상해 보세요. 어떤 학생이 13만 개의 시험 문제를 다 풀고, 그중 가장 점수가 높았던 100개만 골라 자랑합니다. "나 이 100문제 만점 받았어!" 물론 그 100문제는 운이 좋았던 것일 수 있습니다. 금융에서 전략을 '데이터 마이닝'으로 찾아내는 작업이 정확히 이 상황입니다. 과거 데이터에 맞는 전략 13만 개를 자동 생성하고, 그중 과거 성적이 좋은 것만 고르면 — 나중에(샘플 외)도 잘 할까요?
대표 논문: 136,000개 전략을 한 번에 검증한 경험적 베이즈
High-Throughput Asset Pricing(Andrew Y. Chen, Chukwuma Dim, 2311.10685)는 이 달 코호트에서 가장 높은 점수를 받은 논문입니다.
연구자는 회계비율, 과거 수익률, 주식 티커 기호만으로 136,000개의 롱숏 전략을 자동 생성했습니다. 눈여겨볼 점은 "성과가 좋아 보이는 전략"을 미리 골라 넣지 않았다는 것입니다. 전략의 중앙값 성과는 0에 가까웠습니다. 즉, 온갖 잡동사니가 섞인 정직한 후보군이었죠.
선별 도구로 경험적 베이즈(empirical Bayes, EB)를 씁니다. 쉽게 말하면 각 전략의 과거 성적이 "실력일까 운일까"를 통계적으로 분리해서, 실력의 기대치가 높은 전략만 남기는 방법입니다. 단순히 과거 점수가 높은 것을 고르는 것과는 다르죠.
핵심 결과:
- EB로 고른 상위 1% 전략(단순 평균)의 1983~2020년 샘플 외 수익률은 연 5.70%. 학술 저널에 발표된 200개 전략의 평균 연 5.88%와 대등합니다. 학자들이 수십 년간 공들여 찾은 전략들을, 기계가 자동으로 생성한 전략들이 따라잡은 겁니다. (단, Sharpe는 1.46 대 2.03으로 발표 전략이 더 우세했습니다.)
- 놀라운 이론적 결론: 단순히 과거 Sharpe가 높은 전략을 고르는 '순진한' 방법도 샘플 외 Sharpe 1.45로 EB(1.46)와 거의 같았습니다. 논문은 이 현상을 수학적으로 예측하고 있었는데(제안 1), 현실도 딱 그대로 나왔습니다.
- 그러나 2004년이라는 벽이 있었습니다. 상위 1% 전략의 수익이 1983
2005년에는 연 8.17%였다가 20052020년에는 연 2.03%로 급감합니다. 인터넷과 정보기술이 발달하며 시장의 예측 구조 자체가 바뀐 것으로 해석됩니다. - 상위 전략들의 면면도 흥미롭습니다. 1993년 데이터로 예측한 상위 20개 전략의 주제는 모기지 부채, 이자비용 증가, 감가상각비처럼 학술 논문에서 잘 다루지 않는 것들이었습니다. 이 전략들의 이후 10년 실현 Sharpe는 평균 약 1.0.
- 그리고 실무자에게 가장 중요한 경고: 재무학에서 흔히 쓰는 다중검정 보정 기법들은 대부분의 진짜 성과 전략을 찾아내지 못했습니다. 너무 엄격한 필터가 진짜까지 걸러 버린 겁니다.
이 테마의 나머지 이야기
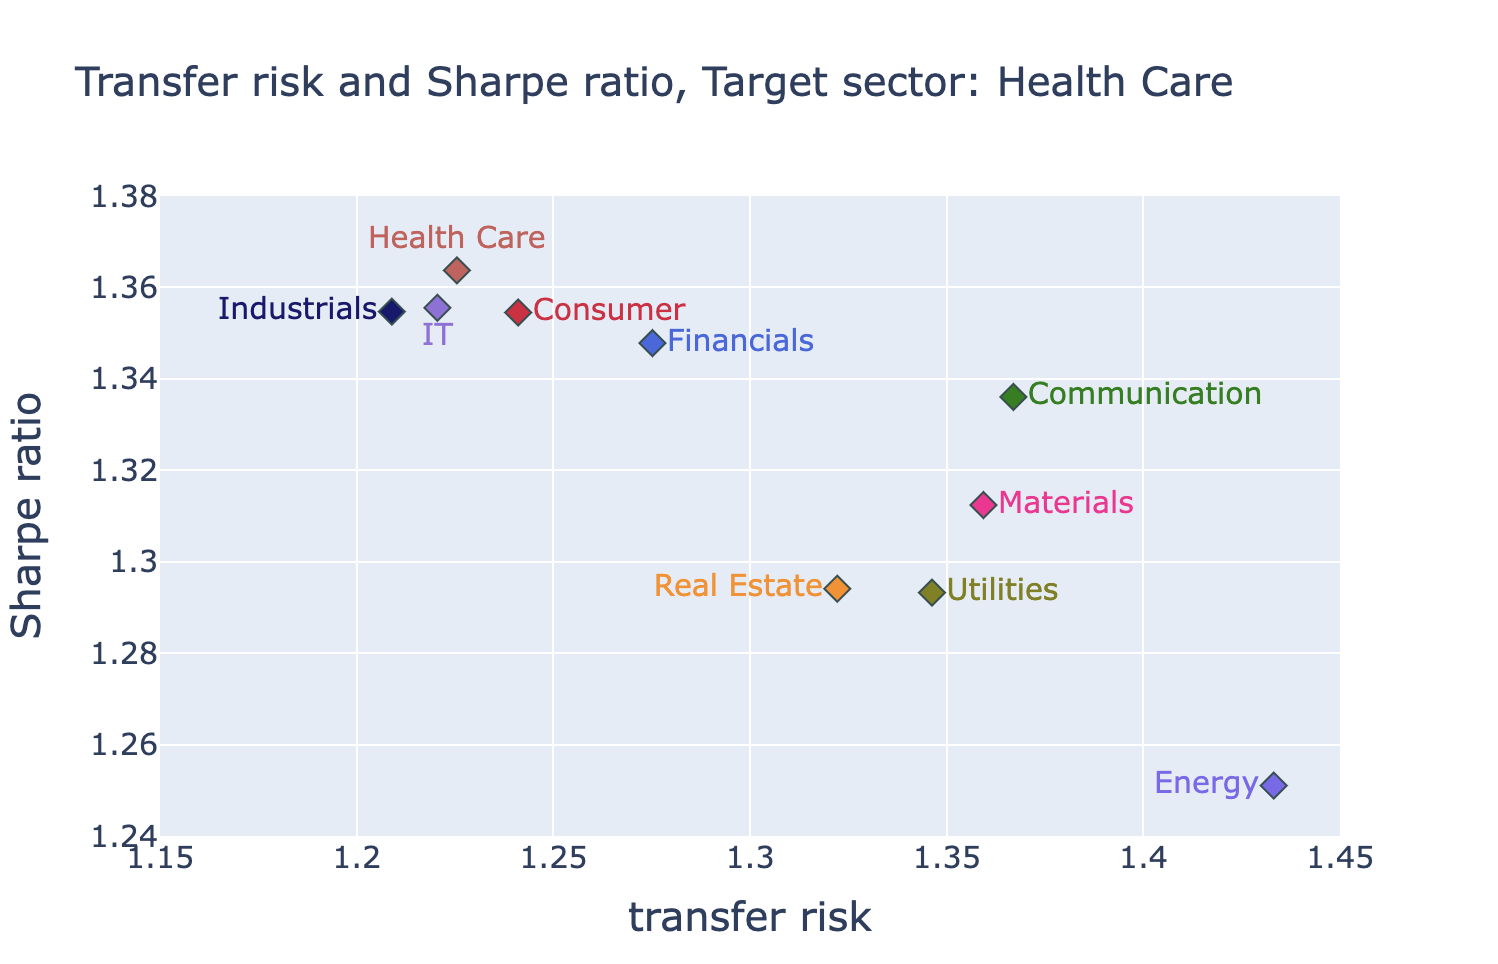
- 전이 학습의 위험(2311.03283, B 티어): 미국 시장에서 학습한 모델을 영국·브라질 시장에 쓰면 어떻게 될까? '전이 위험'을 정의하고, 어떤 원천 시장에서 옮겨와야 성과가 유지되는지를 사전에 판단하는 틀을 제시합니다.
- NFT 워시 트레이딩 탐지(2311.18717, B 티어): 공개된 블록체인 데이터만으로 NFT 거래의 약 **38%(범위 30
40%)**가 자전거래(가짜 거래)일 수 있다고 추정했습니다. 금액 기준으로는 약 60%(2595%)까지 올라갑니다. 거래량이 곧 인기라는 통념을 다시 생각하게 하는 숫자입니다. - Cont의 정형화 사실 재검토(2311.07738, B 티어): 2001년에 정리된 "주식 수익률은 두꺼운 꼬리를 가진다" 같은 시장의 통계적 사실들이, 20년의 규제·시장구조 변화를 지나고도 여전히 성립하는지 확인했습니다. 모델의 가정을 점검하는 기본기에 대한 연구입니다.
이 테마의 공통 인사이트
전략을 '많이 찾아내는 것'보다 '찾은 것이 진짜인지 아는 것'이 훨씬 어렵습니다. 대규모 탐색에는 그에 맞는 통계적 장치가 필요하고, 지나치게 엄격한 필터는 오히려 진짜를 놓칩니다.
테마 4. 복잡한 파생상품 모델을 실시간으로 계산하기
모델이 똑똑해질수록 계산은 어려워진다
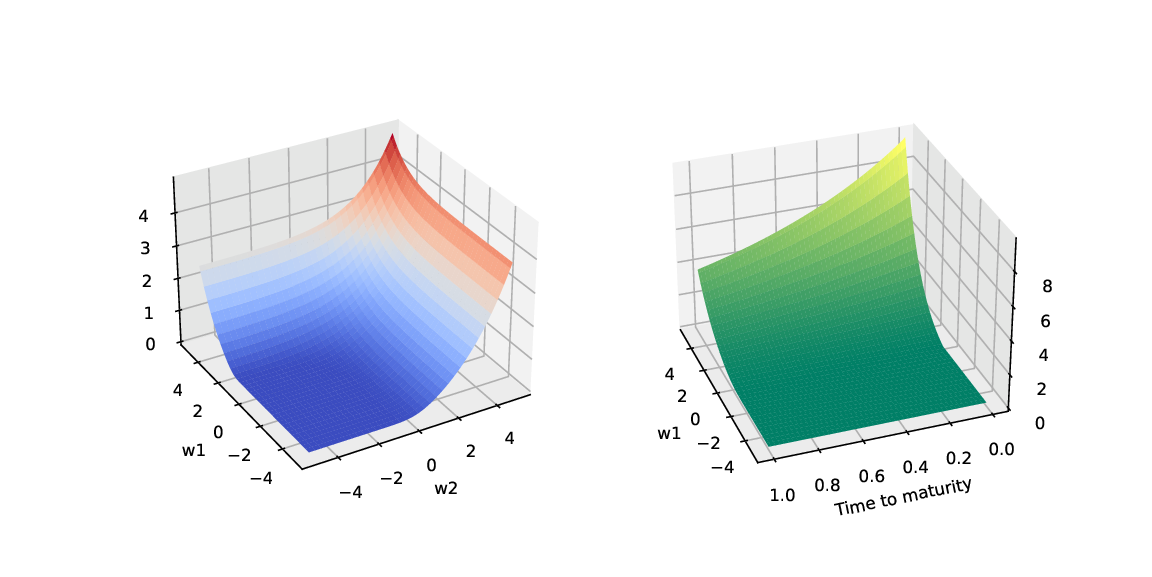
옵션이나 신용 파생상품처럼 구조가 복잡한 상품을 다루려면 가격을 계산해야 하고, 리스크를 관리하려면 가격이 변할 때 리스크 지표가 얼마나 빨리 변하는지(민감도, 델타·감마)까지 알아야 합니다. 감마는 자동차로 치면 '가속도계'입니다. 속도(가격)가 변해도 가속도(감마)까지 알아야 급제동에 대비할 수 있죠.
문제는 최신 변동성 모델일수록 계산이 까다롭다는 것입니다. 특히 CVA(신용 가치 조정, 거래 상대방이 부도날 위험을 가격에 반영한 것)의 리스크를 계산할 때는 골치 아픈 일이 벌어집니다.
대표 논문: 계단이 많은 도로에서 가속도를 정확히 재기
Fast and Stable Credit Gamma of CVA(Roberto Daluiso, 2311.11672, A 티어)가 바로 그 이야기입니다.
CVA를 계산하려면 거래 상대방의 '부도 시각'을 시뮬레이션(몬테카를로)으로 뽑습니다. 그런데 이 부도 시각은 미세하게 변할 수 있는 매끄러운 값이 아니라, 확 튀는(비미분적) 값입니다. 계단이 있는 도로에서 속도계는 읽히는데 가속도계가 말을 안 듣는 상황이죠. 그래서:
- 보통 쓰는 '살짝 흔들어 보고 변화량을 재는' 유한차분(finite difference) 방법은 통계적 노이즈가 극심했습니다. 1bp(0.01%포인트)만 흔들면 결과가 사실상 잡음 덩어리가 됩니다.
- 최신 기법인 AAD(자동 미분)는 매끄러운 함수에서 빠르지만(오버헤드 약 4배), 부도 시뮬레이션의 비미분성 때문에 그대로는 못 씁니다.
논문은 조건부 확률에 대한 보정 항을 붙인 해석적 추정기를 제시합니다. 결과적으로 1차(신용 델타)와 2차(크레딧 감마, 금리-신용 교차 감마) 민감도를 가격 계산의 상수 배 수준 시간으로 안정적으로 계산합니다. 10만 개 경로 실험에서 제안 방법(AD2)의 신뢰구간은 유한차분보다 훨씬 좁았고, 심지어 필러(만기 구간) 단위의 세밀한 크레딧 감마에서 유한차분은 사실상 순수 노이즈였던 반면 제안 방법은 정확하게 수렴했습니다.
실무자에게 반가운 발견 하나: 전형적인 CVA 데스크에서는 금리와 신용이 섞이는 교차 감마가 순수 크레딧 감마보다 오히려 더 중요하다는 것이 실험으로 확인됐습니다.
이 테마의 나머지 이야기
- 변동성 파생상품의 경로의존 PDE(2311.08289, A 티어): VIX 옵션처럼 '과정 전체'에 의존하는 상품의 가격을 푸리에 변환 기반의 경로의존 편미분방정식으로 다룹니다. 이론적으로는 아름답지만, 저자도 인정하듯 수치 구현이 추가로 필요합니다.
- VaR/ES 추정 오차 분해(2311.15333, A 티어): "우리가 계산한 VaR(최대 예상 손실)의 오차는 얼마인가?"라는 질문에 중심극한정리로 답합니다. 리스크 한도의 신뢰 구간을 정량화할 수 있게 해 주는 이론입니다.
이 테마의 공통 인사이트
모델을 정교하게 만들수록 계산은 어려워집니다. 이 달의 상위 논문들은 '더 좋은 모델'이 아니라 '복잡한 모델을 빠르고 안정적으로 계산하는 수법'에 집중했고, 이것이 실무 리스크 시스템의 품질을 결정한다는 점을 보여줍니다.
테마 5. 미래를 '하나'가 아니라 '가능한 여러 개'로 그리기
평균만 말하는 예측의 함정
"내일 전력 가격은 메가와트시(MWh)당 70유로입니다." — 이런 단일 예측은 실전에서 거의 쓸모가 없습니다. 투자자나 발전사에게 진짜로 필요한 것은 "최악의 경우 300유로까지 갈 수 있고, 새벽에는 음수가 될 수도 있다"는 불확실성의 지도이기 때문입니다. 일기예보로 치면 "내일 평균 기온 15도"보다 "아침 8도~오후 22도, 저녁에 비 올 확률 40%"가 더 유용한 것과 같습니다.
이 '가능한 미래들의 모음(시나리오)'을 생성 모델로 만드는 연구가 이 달의 마지막 테마입니다.
대표 논문: 정규화 흐름으로 전력 가격 시나리오 만들기
Multivariate Scenario Generation of Day-Ahead Electricity Prices using Normalizing Flows(Hilger 외, 독일 유리히 에너지연구소, 2311.14033)는 이 접근의 교과서 같은 논문입니다.
핵심 아이디어:
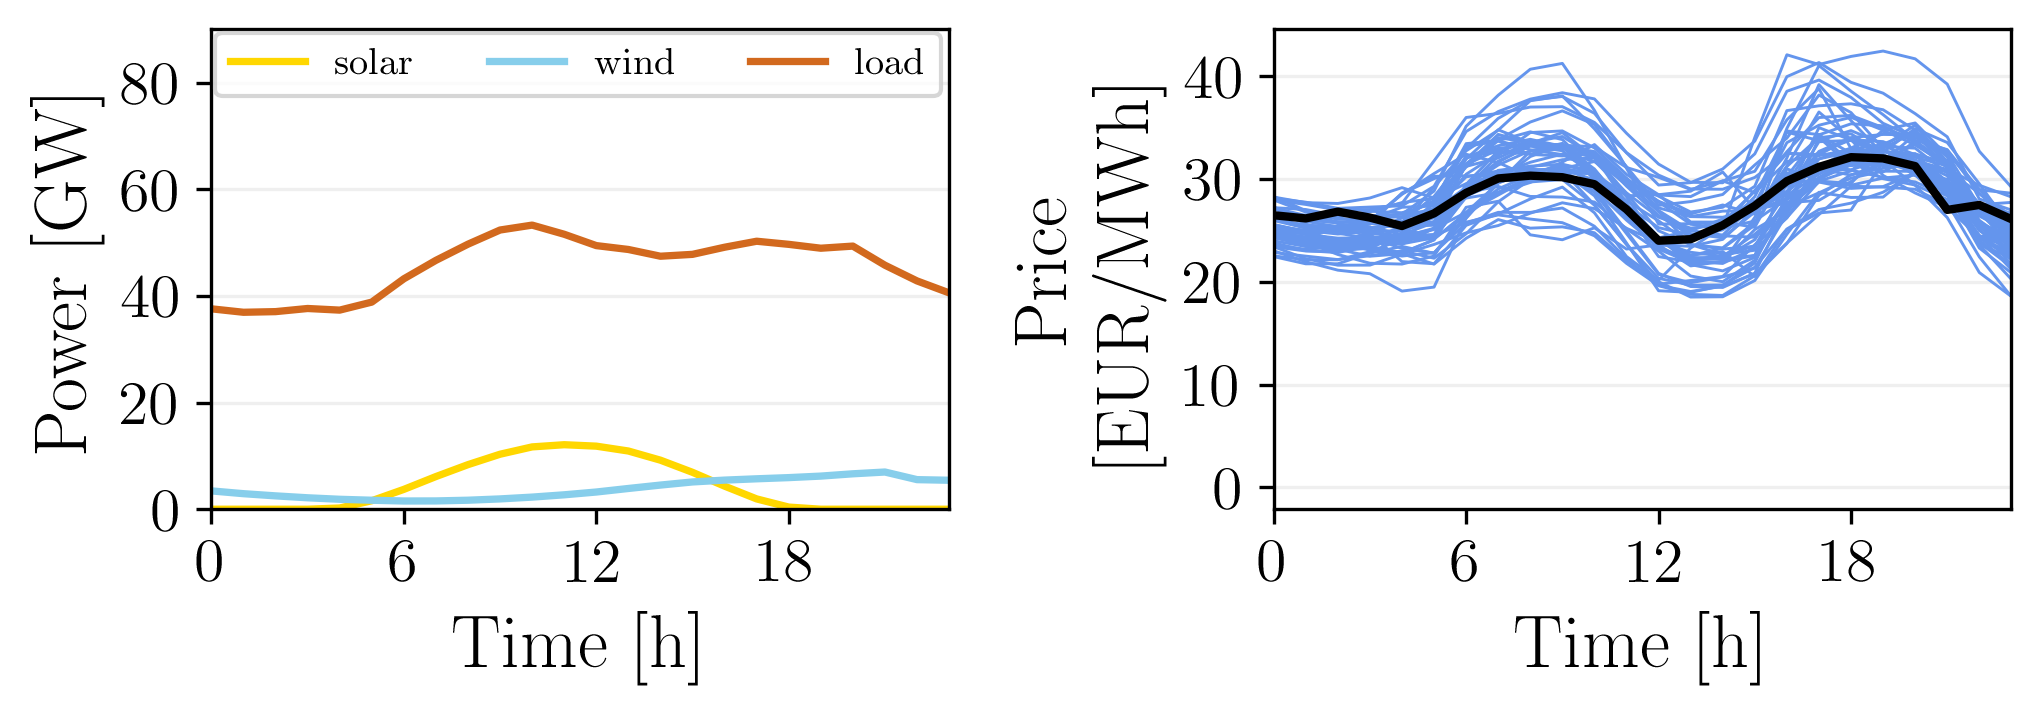
- 하루 전력 가격은 24시간대(정오 피크, 새벽 저점)가 서로 얽혀 있습니다. 그래서 24개 시간대 가격을 하나의 24차원 결합 분포로 통째로 모델링했습니다. (실제 일전 입찰 시장에서도 24시간 가격이 동시에 정해집니다.)
- 도구로 정규화 흐름(normalizing flow)을 사용했습니다. 쉽게 말하면 '뒤집을 수 있는 신경망'으로 단순한 종 모양 분포(표준 정규분포)를 실제 가격 분포의 복잡한 모양(두꺼운 꼬리, 음수 가격, 왜곡)으로 뒤틀어 변환하는 기법입니다. 학습은 우도(그럴듯함)를 직접 최대화하므로 GAN 같은 다른 생성 모델보다 안정적입니다.
- 조건으로 잔여부하(전력 수요 - 재생에너지 발전) 예측, 풍력·태양력 예측 등을 넣어 "오늘 상황이 이러이럴 때"의 분포를 만듭니다.
- 주기적 재학습을 통해 2021년 에너지 위기(기준일 2021년 10월 1일)로 시장이 완전히 달라진 뒤에도 적응하도록 설계했습니다.
핵심 결과:
- 분포 재현력이 뛰어납니다. 전체 기간(2016-04-20~2022-12-31)의 실제 가격과 생성 시나리오의 통계량 비교 — 평균 72.87 대 70.19 EUR/MWh, 표준편차 90.75 대 84.98, 왜도 2.94 대 2.75, 첨도 10.11 대 9.16. 두꺼운 꼬리와 뾰족한 봉우리까지 비슷하게 재현했습니다.
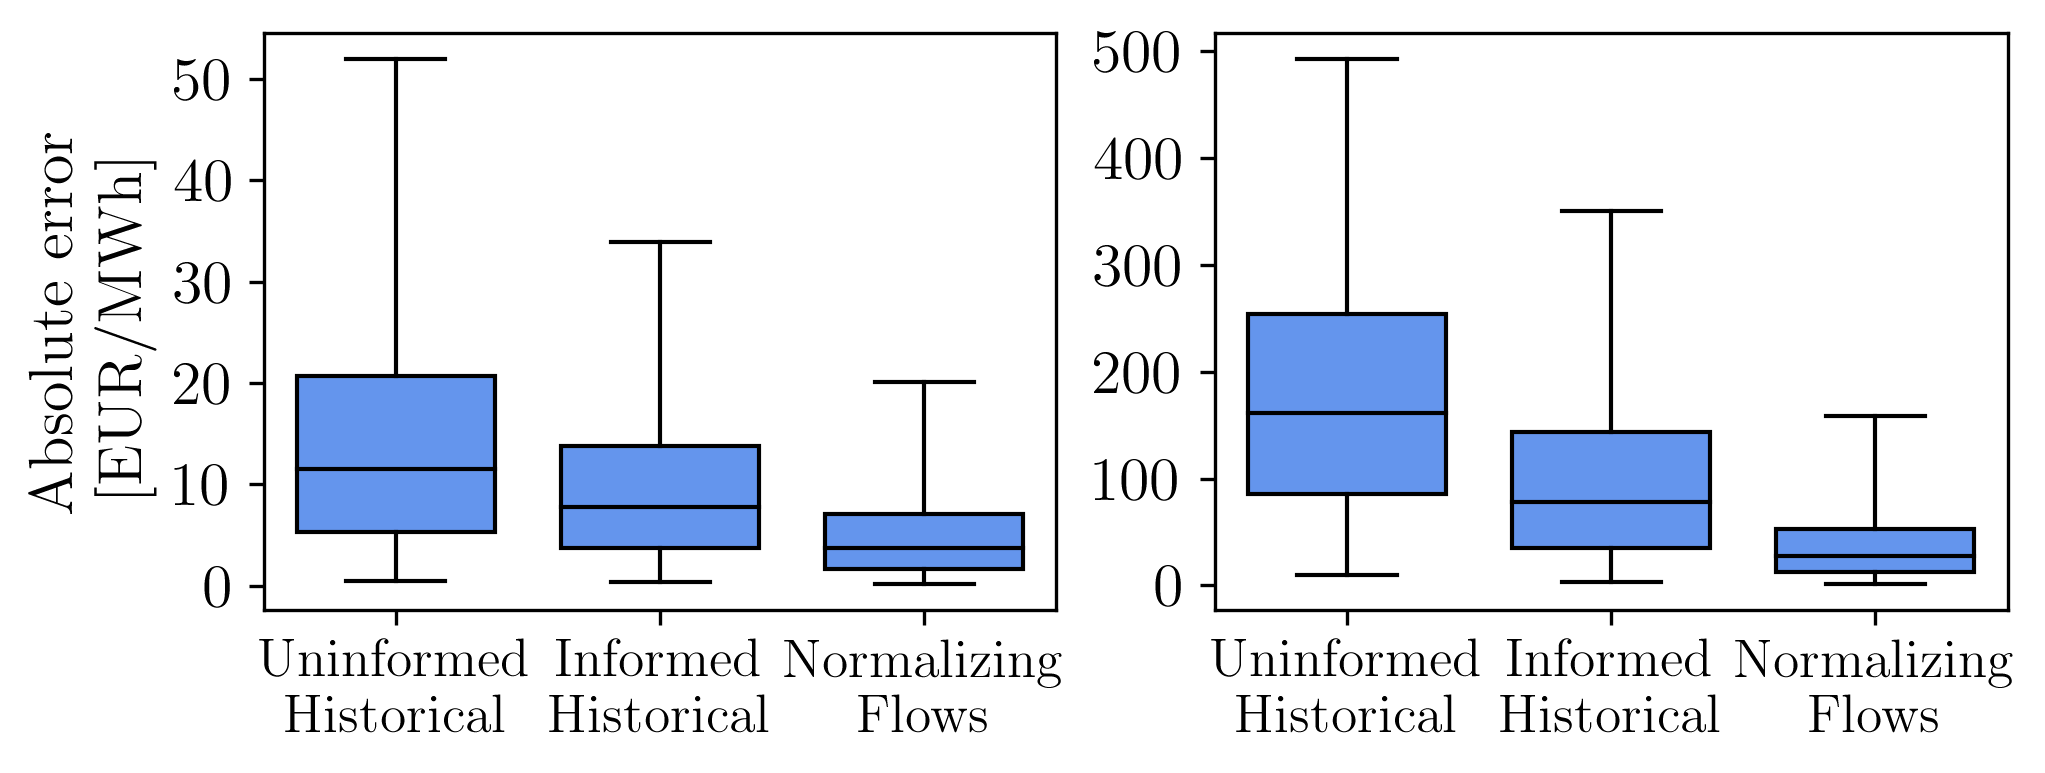
- 점 예측 성능(MAE)도 경쟁력이 있습니다. 2019년 구간 3.88 EUR/MWh로, LSTM 기반 최신 연구(3.73 EUR/MWh)와 비슷한 수준입니다. 점 예측이 목적이 아닌 모델이 이 수치를 냈다는 점이 인상적입니다.
- 확률 예측 품질을 재는 지표(에너지 스코어, 변이도 스코어)에서는 벤치마크 2종을 모든 구간에서 일관되게 이겼고, 2022년 위기 구간에서 오히려 격차가 더 벌어졌습니다. 다만 위기 전후로 오차의 절대값 자체는 약 10배 커졌습니다 — 시장 전체의 불확실성이 폭증한 탓입니다.
- 한 가지 아쉬운 점: 최고가 스파이크(가격이 폭등하는 순간)의 발생 확률을 다소 낮게 추정하는 경향이 있었습니다.
이 테마의 나머지 이야기
- 꼬리를 유연하게 만드는 정규화 흐름(2311.00580, B 티어): 생성 모델은 기본적으로 꼬리를 가볍게 만드는 경향이 있는데, 극단값 이론(EVT)을 부품으로 끼워 넣어 금융 수익률의 극단 충격(폭락)을 현실적으로 만들었습니다.
- 시장 시뮬레이터 정밀 보정(2311.11913, B 티어): 가상의 주문장(호가창) 거래소 시뮬레이터를 실제 시장의 통계(수익률 분포, 변동성 군집 등)에 맞춰 자동으로 보정합니다. 플래시 크래시 같은 '일어나지 않은 사건'을 실험실에서 재현할 수 있게 해 줍니다.
이 테마의 공통 인사이트
단일 예측값으로는 시장의 불확실성을 다룰 수 없습니다. 분포 전체를 생성하는 모델 + 체제 변화에 맞춘 정기 재학습이 합성 시장 데이터의 새로운 표준이 되고 있습니다.
2023년 11월 전체를 관통하는 메시지
다섯 테마를 관통하는 문장 하나를 고르라면 이것입니다. "더 큰 모델이 아니라, 더 정직한 측정."
- 13만 6천 개 전략을 한 번에 검증하면서도 편향을 통계적으로 통제하고(High-Throughput Asset Pricing),
- AI의 '같은 질문 다른 답'이 투자 수익을 얼마나 흔드는지 처음으로 계량했으며(LLM Volatility),
- 20년 전에 정리된 시장의 통계적 사실을 현대 데이터로 다시 검증했습니다(Cont's Stylized Facts 재검토).
동시에 불확실성을 다루는 도구 자체도 정교해졌습니다. 위험선호를 목표 함수에 넣는 강화학습 이론, 부도 시뮬레이션의 계단을 우회하는 감마 계산, 미래 가격 분포를 통째로 생성하는 정규화 흐름까지 — "모르는 것을 모른 채로 다루지 않는" 방법론들이 한 달에 모였습니다.
그리고 한 가지 역사적 아이러니. 이 달에는 FinMem을 필두로 LLM 트레이딩 에이전트가 처음으로 의미 있게 모습을 드러낸 동시에, 그 한계(환각, 비결정성)를 짚어내는 연구가 함께 나왔습니다. 이후 몇 년간 시장을 달굴 LLM 트레이딩 붐의 시작점에, 이미 경고장이 붙어 있었던 셈입니다.
더 알아보기
원문 링크 (이 글에서 다룬 논문)
- High-Throughput Asset Pricing — 경험적 베이즈로 136,000개 전략 스크리닝 (A 티어)
- Benchmarking Large Language Model Volatility — LLM 감성의 비결정성과 투자 수익 변동 (A 티어)
- Risk-sensitive MDP and Learning under General Utility Functions — 위험선호를 반영한 강화학습 이론 (A 티어)
- Fast and Stable Credit Gamma of CVA — CVA 신용 감마의 빠르고 안정적인 계산 (A 티어)
- FinMem: A Performance-Enhanced LLM Trading Agent — 계층형 메모리 기반 LLM 트레이딩 에이전트 (A 티어)
- Path-dependent PDEs for volatility derivatives — 경로의존 변동성 파생상품의 PDE 정식화 (A 티어)
- Asymptotic Error Analysis of Multilevel Stochastic Approximations for VaR and ES — 리스크 측정치의 추정오차 분석 (A 티어)
- Multivariate Scenario Generation of Day-Ahead Electricity Prices — 정규화 흐름 기반 전력 가격 시나리오 (B 티어)
- Deficiency of Large Language Models in Finance: Hallucination — 금융 LLM 환각 측정 (B 티어)
- Can AI Detect Wash Trading? Evidence from NFTs — NFT 자전거래 탐지 (B 티어)
- Risk of Transfer Learning and its Applications in Finance — 금융 전이학습의 위험 (B 티어)
- Revisiting Cont's Stylized Facts for Modern Stock Markets — 시장 통계적 사실의 재검토 (B 티어)
- Flexible Tails for Normalising Flows — 극단 꼬리를 가진 생성 모델 (B 티어)
- Deep Calibration of Market Simulations — 시장 시뮬레이터 자동 보정 (B 티어)
대표 논문 5편의 5차원 점수 (참고)
| 논문 | 신규성 | 적용성 | 엄밀성 | 재현성 | 통찰 |
|---|---|---|---|---|---|
| High-Throughput Asset Pricing | 80 | 82 | 78 | 38 | 84 |
| Benchmarking LLM Volatility | 72 | 78 | 68 | 52 | 80 |
| Risk-sensitive MDP | 78 | 66 | 74 | 38 | 76 |
| Fast and Stable Credit Gamma of CVA | 72 | 78 | 76 | 38 | 68 |
| NF Scenario Generation (전력 가격) | 68 | 76 | 58 | 35 | 67 |
(재현성 점수가 대체로 낮은 편인 것은 이 무렵 연구의 공통적 특징으로, 코드·데이터 공개가 제한적이었음을 뜻합니다.)
함께 읽으면 좋은 논문 (KB 유사도 기준)
- Why and how systematic strategies decay — 전략이 왜 시간이 지나면 쇠퇴하는가 (샘플 외 성과와 이어짐)
- Look-Ahead-Bench: Look-ahead Bias Benchmark — 미래 정보가 스며든 백테스트의 기준 벤치마크
- Assessing Look-Ahead Bias in Stock Return Predictions Generated By GPT Signals — GPT 감성 신호의 미래 정보 누수 점검
- Controlling False Discovery Rates under Cross-Sectional Correlations — 전략 간 상관을 고려한 거짓 발견률 제어
📚 이 글에서 다룬 논문 (20편)
- A
- A
- AFinMem: A Performance-Enhanced LLM Trading Agent with Layered Memory and Character Design
Yangyang Yu, Haohang Li, Zhi Chen 외 6명
- AAsymptotic Error Analysis of Multilevel Stochastic Approximations for the Value-at-Risk and Expected Shortfall
Stéphane Crépey, Noufel Frikha, Azar Louzi 외 1명
- BMultivariate Scenario Generation of Day-Ahead Electricity Prices using Normalizing Flows
Hannes Hilger, Dirk Witthaut, Manuel Dahmen 외 3명
- BReinforcement Learning with Maskable Stock Representation for Portfolio Management in Customizable Stock Pools
Wentao Zhang, Yilei Zhao, Shuo Sun 외 5명
- BRisk of Transfer Learning and its Applications in Finance
Haoyang Cao, Haotian Gu, Xin Guo 외 1명
- BCan AI Detect Wash Trading? Evidence from NFTs
Brett Hemenway Falk, Gerry Tsoukalas, Niuniu Zhang
- BRevisiting Cont's Stylized Facts for Modern Stock Markets
Ethan Ratliff-Crain, Colin M. Van Oort, James Bagrow 외 2명
- BFlexible Tails for Normalising Flows, with Application to the Modelling of Financial Return Data
Tennessee Hickling, Dennis Prangle
- BDeep Calibration of Market Simulations using Neural Density Estimators and Embedding Networks
Namid R. Stillman, Rory Baggott, Justin Lyon 외 4명
- AWhy and how systematic strategies decay
Antoine Falck, Adam Rej, David Thesmar
- AControlling False Discovery Rates under Cross-Sectional Correlations
Junpei Komiyama, Masaya Abe, Kei Nakagawa 외 1명
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2026-09 월간
2026년 9월의 금융 AI 연구: 측정이 통념을 뒤집고, 검증이 창의성을 압도하다
2026년 9월 arXiv에 공개된 금융 AI 연구를 5개 테마로 정리했습니다. 1년치 CME 실측 데이터로 HFT 설계 원칙을 뒤집은 S티어 논문, 수천 개 LLM 에이전트의 프로덕션 현실, anytime-valid 심판으로 팩터 거짓발견을 5~11배 줄이는 방법, 매직 스트라이크로 분산 계약을 정밀 산정하는 수학, drawdown을 강건하게 제어하는 포트폴리오 이론까지 — 측정과 검증이 창의성을 압도하는 달이었습니다.
 📊 2026-04 월간
AI가 진짜 돈을 움직이기 시작했다 — 2026년 4월 금융 AI 연구 하이라이트
2026년 4월 금융 AI 연구 동향. LLM 에이전트가 실제 자본으로 온체인 거래를 시작하고, 백테스트의 허상이 대규모 실증으로 검증된 달의 핵심 논문들을 살펴봅니다.
 📊 2025-12 월간
크립토 백테스트가 거짓말하는 이유, 그리고 2025년 12월 퀀트 연구의 다섯 가지 흐름
2025년 12월 arXiv에 올라온 금융 AI·퀀트 연구 중 주목할 만한 다섯 가지 흐름을 살펴봅니다. 크립토 백테스트의 과대평가 문제부터 팩터 알파의 수명까지, 실전에 가까워지는 퀀트 연구의 최신 동향을 쉽게 풀어 설명합니다.