
매달 arXiv에 쏟아지는 금융 연구 중에서 가장 의미 있는 논문을 골라 정리합니다. 2023년 12월은 유난히 "이론의 달"이었습니다. 그런데 그 이론이 한결같이 같은 방향을 가리키고 있었어요 — "우리가 여태 믿어온 가정 하나씩을 내려놓자." 가격이 미래만 보고 결정된다는 가정, 시장 모형을 완전히 안다는 가정, 투자자가 시간이 지나도 약속을 지킨다는 가정. 이 달의 다섯 이야기는 각각 다른 가정을 조용히 내려놓는 과정입니다.
들어가며: 2023년 12월에 무슨 일이 있었나
2023년 12월, arXiv에는 220편의 관련 논문이 수집되었고, 그중 91편이 우리 평가 기준의 '관련 논문'으로 분류되었습니다. 최상위 A 티어는 5편입니다.
이 달의 특징을 한마디로 하면 "가정을 벗는 수학, 데이터로 서는 실전"입니다. 파생상품 가격결정, 리스크 측도, 포트폴리오 선택, 시장 미시구조, 강화학습 트레이딩 — 서로 무관해 보이는 다섯 분야가 모두 "기존 모형이 가정하던 것"을 하나씩 걷어내면서 더 정직한 계산으로 나아가고 있어요. 어려운 수학 이야기가 나오겠지만, 핵심 아이디어는 모두 일상의 비유로 설명할 수 있습니다. 천천히 따라오세요.
테마 1: 길을 기억하는 옵션 가격결정 — "어제의 날씨가 오늘의 가격을 결정한다"
무엇이 문제였나
미국형 옵션은 "언제 팔지"를 자유롭게 정할 수 있는 상품입니다. 그래서 가격을 매기려면 "언제 행사하는 게 최선일지"를 계산해야 해요. 이걸 계산하는 유명한 방법(Longstaff-Schwartz 알고리즘)이 있지만, 한 가지 가정을 깔고 있습니다 — "오늘의 시장 상황만 알면 최적 결정을 내릴 수 있다"는 가정, 수학자들은 이를 마르코프(Markov) 가정이라 부릅니다.
그런데 실제 시장의 변동성(가격의 흔들림)은 어제·그제의 움직임에 달려 있습니다. 변동성이 폭발한 뒤에는 한동안 계속 흔들리는 경향이 있죠. "기억이 있는" 시장에서는 오늘의 상태만으로는 부족하고, 지나온 길 전체가 필요합니다.
핵심 아이디어
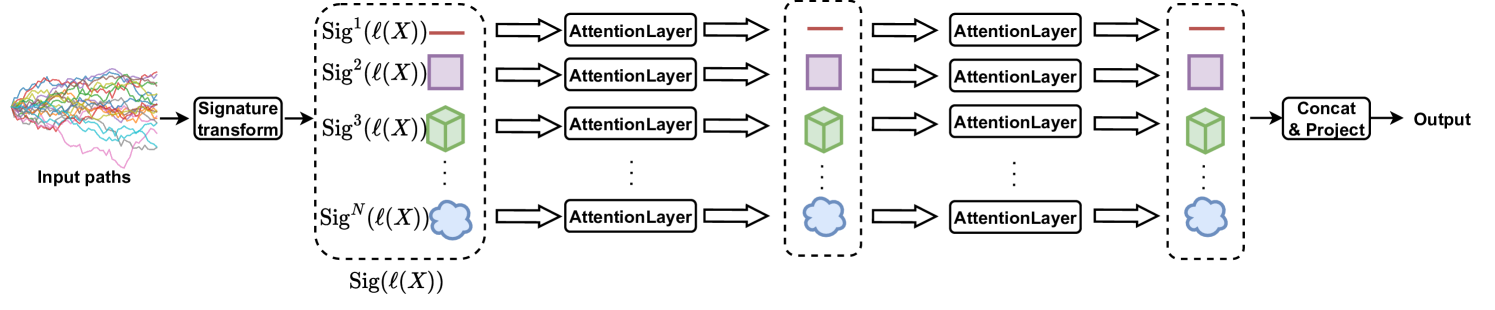
2312.03444 논문은 이 "길 전체"를 수학적으로 다루는 도구 — 시그니처(signature) — 를 제안합니다. 시그니처는 금융 공학보다 원래 인공지능 쪽에서 쓰이던 도구인데요, 한마디로 "지나온 경로를 숫자들의 무한한 목록으로 압축하는 방법"입니다. 마치 사람이 산책로를 걸어온 자국을 사진 한 장에 담는 대신, "오른쪽으로 얼마나 꺾였는지, 얼마나 오래 걸었는지"를 순서대로 기록하는 것과 비슷해요.
저자들은 이 시그니처를 두 가지 방식으로 활용했습니다:
- 행사 시점 예측(프라이멀): 유명한 알고리즘의 "기억 있는 버전"으로 확장 — 경로 압축 정보를 기초로 언제 행사할지 학습합니다.
- 가격 상한 계산(듀얼): "이 옵션 가격이 이보다 비쌀 수 없다"는 상한선을 독립적으로 계산해, 오차 범위를 양쪽에서 조입니다.
두 방법 모두 수학적으로 수렴함을 증명했고, 마르코프 가정이 통하지 않는 세계(분수 브라운 운동, 러프 변동성 모형)에서의 첫 수치 실험을 보여주었습니다. 코드도 공개되어 있어요.
한계
수치 실험이 "첫 시도" 수준이라 실전 데이터 검증은 아직 부족합니다. 경로를 압축하는 항목이 늘어날수록 계산량도 늘어나는 점도 숙제입니다.
📄 Primal and dual optimal stopping with signatures (A 티어, 복합점수 68.6) — 함께 볼 논문: 내재변동성 표면도 경로 의존적이다
테마 2: 최악의 경우를 계산하는 리스크 측도 — "틀릴 수 있다는 걸 계산에 넣자"
무엇이 문제였나
포트폴리오의 위험을 측정하려면 "나쁜 시나리오"를 상정해야 합니다. 그런데 시나리오 자체가 틀리면 어떡할까요? 리스크 측도가 "위험을 과소평가하는 계산기"가 되어버립니다. 통계학의 오래된 딜레마죠 — 모델을 믿으면 틀릴 때 무방비가 되고, 안 믿으면 아무것도 계산할 수 없습니다.
핵심 아이디어 (2312.05973)
이 논문은 약한 최적수송(weak optimal transport)이라는 도구로 이 문제를 풉니다. 이름이 무섭지만 아이디어는 단순합니다: "관찰된 데이터에서 얼마나 멀리 벗어나는 시나리오까지 감안할지"에 값을 매기는 거예요. 시나리오를 한참까지 끌고 가면 보수적(안전)해지고, 가까이만 두면 낙관적이죠. 이 "감안 거리"를 조절하면서 최악의 손실을 계산합니다.
놀라운 결과는, 이 복잡한 계산이 손실 함수를 일그러뜨리는 하나의 변환으로 정확히 표현된다는 것입니다. 그림처럼, 원래 손실 곡선을 구부리고 늘려서 "최악의 관점에서 본 손실"로 바꾸는 거예요.
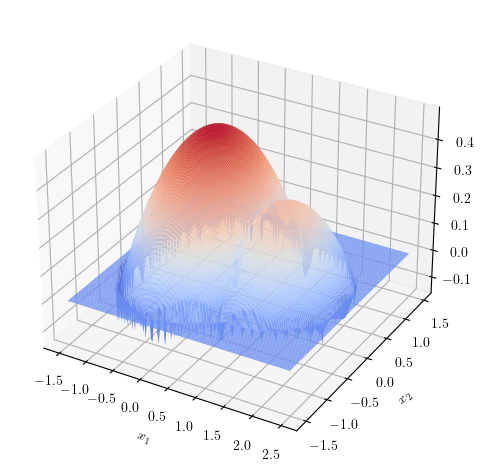
이 변환은 신경망으로 근사할 수도 있어서, 실제 계산이 가능합니다. 논문은 이 프레임워크로 (1) 보험사의 최악 손실, (2) 시장에 견적된 옵션 가격만으로 계산하는 모형 프리 무차익 가격까지 계산해 보여줍니다.
함께: 포트폴리오도 "다변화"를 목표로 직접 세우자
같은 달의 수익-다변화 이중목적 포트폴리오 연구는 "수익을 추구하면서도 다변화 자체를 목표로 삼자"고 제안합니다. 재미있는 발견: 자산들이 서로 똑같이 움직이는(등상관) 상황에서는 "최대 다변화" 전략이 잘 알려진 리스크 패리티 전략과 수학적으로 같아진다는 거예요. 서로 다른 출발점이 같은 정상에 도달하는 셈이죠.
한계
이론과 계산 프레임워크가 중심이고, 실제 데이터 대규모 실증은 아직 적습니다.
📄 Risk measures based on weak optimal transport (A 티어, 복합점수 67.5)
테마 3: 모형 없이 포트폴리오를 배우는 AI — "정답 교재 없이 공부하기"
무엇이 문제였나
"주식과 현금을 몇 대 몇으로 나눌까"라는 고전적 질문(머튼 문제)에 답하려면, 전통적으로 시장 모형 — 수익률이 어떻게 움직이는지에 대한 수학적 가정 — 을 먼저 세우고 그 위에서 최적해를 계산합니다. 문제는 모형이 틀리면 최적해도 틀린다는 것. 계산은 완벽한데 현실과 안 맞는, "정답이 틀린 문제집"으로 공부하는 셈이에요.
핵심 아이디어 (2312.11797)
이 논문은 문제집을 아예 버리자고 제안합니다. 주가와 변동성 지표(VIX 같은) 같은 관찰 가능한 데이터만으로 포트폴리오 정책을 직접 학습하는 강화학습 접근이에요.
핵심 트릭은 "의도적인 무작위성"입니다. 정책을 약간 흔들어 가며(가우시안 분포로 무작위화) 실험하면, 그 흔들린 정책들의 평균이 사실은 원래 문제의 최적해라는 이론적 결과를 증명했어요. 덕분에 "모형을 추정하는 단계"를 통째로 건너뛸 수 있습니다.
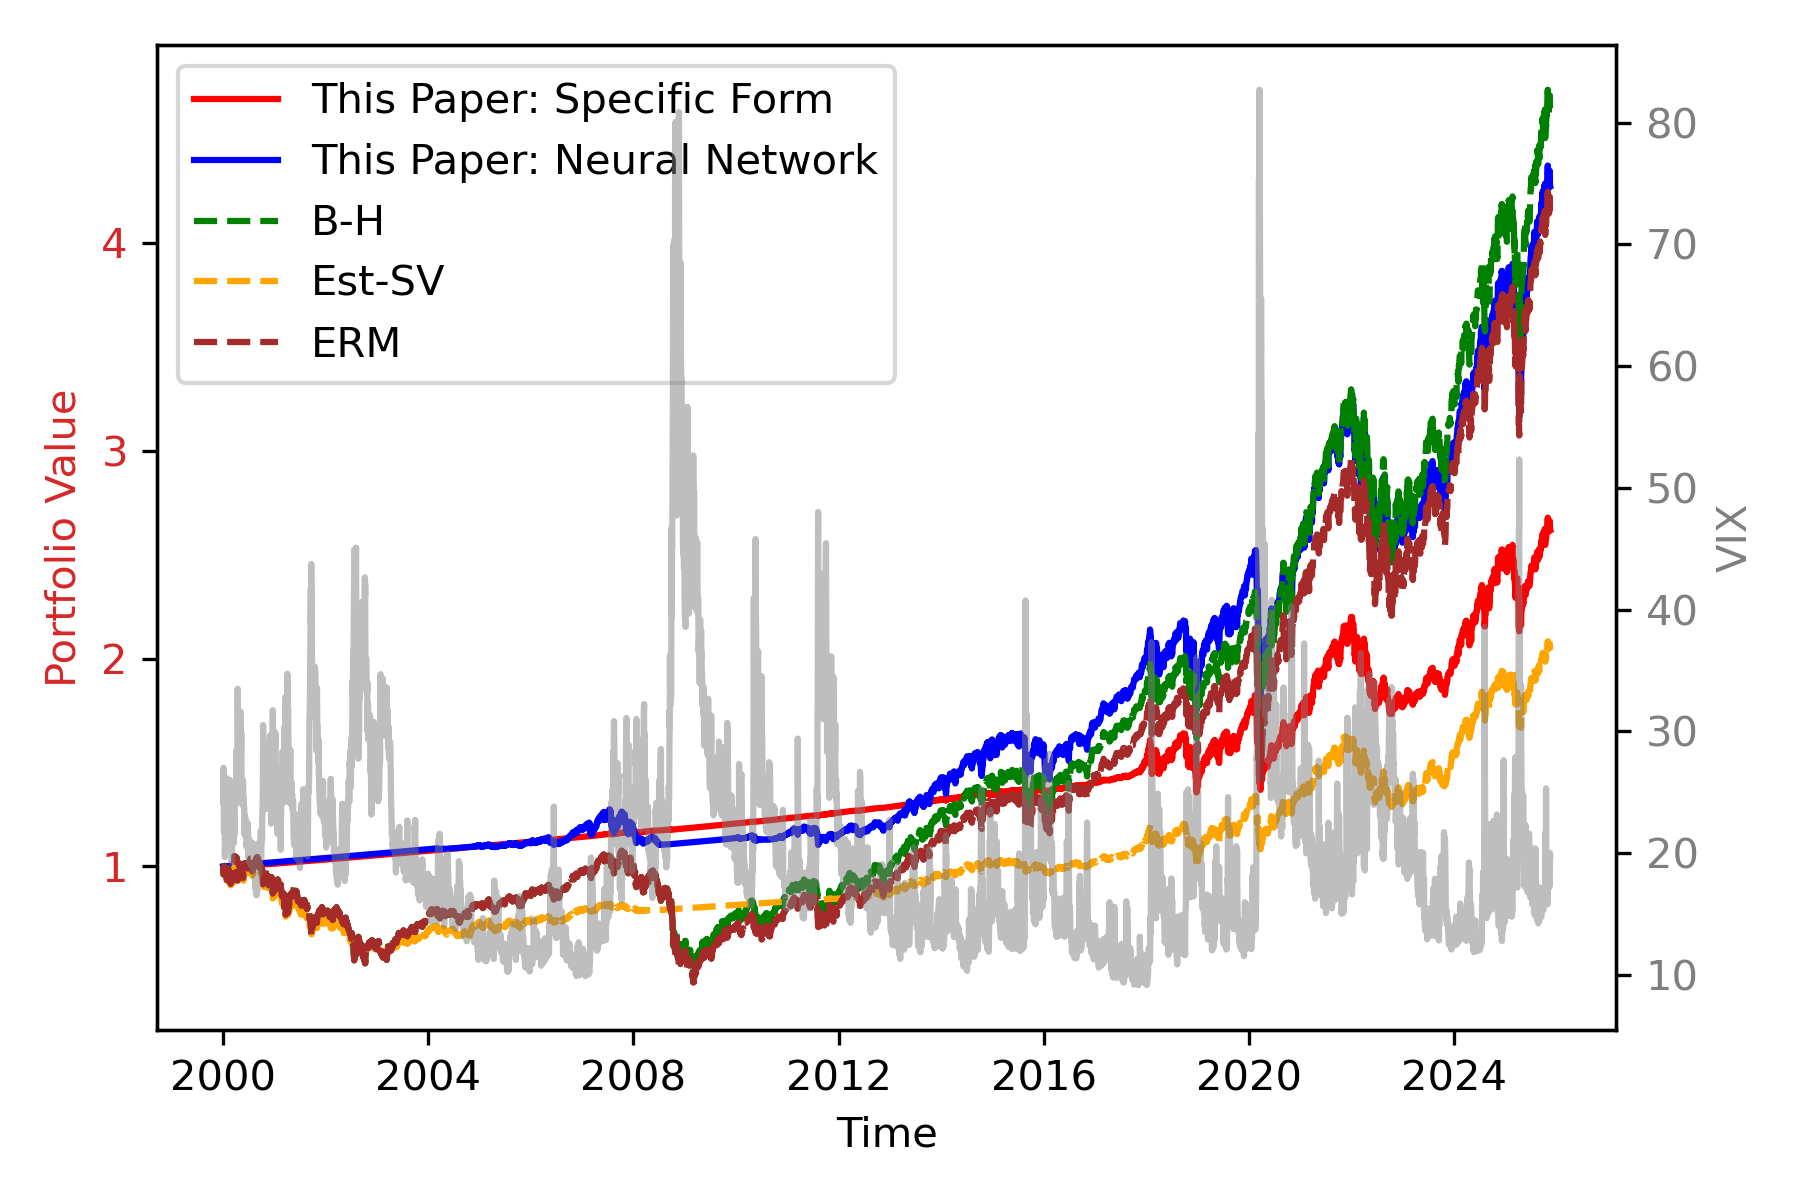
실증도 인상적입니다. S&P 500과 VIX 데이터로 2000년 이후를 아웃오브샘플로 검증했는데(초기 10년치로 미리 학습, 이후 매월 재학습·매일 리밸런싱), 전통적인 "추정 후 대입" 방식을 결정적으로 이겼습니다.
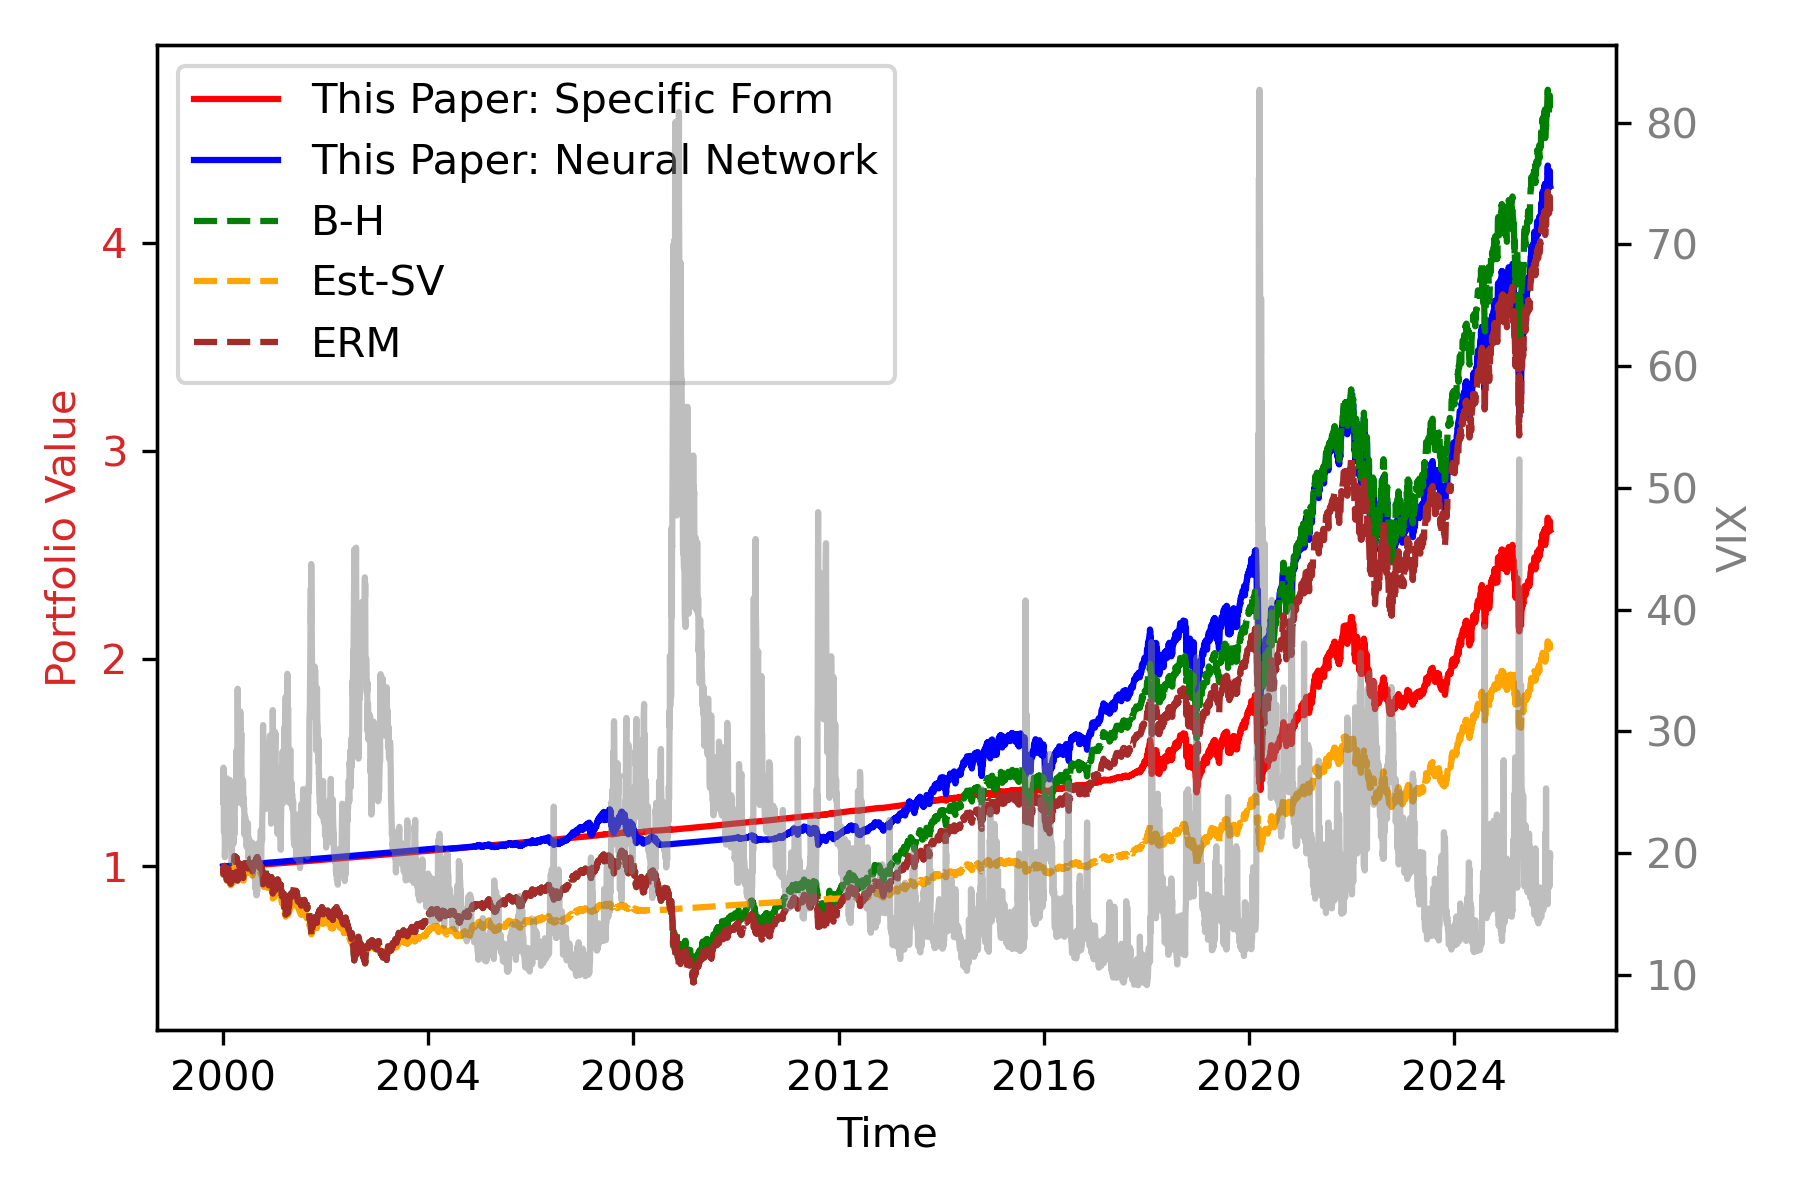
가장 흥미로운 관찰은 이겁니다: "경험적 위험 최소화"라는 전통적 학습 방법에 신경망을 쓰면, 항상 "지수에 올인"을 선택해서 결국 사고팔지 않는 바이앤홀드와 똑같아진다는 거예요. 데이터를 아무리 많이 먹여도 함정에 빠질 수 있다는 생생한 사례입니다.
함께: 수수료에 강건한 온라인 배분
Onflow는 거래비용이 높아도 무너지지 않는 모델 프리 자산배분 알고리즘을 제안합니다. 매번 리밸런싱할 때마다 수수료를 내야 하는 현실 — "자주 고치면 고칠수록 손해"라는 현실 — 을 알고리즘 설계에 직접 반영했어요.
한계
실증은 S&P 500 단일 자산군 중심이고 거래비용·세금의 정밀 반영은 아직입니다. 참고로 이 논문은 2023년 발표 이후 데이터 기간을 2025년까지 늘린 개정판(v3)이 나와 있으니, 최신 버전을 보시길 권합니다.
📄 Data-Driven Merton's Strategies via Policy Randomization (A 티어, 복합점수 65.5)
테마 4: 1밀리초 안에 독성 주문을 알아내기 — "위험한 손님 가려내기"
무엇이 문제였나
브로커(증권사·유동성 공급자)는 고객 주문을 받습니다. 그런데 모든 고객이 평등하지 않아요. "그냥 빨리 팔고 싶은" 손님도 있는 반면, 곧 가격이 움직일 것을 알고 미리 들어오는 손님도 있습니다. 후자를 받으면 브로커는 곧바로 손실을 봅니다 — 이를 "독성 흐름(toxic flow)"이라 부릅니다. 문제는 이걸 실시간으로 구분해야 한다는 것. 주문을 받고 나서 생각해보면 늦습니다.
핵심 아이디어 (2312.05827)
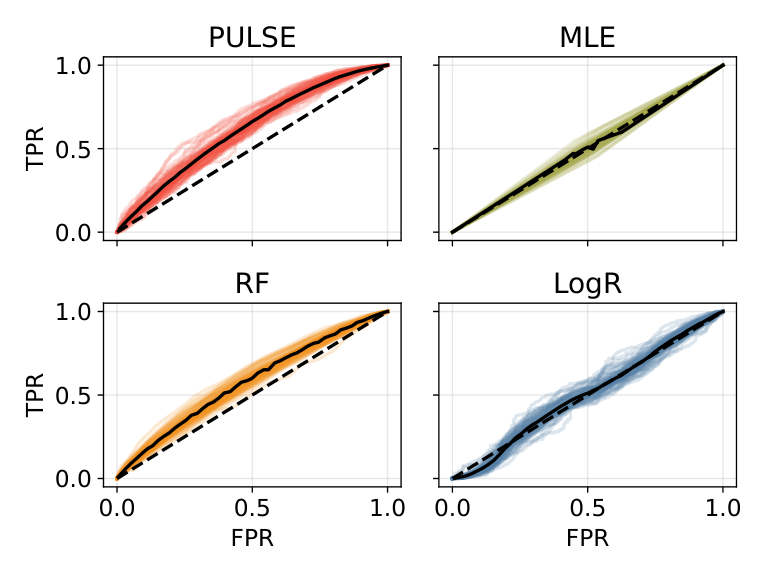
이 논문은 신경망을 온라인 베이지안 방식으로 빠르게 갱신하는 새로운 방법(PULSE)을 제안합니다. 비유하자면, 매뉴얼을 처음부터 다시 읽는 대신 오늘 새로 배운 부분만 표시해두는 독서법이에요. 신경망의 마지막 층과 특징 변환 부분만 순차적으로 추정해서, 파라미터 갱신과 예측이 1밀리초도 안 걸립니다. 실시간 체결 환경에 그대로 꽂을 수 있는 속도죠.
실제 외환(FX) 거래 데이터로 검증한 결과:
- 독성 여부 예측 성능(AUC)이 로지스틱 회귀, 랜덤 포레스트, 전통적 통계 추정을 모든 시간 지평에서 상회
- 예측 기반으로 "받을 주문은 내부 체결, 위험한 주문은 외부 시장으로 넘기는" 전략을 짜면 손익(PnL)이 가장 높고, 손실 회피도 가장 컸습니다
- 거래 지평이 길어질수록 예측이 어려워지지만, PULSE의 우위는 오히려 벌어졌어요
함께: 주문이 도착하는 리듬에도 규칙이 있다
호크 과정 연구는 주문이 쏟아지는 "폭발적 도착" 패턴이 시장 전체의 거친 변동성으로 이어짐을 수학적으로 연결했습니다. 호가장 모형 연구는 주문의 크기까지 함께 모형화했고요. 거래의 시간 구조 자체가 정보라는 공통된 통찰입니다.
한계
전용(proprietary) 데이터셋으로 검증되어 외부 재현이 어렵습니다 — 이 논문의 가장 큰 약점이에요. 주식·선물 등 다른 자산군에서의 검증이 필요합니다.
📄 Detecting Toxic Flow (A 티어, 복합점수 65.3)
테마 5: 오늘의 나와 내일의 나의 약속 — "배신하지 않는 투자 전략"
무엇이 문제였나
사람은 미래의 자신과 약속을 잘 지키지 못합니다. 오늘은 "다음 달엔 보수적으로 투자하자"고 결심하지만, 막상 시장이 뜨거워지면 계획이 바뀌죠. 수학적으로 이를 '시간 불일치'라 부릅니다. 이런 성향의 투자자에게 "최적 전략"이란 건 사실상 없어요 — 미래의 내가 배신할 것을 알기 때문입니다. 대신 균형 전략 — 미래의 나조차 벗어나고 싶지 않을 전략 — 이 합리적인 목표가 됩니다.
핵심 아이디어 (2312.15173)
이 논문은 "오늘의 목표와 내일의 목표가 다른" 투자자를 위한 균형 전략의 존재 조건을 수학적으로 정확히 규정했습니다. 쉽게 말해 "약속을 지킬 만한 전략이 언제, 어떤 형태로 존재하는가"에 대한 필요충분 조건이에요. 그리고 현실적인 제약 — 포트폴리오 비중 상한, 차입 비용 — 을 반영한 상태에서, 균형 포트폴리오를 간단한 방정식의 해로 명시적으로 적어냈습니다.
함께: 은행의 부도 헤징도 AI가 배운다
CVA 헤징 연구는 거래상대방 부도라는 "드문 대형 사건"을 강화학습으로 헤징하는 방법을 제안합니다. 거래비용과 부도 리스크를 반영한 위험회피형 학습으로, 전통적 민감도 헤징을 꾸준히 이겼어요. 희귀한 부도 사건을 학습하기 위해 표본을 의도적으로 조작하는(중요도 표본추출) 기술도 인상적입니다. 이 연구는 이탈리아 대형 은행(Intesa Sanpaolo)과의 공동 연구라는 점도 눈에 띕니다.
한계
균형 전략의 명시적 공식은 "시장 계수가 일정한" 단순한 경우에 한정됩니다. CVA 헤징 연구는 시뮬레이션 기반이라 실거래 검증이 남아 있어요.
📄 Equilibrium stochastic control with implicitly defined objective functions (A 티어, 복합점수 67.0)
한계와 주의점
정직하게 말씀드리면, 2023년 12월 A 티어 5편의 재현성 점수는 모두 낮습니다 (28~42점). 이유는 각각인데요:
- 독성 흐름 논문은 은행 내부 데이터로 검증해 외부 재현이 불가능합니다.
- 최적정지·리스크 측도 논문들은 이론이 탄탄하지만 수치 실험이 제한적입니다.
- 머튼 전략 논문은 데이터 기간이 길지만 단일 자산군에 집중합니다.
즉, 이 달의 연구는 아이디어와 이론의 성숙도에 비해 현장 검증의 성숙도가 아직 따라오지 못하는 단계입니다. 실무 적용 전 자체 검증이 필수예요.
그래서 투자/실무엔?
- 파생상품 운용: "기억 있는" 변동성 환경에서 미국형 옵션을 다룬다면, 시그니처 기반 접근이 기존 알고리즘의 실용적 대안이 될 수 있습니다.
- 리스크 관리: "모델이 틀릴 경우"를 계산에 넣는 강건 측도 — 꼬리위험 관리에 직접 도움이 됩니다.
- 자산배분: 모형 추정 없이 데이터로 배우는 정책 — 추정 오차에 취약한 전략의 대안으로 검증해볼 만합니다.
- 체결·주문 라우팅: 독성 주문 탐지는 이 달 연구 중 실전 적용 가치가 가장 높습니다. 온라인 학습 구조는 다른 스트리밍 예측 문제에도 그대로 이식 가능해요.
- 장기 운용: "약속을 지키는 전략" 설계 — 리밸런싱 규율을 전략에 내장하는 아이디어는 전략 기획 단계에서부터 유용합니다.
월 전체 Big Picture
2023년 12월을 관통하는 메시지는 "가정을 벗는 수학, 데이터로 서는 실전"입니다. 시그니처가 마르코프 가정을, 약한 최적수송이 완전한 모형 믿음을, 정책 무작위화가 모형 추정을, 균형 제어가 시간 일관성을 내려놓았습니다. 동시에 독성 흐름 탐지는 1밀리초라는 실전 제약을 정면으로 해결했어요. "아름다운 모형의 일반화"와 "현장에서 돌아가는 시스템"이 같은 달에 나란히 전진했다는 것 — 2023년 말 금융공학의 진짜 흐름입니다.
더 알아보기
이 글에서 다룬 논문들의 arXiv 링크입니다:
- Primal and dual optimal stopping with signatures — A티어, 복합점수 68.6
- Risk measures based on weak optimal transport — A티어, 복합점수 67.5
- Equilibrium stochastic control with implicitly defined objective functions — A티어, 복합점수 67.0
- Data-Driven Merton's Strategies via Policy Randomization — A티어, 복합점수 65.5
- Detecting Toxic Flow — A티어, 복합점수 65.3
- CVA Hedging by Risk-Averse Stochastic-Horizon Reinforcement Learning — B티어, 복합점수 64.1
전체 관련 논문 91편의 목록과 테마별 상세 분석은 백필 리포트 2312에서 확인할 수 있습니다.
ohselab은 금융 AI 연구를 체계적으로 수집·평가·공유합니다.
📚 이 글에서 다룬 논문 (11편)
- APrimal and dual optimal stopping with signatures
Christian Bayer, Luca Pelizzari, John Schoenmakers
- ARisk measures based on weak optimal transport
Michael Kupper, Max Nendel, Alessandro Sgarabottolo
- AEquilibrium stochastic control with implicitly defined objective functions
Zongxia Liang, Jianming Xia, Keyu Zhang
- AData-Driven Merton's Strategies via Policy Randomization
Min Dai, Yuchao Dong, Yanwei Jia 외 1명
- ADetecting Toxic Flow
Álvaro Cartea, Gerardo Duran-Martin, Leandro Sánchez-Betancourt
- BCVA Hedging by Risk-Averse Stochastic-Horizon Reinforcement Learning
Roberto Daluiso, Marco Pinciroli, Michele Trapletti 외 1명
- BThe implied volatility surface (also) is path-dependent
Hervé Andrès, Alexandre Boumezoued, Benjamin Jourdain
- BA return-diversification approach to portfolio selection
Francesco Cesarone, Rosella Giacometti, Manuel Luis Martino 외 1명
- BOnflow: a model free, online portfolio allocation algorithm robust to transaction fees
Gabriel Turinici, Pierre Brugiere
- BConvergence of Heavy-Tailed Hawkes Processes and the Microstructure of Rough Volatility
Ulrich Horst, Wei Xu, Rouyi Zhang
- BLimit Order Book Dynamics and Order Size Modelling Using Compound Hawkes Process
Konark Jain, Nick Firoozye, Jonathan Kochems 외 1명
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2023-10 월간
AI가 금융 리스크를 읽고, 수학이 헤징을 혁신하다 — 2023년 10월 금융 AI·퀀트 연구 하이라이트
2023년 10월 arXiv에 올라온 금융 AI·퀀트 연구 중 주목할 논문 6편을 테마별로 정리했습니다. GPT로 기업 리스크를 추출하고, 시그니처로 거친 변동성에 헤징하며, 주문 흐름의 최적 해법을 찾는 최신 연구를 쉽게 풀어 설명합니다.
 📊 2026-04 월간
AI가 진짜 돈을 움직이기 시작했다 — 2026년 4월 금융 AI 연구 하이라이트
2026년 4월 금융 AI 연구 동향. LLM 에이전트가 실제 자본으로 온체인 거래를 시작하고, 백테스트의 허상이 대규모 실증으로 검증된 달의 핵심 논문들을 살펴봅니다.
 📊 2026-03 월간
AI가 주식을 예측할 수 있을까? — 2026년 3월 금융 AI 연구 리뷰
2026년 3월 금융 AI 논문 734편을 분석한 월간 종합. LLM의 시간 편향 문제, 백테스트 엔진의 숨겨진 오차, 포트폴리오 최적화의 새로운 수학, LOB 시뮬레이션의 현실화, 강화학습 트레이딩 시스템의 실전 전환까지 — 신뢰할 수 있는 금융 AI를 만드는 5가지 연구 테마를 살펴봅니다.