
매달 수백 편의 논문이 쏟아지는 AI 트레이딩 분야에서, 실전에 가까운 연구만 골라 쉽게 풀어드립니다. 이번 호는 2019년 10월 코호트입니다.
한 줄 요약
"가격표는 같은데 미래의 가격은 다르다" — 옵션 가격표만으로는 알 수 없는 것들이 2019년 10월의 연구들을 관통하는 키워드입니다.
들어가며: 2019년 10월, LLM 이전의 세상
지금은 뉴스를 읽고 투자하는 AI 이야기가 흔하지만, 2019년 10월에는 그런 논문이 한 편도 없었습니다. 대신 어떤 논문들이 나왔을까요? 주식과 채권 가격을 만드는 "수학적 공식"을 더 정밀하게 다듬는 연구, 포트폴리오 배분에서 사람이 놓치는 오차를 줄이는 연구, 그리고 시장조성자(딜러)의 일을 인공지능이 대신하게 하는 연구였습니다.
재미있는 것은, 이 시기의 연구들이 대부분 "우리가 쓰는 모델이 진짜 시장과 어떻게 다른가"라는 하나의 질문으로 수렴한다는 점입니다. 이번 호에서는 2019년 10월 논문들 가운데 다섯 가지 테마를 골랐습니다.
- 옵션 가격표는 같아도 VIX 선물 가격은 다르다
- 포트폴리오의 운명을 가르는 것은 '공분산'이다
- 채권 딜러의 일을 대신하는 강화학습
- 가짜 상관행렬을 대량 생산하는 GAN
- 공부를 '적당히' 멈추는 딥러닝 전략
테마 1: 옵션 가격표는 같아도 VIX 선물 가격은 다르다
무엇이 문제였나
주식시장에는 '공포 지수'라는 것이 있습니다. 바로 VIX입니다. S&P 500 지수가 앞으로 30일간 얼마나 흔들릴지를 시장이 예상한 숫자인데, 공포가 커지면 올라갑니다. 이 VIX의 미래 값에 베팅하는 상품이 VIX 선물입니다.
문제는 이 VIX 선물의 '적정 가격'을 계산하려면 주식 시장 전체의 미래 움직임을 담은 모델이 필요한데, 그 모델은 옵션 가격표(바닐라 옵션 가격)로만 맞춰 놓는다는 점입니다. 그런데 옵션 가격표를 완벽하게 맞춘 두 모델이 VIX 선물 가격에 대해서는 서로 다르게 말한다면? 그동안 금융공학계의 통념은 "그래도 국소변동성(local volatility) 모델이 VIX 선물 가격의 '상한' 같은 역할을 한다"였습니다. 쉽게 말하면 "옵션 가격표를 맞춘 모델 중에서 가장 비싸게 쳐 주는 모델"이라는 뜻이죠.
핵심 아이디어: 동전 던지기 하나로 통념이 무너지다
런던정경대학교와 블룸버그의 연구팀은 이 통념에 단순한 반례를 제시했습니다. 생각해 보세요. 미래의 변동성이 아직 결정되지 않은 채 "동전 던지기"로 정해지는 세상이 있다고 합시다. 동전이 앞면이 나오면 변동성이 25%로 높아지고, 뒷면이 나오면 2%로 낮아집니다. 그 전까지는 20%로 유지됩니다.
- 이 세상에서 미래의 VIX²(변동성의 제곱)는 평균값 하나로 확정됩니다. 아직 동전 결과를 모르니 평균만 남기 때문입니다.
- 그런데 국소변동성 모델의 세상에서는 주가가 어디에 있느냐에 따라 미래 변동성이 달라집니다. 즉 VIX²가 확률변수로 흔들립니다.
- 두 VIX²의 평균은 정확히 같습니다. 하지만 "변동성이 클수록 이득"인 상품(복잡한 파생상품이라도 본질은 이런 복권입니다)은 평균이 같아도 흔들림이 큰 쪽이 더 비쌉니다.
결과적으로 VIX 선물은 국소변동성 모델이 말하는 가격보다 더 비싸게 나올 수 있습니다. 즉 "국소변동성이 VIX 선물 가격을 최대화한다"는 통념이 틀렸다는 뜻입니다. 흥미롭게도 실제 SPX 시장 데이터에서는 짧은 만기에서 바로 이런 '역전' 현상이 관측되어 있었습니다. 이 논문은 그 현상이 순수한 수학적 모델로도 만들어질 수 있음을 처음 증명한 것입니다.
결과: 긴 만기에서는 다시 원래대로
연구팀은 여기서 멈추지 않고, 만기가 길어지면(3~5개월 이상) 시장 데이터가 오히려 원래의 순서를 시사한다는 점까지 반영해 모델을 확장했습니다. 짧은 만기에서 역전, 긴 만기에서 복원 — 시장이 보여 주는 만기별 패턴을 모델이 따라갈 수 있다는 것이죠.
한계와 주의점
이것은 이론적 반례이지, 시장 데이터에 맞춰 캘리브레이션한 모델이 아닙니다. "실제로 얼마 차이가 난다"는 수치를 주지 않습니다. 또한 확장 모델의 수학적 해가 유일한지에 대한 문제는 이 논문도 해결하지 못하고 미결 과제로 남겼습니다.
그래서 투자/실무엔?
VIX 선물이나 변동성 파생상품을 다루는 사람에게는 중요한 경고입니다. "옵션 가격표에 맞춘 모델"만 믿고 VIX 관련 상품의 가격을 신뢰하면 안 됩니다. 모델마다 VIX 선물 가격이 달라질 수 있으므로, 가격을 복수 모델로 대조하는 습관이 필요합니다.
논문: Inversion of Convex Ordering: Local Volatility Does Not Maximize the Price of VIX Futures (A 티어, composite 70.9)
이 테마의 공통 인사이트
이 달의 옵션·변동성 이론 연구들(변동성의 변동성 전개, Heston 모델의 차익거래 가능성, 델타 헤지의 강건성 등)은 하나같이 이렇게 말합니다. "바닐라 옵션 가격으로 모델을 맞췄다고 안심하지 마라. 모델의 내부 구조가 다른 파생상품 가격을 좌우한다."
테마 2: 포트폴리오의 운명을 가르는 것은 '공분산'이다
무엇이 문제였나
"위험을 최소화하는 포트폴리오"는 계산법 자체는 간단합니다. 주식들이 서로 어떻게 같이 움직이는지(공분산)만 알면 되니까요. 기대수익률 같은 까다로운 추정이 필요 없다는 점에서 실무자들이 가장 사랑하는 배분법입니다.
하지만 실제 주식 수백 종목에 적용하면 일이 꼬입니다. 종목이 많아지면 "지난 데이터로 계산한 공분산"이 엉터리가 되기 쉽고, 그러면 포트폴리오가 표본 밖에서 엉망이 됩니다. 계산기로 연산을 많이 했다고 답이 정확해지는 게 아니라, 반복 계산이 오차를 증폭시키는 것과 비슷합니다.
핵심 아이디어: 좋은 공식보다 좋은 '튜닝 절차'
고급 공분산 추정법들은 몽땅 "노브"를 하나씩 달고 있습니다. 축소 강도, 벌점(penalty) 크기 같은 설정값인데, 이걸 어떻게 고르느냐에 결과가 달라집니다. 독일 유로파대학교의 연구팀은 이 노브를 사람이 찍지 말고 교차검증(cross-validation)으로 데이터에 맞춰 자동 선택하자고 제안합니다. 12개월을 학습용, 그다음 1개월을 검증용으로 쪼개고, "포트폴리오의 실제 위험이 가장 낮아지는" 설정값을 고르는 방식입니다.
결과: 자동 튜닝이 비싼 공식을 이긴다
S&P 500에서 50·100·200·250종목으로 구성한 네 개 유니버스로 1990년부터 2018년까지, 월별 리밸런싱으로 대장주 29년을 훑은 대규모 실증입니다.
- 교차검증으로 튜닝한 GLASSO라는 방법이 네 유니버스 모두에서 위험(연환산 표준편차)이 가장 낮았습니다. 250종목 기준으로 0.1019로, 단순히 과거 데이터를 그대로 쓰는 방법(0.1858)이나 종목을 똑같이 나눠 담는 방법(0.1216)보다 낮습니다.
- 매달 사고파는 정도(턴오버)도 월평균 0.50 수준으로, 그대로 쓰는 방법(2.09)의 4분의 1이라 거래비용 절감 효과도 큽니다.
- 반전: 아주 정교한 최신 추정법이라도, 자동 튜닝을 갖춘 단순한 방법에 밀릴 수 있다는 결론입니다. 교차검증이 시장 상황 변화에 빠르게 적응하기 때문입니다.
한계와 주의점
"지난 29년간 살아남은 기업"만 골라서 실험한 점(생존 편향), 수익률의 변동성이 일정하다고 가정한 점은 아쉬운 부분입니다. 거래비용을 절감했다는 턴오버 수치는 실제로 비용을 공제한 수익률이 아니라 참고 지표입니다.
그래서 투자/실무엔?
공분산 기반 배분(최소분산, 리스크 패리티 등)을 만들 계획이라면, 어떤 추정법을 쓸지보다 "튜닝값을 어떻게 정할지"를 먼저 설계하세요. 간단한 방법 + 엄격한 교차검증이 화려한 모델 + 직감 튜닝을 이깁니다.
논문: Cross-validated covariance estimators for high-dimensional minimum-variance portfolios (A 티어, composite 67.2)
이 테마의 공통 인사이트
이 달 포트폴리오 연구 26편(가장 많은 분과입니다)은 공통적으로 "추정 오차 관리가 배분 그 자체보다 어렵고 중요하다"고 말합니다. 섹터 구조를 활용한 주성분 분해, 강건 최적화, 희소성 제약 등도 모두 같은 문제의식에서 출발합니다.
테마 3: 채권 딜러의 일을 대신하는 강화학습
무엇이 문제였나
회사채 시장은 주식처럼 거래소에서 즉시 체결되지 않습니다. 기관 투자자들이 "이 채권 이 가격에 살 수 있겠어요?"라고 견적(RFQ)을 보내면, 딜러가 매수 가격과 매도 가격을 제시하는 방식입니다. 딜러는 스프레드(매수·매도 가격 차이)로 돈을 벌지만, 재고를 떠안는 리스크를 감수해야 합니다. 그래서 어떤 가격으로 호가를 제시할지가 딜러의 핵심 기술입니다.
이 문제를 수학으로 풀어 주는 고전 모형(Avellaneda-Stoikov 모형)이 있지만, 계산에 치명적인 문제가 있습니다. 다루는 채권이 늘어나면 계산량이 폭발한다는 것, 이른바 차원의 저주입니다. 채권 20종목의 호가를 동시에 최적화하라는 요구 앞에서 전통적인 계산법은 사실상 무력합니다.
핵심 아이디어: 격자 대신 신경망, 그리고 '마트료시카' 트릭
파리 대학과 J.P. Morgan이 함께한 이 연구는 강화학습(actor-critic 방식)으로 이 계산을 대체합니다. 가치함수와 호가 정책을 각각 신경망이 익히고, 격자 계산 없이 수십 개 채권까지 확장됩니다.
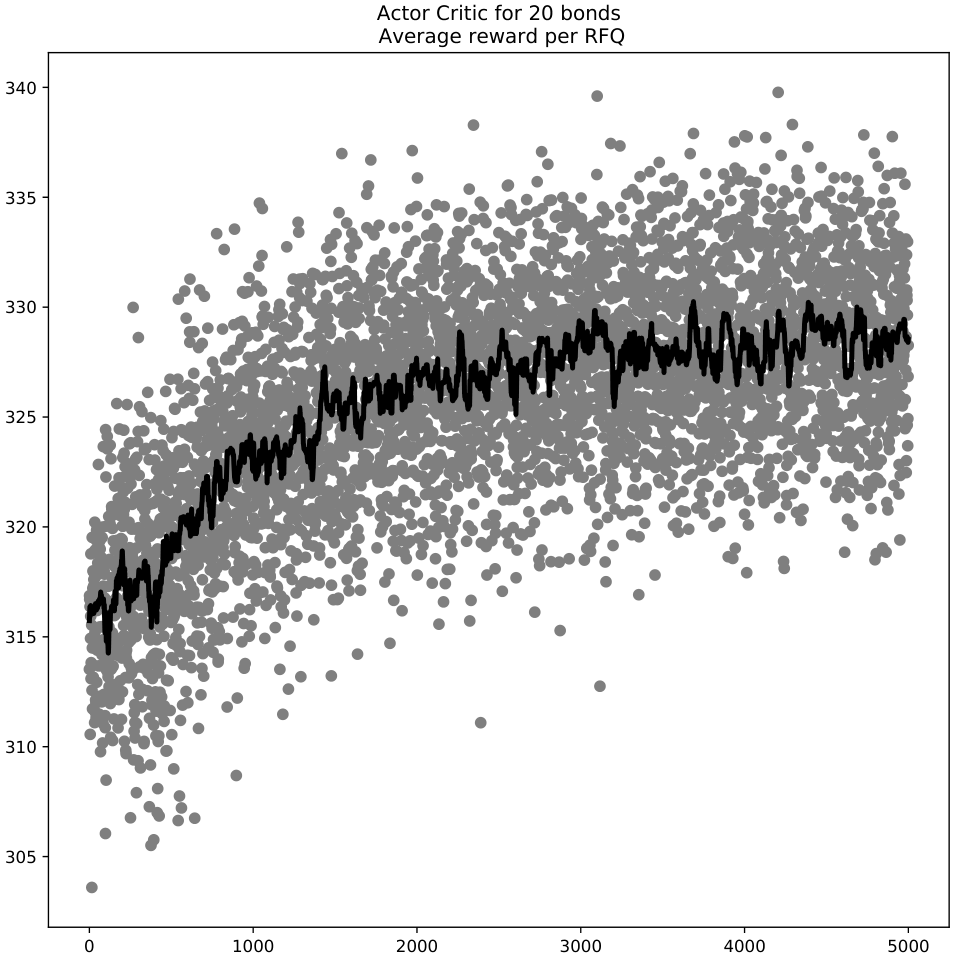
여기서 가장 눈에 띄는 것은 실전 감각이 묻어나는 학습 전략입니다. 학습 초반에는 재고 한도를 넉넉하게 풀어 주면 학습이 불안정해지고, 처음부터 빡빡하게 조이면 학습이 멈춰 버립니다. 그래서 "마트료시카 인형"처럼 한 겹씩 벗기듯, 재고 한도를 처음에는 RFQ 크기의 3~5배로 두고 500 스텝마다 한 겹씩 늘려 최대 10배까지 확장합니다.
결과: 20개 채권에서 사람 딜러의 계산을 넘다
- 채권 1~2개의 단순한 경우에는 전통적인 계산법의 답과 일치하여, 방법의 정확성을 먼저 확인했습니다.
- 채권 20종목 사례까지 성공했습니다. 전통 계산법으로는 도달할 수 없는 영역입니다. 실험에 쓴 데이터는 J.P. Morgan과의 협업으로 확보한 실제 유럽 회사채 20종목의 견적 특성(도착 빈도, 평균 견적 규모 20만~130만 수준)입니다.
- 신경망 크기와 학습 시간은 채권 수에 그냥 비례해 늘어날 뿐이고, 학습률 같은 설정값은 채권 수가 바뀌어도 그대로 쓸 수 있었습니다. 확장성이 검증된 셈입니다.
한계와 주의점
실거래 손익이 아니라 시뮬레이션 보상 기준의 검증입니다. 견적 도착 패턴, 체결 확률 같은 입력값은 추정된 값에 의존합니다. 또한 J.P. Morgan의 지원을 받은 연구로, 논문도 "이 아이디어가 해당 기관의 관행을 반영하지 않는다"는 단서를 명시하고 있습니다.
그래서 투자/실무엔?
여러 종목의 호가·집행을 동시에 최적화해야 하는 자기자본 트레이딩이라면, "제한을 점진적으로 푸는 학습 스케줄"이라는 구체적인 레시피를 가져갈 수 있습니다. 리스크 한도를 학습 과정에서 단계적으로 넓히는 이 아이디어는 알고리즘 트레이딩 전반의 안정화 기법으로 응용 가능합니다.
논문: Deep reinforcement learning for market making in corporate bonds: beating the curse of dimensionality (B 티어, composite 64.0)
이 테마의 공통 인사이트
같은 달의 시장 미시구조 연구들을 보면, 한쪽에서는 거래소의 지연 편차를 완화하는 공정한 주문 매칭(Libra)이 제안되고, 다른 쪽에서는 참여자 측의 고차원 최적화가 강화학습으로 돌파됩니다. 공통점은 현실의 제약 — 지연, 고객 견적, 자산 간 상관 — 을 모델에 직접 집어넣는다는 것입니다.
테마 4: 가짜 상관행렬을 대량 생산하는 GAN
무엇이 문제였나
포트폴리오 스트레스 테스트를 하려면 "현실적인 주식 간 상관관계"가 많이 필요한데, 실제 상관행렬은 역사에서 하나만 관측됩니다. 그럴 듯한 가짜 상관행렬을 대량으로 만들어 보려 해도, 진짜가 가진 특징들이 있어야 합니다. 예를 들면 이런 것들입니다.
- 모든 종목이 서로 어느 정도는 함께 움직인다(평균 상관계수 0.36 안팎)
- 시장 전체를 끌고 가는 '거대 요인'이 하나 있어야 한다
- 업종별로 뭉치는 계층 구조가 보여야 한다
2018년까지만 해도 "이런 특징을 모두 갖춘 가짜 상관행렬을 만드는 알고리즘은 없다"고 알려져 있었습니다.
핵심 아이디어: 그림을 그리는 GAN에게 행렬을 그리게 하라
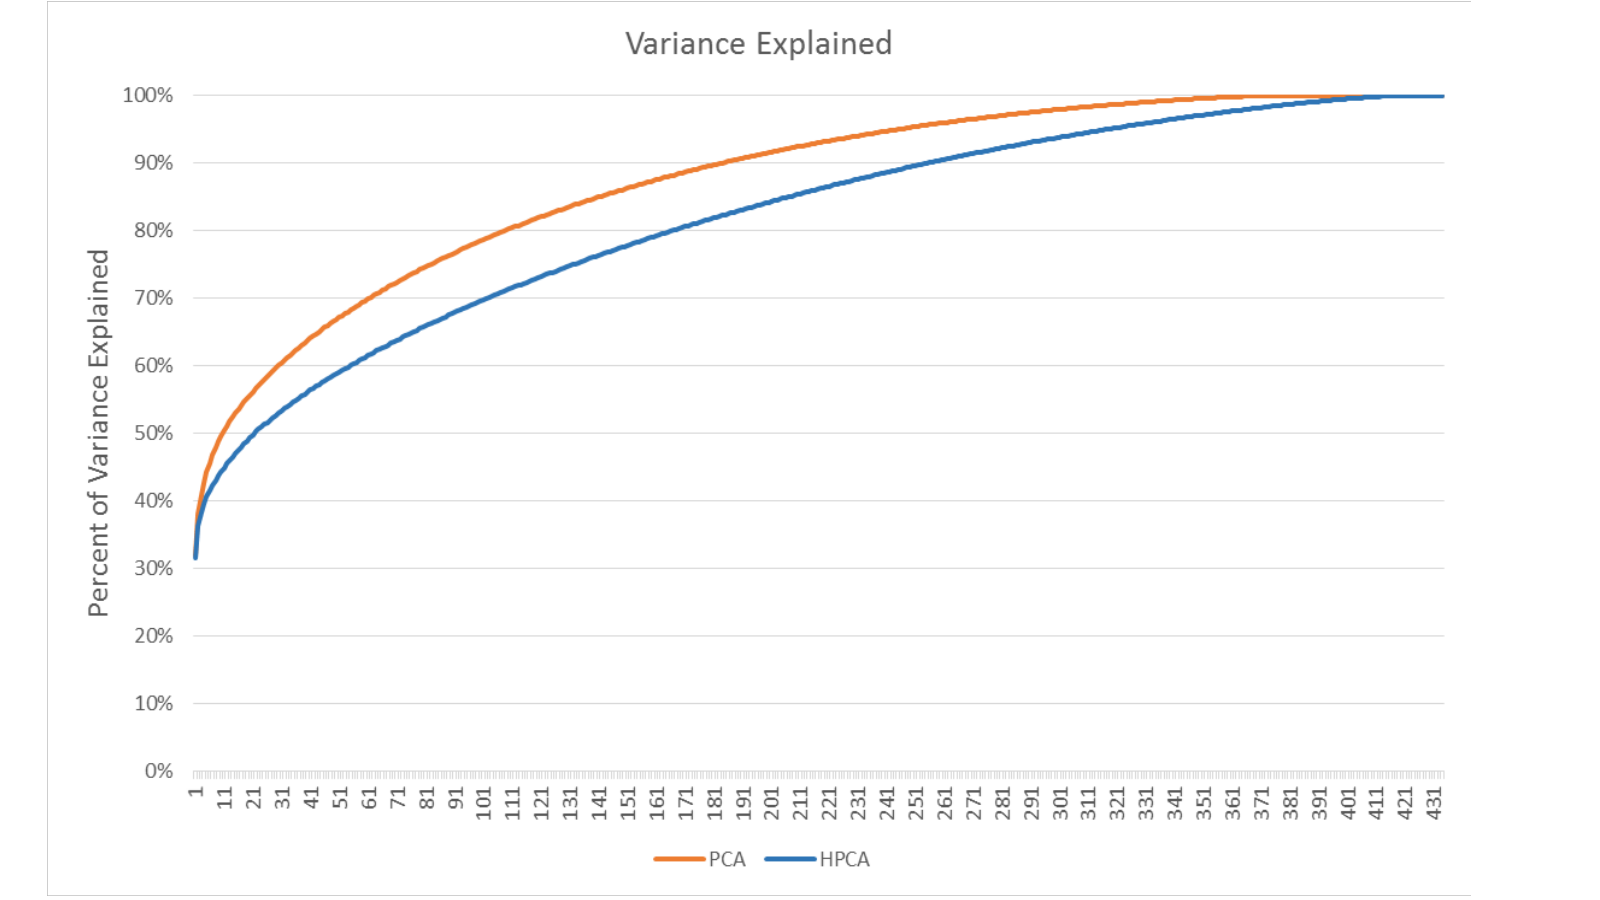
GAN(생성적 적대 신경망)은 가짜 그림을 만들어 내는 기술로 유명합니다. 연구자는 S&P 500 수익률로 추정한 약 1만 개의 진짜 상관행렬을 모아, 행과 열의 순서를 교통정리(계층적 배열)한 뒤 마치 그림처럼 GAN에게 보여 주었습니다. 그리고 GAN이 그려 낸 가짜 상관행렬이 진짜의 '습관'을 얼마나 재현하는지 검사했습니다.
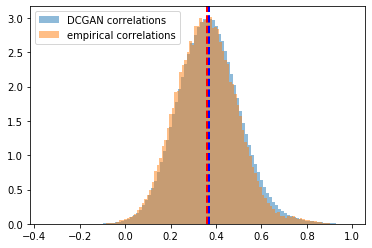
결과: 평균 0.36, 표준편차 0.13 — 진짜와 구분이 어렵다
- 상관계수 분포가 진짜와 거의 동일합니다. 평균 0.36, 표준편차 0.13로 수치까지 일치합니다.
- 고유값 분포에서 "거대한 첫 번째 요인 + 튀어나온 소수 요인"이라는 진짜 상관행렬의 지문이 재현됐고, 지배적 요인의 모든 성분이 양수라는 성질(모든 종목이 함께 오른다는 뜻)도 만족했습니다.
- 업종별 군집 구조와, 종목들을 연결한 '최소신장트리'의 모양까지 그럴듯했습니다.
한계와 주의점
분포의 꼬리(극단 상황)가 완벽하지 않습니다. 위기가 와서 상관관계가 폭발하는 극단적 상황이 잘 재현되지 않을 수 있다는 뜻입니다. 또한 GAN이 늘 같은 구역만 그려 내는 '모드 붕괴'로, 진짜 상관행렬의 모든 변형을 덮고 있는지 확인되지 않았습니다(논문도 이를 솔직하게 인정합니다).
그래서 투자/실무엔?
전략 백테스트를 수천 번 돌려 보거나 포트폴리오 위험 시나리오를 대량 생성할 때 유용한 '가상 실험실' 재료입니다. 다만 꼬리 위험은 가짜 데이터가 약하므로, 스트레스 테스트는 실제 위기 시나리오와 병행해야 합니다.
논문: CorrGAN: Sampling Realistic Financial Correlation Matrices Using Generative Adversarial Networks (A 티어, composite 66.0)
이 테마의 공통 인사이트
같은 달에는 저랭크 코퓰라와 신경망으로 고차원 공분산을 예측하는 연구, 상관행렬의 고유구조로 시장 국면과 위기 근접 신호를 읽는 연구도 나왔습니다. 공통된 방향은 "상관구조를 추정 대상에서 생성·예측 가능한 대상으로 바꾸자"는 것입니다.
테마 5: 공부를 '적당히' 멈추는 딥러닝 전략
무엇이 문제였나
"인기 팩터 20개를 신경망에 넣으면 주식 순위를 예측할 수 있지 않을까?" — 이 아이디어는 오래됐지만, 그대로 쓰면 실패합니다. 시험 문제집을 통째로 외울 때까지 공부한 학생처럼, 딥러닝은 과거 데이터에 과적합되어 미래의 순위를 망치기 때문입니다.
핵심 아이디어: '랭킹 일치도'가 목표에 도달하면 멈춘다
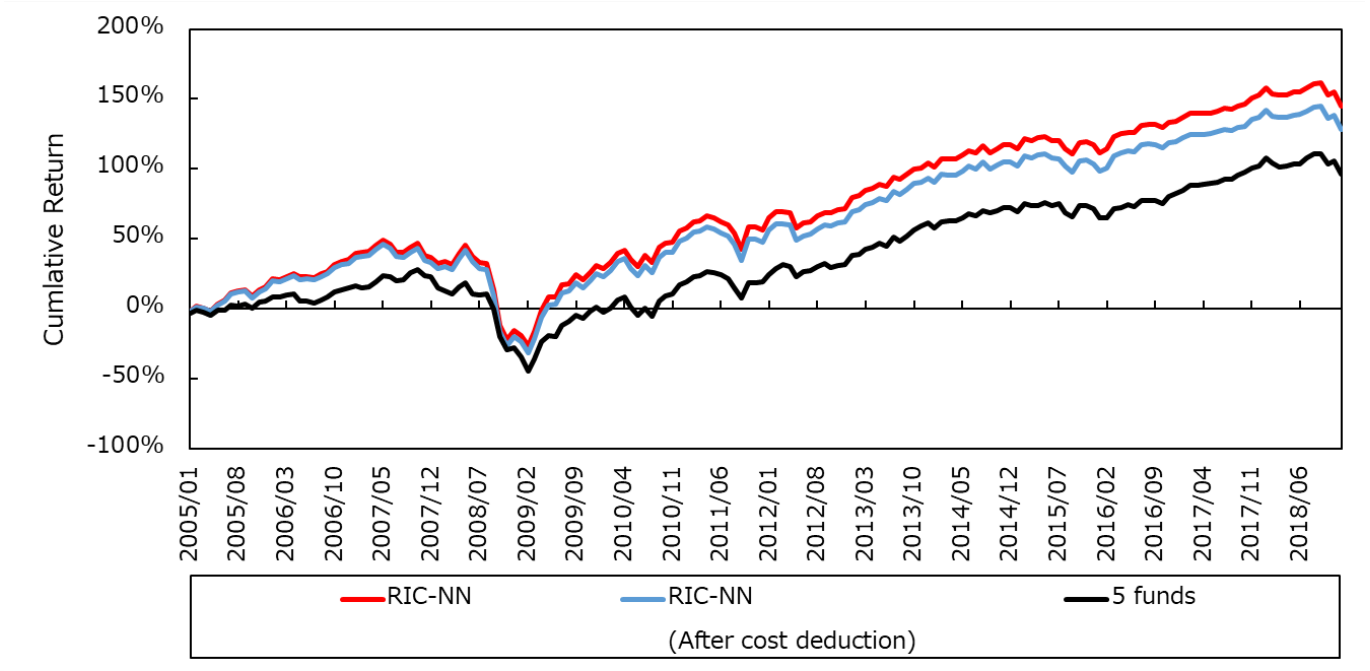
일본 노무라자산운용의 연구팀은 단순하지만 영리한 해법을 제시합니다. 전략에 필요한 것은 수익률의 정확한 값이 아니라 종목 순위입니다. 그래서 학습을 "예측 순위와 실제 순위의 일치도(rank IC)"로 관찰하다가, 일치도가 목표치(0.20)에 도달하는 순간 학습을 중단합니다. "적당히 과적합"해서 현재 데이터의 감각은 얻되, 새 데이터에 범용할 여지를 남기는 것입니다.
추가로, 선진 시장(북미)에서 학습한 모델을 아시아태평양 시장에 전이학습하는 실험도 진행했습니다.
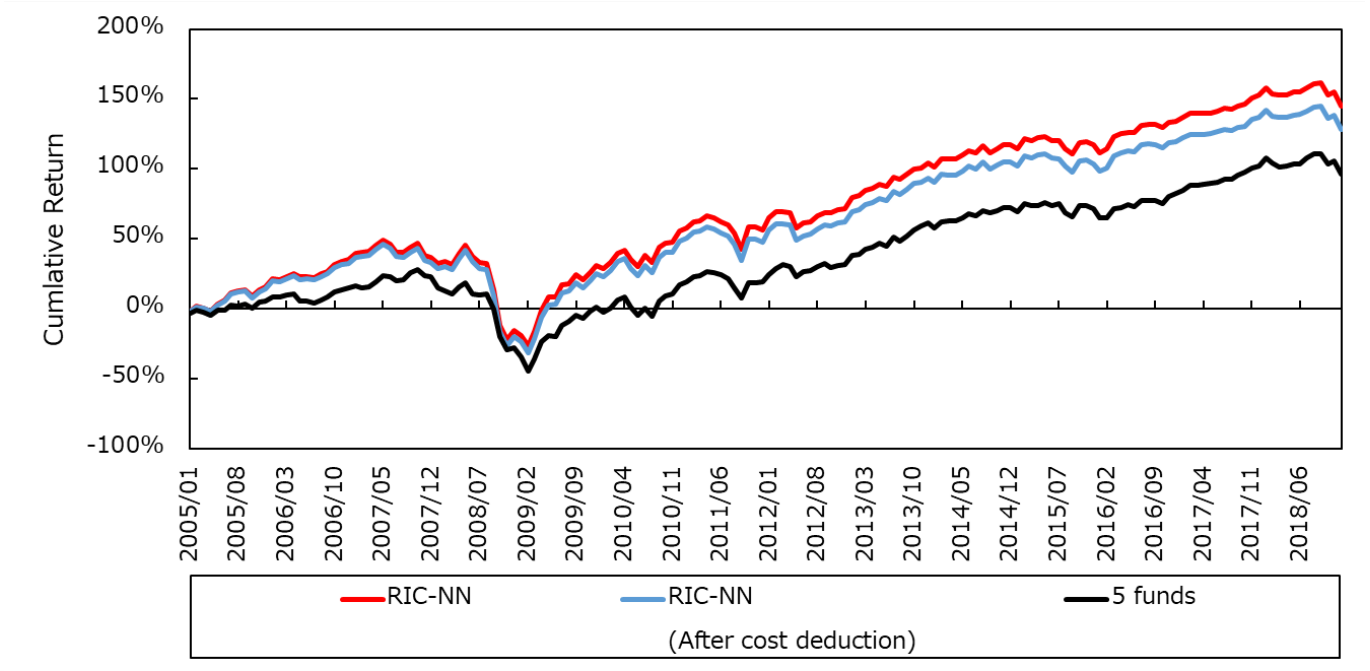
결과: 14년간의 시험에서 펀드 평균을 앞서다
MSCI 북미·아시아태평양 지수 구성주(평균 1,194종목), 인기 팩터 20개로 1994년부터 2018년까지 학습하고 2005~2018년 14년간 월별로 검증한 결과입니다.
- 북미 롱 포트폴리오: RIC-NN의 연환산 초과수익 1.23%, 정보비율 0.30으로, 라쏘 회귀(0.62%, 0.11), 랜덤 포레스트, 표준 신경망을 모두 이겼습니다.
- 롱숏 전략: 연환산 3.86%, 최대낙폭 -21.26%로 벤치마크 대비 안정적입니다.
- 전이학습은 '북미 → 아시아'로만 효과가 있었습니다. 북미 데이터를 얹은 아시아 모델은 초과수익 5.25%→5.78%, 정보비율 1.25→1.46로 개선됐고, 반대 방향은 효과가 없었습니다. 두 시장 사이의 비대칭적 관계가 드러난 흥미로운 결과입니다.
- 14년간 주요 주식형 펀드 5개의 평균 수익을 상회했습니다(다만 2007~2008년 금융위기의 큰 낙폭은 피하지 못했습니다).
한계와 주의점
거래비용·턴오버가 성과 수치에 반영되지 않았고, "5개 펀드의 평균"이라는 비교 기준 선택에 결과가 민감합니다. 특정 MSCI 지역과 20개 팩터 구성에 한정된 실험이며, 노무라자산운용 소속 연구진의 산업 연계 연구라는 점도 참고해야 합니다.
그래서 투자/실무엔?
딥러닝 투자 전략을 만들 때 조기 종료(early stopping) 기준을 검증 손실이 아니라 '전략이 실제로 쓸 지표'로 설계하라는 교훈은 즉시 적용할 수 있습니다. 또한 "선진 시장 → 신흥 시장" 방향의 전이학습이 유효하다는 실증은 글로벌 크로스섹션 전략의 출발점이 됩니다.
논문: A Robust Transferable Deep Learning Framework for Cross-sectional Investment Strategy (B 티어, composite 63.5)
이 테마의 공통 인사이트
이 달의 실증 연구들 — 점프와 변동성 국면을 분리하는 절차, 가격충격으로 자산가격 퍼즐을 푸는 균형 모형, 중국 주식의 고유모멘텀 검증, 센티먼트의 장·단기 분해, 3,607개 암호화폐의 동조화 분석 — 은 공통적으로 "어떤 신호를, 어느 시간규모로, 어느 시장에서 쓸 것인가"를 묻습니다. 모델보다 신호의 조건이 중요하다는 뜻입니다.
월 전체 Big Picture: "가격표가 전부가 아니다"
2019년 10월의 다섯 테마를 관통하는 메시지는 하나입니다. 보이는 가격표(옵션 가격, 과거 수익률, 견적 데이터)로 모델을 맞췄다고 안심하면, 보이지 않는 곳에서 오차가 터진다.
- 옵션 가격표가 같아도 VIX 선물 가격이 달라지고
- 공분산 추정에서 튜닝 절차가 성패를 가르고
- 채권 견적 최적화는 차원의 저주를 강화학습으로 넘고
- 가짜 상관행렬은 진짜의 '습관'까지 재현해야 쓸모가 있고
- 딥러닝 전략은 '적당히' 멈춰야 미래를 예측합니다
LLM이 등장하기 직전, 확률론·통계학·강화학습·생성 모델이 각자의 자리에서 금융의 현실적 제약을 정면으로 다루던 시기였습니다.
더 알아보기
이 글에서 다룬 논문들의 상세한 5차원 점수와 전체 분석은 백필 리포트에서 확인하실 수 있습니다.
- 백필 리포트:
analysis/reports/backfill/1910.md - arXiv 원문 링크: 각 테마 섹션의 "논문" 링크 참조
- 함께 보면 좋은 논문 (KB 유사 논문 기준):
- The quadratic rough Heston model and the joint S&P 500/VIX smile calibration — VIX 선물 가격 테마의 후속 연구 (A 티어)
- Optimal market making under partial information — 마켓메이킹 최적화 테마와 이어지는 연구
- Market Making with Deep Reinforcement Learning from Limit Order Books — 강화학습 마켓메이킹의 최근 계보
ohselab — AI와 데이터로 투자의 미래를 연구합니다. https://ohselab.com
📚 이 글에서 다룬 논문 (15편)
- AInversion of Convex Ordering: Local Volatility Does Not Maximize the Price of VIX Futures
Beatrice Acciaio, Julien Guyon
- ACross-validated covariance estimators for high-dimensional minimum-variance portfolios
Sven Husmann, Antoniya Shivarova, Rick Steinert
- BLibra: Fair Order-Matching for Electronic Financial Exchanges
Vasilios Mavroudis, Hayden Melton
- BChange of drift in one-dimensional diffusions
Sascha Desmettre, Gunther Leobacher, L. C. G. Rogers
- BHigh-Dimensional Multivariate Forecasting with Low-Rank Gaussian Copula Processes
David Salinas, Michael Bohlke-Schneider, Laurent Callot 외 2명
- BInference of Binary Regime Models with Jump Discontinuities
Milan Kumar Das, Anindya Goswami, Sharan Rajani
- BResolving asset pricing puzzles using price-impact
Xiao Chen, Jin Hyuk Choi, Kasper Larsen 외 1명
- BA Robust Transferable Deep Learning Framework for Cross-sectional Investment Strategy
Kei Nakagawa, Masaya Abe, Junpei Komiyama
- AThe quadratic rough Heston model and the joint S&P 500/VIX smile calibration problem
Jim Gatheral, Paul Jusselin, Mathieu Rosenbaum
- BMarket Making with Deep Reinforcement Learning from Limit Order Books
Hong Guo, Jianwu Lin, Fanlin Huang
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2025-07 월간
거래소 사이의 그림자, 밤에만 오르는 주식, 그리고 로봇 투자자 — 2025년 7월 AI 트레이딩 연구 리뷰
2025년 7월 시스템 트레이딩 최신 연구를 일반인 눈높이로 풀어쓴 월간 종합 리뷰. CEX-DEX 차익거래의 19개월 실증 데이터, 30년간의 오버나이트 수익 프리미엄, 중국 주식시장의 숨은 편향, 그리고 거래비용을 고려한 포트폴리오 이론까지.
 📊 2025-02 월간
TRADES: Generating Realistic Market Simulations with Diffusion Models
2025년 2월 arXiv에 공개된 시스템 트레이딩 핵심 논문 7편을 분석합니다. 뉴스를 읽는 트레이딩 AI,알파를 자동 발굴하는 LLM 에이전트, 시장충격의 비밀, DeFi 최적화까지 — AI가 금융 의사결정의 핵심 레이어에 진입하고 있습니다.
 📊 2024-07 월간A
2024년 7월 금융 AI 논문 리뷰: M6 우승 전략, 거친 변동성, 연준의 속마음
2024년 7월 arXiv 금융 논문 309편을 분석했습니다. M6 대회 우승의 하이퍼네트워크 포트폴리오, 거친 변동성 검정, 약한 팩터 이론, GPT-4가 읽는 연준 회의록의 이견, 지정가 체결의 음의 드리프트까지 5가지 테마로 정리합니다.