
매달 arXiv에 쏟아지는 금융 AI 논문 중에서 의미 있는 연구를 골라 정리합니다. 이번에는 2019년 9월입니다. 이 달의 논문들을 읽다 보면 하나의 단어가 계속 등장합니다 — "모르는 것". 자산들이 함께 움직이는 진짜 방식을 모르고, 가격에 섞인 잡음의 정체를 모르고, 내 전략이 기존 전략보다 나아지는지조차 확신하지 못합니다. 그런데 이 달의 연구자들은 그 "모르는 것"을 피하지 않고 숫자와 범위로 되돌려주는 방법들을 내놓았습니다.
들어가며: 완벽한 답 대신 "정직한 범위"
날씨 예보를 생각해 보세요. "내일 기온은 23도입니다"보다 "내일 기온은 21~25도 사이일 가능성이 높습니다"가 더 정직한 예보인 경우가 많습니다. 정확한 값을 하나 찍어 주는 대신, 얼마나 틀릴 수 있는지를 함께 말해 주는 것이죠.
금융 공학에서도 비슷한 전환이 일어나던 시기가 있었습니다. "이 상품의 정확한 가격은 3만 원입니다" 대신 "이 상품은 모형을 어떻게 잡아도 2만 8천~3만 2천 원 사이여야 합니다(그보다 비싸면 공짜 돈이 생깁니다)"처럼 말하는 접근이죠. 2019년 9월은 이 관점이 여러 갈래로 동시에 꽃피운 달이었습니다. 파생상품 가격, 초단기 변동성, 거래소 규칙, 인공지능 학습, 은퇴 자금까지 — 다섯 갈래 이야기를 차례로 따라가 보겠습니다.
테마 1: "모델이 틀려도" 성립하는 가격 — 무차익 가격 범위
왜 흥미로운가
두 회사 주식의 '차이'에 돈이 걸린 스프레드 옵션 같은 상품을 가격매기려면, 두 주식이 함께 어떻게 움직이는지 알아야 합니다. 그런데 시장에서 실제로 사고팔 수 있는 것은 각 회사의 개별 옵션뿐입니다. 요리로 치면, "밀가루 가격과 계란 가격은 아는데 이 둘의 가격이 함께 오르내리는지"는 시장이 말해 주지 않는 거죠. 보통은 '이 둘은 이런 식으로 같이 움직인다'는 가정(모형)을 하나 정해서 가격을 계산하는데, 그 가정이 틀리면 가격도 틀립니다.
그렇다면 가정을 아예 안 하면 어떻게 될까요? 답은 하나가 아니라 범위가 됩니다. "어떤 결합 분포가 와도 자가당착(공짜 돈)이 생기지 않는 가격대"를 계산하는 거죠.
대표 논문: 가격의 "안전 영역"을 계산기로 찾아내다
이 달의 첫 대표 논문(Robust pricing and hedging of options on multiple assets and its numerics)은 바로 이 범위를 실제로 계산하는 방법을 처음으로 제시합니다. 지금까지는 "그런 범위가 존재한다"는 수학적 증명만 있었고, 실제로 숫자를 뽑는 방법이 없었거든요.
핵심은 두 계산기를 만들어 서로 대조한 것입니다.
- 계산기 1 (선형계획법): 가능한 모든 경우의 수를 격자처럼 쪼개어, 조건을 만족하는 최악의 경우와 최선의 경우를 직접 찾습니다. 정확하지만, 문제가 조금만 복잡해지면 계산량이 폭발합니다.
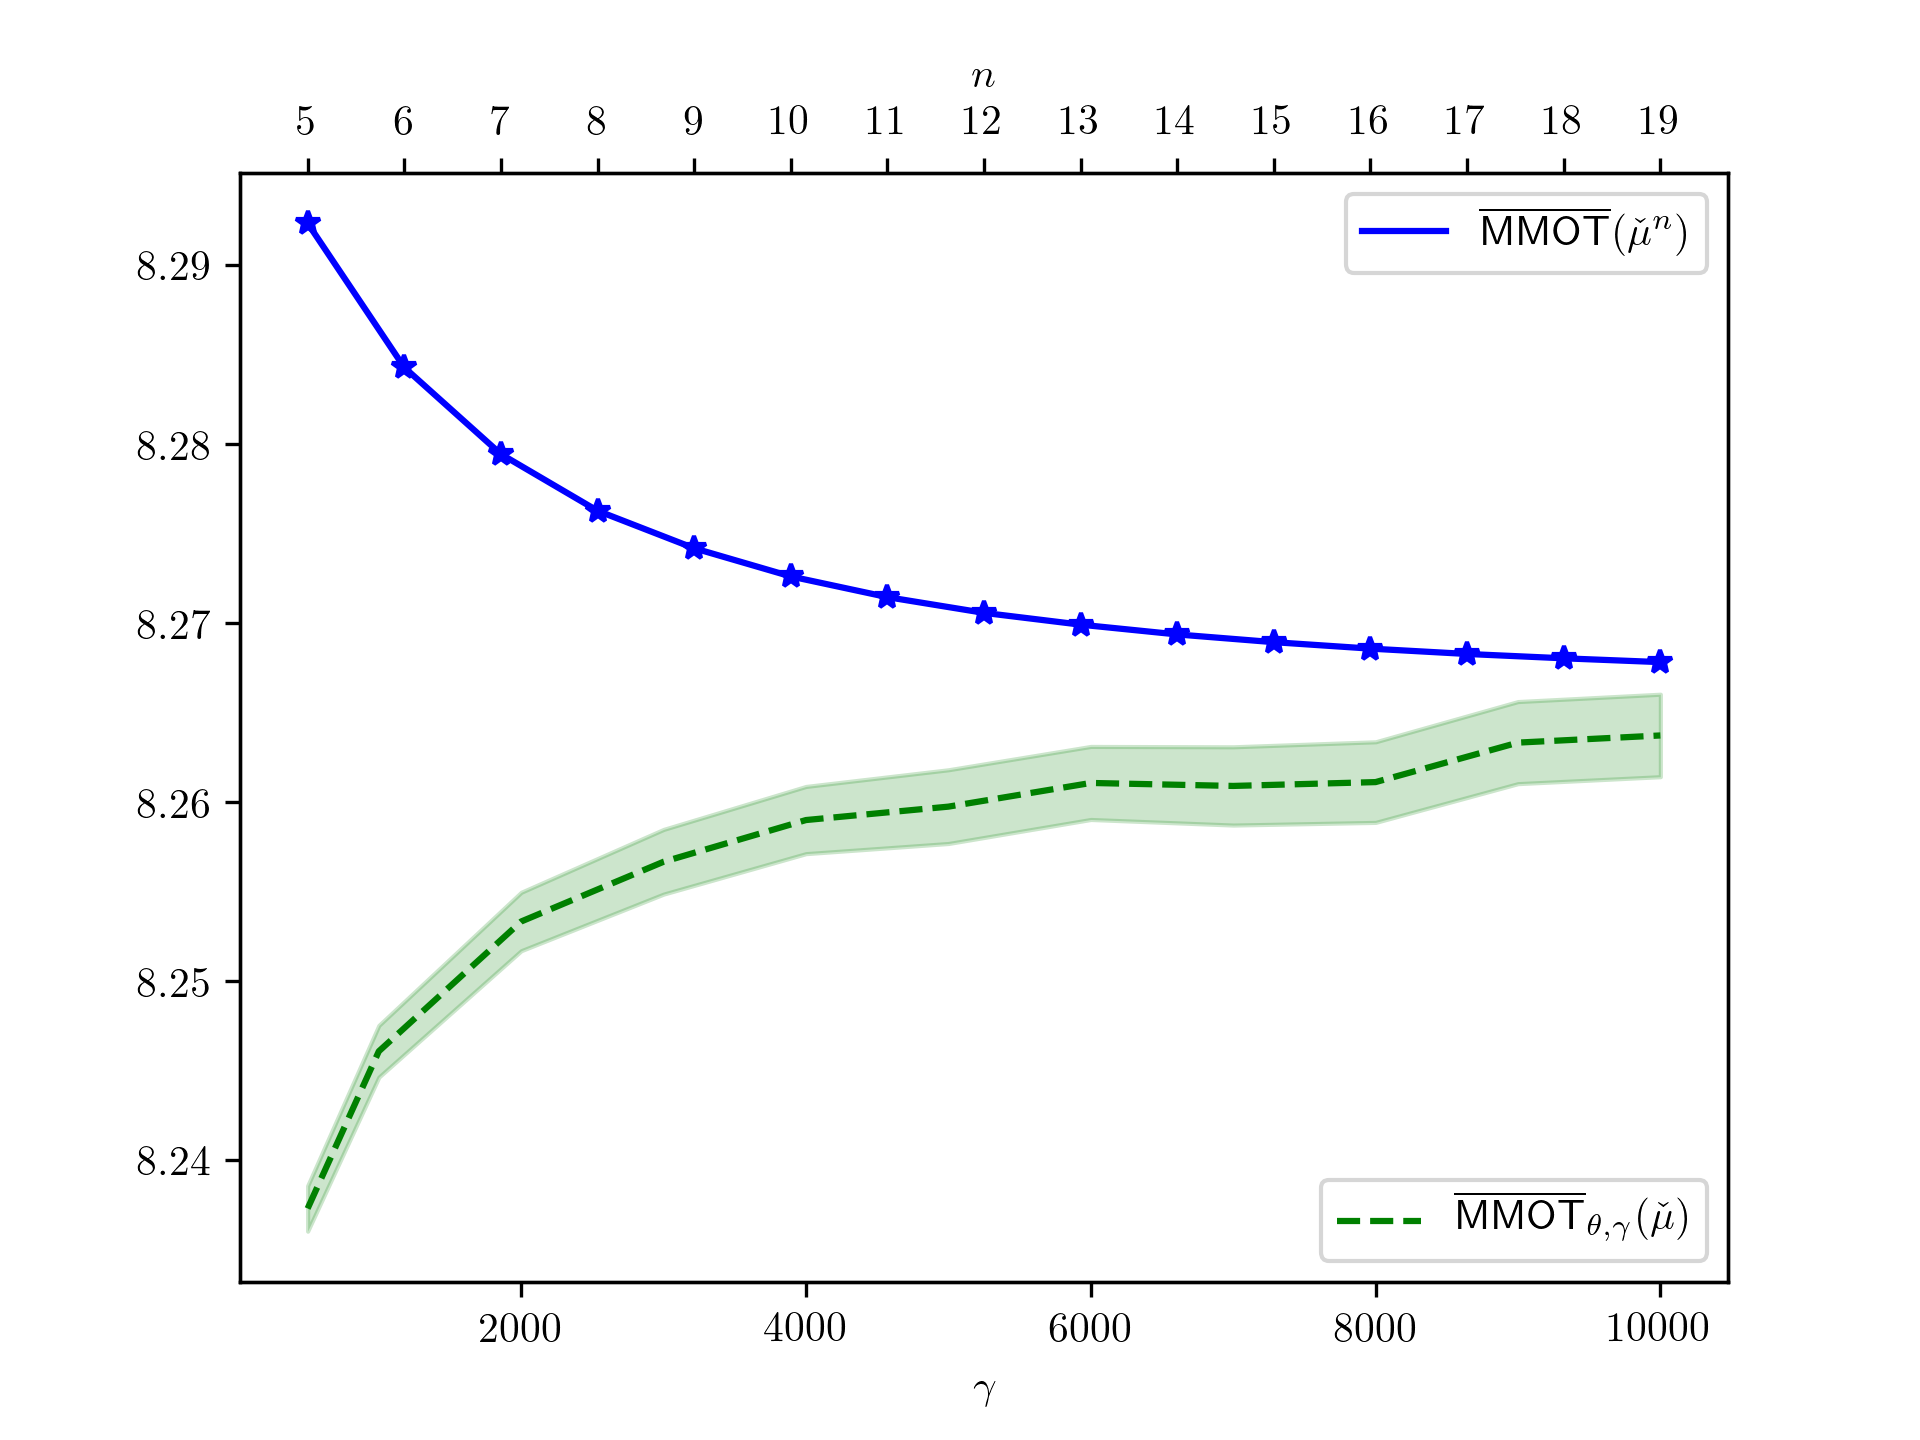
- 계산기 2 (신경망): "항상 안전한 헤지 전략"을 인공지능으로 근사하게 설계했습니다. 두 계산기의 오류 원인은 전혀 다른데, 둘 다 같은 숫자를 내놓으면 그 숫자를 신뢰할 수 있다는 것이 논문의 논리입니다.
무엇을 알아냈나
- 추가 정보는 가격을 좁힌다. 두 자산의 만기 시점 가격 분포만 알 때 스프레드 옵션의 무차익 하한 가격은 0.335였는데, 중간 시점의 옵션 가격 정보까지 쓰자 0.416, 네 시점 정보를 모두 쓰자 0.776으로 올라왔습니다. 상한은 8.337 → 8.254 → 7.920으로 내려갔습니다. 정보가 늘수록 가격의 "안전 영역"이 좁아지는 것이죠.
- 그래도 범위는 넓습니다. 네 시점 정보를 총동원해도 가격대는 0.78~7.92로, 여전히 열 배 가까이 차이납니다. 논문도 "이 범위를 가격표로 쓰기는 사례에 따라 다르다"고 솔직하게 말합니다.
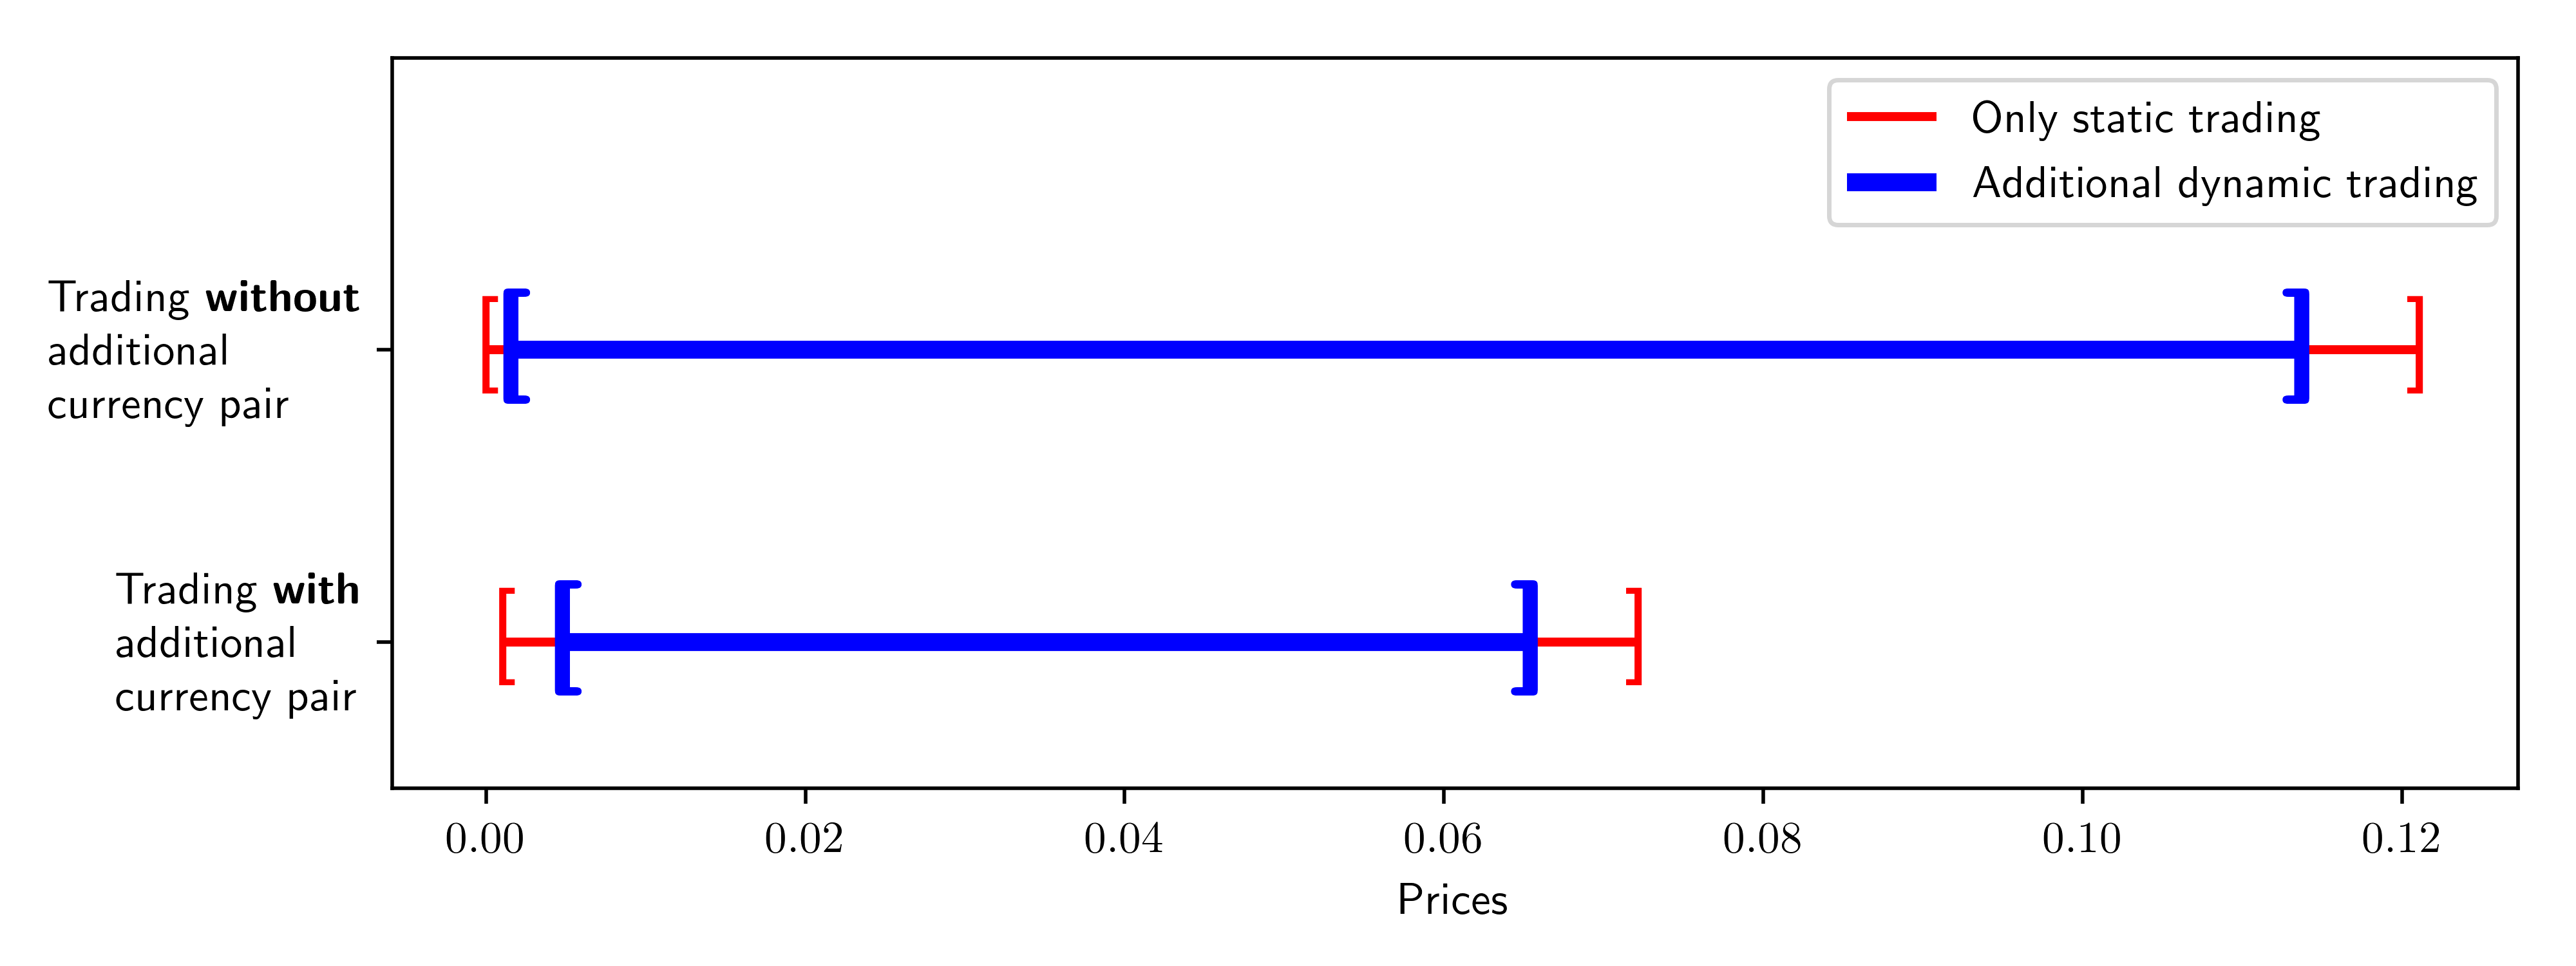
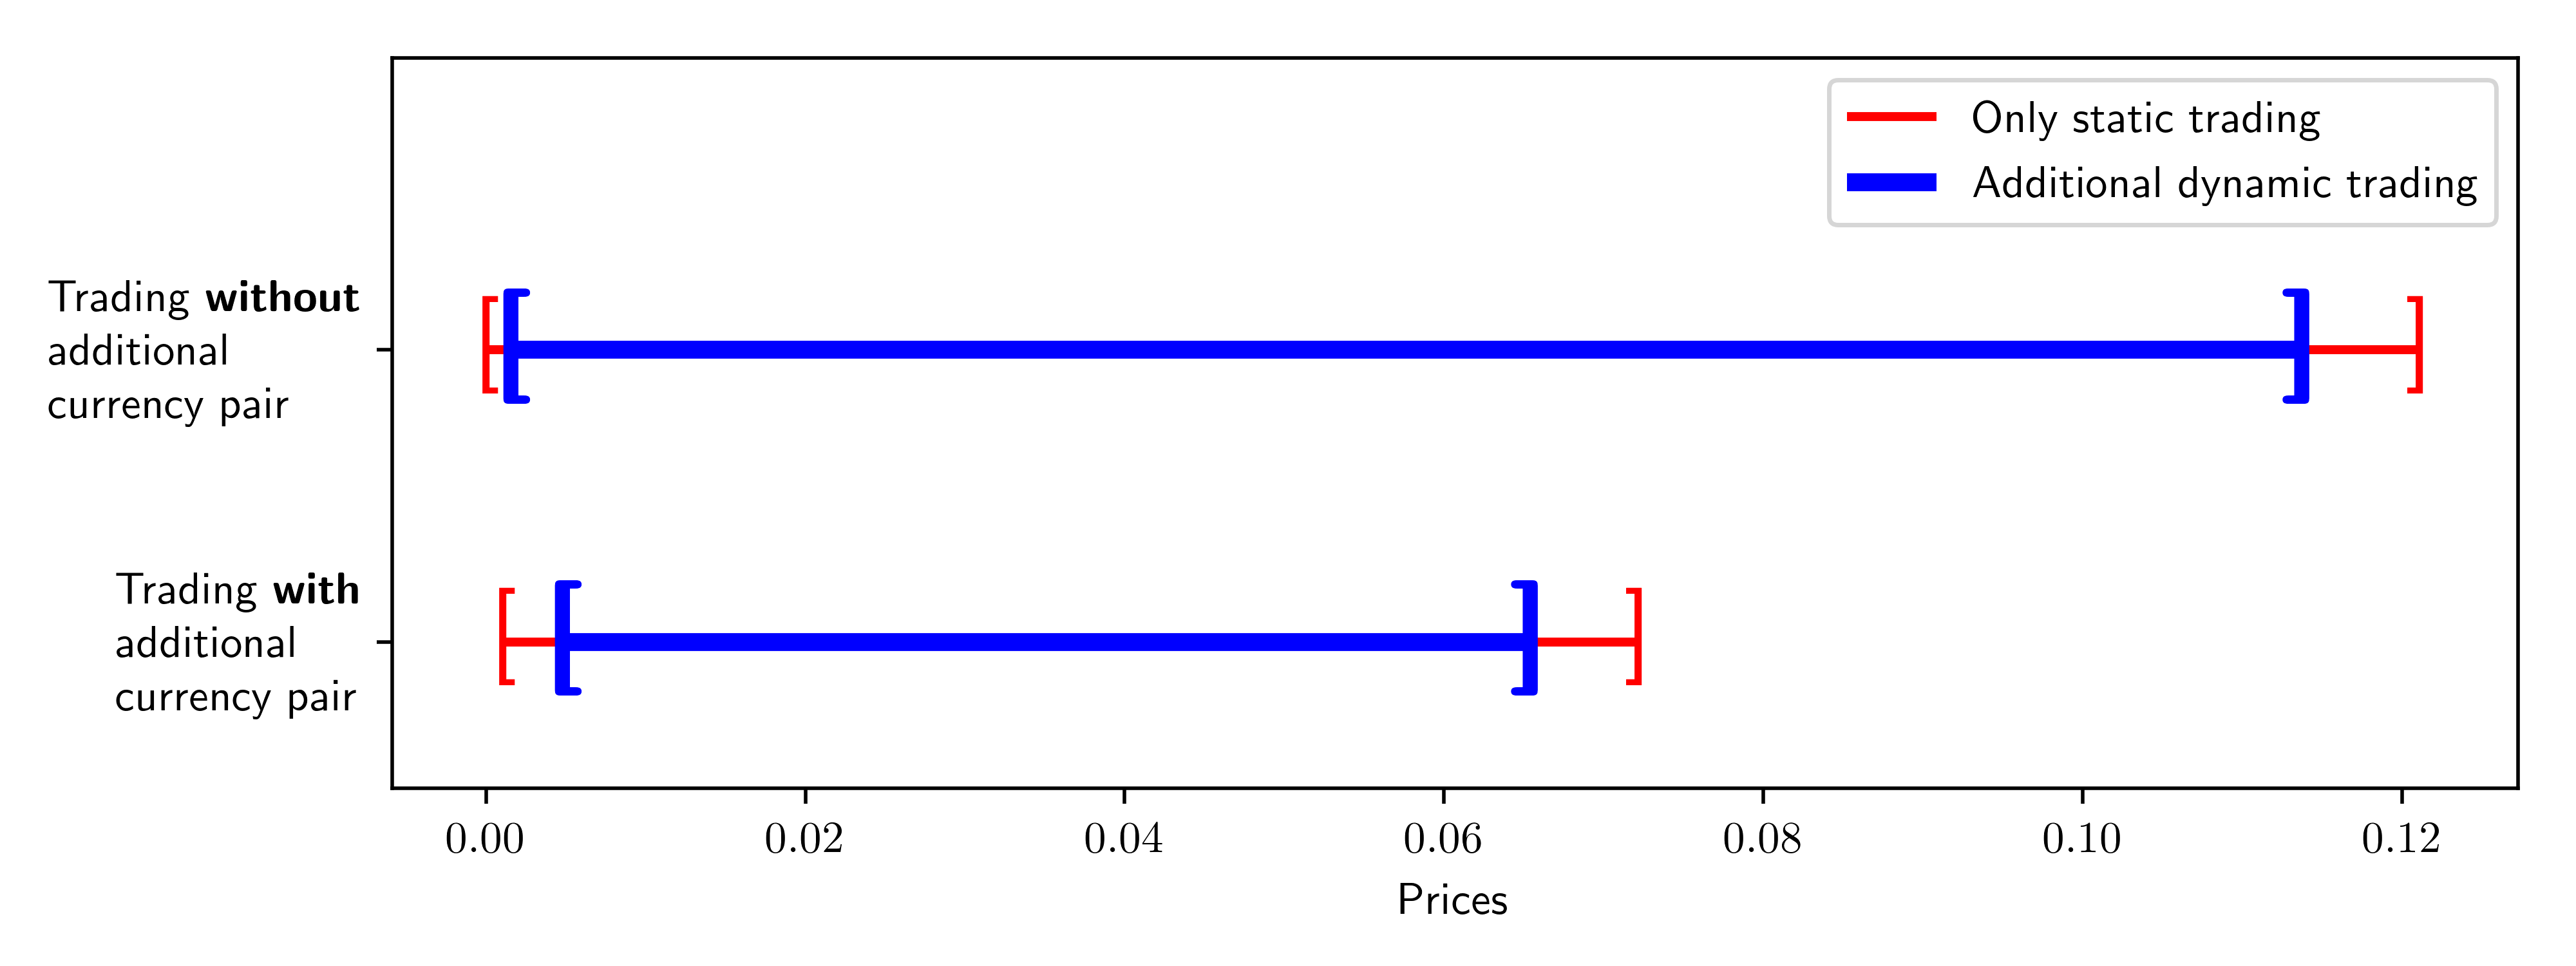
- 실제 시장 데이터로 검증. 2019년 1월 28일의 달러-파운드, 달러-유로 옵션 가격으로 아시안 옵션의 가격 범위를 계산했는데, 여기에 세 번째 통화쌍(유로-파운드) 옵션 가격을 끼우자 상한이 거의 절반으로 줄었습니다. 겉보기엔 상관없어 보이는 정보도, 자산 간 관계를 알려 주면 가격을 크게 좁힌다는 뜻입니다.
한계와 주의점
범위가 좁혀져도 여전히 넓다는 점, 계산 난이도가 차원이 오르면 급격히 나빠진다는 점(4개 자산까지 실험에서 최대 약 3% 오차)을 인정해야 합니다. "가격을 정확히 알려 주는 마법"이 아니라 "어디까지가 말이 되는 가격인지"를 알려 주는 감사 도구에 가깝습니다.
이 테마의 공통 인사이트
이 달의 강건 금융 연구들 — 드리프트(기대수익률)가 아무리 틀려도 전략이 무너지지 않게 만드는 포트폴리오 연구(1909.01830), 가격충격 자체를 모르는 상황의 대량 청산 연구(1909.00748) — 은 모두 같은 정신을 공유합니다. "맞는 모형 하나를 찾는 대신, 틀릴 수 있는 모든 모형에서 살아남는 답을 구하자."
테마 2: 초단기 가격의 진실 — 점프와 잡음 속에서 변동성 구하기
왜 흥미로운가
1초 간격으로 찍힌 주가 데이터를 보면 두 가지 골칫거리가 섞여 있습니다. 하나는 점프 — 뉴스가 터지면 가격이 확 튀는데, 이런 큰 움직임 뒤에는 눈에 잘 안 보이는 작은 점프들이 무수히 깔려 있습니다. 다른 하나는 체결 잡음 — 원하는 가격에 체결되지 않고 호가 단위로 흔들리면서 생기는 미세한 왜곡이죠. 이 둘을 제대로 분리하지 못하면 "변동성 15%"라는 숫자 자체가 틀리게 됩니다.
대표 논문: 일부러 틀린 계산을 해 놓고 나중에 고치다
이 달의 두 번째 대표 논문(Bayesian Inference on Volatility in the Presence of Infinite Jump Activity and Microstructure Noise)의 아이디어는 독특합니다. 점프의 정체를 완전히 파악하려 하지 않고, 점프를 아예 무시한 채로 계산한 뒤 결과를 수정하는 겁니다.
쉽게 비유하면 이런 상황입니다. 시끄러운 카페에서 친구 목소리만 녹음하고 싶은데, 주변 소음의 정체를 일일이 파악하는 게 불가능합니다. 그래서 "소음 없다고 치고" 친구 목소리를 추정하고, 나중에 "소음 때문에 평균적으로 얼마나 커졌고, 얼마나 흔들렸는지"를 측정해서 결과를 평행이동하고 폭을 조절하는 거죠. 논문은 이 수정된 계산이(수학적으로) 아주 정확한 구간 추정에 준한다는 것을, 표본이 늘어날수록 계산된 분포가 정규분포 형태로 안정된다는 정리로 증명합니다.
무엇을 알아냈나
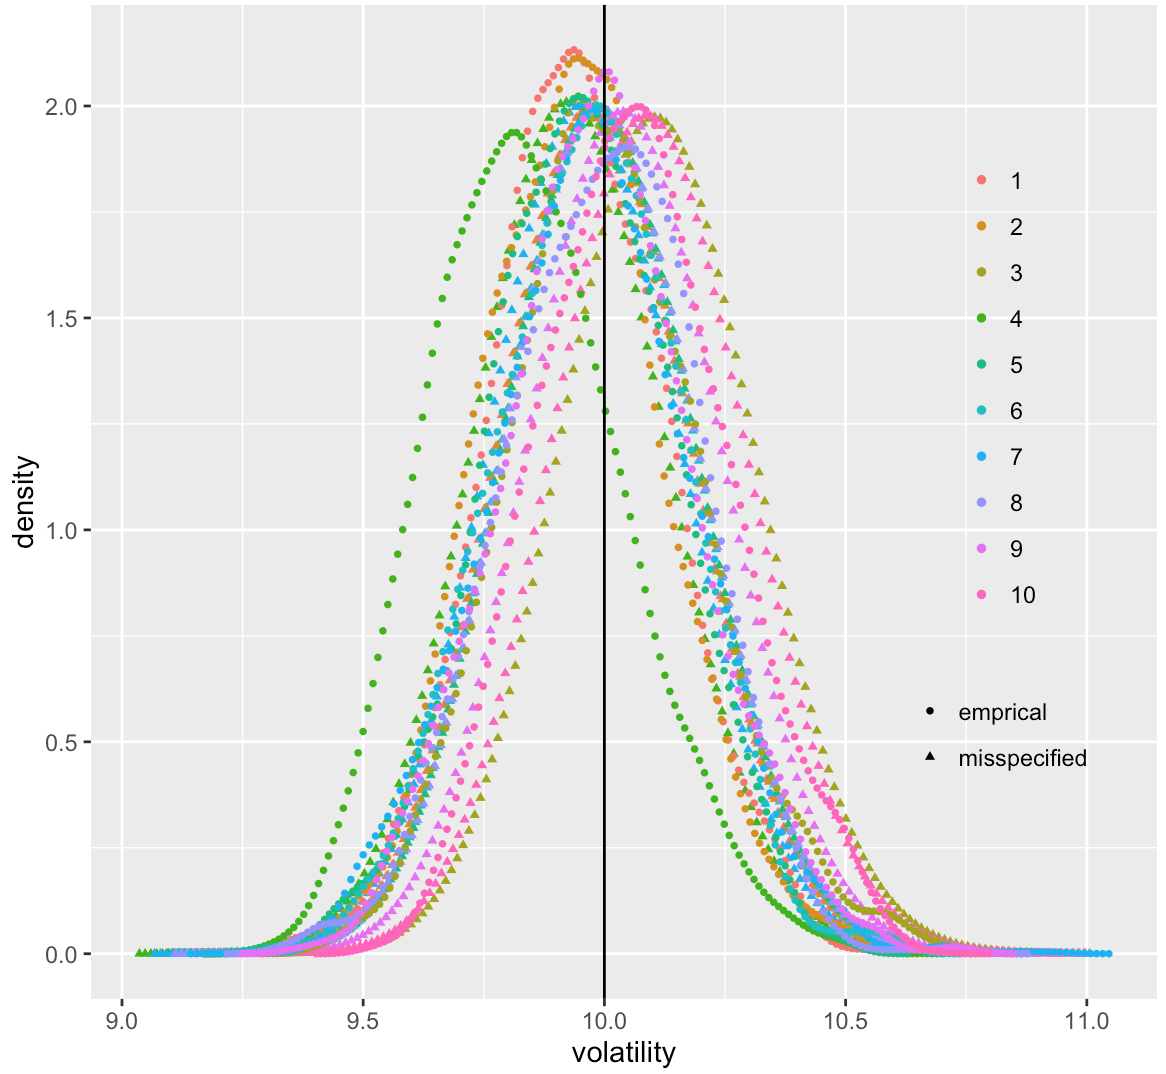
- 컴퓨터 실험(진짜 변동성 0.3, 표본 5,000개 기준)에서, 수정된 계산이 만든 95% 신뢰구간이 실제 값을 담은 비율은 94.0~95.3%로 목표(95%)에 근접했습니다. 베이지안 방식의 구간이 고전적 통계 방식(94.5%)보다 오히려 살짝 정확한 경우도 있었습니다.
- 추정 오차도 작았습니다. 점프와 잡음이 함께 있는 까다로운 설정에서 평균 편향이 0.01 수준(진짜 값 1 기준 0.0131 vs 0.0110)이었습니다.
- 사전 가정을 바꿔도 결과가 안정적이었습니다.
한계와 주의점
가정이 만만치 않습니다. 작은 점프의 활동성이 일정 수준 이하일 것, 점프의 꼬리가 극단적으로 두껍지 않을 것(16차 모멘트가 존재할 것), 체결 잡음이 완전히 무작위일 것 등입니다. 그리고 모두 가상 데이터 실험이고 실제 초단기 거래 데이터 검증은 없으며, 코드도 공개되지 않았습니다(재현성 점수 43).
이 테마의 공통 인사이트
이 달 변동성 연구들 — 시간에 따라 변하는 변동성 곡선을 정밀하게 붙이는 연구(1909.07139), 주가지수 옵션과 공포지수(VIX) 옵션을 한 모형에서 모순 없이 가격하는 연구(1909.10187), 옵션 스마일 보정을 빠르게 만드는 연구(1909.13366) — 은 모두 "현실의 복잡함을 넣어도 계산이 멈추지 않게"라는 목표를 공유합니다.
테마 3: 거래소는 어떻게 설계되어야 하는가
왜 흥미로운가
옵션 거래소를 새로 연다고 상상해 보세요. 어떤 행사가(예: "현재 주가의 90%, 100%, 110%에서 살 수 있는 권리")의 옵션을 상장할까요? 전부 다 상장하면 유동성이 흩어져 어떤 옵션도 거래가 안 됩니다. 그리고 시장조성자(사고팔 물건을 항상 내놓는 전문딜러)에게는 어떤 보상을 약속해야 좁은 호가스프레드로 고객을 맞을까요? 놀랍게도 이런 "시장 설계" 문제를 시장 데이터만으로 풀어 보자는 연구가 이때까지 거의 없었습니다.
대표 논문: 수요 데이터로 행사가를 고르고, 보상 체계로 스프레드를 좁히다
세 번째 대표 논문(How to design a derivatives market?)은 이 두 문제를 한 묶음으로 다룹니다.
첫 번째 문제(행사가 선택)의 아이디어는 오디오 압축과 닮아 있습니다. 고음질 음악을 작은 용량으로 줄이려면 "사람들이 많이 듣는 소리"를 남기듯이, 실제 거래 데이터로 추정한 수요 분포를 가장 잘 대표하는 행사가 10개를 고르는 겁니다. 손실 함수에서 큰 오차를 더 세게 벌해주면(p=8), 시장에서 멀리 떨어진 행사가까지 덮는 배치가 나옵니다.
두 번째 문제(유동성 보상)는 '주인-대리인' 설계로 풀었습니다. 거래소가 시장조성자에게 제시할 계약의 최적 형태를 수학적으로 유도하고, 시장조성자가 이에 반응해 어떤 스프레드를 고를지까지 닫힌 공식으로 계산한 것이죠.
무엇을 알아냈나
- 유럽 최대 거래소 중 하나인 Euronext의 실제 거래량 데이터(2018년 12월~2019년 5월, 전 옵션 종목)로 행사가 선택을 시험했고, 알고리즘이 실제 수요의 특성 — 가격 근처에 몰림, 만기 내(ITM) 쪽으로 약간 치우침, 만기가 길수록 넓은 행사가 분포 — 를 잘 재현했습니다.
- 보상 실험에서는 딱 두 가지 규칙이 확인됐습니다. ① 특정 옵션의 거래를 더 높게 평가해주면(보상을 크게) 그 옵션의 스프레드가 좁아진다. ② "스프레드가 넓으면 벌점" 규칙(ω)의 강도를 0 → 0.1 → 0.2로 올리면 모든 옵션의 스프레드가 함께 좁아진다.
한계와 주의점
유럽형 바닐라 옵션만, 시장조성자는 한 명, 하루도 안 되는 짧은 시간에 가격이 크게 움직이지 않는다는 가정 위에 서 있습니다. 행사가를 "몇 개" 상장할지는 논문이 해결하지 못했고, 자기 거래소 데이터만 쓰면 수요 추정이 틀어질 수 있다고 스스로 경고합니다. 거래소 실무가 쓰는 수수료 체계보다 계약 구조가 훨씬 복잡해 당장 도입하기는 어렵습니다.
이 테마의 공통 인사이트
이 달 미시구조 연구들 — FX 트레이더들의 선행-후행 관계로 '수급 쏠림'을 추정한 연구(1909.10807), 대량 주문의 실행 궤적을 다시 짠 연구(1909.10464), 지연 시간을 실제 규모로 실험하는 거래소 시뮬레이터(1909.12926), 숨은 아이스버그 주문을 찾아내는 연구(1909.09495) — 는 모두 "시장의 규칙과 구조가 가격을 만든다"는 관점에 서 있습니다. 가격을 외부에서 받는 대신, 만들고 있는 힘을 연구하기 시작한 거죠.
테마 4: 인공지능도 "망가지지 않는 법"을 배운다
왜 흥미로운가
과거 데이터로 매매 규칙을 개선하는 인공지능을 만들었다고 해 보죠. 시험해 보니 평균 성과는 좋아졌는데, 어떤 달에는 기존 규칙보다 훨씬 나쁘게 굴었습니다. 실전에서 이 "끔찍한 최악의 경우"가 문제입니다. 평균이 좋은 전략이라도, 한 번 큰 손실을 보면 자금이 남아 있지 않으니까요.
대표 논문: "기존 전략보다 나빠지지 않는" 인공지능, 증명까지 하다
네 번째 대표 논문(Safe Policy Improvement with an Estimated Baseline Policy)은 이 안전장치를 다룹니다. 지금까지의 안전 학습 알고리즘은 "기존 전략(기준 정책)"을 정확히 알고 있어야 했는데, 현실의 데이터에는 기록만 있고 전략은 없는 경우가 많습니다(의료 기록, 고객 상담 로그, 오래 전 거래 기록 등). 논문은 기준 전략을 데이터에서 대충 추정해 넣어도 안전장치가 유지된다는 것을 처음으로 수학적으로 증명합니다.
무엇을 알아냈나
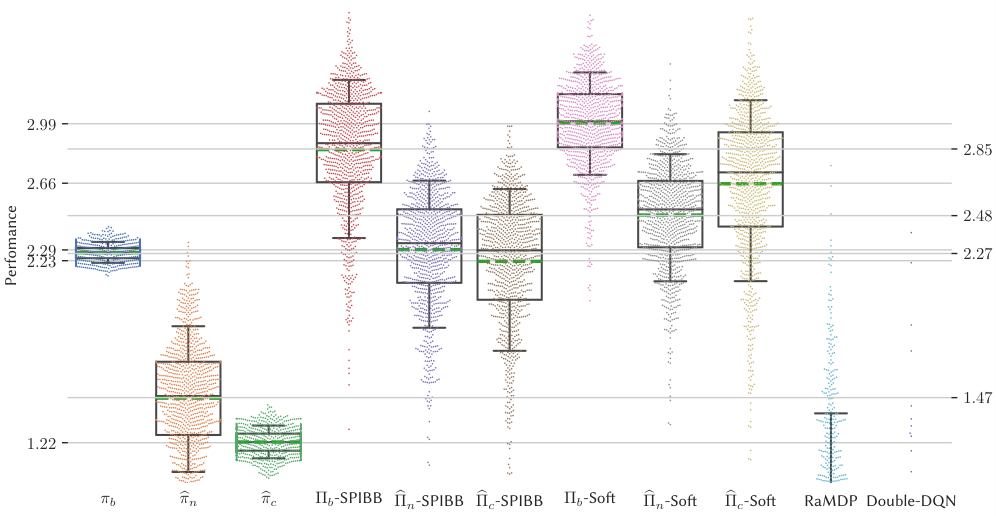
- 헬리콥터 조종 실험(데이터 3,000개의 작은 데이터셋)에서, "기준 전략을 추정한" 안전 학습 알고리즘은 기준 전략(평균 2.27)을 넘는 평균 성과 2.66을 냈고, 데이터가 적을수록 강한 면모를 보였습니다.
- 같은 조건에서 무리하게 학습한 알고리즘들은 무너졌습니다. 보상 조정 기반 알고리즘은 평균 0.37, 일반 심층강화학습은 −0.77로 처참했습니다. "무조건 잘하려 하기보다, 나빠지지 않는 것이 이긴다"는 교훈입니다.
- 놀라운 발견 하나: 추정된 기준 전략이 진짜 기준보다 결과가 살짝 더 좋은 경우가 있었습니다. 추정에 따른 흔들림이 가끔 더 좋은 행동을 더 자주 선택하게 만들고, 나빠질 때는 알고리즘이 그 길을 피한다는 분석입니다.
한계와 주의점
아직 남은 과제가 분명합니다. 추정 자체의 불확실성을 계산하는 알고리즘이 없고, 연속적인 행동 공간(예: 매매 수량을 연속으로 정하는 문제)이나 데이터가 순차적으로 쌓이는 환경은 다루지 않았습니다. 무엇보다 금융 데이터에서의 실증이 없어, 매매에 쓰려면 별도의 검증이 반드시 필요합니다. 좋은 소식은 코드가 공개되어 있어(재현성 68) 실험을 재현·확장할 수 있다는 점입니다.
이 테마의 공통 인사이트
이 달의 금융 AI는 두 갈래였습니다. 뉴스에서 회사들이 함께 언급되는 관계를 그래프로 학습해 주가를 예측한 Equity2Vec(1909.04497), 여러 인공지능 에이전트로 주문장의 가격 형성을 추론한 연구(1909.07748), 투자자 군집을 함께 학습한 연구(1909.05289)처럼 "관계를 학습하는 예측"이 하나라면, 다른 하나는 바로 이 "망가지지 않는 학습"입니다.
테마 5: 은퇴 자금은 혼자 굴리는 게 아니라 나눠서 굴려야 싸다
왜 흥미로운가
은퇴하면 자금을 어떻게 굴릴지 선택해야 합니다. ① 종신연금에 가입해 매달 일정액을 죽을 때까지 받거나, ② 개인 펀드로 직접 관리하거나, ③ 요즘 주목받는 방식 — 구성원 전체가 하나의 펀드를 함께 굴리고, 먼저 떠난 사람의 몫이 남은 사람들에게 돌아가는 구조(집단적 확정기여, CDC)입니다. 세 번째 방식이 왜 더 효율적일까요? 바로 위험 공유 덕분입니다. 혼자 투자하면 "너무 오래 살아 자금이 떨어지는 위험"을 혼자 감당하지만, 함께라면 그 위험을 나눌 수 있으니까요.
대표 논문: 공유 연금이 정확히 20% 더 싸다는 계산
다섯 번째 대표 논문(Collectivised Post-Retirement Investment)은 이 차이를 정확한 금액으로 계산했습니다. 영국 연금시장을 보정한 모형(주식 기대수익 연 8.2%, 국채 4.7%, 물가상승률 2%, 주식 변동성 15% — 1985년~2019년 실제 지수 데이터, 사망률은 공식 예측 모형)에서 세 가지를 비교했습니다.
무엇을 알아냈나
- 핵심 숫자: 초기 예산 126,636파운드(표에서는 126.6천 파운드 단위)를 굴렸을 때, 연금을 사면 126.6천 파운드 어치의 가치가 나오고(기준선 0%), 개인 펀드는 128.7천 파운드(+1.5%), 공유 펀드는 152.2천 파운드(+20%)가 나왔습니다. 반대로 말하면, 공유 펀드와 같은 결과를 내려면 연금이나 개인 운용은 초기자금이 약 20% 더 필요합니다.
- 소비 패턴도 다릅니다. 연금은 매달 똑같은 액수를 쓰지만, 공유 펀드는 시장 상황에 따라 쓰는 양이 조정됩니다. 그리고 흥미로운 관찰: 연금은 투자에서 완전히 조심스러우면서도 "일찍 돌아가시는 경우"의 위험은 무시하는 모순이 있습니다. 많은 은퇴자가 연금을 본능적으로 꺼리는 이유가 여기 있을 수 있다는 것입니다.
- 100명이면 충분했습니다. 나이·자산·성격이 다른 무작위 100명으로 구성된 펀드를 100만 번 시뮬레이션한 결과, 거의 모든 구성원이 "이론상 최대치의 98% 이상"을 얻었습니다. 아주 큰 펀드가 아니어도 위험 공유의 이득을 대부분 누릴 수 있다는 뜻입니다.
한계와 주의점
모형이 단순합니다. 미래 사망률을 정확히 안다고 가정했고(전염병 같은 '모두가 오래 사는' 위험은 제외), 유산을 남기고 싶은 마음도, 세제·제도 차이도 반영하지 않았습니다. 그리고 주식 기대수익 같은 값을 바꾸면 "개인 펀드 vs 연금"의 우열은 뒤집힐 수 있습니다(다만 공유 펀드의 우위는 유지된다고 논문은 보장합니다). 재현성 점수 42로 코드 공개는 없습니다.
이 테마의 공통 인사이트
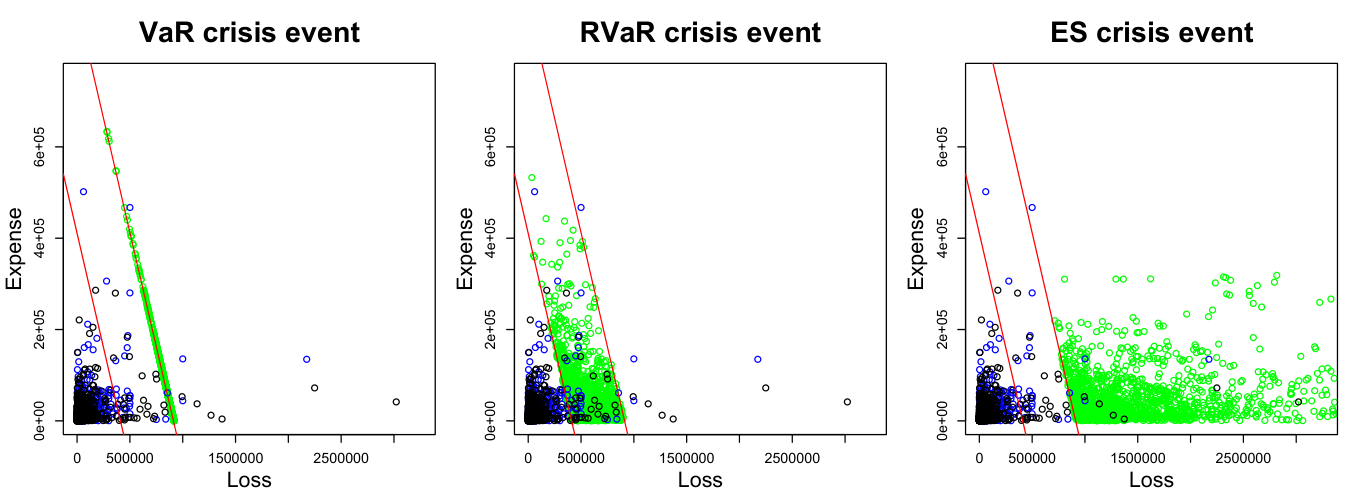
이 달의 포트폴리오·리스크 연구들 — 거래비용을 반영한 옵션 가격·헤지(1909.06260), 위기 시나리오에서의 시스템 리스크 배분(1909.11794), 평균회귀 전략의 실전 검증(1909.04327) — 은 모두 "개인이 혼자 감당하기 어려운 위험을 구조와 배분으로 다룬다"는 공통점이 있습니다. 그중 시스템 리스크 연구는 위기 시나리오 샘플링으로 리스크 배분을 계산하는 모습이 인상적입니다.
이 달 전체를 관통하는 메시지
2019년 9월의 연구들을 한 문장으로 요약하면 "모르는 것을 무시하지 않고 정량화하는 법"입니다. 모형이 틀릴 수 있는 모든 경우를 계산에 넣고(테마 1), 점프와 잡음이라는 보이지 않는 오염을 보정해 내며(테마 2), 유동성을 만드는 규칙 자체를 설계하고(테마 3), 학습 알고리즘에 '추락 금지' 하한을 걸고(테마 4), 개인이 혼자 감당할 수 없는 수명 위험을 나눕니다(테마 5). 서로 다른 분과의 논문들이지만 태도는 하나입니다 — 정확한 점 하나를 믿지 말고, 범위와 하한을 관리하자.
2026년 오늘 "신뢰구간", "강건 최적화", "안전한 오프라인 강화학습"이라는 말이 흔해졌지만, 그 문제들이 이렇게 선명하게 정의되어 있던 순간이 2019년 9월이었습니다. 시간을 되돌아보는 즐거움이 있는 달입니다.
더 알아보기
원문 링크와 5차원 평가 점수
이 글에서 다룬 논문들의 원문과, 우리 지식 베이스가 매긴 5차원 점수입니다(신규성 / 적용성 / 엄밀성 / 재현성 / 통찰, 종합점수는 이들의 가중 합).
| 논문 | 티어 | 종합 | 신규성 | 적용성 | 엄밀성 | 재현성 | 통찰 |
|---|---|---|---|---|---|---|---|
| 1909.03870 무차익 가격 범위 | A | 72.4 | 68 | 62 | 84 | 78 | 70 |
| 1909.12730 공유 연금 | A | 70.0 | 72 | 73 | 78 | 42 | 76 |
| 1909.04853 고빈도 변동성 추정 | A | 68.2 | 74 | 61 | 84 | 43 | 72 |
| 1909.07139 변동성면 적합 | A | 67.7 | 74 | 70 | 76 | 38 | 72 |
| 1909.01830 강건 포트폴리오 전략 | A | 66.1 | 68 | 56 | 83 | 45 | 72 |
| 1909.10187 SPX·VIX 동시 가격화 | B | 64.9 | 72 | 68 | 72 | 38 | 67 |
| 1909.00748 불확실성 하 청산 | B | 64.7 | 72 | 68 | 84 | 38 | 76 |
| 1909.09257 파생 거래소 설계 | B | 63.8 | 76 | 67 | 78 | 38 | 74 |
| 1909.11532 미국형 옵션 신경망 | B | 63.6 | 68 | 65 | 67 | 48 | 66 |
| 1909.05236 안전한 정책 개선 | B | 63.5 | 66 | 53 | 74 | 68 | 62 |
| 1909.10035 실현분산 예측 | B | 63.1 | 63 | 72 | 64 | 42 | 67 |
| 1909.13366 스마일 보정 | B | 62.9 | 72 | 64 | 68 | 38 | 67 |
| 1909.10807 수급 쏠림과 유동성 | B | 62.0 | 72 | 70 | 67 | 35 | 76 |
| 1909.10464 좋은 실행의 역학 | B | 61.0 | 68 | 62 | 75 | 42 | 70 |
| 1909.04497 Equity2Vec | B | 61.0 | 67 | 65 | 66 | 35 | 64 |
| 1909.09495 아이스버그 주문 탐지 | B | 60.6 | 62 | 78 | 55 | 38 | 68 |
우리 지식 베이스에서 함께 읽을 논문
- 무차익 가격·마팅게일 최적수송 계열: Martingale transport with homogeneous stock movements, Bid-Ask Martingale Optimal Transport, Deep calibration of (rough) stochastic volatility models
- 고빈도 변동성·미시구조 계열: Stochastic leverage effect in high-frequency data, Holistic multi-scale inference of the leverage effect
- 거래소·유동성 설계 계열: Optimal make take fees in a multi market maker environment, Automated Market Making and Loss-Versus-Rebalancing
- 안전한 강화학습 계열: FinRL-Meta: Market Environments and Benchmarks, CSPI-MT: Calibrated Safe Policy Improvement, JAX-LOB: A GPU-Accelerated limit order book simulator
- 공유 연금 계열: Collectivised Pension Investment with Homogeneous Epstein-Zin Preferences, Collectivised Pension Investment with Exponential Kihlstrom-Mirman Preferences, Optimal post-retirement investment under longevity risk
이 글은 2019년 9월 arXiv 백필 코호트(전체 155편, 관련 87편)의 평가 결과를 바탕으로 작성했습니다. 모든 수치는 원문 논문에서 인용했으며, 블로그 성격상 일부 이론적 세부사항은 생략했습니다. 심층 분석은
analysis/reports/backfill/1909.md를 참고하세요.
📚 이 글에서 다룬 논문 (43편)
- ARobust pricing and hedging of options on multiple assets and its numerics
Stephan Eckstein, Gaoyue Guo, Tongseok Lim 외 1명
- B
- ABayesian Inference on Volatility in the Presence of Infinite Jump Activity and Microstructure Noise
Qi Wang, José E. Figueroa-López, Todd Kuffner
- BAdditive normal tempered stable processes for equity derivatives and power law scaling
Michele Azzone, Roberto Baviera
- ARobust Utility Maximizing Strategies under Model Uncertainty and their Convergence
Jörn Sass, Dorothee Westphal
- BConsistent and Efficient Pricing of SPX and VIX Options under Multiscale Stochastic Volatility
Jaegi Jeon, Geonwoo Kim, Jeonggyu Huh
- APortfolio liquidation under factor uncertainty
Ulrich Horst, Xiaonyu Xia, Chao Zhou
- BHow to design a derivatives market?
Bastien Baldacci, Paul Jusselin, Mathieu Rosenbaum
- BSafe Policy Improvement with an Estimated Baseline Policy
Thiago D. Simão, Romain Laroche, Rémi Tachet des Combes
- BUsing Machine Learning to Predict Realized Variance
Peter Carr, Liuren Wu, Zhibai Zhang
- BUnveiling the relation between herding and liquidity with trader lead-lag networks
Carlo Campajola, Fabrizio Lillo, Daniele Tantari
- BEquilibrium concepts for time-inconsistent stopping problems in continuous time
Erhan Bayraktar, Jingjie Zhang, Zhou Zhou
- AMechanics of good trade execution in the framework of linear temporary market impact
Claudio Bellani, Damiano Brigo
- BEquity2Vec: End-to-end Deep Learning Framework for Cross-sectional Asset Pricing
Qiong Wu, Christopher G. Brinton, Zheng Zhang 외 3명
- B
- ARobust no arbitrage and the solvability of vector-valued utility maximization problems
Andreas H Hamel, Birgit Rudloff, Zhou Zhou
- BStock market microstructure inference via multi-agent reinforcement learning
J. Lussange, I. Lazarevich, S. Bourgeois-Gironde 외 2명
- BExploring Graph Neural Networks for Stock Market Predictions with Rolling Window Analysis
Daiki Matsunaga, Toyotaro Suzumura, Toshihiro Takahashi
- BDeep Prediction of Investor Interest: a Supervised Clustering Approach
Baptiste Barreau, Laurent Carlier, Damien Challet
- BMarkov Chain Monte Carlo Methods for Estimating Systemic Risk Allocations
Takaaki Koike, Marius Hofert
- BAn arbitrage-free conic martingale model with application to credit risk
Cheikh Mbaye, Frédéric Vrins
- BWATTNet: Learning to Trade FX via Hierarchical Spatio-Temporal Representation of Highly Multivariate Time Series
Michael Poli, Jinkyoo Park, Ilija Ilievski
- BEmpirical investigation of state-of-the-art mean reversion strategies for equity markets
Seung-Hyun Moon, Yong-Hyuk Kim, Byung-Ro Moon
- BArbitrage-free modeling under Knightian Uncertainty
Matteo Burzoni, Marco Maggis
- AMartingale transport with homogeneous stock movements
Stephan Eckstein, Michael Kupper
- ABid--Ask Martingale Optimal Transport
Bryan Liang, Marcel Nutz, Shunan Sheng 외 1명
- AApproximation Rates for Deep Calibration of (Rough) Stochastic Volatility Models
Francesca Biagini, Lukas Gonon, Niklas Walter
- AStochastic leverage effect in high-frequency data: a Fourier based analysis
Imma Valentina Curato, Simona Sanfelici
- BHolistic Multi-Scale Inference of the Leverage Effect: Efficiency under Dependent Microstructure Noise
Ziyang Xiong, Zhao Chen, Christina Dan Wang
- BOptimal make take fees in a multi market maker environment
Bastien Baldacci, Dylan Possamaï, Mathieu Rosenbaum
- AAutomated Market Making and Loss-Versus-Rebalancing
Jason Milionis, Ciamac C. Moallemi, Tim Roughgarden 외 1명
- AFinRL-Meta: Market Environments and Benchmarks for Data-Driven Financial Reinforcement Learning
Xiao-Yang Liu, Ziyi Xia, Jingyang Rui 외 6명
- BCSPI-MT: Calibrated Safe Policy Improvement with Multiple Testing for Threshold Policies
Brian M Cho, Ana-Roxana Pop, Kyra Gan 외 4명
- AJAX-LOB: A GPU-Accelerated limit order book simulator to unlock large scale reinforcement learning for trading
Sascha Frey, Kang Li, Peer Nagy 외 5명
- BCollectivised Pension Investment with Homogeneous Epstein-Zin Preferences
John Armstrong, Cristin Buescu
- BCollectivised Pension Investment with Exponential Kihlstrom--Mirman Preferences
John Armstrong, Cristin Buescu
- BOptimal post-retirement investment under longevity risk in collective funds
John Armstrong, Cristin Buescu, James Dalby
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2026-09 월간
2026년 9월의 금융 AI 연구: 측정이 통념을 뒤집고, 검증이 창의성을 압도하다
2026년 9월 arXiv에 공개된 금융 AI 연구를 5개 테마로 정리했습니다. 1년치 CME 실측 데이터로 HFT 설계 원칙을 뒤집은 S티어 논문, 수천 개 LLM 에이전트의 프로덕션 현실, anytime-valid 심판으로 팩터 거짓발견을 5~11배 줄이는 방법, 매직 스트라이크로 분산 계약을 정밀 산정하는 수학, drawdown을 강건하게 제어하는 포트폴리오 이론까지 — 측정과 검증이 창의성을 압도하는 달이었습니다.
 📊 2026-08 월간
2026년 8월의 금융 AI 연구: 이론과 실전의 간극이 좁혀지는 달
2026년 8월 arXiv에 공개된 금융 AI 연구를 4개 테마로 정리했습니다. 포트폴리오 최적화의 실전화, LLM 에이전트 벤치마크 전쟁, 변동성 표면의 수학적 통일, 뉴스 NLP의 시간 누수 감사 — 이론이 실제로 작동하는 도구로 변하는 순간을 포착했습니다.
 📊 2026-07 월간
7월의 AI 투자 연구: 더 큰 모델이 정답이 아니다
2026년 7월 시스템 트레이딩 연구 동향. LLM 에이전트 비용 최적화, DEX 라우팅 $2,400만 손실 계량화, 추세추종의 주파수 영역 해석, 포트폴리오 분포 불확실성 강건 최적화, 시계열 부트스트랩 실용화.