
매달 arXiv에 쏟아지는 금융 AI 논문 중에서 의미 있는 연구를 골라 정리합니다. 이번에는 2019년 8월입니다. 이 달의 연구들을 읽다 보면 하나의 패턴이 보입니다. 연구자들이 "교과서가 가정한 이상적인 세계"에서 "실제 시장이 겪는 마찰"로 한 걸음씩 걸어 나오고 있다는 것. 그 마찰의 이름은 다름 아니라 추정 오차, 유동성 부족, 그리고 지연 시간이었습니다.
들어가며: 완벽한 계획이 실전에서 흔들리는 이유
모의 투자 대회에서 좋은 성적을 낸 전략이 실제 돈을 넣으면 잘 안 되는 경우를 종종 봤을 겁니다. 왜 그럴까요? 보통은 세 가지가 빠져 있어서입니다.
- "내가 계산한 최적 포트폴리오" 자체가 틀릴 수 있다. 필요한 숫자(수익률 기대치, 리스크)를 전부 정확히 아는 게 아니라 몇 달치 데이터로 어림잡아 계산하니까요.
- 사고 싶을 때 팔리는 게 아니다. 특히 전력처럼 거래가 거의 없는 시장에서는 "팔 사람"이 아예 없을 수 있습니다.
- 주문을 보내는 동안 시장은 계속 움직인다. 내가 보고 누른 가격과 실제 체결 가격이 다를 수 있습니다.
2019년 8월의 논문들은 이 세 가지를 각각 정면으로 다룹니다. 낯설게 느껴지는 용어는 최대한 쉬운 비유로 풀어 갈게요.
테마 1: "최적 포트폴리오"는 얼마나 틀릴 수 있는가
왜 흥미로운가
맛집을 찾을 때 리뷰 평점 4.5점짜리 식당과 4.4점짜리 식당 중 어디를 갈까요? 사실 이 두 평점은 리뷰가 몇 개 안 되면 통계적으로 구분할 수 없을 수도 있습니다. "4.5가 더 좋다"고 단정하기에는 오차가 너무 큰 거죠.
포트폴리오 최적화도 똑같습니다. "이 조합이 가장 좋다"고 계산기(수학 모형)가 대답해도, 그 계산에 들어간 숫자들은 전부 추정치입니다. 그러면 결과인 '최적 포트폴리오'도 흔들리게 마련이죠. 그런데 이상하게도, 이 흔들림의 크기를 정확히 알려 주는 이론이 오랫동안 부족했습니다.
대표 논문: 최적 포트폴리오의 "오차 범위"를 공식으로 만들다
이 달의 첫 번째 대표 논문(Sampling Distributions of Optimal Portfolio Weights and Characteristics in Low and Large Dimensions)은 바로 이 "흔들림의 크기"를 수학적으로 정확히 계산합니다.
쉽게 말하면 이런 일입니다. 데이터 몇 개로 뽑은 최적 포트폴리오가, "진짜 최적"에서 얼마나 떨어져 있을지의 분포(가능성의 지도)를 공식으로 만든 거예요. 그리고 이 공식 덕분에 "이 포트폴리오의 진짜 리스크는 95% 확률로 이 범위 안이다" 같은 말이 가능해집니다. 게다가 이 방법은 매번 큰 계산(공분산행렬 역행렬 같은)을 반복하지 않아도 되어서 빠르고, 주식이 수백 개인 '고차원' 환경에서도 성립합니다.
무엇을 알아냈나
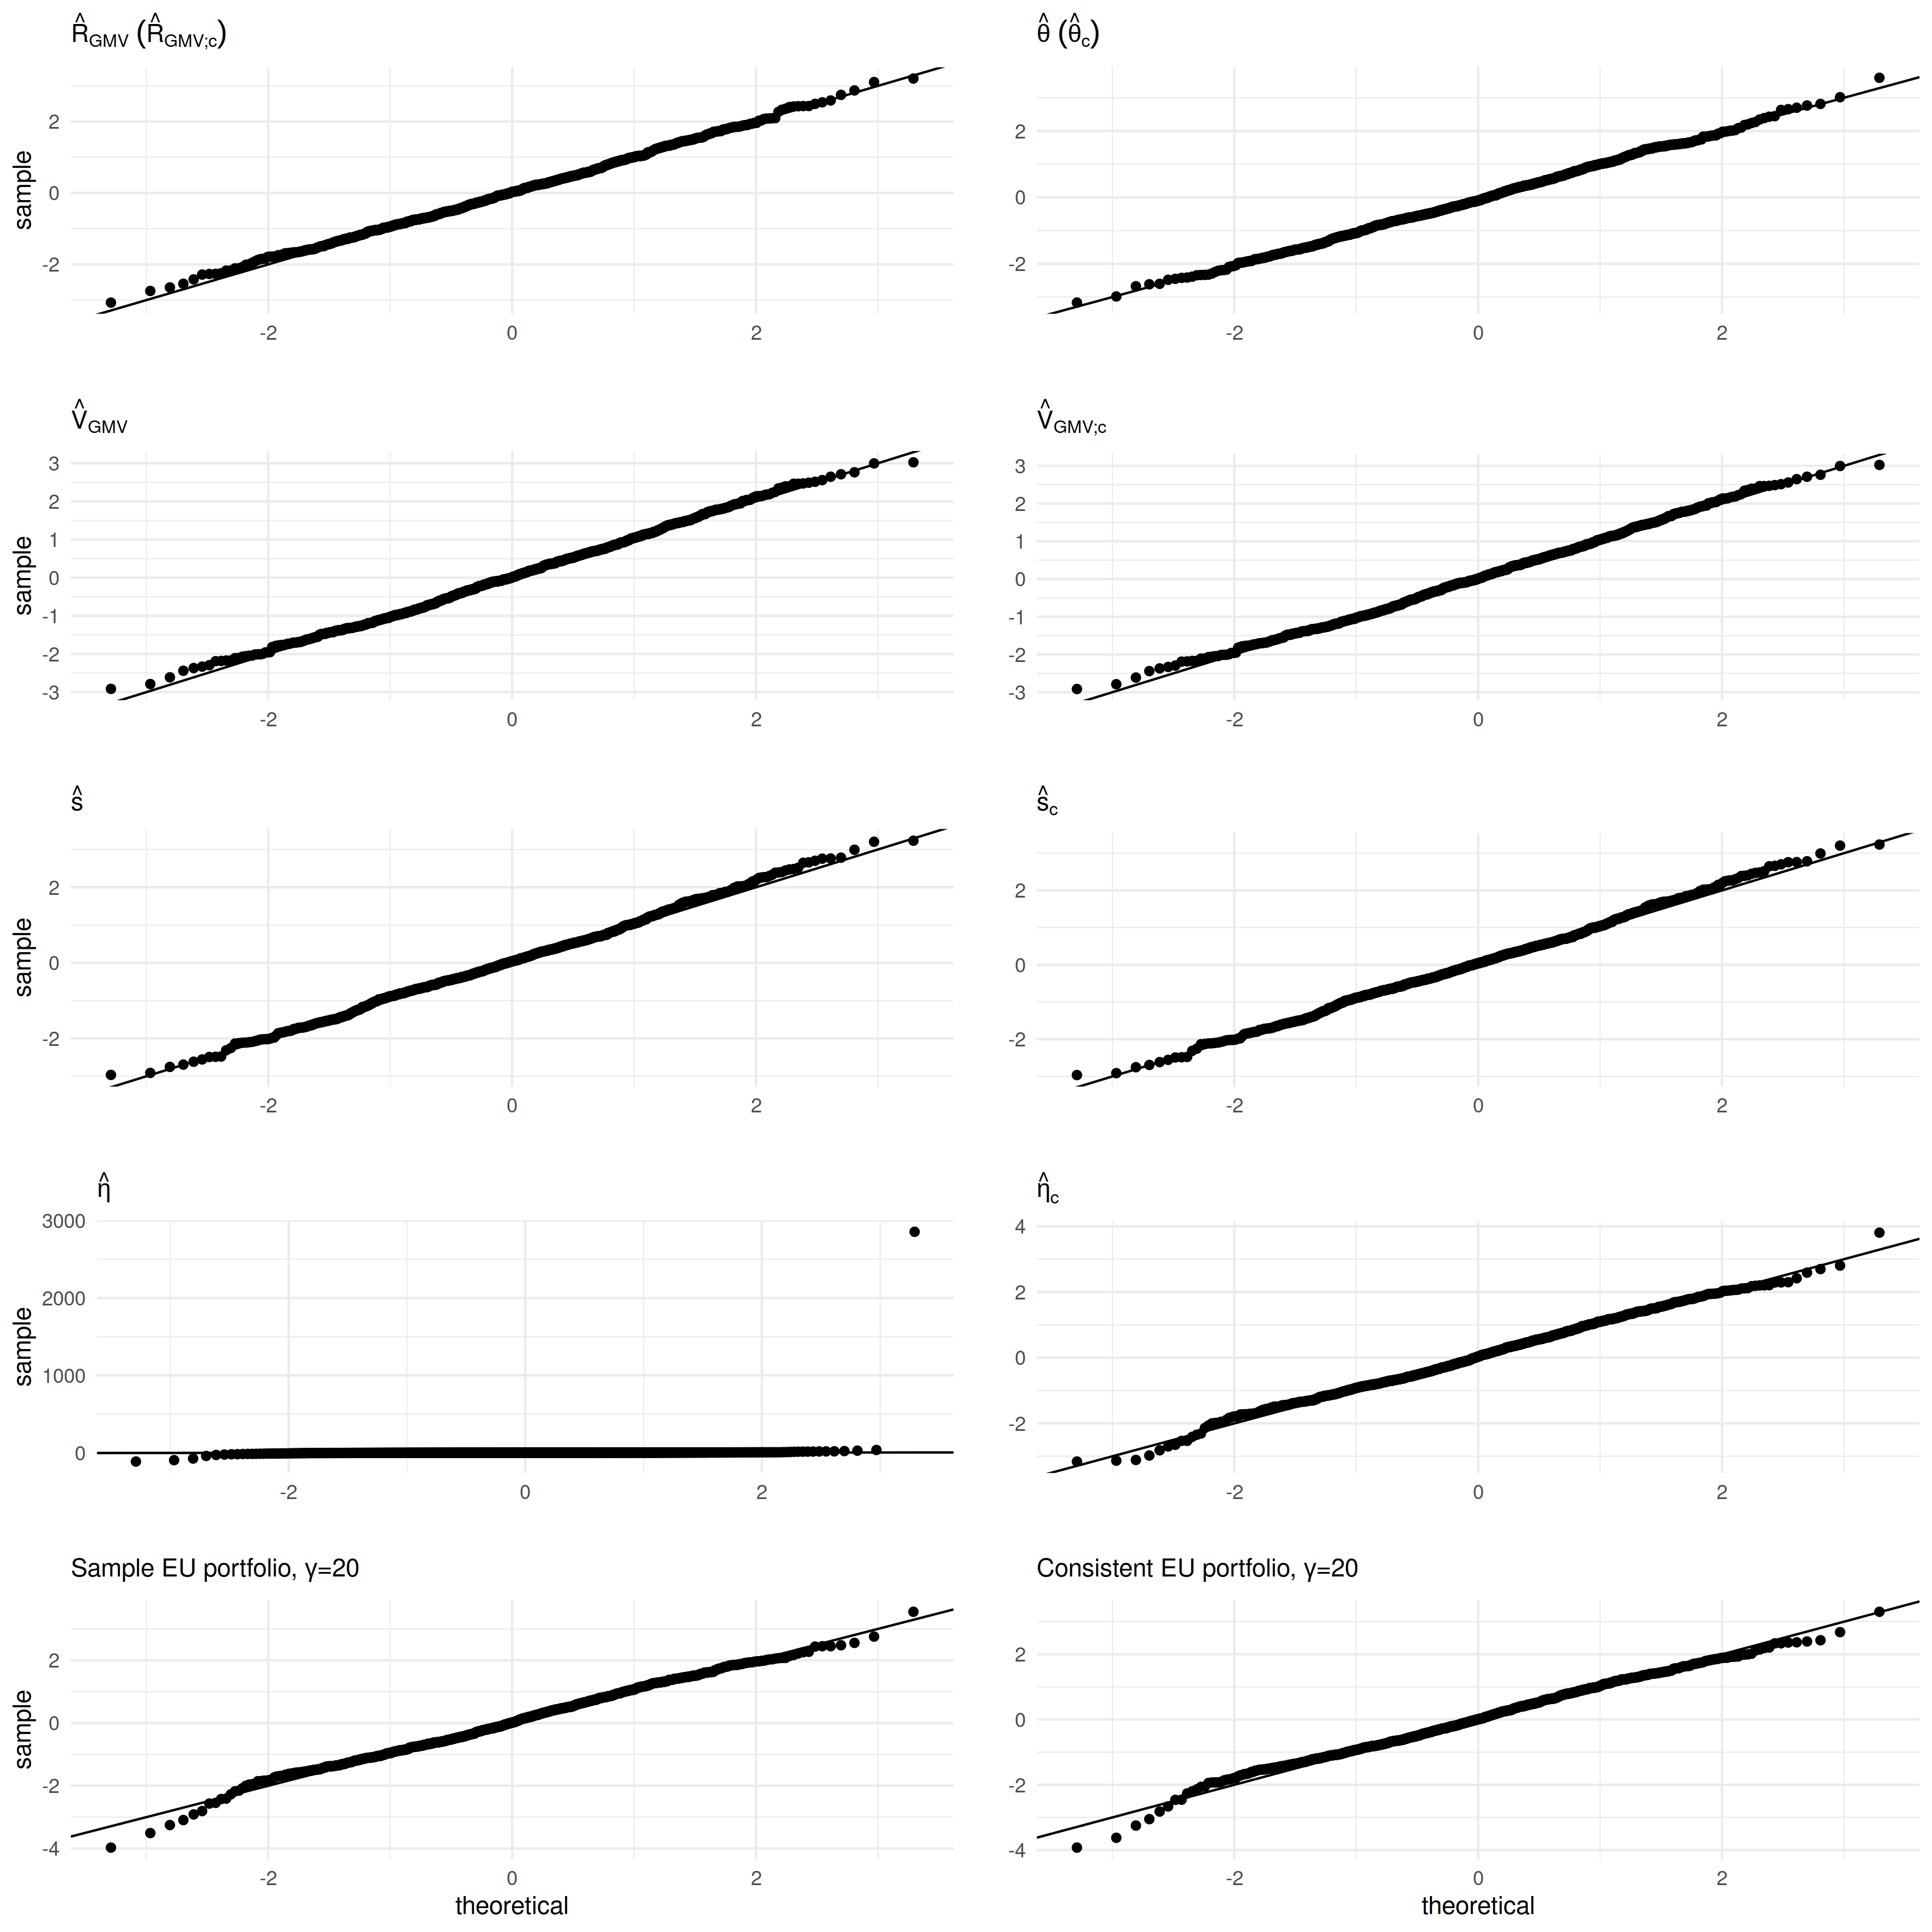
- 컴퓨터 실험(모의 데이터 1,000개 기준)에서 이론이 예측한 분포와 실제 분포가 잘 맞았습니다. 조건이 까다로워져도 말이죠.
- 데이터가 '정규 분포'를 벗어나(극단값이 많은 두꺼운 꼬리) 일부 추정량에서 오차가 생기긴 했지만, 개선된 추정법을 쓰면 대부분 사라졌습니다.
- 주식 수익률 간의 의존성이 있어도(제곱수익률의 자기상관) 큰 영향은 없었습니다.
한계와 주의점
정직하게 말하면 두 가지가 있습니다. 첫째, 논문의 이론은 "주식 수익률이 독립이고 정규 분포"라는 가정 위에 서 있는데, 논문 스스로 하루 단위 이상의 고빈도 데이터에는 맞지 않는다고 인정합니다. 둘째, 2023년에 이 논문의 정리(statement) 일부에 오류가 발견되어 정오표가 발표되었습니다 (수학자들이 지적해서 수정됐습니다). 결과의 큰 방향은 유지되지만, "이론 논문의 공식을 그대로 신뢰하기 어렵다"는 교훈을 주는 사례입니다.
이 테마의 공통 인사이트
이 달 포트폴리오 연구들은 한목소리로 말합니다. "정답을 구하려 하지 말고, 정답의 불확실성을 관리하라." 낙폭(자산이 하락한 폭)을 직접 줄이는 최적화(1908.08684), 계수가 과도하게 줄어드는 문제를 고친 자산배분(1908.04697), 데이터가 틀릴 경우를 대비한 강건한 지수 추종(1908.07659), 옵션 투자 매력도를 하나의 숫자로 비교하는 '내재 샤프 비율'(1908.04837), 그리고 "강건화가 정말로 도움이 되나"를 시장 데이터로 검증한 연구(1908.05002)까지 — 모두 '추정 오차라는 현실'을 다루는 다양한 방법이었습니다.
테마 2: 전력처럼 팔기 어려운 것을, 어떻게 헤지할까
왜 흥미로운가
전력은 참 특별한 상품입니다. 저장이 안 되거든요. 냉장고에 전기를 쟁여 둘 수 없으니, 수요와 공급이 맞는 순간에만 거래됩니다. 게다가 "3년 후의 전력" 같은 장기 계약은 거래소에 상장조차 되어 있지 않습니다. 소수의 에너지 회사들끼리 장외에서만 주고받죠.
이런 시장에서 "내년에 전기를 대량으로 사기로 한 회사"는 큰 걱정이 있습니다. 지금 가격을 잠그고 싶은데, 거래할 상대가 거의 없어서 대신 쓸 수 있는 건 이미 활발히 거래되는 '가까운 만기' 계약뿐입니다. 가까운 계약만으로 3년 뒤의 위험을 감당하려면 어떻게 해야 할까요?
대표 논문: 유동성 있는 계약만으로 장기 위험을 줄이는 법
이 달의 두 번째 대표 논문(A multi-factor polynomial framework for long-term electricity forwards with delivery period)은 두 가지를 한 번에 해결합니다. 장기 전력 계약의 가격을 빠르고 정확하게 계산하는 모형, 그리고 유동성이 있는 근월 계약만으로 장기 노출을 줄이는 롤링 헤지(계속 갈아타며 위험을 줄이는 전략)입니다.
비유하자면, 3년 뒤 여름휴가 비용을 걱정하면서 당장은 '매달 저축'으로 대비하는 것과 비슷합니다. 지금 당장 3년치를 한꺼번에 준비할 수 없으니, 가까운 시점의 계약을 조금씩 이어 가며 위험을 나눠 갖는 거죠.
무엇을 알아냈나
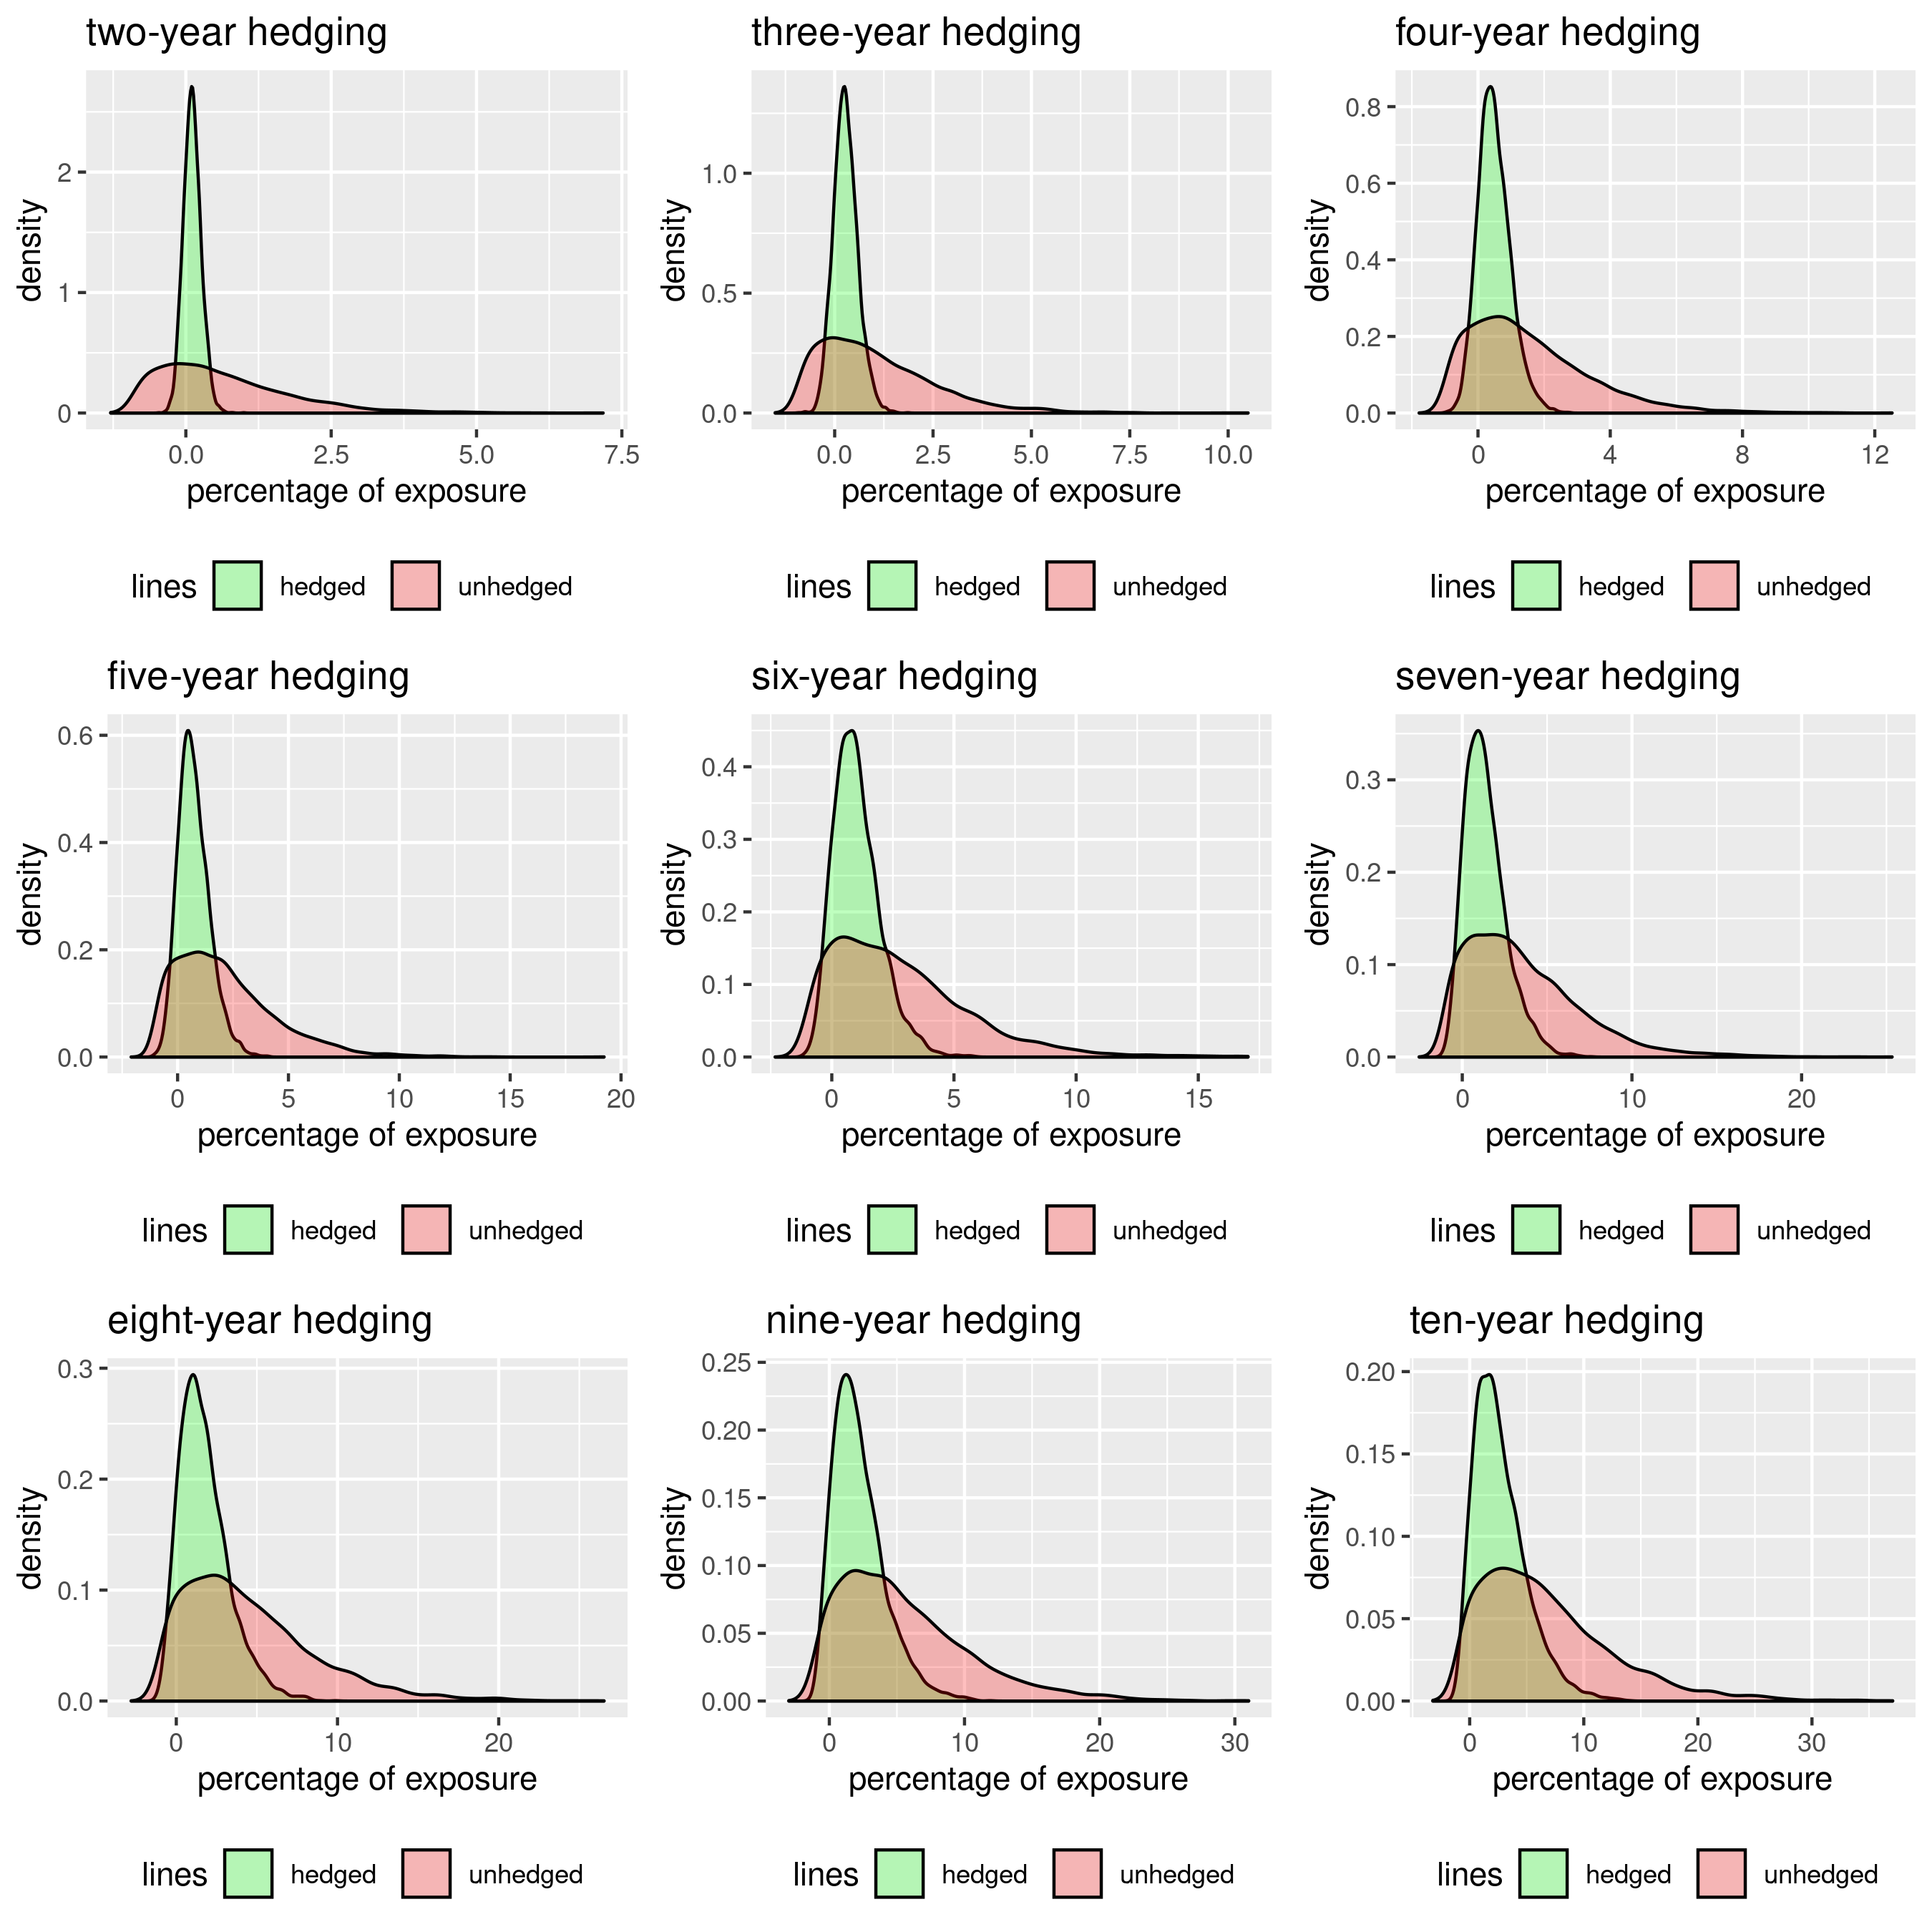
독일 전력 시장의 실제 데이터(2010년 1월~2018년 4월, 월별 호가)로 모형을 맞춘 뒤, 컴퓨터로 전력 가격의 미래 경로 5,000개를 만들어 헤지 성능을 측정했습니다. 결과는 인상적입니다.
| 위험을 감수하는 기간 | 헤지했을 때 흔들림(표준편차) | 아무것도 안 했을 때 |
|---|---|---|
| 2년 | 0.1532 | 1.1278 |
| 5년 | 0.7125 | 2.2762 |
| 10년 | 2.2982 | 5.7729 |
2년 뒤를 준비하는 경우, 헤지를 하면 위험의 흔들림이 약 7분의 1로 줄어듭니다. 다만 정직하게 말하면 완전히 없어지는 건 아닙니다. 10년 뒤를 준비하는 경우에도 상당한 흔들림(2.2982)이 남죠. "헤지는 위험을 크게 줄이지만 마법이 아니다"가 이 연구의 결론에 가깝습니다.
한계와 주의점
이 연구는 전력 회사와 공동으로 진행해 실제 산업 데이터를 썼지만, 그래서 그 데이터는 공개되어 있지 않고 코드도 없습니다. 숫자를 직접 재현하려면 상당한 구현 노력이 필요합니다. 또 헤지 비율 계산이 시장의 '위험 가격' 추정에 의존합니다.
이 테마의 공통 인사이트
이 달의 파생·변동성 연구들은 전부 같은 고민을 합니다. "현실의 불편함(저장 불가, 가격 급등, 유동성 부족)을 수학에 넣고도 계산이 가능하게 유지하라." 금리 곡선의 가능한 모양을 전부 분류한 연구(1908.04667), 폭발하지 않는 변동성 모형(1908.07417), 인공지능으로 모형 보정을 빠르게 하는 방법(1908.08806), 에너지 가격의 급등을 빠르게 시뮬레이션하는 기법(1908.03137), 환율 옵션 가격의 근사 공식(1908.09640)이 모두 이 흐름에 있습니다.
테마 3: 주문을 보내는 그 짧은 사이에 벌어지는 일
왜 흥미로운가
온라인 쇼핑에서 '구매' 버튼을 누르는 순간과 실제로 결제가 되는 순간 사이에, 가격이 바뀌어 버리는 일이 있다고 상상해 보세요. 주가를 보고 "지금 5만 원에 사자"고 누르는데, 주문이 도착했을 때는 이미 상황이 달라져 있는 겁니다. 내가 보던 매물이 사라졌거나, 남은 매물이 더 비쌀 수 있죠.
전자 거래에서는 이 시간차(latency)가 초 단위가 아니라 천분의 일 초 단위로 문제를 만듭니다. 시장을 빠르게 읽어 주문을 보내는 사람조차도, 주문이 날아가는 동안 움직이는 '호가창'이라는 과녁을 정확히 맞히지 못할 수 있습니다.
대표 논문: "얼마나 비싸게까지 체결시킬 것인가"의 최적해
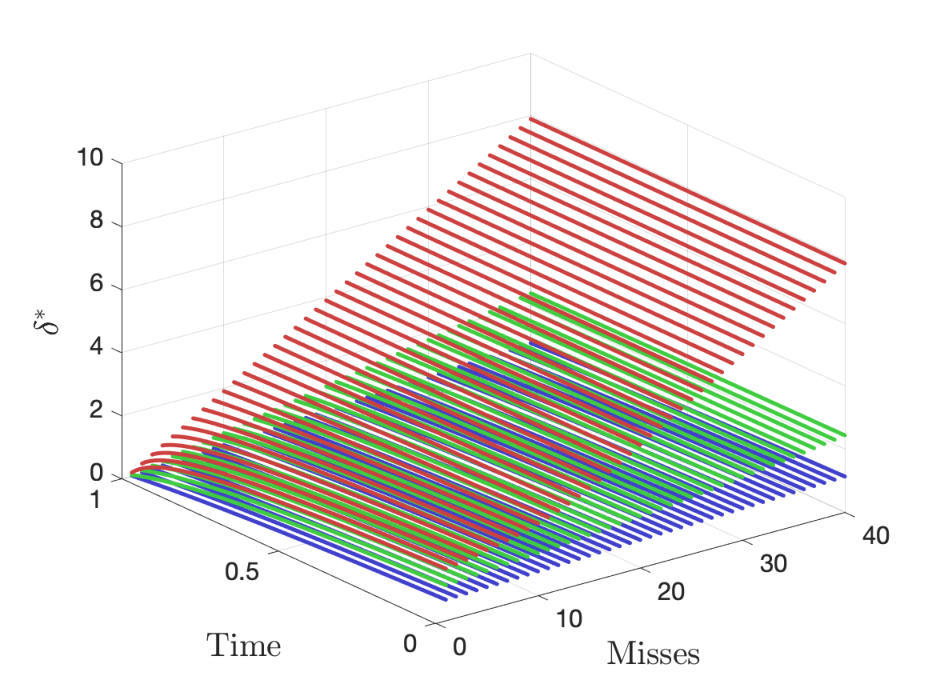
세 번째 대표 논문(Latency and Liquidity Risk)은 이 문제를 깔끔하게 수학 문제로 바꿉니다. 주문에 가격 한도를 정해 두면, 그 한도 안에서만 체결이 일어납니다. 한도를 촘촘히 잡으면 원하는 가격을 지키지만 주문이 아예 체결 안 될 확률이 올라가고, 한도를 넉넉히 잡으면 체결은 잘 되지만 더 비싸게 사게 됩니다. 이 둘의 균형점을 찾는 것이 이 논문의 목표입니다.
무엇을 알아냈나
컴퓨터 시뮬레이션 1만 회로 전략을 검증했습니다. 눈에 띄는 숫자들이 있습니다.
- 주문을 '무조건 원하는 가격에만' 보내는 순진한 전략은 주문의 57.97%를 놓칩니다. 거의 절반이 넘죠.
- 논문이 찾은 최적 전략 중 하나는 '호가창을 걷는 추가 비용이 정확히 0'이 되는 지점인데, 이때 놓치는 주문 비율은 10.48%로 크게 줄어듭니다.
- "놓치는 주문을 10% 미만으로, 그것도 95% 확률로 유지한다"는 같은 목표를 놓고 비교하면, 상황에 따라 허용 범위를 조절하는 적응형 전략이 고정 전략보다 기대 비용이 약 38% 낮았습니다(5.93 대 9.52).
한마디로, "체결을 얼마나 포기할지"에 대한 가격표를 매기는 셈인데, 그 가격표를 상황에 따라 조절하는 편이 낫다는 뜻입니다.
한계와 주의점
이 결과는 실제 거래 데이터가 아니라 이론 모형 위의 시뮬레이션입니다. 재현성 점수가 낮고(코드 미공개), 주문 충격이 단순한 확률 분포를 따른다고 가정합니다. 실전 적용 전에는 반드시 자기 거래 데이터로 검증해야 합니다.
이 테마의 공통 인사이트
이 달 미시구조 연구들은 한목소리로 말합니다. "체결을 당연하게 여기지 마라." 거래량·스프레드·호가 잔량으로 초단기 변동성을 추정하는 '시장 불변량'(1908.02847), 시장조성자가 정보 이점을 갖는 현실을 모형화한 연구(1908.08777), 초고빈도 거래의 가격 틱을 모델링한 연구(1908.05089), 그리고 거래 자체가 시장에 영향을 주는 상황에서의 헤지(1908.00054)까지 — 모두 '주문과 체결 사이의 틈'을 다룹니다.
테마 4: 금융 뉴스를 읽는 인공지능, FinBERT
왜 흥미로운가
"이 회사 실적이 개선되었다"와 "부채가 개선되었다" — 금융 뉴스의 한 단어는 문맥에 따라 전혀 다른 뜻이 됩니다. 게다가 금융 문서에는 '유동성 비율', '어닝 서프라이즈' 같은 전문 용어가 가득합니다. 이런 문장을 사람처럼 읽어 긍정/부정을 판별하려면, 일반적인 한국어·영어 사전으로는 부족합니다.
반면 금융 문장에 '긍정/부정' 표지를 붙인 데이터는 만들기 비쌉니다. 전문가가 붙여야 하거든요. 라벨은 적고, 언어는 어려운 상황. 2019년, 이 문제에 '사전학습된 언어모델'이라는 새로운 해법이 도착합니다.
대표 논문: FinBERT — 금융에 맞게 다시 공부한 언어모델
네 번째 대표 논문(FinBERT: Financial Sentiment Analysis with Pre-trained Language Models)의 아이디어는 단순합니다. 방대한 일반 텍스트로 '언어'를 먼저 배운 모델(BERT)에, 금융 문서로 한 번 더 공부를 시킨 뒤(사전학습), 소량의 금융 감성 데이터로 미세조정하는 거죠. 시험을 치르기 전에 교과서를 한 번 더 읽고 들어가는 셈입니다.
무엇을 알아냈나
- 금융 문장 데이터셋(Financial PhraseBank, 문장 4,845개)에서 FinBERT는 정확도 86%, F1 점수 0.84로, 이전 최고 방법들(ULMFit 83%, 단순 신경망 71%)을 모두 앞섰습니다. 주석자들이 100% 동의한 명확한 문장만 보면 정확도 97%에 이릅니다.
- 감성 '점수'를 매기는 과제(FiQA 데이터, 뉴스·트윗 1,174건)에서도 오차(MSE) 0.07, 설명력(R²) 0.55로 이전 최고(각각 0.08/0.40, 0.09/0.41)를 넘었습니다. 다만 비교 대상들은 공식 시험 데이터셋, FinBERT는 자체 교차검증이라 조건이 다르다는 점을 논문 스스로 밝히고 있습니다.
- 라벨이 250개만 있어도 정확도 약 80%에 도달했습니다. 라벨이 부족한 환경에서 사전학습의 힘이 크다는 뜻입니다.
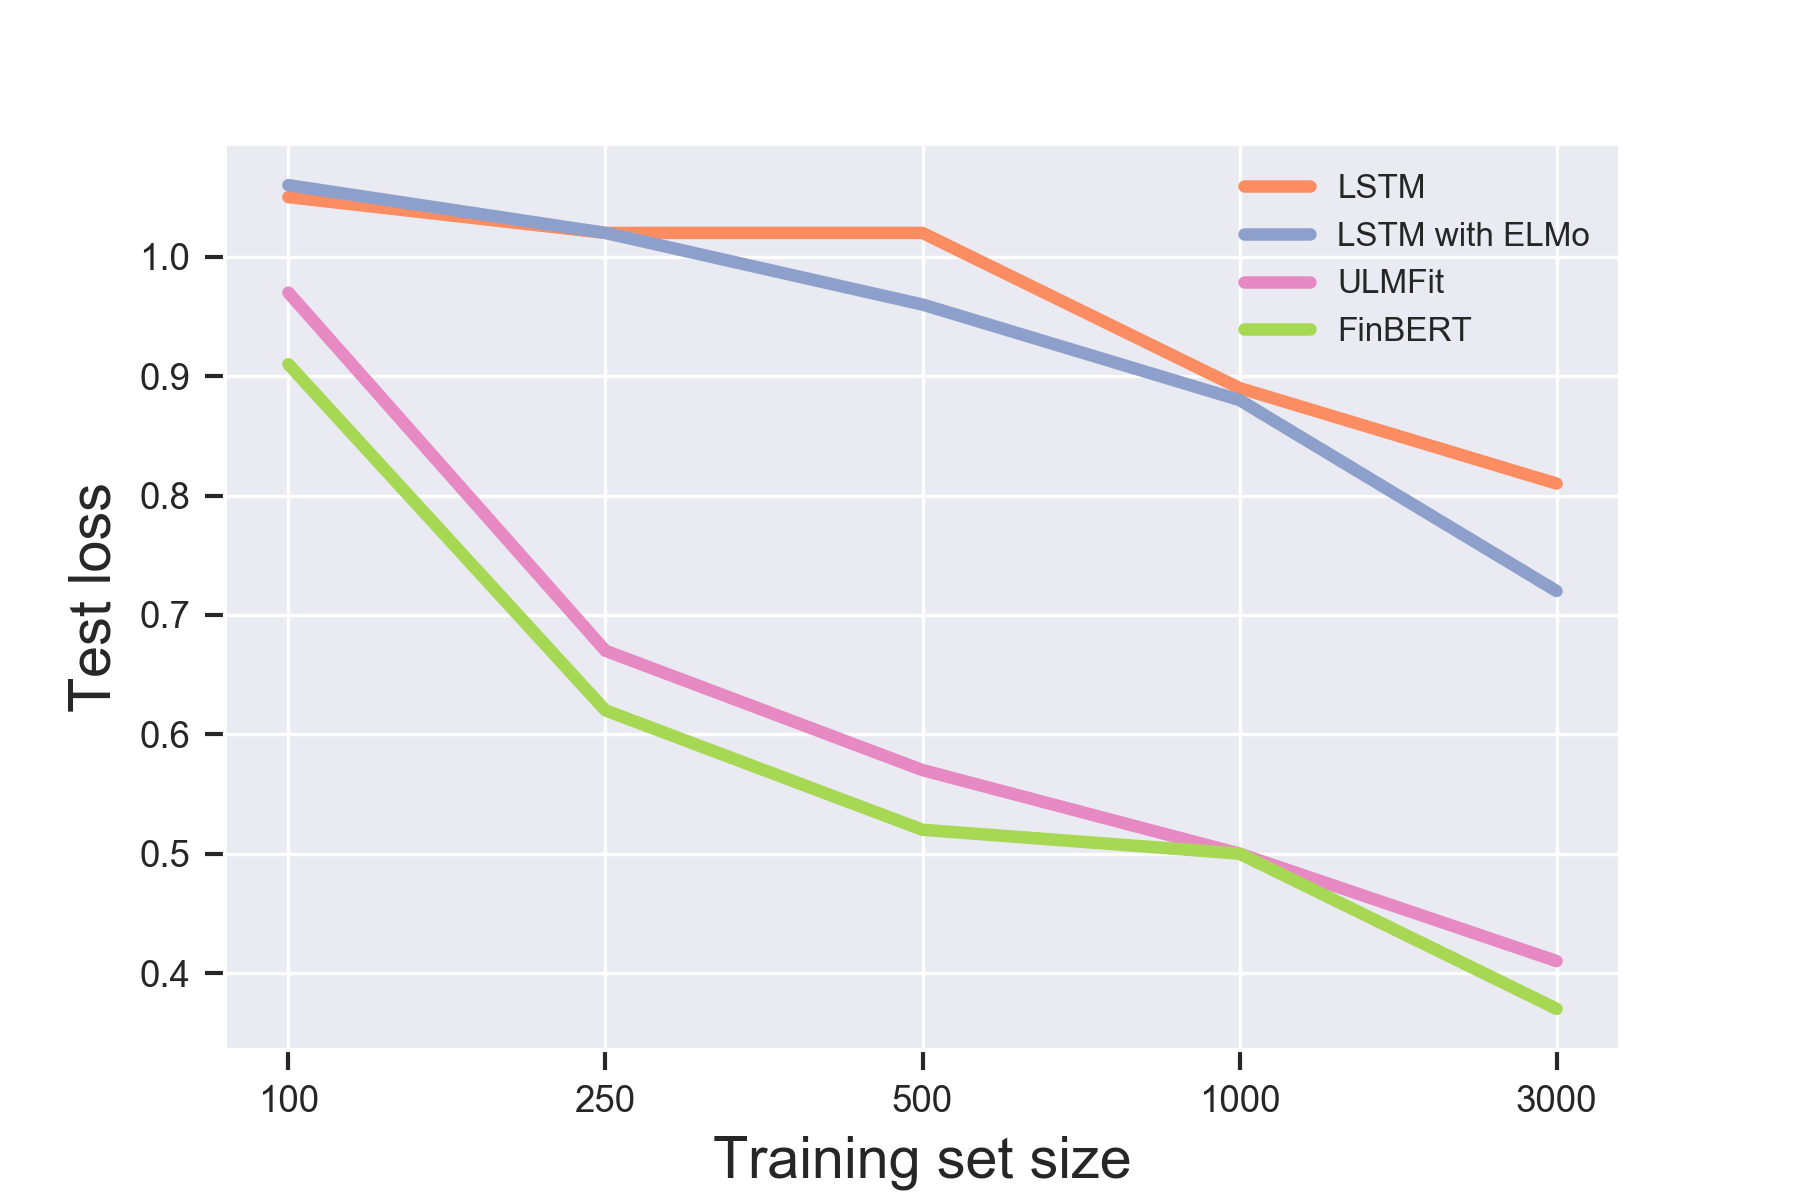
흥미로운 사실 하나: 논문은 '금융 데이터 추가 공부'의 효과가 생각보다 크지 않았다고 정직하게 보고합니다(85% → 86%). 이미 성능이 한계에 근접했기 때문일 수 있다는 분석입니다. 오히려 학습을 서서히 풀어 주는 기법(점진적 해제)이 과적합 방지에 핵심이었다고 합니다.
한계와 주의점
이 논문은 석사 학위 논문 기반이라 동료심사 논문이 아닙니다. 그리고 무엇보다, 감성 분류를 잘한다는 것과 투자 수익이 난다는 것은 별개 문제입니다. 한국어 공시·뉴스에 쓰려면 재학습과 별도의 실증 검증이 반드시 필요합니다.
이 테마의 공통 인사이트
2019년 8월의 금융 AI는 대체로 '새 도구 발명'이 아니라 범용 AI의 금융 이식이었습니다. 기업 관계 그래프로 주가 방향을 예측한 연구(1908.07999), 비트코인 거래 그래프로 자금세탁을 잡아내려 한 연구(1908.02591), 시장이 변하면 전략 설정을 자동으로 다시 맞추는 연구(1908.08258)가 모두 같은 정신 — "있는 기술을 금융의 현실에 맞게 고쳐 쓰기" — 을 공유합니다.
이 달 전체를 관통하는 메시지
2019년 8월의 연구들을 한 문장으로 요약하면 "모형 밖의 마찰을 모형 안으로 들여오기"입니다. 포트폴리오의 '정답'이 품은 불확실성을 계산하고(테마 1), 거래가 거의 없는 시장의 현실을 헤지 설계에 반영하고(테마 2), 주문이 날아가는 짧은 순간의 리스크를 가격표로 만들고(테마 3), 금융의 특수한 언어를 인공지능에게 가르쳤습니다(테마 4).
오늘날 화려한 AI 트레이딩 이야기들이 결국 부딪히게 되는 문제 — "추정한 게 맞나?", "이만큼 팔 수 있나?", "체결이 되긴 하나?", "뉴스를 제대로 읽었나?" — 가 2019년 8월에 이미 이렇게 선명하게 정의되어 있었다는 점이, 시간을 되돌아보는 즐거움입니다.
더 알아보기
원문 링크와 5차원 평가 점수
이 글에서 다룬 논문들의 원문과, 우리 지식 베이스가 매긴 5차원 점수입니다(신규성 / 적용성 / 엄밀성 / 재현성 / 통찰, 종합점수는 이들의 가중 합).
| 논문 | 티어 | 종합 | 신규성 | 적용성 | 엄밀성 | 재현성 | 통찰 |
|---|---|---|---|---|---|---|---|
| 1908.08954 전력 선도 롤링 헤지 | A | 71.3 | 68 | 76 | 82 | 48 | 72 |
| 1908.04243 포트폴리오 표본분포 | A | 71.0 | 72 | 68 | 85 | 45 | 76 |
| 1908.03281 지연 리스크 | A | 66.2 | 72 | 76 | 82 | 38 | 72 |
| 1908.00054 비거래위험 헤지 | B | 63.8 | 73 | 65 | 79 | 43 | 72 |
| 1908.04667 금리 곡선 분류 | B | 63.6 | 73 | 35 | 91 | 48 | 70 |
| 1908.10063 FinBERT | B | 63.1 | 72 | 58 | 64 | 48 | 69 |
| 1908.07417 변동성 모형 | B | 62.1 | 67 | 48 | 83 | 38 | 68 |
| 1908.07999 HATS 그래프 어텐션 | B | 61.2 | 63 | 55 | 55 | 75 | 61 |
| 1908.07659 강건 지수 추종 | B | 60.1 | 66 | 65 | 61 | 38 | 65 |
| 1908.04837 내재 샤프 비율 | B | 60.0 | 68 | 67 | 58 | 30 | 70 |
| 1908.02847 시장 불변량 변동성 | B | 59.8 | 65 | 77 | 53 | 35 | 68 |
| 1908.08806 딥러닝 모형 보정 | B | 59.5 | 68 | 67 | 58 | 32 | 66 |
| 1908.02591 비트코인 자금세탁 탐지 | B | 58.8 | 58 | 48 | 56 | 72 | 62 |
| 1908.08684 낙폭 최소화 포트폴리오 | B | 58.6 | 60 | 70 | 57 | 42 | 58 |
우리 지식 베이스에서 함께 읽을 논문
- 포트폴리오 추정 불확실성 계열: Two is better than one: Regularized shrinkage of large minimum variance portfolios, Covariance matrix filtering and portfolio optimisation, Robust deep hedging
- 지연·호가창 계열: JAX-LOB: A GPU-Accelerated limit order book simulator, Generative AI for End-to-End Limit Order Book Modelling, Conservation Laws in a Limit Order Book
- 금융 감성 분석 계열: FinBERT: A Pretrained Language Model for Financial Communications, FinBERT2
이 글은 2019년 8월 arXiv 백필 코호트(전체 122편, 관련 78편)의 평가 결과를 바탕으로 작성했습니다. 모든 수치는 원문 논문에서 인용했으며, 블로그 성격상 일부 이론적 세부사항은 생략했습니다. 심층 분석은
analysis/reports/backfill/1908.md를 참고하세요.
📚 이 글에서 다룬 논문 (30편)
- BA multi-factor polynomial framework for long-term electricity forwards with delivery period
Xi Kleisinger-Yu, Vlatka Komaric, Martin Larsson 외 1명
- ASampling Distributions of Optimal Portfolio Weights and Characteristics in Low and Large Dimensions
Taras Bodnar, Holger Dette, Nestor Parolya 외 1명
- ALatency and Liquidity Risk
Álvaro Cartea, Sebastian Jaimungal, Leandro Sánchez-Betancourt
- BHedging Non-Tradable Risks with Transaction Costs and Price Impact
Alvaro Cartea, Ryan Donnelly, Sebastian Jaimungal
- BA lognormal type stochastic volatility model with quadratic drift
Peter Carr, Sander Willems
- BOn deep calibration of (rough) stochastic volatility models
Christian Bayer, Blanka Horvath, Aitor Muguruza 외 2명
- AFast Pricing of Energy Derivatives with Mean-reverting Jump-diffusion Processes
Nicola Cufaro Petroni, Piergiacomo Sabino
- B
- BStrategic Insider Trading Equilibrium with a Non-fiduciary Market Maker
Knut Aase, Bernt Øksendal
- BA nonlinear optimisation model for constructing minimal drawdown portfolios
C. A. Valle, J. E. Beasley
- BMyopic robust index tracking with Bregman divergence
Spiridon Penev, Pavel Shevchenko, Wei Wu
- B
- BIs being `Robust' beneficial?: A perspective from the Indian market
Mohammed Bilal Girach, Shashank Oberoi, Siddhartha P. Chakrabarty
- BHATS: A Hierarchical Graph Attention Network for Stock Movement Prediction
Raehyun Kim, Chan Ho So, Minbyul Jeong 외 3명
- AAnti-Money Laundering in Bitcoin: Experimenting with Graph Convolutional Networks for Financial Forensics
Mark Weber, Giacomo Domeniconi, Jie Chen 외 4명
- BAdaptive Configuration Oracle for Online Portfolio Selection Methods
Favour M. Nyikosa, Michael A. Osborne, Stephen J. Roberts
- ATwo is better than one: Regularized shrinkage of large minimum variance portfolio
Taras Bodnar, Nestor Parolya, Erik Thorsén
- A
- AJAX-LOB: A GPU-Accelerated limit order book simulator to unlock large scale reinforcement learning for trading
Sascha Frey, Kang Li, Peer Nagy 외 5명
- AFinBERT: A Pretrained Language Model for Financial Communications
Yi Yang, Mark Christopher Siy UY, Allen Huang
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2026-04 월간
AI가 진짜 돈을 움직이기 시작했다 — 2026년 4월 금융 AI 연구 하이라이트
2026년 4월 금융 AI 연구 동향. LLM 에이전트가 실제 자본으로 온체인 거래를 시작하고, 백테스트의 허상이 대규모 실증으로 검증된 달의 핵심 논문들을 살펴봅니다.
 📊 2026-03 월간
AI가 주식을 예측할 수 있을까? — 2026년 3월 금융 AI 연구 리뷰
2026년 3월 금융 AI 논문 734편을 분석한 월간 종합. LLM의 시간 편향 문제, 백테스트 엔진의 숨겨진 오차, 포트폴리오 최적화의 새로운 수학, LOB 시뮬레이션의 현실화, 강화학습 트레이딩 시스템의 실전 전환까지 — 신뢰할 수 있는 금융 AI를 만드는 5가지 연구 테마를 살펴봅니다.
 📊 2026-01 월간
AI가 포트폴리오를 짜고, 뉴스를 조작하고, 블록체인에서 대량 매도한다 — 2026년 1월 금융 AI 연구 하이라이트
2026년 1월 arXiv에 올라온 금융 AI 연구를 5개 테마로 정리했습니다. 파라미터 불확실성을 포트폴리오에 반영하는 방법, LLM 에이전트의 결정 재현성 문제, DEX에서의 대량 매도 최적화, 연합학습으로 신용리스크를 예측하는 방법, 그리고 주문흐름과 변동성을 하나로 묶는 미시구조 이론까지.