
매달 arXiv에 쏟아지는 금융 AI 논문 중에서 의미 있는 연구를 골라 정리합니다. 이번에는 2019년 7월로 시간을 되돌아갑니다. ChatGPT는 물론, 오늘날 트레이딩 뉴스를 뜨겁게 달구는 언어모델 에이전트가 나오기 3년 전입니다. 그런데 이 달의 논문들을 읽다 보면 이런 생각이 듭니다. "오늘날의 화려한 AI 트레이딩이 딛고 서 있는 기초 공사가, 바로 이때 벌어지고 있었구나."
들어가며: 2019년 7월, 생성형 AI 이전의 세계
2019년 여름의 금융 AI 연구는 지금과 전혀 다른 얼굴을 하고 있습니다. '이번 달에는 어떤 LLM 전략이 새로 나왔나'를 물어볼 곳이 없습니다. 대신 연구자들은 더 근본적인 문제들에 매달리고 있었어요.
- 옵션 가격을 계산하려면 항상 가격 모형을 믿어야 하는데, 모형 자체를 안 믿고도 가격의 경계를 구할 수는 없을까?
- 주가의 변동성은 왜 종이처럼 매끈하지 않고 사포처럼 거칠까? 그 거친 질감은 시장 내부 어디에서 태어나는 걸까?
- 자산이 30개면 최적 호가를 계산하는 컴퓨터가 터져 버리는데, 현실의 마켓메이커는 어떻게 살아남을까?
- 인공지능이 주가를 예측하는 대신, 주가 데이터 자체를 만들어 내면 어떨까?
이 질문들에 대한 답이 이 달 한꺼번에 쏟아졌습니다. 하나씩 따라가 보죠. 어렵게 느껴지는 용어는 최대한 일상적인 비유로 풀어 갑니다.
테마 1: 옵션 가격을 '모델 없이' 묶어 버리는 수학
왜 흥미로운가
중고차를 사려고 딜러 여러 명에게 견적을 받았다고 상상해 보세요. 각 딜러는 자기만의 가격 계산법을 씁니다. 그런데 딜러들의 견적만 보고도 "이 차의 진짜 가치는 아무리 높아도 ○○○만 원을 넘을 수 없다"고 말할 수 있다면 어떨까요? 가격 계산법(모형)을 전혀 믿지 않으면서 말이죠.
금융의 옵션 시장이 정확히 이 상황입니다. 옵션 가격을 계산하려면 보통 블랙-숄즈 같은 가격 모형을 가정하는데, 모형이 틀리면 계산된 가격도 틀립니다. 하지만 시장에는 만기별로 콜옵션 가격이 실제 호가로 걸려 있어요. 이 관측된 가격들만으로 "이 이색옵션의 가격은 이 값을 넘을 수 없다"는 상한을 구하는 연구가 이 달의 대표 논문입니다.
대표 논문: 관측된 콜 시세 몇 개로 가격의 천장을 만드는 법
Consistent upper price bounds for exotic options given a finite number of call prices and their convergence (arXiv 1907.09144)
이 논문이 다루는 대상은 아시안 옵션처럼 두 시점의 주가에 걸린 이색옵션입니다. 연구진은 두 가지 가정만 씁니다. 첫째, 무차익거래 조건 하에서 할인된 주가 과정은 '마팅게일'(미래 기댓값이 현재 값)이다. 둘째, 페이오프가 '방향볼록'하다(아시안 옵션이 해당). 이 두 조건만으로 만기별 콜 시세에 부합하는 가장 불리한 확률 분포를 설계할 수 있고, 그 위에서 옵션 페이오프의 기댓값을 최대로 한 값이 곧 모형과 무관한 가격 상한이 됩니다.
실제 데이터로 검증한 점이 인상적입니다.
- 2019년 5월 29일의 SAP 주식(주가 110유로) 시장 데이터를 사용했습니다. 행사가 90~125유로의 콜옵션 8개, 만기 2개(2019년 6월 17일과 8월 12일)의 실제 호가를 그대로 씁니다.
- 이 데이터로 두 시점의 평균 가격에 걸린 아시안 옵션의 상한을 계산했고, 동시에 무차익거래 여부까지 확인됩니다(관측 시세들이 서로 모순되지 않는다는 뜻입니다).
- 수렴 속도도 확인했습니다. 페이오프가 x·y²인 인공 예제에서 진짜 상한은 12.5인데, 근사 계산은 구간을 2개로 쪼갤 때(이론적 표기 n=3) 12.808에서 시작해, n=5에서 12.517, n=11에서 12.500004로 진짜 값에 빠듯하게 붙습니다. 논문은 이 속도가 이론적으로 더 빨라질 수 없음까지 증명합니다.
정직하게 말하면 한계도 있습니다. 실데이터 계산에서는 이자율을 0으로 두는 근사와 호가의 중간값 사용 때문에 이론값과 어긋남이 남습니다(분포의 기대값이 주가 110유로 대비 92.295로 나오는 부분). 논문이 스스로 밝힌 오차입니다.
가볍게 더 보기
- Neural network regression for Bermudan option pricing (1907.06474): 버뮤던 옵션을 계산할 때 쓰는 유명한 기법(Longstaff–Schwartz)이 있는데, 그 안의 '회귀 계산'을 신경망으로 바꾸고도 수렴한다는 것을 증명했습니다. 계산 엔진의 부품만 교체한 셈인데, 고차원 문제에서 효율이 크게 좋아집니다.
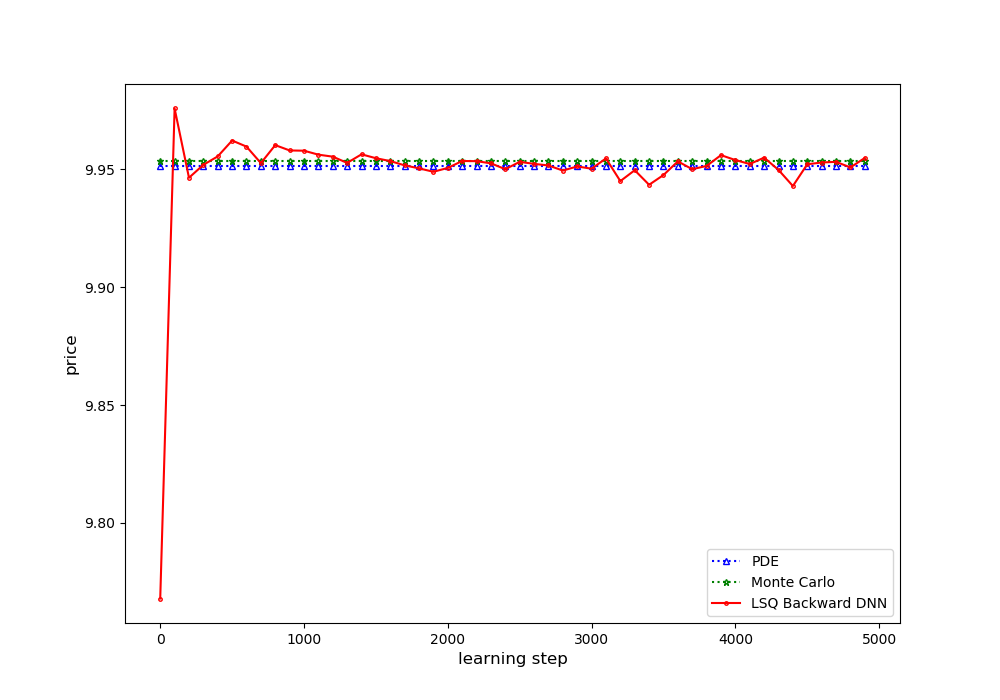
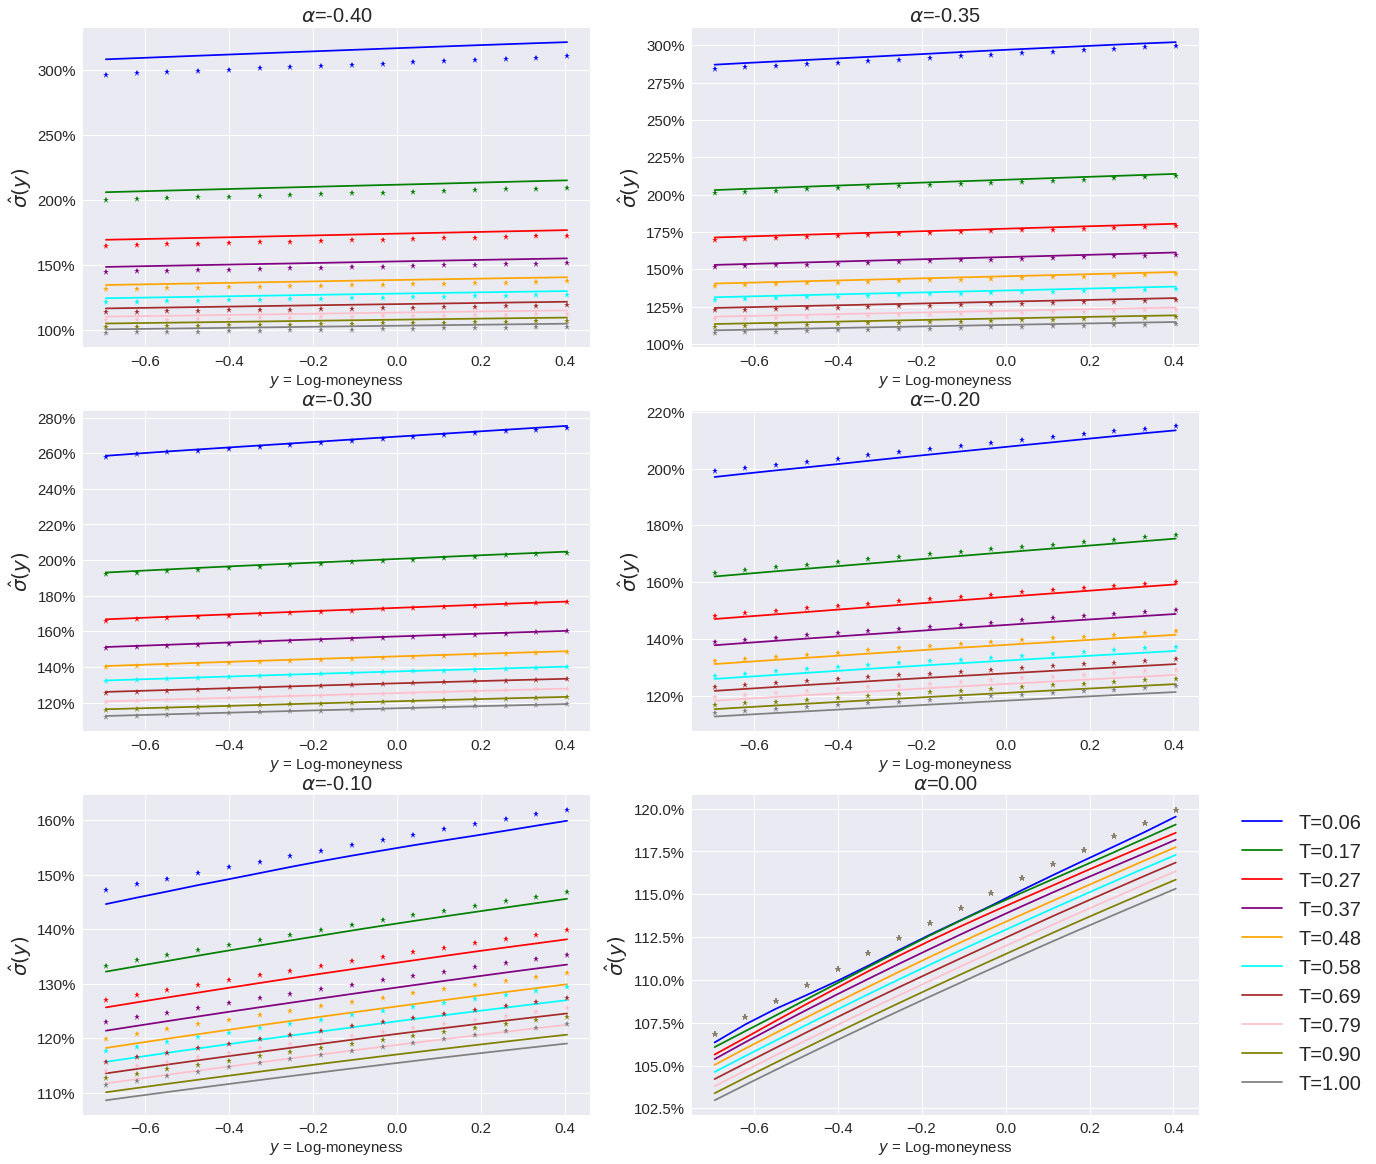
- Deep Learning-Based Least Square FBSDE Solver for High-Dimensional Derivative Pricing (1907.10578): 조기 상환이 있는 복잡한 파생상품(예: 콜러블 일드 노트)을 주식 1~5개 기준으로 가격을 매기는 수치 해법입니다. 위 그림이 바로 이 논문의 결과입니다.
- A model-free backward and forward nonlinear PDEs for implied volatility (1907.07305): 블랙-숄즈 공식을 거꾸로 반복해서 풀지 않고, 내재변동성 자체가 따르는 방정식을 직접 유도했습니다.
이 테마의 공통 인사이트
세 논문은 모두 "가격 모형을 절대적으로 믿지 말자"는 태도를 공유합니다. 하나는 모형 없이 가격의 경계를 구하고(09144), 나머지는 계산 과정에서 모형 의존성을 줄입니다(신경망 회귀, 모형-불가 PDE). 옵션 시장에서 '모형 리스크'라는 오래된 골칫거리를 이론과 계산 양쪽에서 조여 오는 흐름입니다.
테마 2: 마켓메이커의 고민 — 자산이 30개면 계산이 터진다
왜 흥미로운가
시장조성자(market maker)는 사겠다는 가격과 팔겠다는 가격을 동시에 제시하고 스프레드로 먹고사는 금융계의 노점상입니다. 노점상이 바나나 하나만 팔면 가격을 정하기 쉽죠. 그런데 바나나, 사과, 포도, 귤 등 30개 품목을 동시에 팔면서 각각의 재고가 쌓이면? 품목이 늘어날수록 "지금 이 재고 상태에서 각 품목의 최적 가격은?"이라는 계산이 기하급수적으로 어려워집니다. 이를 '차원의 저주'라고 합니다.
대표 논문: 크기가 문제다 — 거래 규모를 감안한 OTC 마켓메이킹
Size matters for OTC market makers: general results and dimensionality reduction techniques (arXiv 1907.01225)
이 논문은 두 마리 토끼를 한 번에 잡습니다.
첫째, 차원을 줄입니다. 30개 자산(여기서는 각각 100유로짜리 채권)의 가격 움직임 상관관계를 분석해 보니, 전체 움직임을 설명하는 큰 축이 두 개뿐이었습니다. 첫 번째 축은 30개 자산이 함께 오르내리는 '시장 지수' 같은 것, 두 번째 축은 15개 자산과 나머지 15개 자산이 반대로 움직이는 축이었습니다(수치로는 공분산의 고유값이 19.895와 4.585 두 개가 지배하고, 나머지 28개는 모두 0.15 미만). 즉, 30차원 문제를 2차원으로 압축해도 정보가 거의 사라지지 않습니다. 30개 품목 가격을 하나하나 계산하는 대신 '시장'과 '그룹 간 괴리' 두 개만 보고 결정하는 거죠.
둘째, 거래 규모를 모형에 넣습니다. 장외(OTC) 시장에서는 상대방이 "이 자산 6,250개 사겠습니다"처럼 수량이 제각각인 요청(RFQ)을 보냅니다. 논문은 요청 수량을 6,250 / 12,500 / 18,750 / 25,000 네 가지로 나누고(발생 확률은 각각 0.53, 0.35, 0.10, 0.02), 수량이 클수록 더 넓은 호가를 답하는 것이 최적임을 계산으로 보여 줍니다. 덩치 큰 거래일수록 재고 위험이 커지니 가격을 보수적으로 불러야 한다는, 직관과 일치하는 결론입니다.
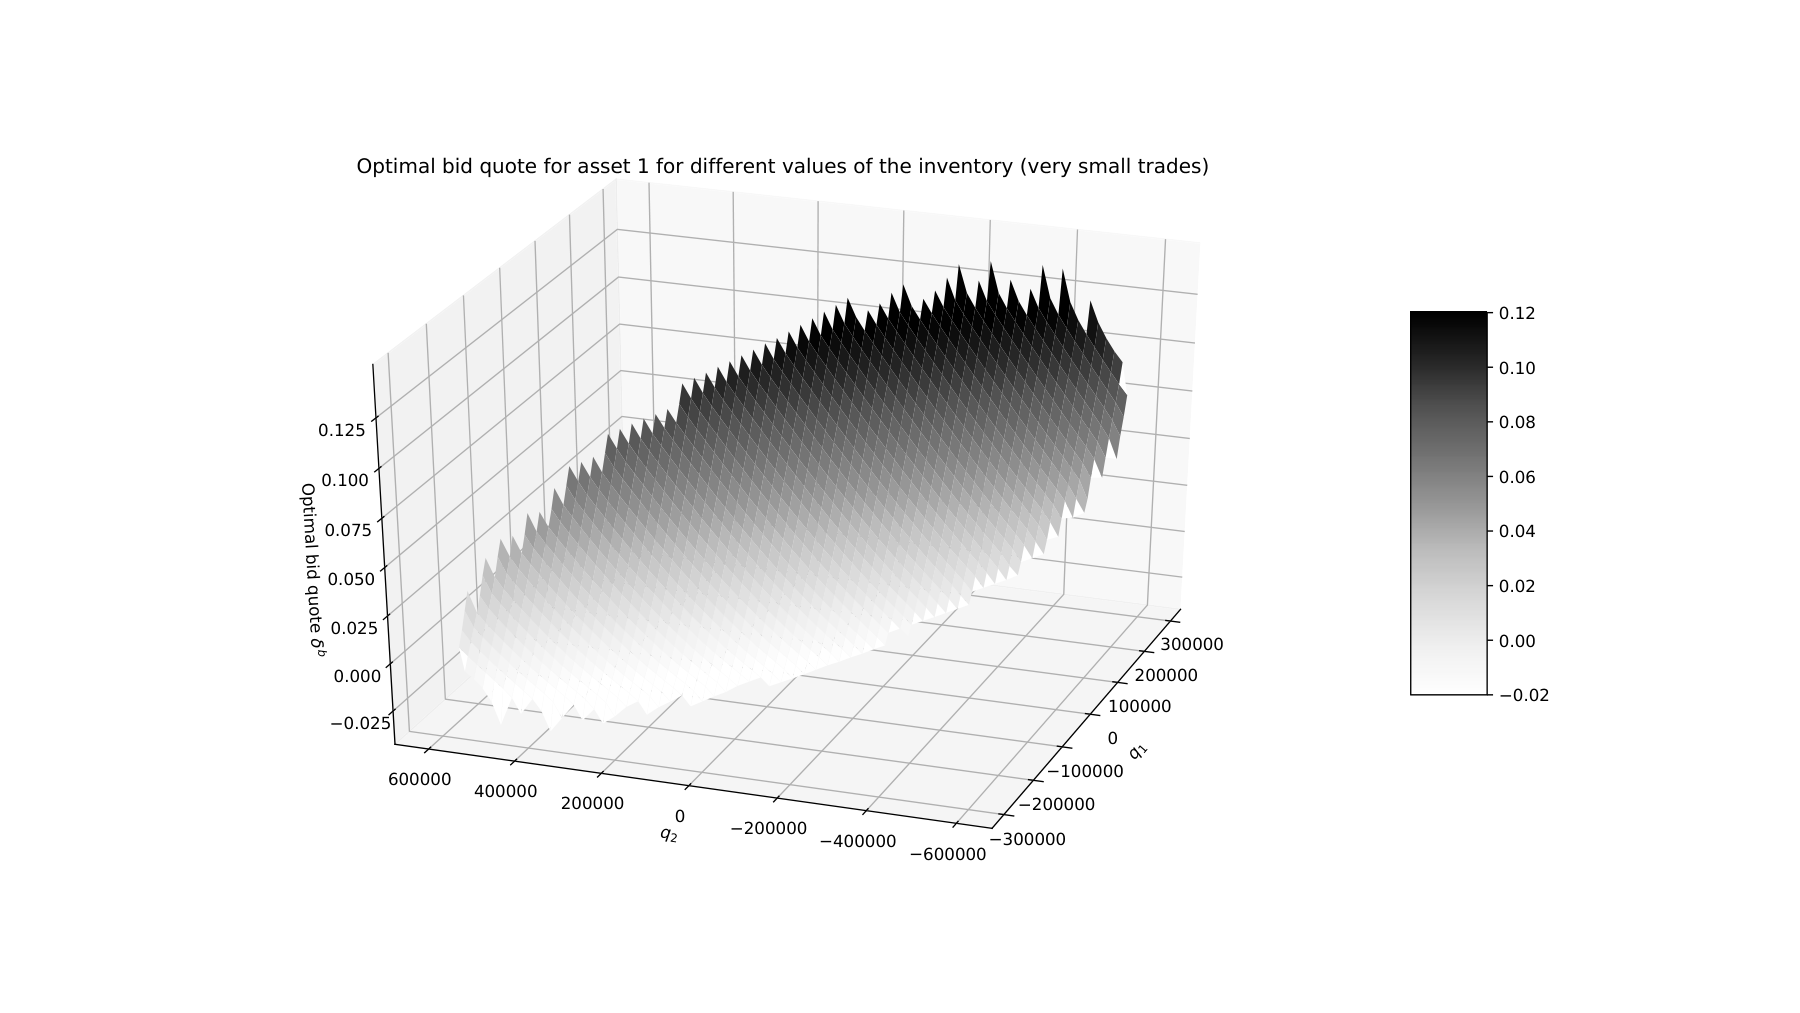
구체적 설정도 실무 감각을 줍니다. 자산당 하루 RFQ 10건, 요청 수량은 평균 1만 자산(약 100만 유로)의 감마분포, 최적 호가와 근시안적 호가로 각각 2,000번 시뮬레이션해 재고 분포를 비교했습니다.
가볍게 더 보기
- Algorithmic market making for options (1907.12433): 옵션 여러 개를 한꺼번에 관리하는 시장조성 문제에서는 포트폴리오 전체의 '베가'(변동성에 대한 민감도) 하나만 추적하면 문제가 크게 단순해진다는 아이디어입니다.
- Multi-Level Order-Flow Imbalance in a Limit Order Book (1907.06230): 나스닥 6개 대형주 데이터로, 호가창의 깊은 곳까지 주문 흐름을 보면 볼수록 가격이 어떻게 움직일지 더 잘 설명된다는 실증 결과입니다. "겉에 보이는 호가만이 전부가 아니다"라는 시장 미시구조의 기본 교훈을 깔끔하게 확인시켜 줍니다.
이 테마의 공통 인사이트
세 논문은 "현실의 시장조성은 1자산·1사이즈 가정에서 벗어나야 한다"는 점을 공유합니다. 차원 축소(01225), 민감도 축약(12433), 호가창 깊이 활용(06230) — 방법은 달라도 방향은 같습니다. 단순한 모형을 더 크게 쓰는 대신, 큰 문제를 지혜롭게 줄여라.
테마 3: 변동성은 왜 거칠까 — 시장 내부의 자기 피드백
왜 흥미로운가
주가의 '변동성'(얼마나 심하게 흔들리는지)을 확대해 들여다보면 이상한 점이 있습니다. 매끈한 곡선이 아니라, 잔디밭이나 사포 표면처럼 아주 작은 눈금에서도 울퉁불퉁합니다. 이것을 '거친 변동성(rough volatility)'이라 부르고, 실증 연구들은 그 거칠기 정도가 허스트 지수 약 0.1 수준임을 알려 왔습니다.
그런데 이 거칠기는 왜 생기는 걸까요? 누가 시장에 이런 질감을 입히는 걸까요?
대표 논문: 주문이 주문을 부르는 시장에서 거친 변동성이 태어나다
From quadratic Hawkes processes to super-Heston rough volatility models with Zumbach effect (arXiv 1907.06151)
이 논문의 출발점은 'Hawkes 과정'이라는 미시구조 모형입니다. 쉽게 말하면 "주문이 주문을 부르는" 현상입니다. 누군가 사면 그 주문이 또 다른 주문의 기폭제가 되어 시장이 스스로 달아오르는, 자기 흥분(self-exciting) 구조죠. 이전 연구들은 이런 구조에 시장의 높은 내생성(시장 움직임의 대부분이 외부 뉴스가 아니라 내부 거래에서 나온다는 관찰), 대형 주문의 분할 집행, 무차익거래 조건을 결합하면 거시적 극한에서 거친 헤스톤 모형이 나온다는 것을 보였습니다.
이 논문은 한 단계 더 나갑니다. Hawkes 강도를 제곱형으로 확장한 것이죠. 쉽게 말하면, 피드백이 선형("주문 하나가 주문 하나를 부른다")이 아니라 이차항("큰 움직임이 더 큰 움직임을 부른다")으로 작동하도록 만든 모형입니다. 이렇게 하면 극한에서 변동성 역학이 기존의 헤스톤보다 더 두꺼운 꼬리를 가진 '초-헤스톤(super-Heston)' 형태로 나옵니다. 그리고 결정적으로, Zumbach 효과가 살아남습니다.
Zumbach 효과란 "가격이 오르내린 추세 자체가 미래의 변동성을 키운다"는 실증 현상입니다. 과거 수익률의 추세가 미래 불확실성을 부추기는 것이죠. 이 효과는 이전의 거친 변동성 모형들에서는 약한 형태로만 재현됐는데, 제곱형 피드백을 쓰면 변동성이 과거 수익률 항을 명시적으로 품게 되어 이 현상이 모형 안에 그대로 자리 잡습니다.
논문은 안정적인 경우와 '준불안정'한 경우를 나눠 각각의 극한을 엄밀히 증명하고, 두 경우 모두에서 거친 변동성이 나오지만 그 원인이 서로 다르다는 점도 밝힙니다(하나는 커널이 0에서 특이해서, 다른 하나는 커널의 꼬리가 두꺼워서).
가볍게 더 보기
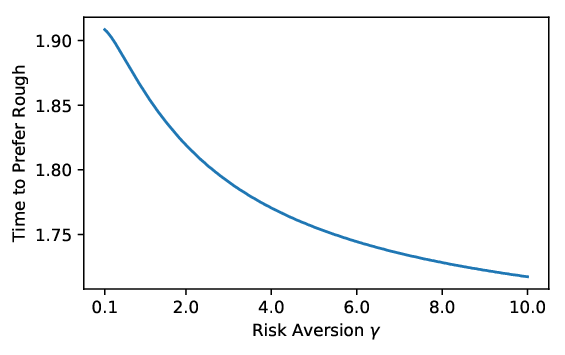
- Time-inconsistency with rough volatility (1907.11378): 위 그림의 논문입니다. 거친 변동성 환경에서는 '오늘의 나'와 '내일의 나'가 원하는 투자 전략이 달라지는 시간불일치 문제가 생기는데, 이를 게임이론으로 풀어 균형 전략을 구했습니다. 수치 실험에서 거친 변동성을 반영한 트레이딩 규칙이 고전적 규칙보다 나았습니다.
- Forecasting security's volatility using low-frequency historical data, high-frequency historical data and option-implied volatility (1907.02666): 저빈도 가격, 고빈도 가격, 옵션 내재변동성 — 서로 다른 세 정보원을 하나의 예측 모형으로 통합했습니다. 고빈도 데이터의 표집 간격이 5분일 때 예측 성능이 가장 좋았다는 실용적 결론도 담겨 있습니다.
이 테마의 공통 인사이트
세 논문은 변동성을 외부에서 주어지는 숫자가 아니라 시장 내부 활동이 만들어 내는 결과물로 봅니다. 미시 거래가 거친 변동성을 유도하고(06151), 그 거친 변동성은 투자 전략 자체를 바꾸며(11378), 여러 정보원을 통합해야 그 움직임을 더 잘 예측할 수 있습니다(02666). "변동성은 시장의 숨결"이라는 관점이 이론·전략·예측에서 동시에 확인된 달입니다.
테마 4: AI가 데이터를 만들고 투자를 대신한다
왜 흥미로운가
2019년의 인공지능은 주가를 '예측'하는 것을 넘어 두 가지 새로운 역할을 시작합니다. 하나는 실제와 구별하기 어려운 가짜 금융 데이터를 만들어 내는 일, 다른 하나는 사람 대신 돈을 굴려 주는 일입니다. 전자는 요리 레시피를 알려 주는 대신 요리사 자체를 복제하는 것 같고, 후자는 나를 대신해 운전해 주는 자율주행차 같습니다. 두 경우 모두 "믿어도 될까?"라는 질문이 따라붙습니다.
대표 논문: Quant GANs — S&P 500을 인공지능으로 '제조'하다
Quant GANs: Deep Generation of Financial Time Series (arXiv 1907.06673)
GAN(생성 적대 신경망)은 두 인공지능이 대결하는 구조입니다. 하나는 가짜 데이터를 만들고(생성기), 다른 하나는 진짜와 가짜를 구별하려 하고(판별기), 이 싸움이 반복되면 생성기가 진짜 같은 데이터를 만들게 됩니다. 사진 위조로 유명해진 기술이죠. Quant GANs는 이 구조에 '시간 합성곱 신경망(TCNN)'을 장착해 금융 시계열을 생성합니다.
성과가 꽤 놀랍습니다.
- 데이터: S&P 500 일간 가격, 2009년 5월~2018년 12월, 2,413개 관측치.
- 분포 재현: 생성된 로그 수익률의 분포가 실제와 일간·주간·월간은 물론 100일 래그까지 잘 일치합니다.
- 의존 구조 재현: 진짜 금융 데이터의 특징 — 수익률 자체의 상관은 금방 사라지지만, 수익률의 제곱(변동성 척도)의 상관은 오래 남는 패턴(변동성 군집) — 일 그대로 재현됩니다. '하락이 변동성을 더 키운다'는 레버리지 효과까지 잡아냅니다.
- 벤치마크: 평가 지표 대부분에서 전통적인 GARCH(1,1) 모형을 지표에 따라 약 2~10배 큰 폭으로 앞섭니다. 위험중립 분포로의 전환(옵션 가격결정에 필수)까지 설계에 반영된 점이 실무적입니다.
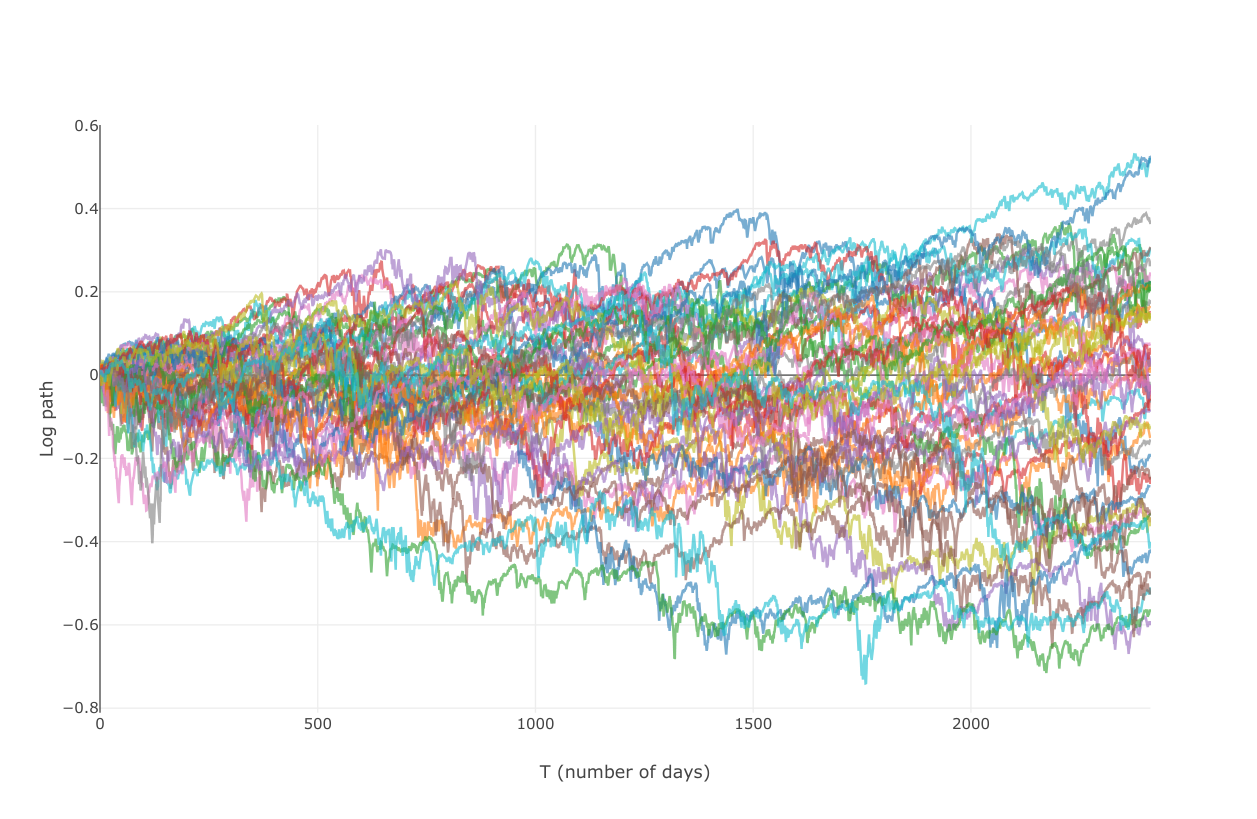
정직한 경고도 잊지 않습니다. GAN 학습이 매우 불안정해 여러 번의 시도 중 '가장 좋았던' 모델을 골라 보고했고, 분포의 꼬리를 정확히 외삽하는 문제와 모든 성질을 한 번에 평가할 단일 지표는 미해결 과제로 남았습니다.
가볍게 더 보기
- Artificial Intelligence Alter Egos: Who benefits from Robo-investing? (1907.03370): 2003년 1월~2012년 3월(2008년 금융위기 포함) 실제 브로커리지 계좌를 가진 투자자 2만여 명의 거래 기록으로, 각 투자자를 대신할 '그림자 로보투자자'를 만들었습니다. 업계에서 쓰이는 로보 자문 전략(고급 기계학습 포함)과 사람을 겨룬 결과, 로보 투자의 혜택은 저소득·고위험 회피 투자자 등 특정 집단에 집중되고, 금융위기 때는 '기계가 인간보다 현금 회피를 잘했다'는 점이 드러납니다. AI 자문이 누구에게 유리한지를 묻는, 지금 읽어도 시의적절한 질문입니다.
이 테마의 공통 인사이트
두 논문은 AI의 역할이 '예측'에서 '환경 조성(합성 데이터)과 대리 실행(로보 자문)'으로 넓어지고 있음을 보여 줍니다. 동시에 "합성 데이터의 꼬리까지 믿을 수 있는가", "로봇 자문의 수혜자는 누구인가"처럼 신뢰의 경계를 정직하게 묻습니다. 기술이 성큼 앞서 나갈 때 좋은 연구가 하는 일은 한계를 솔직하게 표시하는 것이기도 합니다.
테마 5: 내 주식 100개를 AI가 굴린다면
왜 흥미로운가
"AI한테 내 포트폴리오를 맡기면 얼마나 벌 수 있을까?" 이 질문에 대한 가장 진지한 시도 중 하나가 이 달 나왔습니다. 답부터 말하면, 조건에 따라 다르고 — 숫자가 꽤 흥미롭지만 — 함정도 있다는 것입니다.
대표 논문: 대규모 평균-분산 포트폴리오를 강화학습으로
Large scale continuous-time mean-variance portfolio allocation via reinforcement learning (arXiv 1907.11718)
전통적인 마코비츠 포트폴리오는 "기대수익은 크게, 변동성은 작게"라는 단순한 원리입니다. 그런데 종목이 수백 개로 늘면 필요한 통계량을 정확히 추정하기 어렵고, 계산도 무거워집니다. 이 논문은 강화학습을 연속시간 제어와 결합한 EMV 알고리즘으로 이 문제를 풉니다. 핵심 아이디어는 전략에 의도적인 무작위성(탐색)을 넣되, 그 무작위성의 폭을 시간이 지나며 줄이는 것 — 시험 운행을 점점 줄여 가는 연습생처럼요.
S&P 500 실제 데이터로 검증했습니다(데이터는 와튼 연구 데이터 서비스).
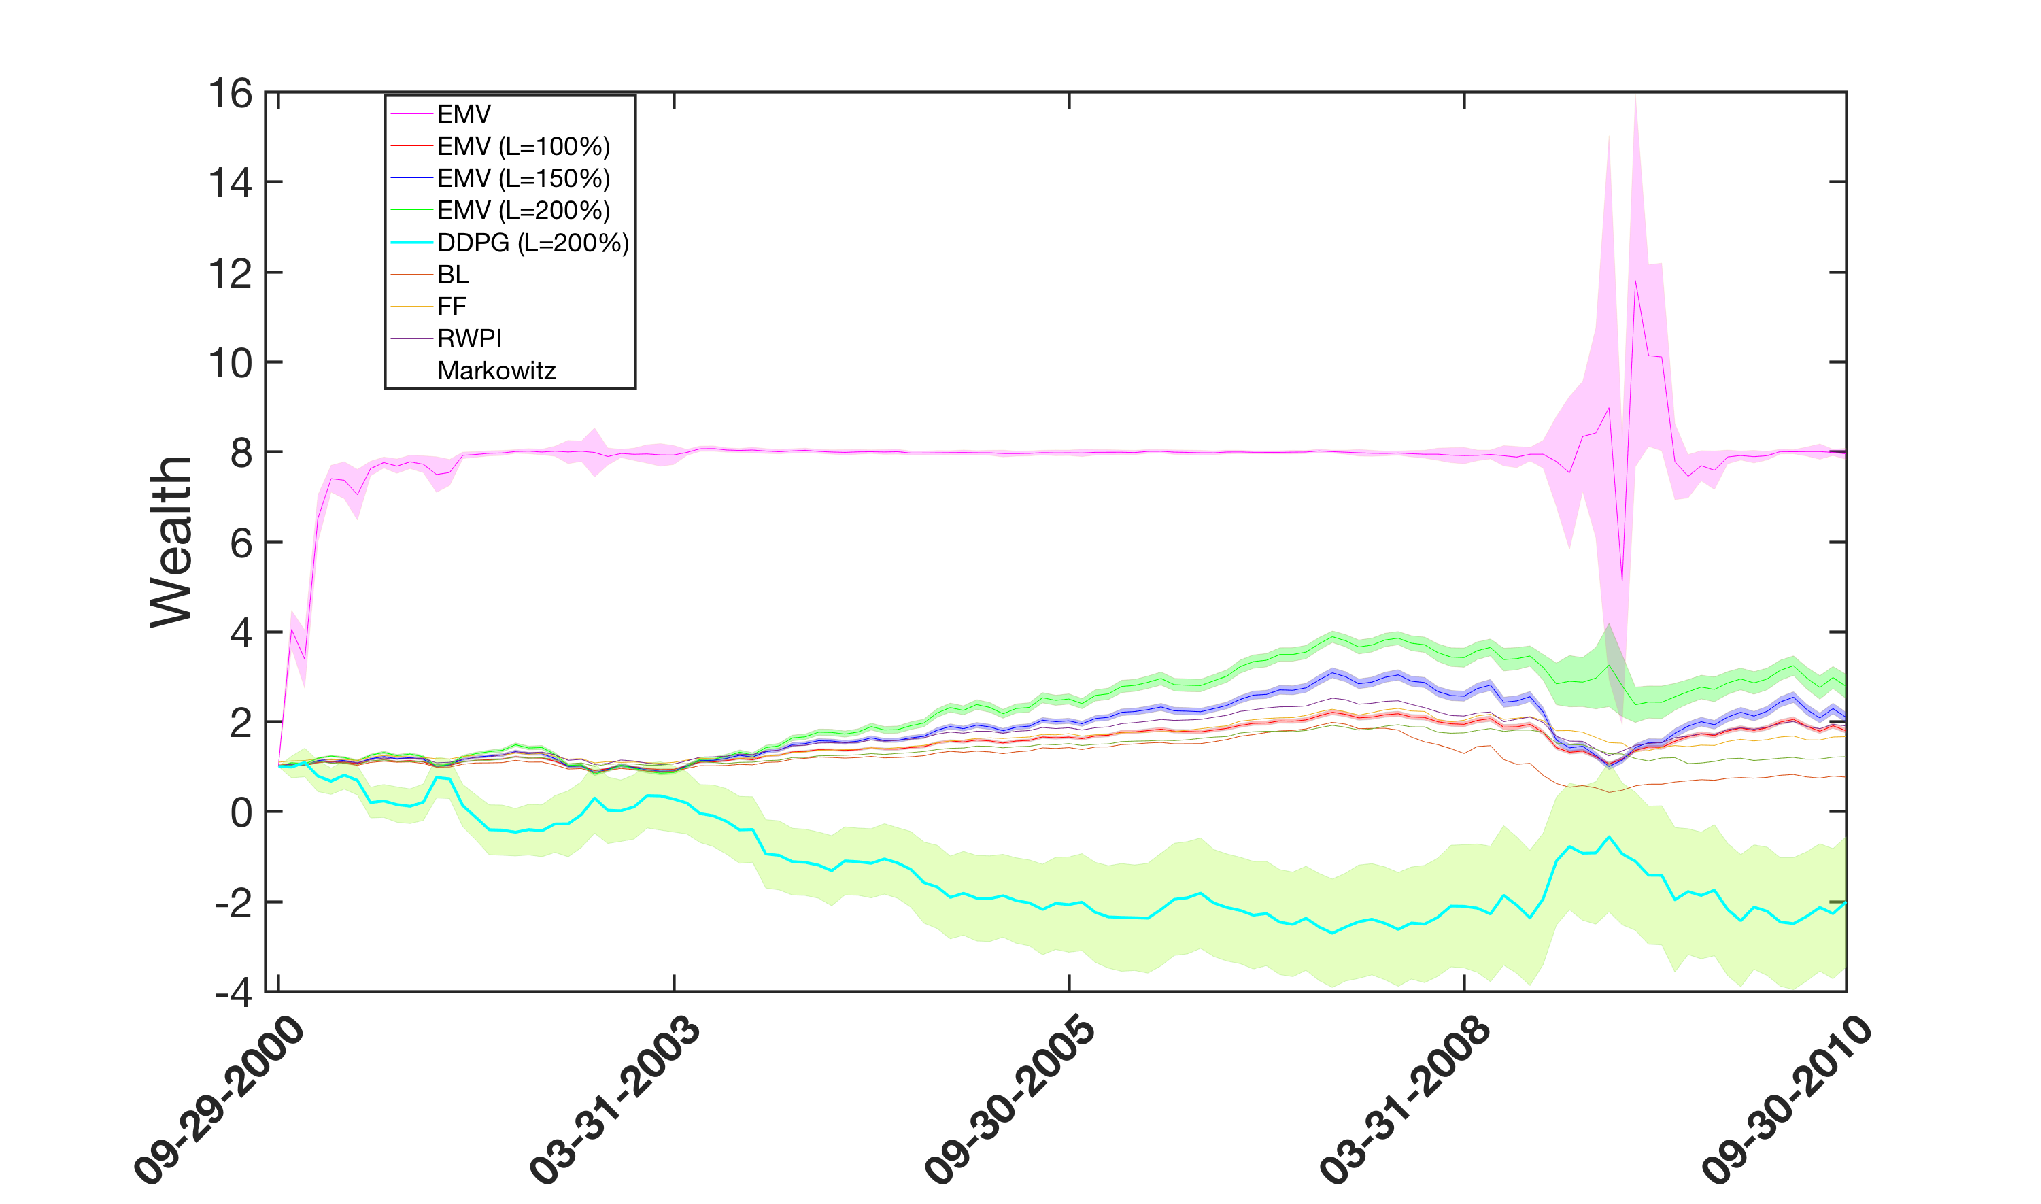
- 월간 리밸런싱 (종목 20
100개, 1990년 8월2000년 8월 10년치로 학습, 2000년 9월~2010년 9월 10년으로 테스트, 목표는 10년에 자산 8배 — 연 환산 23%): 총노출 200% 레버리지 제약 안에서 연환산 수익률이 종목 20개일 때 10.8%(샤프 비율 0.797), 60개일 때 11.2%(샤프 1.323), 100개일 때 6.3%(샤프 1.627). - 일간 리밸런싱 (2017년 1월~2018년 1년 학습, 이후 1년 테스트, 목표 1년 40% 수익): 종목 50개에서 44.9%(샤프 1.347), 75개에서 33.0%(샤프 1.370), 100개에서 17.9%(샤프 1.124)로 목표를 넘겼습니다.
- 비교 상대로 블랙-리터만, 파마-프렌치, 마코비츠 같은 고전적 기법과 딥 강화학습 DDPG를 함께 시험했는데, EMV가 월간·일간 모두에서 큰 폭으로 앞섰습니다. 같은 조건의 DDPG는 종목 20개 월간 테스트에서 연환산 −300.1%로 무너졌습니다.
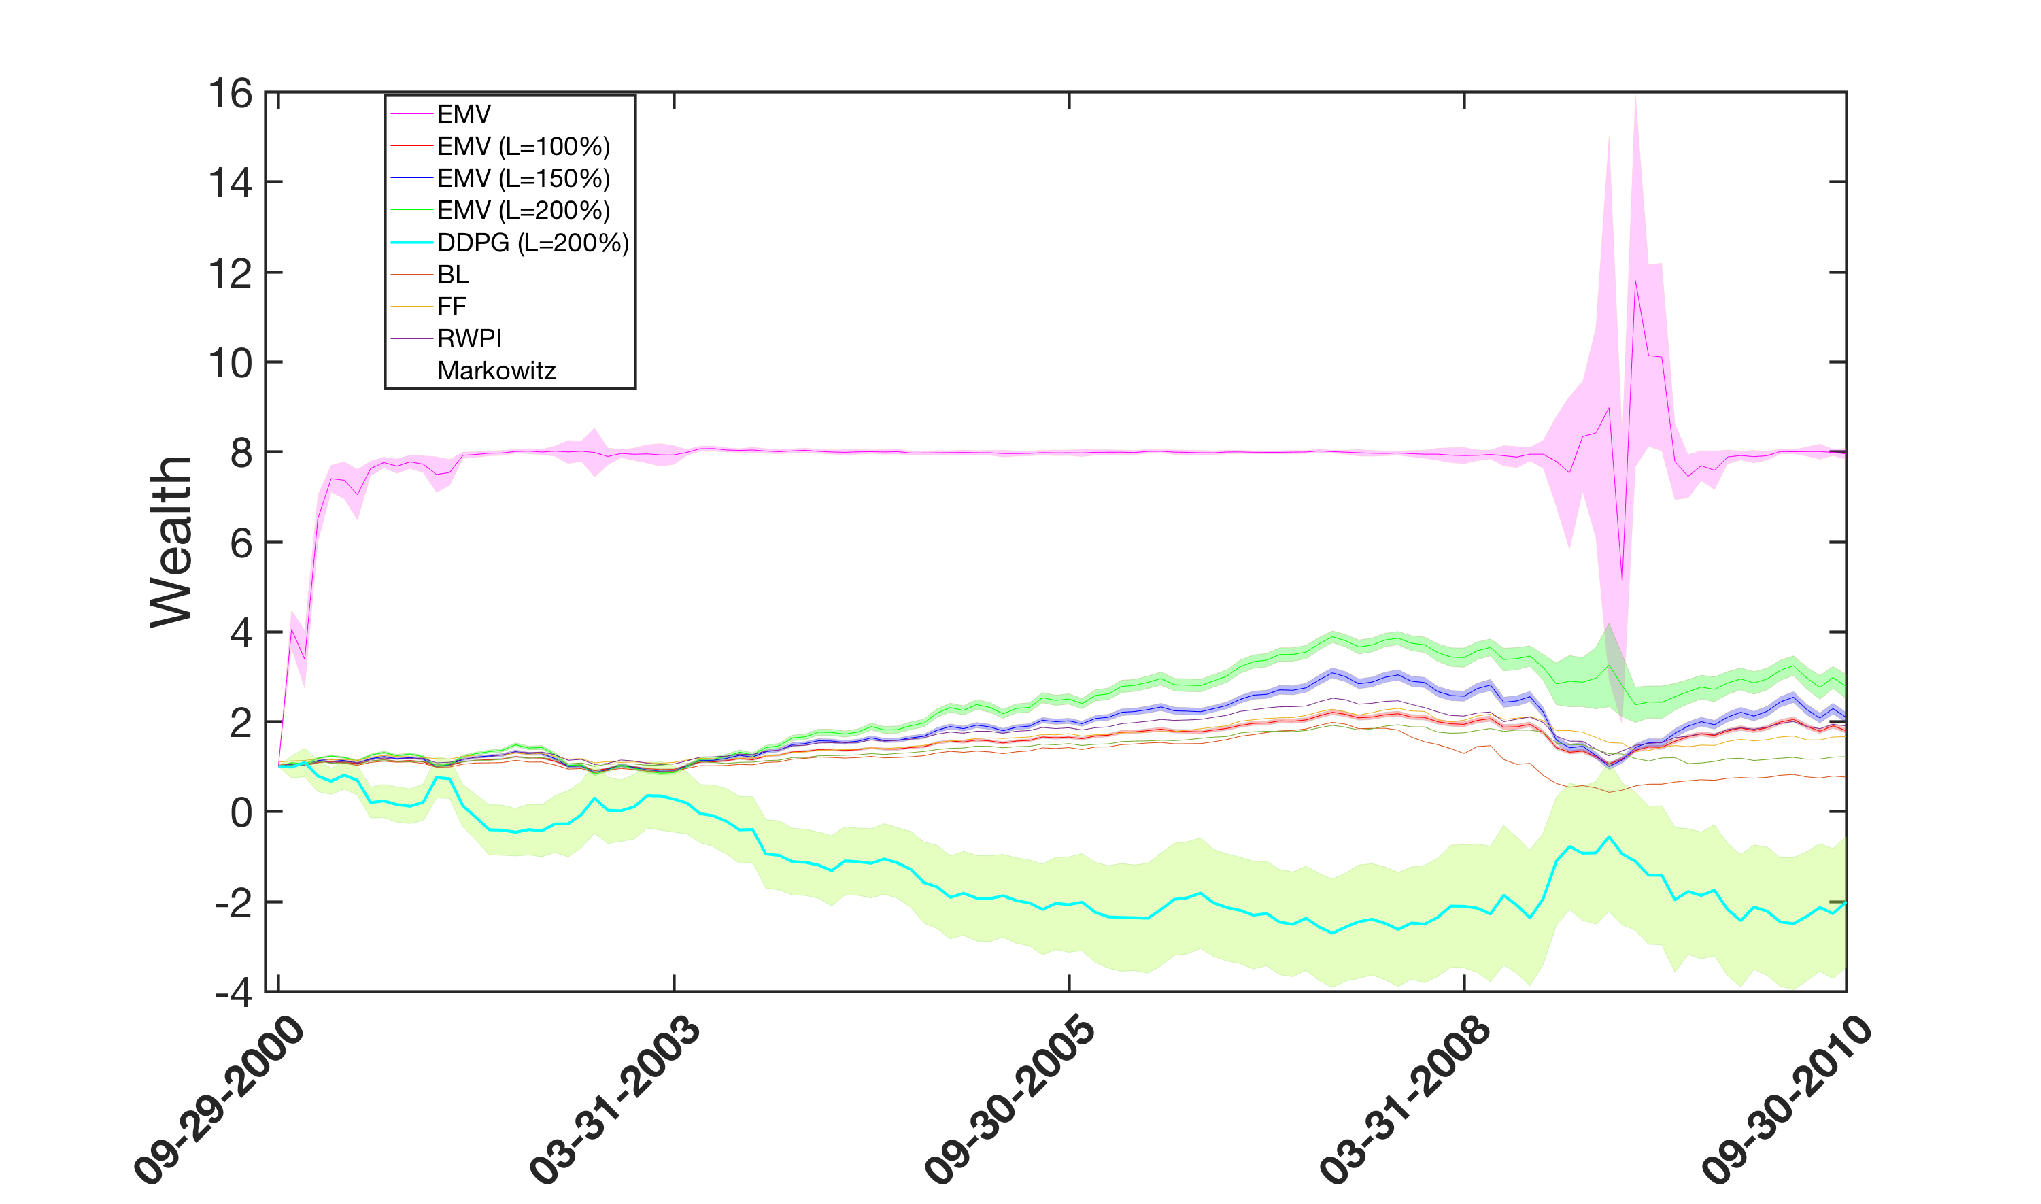
하지만 이 숫자를 "AI가 매년 44% 번다"로 읽으면 곤란합니다. 거래비용·슬리피지·유동성 제약이 결과에 반영되어 있지 않은 이상화된 백테스트이고, 재현성 점수도 낮습니다(38점). 실전 수익률을 예고하는 숫자라기보다 "간단한 원리의 전략이 복잡한 벤치마크를 압도할 수 있다"는 가능성의 증거로 읽는 것이 맞습니다.
가볍게 더 보기
- Systemic Optimal Risk Transfer Equilibrium (1907.04257): 여러 기관이 위험을 서로 떠넘기는 시스템에서, 각자의 예산 제약을 지키면서도 전체가 최적이 되도록 위험 이전 가격을 정하는 균형 이론입니다.
- Elicitability and Identifiability of Systemic Risk Measures (1907.01306): 시스템 리스크 측정값을 '백테스트할 수 있는' 형태로 다루는 통계적 기초를 닦은 논문입니다. 리스크 숫자를 믿으려면 먼저 그 숫자가 검증 가능해야 하니까요.
- Bandits with Feedback Graphs and Switching Costs (1907.12189): 전략을 바꿀 때 비용이 드는 환경에서 최적을 찾아가는 '다중 슬롯 밴딧' 이론의 확장입니다.
- A Note on Universal Bilinear Portfolios (1907.09704): 과거를 다 안다고 가정했을 때의 최적 전략에 얼마나 근접할 수 있는지 묻는 고전적 벤치마크 이론을 넓혔습니다.
이 테마의 공통 인사이트
다섯 논문은 "포트폴리오 이론은 죽지 않고 확장되고 있다"는 점을 공유합니다. 강화학습은 마코비츠를 대체한 것이 아니라 대규모 문제를 풀기 위한 엔진으로 투입되었고(11718), 리스크 측정은 검증 가능한 형태로 정교해지며(01306), 시스템 전체의 위험은 개별 기관 위험과 분리되어 다루어집니다(04257). 새 도구가 옛 이론을 밀어내는 대신, 옛 이론이 새 도구의 지도가 되어 준 셈입니다.
2019년 7월 전체를 관통하는 메시지
이 달의 연구들을 한 문장으로 요약하면 "금융 AI의 기초 공사"입니다. 오늘날 언어모델 트레이딩 에이전트가 화제가 되기 3년 전, 연구자들은 모델이 틀려도 무너지지 않는 가격의 경계를 세우고(테마 1), 변동성의 거친 질감이 어디서 태어나는지 밝히고(테마 3), 큰 계산을 지혜롭게 줄이는 법을 찾고(테마 2), 신경망을 예측기 대신 계산 엔진과 데이터 생성기로 투입하고(테마 4), AI 자산배분의 가능성과 한계를 정직하게 측정하고 있었습니다(테마 5).
화려한 최신 논문들이 딛고 서 있는 지반은 사실 이렇게 쌓입니다. 2019년 7월은 그 지반 공사가 한창이던 달이었습니다.
더 알아보기
원문 링크와 5차원 평가 점수
이 글에서 다룬 논문들의 원문과, 우리 지식 베이스가 매긴 5차원 점수입니다(신규성 / 적용성 / 엄밀성 / 재현성 / 통찰, 종합점수는 이들의 가중 합).
| 논문 | 티어 | 종합 | 신규성 | 적용성 | 엄밀성 | 재현성 | 통찰 |
|---|---|---|---|---|---|---|---|
| 1907.01225 OTC 마켓메이커 | A | 70.5 | 75 | 78 | 83 | 48 | 76 |
| 1907.09144 이색옵션 가격 상한 | A | 70.2 | 72 | 69 | 82 | 43 | 76 |
| 1907.06474 버뮤던 신경망 회귀 | A | 68.8 | 62 | 76 | 78 | 52 | 66 |
| 1907.06151 초-헤스톤 거친 변동성 | A | 67.7 | 76 | 54 | 83 | 43 | 78 |
| 1907.06673 Quant GANs | A | 67.2 | 72 | 59 | 69 | 67 | 70 |
| 1907.03370 로보 투자 그림자 실험 | A | 67.0 | 67 | 74 | 68 | 42 | 76 |
| 1907.12433 옵션 마켓메이킹 | A | 65.7 | 73 | 76 | 74 | 43 | 67 |
| 1907.02666 변동성 예측 통합 | A | 65.6 | 66 | 65 | 79 | 42 | 67 |
| 1907.11378 거친 변동성과 시간불일치 | A | 65.0 | 78 | 57 | 78 | 38 | 69 |
| 1907.11718 RL 자산배분 | B | 64.2 | 73 | 61 | 76 | 38 | 68 |
| 1907.04257 시스템 위험이전 균형 | B | 61.4 | 70 | 38 | 84 | 45 | 68 |
| 1907.01306 시스템 리스크 측도 | B | 60.9 | 72 | 43 | 80 | 38 | 68 |
우리 지식 베이스에서 함께 읽을 논문
- 옵션 가격 상한 계열의 후속 연구: Model-free bounds for multi-asset options using option-implied information, Recipes for hedging exotics with illiquid vanillas
- 금융 시계열 생성 계열: Deep Hedging: Learning to Simulate Equity Option Markets, MarketGANs: Multivariate financial time-series data augmentation
- 거친 변동성 계열: The quadratic rough Heston model and the joint S&P 500/VIX smile calibration
- 강화학습 트레이딩 환경: FinRL-Meta: Market Environments and Benchmarks for Data-Driven Financial RL
이 글은 2019년 7월 arXiv 백필 코호트(전체 146편, 관련 89편)의 평가 결과를 바탕으로 작성했습니다. 모든 수치는 원문 논문에서 인용했으며, 블로그 성격상 일부 이론적 세부사항은 생략했습니다. 심층 분석은
analysis/reports/backfill/1907.md를 참고하세요.
📚 이 글에서 다룬 논문 (23편)
- B
- BNeural network regression for Bermudan option pricing
Bernard Lapeyre, Jérôme Lelong
- AA model-free backward and forward nonlinear PDEs for implied volatility
Peter Carr, Andrey Itkin, Sasha Stoikov
- ASize matters for OTC market makers: general results and dimensionality reduction techniques
Philippe Bergault, Olivier Guéant
- AAlgorithmic market making for options
Bastien Baldacci, Philippe Bergault, Olivier Guéant
- BMulti-Level Order-Flow Imbalance in a Limit Order Book
Ke Xu, Martin D. Gould, Sam D. Howison
- AFrom quadratic Hawkes processes to super-Heston rough volatility models with Zumbach effect
Aditi Dandapani, Paul Jusselin, Mathieu Rosenbaum
- A
- BForecasting security's volatility using low-frequency historical data, high-frequency historical data and option-implied volatility
Huiling Yuan, Yong Zhou, Zhiyuan Zhang 외 1명
- AQuant GANs: Deep Generation of Financial Time Series
Magnus Wiese, Robert Knobloch, Ralf Korn 외 1명
- AArtificial Intelligence Alter Egos: Who benefits from Robo-investing?
Catherine D'Hondt, Rudy De Winne, Eric Ghysels 외 1명
- BSystemic Optimal Risk Transfer Equilibrium
Francesca Biagini, Alessandro Doldi, Jean-Pierre Fouque 외 2명
- BElicitability and Identifiability of Systemic Risk Measures
Tobias Fissler, Jana Hlavinová, Birgit Rudloff
- BBandits with Feedback Graphs and Switching Costs
Raman Arora, Teodor V. Marinov, Mehryar Mohri
- AModel-free bounds for multi-asset options using option-implied information and their exact computation
Ariel Neufeld, Antonis Papapantoleon, Qikun Xiang
- ARecipes for hedging exotics with illiquid vanillas
Joaquin Fernandez-Tapia, Olivier Guéant
- ADeep Hedging: Learning to Simulate Equity Option Markets
Magnus Wiese, Lianjun Bai, Ben Wood 외 1명
- BMarketGANs: Multivariate financial time-series data augmentation using generative adversarial networks
Jeonggyu Huh, Seungwon Jeong, Hyun-Gyoon Kim 외 2명
- AThe quadratic rough Heston model and the joint S&P 500/VIX smile calibration problem
Jim Gatheral, Paul Jusselin, Mathieu Rosenbaum
- AFinRL-Meta: Market Environments and Benchmarks for Data-Driven Financial Reinforcement Learning
Xiao-Yang Liu, Ziyi Xia, Jingyang Rui 외 6명
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2019-03 월간A
2019년 3월 금융 AI 연구: 거친 변동성에서 감정 네트워크까지
2019년 3월 arXiv에 올라온 금융 AI 논문 56편을 5개 테마로 정리했습니다. 거친 변동성 옵션 가격의 근사 수학, 신경망 조건부 밀도 추정 벤치마크, 공분산 앙상블 리스크 모형, 시장조성 백테스트의 함정, 1,944개 암호화폐의 감정 네트워크까지 — 예측이 아니라 분포와 근사가 중심이던 시대의 연구입니다.
 📊 2026-05 월간
2026년 5월 AI 트레이딩 연구 한눈에 보기 — 성과를 어떻게 믿을 것인가?
2026년 5월 arXiv에 올라온 AI 트레이딩 연구 중 가장 주목할 만한 논문들을 테마별로 정리했습니다. 백테스트 신뢰성, LLM 에이전트 감사, 마켓메이킹 최적화, 포트폴리오 의사결정, 변동성 모형의 다섯 가지 연구 흐름을 살펴봅니다.
 📊 2025-12 월간
크립토 백테스트가 거짓말하는 이유, 그리고 2025년 12월 퀀트 연구의 다섯 가지 흐름
2025년 12월 arXiv에 올라온 금융 AI·퀀트 연구 중 주목할 만한 다섯 가지 흐름을 살펴봅니다. 크립토 백테스트의 과대평가 문제부터 팩터 알파의 수명까지, 실전에 가까워지는 퀀트 연구의 최신 동향을 쉽게 풀어 설명합니다.