매달 arXiv에 쏟아지는 금융 AI 논문 중에서 의미 있는 연구를 골라 정리합니다. 이번에는 2019년 1월입니다. 이 달의 논문들을 읽다 보면 하나의 인상이 강하게 남습니다 — "정확한 계산은 느리고, 빠른 계산은 부정확하다는 오래된 딜레마를, 마침내 풀기 시작했다." 옵션 가격을 계산하느라 몇 초씩 기다리던 시대를 끝내는 신경망, 실물 데이터 800만 건으로 '큰 주문의 상처'를 측정한 실증 연구, 그리고 아직 이름조차 생소하던 '강화학습 트레이딩'의 초기 실험까지 — 계산 속도와 현실성을 동시에 좇은 한 달이었습니다.
들어가며: 비싼 계산기와 싼 계산기 사이에서
초등학교 때 계산기를 써 보셨다면 이런 경험이 있을 겁니다. 어려운 계산은 계산기가 대신해 주지만, "너무 느리면" 시험에 못 쓴다는 것. 금융의 세계에서도 비슷한 딜레마가 오래됐습니다.
옵션(미래의 특정 가격에 사고팔 수 있는 권리)을 가격을 매기려면 복잡한 확률 계산이 필요한데, 가장 정확한 방법은 몬테카를로 시뮬레이션 — 컴퓨터가 가격의 미래 경로를 수만 번 그려 보고 평균을 내는 방식 — 입니다. 문제는 느리다는 것. 정확한 모형일수록 계산이 오래 걸려서, 실제 트레이딩 데스크에서는 "계산이 빠른 대신 덜 정확한 모형"을 쓰는 일이 비일비재했습니다. 마치 요리를 잘하는 셰프는 주문을 오래 받고, 주문을 빨리 받는 분식집은 메뉴가 단순한 것과 비슷하죠.
2019년 1월의 연구자들은 이 딜레마에 대한 해법을 내놓습니다. "비싼 계산기를 한 번만 써서, 싼 계산기에게 요리를 가르치자." 그리고 그 '싼 계산기'가 얼마나 정확한지, 오차가 얼마나 되는지까지 수치로 검증합니다. 이 달의 다섯 갈래 이야기 — 옵션 가격의 신경망 보정, 대주문 집행 전략, 주문 흐름의 모델링, 리스크 계산의 가속화, 강화학습 트레이딩 — 는 모두 이 정신을 공유합니다. "계산을 현실 가능한 비용으로 만들되, 그 근사가 얼마나 믿을 만한지 함께 말하라."
테마 1: 느린 계산기에게 요리를 가르치다 — 신경망 옵션 보정
왜 흥미로운가
옵션 시장에는 '내재변동성(implied volatility) 표면'이라는 것이 있습니다. 쉽게 말하면 "행사가와 만기별로 시장이 매긴 옵션의 비싼 정도"를 3D 지형도처럼 그린 것입니다. 트레이더는 이 지형도를 보면서 자기 모형의 파라미터를 조정해, 모형이 그린 지형도가 시장의 지형도와 겹치게 만듭니다 — 이를 보정(calibration) 이라고 합니다.
문제는 보정 속도입니다. 지형도를 한 번 그리는 데 0.5초가 걸리는데, 보정하려면 그림을 수천 번 다시 그려야 합니다. 그러면 보정 한 번에 몇십 분이 걸립니다. 시장이 요동치는 날에는 "어제의 보정값"으로 버텨야 하는 셈이죠. 더 정확한 모형으로 갈수록 상황은 나빠집니다 — 2010년대에 각광받던 '거친 변동성(rough volatility)' 모형은 정확한 대신 계산이 너무 느려, 산업에서는 사실상 쓰기 어려웠습니다.
대표 논문: Deep Learning Volatility — 밀리초 만에 끝나는 보정
이 연구(1901.09647)는 King's College London의 Blanka Horvath, Imperial College London의 Aitor Muguruza, École Polytechnique의 Mehdi Tomas가 발표했습니다. 아이디어는 우아합니다 — 모형 파라미터를 넣으면 옵션 가격 표면을 뱉어 주는 신경망을 미리 훈련해 두자.
- 오프라인 훈련: 느린 몬테카를로 계산으로 수많은 파라미터 조합의 가격 표면을 미리 계산해 "정답지"를 만듭니다. 이 정답지로 신경망을 가르칩니다. 이 단계는 한 번만 하면 됩니다.
- 온라인 호출: 훈련이 끝나면, 어떤 파라미터를 넣어도 신경망이 즉시 가격 표면을 그려 줍니다. 보정은 이제 "그림을 빠르게 비교하며 파라미터를 조정하는" 단순한 작업이 됩니다.
- 픽셀처럼 다루기: 옵션 가격과 내재변동성을 '픽셀 모음'처럼 격자로 표현해 학습에 쓴 점이 이 연구의 독특한 부분입니다. 정보를 어떤 그릇에 담느냐가 성능을 좌우한다는 관찰이죠.
흥미로운 점은 이 연구가 '가격 근사'와 '시장 데이터 보정'을 분리했다는 것입니다. 신경망은 오직 '계산기' 역할만 하고, 보정은 전통적인 최적화가 맡습니다. 그래서 그라디언트(기울기)를 쓰는 방법도, 안 쓰는 방법도 모두 얹을 수 있습니다.
무엇을 알아냈나
핵심 숫자는 압도적입니다.
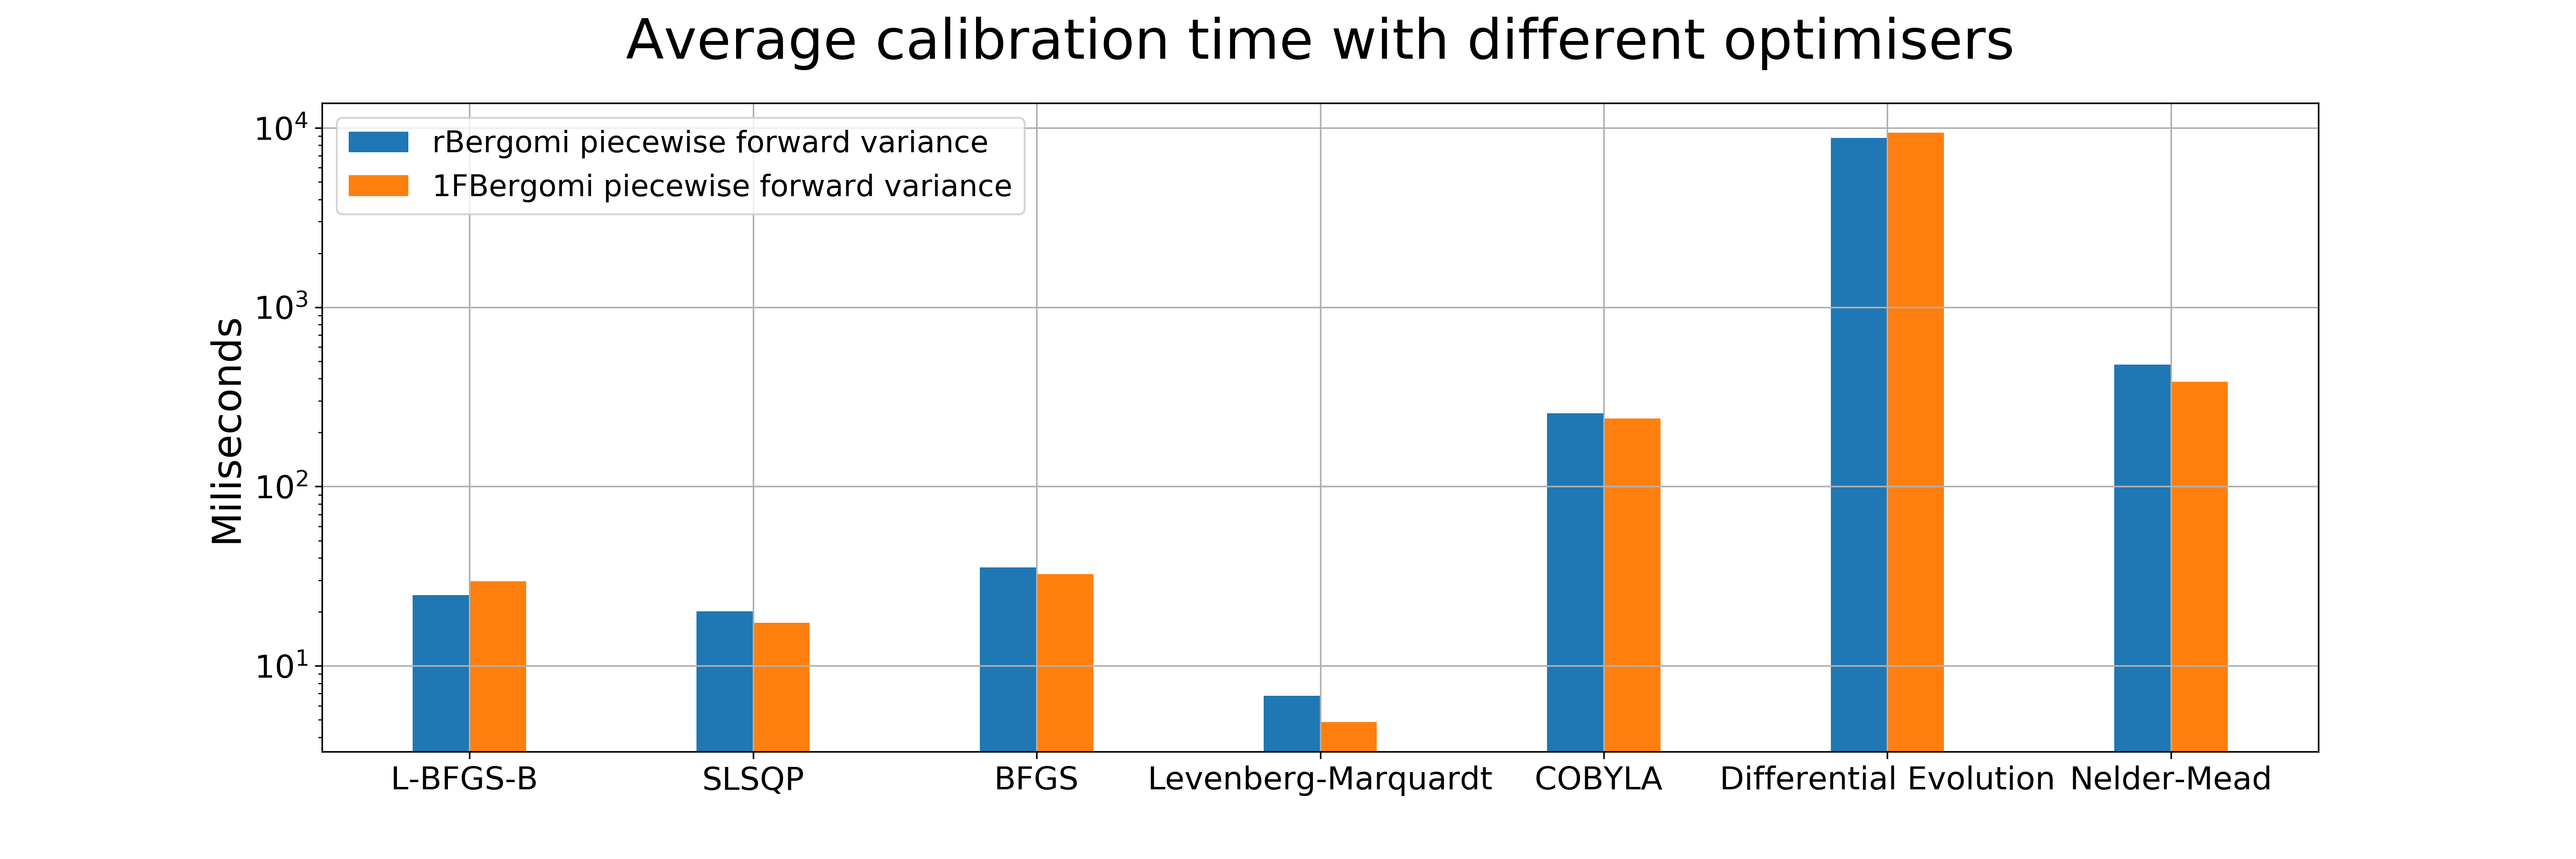
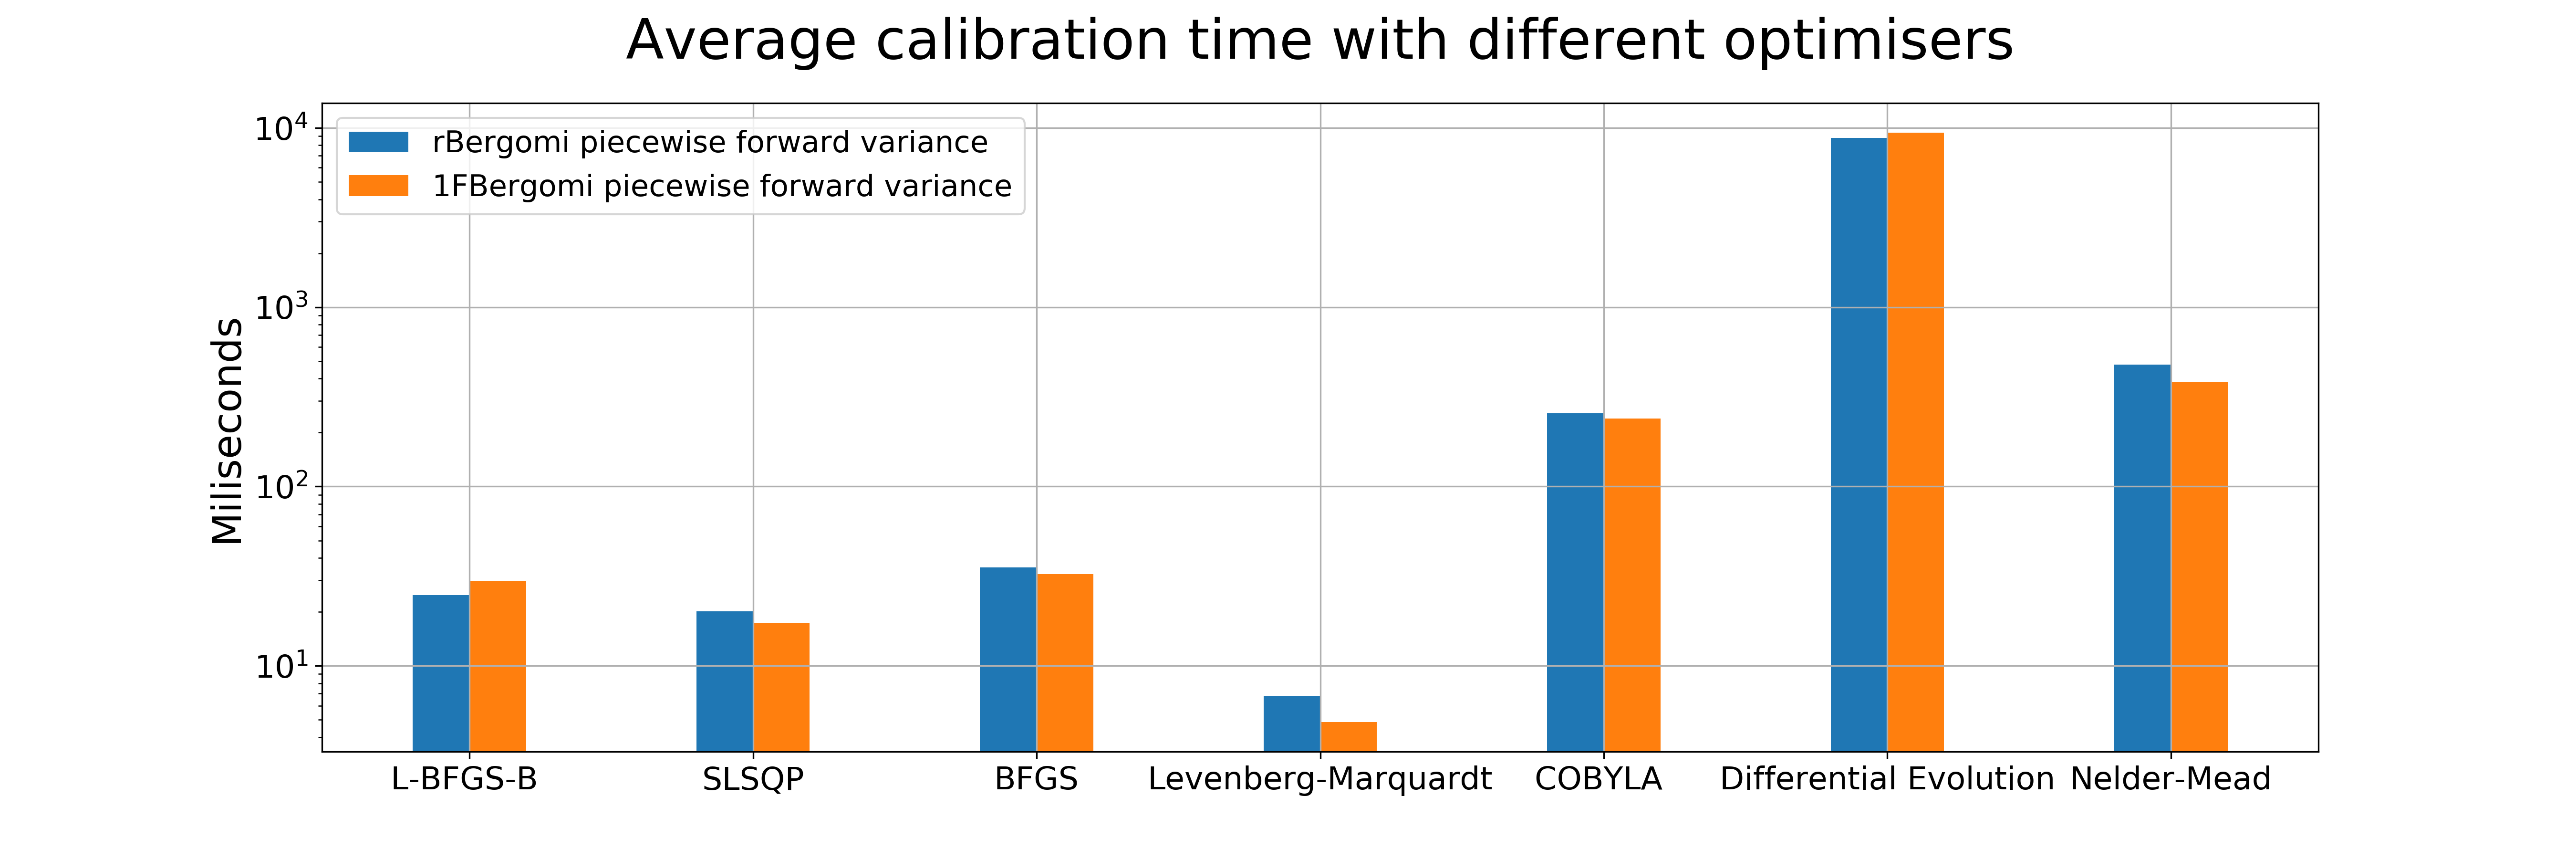
- 전체 내재변동성 표면 한 번 그리는 데, 몬테카를로는 0.3~0.5초(300,000~500,000 마이크로초)가 걸렸지만 신경망은 30.9마이크로초 — 약 9,000~16,000배 빠릅니다. 기울기까지 계산해도 113마이크로초에 불과합니다.
- 이 속도면 보정 작업 전체가 몇 밀리초에 끝납니다. "시장이 움직이는 동안 실시간으로 재보정"이 현실적으로 가능한 수준이죠.
- 놀라운 것은 속도만이 아닙니다. 신경망 근사의 오차가, 학습에 쓴 몬테카를로 계산 자체의 오차 범위(6만 개 경로 기준) 안에 머물렀습니다. 즉 "싼 계산기가 비싼 계산기보다 더 틀리지 않았다"는 뜻입니다.
- 시장 관점에서 보면: 유동성이 좋은 1년 미만 옵션의 호가 스프레드는 내재변동성 기준 약 0.2%인데, 신경망 오차는 내재변동성 20%일 때 상대 오차 약 1% 수준으로, 시장의 '소음'과 견줄 만합니다.
- 저자들은 8만 개 파라미터 조합 전반에서 오차 분포를 몬테카를로 벤치마크와 일일이 대조했고, 학습에서 본 적 없는 조합에서도 오차가 원래 계산기 수준으로 유지됨을 확인했습니다.
부수적인 재미도 있습니다. 저자들은 이 접근이 "어느 모형이 데이터에 더 잘 맞는지"를 분류하는 모형 식별(model recognition) 에도 쓸 수 있다고 말합니다. 가격 표면의 '생김새'에서 모형의 지문을 읽어 낼 수 있다는 것이죠.
한계와 조심할 점
- 신경망의 정확도는 결국 학습에 쓴 몬테카를로에 묶입니다. 학습 데이터가 덮지 않은 파라미터 영역에서는 보장이 없습니다. "학습 범위 밖의 시장 상황"이라는 근본적 한계가 남아 있습니다.
- 훈련 자체에는 상당한 계산 비용이 듭니다(다만 한 번이면 됩니다).
- 거래 비용, 유동성 같은 실전 마찰은 다루지 않은 이론-계산 연구입니다.
가볍게 더 보기
같은 방향의 연구들이 이달에 여럿 나왔습니다. 1901.06021은 Gaussian process와 베이지안 추론으로 국소변동성을 추정하면서, "단일 최적 보정값" 대신 보정 결과의 불확실성까지 확률적으로 추정합니다. 1901.11491은 레버리지 효과(가격이 떨어지면 변동성이 커지는 현상)를 포함한 변동성 모형에서, 베이지안 계산(MCMC)이 잘 섞이게 하는 파라미터 처리 기법을 다룹니다. 1901.08943은 신경망을 기존 옵션 계산기의 '고속 대체품'으로 쓰는 실용 프레임워크를, 1901.05672는 복잡한 경로의존 옵션 가격 계산에서 느린 회귀 단계를 제거해 병렬 처리를 가능하게 하는 수학 기법을 제안합니다.
이 테마의 공통 인사이트
이 논문들은 하나같이 "정확한 계산을 한 번 비싸게 해서, 싼 근사로 압축해 두라"고 말합니다. 그리고 그 근사가 얼마나 믿을 만한지(오차 범위, 불확실성 구간)를 반드시 함께 제시합니다. '예측의 마법'이 아니라 '계산의 대체재' 로서의 머신러닝 — 2019년 초 금융 AI가 자리매김한 지점입니다.
테마 2: 대주문의 무게 — 팔아야 할 때 팔기만 할까?
왜 흥미로운가
큰 주문을 한 번에 내면 시장 가격이 밀립니다. 100만 주를 팔겠다고 선언하면 가격이 떨어져서, 실제로는 더 싼 값에 팔게 되죠. 그래서 기관투자자는 주문을 잘게 쪼개 하루 종일 나눠 팝니다. 그런데 무엇을 기준으로 잘 팔았다고 평가할까요?
평가 기준은 여러 가지가 있습니다. '주문을 시작하기 직전의 가격'(Implementation Shortfall)과 비교하기도 하고, '그날 시장의 거래량 가중 평균 가격'(VWAP)과 비교하기도 합니다. 흔히 "시장 평균보다 싸게 팔았다"는 말이 후자죠. 놀랍게도 이 평가 기준의 선택이 최적 매매 전략을 통째로 바꿉니다.
대표 논문: Optimal VWAP execution — 벤치마크가 바뀌면 답이 달라진다
이 연구(1901.02327)는 HSBC의 Alexander Barzykin과 Bologna 대학의 Fabrizio Lillo가 발표했습니다. 시장 충격이 '시간에 걸쳐 서서히 사라지는'(transient) 현실적 모형에서, VWAP 벤치마크에 대한 최적 청산 전략을 수식으로 풀어냈습니다.
- 먼저 더 큰 틀을 제시합니다. 거래하는 구간과 VWAP을 계산하는 구간이 꼭 같을 필요가 없다는 겁니다. 이 틀 안에서 기존의 유명한 전략들 — Implementation Shortfall, Target Close, VWAP, TWAP — 이 모두 특수한 경우로 들어갑니다. "네비게이션의 목적지 설정이 바뀌면 경로가 바뀌는" 것과 같습니다.
- 위험을 싫어하는 투자자(위험회피도가 있는)를 가정하고, 연속 시간과 이산 시간 모두에서 명시적인 해를 구했습니다.
무엇을 알아냈나
이 논문의 가장 흥미로운 결론은 직관을 뒤집습니다.
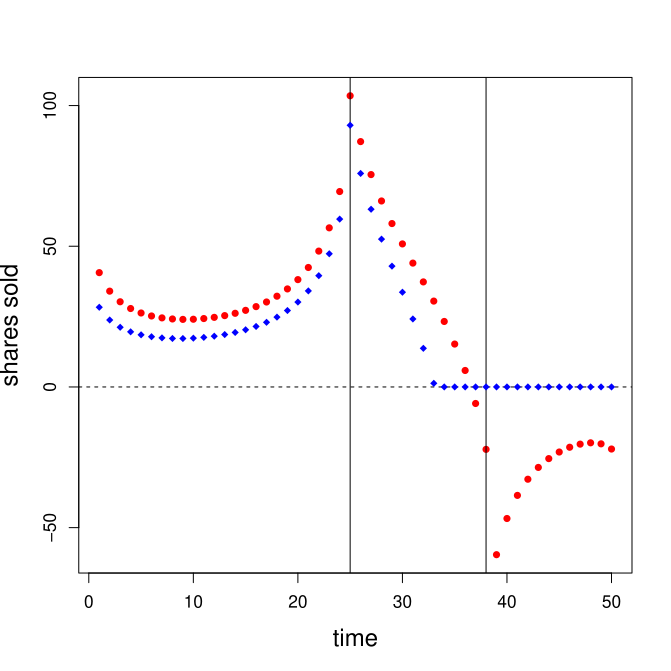
- 기존의 Implementation Shortfall 기준에서는 '팔 주문이면 계속 팔기만 하는 것'이 보통 최적이었습니다. 그런데 VWAP 기준에서는 최적해에 매수와 매도가 동시에 포함될 수 있습니다 — 시장 충격이 서서히 사라지는(볼록한 감쇠 커널) 경우에도 그렇습니다!
- 왜 그럴까요? VWAP은 '시장의 평균'에 대한 상대 평가입니다. 시장 평균보다 유리한 순간에 팔고, 불리한 순간에는 잠시 되사기도 하는 전략이 오히려 '평균보다 잘 팔았다'는 점수를 높일 수 있습니다. 시험에서 "전체 평균보다 높은 점수"를 목표로 하면 과목별로 유불리를 따지는 것과 비슷하죠.
- 벤치마크 측정 구간의 길이와 위치를 바꿔 가며, 브로커가 얻을 수 있는 '초과 이익'이 어떻게 변하는지도 수치로 보여 줍니다(논문의 이익 곡선 그림).
한계와 조심할 점
- 수수료 같은 거래 비용과 주문을 어떻게 쪼개어 내놓을지(자식 주문 배치)는 최적화에 포함되지 않았습니다. 실무 적용에는 이 조각이 더 필요합니다.
- 시장 충격이 '선형'이라는 가정에 의존합니다. 실제 시장의 비선형 충격은 다루지 않았습니다.
- 공개 코드가 없어(재현성 점수 42) 수치를 직접 재현하려면 독자에게 상당한 노력이 필요합니다.
가볍게 더 보기
같은 달에 나온 실증 연구 1901.05332는 이 이론의 '현실성'을 뒷받침합니다. 기관투자자의 실제 주문 800만 건 이상(ANcerno 데이터베이스)을 분석한 결과, 주문이 끝난 뒤에도 가격 충격이 수 주에 걸쳐 아주 서서히 사라졌습니다. 게다가 주문 흐름의 자기상관을 보정하면 장기적으로 남는 충격이 처음 충격의 약 절반에 이른다는, 냉정한 결론입니다. 1901.00617은 주문이 제대로 체결되지 않을 불확실성까지 고려해, 위험회피 성향이 청산 속도를 어떻게 바꾸는지 폐쇄형 공식으로 보여 줍니다.
이 테마의 공통 인사이트
"얼마나 빨리 팔 것인가"의 답은 "무엇을 기준으로 평가받는가" 에 달려 있습니다. 그리고 시장 충격은 주문이 끝나도 오래 남습니다. 이 두 사실을 함께 기억하면, 대규모 리밸런싱 전략을 설계할 때 '평가 기준 정의'부터 명시해야 한다는 실무적 교훈이 나옵니다.
테마 3: 주문 흐름에는 기억이 있다 — 큐와 흥분의 미시구조
왜 흥미로운가
주식을 사려면 주문장(호가창, limit order book)을 봅니다. "지금 이 가격에 팔겠다는 사람이 몇 주나 대기 중인가"가 쌓여 있는 장부죠. 이 장부에 주문이 도착하는 방식은 무작위가 아닙니다. 방금 전에 주문이 몰렸다면, 잠시 뒤에도 주문이 몰릴 가능성이 높습니다(자기흥분). 또 현재 대기 잔량이 얼마인가에 따라 주문이 올 확률이 달라집니다(큐 반응).
문제는 이 두 성질 — 과거 흐름의 기억과 현재 장부 상태의 영향 — 을 하나의 모형에서 잡아내기가 쉽지 않다는 것입니다.
대표 논문: Queue-reactive Hawkes models — 기억과 상태를 한 모형에
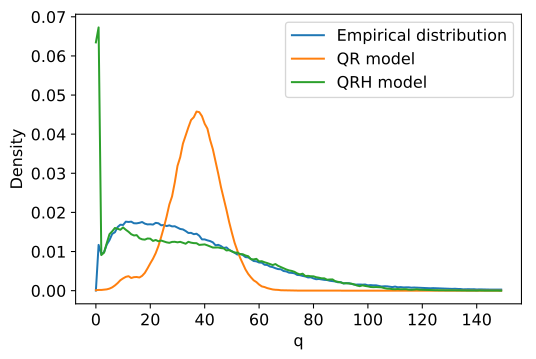
이 연구(1901.08938)는 Paris-Dauphine 대학과 CNRS의 Peng Wu, Marcello Rambaldi, Jean-François Muzy, Emmanuel Bacry 팀이 발표했습니다. 유럽 선물거래소(Eurex)의 독일 국채 선물(Bund)과 DAX 선물 실제 호가 데이터로 검증했습니다.
- 두 재료를 합치다: 주문장 상태에 반응하는 '큐 반응형(Queue-Reactive)' 모형에, 과거 주문 흐름에 흥분하는 'Hawkes 과정'을 더했습니다. 마치 "현재 도로 상황(큐)과 최근 교통 흐름(기억)을 모두 보고 다음 차가 올 확률을 예측하는" 것과 같습니다.
- 두 가지 변형(QRH-I, QRH-II)을 제시하고, 두 번째 모형은 최대우도추정과 최소제곱 두 방식 모두로 보정할 수 있게 했습니다.
무엇을 알아냈나
- Hawkes 항을 더하자, 순수 큐 반응형 모형이 재현하지 못하던 것들 — 이벤트 간 시간 간격의 분포, 대기 잔량 분포의 모양 — 이 크게 개선되었습니다. 모형이 만든 가짜 데이터와 실제 데이터가 거의 겹칩니다.
- 구체적 발견이 흥미롭습니다. 시장가 주문과 중간가격의 변화는 주로 호가 불균형(매수·매도 대기량의 비율)의 함수인 반면, 지정가 주문과 취소 주문의 도착률은 그렇지 않습니다. 즉 "호가가 기울었다"는 신호 하나로는 지정가·취소 흐름을 설명할 수 없다는 뜻입니다.
- 틱 크기가 작은 자산과 큰 자산 사이의 차이도 뚜렷하게 드러났습니다.
한계와 조심할 점
- 최우선 호가(Level-I) 데이터만 사용해, 호가창 깊은 층의 정보는 다루지 않았습니다.
- 상용 데이터(Eurex)에 의존해 재현성 점수가 낮습니다(38).
- 모형이 정교한 만큼 실전 트레이딩 로직에 넣기에는 엔지니어링 부담이 큽니다.
가볍게 더 보기
같은 테마의 연구들도 '주문 도착의 비무작위성'을 다룹니다. 1901.09729는 전력 인트라데이 시장의 거래 도착 간격을 시간대별로 변하는 분포로 모델링하고, 시뮬레이션 경로와 확률 예측으로 평가했습니다. 1901.00834는 서로 다른 시간 척도(초 단위 vs 분 단위)의 거래자 활동 사이 인과 네트워크를 추정해, 가격의 '시간 되돌림 비대칭'이라는 미시구조 현상의 기원을 밝혔습니다. 1901.08280은 고차원 호가창 데이터를 요약해 단기 예측에 쓰는 딥러닝 접근을 시도했습니다.
이 테마의 공통 인사이트
주문 흐름은 기억(과거 흐름)과 상태(현재 호가)의 결합으로 움직이며, 그 결합 방식은 주문 유형마다 다릅니다. 주문 흐름 시뮬레이터나 단기 예측 모델을 만들 때 "하나의 규칙으로 통일하지 말라"는 것이 이 달 미시구조 연구들의 공동 조언입니다.
테마 4: 숫자를 얼마나 믿을 수 있는가 — 리스크 계산의 신뢰성
왜 흥미로운가
2008년 금융위기 이후 은행 감독 규제의 핵심 키워드는 CVA(신용평가조정) 였습니다. 거래 상대방이 파산했을 때 잃을 돈의 현재가치를 뜻하는데, 국제결제은행(BIS) 집계로 위기 기간 총 신용 손실의 약 3분의 2가 CVA 손실이었습니다. 그래서 은행들은 매일같이 이 숫자를 계산해야 하는데, 계산이 어마어마하게 비쌉니다. 거래 상대방별로 모든 거래의 가치를 '시장 위험 + 신용 위험' 아래 동시에 시뮬레이션해야 하기 때문입니다.
여기에 2019년 1월의 연구자들은 두 가지 질문을 던집니다. 계산을 빠르게 만들 수 있는가? 그리고 빠르게 만든 숫자를 얼마나 믿을 수 있는가?
대표 논문: Gaussian Process로 CVA 계산하기 — 빠르게, 그리고 '오차 표시'와 함께
이 연구(1901.11081)는 Paris-Saclay 대학의 Stéphane Crépey와 Illinois Institute of Technology의 Matthew Dixon이 발표했으며, 이 달 전체에서 가장 높은 평가(종합점수 72.0) 를 받았습니다.
- 메타모델 아이디어: 파생상품 포트폴리오의 '가치 지도'(시나리오 × 시간 × 거래별 평가액)를 다중 출력 Gaussian process 회귀로 학습합니다. Gaussian process는 "예측값과 함께 그 예측의 신뢰 구간까지 돌려주는" 통계 모델입니다. 요리로 치면 "맛을 예측할 뿐 아니라, 이 예측이 틀릴 확률도 함께 말해 주는" 요리책인 셈입니다.
- 이렇게 하면 계산량을 폭발시키던 중첩 시뮬레이션(시뮬레이션 속의 시뮬레이션)이 사라집니다. 이후에는 위험 요인의 움직임만 시뮬레이션하면 됩니다.
- 베이지안 장점: 학습 데이터에서 멀리 떨어진 지점의 가치를 추정할 때, 신경망과 달리 Gaussian process는 "여기서는 나도 잘 모르겠다"를 95% 불확실성 밴드로 정직하게 표시합니다.
무엇을 알아냈나
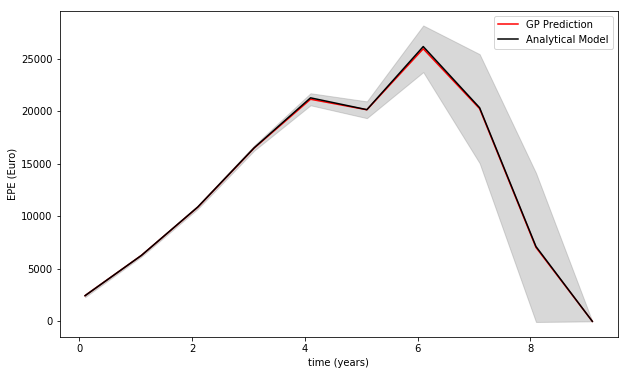
- 금리 스왑 포트폴리오 실험에서, Gaussian process 메타모델이 계산한 CVA가 완전 재평가(모든 것을 다시 계산한 값)와 0.25% 이내로 일치했습니다. "빠르지만 틀리지 않았다"는 증명입니다.
- 커널을 한 번 학습하면 비싼 가격결정·민감도(그리크) 계산이 더 이상 필요 없고, 포트폴리오를 바꾸는(리밸런싱) 유연성도 유지됩니다. 위험 요인에 대한 민감도는 공식 형태로 바로 나옵니다.
- 학습 표본 100개로도 수렴이 잘 되었고, 기대노출(EPE) 프로파일이 해석 모형과 겹치면서 95% 불확실성 밴드가 함께 그려졌습니다(위 그림의 회색 띠가 바로 그것입니다).
- 대규모 포트폴리오는 하위 포트폴리오별로 모델을 나누는 '분할 정복'으로 확장할 수 있습니다 — 병렬 처리가 가능해 현실적입니다.
한계와 조심할 점
- 검증 대상이 단순한 금리 스왑 포트폴리오입니다. 복잡한 옵션이나 대규모 다자산 포트폴리오에서는 추가 검증이 필요합니다.
- Gaussian process의 계산 비용은 학습점 수에 민감해서, 대규모에서는 분할 정복이 거의 필수입니다.
- 위험 요인 자체의 모형이 틀리면(모형 위험) 이 계산도 틀립니다. 계산 근사의 오차만 다룬 연구입니다.
가볍게 더 보기
이 달의 리스크·포트폴리오 연구는 모두 "점 추정이 아니라 분포와 불확실성을 다루라" 는 방향입니다. 1901.10989는 거래비용과 변동성이 시장 안에서 함께 결정된다는 균형 모형을 제시해, 유동성 프리미엄과 변동성의 관계를 수학적으로 도출했습니다(엄밀성 점수 84로 이 달 최고 수준). 1901.00997은 CVaR(극단적 손실의 평균)을 추정할 때 추정 오차가 얼마나 될지의 확률적 한계(집중 경계)를 경량·중량 꼬리 분포 모두에서 제시합니다. 1901.09309는 요인모형의 잔차가 평균회귀한다는 성질과 확률제어를 결합해, 거래비용을 포함한 시장중립 차익 전략을 '사람이 읽을 수 있는' 형태로 도출합니다. 1901.07450은 시간에 따른 정보 구조까지 반영하는 새로운 거리 측도(adapted Wasserstein 거리)로, 헤징과 효용 최적화가 모델 오차에 얼마나 안정적인지를 정량화하는 이론 작업입니다.
이 테마의 공통 인사이트
"얼마가 나왔는가"보다 "그 숫자를 얼마나 믿을 수 있는가" 가 2019년 1월 리스크 연구의 중심 화두입니다. 계산을 가속할 때도 오차를 함께 표시하고(1901.11081), 추정치에는 확률적 한계를 붙이고(1901.00997), 모델 오차에 대한 안정성을 수학으로 측정합니다(1901.07450). 빠른 숫자와 정직한 오차 표시는 한 세트입니다.
테마 5: AI 트레이더의 첫 실험실 — 데이터가 적으면 만들면 된다?
왜 흥미로운가
"AI가 스스로 매매하면 돈을 벌 수 있을까?" — 강화학습(시행착오로 최적 행동을 배우는 AI)이 게임과 로봇에서 성공한 뒤, 금융에서도 이 질문이 뜨거워졌습니다. 그런데 금융은 게임과 다릅니다. 바둑은 수천만 판을 둘 수 있지만, 주식 데이터는 10년치 일봉이 약 2,500개뿐입니다. 데이터가 너무 적어 AI가 제대로 배우기 어렵습니다.
2019년 1월, 이 문제를 정면으로 다룬 연구들이 등장합니다. "금융이라는 특수한 환경에 맞게 AI 학습 구조 자체를 보완하자"는 실험들입니다.
대표 논문: Model-based Deep RL for Dynamic Portfolio Optimization — 예측·합성·모방의 3종 세트
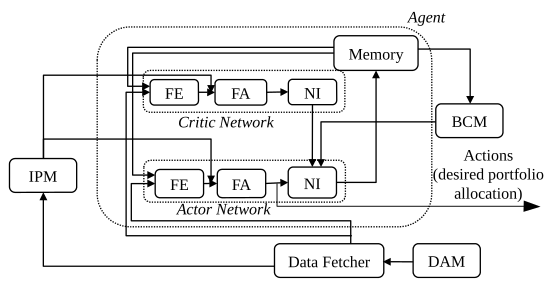
이 연구(1901.08740)는 싱가포르 Neuri 팀이 발표했습니다. 순수 강화학습 대신 세 가지 보조 모듈을 결합한 것이 핵심입니다.
- 예측 주입 모듈(IPM): 포트폴리오 안 모든 자산의 가격 움직임을 함께 예측하는 시계열 예측 모델(비선형 동적 볼츠만 기계와 WaveNet 변형 두 가지를 실험)을 두고, 그 예측을 강화학습 에이전트의 '추가 특징'으로 넣어 줍니다. "오늘의 날씨 예보를 보고 외출 계획을 세우는" 것과 비슷하죠.
- 데이터 증강 모듈(DAM): 재귀 GAN(생성적 적대 신경망)으로 가짜 가격 시계열을 만들어 학습 데이터를 불립니다. 진짜와 구분하기 어려운 합성 데이터를 목표로 하며, 통계 검정(KS 검정)으로 품질을 확인했습니다. "문제집이 부족하면 비슷한 유형의 문제를 만들어 더 푸는" 전략입니다.
- 행동 복제 모듈(BCM): 위험을 줄이는 우수한 행동을 모방하게 해, 수익-위험 비율을 지키면서 포트폴리오 변동성을 낮춥니다.
그리고 백테스트 환경에 현실의 제약을 되돌려 넣었습니다 — 주문은 '다음 봉(막대)의 시가'에 체결되고(즉시 체결 가정 없음), 슬리피지(예상 가격과 실제 체결 가격의 차이)가 붙고, 소수점 주문은 불가입니다.
무엇을 알아냈나
실험은 미국 주식 6종(Costco, Cisco, Ford, Goldman Sachs, AIG, Caterpillar)과 현금, 그리고 S&P 500 지수를 참고 특징으로 쓰는 소규모 포트폴리오에서 진행했습니다. 훈련은 20052016년, 테스트는 2017년 1월2018년 12월, 초기 자금은 미화 50만 달러. 거래 수수료 20bp와 슬리피지 50bp를 가정한, 꽤 깐깐한 설정입니다.
- 기준선(단순 균등 배분 전략)은 최종 자산 574,859달러, 샤프 비율(위험 1단위당 수익) 0.57이었습니다. 순수 강화학습 기준선은 570,482달러, 샤프 0.56으로 오히려 약간 밀렸습니다. "AI가 무조건 잘한다"는 통념이 깨지는 첫 대목입니다.
- 예측 모듈(IPM)만 추가하자 샤프가 0.56 → 0.61, 소르티노 비율(하방 위험 기준) 0.78 → 0.87로 크게 개선됐습니다. 다만 변동성이 12.79% → 14.14%로 높아져 과적합 신호가 보였습니다.
- 데이터 증강(DAM) 은 이 과적합을 눌렀습니다(변동성 14.14% → 12.84%). 행동 복제(BCM) 는 최대 낙폭(MDD)을 12.7% → 12.4%로 줄였습니다.
- 세 모듈을 모두 켜자: 최종 자산 580,899달러, 연율 수익 8.09%, 변동성 12.77%, 샤프 0.63, 소르티노 0.89, 최대 낙폭 12.40% — 모든 기준선을 넘어선 최고의 위험 대비 수익이 나왔습니다.
한 줄로 요약하면: "예측을 넣어 수익을 높이고, 합성 데이터로 과적합을 막고, 모방으로 위험을 낮추라." 세 기법이 서로의 부작용을 보완한 결과입니다.
한계와 조심할 점
- 자산 6종이라는 극소형 포트폴리오, 약 2년짜리 단일 테스트 구간의 결과입니다(엄밀성 점수 52). 샤프 0.56→0.63의 개선이 다른 시장 국면에서도 유지될지는 알 수 없습니다.
- 회사 내부 연구로, 데이터와 코드의 공개 계획이 '추후'로만 표기되어 재현성 점수가 낮습니다(42). "공개됐다"와 "공개 예정이다"는 다르죠.
- 하루 한 번(일간) 의사결정 기준의 저빈도 전략이라, 고빈도나 대규모 자금에는 그대로 적용하기 어렵습니다.
가볍게 더 보기
같은 달의 연구들은 'AI 트레이딩의 재료'를 여러 각도에서 다듬습니다. 1901.01751은 GAN으로 트레이딩 전략을 미세조정하고 여러 전략을 조합하는 앙상블 기법을 579개 자산에서 검증했습니다. 1901.11493은 재귀 신경망으로 '시간에 따라 변하는 비선형 팩터'를 모델링해, 예측력과 해석 가능성을 동시에 노립니다. 1901.01832은 '가격의 극값'이 품은 경제적 가치를 실증 분석해, 잠재 최대 손실이 잠재 최대 이익을 선행 예측한다는 흥미로운 비대칭을 보고합니다.
이 테마의 공통 인사이트
2019년 초의 강화학습 트레이딩 연구는 "AI로 돈을 벌 수 있나"보다 "금융이라는 환경에서 AI를 제대로 학습시키려면 무엇을 보완해야 하나" 를 묻습니다. 데이터가 적으면 합성하고(GAN), 예측을 특징으로 넣고(IPM), 위험을 모방으로 억제하며(BCM), 백테스트에 현실적 제약을 넣는다 — 이후 수년간의 트레이딩 AI 연구가 되돌아오게 될 실험실의 첫 설계도입니다.
이 달 전체를 관통하는 메시지
2019년 1월의 다섯 이야기는 하나의 문장으로 모입니다 — "정확함과 빠름의 딜레마를 '근사의 엔지니어링'으로 풀고, 그 근사가 얼마나 믿을 만한지 함께 말하라." 느린 몬테카를로를 신경망으로 증류해 밀리초 캘리브레이션을 실현하고(테마 1), 중첩 시뮬레이션을 Gaussian process로 대체하되 95% 신뢰 구간을 달고(테마 4), 대주문 실행에서는 '평가 기준이 바뀌면 답이 바뀐다'는 현실을 직시하며(테마 2), 주문 흐름은 기억과 상태의 결합임을 실제 데이터로 확인하고(테마 3), 강화학습에는 예측·합성·모방이라는 현실적 보조 바퀴를 달았습니다(테마 5).
이 달의 연구가 특별한 이유는, 머신러닝이 '예측의 마법'이 아니라 '계산의 대체재이자 추정의 도구' 로 자리매김한 시점의 기록이기 때문입니다. 놀랍게도 가장 현대적으로 느껴지는 교훈은 오히려 검증에 있습니다 — 근사 오차를 원래 계산기와 대조하고, 보정 불확실성을 수치로 표시하며, 백테스트에 슬리피지와 수수료를 되돌려 넣는 태도. 2020년대의 'AI 트레이딩이 정말 돈을 버는가'라는 질문 앞에서, 우리는 여전히 2019년 1월의 이 기본기를 시험하고 있습니다.
더 알아보기
원문 링크와 5차원 평가 점수
이 글에서 다룬 논문들의 원문과, 우리 지식 베이스가 매긴 5차원 점수입니다(신규성 / 적용성 / 엄밀성 / 재현성 / 통찰, 종합점수는 이들의 가중 합).
| 논문 | 티어 | 종합 | 신규성 | 적용성 | 엄밀성 | 재현성 | 통찰 |
|---|---|---|---|---|---|---|---|
| 1901.11081 Gaussian process CVA 계산 | A | 72.0 | 67 | 78 | 70 | 76 | 68 |
| 1901.09647 Deep Learning Volatility | A | 68.8 | 68 | 76 | 63 | 70 | 67 |
| 1901.02327 최적 VWAP 실행 | A | 67.0 | 72 | 78 | 73 | 42 | 76 |
| 1901.10989 거래비용 균형 자산가격 | A | 66.0 | 76 | 49 | 84 | 38 | 78 |
| 1901.05332 시장충격의 느린 감쇠(ANcerno) | A | 65.8 | 68 | 76 | 75 | 38 | 80 |
| 1901.07450 Adapted Wasserstein 거리 | A | 65.0 | 76 | 43 | 84 | 42 | 78 |
| 1901.00997 CVaR 추정 집중 경계 | B | 64.5 | 67 | 65 | 76 | 43 | 64 |
| 1901.06021 확률적 국소변동성 추정 | B | 62.2 | 68 | 62 | 68 | 42 | 66 |
| 1901.11491 레버리지 확률변동성 MCMC | B | 62.0 | 57 | 62 | 75 | 48 | 60 |
| 1901.09309 고차원 통계 차익거래 | B | 61.6 | 70 | 61 | 69 | 40 | 63 |
| 1901.08938 Queue-reactive Hawkes 주문 흐름 | B | 59.9 | 70 | 62 | 72 | 38 | 70 |
| 1901.08740 모델 기반 강화학습 포트폴리오 | B | 59.8 | 69 | 65 | 52 | 42 | 61 |
| 1901.01751 GAN 전략 미세조정 | B | 59.7 | 67 | 61 | 59 | 43 | 62 |
| 1901.09729 전력 인트라데이 거래 도착 | B | 59.4 | 62 | 64 | 67 | 47 | 61 |
| 1901.00834 가격 시간역전 비대칭의 기원 | B | 58.9 | 73 | 55 | 67 | 40 | 76 |
| 1901.00617 동적 위험조정 최적 청산 | B | 58.7 | 70 | 61 | 72 | 35 | 69 |
| 1901.11493 Deep Recurrent Factor Model | B | 56.2 | 62 | 68 | 48 | 38 | 61 |
| 1901.08280 Neural Bag-of-Features 단기 예측 | B | 54.5 | 65 | 68 | 42 | 30 | 52 |
| 1901.01832 가격 극값의 경제적 가치 | B | 54.4 | 58 | 63 | 53 | 30 | 61 |
| 1901.08943 신경망 옵션 가격·내재변동성 | B | 54.1 | 55 | 72 | 55 | 25 | 52 |
| 1901.05672 Wiener chaos Bermudan 옵션 | B | 52.4 | 72 | 48 | 66 | 32 | 62 |
우리 지식 베이스에서 함께 읽을 논문
- 변동성 보정·파생 가격결정 계열: Deep Smoothing of the Implied Volatility Surface, Beyond Surrogate Modeling: Learning the Local Volatility Via Shape Constraints, No-Arbitrage Deep Calibration for Volatility Smile and Skewness
- 최적 실행 계열: Learning a functional control for high-frequency finance, Optimal multi-asset trading with linear costs: a mean-field approach, Optimal Execution under Incomplete Information
- 호가창·주문 흐름 계열: LOB modeling using Hawkes processes with a state-dependent factor, From Zero-Intelligence to Queue-Reactive: Limit Order Book modeling, JAX-LOB: A GPU-Accelerated limit order book simulator
- CVA·리스크 계산 계열: Smooth Nested Simulation: Bridging Cubic and Square Root Convergence Rates, CVA Sensitivities, Hedging and Risk, CVA Hedging by Risk-Averse Stochastic-Horizon Reinforcement Learning
- 강화학습 포트폴리오 계열: FinRL: Deep Reinforcement Learning Framework to Automate Trading, WaveCorr: Correlation-savvy Deep Reinforcement Learning for Portfolio Management, Adaptive learning for financial markets mixing model-based and model-free RL
이 글은 2019년 1월 arXiv 백필 코호트(전체 101편, 관련 54편)의 평가 결과를 바탕으로 작성했습니다. 모든 수치는 원문 논문에서 인용했으며, 블로그 성격상 일부 이론적 세부사항은 생략했습니다. 심층 분석은
analysis/reports/backfill/1901.md를 참고하세요.
📚 이 글에서 다룬 논문 (36편)
- A
- AOptimal VWAP execution under transient price impact
Alexander Barzykin, Fabrizio Lillo
- AEquilibrium Asset Pricing with Transaction Costs
Martin Herdegen, Johannes Muhle-Karbe, Dylan Possamaï
- ASlow decay of impact in equity markets: insights from the ANcerno database
Frédéric Bucci, Michael Benzaquen, Fabrizio Lillo 외 1명
- AAdapted Wasserstein Distances and Stability in Mathematical Finance
Julio Backhoff-Veraguas, Daniel Bartl, Mathias Beiglböck 외 1명
- BA Probabilistic Approach to Nonparametric Local Volatility
Martin Tegnér, Stephen Roberts
- BApproaches Toward the Bayesian Estimation of the Stochastic Volatility Model with Leverage
Darjus Hosszejni, Gregor Kastner
- BPricing options and computing implied volatilities using neural networks
Shuaiqiang Liu, Cornelis W. Oosterlee, Sander M. Bohte
- BOptimal execution with dynamic risk adjustment
Xue Cheng, Marina Di Giacinto, Tai-Ho Wang
- BQueue-reactive Hawkes models for the order flow
Peng Wu, Marcello Rambaldi, Jean-François Muzy 외 1명
- BEstimation and simulation of the transaction arrival process in intraday electricity markets
Michał Narajewski, Florian Ziel
- BThe market nanostructure origin of asset price time reversal asymmetry
Marcus Cordi, Damien Challet, Serge Kassibrakis
- BConcentration bounds for CVaR estimation: The cases of light-tailed and heavy-tailed distributions
Prashanth L. A., Krishna Jagannathan, Ravi Kumar Kolla
- BModel-based Deep Reinforcement Learning for Dynamic Portfolio Optimization
Pengqian Yu, Joon Sern Lee, Ilya Kulyatin 외 2명
- BGenerative Adversarial Networks for Financial Trading Strategies Fine-Tuning and Combination
Adriano Koshiyama, Nick Firoozye, Philip Treleaven
- BDeep Recurrent Factor Model: Interpretable Non-Linear and Time-Varying Multi-Factor Model
Kei Nakagawa, Tomoki Ito, Masaya Abe 외 1명
- BTiming the market: the economic value of price extremes
Haibin Xie, Shouyang Wang
- BTemporal Logistic Neural Bag-of-Features for Financial Time series Forecasting leveraging Limit Order Book Data
Nikolaos Passalis, Anastasios Tefas, Juho Kanniainen 외 2명
- ADeep Smoothing of the Implied Volatility Surface
Damien Ackerer, Natasa Tagasovska, Thibault Vatter
- ABeyond Surrogate Modeling: Learning the Local Volatility Via Shape Constraints
Marc Chataigner, Areski Cousin, Stéphane Crépey 외 2명
- ANo-Arbitrage Deep Calibration for Volatility Smile and Skewness
Kentaro Hoshisashi, Carolyn E. Phelan, Paolo Barucca
- ALearning a functional control for high-frequency finance
Laura Leal, Mathieu Laurière, Charles-Albert Lehalle
- BOptimal multi-asset trading with linear costs: a mean-field approach
Matt Emschwiller, Benjamin Petit, Jean-Philippe Bouchaud
- AOptimal Execution under Incomplete Information
Etienne Chevalier, Yadh Hafsi, Vathana Ly Vath
- ALOB modeling using Hawkes processes with a state-dependent factor
Emmanouil Sfendourakis, Ioane Muni Toke
- AFrom Zero-Intelligence to Queue-Reactive: Limit Order Book modeling for high-frequency volatility estimation and optimal execution
Tommaso Mariotti, Fabrizio Lillo, Giacomo Toscano
- AJAX-LOB: A GPU-Accelerated limit order book simulator to unlock large scale reinforcement learning for trading
Sascha Frey, Kang Li, Peer Nagy 외 5명
- ASmooth Nested Simulation: Bridging Cubic and Square Root Convergence Rates in High Dimensions
Wenjia Wang, Yanyuan Wang, Xiaowei Zhang
- BCVA Sensitivities, Hedging and Risk
Stéphane Crépey, Botao Li, Hoang Nguyen 외 1명
- BCVA Hedging by Risk-Averse Stochastic-Horizon Reinforcement Learning
Roberto Daluiso, Marco Pinciroli, Michele Trapletti 외 1명
- AFinRL: Deep Reinforcement Learning Framework to Automate Trading in Quantitative Finance
Xiao-Yang Liu, Hongyang Yang, Jiechao Gao 외 1명
- AWaveCorr: Correlation-savvy Deep Reinforcement Learning for Portfolio Management
Saeed Marzban, Erick Delage, Jonathan Yumeng Li 외 2명
- BAdaptive learning for financial markets mixing model-based and model-free RL for volatility targeting
Eric Benhamou, David Saltiel, Serge Tabachnik 외 2명
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2025-09 월간
월간 종합 블로그: 2025년 9월 — RL 포트폴리오의 이론적 한계와 새로운 수학적 도구의 등장
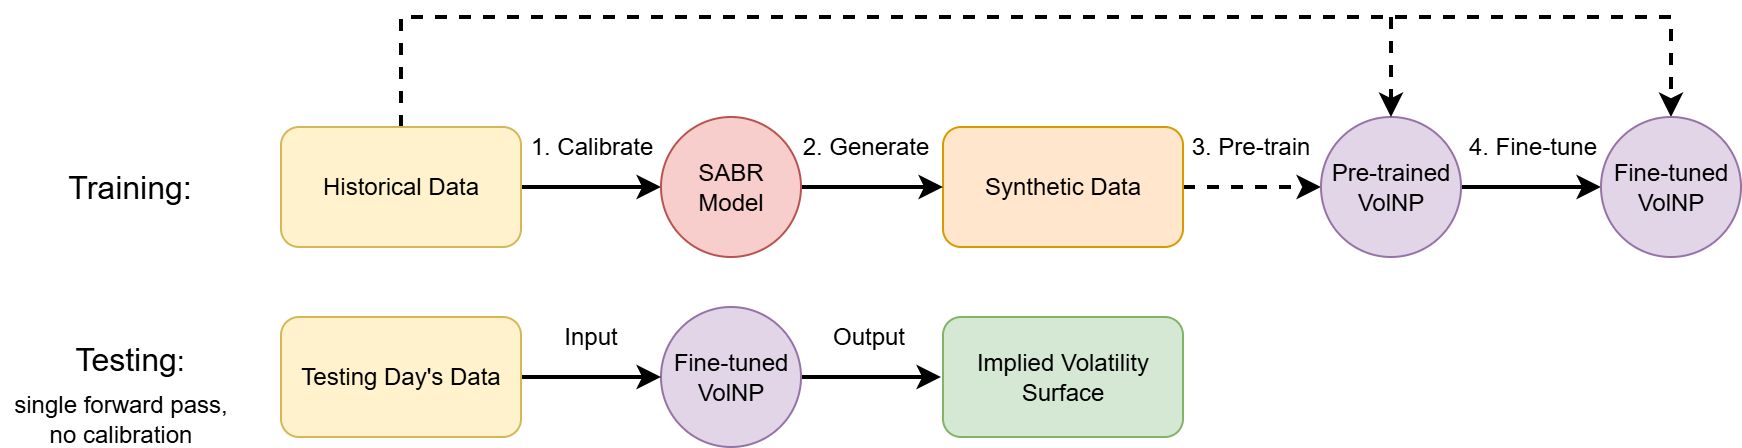
2025년 9월 arXiv에 공개된 AI 금융 연구를 5가지 테마로 정리합니다. 강화학습 포트폴리오의 이론적 한계, GFlowNet 기반 알파 마이닝, SABR 메타러닝 IVS 복원, 확산모델 포트폴리오 최적화, LLM 트레이딩 에이전트까지 — 전통 수리금융과 생성 AI가 결합하는 새로운 흐름을 살펴봅니다.
 📊 2019-07 월간A
옵션 가격결정과 거친 변동성, 그리고 Quant GANs: 2019년 7월 금융 AI 논문
2019년 7월 arXiv 금융 AI 연구를 5개 테마로 정리했습니다. 모델 없이 옵션 가격 상한을 구하는 수학, 미시구조에서 태어나는 거친 변동성, 금융 시계열을 생성하는 Quant GANs, 로보 투자의 진짜 수혜자, 강화학습 자산배분 — 생성형 AI 이전의 기초 공사 현장을 다룹니다.
 📊 2019-03 월간A
2019년 3월 금융 AI 연구: 거친 변동성에서 감정 네트워크까지
2019년 3월 arXiv에 올라온 금융 AI 논문 56편을 5개 테마로 정리했습니다. 거친 변동성 옵션 가격의 근사 수학, 신경망 조건부 밀도 추정 벤치마크, 공분산 앙상블 리스크 모형, 시장조성 백테스트의 함정, 1,944개 암호화폐의 감정 네트워크까지 — 예측이 아니라 분포와 근사가 중심이던 시대의 연구입니다.