7년 전 오늘의 금융 AI 연구는, 화려한 인공지능 대신 "시장의 마찰을 수학으로 다루는 법"을 묻고 있었습니다.
매달 arXiv에 쏟아지는 수백 편의 금융 AI 논문 중에서 의미 있는 연구를 골라 정리합니다. 이번 달(2019년 2월)은 특별히 돌아보기 좋은 시기입니다. 지금은 당연해 보이는 질문들 — "옵션 가격표를 어떻게 하면 모순 없이 만들까", "내 위험 예측이 정말 맞는지 어떻게 검증할까", "규제가 최소 가격 단위를 바꾸면 시장은 어떻게 반응할까" — 을 이때 사람들이 어떻게 정리하기 시작했는지 볼 수 있기 때문입니다.
들어가며: 2019년 2월, 무슨 일이 있었나
2019년 초의 금융 AI 세계는 지금과 사뭇 달랐습니다. 요즘 화제인 대규모 언어모델(LLM) 트레이딩 에이전트는 아직 세상에 없었고, "AI로 종목 고르기"보다는 수학과 통계로 시장의 규칙을 정확히 적는 일이 연구의 중심이었습니다.
이 달 arXiv의 금융 관련 논문 120편 가운데 우리 기준으로 의미 있는 연구는 65편이었고, 그중 최고 등급(A등급) 10편은 전부 가격결정·위험 측정·시장 미시구조·포트폴리오 이론이었습니다. 쉽게 말해 "더 똑똑한 예측 모델"이 아니라 "예측이 틀릴 때를 대비한 정직한 장치들"이 이 달의 주인공입니다.
이번 글은 그 65편을 다섯 갈래로 묶어 소개합니다.
- 옵션 가격을 모순 없이 빠르게 그리는 법
- 위험 예측을 "채점"하는 법
- 호가장(주문이 쌓인 장부)의 법칙
- 제약이 걸린 포트폴리오를 짜는 법
- 데이터가 흔들려도 버티는 AI의 입력 다루기
테마 1: 옵션 가격표를 모순 없이, 그리고 빠르게
시장의 "감정가 지도"가 어긋나면 생기는 일
옵션을 사고팔 때 우리는 사실 "변동성"을 사고파는 셈입니다. 주가가 앞으로 얼마나 흔들릴지를 예상한 값이 옵션 가격에 들어 있기 때문이죠. 이렇게 만기(언제)와 행사가격(얼마에)별로 뽑아낸 변동성의 지도를 내재변동성 표면(implied volatility surface)이라고 합니다.
문제는 이 지도가 실제 시세와 어긋나 있으면 돈이 새는 구멍이 생긴다는 점입니다. 예를 들어 지도가 "3월 옵션은 1월 옵션보다 비싸다"고 말하는데 실제 시세가 그 반대라면, 지도를 믿고 거래한 사람들은 무의미한 차익 기회에 노출됩니다. 이런 모순(무차익 조건 위반) 없이, 동시에 시장의 매수·매도 호가 사이(bid-ask 스프레드)에 정확히 들어맞는 지도를 그리는 것은 시장조성자의 오래된 숙제였습니다.
대표 논문: 0.1초 만에 무차익 변동성 표면을 짓는 Sinkhorn 알고리즘 (1902.04456)
Building arbitrage-free implied volatility: Sinkhorn's algorithm and variants (De March, Henry-Labordère)
이 논문이 던진 질문은 단순합니다. "무차익이고, 시세에 완벽히 들어맞고, 심지어 실적 발표 직전처럼 스마일 모양이 찌그러져 있는 경우까지, 그것도 빠르게 만들 수 있을까?"
정답의 열쇠는 수학의 다른 분야에서 왔습니다. 최적수송(optimal transport) — 두 확률 분포 사이를 "가장 싼 비용으로" 옮기는 방법을 연구하는 분야인데, 2013년에 이 문제를 놀랍도록 빠르게 푸는 Sinkhorn 알고리즘이 등장했습니다. 저자들은 이 아이디어를 옵션 가격 문제에 맞게 "마팅게일" 조건(미래 가격 기대값이 현재 가격과 같아야 한다는 자산가격의 기본 규칙)을 지키도록 개조했습니다.
쉽게 비유하면 이렇습니다. 공중에 떠 있는 모래(현재 가격 분포)를 여러 목표 지점(만기 가격 분포)으로 옮겨야 하는데, 단 옵션 시세라는 "이름표 가격"과 충돌하지 않아야 합니다. 이 논문의 알고리즘은 그 조건들을 만족하는 모래 이동 계획을 반복 수정하며 찾아내고, 그것이 수렴한다는 것을 증명했습니다.
핵심 결과는 실무적입니다.
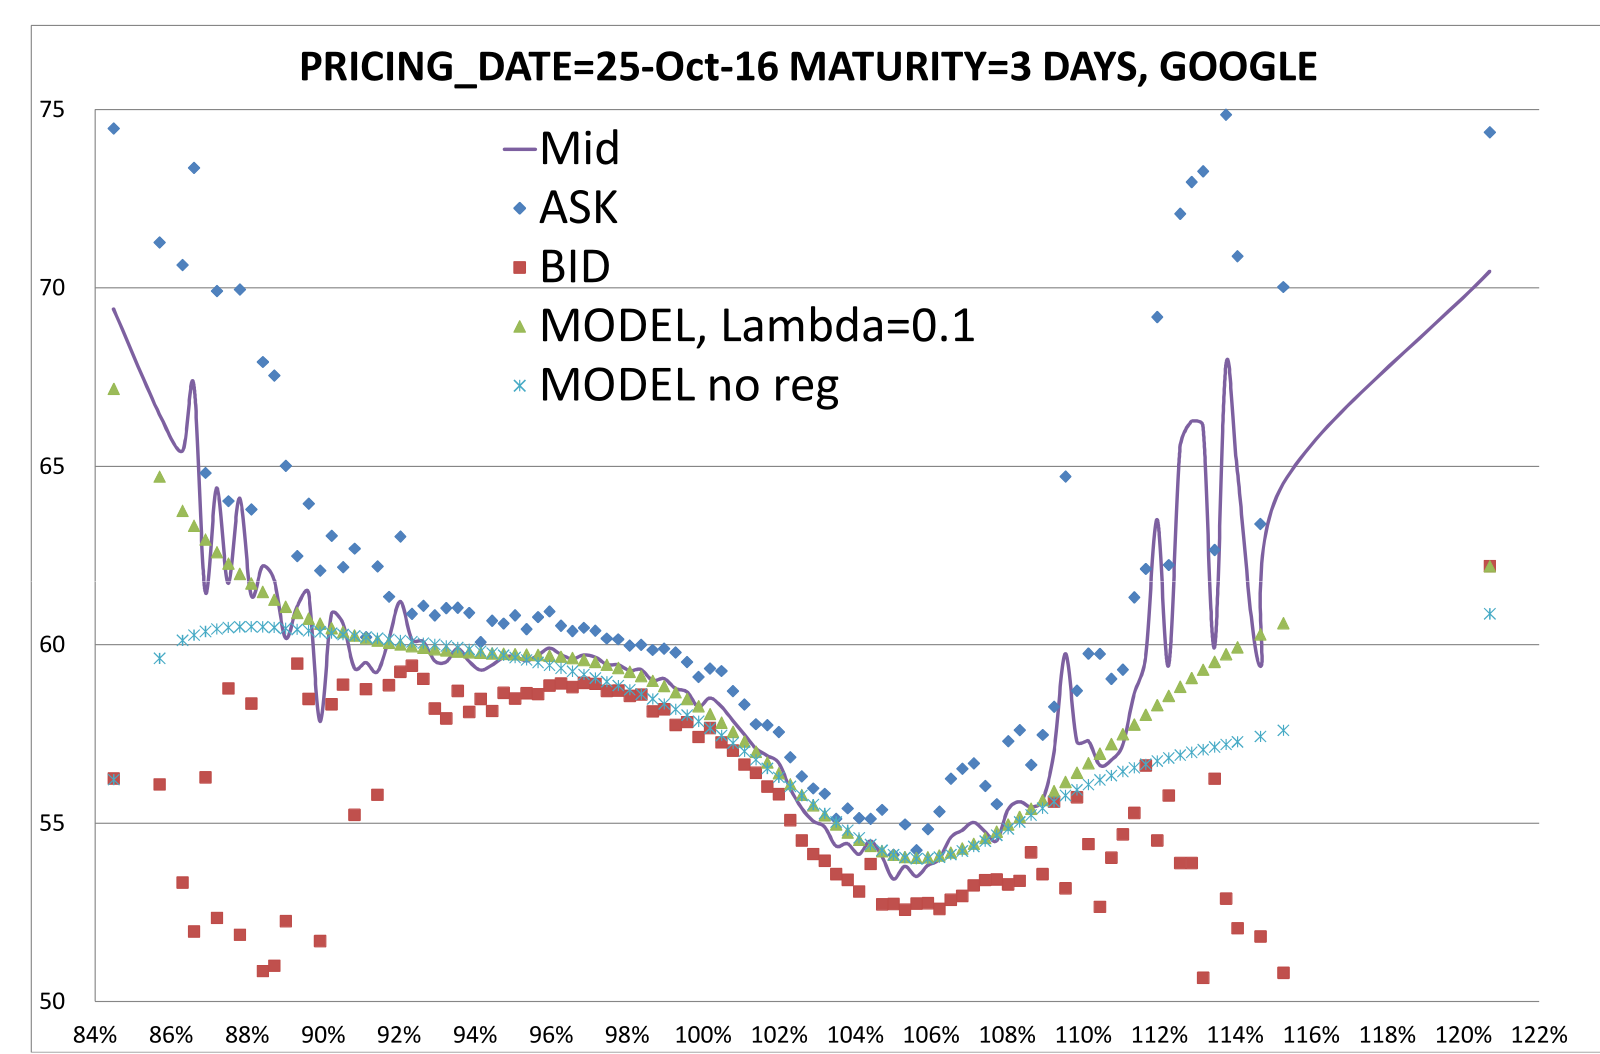
- 캘리브레이션 한 번에 0.1초. 원문 그림 캡션에 그대로 "Computational time = 0.1 s"라고 적혀 있습니다. 시장조성 시스템이 실시간으로 표면을 갱신할 수 있는 속도입니다.
- 구글·아마존(실적 발표 직전의 기이한 스마일 포함), DAX, 유로스톡스 50, 소시에테 제네랄, 다농, 애플, S&P 500까지 — 개별 주식과 지수에서 시세를 매수·매도 호가 안에 완전히 적합하면서 모순 없는 표면을 얻었습니다.
- 정규화 페널티(시세를 외면하지 않도록 붙이는 장치)의 강도는 실험에서 0.1로 두었습니다.
물론 한계도 있습니다. 논문의 구조는 두 시점(두 만기)을 다루는 프레임워크이고, 코드가 공개되어 있지 않아(재현성 점수 48/100) 직접 구현해야 합니다. 또한 지금 볼 수 있는 전문은 여러 차례 개정된 판본이라 2019년 초판과 세부 수치가 다를 수 있습니다.
나머지 논문들: 더 정확한 근사, 더 빠른 계산
- 물리학에서 온 근사 도구 (1902.03610) — 양자역학에서 쓰던 "경로적분" 기법을 금리·신용 파생상품의 가격 계산에 이식했습니다. 만기가 길거나 변동성이 큰 구간에서 기존 근사가 흔들리던 문제를 준해석적(거의 공식에 가까운) 방법으로 다룹니다.
- 거칠어진 변동성을 계산하는 법 (1902.01471) — 2014년 이후 각광받은 "거친(rough) 변동성 모형"을 Monte Carlo로 돌릴 때의 계산 속도 문제를 다룹니다. 특정 근사 방식의 수렴률이 이론상 매우 높을 수 있음을 증명했지만, "그래서 항상 더 빠른 것은 아니다"라는 냉정한 결론도 함께입니다.
이 테마의 공통 인사이트
세 논문 모두 "완전시장 교과서 공식"을 실제 시장의 제약 — 매수·매도 호가, 계산 시간, 거친 데이터 — 에 맞게 재정의하려 합니다. 빠른 근사법의 진보가 결국 시장의 마찰을 정직하게 다루는 방향으로 이어졌던 달입니다.
테마 2: 위험 예측을 "채점"하는 법
"나 오늘 95% 확률로 이 정도까지만 잃는다"는 말을 어떻게 검증할까
위험관리에서 가장 흔한 두 숫자가 VaR와 ES입니다.
- VaR(Value at Risk, 위험가치): "95% 확률로 오늘 손실은 이 금액을 넘지 않는다"는 문지기 같은 숫자. 이상치에 강건하지만, 진짜 큰 날의 손실이 얼마나 나쁜지는 말해 주지 않습니다.
- ES(Expected Shortfall, 기대손실): "그 5% 나쁜 날들의 평균 손실" — 꼬리 위험을 직접 보지만, 극단값 하나에 쉽게 흔들립니다.
그런데 2010년 Cont 등이 제안한 RVaR(Range Value at Risk)라는 중간 지점이 있습니다. VaR의 "구간 평균"으로, 강건함과 민감함 사이의 절충이죠. 문제는 이 RVaR 예측을 어떻게 백테스트하느냐였습니다. RVaR 하나만으로는 "예측이 맞았다/틀렸다"를 채점할 점수함수를 만들 수 없음이 수학적으로 알려져 있었거든요.
대표 논문: RVaR를 채점하는 방법을 찾다 (1902.04489)
Evaluating Range Value at Risk Forecasts (Fissler, Ziegel)
이 논문의 해법은 우아합니다. "RVaR 혼자 채점하지 말고, 두 개의 VaR 보조 답과 함께 묶어서 채점하라." (VaR 하나, 다른 수준의 VaR 하나, 그리고 그 사이의 RVaR) 이 세 숫자의 묶음은 엄밀한 의미에서 채점 가능하며, 저자들은 그에 맞는 일관성 있는 점수함수 전체를 수학적으로 찾아냈습니다.
추가로 여러 가지를 정리했습니다.
- RVaR의 강건성을 "고장점(breakdown point)"으로 정량화했습니다. 이상치가 어느 정도 쌓이면 무너지는지를 나타내는 지표인데, RVaR는 VaR와 ES 사이에 정확히 놓입니다. 두 위험수준 사이의 여백이 좁을수록 강건하고, 넓을수록 ES에 가까워집니다.
- 모델 두 개를 비교할 때 쓰는 진단 도구인 Murphy diagram(점수함수를 여러 기준점에서 잘라 보는 그래프)을 이 삼중량에 맞춰 정리했습니다.
- 시뮬레이션으로 "정답을 아는 예측자", "과도하게 자신하는 예측자" 등을 놓고 실제로 점수로 분리되는지를 확인했습니다. 예를 들어 위험수준을 아주 극단적으로(하위 1%, 상위 5%) 잡아도 점수함수가 예측력을 잘 분리해 냅니다.
(이 논문의 원문 그림은 캡션 없이 추출되어 본문에는 넣지 않았습니다.)
정직하게 말하면, 이 논문은 실전 데이터로 수익을 냈다는 연구가 아니라 위험 모델 검증의 이론적 토대를 넓힌 연구입니다. 논문 스스로 "구체적 점수함수 선택은 여전히 열린 문제"라고 밝히고 있으며, 그래서 적용성 점수는 62/100에 그칩니다. 대신 엄밀성은 88/100으로 이 달 최고 수준입니다.
나머지 논문들: 나누는 기준, 배우는 기준
- 공정한 자본 배분 (1902.10044) — 포트폴리오의 위험(ES 기준)을 구성 자산별로 "공정하게" 나누는 기준을 수학적으로 정의하고 추정량의 성질을 증명했습니다. 펀드 내부에서 위험 몫을 계산할 때의 기준점입니다.
- 임계값을 데이터에서 배우는 꼬리 모형 (1902.09205) — 극단 손실 분석에서는 "어디서부터 꼬리로 볼지(임계값)"가 늘 골칫거리입니다. 이 논문은 임계값과 레짐 변화를 동시에 추정하는 베이지안 방법을 제안합니다.
- 백테스트 성과를 얼마나 깎을까 (1902.01802) — 전략을 반복 수정하다 보면 백테스트 성과는 구조적으로 부풀려집니다. 이 논문은 그 정도를 모형화해 "백테스트 PnL 할인계수"를 계산하는 틀을 제시합니다. 승인 회의에서 쓰기 좋은 보수적 장치입니다.
이 테마의 공통 인사이트
이 달의 위험 연구는 하나같이 "측정치를 고르는 일"과 "그 예측을 검증하는 일"을 구분합니다. 좋은 위험 숫자 하나보다, 그 숫자가 틀렸음을 알아채는 장치가 더 중요하다는 2019년의 경고는 오늘도 유효합니다.
테마 3: 호가장의 법칙 — 가격이 아니라 주문의 물리학
주식시장의 "계산대 줄"을 아시나요
주식을 사려면 보통 "얼마에 사겠다"고 장부에 이름을 올립니다. 이렇게 가격대별로 쌓인 대기 주문의 장부가 호가장(limit order book)입니다. 최선호 매수 가격과 최선호 매도 가격의 간격이 bid-ask 스프레드이고, 이 간격은 시장이 물건에 매기는 일종의 수수료입니다.
1985년 Glosten과 Milgrom은 이 스프레드가 "내부 정보를 가진 거래자에게 당하지 않기 위한 보험료"라는 유명한 해석을 내놓았지만, 최선호 호가 한 줄만 다뤘습니다. 실제 장부는 가격마다 줄이 여러 겹인데 말이죠.
대표 논문: Glosten-Milgrom에서 호가장 전체로 (1902.10743)
From Glosten-Milgrom to the whole limit order book and applications to financial regulation (Huang, Pulido, Rosenbaum, Saliba, Sfendourakis)
이 논문은 참가자를 세 부류 — 내부 정보를 가진 거래자, 아무 정보 없이 거래하는 노이즈 거래자, 경쟁하는 시장조성자 — 로 놓고, 시장조성자가 이윤을 남기지 못한다는 조건(경쟁이니까요)을 강제합니다. 그러자 놀라운 일이 벌어집니다. 스프레드만이 아니라 가격대마다 쌓여 있는 유동량(장부의 모양 전체)이 하나의 방정식 체계로 설명됩니다.
여기에 시장의 "최소 가격 단위" — 틱(tick) — 를 넣으면 규제 분석이 가능해집니다.
- 제약된 스프레드 = 틱 값 + 고유 스프레드. 틱이 커지면 스프레드는 최소한 틱 값만큼은 좁아질 수 없다는, 계산 가능한 법칙입니다.
- 유럽의 MiFID II 규제(제49조)는 종목의 유동성에 따라 틱 크기를 정하는데, 목표가 "유동성 좋은 종목의 스프레드를 1.5~2틱으로"입니다. 이 규제는 실증 검증 대상으로 안성맞춤이었습니다.
실증 결과(핵심): 2022년 10월~2023년 3월의 데이터로 모형의 모수를 맞춘 뒤, 2023년 4월에 유동성 구간이 바뀌어 틱이 달라진 종목들의 새 스프레드를 예측했습니다.
- "스프레드가 그대로일 것"이라는 단순 가정을 11종목 중 9종목에서 이겼습니다.
- 평균 상대 오차는 모델 14% 대 상수 가정 39%였습니다.
- 개별 종목: 미슐랭 1.66% 대 36.53%, 레미 쿠앙트로 1.13% 대 43.95%, FDJ 3.13% 대 27.72% 등으로 격차가 큽니다. (원문은 본문에서 "10종목이 구간을 바꿨다", 표에서는 11종목을 담는 등 수치가 조금 섞여 있습니다.)
- 유일한 큰 예외는 LHYFE로, 틱이 커졌는데 스프레드가 오히려 줄어든 이상치였습니다(모델 오차 29.54%, 상수 가정 8.62%).
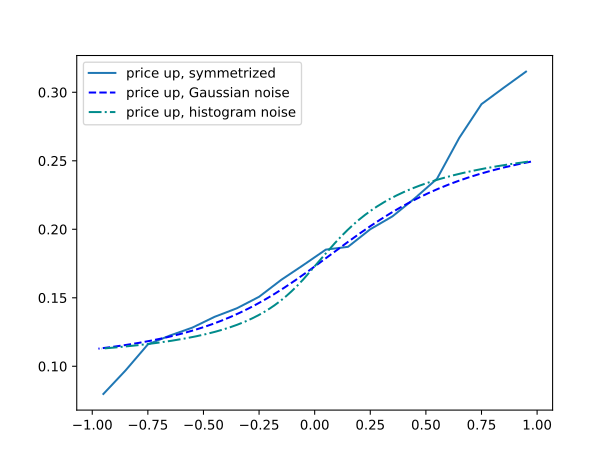
또한 장부의 거래량 불균형(최선호 매수 대비 매도 잔량의 비율)이 곧 있을 가격 움직임을 예측한다는 잘 알려진 현상을 이 모형이 다시 만들어 냅니다. 아래 그림에서 파란 실선이 실제 관측, 점선이 모형의 예측입니다.
마지막으로 큐 포지션 가치를 공식화했습니다. 주문을 먼저 건 사람이 유리한 이유를 정량화한 것인데, 예를 들어 에어리퀴드의 경우 스프레드가 0.0301유로인데 큐의 맨 앞자리 가치가 0.0126유로 — 자리 하나가 스프레드의 40% 안팎 값입니다. 초단기 체결 전략에서 "얼마나 빨리 줄을 서야 하는가"가 수학으로 표현된 셈입니다.
한계도 분명합니다. 시장조성자만 지정가 주문을 낼 수 있다고 가정하고(현실의 정보 거래자는 패시브 주문을 겁니다), 경쟁적 시장조성이 전제라 유동성 좋은 종목에 맞습니다. 실증 데이터가 독점 데이터라 재현성 점수는 45/100입니다.
나머지 논문들: 최적 호가, 거래의 스케일 법칙
- 불완전 정보 아래의 최적 시장조성 (1902.01157) — 시장 상태를 눈치채며 주문 도착 강도에 맞춰 호가를 조정하는 시장조성 전략을 이론적으로 풀었습니다. "지금 장이 어떤 상태인지"를 추정하며 호가를 넣는 문제의 기준점입니다.
- 거래 불변량은 정말 불변인가 (1902.03457) — 기관 대형 주문 약 800만 건을 분석해, 잘 알려진 "거래 규모의 3/2 스케일링 법칙"은 튼튼하지만 기존의 불변량 정의는 거래비용과 묶여 있어 보편적이지 않음을 보이고, 비용으로 정규화한 새 불변량을 제안합니다.
이 테마의 공통 인사이트
미시구조 연구의 초점이 "가격 예측"에서 "주문 흐름과 줄 서기의 물리학"으로 옮겨가고 있음을 보여 주는 달입니다. 규제(틱 크기)와 체결 전략(큐 위치)이 같은 방정식으로 다뤄진다는 점이 특히 흥미롭습니다.
테마 4: 제약이 걸린 포트폴리오를 짜는 법
"위험을 똑같이 나눈다"는 약속이 깨지는 순간
리스크 패리티(위험균형) 포트폴리오는 요즘 많이 쓰입니다. 아이디어는 간단해 보입니다. 자산별로 "위험 몫"을 똑같이 나눠 가지는 거죠. 금액이 아니라 위험을 기준으로 나누기 때문에 배분이 안정적이라는 장점이 있습니다.
하지만 현실의 운용은 제약투성입니다. 작은 회사 주식(소형주)에는 많은 돈을 못 넣습니다(유동성 문제). 거래가 잦으면 비용이 폭발합니다. 그런데 비중 제약을 걸면 "각 자산의 위험 몫이 정확히 같다"는 약속이 깨집니다. 수학적으로 어떤 문제를 풀어야 제약이 걸린 상태에서도 위험균형에 가장 가까운 답을 얻는지가 애매했습니다.
대표 논문: 제약이 있어도 위험 몫을 지키는 포트폴리오 (1902.05710)
Constrained Risk Budgeting Portfolios: Theory, Algorithms, Applications & Puzzles (Richard, Roncalli)
이 논문은 "제약이 걸린 위험예산 포트폴리오"를 정확히 정의하는 최적화 문제를 세우고, 기계학습에서 쓰는 대규모 최적화 알고리즘(순환 좌표하강, ADMM, 근접 연산자, Dykstra 알고리즘)을 금융에 이식해 풀었습니다. 저자들이 "금융에서는 잘 알려지지 않았지만 ML에서는 인기 있는 도구를 알리고 싶었다"고 쓸 정도로, 이론과 알고리즘을 함께 정리한 실용적 논문입니다.
실무 예시가 명확합니다. 시가총액 비중이 34%, 25%, 20%, 15%, 3%, 2%, 1%인 주식 7개를 놓고(변동성은 15%~21%), 마지막 3개를 소형주로 보고 비중을 시총 가중 그대로 고정한 채 나머지 4개에만 위험균형을 적용했습니다(이 방식을 C-ERC라 부릅니다).
- 대형주 4개의 위험 기여가 각각 정확히 23.46%로 동일하게 나왔습니다. 제약에 걸리지 않은 자산에는 위험균형의 약속이 그대로 유지된 겁니다.
- 포트폴리오 전체 변동성: 시총 가중 14.50%, 순수 위험균형 15.23%, 이 논문의 제약 방식 14.68% — 유동성 제약을 지키면서도 위험 수준은 거의 그대로입니다.
회전율(얼마나 자주 갈아치우는가)을 직접 제약하는 방법도 제시합니다. 현재 포트폴리오에서의 총 거래 비용에 상한을 거는 방식인데, 상한을 0%부터 70%까지 풀어 가며 실험한 결과 예상대로 상한이 풀리면 점점 순수 위험균형 포트폴리오로 수렴했습니다(어떤 자산의 비중은 12.5%에서 28.68%까지 커졌습니다).
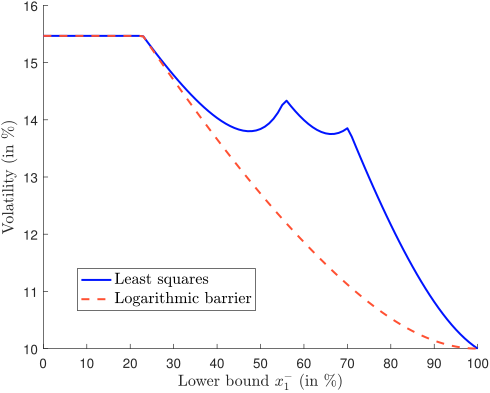
저작들은 솔직하게 한계도 밝힙니다. 리스크 척도의 "규모 확대에 비례하는 성질(동차성)"이 제약과 양립하지 않을 수 있고, 일부 경우 라그랑주 승수(제약의 강도를 조절하는 계수)를 어떻게 맞춰야 할지가 미해결 문제로 남는다고("scaling puzzle") 고백합니다. 논문 제목의 "Puzzles"가 바로 이겁니다.
나머지 논문들: 거래가 시장을 바꿀 때
- 포트폴리오 거래의 평균장게임 (1902.09606) — 여러 상관된 자산을 동시에 청산·헤징할 때의 최적 전략을 다룹니다. 특히 많은 투자자가 비슷한 전략으로 몰릴 때(거래 군집) 시장이 인식하는 상관관계가 왜곡된다는 메커니즘을 설명합니다. 통찰 점수 82/100으로 이 달 최고 수준이나, 재현성은 32/100으로 낮습니다.
- 모델 위험에 강건한 포트폴리오 (1902.06623) — 추정이 조금 틀려도 최악의 경우를 가정하고 버티는(최악 모델 위험 접근) 평균-분산 포트폴리오의 해석적 해를 찾았습니다.
이 테마의 공통 인사이트
"제약을 넣으면 예쁜 이론이 깨진다"는 사실을 깨진 채로 다루는 법을 배우던 시기입니다. 이 달 포트폴리오 연구들은 완벽한 해답 대신, 제약의 대가를 계산하고 예측하는 실무적 틀을 제공합니다.
테마 5: 데이터가 흔들려도 버티는 AI
요리의 "간"을 레시피에만 맡기면 생기는 일
금융 시계열은 특이합니다. 평균과 분포가 시간에 따라 계속 변합니다. 고요한 시장과 폭락하는 시장은 통계적으로 다른 세계입니다. 이런 데이터를 인공지능에 넣기 전에 보통 "정규화"라는 전처리를 합니다 — 값을 일정한 범위로 맞추는 작업입니다. 요리에서 간을 맞추는 것과 비슷합니다.
문제는 정규화 기준이 고정되어 있으면, 재료(데이터 분포)가 바뀌는 순간 레시피가 망한다는 점입니다. 2019년 2월의 이 논문은 "정규화 자체를 학습시키자"고 제안합니다.
대표 논문: 정규화를 배우는 신경망 레이어 (1902.07892)
Deep Adaptive Input Normalization for Time Series Forecasting (Passalis, Tefas, Kanniainen, Gabbouj, Iosifidis)
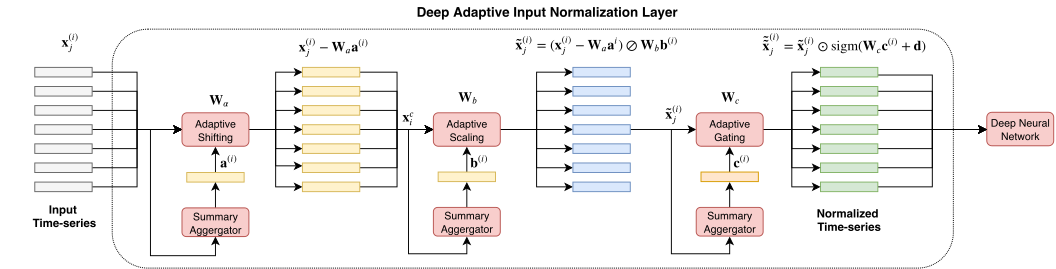
DAIN(Deep Adaptive Input Normalization) 레이어는 모델 앞단에 붙여서, 입력 데이터의 분포를 보고 (1) 중심을 옮기고, (2) 스케일을 조정하고, (3) 필요한 신호는 살리고 잡음은 죽이는 작업을 스스로 학습합니다. 학습이 끝나면 새로운 시계열에도 그대로 적용됩니다.
검증은 대용량 호가장 데이터셋(FI-2010)으로 했습니다. 최근 15개의 측정 벡터(총 2,160개 숫자)를 보고 다음 가격 방향을 세 가지로 예측하는 과제입니다.
- 정규화를 안 하면 성능 지표(Cohen's kappa)가 0 근처 — 완전한 무작위 수준이었습니다. 정규화가 얼마나 중요한지부터 증명한 셈입니다.
- 이 논문의 "적응적 이동" 한 단계만 넣어도 기존 정규화(z-score, 배치 정규화 등) 대비 상대적 성능 개선이 MLP에서 15% 초과, CNN에서 30%, RNN에서 13%였습니다.
- 진짜 하이라이트는 분포 급변 실험입니다. 입력값 전체에 평균의 3배를 더해 세상을 뒤집어 놓았더니, 고정 정규화를 쓴 모델의 정확도는 75.39%에서 56.56%로 추락한 반면 DAIN은 78.59%에서 78.21%로 0.5%p도 안 떨어졌습니다.
정직한 한계: 이 논문은 분류 성능만 검증했을 뿐 실거래 수익성과 거래비용을 검증하지 않았습니다. 적용성 점수는 58/100입니다. 게이팅 단계는 GRU처럼 이미 게이트가 있는 모델에는 효과가 없었고, 서브 레이어별 학습률 튜닝이 민감하다는 점도 논문이 인정합니다. 재현성 점수 78/100은 이 달 논문 중 높은 편이라, 시도해 보기는 좋은 후보입니다.
나머지 논문들
- 차트 이미지로 배우는 DQN의 국경 넘기 (1902.10948) — 미국 주식 차트 이미지로 학습한 심층 Q-네트워크가 31개국 시장에서도 수익 신호를 만들었다는 흥미로운 주장입니다. 다만 재현성 점수 30/100이라 신중한 재검증이 필요합니다.
이 테마의 공통 인사이트
2019년 초의 금융 ML은 "더 큰 모델" 경쟁 이전에, 비정상 데이터와 과적합이라는 기본 장벽을 다루던 시기였습니다. 7년이 지난 지금도 "입력이 흔들리면 모델이 무너진다"는 이 기본 장벽은 그대로 남아 있습니다.
월 전체 Big Picture
2019년 2월의 다섯 테마는 서로 다른 이야기처럼 보이지만 하나로 이어집니다. "마찰 없는 이론에서 실제 시장의 마찰로."
- 옵션 가격결정은 매수·매도 호가라는 마찰을,
- 위험 측정은 이상치와 예측의 불완전성이라는 마찰을,
- 미시구조는 최소 가격 단위와 정보의 비대칭이라는 마찰을,
- 포트폴리오는 비중과 거래비용이라는 마찰을,
- 머신러닝은 변하는 데이터 분포라는 마찰을
각각 정면으로 다루기 시작한 달입니다. 그리고 해법의 모양도 닮아 있습니다. 강건함과 정확함 사이의 균형점을 공식으로 세우고, 계산 가능한 알고리즘으로 실무에 내려놓는 것. 7년이 지난 오늘, 이 논문들이 묻는 질문 — 무차익 표면, 위험 예측의 검증, 체결 비용, 제약 최적화, 입력 불안정성 — 은 여전히 자산운용의 일상 업무 그대로입니다.
더 알아보기
원문 링크와 5차원 점수 (신규성 / 적용성 / 엄밀성 / 재현성 / 통찰)
| 논문 | 링크 | 점수 |
|---|---|---|
| 무차익 변동성 표면 (Sinkhorn) | arXiv:1902.04456 | 72 / 82 / 82 / 48 / 70 |
| RVaR 예측 평가 | arXiv:1902.04489 | 76 / 62 / 88 / 52 / 78 |
| 호가장 전체 모형과 틱 규제 | arXiv:1902.10743 | 78 / 81 / 82 / 45 / 78 |
| 제약 위험예산 포트폴리오 | arXiv:1902.05710 | 67 / 78 / 76 / 55 / 76 |
| 입력 정규화 학습 (DAIN) | arXiv:1902.07892 | 66 / 58 / 65 / 78 / 62 |
함께 읽으면 좋은 논문
- 변동성 표면과 최적수송이 궁금하다면: Bid-Ask Martingale Optimal Transport (2603.24605), Distributionally Robust Martingale Optimal Transport (2106.07191)
- 위험 측정의 검증이 궁금하다면: Estimation of tail risk measures in finance (2407.05933), Dynamic risk constraints for limited liability operators (2011.03314)
- 호가장 모형이 궁금하다면: LOB shape modeling with heterogeneously informed traders (2009.02808), JAX-LOB: GPU 가속 호가장 시뮬레이터 (2308.13289)
- 위험균형 포트폴리오가 궁금하다면: Risk Budgeting Portfolios: Existence and Computation (2211.07212), Risk Parity Portfolios with Skewness Risk (2202.10721)
- 시계열 모델의 붕괴가 궁금하다면: Forecast Collapse in Time-Series Foundation Models (2608.14106)
📚 이 글에서 다룬 논문 (24편)
- ABuilding arbitrage-free implied volatility: Sinkhorn's algorithm and variants
Hadrien De March, Pierre Henry-Labordere
- AEvaluating Range Value at Risk Forecasts
Tobias Fissler, Johanna F. Ziegel
- AFair Estimation of Capital Risk Allocation
Tomasz R. Bielecki, Igor Cialenco, Marcin Pitera 외 1명
- AA changepoint approach for the identification of financial extreme regimes
Chiara Lattanzi, Manuele Leonelli
- BHow should you discount your backtest PnL?
Adam Rej, Philip Seager, Jean-Philippe Bouchaud
- AFrom Glosten-Milgrom to the whole limit order book and applications to financial regulation
Weibing Huang, Sergio Pulido, Mathieu Rosenbaum 외 2명
- AOptimal market making under partial information with general intensities
Diego Zabaljauregui, Luciano Campi
- BAre trading invariants really invariant? Trading costs matter
Frédéric Bucci, Fabrizio Lillo, Jean-Philippe Bouchaud 외 1명
- AConstrained Risk Budgeting Portfolios: Theory, Algorithms, Applications & Puzzles
Jean-Charles Richard, Thierry Roncalli
- AA Mean Field Game of Portfolio Trading and Its Consequences On Perceived Correlations
Charles-Albert Lehalle, Charafeddine Mouzouni
- BModel risk in mean-variance portfolio selection: an analytic solution to the worst-case approach
Roberto Baviera, Giulia Bianchi
- BDeep Adaptive Input Normalization for Time Series Forecasting
Nikolaos Passalis, Anastasios Tefas, Juho Kanniainen 외 2명
- BGlobal Stock Market Prediction Based on Stock Chart Images Using Deep Q-Network
Jinho Lee, Raehyun Kim, Yookyung Koh 외 1명
- BBid--Ask Martingale Optimal Transport
Bryan Liang, Marcel Nutz, Shunan Sheng 외 1명
- ADistributionally Robust Martingale Optimal Transport
Zhengqing Zhou, Jose Blanchet, Peter W. Glynn
- AThe importance of dynamic risk constraints for limited liability operators
John Armstrong, Damiano Brigo, Alex S. L. Tse
- AJAX-LOB: A GPU-Accelerated limit order book simulator to unlock large scale reinforcement learning for trading
Sascha Frey, Kang Li, Peer Nagy 외 5명
- ARisk Budgeting Portfolios: Existence and Computation
Adil Rengim Cetingoz, Jean-David Fermanian, Olivier Guéant
- ARisk Parity Portfolios with Skewness Risk: An Application to Factor Investing and Alternative Risk Premia
Benjamin Bruder, Nazar Kostyuchyk, Thierry Roncalli
- AForecast Collapse in Time-Series Foundation Models
Shu Wan, Miles Ma, Hank Zhu 외 4명
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2026-04 월간
AI가 진짜 돈을 움직이기 시작했다 — 2026년 4월 금융 AI 연구 하이라이트
2026년 4월 금융 AI 연구 동향. LLM 에이전트가 실제 자본으로 온체인 거래를 시작하고, 백테스트의 허상이 대규모 실증으로 검증된 달의 핵심 논문들을 살펴봅니다.
 📊 2026-03 월간
AI가 주식을 예측할 수 있을까? — 2026년 3월 금융 AI 연구 리뷰
2026년 3월 금융 AI 논문 734편을 분석한 월간 종합. LLM의 시간 편향 문제, 백테스트 엔진의 숨겨진 오차, 포트폴리오 최적화의 새로운 수학, LOB 시뮬레이션의 현실화, 강화학습 트레이딩 시스템의 실전 전환까지 — 신뢰할 수 있는 금융 AI를 만드는 5가지 연구 테마를 살펴봅니다.
 📊 2026-01 월간
AI가 포트폴리오를 짜고, 뉴스를 조작하고, 블록체인에서 대량 매도한다 — 2026년 1월 금융 AI 연구 하이라이트
2026년 1월 arXiv에 올라온 금융 AI 연구를 5개 테마로 정리했습니다. 파라미터 불확실성을 포트폴리오에 반영하는 방법, LLM 에이전트의 결정 재현성 문제, DEX에서의 대량 매도 최적화, 연합학습으로 신용리스크를 예측하는 방법, 그리고 주문흐름과 변동성을 하나로 묶는 미시구조 이론까지.