
이번 달의 한 줄: 2019년 3월의 연구자들은 "내일 가격이 얼마일까"보다 "내일 가격의 분포가 어떤 모양일까"를 묻기 시작했고, 그 질문의 답을 "빠르고 정확하게 근사하는 기술"로 찾고 있었습니다.
들어가며: 2019년 3월, 금융 AI의 조용한 전환기
2019년 봄을 기억하시나요? 그해 3월, 전 세계는 첫 번째 블랙홀 사진을 기다리고 있었고, 주식시장은 2018년 말의 폭락에서 간신히 숨을 돌리고 있었습니다. 그리고 arXiv에는 그 달에만 99편의 금융 논문이 올라왔고, 그중 56편이 퀀트 투자에 실제로 쓸모 있는 연구로 분류되었습니다.
이 시기의 연구를 보면 지금(2020년대 후반)과 확연히 다른 점이 있습니다. 바로 AI가 "예측 기계"가 아니라 "추정 기계"로 쓰이던 시절이었다는 점입니다. 요즘은 AI 트레이딩 에이전트가 뉴스를 읽고 매매를 결정하는 이야기가 주를 이루지만, 2019년 3월의 논문들은 이런 질문들을 던지고 있었습니다.
- 변동성이라는 "거칠고 예측 불가능한 것"의 가격을 빠르고 정확하게 근사하려면?
- 내일 수익률의 평균이 아니라 전체 분포를 그리려면?
- 주식 2,000개의 위험을 나타내는 공분산 행렬이 병들어 있을 때?
- 백테스트가 보여주는 수익이 과장된 것이라면?
- 비트코인 말고 작은 코인 수천 개의 감정이 시장을 움직인다면?
이번 글에서는 2019년 3월의 금융 AI 연구를 5개 테마로 묶어, 전공자가 아니셔도 따라올 수 있게 풀어드립니다. 결론부터 말하면, 이 달의 연구가 남긴 가장 실용적인 교훈은 "모든 근사에는 품질 표시가 붙어야 하고, 모든 백테스트에는 현실성 점검이 붙어야 한다"는 것입니다.
테마 1: 변동성의 미래를 사고파는 수학 — 근사의 엔지니어링
옵션 가격이 "느리게" 나오면 생기는 일
옵션 시장에서 변동성은 날씨와 같습니다. 그런데 이 날씨가 평범하지 않죠 — 2010년대 중반의 연구자들은 변동성이 매끈하게 흘러가는 게 아니라 거칠게 요동친다는 사실을 실증 데이터로 확인했습니다. 이를 반영한 "거친 변동성(rough volatility)" 모형이 새로운 주류로 떠올랐습니다.
문제는 계산이었습니다. 이 모형은 수학적으로 너무 꼬여 있어서 전통적인 방식으로는 옵션 가격이 안 나옵니다. 변동성 지수(VIX) 옵션, 실현분산 옵션처럼 "변동성 자체에 대한 옵션"은 더더욱 그렇습니다. 매번 몬테카를로 시뮬레이션을 돌리자니 느리고, 그렇다고 공식이 있는 것도 아니었습니다.
대표 논문: 대편차 원리로 변동성 옵션 가격을 "한 방에" 근사하다 (1903.02833)
Asymptotics for volatility derivatives in multi-factor rough volatility models (Imperial College London, 복합점수 74.1 — 이 달 최고)
이 논문의 저자들은 통계 물리학에서 오래 쓰인 대편차 원리(large deviations principle)라는 도구를 빌려왔습니다. 쉽게 말하면 이런 아이디어입니다. "어떤 극단적 사건이 일어날 확률은, 그 사건에 가장 가까운 '전형적 경로' 하나가 결정한다"고 가정하면, 복잡한 확률 계산이 하나의 최적화 문제로 바뀝니다. 마치 "가장 험난한 등산로"만 알면 그 산을 넘을 확률을 대략 짐작할 수 있는 것과 비슷합니다.
이걸로 세 가지를 해냈습니다.
- 실현분산 옵션과 VIX 옵션의 만기가 짧을 때 내재변동성을 나타내는 공식에 가까운 근사식을 도출했습니다. 저자들에 따르면 실현분산 옵션의 소시간 거동을 엄밀하게 다룬 것은 이 논문이 처음입니다.
- 여러 개의 요인(변동성 축)이 있을 때, 요인들이 서로 상관되어 있으면 내재변동성 곡선의 모양(직선인지 볼록한지)이 어떻게 변하는지 처음으로 체계 분석했습니다.
- 변동성 스왑을 빠르고 정확하게 가격결정하는 수치 방법을 만들었고, 코드를 GitHub(
LDP-VolOptions)에 공개했습니다.
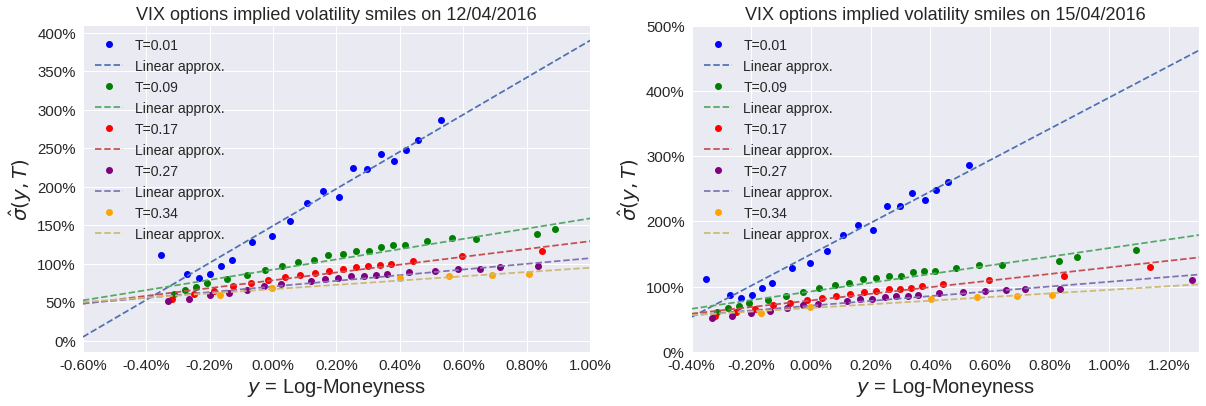
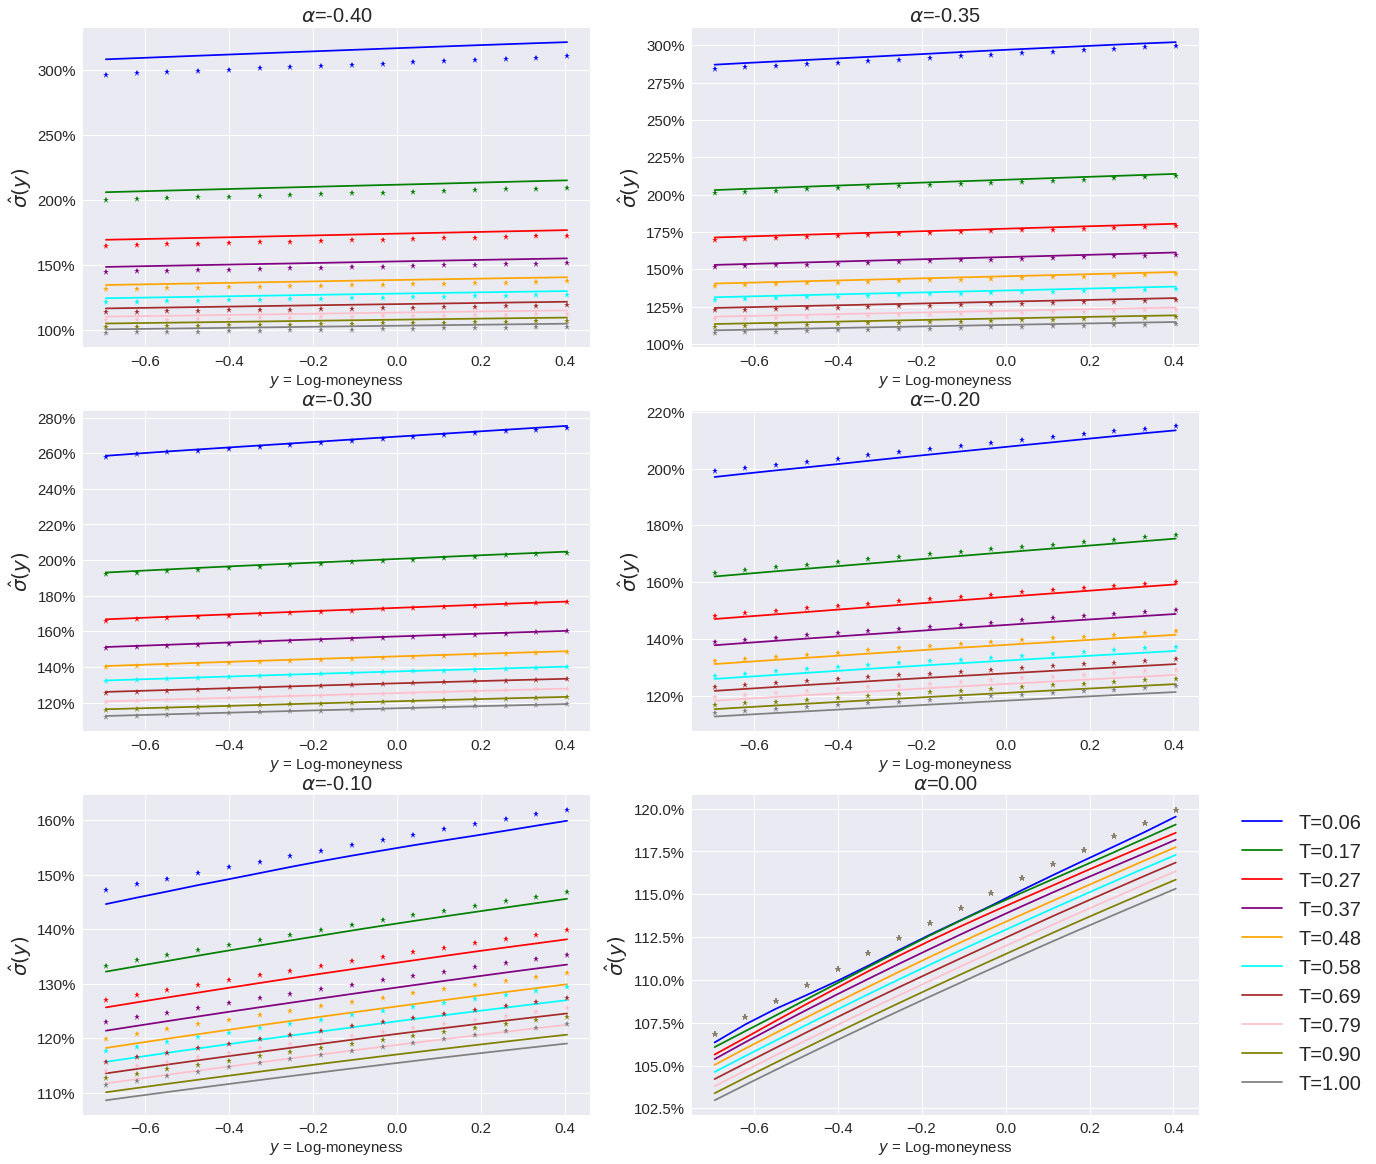
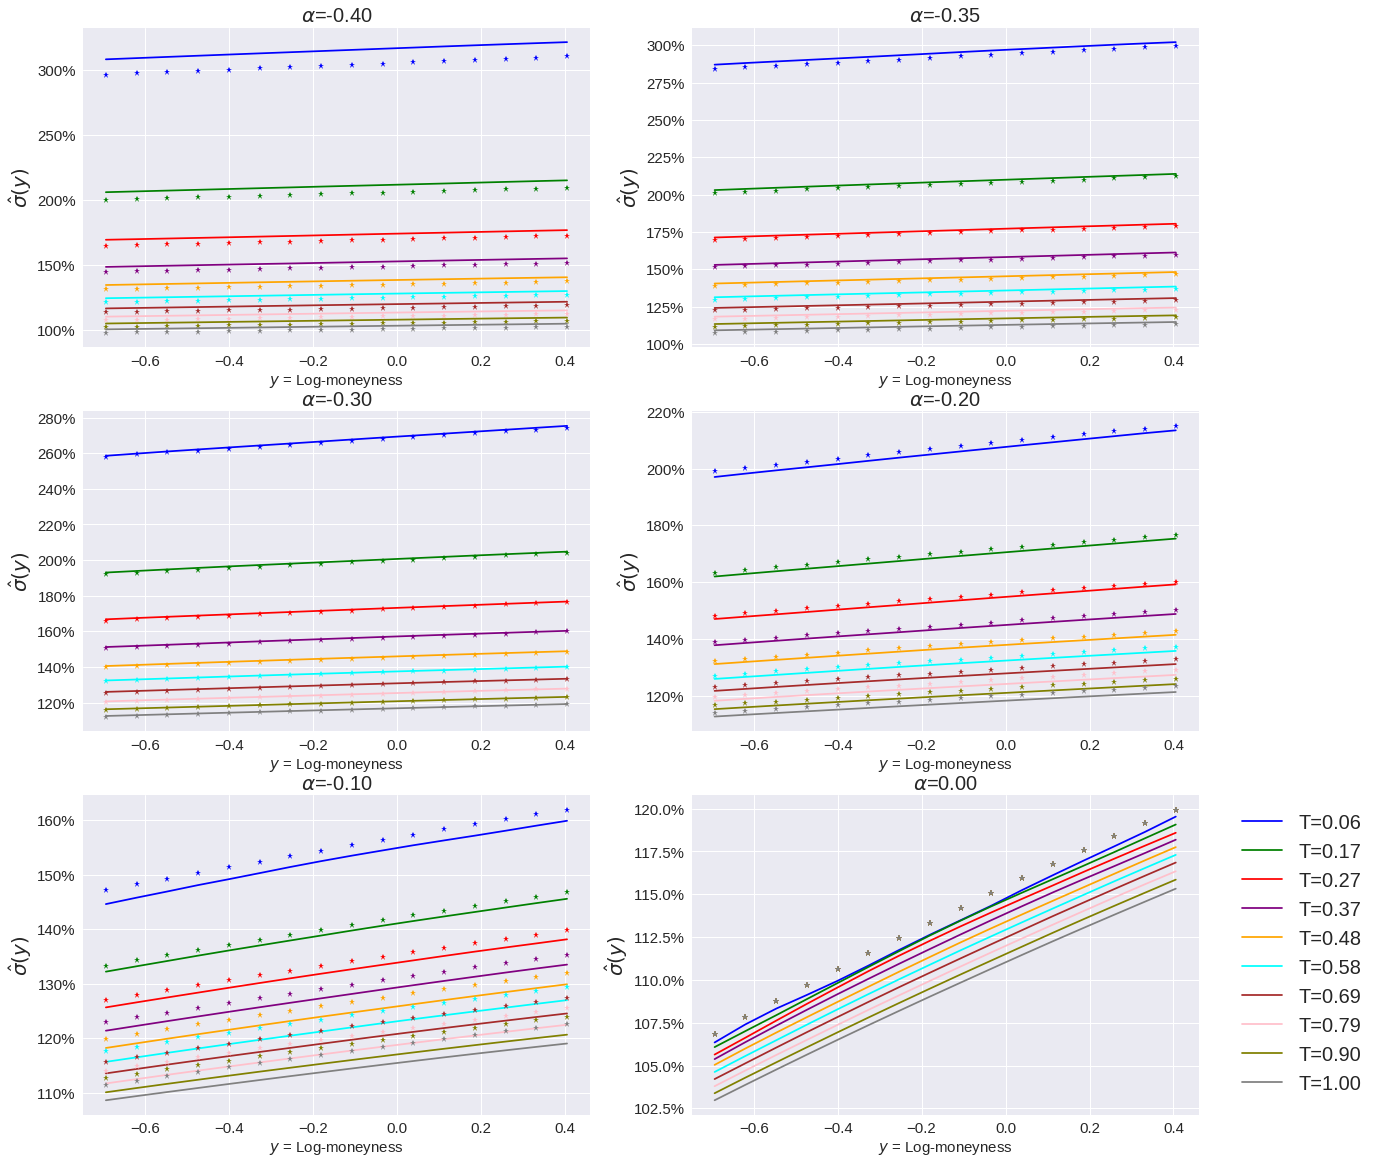
결과 그림이 이 논문의 핵심을 잘 보여줍니다. 아래 그림에서 직선(몬테카를로 시뮬레이션 결과)과 별표(논문의 근사식 결과)가 거의 겹칩니다. 시뮬레이션을 오래 돌리지 않고도 근사식으로 비슷한 답을 낼 수 있다는 뜻입니다.
가볍게 읽어볼 논문들
같은 테마의 다른 논문들도 "빠르고 정확한 근사"라는 같은 목표를 향합니다. Stacked Monte Carlo for option pricing은 항공역학 계산에서 쓰던 "스택킹" 기법을 옵션 가격 시뮬레이션에 옮겨 분산을 줄였고, Variance Reduction Applied to Machine Learning for Pricing Bermudan/American Options in High Dimension은 머신러닝과 분산 감소를 결합해 "언제 팔지 정해야 하는" 다자산 미국형 옵션 가격을 계산했습니다. A fast method for pricing American options under the variance gamma model은 가격이 점프하는 상황을 허용하면서도 빠른 근사를 추구합니다.
이 테마의 공통 인사이트
2019년 3월의 옵션 연구는 "아름다운 완결해"를 좇지 않았습니다. 감당할 수 있는 계산 비용으로, 오차가 측정되는 근사를 만드는 데 몰두했습니다. 근사의 품질을 몬테카를로와 대조해 보여주는 태도는, 어떤 트레이딩 시스템의 성능 검증에도 그대로 적용되는 원칙입니다.
테마 2: 리스크를 하나의 숫자로 믿지 말기
주식 2,000개의 위험을 나타내는 표가 "병들어" 있다면
포트폴리오를 짤 때 우리는 주식들끼리 얼마나 같이 움직이는지(공분산)를 알아야 합니다. 그런데 이상한 일이 벌어집니다. 관측 기간이 2년(T = 500일 정도)이라면, 종목이 2,000개(N)일 때 표본 공분산 행렬은 수학적으로 병들어 있습니다. 통계학자들은 이걸 "특이(singular)하다"고 부르는데, 쉽게 말하면 "이 표로는 위험을 계산할 수 없다"는 뜻입니다. 관측 수가 종목 수에 한참 못 미치면(T ≪ N), 이 행렬의 최대 위계는 T−1에 불과합니다.
전통적 해법은 "산업 분류처럼 사람이 만든 틀에 기대는 것"이었습니다. 하지만 분류는 자의적이고, 시장은 분류대로 움직이지 않습니다.
대표 논문: 머신러닝으로 만드는 위험 모형 (1903.06334)
Machine Learning Risk Models (Quantigic Solutions, Duke-NUS, 복합점수 65.3)
이 논문의 아이디어는 기발하면서도 단순합니다. "병든" 표본 공분산 하나를 믿는 대신, k-means 군집화로 표본을 수없이 많이 뽑아내고(샘플링), 그 평균을 내라는 것입니다. 각각의 샘플은 병들어 있어도, 여러 개를 평균내면 요인 모형이 아닌 형태의 건강한 위험 모형이 얻어집니다. 여러 날씨 예보를 모아 평균을 내면 한 번의 예보보다 정확해지는 것과 비슷한 원리입니다.
핵심 결과는 이렇습니다.
- 백테스트에서 이 머신러닝 위험 모형은 기존 통계 위험 모형을 능가했고, 복잡한 다층 산업 분류 기반 모형과 비슷한 성능을 냈습니다. 그것도 단일 층 군집만으로요.
- 알고리즘 자체는 실행할 때마다 결과가 조금씩 달라지는(비결정적) 방식이지만, 재실험에서 결과는 안정적이었습니다.
- 공분산 추정을 한 번 더 반복하면 두 번째에서 약간 좋아지지만, 그 이상 반복하면 개선되지 않았습니다. 군집 수 K가 100개 이상이면 작은 고유값 문제 때문에 보정 방법을 바꿔야 했습니다.
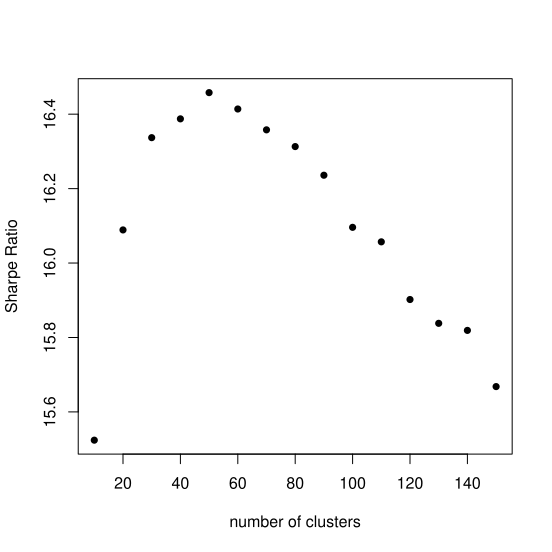
이 논문은 R 구현 코드를 논문 안에 포함했습니다. 백테스트 결과는 논문이 쓴 특정 종목군과 기간에 한정되고, 엄밀성 점수가 상대적으로 낮은 편이지만(58점), "그럴듯한 이론"보다 "바로 써볼 수 있는 구현"을 남긴 점이 실무적 강점입니다.
가볍게 읽어볼 논문들
Active and Passive Portfolio Management with Latent Factors(A등급, 65.9)는 "숨어 있는 요인"을 가격에서 필터링해 추정 수익률에 반영하고, 초과수익을 노리는 포트폴리오와 벤치마크를 따라가는 포트폴리오를 하나의 공식으로 만족시키는 해를 제시했습니다. Computation of systemic risk measures: a mixed-integer programming approach은 한 금융기관의 파산이 연쇄 도산으로 번지는 "시스템 리스크"를 컴퓨터로 계산하는 문제를 다룹니다. Portfolio optimization with two coherent risk measures는 리스크를 볼 때 서로 다른 두 눈(두 개의 리스크 척도)으로 동시에 보자는 제안입니다.
이 테마의 공통 인사이트
이 달의 포트폴리오 연구는 "단일 추정치를 불신하라"는 태도를 공유합니다. 공분산은 앙상블로, 리스크는 두 척도로, 시스템 위험은 전체 네트워크로 봐야 한다는 것. 투자 위험을 한 줄짜리 숫자로 요약하는 습관 자체를 되돌아보게 하는 연구들입니다.
테마 3: "얼마일까" 대신 "어떤 모양일까"
평균 예측으로는 답할 수 없는 질문들
"내일 이 종목의 수익률은?" 하면 보통 평균을 떠올립니다. "1% 오를 것이다." 하지만 실제 투자 결정에 더 중요한 질문은 이런 것들입니다. "3% 이상 떨어질 확률은?", "극단적으로 튈 가능성은?", "변동성이 갑자기 커질 분포의 꼬리는 두꺼운가?" 이 질문들에는 분포 전체를 알아야 답할 수 있습니다.
대표 논문: 신경망으로 분포를 그리는 기술의 모범 사례 (1903.00954)
Conditional Density Estimation with Neural Networks: Best Practices and Benchmarks (Karlsruhe Institute of Technology, 복합점수 66.0)
조건부 밀도 추정은 "입력 x가 주어졌을 때 y가 어떤 분포를 가질까"를 그리는 기술입니다. 혼합 밀도 네트워크(MDN) 같은 신경망은 이론상 어떤 분포든 그릴 수 있지만, 실전에선 과적합이라는 벽에 부딪힙니다. 그림을 너무 사실적으로 그리려다 보면 학습 데이터에만 맞는 엉뚱한 분포가 나오는 거죠.
이 논문의 해법은 의외로 소박합니다. 학습 데이터에 작은 잡음을 섞어라. 저자들은 이 간단한 트릭이 수학적으로 "로그밀도의 곡률에 페널티를 주는 것"(분포가 심하게 구불거리지 않게 하는 것)과 같다는 사실을 유도해냈습니다. "그림을 그릴 때 선을 너무 떨리지 않게 그리라"고 규칙을 정한 셈입니다.
검증도 철저했습니다. 인위적으로 만든 분포 3종과 유럽 주요 50개 기업 지수(EuroStoxx 50)의 실제 수익률을 대상으로 6개의 조건부 밀도 추정기를 비교했습니다.
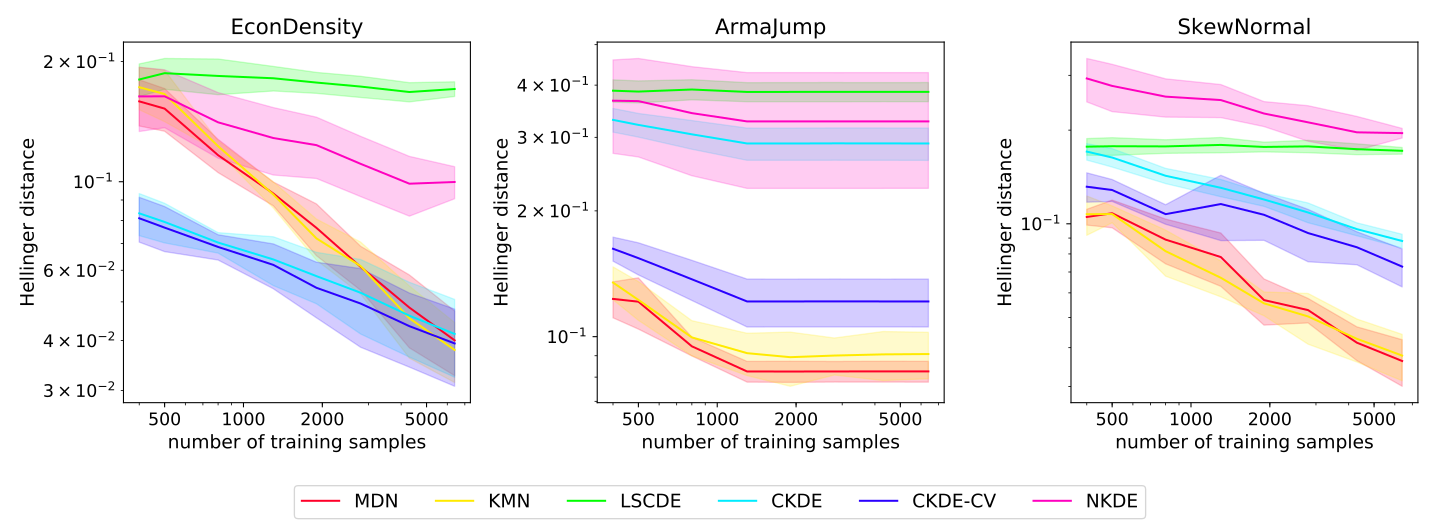
결과는 명쾌했습니다. 잡음 정규화를 적용한 MDN과 KMN이 기존의 준모수·비모수 추정기들을 능가했고, 데이터가 적은 상황에서도 신경망 방식이 기존 커널 밀도 추정의 대안 이상이었습니다. 코드가 GitHub(freelunchtheorem/Conditional_Density_Estimation)에 공개되어 있어 재현성 점수는 이 달 A등급 중 최고(78점)입니다.
가볍게 읽어볼 논문들
Estimating Dynamic Conditional Spread Densities to Optimise Daily Storage Trading of Electricity(A등급, 66.9)는 같은 아이디어를 에너지 시장에 적용했습니다. 전력은 시간대별로 가격이 크게 벌어지는데(예: 새벽 vs 저녁), 이 스프레드의 분포 전체(비대칭성, 꼬리 위험)를 예측해 배터리의 하루 충전·방전 일정을 짭니다. 평균만 맞추는 전략과 분포를 아는 전략의 차이가 실전 수익으로 직결되는 영역입니다.
이 테마의 공통 인사이트
예측의 대상을 '평균'에서 '분포'로 옮기는 것이 이 테마의 메시지입니다. 리스크 관리에서 "가장 나쁜 경우"를 다루려면 분포의 꼬리가 필요한데, 2019년 3월의 연구자들은 신경망을 '가격을 찍어내는 기계'가 아니라 '분포의 모양을 그리는 기계'로 쓰는 법을 정리하고 있었습니다.
테마 4: 백테스트가 거짓말하는 법
환상적인 백테스트 뒤에 숨은 것
트레이딩 전략을 만들면 누구나 백테스트(과거 데이터로 시뮬레이션)를 돌립니다. 그런데 종종 이런 일이 벌어집니다. 백테스트에서는 연 수십 %가 나오던 전략이 실제 매매에서 전혀 다르게 움직이는 거죠. 2019년 3월의 이 테마는 "왜 백테스트가 과장되는가"를 서로 다른 각도에서 파고듭니다.
대표 논문: 시장에는 "일어나지 않는 가격 경로"가 있다 (1903.07222)
Market Making under a Weakly Consistent Limit Order Book Model (Agam Capital, Michigan State University, 복합점수 65.3)
시장조성(market making)은 매수·매도 양쪽에 호가를 걸고 호가 스프레드를 버는 고빈도 전략입니다. 이 분야의 고전 모형(2008년 Avellaneda-Stoikov)은 수학적으로 우아하지만, 실제 호가창(LOB)의 중요한 사실을 하나 빠뜨립니다. 주문이 들어오는 방향에 따라 가격이 움직이는 방식이 일관되어야 한다는 것입니다. 예를 들어 "매수 주문이 들어왔는데 가격이 내려가는" 상황은 현실에서 일어나지 않습니다.
이 논문의 저자들은 시장조성 모형을 처음부터 다시 짰습니다. 대신 쓴 수학적 도구는 최적 전환(optimal switching)과 임펄스 제어라는 제어 이론이고, 그 해를 컴퓨터로 풀었습니다. 그리고 인기 있는 상장지수펀드(ETF)의 실제 호가창 통계로 캘리브레이션했습니다.
결론은 경고에 가깝습니다. 가격 움직임이 일관적이지 않은 호가창을 가정한 시뮬레이션에서는 시장조성 이익이 심각하게 과대평가될 수 있다는 것입니다.
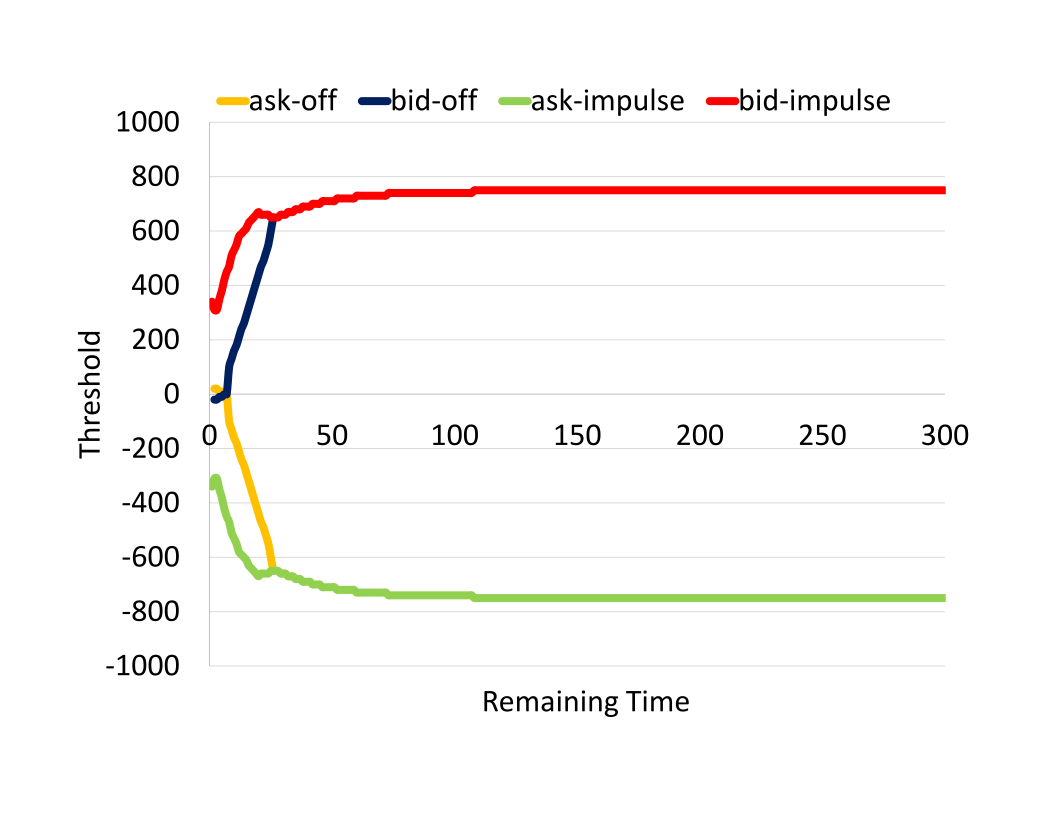
이 논문은 High Frequency 저널에 게재되었으며, 저자들은 Baron Law와 Frederi Viens입니다. 다만 공개 코드가 없어 재현성 점수가 낮은 편(38점)이라는 점은 알려드립니다. 그래도 "백테스트 가격 경로의 현실성부터 점검하라"는 메시지는 전략 검증의 기본 원칙으로 남을 만합니다.
가볍게 읽어볼 논문들
Short Selling with Margin Risk and Recall Risk(A등급, 66.3)은 "공매도 = 음수의 매수"라는 교과서식 생각이 틀린 이유를 보여줍니다. 실제 공매도에는 담보가 소진되는 위험(마진 위험)과 빌린 주식을 갑자기 되돌려줘야 하는 위험(회수 위험)이 있어서, 언제 포지션을 접을지 자체가 최적화 문제가 됩니다. Transaction Cost Analytics for Corporate Bonds는 회사채 거래의 체결 품질을 "예상 거래비용 기준선"으로 측정하는 실무적 방법론입니다. Market Manipulation as a Security Problem은 거래소의 주문매칭 시스템 자체를 보안 취약점의 관점에서 봐야 한다고 주장합니다.
이 테마의 공통 인사이트
전략의 성능은 전략 자체보다 거래 환경을 얼마나 현실적으로 재현했는가에 좌우됩니다. 가격 경로가 현실적인가, 거래비용이 반영됐는가, 매매 제약이 모형에 있는가 — 백테스트를 시작하기 전에 이 세 가지를 먼저 물어야 합니다.
테마 5: 시장은 감정의 네트워크다
비트코인 말고, 작은 코인 수천 개가 하는 일
2018년 초 암호화폐 시장은 그야말로 춘추전국이었습니다. 하루가 다르게 새 코인이 쏟아졌고, 사람들은 소셜 미디어에서 열광하고 공포했습니다. 그런데 당시 연구 대부분은 비트코인 하나만 들여다봤습니다. 시장 전체가 어떻게 얽혀 있는지, 감정이 가격을 움직이는지(혹은 반대인지) 아는 사람은 거의 없었습니다.
대표 논문: 1,944개 코인의 가격과 감정을 하나의 지도로 (1903.00472)
Cryptocurrency market structure: connecting emotions and economics (복합점수 63.9)
이 논문은 2018년 1월 2일부터 6월 14일까지 거래된 1,944개 암호화폐의 가격과 소셜 감정 데이터를 모두 모았습니다. 감정 데이터는 트위터와 StockTwits의 글을 자연어 처리해 긍정·부정으로 분류한 것입니다. 연구자들은 두 가지 도구를 썼습니다. 하나는 켄달 교차상관(함께 움직이는 정도)이고, 다른 하나는 전이 엔트로피(한쪽이 다른 쪽을 먼저 움직이는 정도, 즉 인과의 방향)입니다.
흥미로운 발견이 여럿 나왔습니다.
- 가격과 감정은 실제로 유의미하게 함께 움직입니다.
- 비트코인 같은 대형 코인은 가격 상관망의 중심이지만, 감정망에서는 변방에 머뭅니다. 사람들이 비트코인 이야기를 많이 하는 것과는 별개로, 감정의 네트워크 구조에서 비트코인이 중심이라는 뜻은 아니라는 것이죠.
- 가격이 감정을 일으키고, 감정도 가격을 일으킵니다. 감정에서 가격으로의 연결이 크기는 더 크지만, 유의한 연결의 수는 더 적습니다.
- 가장 놀라운 발견: 시가총액이 작은 소형 코인들이 시장 전체의 연결 구조를 짜는 데 결정적 역할을 합니다. 관찰 기간에 시장의 코인 수는 최대 1,301개(2018년 1월 말)에서 471개(6월 중순)로 줄었습니다.
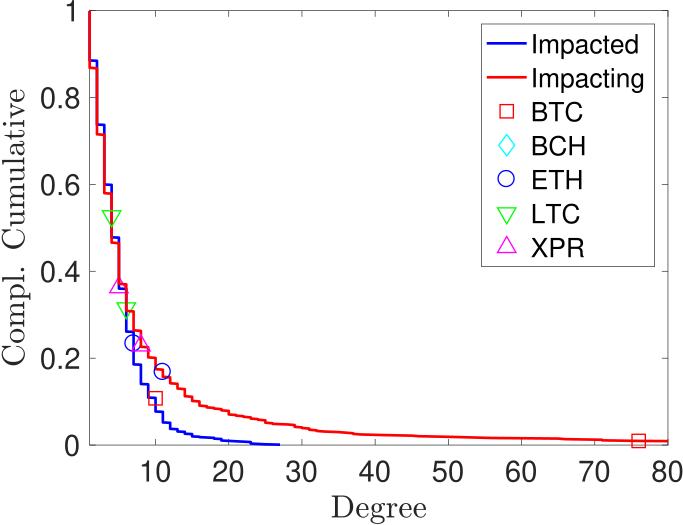
시간대별 데이터라 시계열이 짧고 노이즈가 많다는 한계는 분명합니다. 감정 데이터도 특정 공급자의 분류에 의존합니다. 그래도 "대형 코인만 보면 전체 감정 흐름을 놓친다"는 발견은 감성 기반 투자 신호를 설계할 때 종목을 고르는 기준이 됩니다.
가볍게 읽어볼 논문들
Market Trend Prediction using Sentiment Analysis: Lessons Learned and Paths Forward는 감정 분석의 "교훈"을 정리한 논문입니다. 감정을 "태도(강세/약세)"와 "감성(기쁨/두려움)"으로 나눠 보니, 시장 추세 예측에서 둘이 다르게 작동한다는 것입니다. Multimodal Deep Learning for Finance은 여러 나라 주식시장 사이의 파급 효과를 딥러닝으로 통합해 예측합니다. Altcoin-Bitcoin Arbitrage는 알트코인과 비트코인 사이의 평균회귀 차익 전략과 코드를 공개했고, Cross-shareholding networks and stock price synchronicity는 기업 간 출자 관계(인맥!)가 주가를 함께 움직이게 만든다는 사실을 중국 시장에서 보여줍니다.
이 테마의 공통 인사이트
개별 자산의 가격만 보는 시선에서 자산들 사이의 관계, 가격과 사람들의 감정 사이의 방향성으로. 2019년 3월의 이 연구들은 모두 "연결"을 다룹니다. 오늘날의 대안 데이터 트레이딩이 짚어가야 할 방향을 이미 예고하고 있었습니다.
월 전체 Big Picture
2019년 3월의 금융 AI 연구를 관통하는 메시지는 "정확한 단일 해 대신, 품질이 검증된 근사와 전체 분포를 다루라"는 것입니다.
변동성 옵션 가격은 대편차 원리로 근사하고(1903.02833), 수익률의 미래는 분포 전체로 그리며(1903.00954), 리스크 모형은 병든 추정치 여러 개의 앙상블로 만듭니다(1903.06334). 한편으로는 "백테스트의 가격 경로가 비현실적이면 수익이 부풀려진다"(1903.07222)는 경고와 "대형 코인만 보면 시장 전체의 감정 흐름을 놓친다"(1903.00472)는 발견이 나옵니다.
이 시기의 연구자들은 AI를 '예측의 마법'이 아니라 '추정의 도구'로 쓰기 시작했습니다. 7년 뒤 LLM 트레이딩 에이전트가 등장하는 시점과 나란히 놓고 보면, 연구의 무게중심이 '수학적 근사의 품질'에서 '데이터와 실험의 규모'로 이동했음을 알 수 있습니다. 다만 2019년 3월이 남긴 교훈 — 근사의 오차를 측정하고, 백테스트의 현실성을 점검하고, 코드를 공개해 재현성을 확보하라 — 는 오늘날에도 한 글자도 바꿀 필요가 없습니다.
더 알아보기
이 글에서 다룬 논문들의 arXiv 링크입니다. 복합점수는 ohselab KB의 5차원 평가(새로움·적용성·엄밀성·재현성·통찰)를 합성한 점수입니다.
- Asymptotics for volatility derivatives in multi-factor rough volatility models — A등급, 복합점수 74.1 (새로움 78, 엄밀성 83)
- Estimating Dynamic Conditional Spread Densities to Optimise Daily Storage Trading of Electricity — A등급, 복합점수 66.9 (적용성 78)
- Short Selling with Margin Risk and Recall Risk — A등급, 복합점수 66.3 (엄밀성 84)
- Conditional Density Estimation with Neural Networks: Best Practices and Benchmarks — A등급, 복합점수 66.0 (재현성 78)
- Active and Passive Portfolio Management with Latent Factors — A등급, 복합점수 65.9 (엄밀성 77)
- Market Making under a Weakly Consistent Limit Order Book Model — A등급, 복합점수 65.3 (통찰 78)
- Machine Learning Risk Models — A등급, 복합점수 65.3 (적용성 75)
- Cryptocurrency market structure: connecting emotions and economics — B등급, 복합점수 63.9 (새로움 74)
이 글에서 다룬 8편 외에도 2019년 3월 코호트에서는 공매도의 회수 위험, 회사채 거래비용 분석, 시스템 리스크 계산, 감정 분석의 교훈 등 총 56편의 관련 논문이 평가되었습니다. 전체 목록과 테마별 상세 분석은 백필 리포트 1903에서 확인할 수 있습니다.
📚 이 글에서 다룬 논문 (19편)
- AAsymptotics for volatility derivatives in multi-factor rough volatility models
Chloe Lacombe, Aitor Muguruza, Henry Stone
- A
- AShort Selling with Margin Risk and Recall Risk
Kristoffer Glover, Hardy Hulley
- AConditional Density Estimation with Neural Networks: Best Practices and Benchmarks
Jonas Rothfuss, Fabio Ferreira, Simon Walther 외 1명
- AActive and Passive Portfolio Management with Latent Factors
Ali Al-Aradi, Sebastian Jaimungal
- AMarket Making under a Weakly Consistent Limit Order Book Model
Baron Law, Frederi Viens
- A
- BStacked Monte Carlo for option pricing
Antoine Jacquier, Emma R. Malone, Mugad Oumgari
- BVariance Reduction Applied to Machine Learning for Pricing Bermudan/American Options in High Dimension
Ludovic Goudenège, Andrea Molent, Antonino Zanette
- BComputation of systemic risk measures: a mixed-integer programming approach
Çağın Ararat, Nurtai Meimanjan
- BPortfolio optimization with two coherent risk measures
Tahsin Deniz Aktürk, Çağın Ararat
- BTransaction Cost Analytics for Corporate Bonds
Xin Guo, Charles-Albert Lehalle, Renyuan Xu
- B
- BMarket Trend Prediction using Sentiment Analysis: Lessons Learned and Paths Forward
Andrius Mudinas, Dell Zhang, Mark Levene
- B
- BCross-shareholding networks and stock price synchronicity: Evidence from China
Fenghua Wen, Yujie Yuan, Wei-Xing Zhou
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2023-12 월간A
2023년 12월의 금융 AI 연구: 모형을 덜 믿고, 데이터를 더 믿는 다섯 가지 이야기
2023년 12월 arXiv의 금융 연구를 5개 테마로 정리했습니다. 경로를 기억하는 옵션 가격결정(시그니처), 최악의 시나리오를 계산하는 리스크 측도(약한 최적수송), 모형 없이 포트폴리오를 배우는 강화학습, 1밀리초 만에 독성 주문을 탐지하는 온라인 베이지안 신경망, 시간이 지나도 약속을 지키는 균형 전략까지 — 2023년 말 금융공학의 흐름을 쉽게 풀어 설명합니다.
 📊 2021-04 월간
2021년 4월의 AI 금융 연구: 리스크 지표의 치명적 약점, 그리고 실행의 비밀
2021년 4월 arXiv에 올라온 금융 AI 논문 중 주목할 만한 연구를 4가지 테마로 정리합니다. CoVaR 백테스트 불가능성, 전력 시장 최적 입찰, 랭킹 기반 롱·숏 포트폴리오, Hermite 다항식 옵션 가격결정 등을 살펴봅니다.
 📊 2019-07 월간A
옵션 가격결정과 거친 변동성, 그리고 Quant GANs: 2019년 7월 금융 AI 논문
2019년 7월 arXiv 금융 AI 연구를 5개 테마로 정리했습니다. 모델 없이 옵션 가격 상한을 구하는 수학, 미시구조에서 태어나는 거친 변동성, 금융 시계열을 생성하는 Quant GANs, 로보 투자의 진짜 수혜자, 강화학습 자산배분 — 생성형 AI 이전의 기초 공사 현장을 다룹니다.