
매달 arXiv에 쏟아지는 금융 AI 논문 중에서 의미 있는 연구를 골라 정리합니다. 이번에는 2019년 4월입니다. 이 달의 논문들을 읽다 보면 하나의 인상이 강하게 남습니다 — "시장이라는 실험실을 다시 설계하자." 주식 시장은 세상에서 가장 '실험하기 어려운' 대상입니다. 같은 날을 두 번 살 수 없고, 큰 주문을 넣어 보고 결과를 지울 수 없습니다. 2019년 4월의 연구자들은 이 문제를 여러 방향에서 공격합니다 — 가짜 시장을 통째로 만들어 버리거나(시뮬레이터), 시장이 매긴 가격에 모델을 정확히 끼워 맞추거나(옵션 보정), 흩어진 공시 문서에서 사건을 표로 뽑아내거나(문서 이해). 다 같이 "실험 가능한 금융"을 향한 발걸음입니다.
들어가며: 비행기와 풍동 실험
비행기가 날기 전에 항공 회사들은 풍동(wind tunnel) 에서 모형을 테스트합니다. 실제 하늘에 올려보기 전에, 바람을 통제하면서 수천 번 실험하는 거죠. 트레이딩 세계에는 그동안 이런 풍동이 없었습니다. 트레이딩 전략을 시험하려면 실제 시장이라는 "유일한 하늘"에 띄워 보는 수밖에 없었고, 그러다 보면 어떤 전략이 왜 실패했는지 원인을 분리하기 어려웠습니다 — 시장이 폭락해서? 내 주문이 커서? 운이 나빠서?
2019년 4월의 다섯 갈래 이야기는 이 "풍동의 부재"를 겨냥합니다. 시장 자체를 실험실로 옮기는 연구, 모델과 시장 가격 사이의 틈을 수학으로 메우는 연구, 투자자의 현실(거친 변동성, 흔들리는 기준, 매매 비용)을 최적화에 되돌려 넣는 연구, 가격의 '기초 공사'를 담당하는 이론, 그리고 문서 속 사건을 구조화하는 AI까지. 흥미롭게도 이 다섯 이야기 모두 "숫자를 실험으로 검증할 수 있게 만드는 것"을 지향합니다.
테마 1: 시장에 '풍동'을 세우다 — 가짜 시장에서 실험하기
왜 흥미로운가
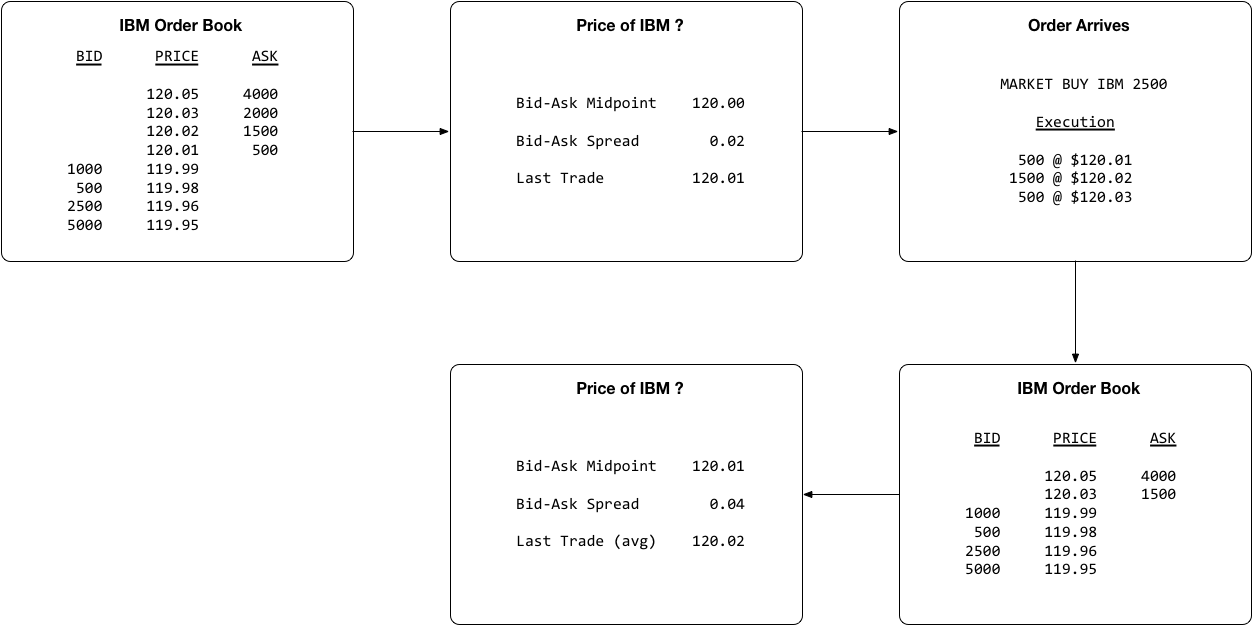
"큰 주문을 한 번에 넣으면 시장 가격이 밀리고, 밀린 가격 때문에 내 수익이 줄어듭니다." — 트레이더라면 모두 아는 사실입니다. 그런데 정확히 얼마나 밀릴까요? 밀림이 얼마나 오래 갈까요? 이 질문에 답하려면 "큰 주문을 넣은 날"과 "넣지 않은 날"을 비교해야 하는데, 역사는 한 번뿐입니다. 2008년 9월 30일 IBM에 대량 매수를 넣었다면 어떻게 되었을지는, 실제로 넣지 않았다면 영원히 모릅니다.
대표 논문: AI 연구용 고충실도 시장 시뮬레이터, ABIDES
이 연구(1904.12066)는 시장 전체를 컴퓨터 안에 재현하는 시뮬레이터 ABIDES를 공개합니다. 이름은 Agent-Based Interactive Discrete Event Simulation의 앞글자인데, 핵심 아이디어는 단순합니다 — 실제 거래소가 일하는 방식 그대로 가짜 시장을 만들자는 겁니다.
무엇이 '그대로'일까요? 실제 미국 거래소 NASDAQ은 주식 시세를 보내는 규칙(ITCH 프로토콜)과 주문을 받는 규칙(OUCH 프로토콜)을 문서로 공개합니다. ABIDES는 이 규칙을 그대로 모사해서, 트레이딩 프로그램(에이전트)과 거래소가 메시지를 주고받으며 거래하게 했습니다. 여기에 세 가지 디테일이 더해집니다.
- 나노초 시계: 실제 거래소와 같은 시간 해상도로 시뮬레이션합니다. 초 단위로 움직이는 알고리즘 트레이더와 하루에 한 두 번 주문하는 투자자가 같은 시장에 어울려 살 수 있습니다.
- 개별 통신 지연: 각 에이전트마다 거래소까지의 네트워크 지연 시간을 따로 설정합니다. "먼저 주문을 넣은 사람이 유리하다"는 고빈도 거래의 현실이 재현되는 셈입니다.
- 과거 날짜 재현: 특정 역사적 날짜를 배경으로 깔고, 실제 그날의 거래 기록을 '노이즈와 함께' 공급해 에이전트들이 현실적인 가격에 반응하게 합니다.
이 가짜 시장에는 배경 시민 같은 존재가 필요합니다. 연구진은 아주 단순한 규칙의 '배경 에이전트' 100개를 풀어 놓았습니다 — 각자 최근 거래 가격을 흘끔 보고(물론 약간의 착오와 함께), 자기가 생각하는 적정가와의 차이를 메우는 주문을 넣는, 극도로 단순한 투자자들입니다. 놀랍게도 이 단순한 군중 100명이 만들어 내는 가격 흐름은 IBM 2008년 9월 30일, MSFT 2016년 6월 24일의 실제 일중 거래와 비슷한 모습을 보였습니다.
무엇을 알아냈나
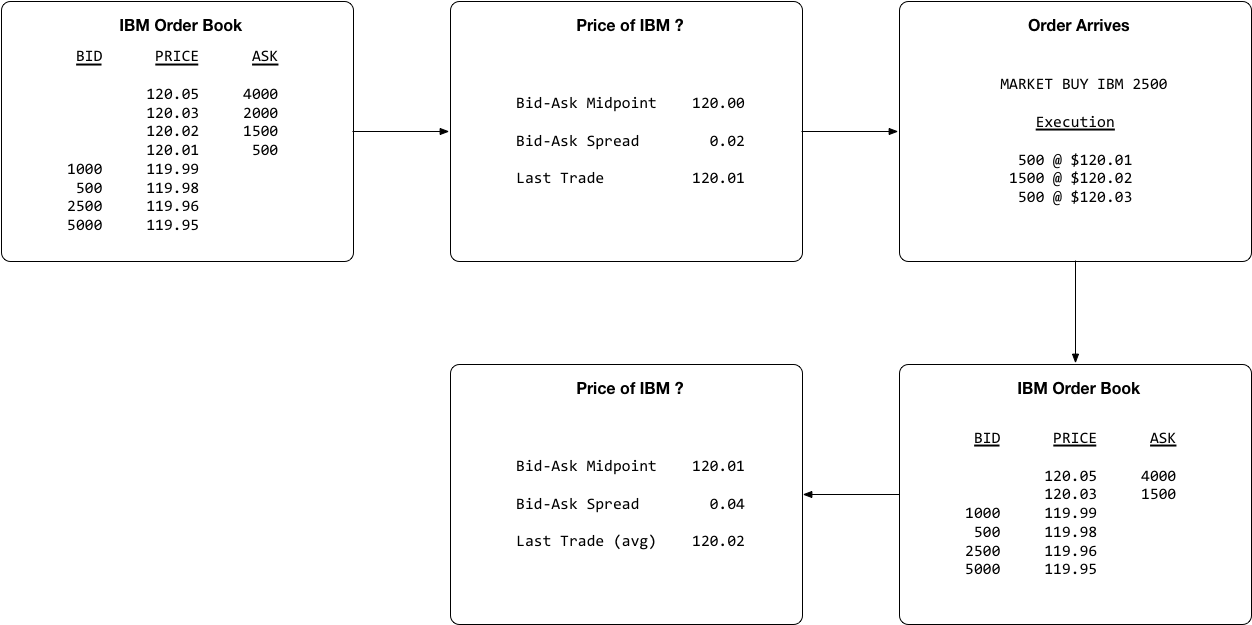
진짜 볼거리는 시장충격 실험입니다. 배경 에이전트 100명이 우글대는 시장에, 실험용 에이전트를 딱 한 마리 투입해 오전 10시에 시장가 매수 한 번을 넣게 했습니다. 실험 변수는 주문의 '탐욕' — 스프레드 근처의 매도 잔량 중 몇 퍼센트를 쓸어 담는가입니다. 주문 크기를 1,232주 / 2,874주 / 5,338주 / 7,801주로 바꿔 가며 관찰했습니다.
- 주문이 커질수록 시장 가격에 남기는 상처(가격 상승)는 비례해서 커졌습니다. 배경 에이전트들이 가격을 원래대로 되돌리려 하는 경향이 있음에도, 충격은 뚜렷했고 특히 경매가 치솟는 주기적 고점에서 두드러졌습니다.
- 더 재미있는 숫자는 이겁니다. 큰 주문을 넣은 실험 에이전트의 총 이익은 탐욕 0.3일 때 평균 미화 2,633달러, 탐욕 1.9일 때 미화 12,502달러로 늘었습니다. 그런데 주당 이익은 오히려 2.14달러에서 1.60달러로 줄었습니다. 쉽게 말하면 "많이 사면 총 이익은 커지지만, 나 혼자 시장을 밀어 올린 대가로 주당 효율은 나빠진다"는 뜻입니다. 큰 주문의 시장충격이라는 고전적 딜레마를 가짜 시장이 정확히 재현해 낸 순간입니다.
- 논문은 큰 주문의 충격이 직후에 그치지 않고 상당 기간 이어진다고 강조합니다. 실험 날짜로 2008년 9월(금융위기의 한복판)을 고른 것도 그래서입니다.
그리고 이 시뮬레이터는 누구나 무료로 내려받을 수 있게 공개했습니다(GitHub, BSD 라이선스). 재현성 점수가 이 달 심층 대상 중 가장 높은 이유입니다. 이후 ABIDES는 체육관(Gym) 인터페이스를 얹은 확장판으로 발전해, 강화학습 트레이딩 연구의 공통 실험대가 되었습니다 — "AI 연구용 공개 풍동"이라는 이 논문의 목표가 실제로 지켜진 셈입니다.
한계와 조심할 점
배경 에이전트는 극도로 단순한 규칙이고, "실제 시장과 얼마나 비슷한가"를 재는 엄격한 통계 기준은 제시하지 않습니다(엄밀성 점수 57). 거래 수수료 같은 제도적 요소도 빠져 있습니다. "가짜 시장에서 통했다"가 "진짜 시장에서 통한다"를 뜻하지는 않는다는 점, 이 연구 자체도 인정하는 한계입니다.
가볍게 더 보기
같은 주제를 다른 각도에서 본 논문들도 있습니다. 1904.03058은 호가창(주문이 쌓인 장부) 전체를 하나의 미분방정식(확률 편미분방정식)으로 묘사해, 가격과 주문 흐름을 하나의 수학 모형으로 묶습니다. 1904.01566은 증권사가 대신 매매해 주는 알고리즘들의 실제 거래 비용을 베이지안 통계로 비교·순위 매기는 실무 도구를 제안합니다 — 표본이 적어도 안정적으로 비교할 수 있어서, "이 알고리즘이 진짜 싼가?"를 데이터로 묻는 방법입니다.
이 테마의 공통 인사이트
"시장에 큰 주문이 미치는 영향" 같은 질문은 관찰만으로는 영원히 답할 수 없습니다. 이 논문들은 시뮬레이터(ABIDES), 수학 모형(호가창 SPDE), 실무 데이터 분석(베이지안 거래비용) 세 갈래로 시장을 '반복 실험이 가능한 대상'으로 옮기려 합니다. 개별 종목 예측이 아니라 주문이 시장에 남기는 흔적을 정량화하는 것이 목표입니다.
테마 2: 옵션 가격을 정확히 끼워 맞추기 — 모델을 망가뜨리지 않는 보정
왜 흥미로운가
옵션 시장에는 가격표가 걸려 있습니다 — 행사가별로 콜옵션 가격이 쭉 나열된 표죠. 문제는 이 가격표와 우리가 쓰는 가격 모델(예: 헤스톤 모델)이 서로 말이 안 맞는 경우가 많다는 점입니다. 모델을 시장에 맞추려면 보통 모델의 내부 성질을 뜯어고쳐야 하는데, 그러다 보면 "이 모델이 원래 가진 변동성의 성격"이 사라져 버립니다 — 수선을 하다 옷의 원단을 바꿔 버리는 격입니다. 시장 가격에 정확히 맞추면서도 모델의 본질은 그대로 보존할 수는 없을까요?
대표 논문: 슈뢰딩거 브리지로 만드는 변동성 모델
이 연구(1904.04554)는 확률론의 고전 도구인 슈뢰딩거 브리지에서 힌트를 얻어 이 문제를 풉니다. 슈뢰딩거 브리지는 "출발 시점의 분포에서 도착 시점의 분포로 가는 경로 중에서 가장 '무작위적인' 경로"를 찾는 수학입니다. 쉽게 말하면, 도착지(시장 가격이 암시하는 분포)에 도달해야 한다는 조건만 지키면서, 경로를 최대한 덜 억지로 흔들어 놓는 겁니다.
연구진은 이 아이디어를 마팅게일(가격의 공정성 조건) 버전으로 바꿔 금융에 맞췄습니다. 결과는 놀랍습니다.
- 시장 가격(바닐라 옵션, 실현분산 옵션, VIX 옵션)에 정확히 맞추면서,
- 원래 모델이 가진 변동성의 변동성(vol-of-vol)은 전혀 손대지 않습니다. 변동성의 드리프트(움직임의 방향)만 조정하기 때문입니다.
가격을 맞추는 계산은 싱크혼 알고리즘이라는 효율적인 반복 계산법의 변형으로 수행했습니다.
무엇을 알아냈나
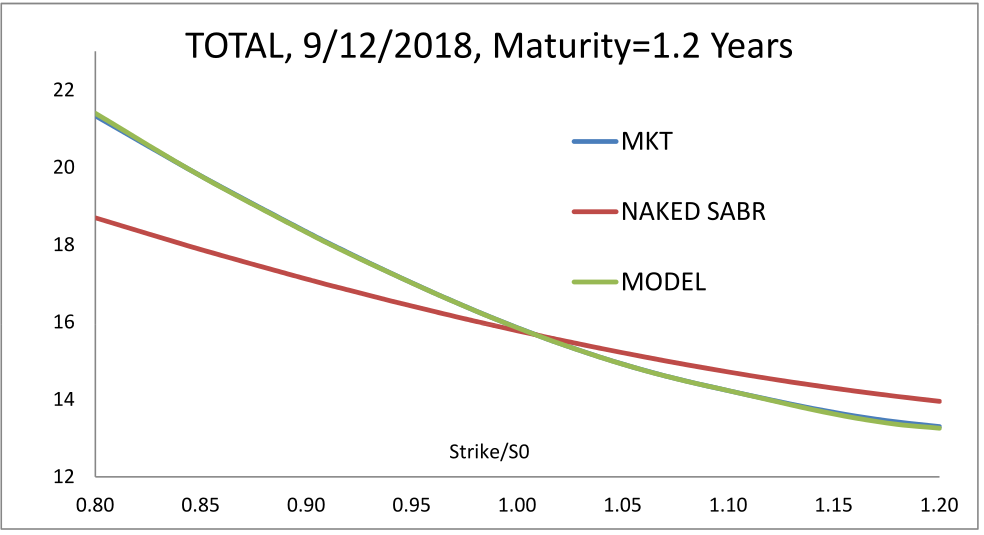
실제 시장 데이터로 검증했습니다. 프랑스 에너지 기업 TOTAL의 바닐라 옵션(가격일 2018년 9월 12일, 만기 1.2년)을 대상으로, 변동성 모델(로그정규 SABR 모형: 변동성 15.8%, 변동성의 변동성 40%, 주가-변동성 상관 −61%)을 준비했습니다. 이 초기 모델은 ATM(현재가 부근) 변동성은 맞았지만 스큐(기울기)가 틀렸습니다.
드리프트 보정을 거친 뒤 몬테카를로로 옵션을 다시 가격해 보니, 시장 가격 곡선과 모델 가격 곡선이 겹쳤습니다. 아래 그림이 그 결과입니다 — 왼쪽은 스마일(행사가별 내재변동성 곡선)이 시장과 모델에서 일치하는 모습, 오른쪽은 보정에 사용된 20개 행사가의 가중치입니다.
추가로 두 가지 보너스가 있습니다. 바닐라 옵션과 VIX 옵션을 동시에 맞추는 정리도 증명했고(정리 4.6), 보정된 모델이 물리학·확률론의 대상인 Dyson 비충돌 브라운 운동과 놀라운 관계를 맺는다는 사실도 발견했습니다. 변동성 모델과 전혀 다른 수학 분야가 만나는 지점입니다.
한계와 조심할 점
재현성 점수가 35로 낮습니다 — 코드가 공개되지 않았고, 수치 실험이 TOTAL 한 건에 불과합니다. 그리고 "시장 가격에 정확히 맞춘다"는 것은 현재 가격과 모순이 없다는 뜻이지, 미래 가격을 예측한다는 뜻이 아닙니다. 보정이 아무리 정확해도 내일의 시장은 다릅니다.
가볍게 더 보기
같은 목표(시장 가격과의 정합성)를 신경망으로 추구하는 연구들도 이 달에 나왔습니다. 1904.12834은 변동성 스마일의 형태를 반영한 맞춤 활성화 함수와 "무차익 조건·경계 조건을 어기지 않는다"는 규칙을 신경망 손실에 넣어, 금융 법칙을 지키는 내재변동성 표면 예측 모델을 만듭니다. 1904.10523은 옵션 가격 기반 모델 보정을 신경망의 오프라인 계산으로 바꿔, 매번 무거운 최적화를 돌리지 않고도 파라미터를 뽑게 합니다. 1904.12260은 VIX 옵션의 가격과 헤지 전략을 점프 변동성 모형(BNS)에서 명시적으로 계산합니다.
이 테마의 공통 인사이트
"모델을 고쳐 가격을 맞추기"보다 "모델의 본질을 지키면서 맞추기"가 이 달의 화두입니다. 수학적 보정(슈뢰딩거 브리지)과 신경망 보정(제약 조건 손실)은 방법은 달라도 목표가 같습니다 — 시장이 매긴 가격과 모순되지 않는 가격 체계. 파생상품 리서치에서 "보정"은 더 이상 수선이 아니라 재조립의 기술이 되어 가고 있습니다.
테마 3: "얼마를 사야 할까"의 세 가지 난제 — 거칠기, 흔들리는 기준, 매매 비용
왜 흥미로운가
"주식 60%, 채권 40%" 같은 최적 포트폴리오 숫자는 보통 아주 깔끔한 가정 위에서 나옵니다 — 변동성이 일정하고, 투자 기준이 시간이 지나도 변하지 않고, 매매에 비용이 안 든다고 가정하죠. 그런데 현실은 그 반대입니다. 변동성은 거칠게 출렁이고(심지어 "변동성의 변동성"이 따로 있습니다), 오늘의 나와 1년 후의 나는 다른 판단을 내리고, 사고팔 때마다 비용이 깎입니다. 이 세 가지를 무시한 최적 비중은 '종이 위의 최적'일 뿐입니다.
대표 논문: 거친 변동성 아래에서도 풀리는 포트폴리오 문제
이 연구(1904.12442)는 그중에서도 가장 수학적으로 까다로운 거친 변동성을 정면으로 다룹니다. 실증 연구들은 변동성의 궤적이 평범한 무작위 걸음보다 훨씬 거칠게 출렁인다고 보고합니다. 문제는 이런 거친 변동성 모델이 시장 데이터는 잘 묘사하면서도, 표준 최적화 도구가 먹히지 않는 비마르코프(과거 전체가 미래에 영향을 미치는) 구조라 포트폴리오 계산이 엄청나게 어렵다는 점입니다.
연구진은 보조 과정을 영리하게 구성해 이 난제를 우회하고, 최적 투자 비중을 리카티-볼테라 방정식이라는 계산 가능한 형태로 뽑아냈습니다. 이론적 하이라이트는 위안이 되는 결론입니다 — 거칠기가 투자자의 기회를 왜곡하지만, 위험-수익 맞교환 곡선(효율적 프런티어)은 여전히 이차 곡선 형태를 유지합니다.
무엇을 알아냈나
수치 실험에서 두 가지가 눈에 들어옵니다.
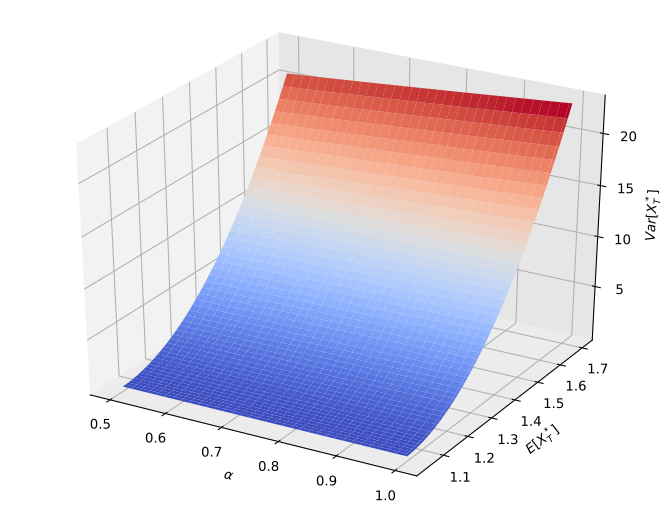
- 거칠기의 효과는 '변동성의 변동성'에 달려 있습니다. 변동성의 변동성이 작으면 거칠수록 주식 비중을 줄이는 편이 유리하고, 크면 반대로 늘리는 편이 유리합니다. "변동성이 거칠면 → 주식을 덜 사라"는 단순한 규칙은 없다는 뜻입니다. 대신 변동성의 변동성 추정이 틀리면 비중 결정도 함께 틀립니다.
- 캘리브레이션 비교: 똑같은 시장 변동성 표면에 고전 헤스톤 모델과 거친 헤스톤 모델을 각각 보정해 두고 전략을 비교하면, 거친 헤스톤 투자자는 일관되게 주식을 더 많이 보유했습니다(모든 시뮬레이션에서 반복된 현상). 그리고 평균 최종 자산이 목표 수익(초기 자산의 1.1163배)에 더 가깝게 도달했습니다.
한계와 조심할 점
재현성 점수 38 — 코드가 없고, 실험의 일부는 "변동성을 일정하게 고정한 채 거칠기만 바꾸는" 인위적 설정입니다(논문도 감성 분석이라고 명시). 거래비용·리밸런싱 제약은 다루지 않았습니다. "거친 모델이 더 좋다"의 보증이 아니라, "거친 모델을 쓴다면 비중이 이렇게 달라질 수 있다"의 지도에 가깝습니다.
가볍게 더 보기
포트폴리오 문제의 다른 두 난제도 이 달의 뜨거운 주제였습니다. 1904.11392은 연속시간 포트폴리오 문제를 강화학습으로 풀어, "탐색과 활용의 절충"이 이론적으로 '시간이 갈수록 보수적으로 변하는 가우시안 정책'임을 증명합니다. 1904.01745은 희귀한 위험을 과대평가하는 인간의 경향(확률왜곡)이 만드는 시간 불일치 — 오늘의 계획과 1년 후의 욕구가 어긋나는 문제 — 를 수학으로 다룹니다. 1904.09379은 투자 기간을 미리 정하지 않아도 성립하는 강건한 투자 기준을 제안합니다. 1904.08925은 지수추종·균등가중 같은 체계적 포트폴리오 전략을 거래비용까지 빼고 난 실제 성과로 비교합니다 — 이론 수익률이 아니라 실수령 수익률의 문제입니다.
이 테마의 공통 인사이트
"최적 포트폴리오"는 상수가 아니라 조건의 함수입니다. 변동성의 거칠기, 투자자의 시간 일관성, 매매 비용 — 각각을 무시할 때마다 '종이 위의 최적'은 현실에서 한 걸씩 어긋납니다. 이 달의 연구들은 각자 담당한 현실 조건 하나씩을 최적화 이론에 되돌려 넣고 있습니다.
테마 4: 가격의 기초 공사 — 모델 없이 가격의 상한을 계산하는 수학
왜 흥미로운가
이 테마는 눈에 잘 안 띄지만, 나머지 모든 계산의 땅을 담당합니다. "모델을 골라야 가격이 나오는" 대신, 시장 가격 정보만으로 이 파생상품의 가격은 이 범위를 벗어날 수 없다고 말하려면 — 가격의 상한과 하한을 모델 없이 계산하려면 — 무엇이 "옳은 계산"인지 먼저 증명해야 합니다. 수학자들이 '기초 공사'라고 부르는 종류의 작업입니다.
대표 논문: 경로 전체 위에서 가격 상한을 계산하는 정수
이 연구(1904.04644)가 다루는 마팅게일 최적수송은 이런 도구입니다. "가격 경로가 지켜야 할 조건(초기 가격, 만기 가격 분포, 공정성 조건)만 주어졌을 때, 이 조건들을 만족하는 모든 세상 중에서 가장 비싸게 복제되는 가격"을 계산하면, 그게 모델을 모르는 투자자에게 안전한 가격 상한이 됩니다. 모델을 통째로 빼고 가격 범위만 말하는, 강건 금융의 핵심 아이디어입니다.
문제는 이 계산이 "정말 그런 값을 내는가" — 원문제(복제 비용)와 쌍대문제(가능한 모든 세상의 가격)의 값이 같다는 쌍대성 — 를 연속시간, 가격 경로 전체에서 증명하기가 몹시 어렵다는 점입니다. 경로들의 공간에는 위상(수렴의 개념)이 까다롭고, 경로 위의 적분(이익의 계산) 정의부터 흔들립니다.
연구진은 경로 공간의 위상(야쿠보프스키의 S-위상)을 정비하고, 몫집합이라는 도구로 헤지 전략들을 분류해, 마침내 쌍대 표현을 증명했습니다(정리 3.1). "복제 비용 = 모든 정합한 세상(마팅게일 측도) 중 가장 비싼 기대값"이라는 등식이 성립한다는, 이 분야의 근간이 되는 결과입니다. 이 틀 안에서 말기 분포만 고정하는 경우, 초기값까지 고정하는 경우, 여러 시점의 분포를 고정하는 경우(바닐라 옵션 만기별 가격표)까지 하나의 프레임워크로 다룹니다.
한계와 조심할 점
이 논문에는 수치 실험이 없습니다. 산출물은 정리와 증명, 그리고 조건이 꼭 필요한지를 보여 주는 반례들입니다. 트레이딩 전략이나 바로 쓸 계산법을 찾는 독자에게는 당장 쓸 것이 없습니다(적용성 점수 52). 대신 엄밀성 86 — "이 계산법이 왜 옳은가"에 대한 보증서로는 이 달 최고 수준입니다.
가볍게 더 보기
이 '기초 공사' 팀의 다른 연구들입니다. 1904.04171은 "데이터가 약간 노이즈를 포함해도 계산된 가격 경계가 터무니없이 튀지 않는다"(안정성)를 증명합니다. 1904.04546은 이론을 신경망으로 실제로 계산하는 알고리즘을 제안하고, 금융 데이터 생성·이상 탐지로 확장합니다. 1904.08780은 "모델을 여러 개 동시에 후보로 두는" 상황에서 무차별(no-arbitrage)의 정의를 정돈합니다.
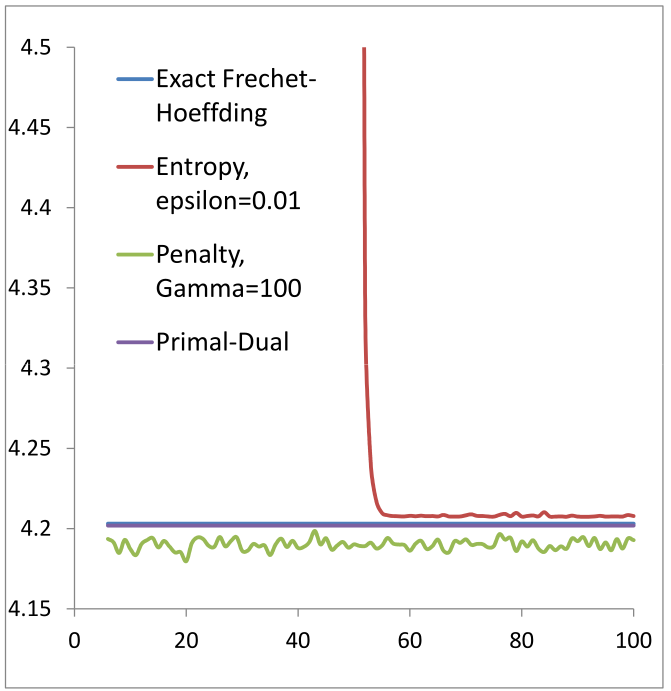
아래 그림은 이론 대신 계산 연구(1904.04546)의 그림입니다 — 대표 논문이 수학 이론이라 그림이 없어, 같은 테마의 수치 실험으로 대체했습니다. 두 확률 분포 사이의 최적수송 값(이론값 4.20)을 신경망 알고리즘이 반복 계산으로 맞춰 가는 모습입니다.
이 테마의 공통 인사이트
"모델을 고르지 않고" 가격 범위를 말하는 강건 금융은 매력적이지만, 그 계산이 옳다는 보증 없이는 무용지물입니다. 이 달의 논문들은 쌍대성(04644), 안정성(04171), 계산법(04546), 무차별 정의(08780)로 그 보증을 한 층씩 쌓아 올립니다. 눈에 보이는 수익은 없지만, 모델-무관 가격을 실무에 쓰려는 모든 팀이 언젠가 통과해야 하는 관문입니다.
테마 5: AI가 예측에서 '표 채우기'로 — 문서 이해와 위험민감 학습
왜 흥미로운가
인공지능 트레이딩이라면 주가를 예측하는 로봇을 떠올리기 쉽습니다. 그런데 실제 투자 리서치에서 필요한 것은 예측만이 아닙니다. "이 회사에 무슨 일이 일어났는가"를 표로 정리하는 일, "지금 얼마나 들고 있을까"를 결정하는 일, "평균 수익이 아니라 나쁜 경우에 얼마나 잃는가"를 고르는 일 — 모두 예측이 아니라 의사결정의 구조입니다. 2019년 4월의 AI 연구들은 이 방향으로 확실히 움직이고 있습니다.
대표 논문: 흩어진 공시에서 사건 표를 채우는 AI, Doc2EDAG
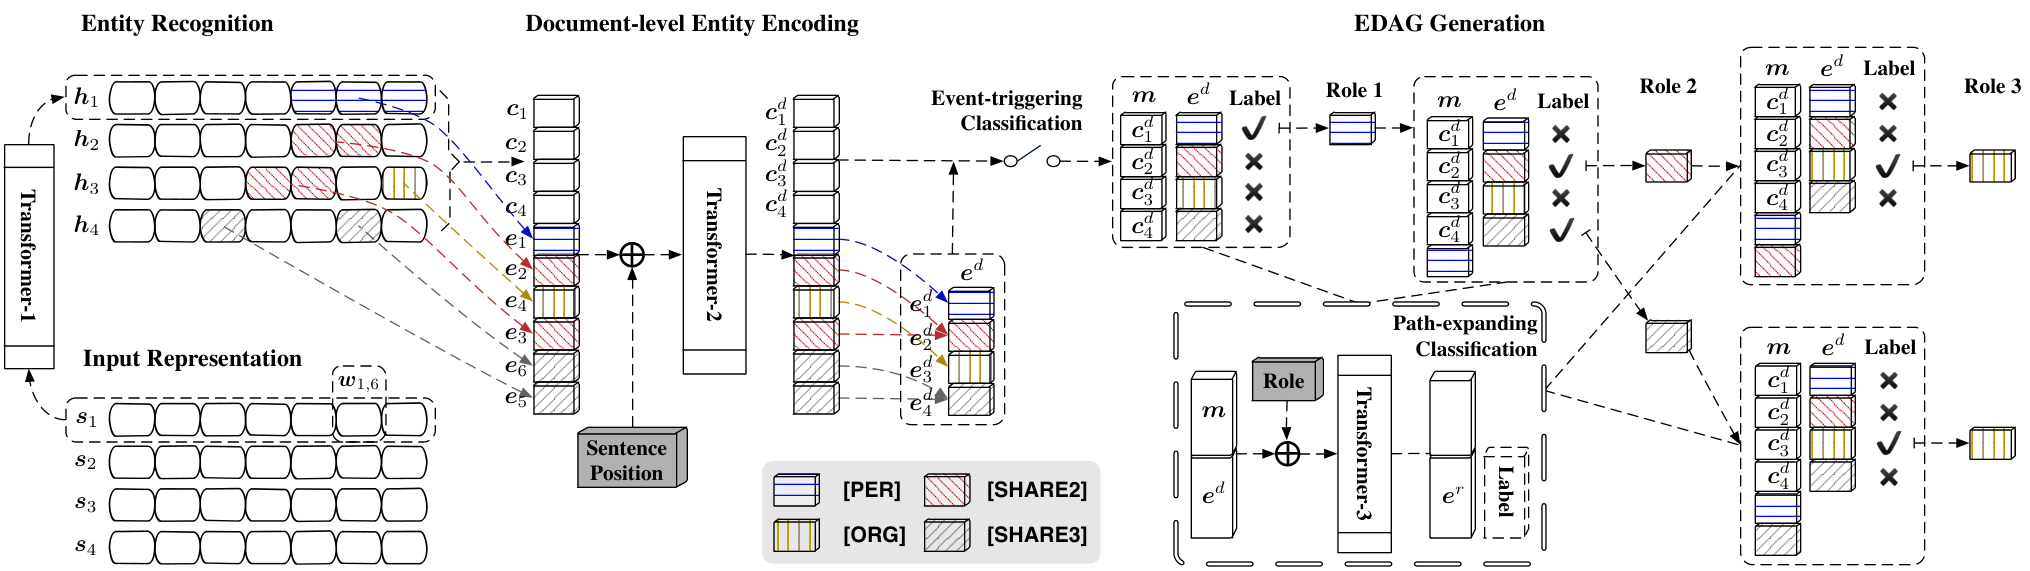
이 연구(1904.07535)의 문제의식은 공시를 읽어 본 사람이라면 바로 와닿습니다. "회사 A가 보유 주식을 담보로 잡았다"는 한 건의 사건 정보가 공시 문서 안에 여러 문장에 흩어져 있습니다 — 회사명은 1단락, 담보 주식 수는 3단락, 상대 금융기관은 5단락에 있을 수 있죠. 심지어 한 문서에 사건이 두 건씩 겹치기도 합니다. 기존 기술은 한 문장 안에서 단어를 찾는 방식이라 이런 문서 수준 과제에서 힘을 못 씁니다.
Doc2EDAG는 문제를 "단어 찾기"에서 "표 채우기"로 바꿉니다. 문장에서 트리거 단어를 찾는 대신, 문서 전체에서 인물·회사·금액 같은 개체들의 역할을 채워 사건 표를 완성하는 것으로 목표를 바꾼 겁니다. 그리고 표를 한 번에 채우지 않고, 사건을 시작한 개체에서부터 정해진 순서대로 그래프를 한 칸씩 확장하며 채웁니다(그래서 EDAG — 개체 기반 유향 비순환 그래프). 이미 지나온 경로를 '기억'해서 중복과 모순을 막습니다.
무엇을 알아냈나
실험은 대규모입니다. 중국 금융 공시 10년치(2008~2018년)에서 총 32,040건의 문서로 데이터셋(ChFinAnn)을 구축했는데, 이는 기존 연구 데이터셋의 약 10배, 범용 표준 데이터셋(ACE 2005)의 약 53배 규모입니다. 사건 유형은 주식동결, 주식재매수, 지분감소, 지분증가, 주식담보 5종이고, 문서의 29%가 사건이 두 건 이상 겹칩니다(자동 라벨링 품질은 수작업 검증에서 정밀도 98.8 / 재현율 89.7).
- 사건 표를 정확히 채웠는가로 매기는 점수(F1)에서 평균 76.3을 기록해, 기존 방법(55.7~60.5)을 크게 앞섰습니다. 사건 유형별로는 주식재매수 87.3, 주식담보 77.3, 지분증가 75.0 등입니다.
- 진짜 차이는 사건이 겹친 문서에서 납니다. 사건이 하나뿐인 문서에서는 82.3이던 점수가, 여러 사건이 겹친 문서에서도 67.3으로 견고한 반면, 비교 방법은 39.4로 무너졌습니다. "이 문서에 사건이 몇 건일까"라는 핵심 난제를 끝까지 해결한 결과입니다.
- 코드와 데이터가 공개되어 재현성 점수 84 — 이 달 AI 연구 중 가장 높습니다.
한계와 조심할 점
중국 공시에 특화된 모델이라 다른 나라 공시(한국어 포함)에는 재학습이 필요합니다(적용성 점수 47). 자동으로 붙인 라벨의 오류(재현율 89.7)가 그대로 남습니다. 그리고 무엇보다, "사건을 잘 정리한다"가 "투자 수익이 난다"를 뜻하지는 않습니다 — 이 논문은 전자만 다룹니다.
가볍게 더 보기
의사결정 구조를 학습하는 다른 연구들입니다. 1904.04912은 모멘텀 전략에서 "추세를 볼 지표"와 "얼마나 살지"를 사람이 정하지 않고 신경망이 한 번에 출력하게 만들며, 샤프 비율을 직접 목표로 학습합니다(Deep Momentum Networks). 1904.08205은 평균 수익이 아니라 CVaR(극단적 손실의 평균) 같은 위험 지표를 직접 최적화하는 알고리즘(StoROO)을 제안하고, 1904.13387은 "짧은 기간만 투자할 거라면 평균이 가장 높은 자산이 최선이 아닐 수 있다"는 위험회피형 탐색 전략을 다룹니다.
이 테마의 공통 인사이트
학습 모델의 출력이 예측값에서 의사결정으로 바뀌고 있습니다. 사건 표를 채우는 것(문서 이해), 포지션 크기를 정하는 것(모멘텀), 위험을 고르는 것(밴딧) — 모두 "맞혀라"가 아니라 "결정하라"는 문제입니다. AI가 실무 리서치에 들어오려면 이 다리가 필요한데, 이 달의 연구들이 그 다리를 놓기 시작했습니다.
이 달 전체를 관통하는 메시지
2019년 4월의 다섯 이야기는 하나의 문장으로 모입니다 — "시장과 모델을 '실험 가능한 것'으로 만들자." 가짜 시장을 지어 큰 주문의 충격을 반복 실험하고(테마 1), 시장이 매긴 가격에 모델을 정밀하게 끼워 맞추며(테마 2), 거칠기·흔들리는 기준·거래비용이라는 현실 조건을 최적화에 되돌려 넣고(테마 3), 그 모든 가격 계산의 옳고 그름을 증명하고(테마 4), 흩어진 문서에서 사건을 표로 정리해(테마 5) — 전부 "실험과 검증이 가능한 금융"을 향한 작업들입니다. 대형 언어 모델(LLM)이 금융에 등장하기 전, 강화학습이 아직 이론 탐색 단계이던 시기의 연구들이지만, 이 달에 공개된 실험대(ABIDES, ChFinAnn 데이터셋, 모델-무관 가격 이론)는 이후의 금융 AI가 "정말 돈을 벌 수 있는가"를 따질 때마다 되돌아오게 됩니다.
더 알아보기
원문 링크와 5차원 평가 점수
이 글에서 다룬 논문들의 원문과, 우리 지식 베이스가 매긴 5차원 점수입니다(신규성 / 적용성 / 엄밀성 / 재현성 / 통찰, 종합점수는 이들의 가중 합).
| 논문 | 티어 | 종합 | 신규성 | 적용성 | 엄밀성 | 재현성 | 통찰 |
|---|---|---|---|---|---|---|---|
| 1904.12066 ABIDES 시장 시뮬레이터 | A | 70.3 | 78 | 62 | 57 | 82 | 73 |
| 1904.04554 슈뢰딩거 브리지 변동성 모형 | A | 69.1 | 75 | 72 | 76 | 35 | 78 |
| 1904.03058 호가창 SPDE 모형 | A | 68.5 | 76 | 66 | 82 | 54 | 77 |
| 1904.01566 베이지안 거래비용 분석 | A | 68.5 | 66 | 82 | 67 | 50 | 76 |
| 1904.07535 Doc2EDAG 공시 사건 추출 | A | 67.8 | 74 | 47 | 76 | 84 | 68 |
| 1904.04912 Deep Momentum Networks | A | 66.5 | 72 | 70 | 68 | 55 | 72 |
| 1904.08205 X-Armed Bandits(CVaR 최적화) | A | 65.3 | 68 | 58 | 82 | 45 | 67 |
| 1904.12442 거친 변동성 포트폴리오 | A | 65.2 | 78 | 59 | 78 | 38 | 68 |
| 1904.12834 금융 제약 내재변동성 신경망 | B | 64.9 | 72 | 67 | 70 | 35 | 72 |
| 1904.11392 강화학습 연속시간 포트폴리오 | B | 64.8 | 70 | 61 | 79 | 43 | 69 |
| 1904.04644 마팅게일 최적수송 쌍대성 | B | 64.7 | 73 | 52 | 86 | 35 | 70 |
| 1904.01745 확률왜곡과 시간일관 투자 | B | 63.6 | 78 | 46 | 78 | 38 | 76 |
| 1904.12260 BNS 모형 VIX 옵션 | B | 60.8 | 60 | 62 | 76 | 38 | 58 |
| 1904.10523 신경망 모형 보정(CaNN) | B | 56.9 | 62 | 68 | 55 | 35 | 58 |
| 1904.04546 최적수송 신경망 알고리즘 | B | 56.7 | 62 | 57 | 63 | 40 | 57 |
| 1904.09379 투자기간 비의존 강건 투자 | B | 56.5 | 68 | 48 | 66 | 35 | 63 |
| 1904.13387 위험회피형 탐색-확정 밴딧 | B | 55.6 | 68 | 58 | 65 | 30 | 72 |
| 1904.08925 거래비용과 체계적 포트폴리오 | B | 55.4 | 48 | 72 | 52 | 32 | 62 |
| 1904.04171 마팅게일 최적수송 안정성 | B | 54.9 | 72 | 43 | 66 | 22 | 68 |
| 1904.08780 다중 사전확률 무차별조건 | B | 53.6 | 65 | 28 | 72 | 35 | 68 |
우리 지식 베이스에서 함께 읽을 논문
- 시장 시뮬레이션 계열: ABIDES-Gym: Gym Environments for Multi-Agent Discrete Event Simulation, Reinforcement Learning in Agent-Based Market Simulation, Can Large Language Models Trade? Testing Financial Theories with LLM Agents
- 변동성 보정·파생상품 계열: Joint calibration to SPX and VIX options with signature-based models, Deep calibration with random grids, Consistent and Efficient Pricing of SPX and VIX Options under Multiscale Models
- 거친 변동성 포트폴리오 계열: Merton's portfolio problem under Volterra Heston model, Return Prediction for Mean-Variance Portfolio Selection
- 강건 가격결정·최적수송 계열: Distributionally Robust Martingale Optimal Transport, Robust pricing and hedging of options on multiple assets and its numerical approximation, A deep learning approach to data-driven model-free pricing
이 글은 2019년 4월 arXiv 백필 코호트(전체 112편, 관련 68편)의 평가 결과를 바탕으로 작성했습니다. 모든 수치는 원문 논문에서 인용했으며, 블로그 성격상 일부 이론적 세부사항은 생략했습니다. 심층 분석은
analysis/reports/backfill/1904.md를 참고하세요.
📚 이 글에서 다룬 논문 (31편)
- AABIDES: Towards High-Fidelity Market Simulation for AI Research
David Byrd, Maria Hybinette, Tucker Hybinette Balch
- AA stochastic partial differential equation model for limit order book dynamics
Rama Cont, Marvin S. Mueller
- ADoc2EDAG: An End-to-End Document-level Framework for Chinese Financial Event Extraction
Shun Zheng, Wei Cao, Wei Xu 외 1명
- AEnhancing Time Series Momentum Strategies Using Deep Neural Networks
Bryan Lim, Stefan Zohren, Stephen Roberts
- AX-Armed Bandits: Optimizing Quantiles, CVaR and Other Risks
Léonard Torossian, Aurélien Garivier, Victor Picheny
- AMean-variance portfolio selection under Volterra Heston model
Bingyan Han, Hoi Ying Wong
- B
- BA neural network-based framework for financial model calibration
Shuaiqiang Liu, Anastasia Borovykh, Lech A. Grzelak 외 1명
- BForward Rank-Dependent Performance Criteria: Time-Consistent Investment Under Probability Distortion
Xue Dong He, Moris S. Strub, Thaleia Zariphopoulou
- BHorizon-unbiased Investment with Ambiguity
Qian Lin, Xianming Sun, Chao Zhou
- BThe impact of proportional transaction costs on systematically generated portfolios
Johannes Ruf, Kangjianan Xie
- BMartingale optimal transport duality
Patrick Cheridito, Matti Kiiski, David J. Prömel 외 1명
- BStability of martingale optimal transport and weak optimal transport
Julio Backhoff-Veraguas, Gudmund Pammer
- BNo-arbitrage with multiple-priors in discrete time
Romain Blanchard, Laurence Carassus
- BRisk-Averse Explore-Then-Commit Algorithms for Finite-Time Bandits
Ali Yekkehkhany, Ebrahim Arian, Mohammad Hajiesmaili 외 1명
- AABIDES-Gym: Gym Environments for Multi-Agent Discrete Event Simulation and Application to Financial Markets
Selim Amrouni, Aymeric Moulin, Jared Vann 외 3명
- BReinforcement Learning in Agent-Based Market Simulation: Unveiling Realistic Stylized Facts and Behavior
Zhiyuan Yao, Zheng Li, Matthew Thomas 외 1명
- AJoint calibration to SPX and VIX options with signature-based models
Christa Cuchiero, Guido Gazzani, Janka Möller 외 1명
- ADeep calibration with random grids
Fabio Baschetti, Giacomo Bormetti, Pietro Rossi
- BConsistent and Efficient Pricing of SPX and VIX Options under Multiscale Stochastic Volatility
Jaegi Jeon, Geonwoo Kim, Jeonggyu Huh
- BMerton's portfolio problem under Volterra Heston model
Bingyan Han, Hoi Ying Wong
- AReturn Prediction for Mean-Variance Portfolio Selection: How Decision-Focused Learning Shapes Forecasting Models
Junhyeong Lee, Haeun Jeon, Hyunglip Bae 외 1명
- ADistributionally Robust Martingale Optimal Transport
Zhengqing Zhou, Jose Blanchet, Peter W. Glynn
- ARobust pricing and hedging of options on multiple assets and its numerics
Stephan Eckstein, Gaoyue Guo, Tongseok Lim 외 1명
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2022-02 월간
2022년 2월 AI 퀀트 리서치 요약 — 포트폴리오, 꼬리 위험, 옵션, 그리고 가상 시장
2022년 2월에 발표된 AI·퀀트 금융 논문들을 일반 독자 눈높이로 풀어쓴 월간 리서치 리뷰. 포트폴리오 최적화, 온라인 학습, 꼬리 위험, 옵션 가격결정, 시장 시뮬레이션 등 다섯 가지 주제를 다룬다.
 📊 2025-12 월간
크립토 백테스트가 거짓말하는 이유, 그리고 2025년 12월 퀀트 연구의 다섯 가지 흐름
2025년 12월 arXiv에 올라온 금융 AI·퀀트 연구 중 주목할 만한 다섯 가지 흐름을 살펴봅니다. 크립토 백테스트의 과대평가 문제부터 팩터 알파의 수명까지, 실전에 가까워지는 퀀트 연구의 최신 동향을 쉽게 풀어 설명합니다.
 📊 2024-12 월간
2024년 12월 AI 퀀트 연구 종합: 포트폴리오의 현실 적응기
2024년 12월 arXiv에 올라온 AI 퀀트 연구를 5가지 테마로 정리합니다. 포트폴리오 최적화의 강건성, 연속시간 강화학습, 금융 정보 신경망, 미시구조의 확산모델, LLM 감성분석까지 — 이론이 현실의 불확실성과 마주한 이야기.