
매달 arXiv에 쏟아지는 금융 AI 논문 중에서 의미 있는 연구를 골라 정리합니다. 이번에는 2019년 5월입니다. 이 달의 논문들을 읽다 보면 하나의 인상이 강하게 남습니다 — "우리가 쓰던 편리한 계산법이, 사실은 무엇을 놓치고 있었을까?" 파생상품 가격을 계산하려면 모델을 하나 골라야 했고, 변동성의 성질을 말하려면 지표를 하나 믿어야 했고, 전략을 백테스트하려면 최고로 나온 숫자를 믿어야 했습니다. 2019년 5월의 연구자들은 그 "믿음"을 하나씩 열어 보고, 그 안에 숨어 있던 오차를 계산 가능한 형태로 꺼내 놓았습니다.
들어가며: 요리책 대신 재료의 성분표
맛있는 음식을 만들려면 요리책이 필요하다고 생각하기 쉽습니다. 그런데 훌륭한 요리사는 요리책보다 재료의 성분표를 먼저 봅니다 — 이 소금은 얼마나 짠지, 이 밀가루는 얼마나 끓는지. 그래야 어떤 요리책을 써도 결과가 흔들리지 않습니다.
2019년 5월 금융 연구의 다섯 갈래 이야기가 딱 이 구조입니다. 주가 그래프라는 "재료"를 통째로 요리책(모델)에 넘기지 않고, 그 재료가 가진 성분(시그니처라는 수학적 사전)을 먼저 뽑아내겠다는 이야기부터, 변동성이라는 재료의 성분표가 지금까지 잘못 읽혀 왔다는 충격적인 보고, 요리 순서(매매 타이밍)가 실패하면 처음부터 다시 해야 한다는 현실적 문제, 그리고 "요리책 100개 중 제일 맛있게 나온 요리책"을 고르는 방식의 함정까지. 흥미롭게도 이 다섯 이야기 모두 "숫자가 틀릴 수 있는 방식과 크기"를 정직하게 계산하는 방법에 관한 것입니다.
테마 1: 가격 곡선을 '사전'으로 펼치다 — 시그니처라는 새 언어
왜 흥미로운가
주가 그래프는 매 순간 위아래로 흔들리는 곡선입니다. 아시안 옵션이나 배리어 옵션 같은 "이상한(exotic)" 파생상품은 이 곡선의 전체 여정에 걸쳐 가격이 결정됩니다 — 평균이 얼마였는지, 중간에 한 번이라도 선을 넘었는지. 문제는 이 곡선의 가격을 계산하려면 지금까지 통째로 '모델'이라는 요리책이 필요했다는 점입니다. 블랙-숄즈 모델을 고르면 그 모델 답게, 헤스톤 모델을 고르면 그 모델 답게 가격이 나옵니다. 모델이 틀리면 가격도 틀립니다.
그런데 곡선을 사전으로 펼치면 어떨까요? 어떤 글이든 몇 천 개의 단어 조합으로 쓸 수 있듯, 어떤 곡선이든 "반복적분"이라는 단어들의 모음으로 쓸 수 있다는 수학이 있습니다. 그 단어 모음을 시그니처(signature) 라고 부릅니다.
대표 논문: 모델 없이 exotic 옵션 가격을 매기는 법
이 연구(1905.00711)는 "시그니처 페이오프"라는 새로운 상품 가족을 제안합니다. 마치 옵션 시장의 '기초 조각' 같은 것인데, 핵심은 어떤 exotic 상품이든 이 조각들의 선형 조합으로 근사할 수 있다는 점입니다(경제학의 애로우-드브류 '원시증권' 아이디어를 경로 전체로 확장한 것).
그러면 가격 결정이 놀랍도록 단순해집니다. 시장에서 여러 파생상품 가격을 관측하고, 거기서 이 곡선 사전의 "기대 시그니처" — 곡선이 평균적으로 어떻게 움직이는가의 요약 — 를 뽑아내면(선형회귀로 충분합니다), 어떤 exotic 상품이든 가격은 단순한 내적으로 계산되고, 헤지도 유한 차원의 최적화 문제로 떨어집니다. 마치 바닐라 옵션 가격에서 내재변동성을 뽑는 것과 비슷하지만, 이게 훨씬 풍부한 정보 — 경로 전체에 대한 위험중립 요약 — 를 담고 있습니다.
무엇을 알아냈나
실험은 아주 영리했습니다. 연구진이 헤스톤 모델로 파생상품 가격 150개(유럽형 옵션·배리어 옵션·분산스왑 각 50개, 만기 1년, 이자율 2%)를 만들어 놓고, 트레이더에게는 모델을 전혀 알려 주지 않았습니다. 트레이더가 가진 것은 오직 가격표뿐 — 실제 시장 상황과 똑같습니다.
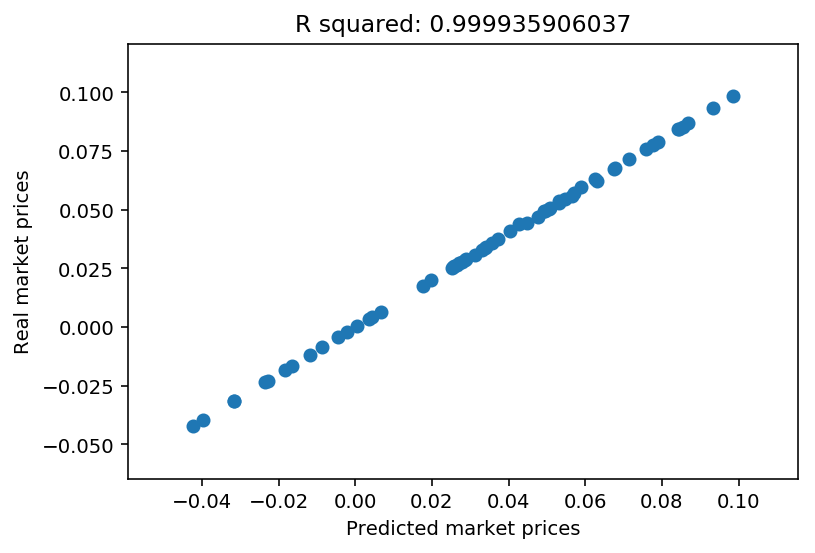
- 가격 75개로 기대 시그니처를 추정하고(사전을 5단어까지), 나머지 75개의 가격을 예측했더니 실제 가격과의 R² = 0.99994 — 거의 완벽하게 맞았습니다.
- 추정된 할인율에서 암묵 단기금리가 약 1.9900%로 나와, 실제 사용한 2%에 근접했습니다(사전만으로 금리까지 회수한 셈).
- 헤지도 가능했습니다. 일별 리밸런싱으로 아시안·배리어·룩백·분산스왑을 헤지했고, 블랙-숄즈 같은 완전시장에서는 이론상 복제 전략과 거의 일치했습니다.
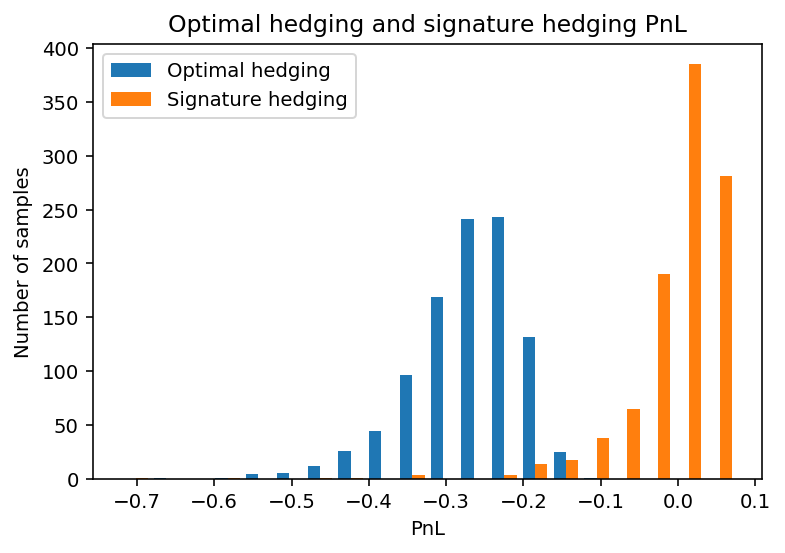
또 하나 실무적인 발견이 있습니다. 거래비용(아주 작은 이차 비용 α = 10⁻⁶)을 넣고 다시 비교해 보니, 이론적 '복제 전략'은 손익이 급격히 무너지는 반면 시그니처 기반 헤지는 훨씬 덜 영향을 받았습니다. 완벽하게 복제하려고 부지런히 사고파는 것이 오히려 비용에 취약했다는 뜻입니다.
가볍게 더 보기
같은 달에 시그니처 아이디어를 다른 문제에 적용한 연구들도 나왔습니다. 1905.00728은 대량 주문을 어떻게 나눠 사고팔지(최적 집행)를, 가격·시장충격 모델을 일일이 가정하지 않고 시그니처만으로 최적화하는 프레임워크를 제시합니다. 1905.01720은 관측 가능한 옵션 가격들만으로 시장의 '기대 시그니처'를 추정해, 시장에 없는 exotic 옵션의 가격을 매기는 수치 방법을 구체화합니다.
이 테마의 공통 인사이트
세 논문이 함께 말하는 것은 "모델을 고르는 대신, 데이터가 가진 구조를 통째로 사전으로 옮기면 문제가 쉬워진다"는 것입니다. 시그니처는 곡선을 유한한 숫자 목록으로 압축하는 '손실 없는 사전'에 가깝고, 덕분에 가격결정·헤지·집행이 모두 선형 최적화라는 잘 풀리는 형태가 됩니다.
테마 2: 변동성은 정말 거칠까 — 지표의 거짓말을 잡아내는 통계
왜 흥미로운가
"변동성은 거칠다"는 이야기를 들어 본 적 있을 것입니다. 주가의 흔들림 크기(변동성) 자체가 또 흔들리는데, 그 흔들림이 아주 나쁘고 울퉁불퉁하다 — 거의 '모래알' 수준이라는 이야기입니다. 2014년 유명한 논문이 주요 지수의 데이터에서 이 '거칠기'를 발견해 파생상품 모델링을 뒤흔들었습니다.
그런데 2019년 5월, 오사카대와 ETH 취리히의 연구진이 조용한 질문을 던졌습니다. "그거, 측정 도구가 만든 착시 아닐까요?"
대표 논문: 거칠기를 재는 자가, 거칠기를 만들어 낸다면?
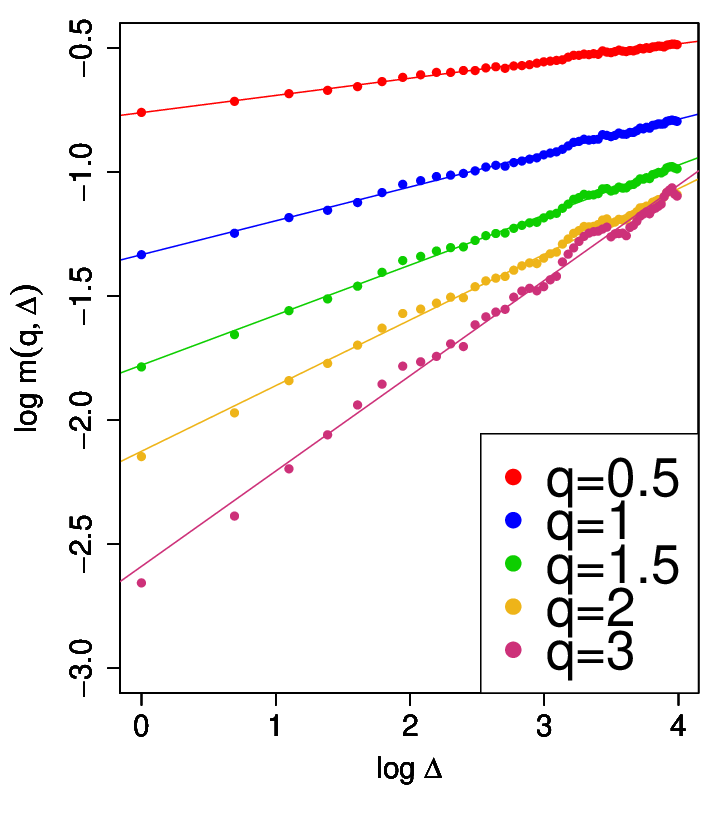
문제는 이렇습니다. 변동성은 직접 보이지 않습니다. 우리는 5분마다 가격을 샘플링해 "실현변동성"이라는 지표로 변동성을 대신 봅니다. 그런데 이 지표에는 추정 오차가 들어 있습니다. 2014년 연구가 쓴 '스케일링 회귀'라는 판별법은 이 오차를 반영하지 않았고, 연구진의 시뮬레이션은 놀라운 사실을 보여 줍니다 — 변동성이 사실은 거칠지 않은데도(심지어 매끈한데도!), 그 회귀 분석은 "거칠다"는 신호를 그대로 만들어 냈습니다. 자를 재는 자가 눈금을 잘못 읽고 있었던 셈입니다.
그래서 연구진은 질문을 바꿉니다. "회귀 계수가 0.1인가"가 아니라 "진짜 Hurst 파라미터(거칠기 지표, 0.5 미만이면 거침)는 얼마인가"를 직접 추정하는 통계 방법(adapted Whittle 추정량)을 새로 만들고, 실현변동성의 오차 분포까지 모형에 넣었습니다(1905.04852).
무엇을 알아냈나
- 시뮬레이션으로 검증해 보니, 실제 거칠기가 0.05 이상이면 5분 실현변동성만으로도 추정이 잘 됩니다(실제 0.3일 때 추정 0.296~0.300). 극단적으로 거친 0.01 구간에서만 약간의 편향이 있지만, "거칠다"라는 결론 자체는 견고합니다.
- 실제 데이터(Oxford-Man 실현변동성 라이브러리, 2008~2017년, 5분 표본)로 주요 지수 5개를 추정한 결과: S&P 500 약 0.043, FTSE 100 약 0.023, 니케이 225 약 0.059, DAX 약 0.036, 러셀 3000 약 0.039. 전부 0.06 미만입니다. 기존 문헌이 말하던 약 0.1보다 더 거칠다는 결론입니다.
- 결정적인 반전: 2014년의 판별법(스케일링 회귀)을 S&P 500에 그대로 적용하면 0.12 정도가 나옵니다. 그런데 진짜 거칠기가 0.03인 가짜 데이터에 같은 회귀를 돌려도 0.12 근처가 나옵니다(1초 표본 0.136, 1분 0.131, 5분 0.122). 그 판별법은 진짜 거칠기를 읽지 못하고 있었습니다. "변동성은 거칠다"는 결론은 옳았지만, 그 증거가 우연히 정확한 증거는 아니었던 것입니다.
가볍게 더 보기
거칠기가 실재한다면 투자자의 행동도 바꿀까요? 1905.05371은 거친 변동성 환경에서의 최적 포트폴리오(Merton 문제)를 풀어, 위험회피 성격(위험에 얼마나 민감한지)에 따라 투자 수요가 달라진다는 결과를 냅니다. 1905.06213은 시장에서 흔히 쓰는 국소-확률 변동성(LSV) 모델 보정의 수학적 근거를 튼튼히 합니다.
이 테마의 공통 인사이트
변동성은 "관측되는 값"이 아니라 "추정되는 잠재 과정"입니다. 성질을 말하려면 측정 오차까지 모형에 넣어야 하고, 넣고 나면 "변동성은 거칠다"는 결론은 오히려 더 강해진다는 것 — 이 달 연구의 멋진 역설입니다.
테마 3: 언제, 어디서 팔 것인가 — 실패하면 다시 시작하는 매매
왜 흥미로운가
주식을 팔기로 마음먹었다면 두 가지를 정해야 합니다. 언제 팔지, 그리고 어디서 팔지. "어디서"의 대표적인 선택지가 다크풀입니다 — 비공개 거래소라서 가격이 조금 더 좋을 수 있지만, 주문이 아예 체결되지 않을 수도 있습니다. 실패하면? 당연히 다시 팔아야죠. 매매 의사결정을 처음부터 다시 시작합니다.
바로 이 "실패하면 처음부터"라는 구조가, 수학적으로는 새 종류의 문제였습니다.
대표 논문: 다시 시작할 수 있는 사람의 최적 전략
전통적인 '최적 정지' 이론(언제 멈추는 게 이득인가)에서 정지 보상은 문제 바깥에 주어져 있습니다. 그런데 다크풀 매매에서는 "멈췄을 때 받는 값"이 내가 다시 시작했을 때 얻을 가치에 의존합니다. 문제의 답이 문제의 조건 안으로 들어오는, 재귀적 구조입니다.
이 연구(1905.02650)는 이 재귀적 문제를 '고정점 문제'로 정식화해 해가 존재하고 유일함을 증명했고, 다크풀 매도 예제에서 해의 모양을 완전히 그려냈습니다. 핵심 결과는 놀라울 정도로 깔끔합니다:
- 트레이더의 판단 기준은 주가의 절대 크기가 아니라 "스프레드 ÷ 주가"라는 비율 하나입니다.
- 이 비율이 충분히 낮으면(좋은 가격 차이가 없으면) 그냥 일반 거래소에서 팔고, 충분히 높으면 체결 실패 위험을 감수하고 다크풀을 시도하며, 중간 애매한 구간에서는 잠시 기다립니다.
- 기다리는 구간은 두 영역을 가르는 '쐐기' 모양이 됩니다.
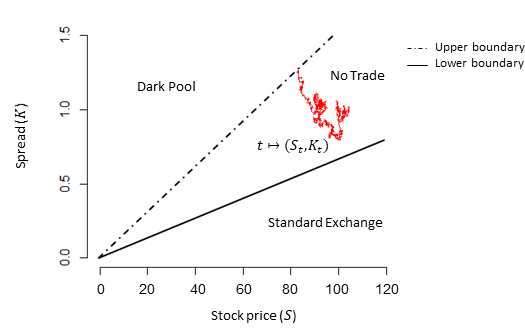
흥미로운 비교 결과도 있습니다. "실패하면 다시 시도할 수 있는" 트레이더와 "한 번만 시도할 수 있는" 트레이더를 비교하면, 재시도가 가능한 트레이더가 다크풀 매도를 더 일찍·더 자주 선택하고, 일반 거래소 매도는 더 오래 미룹니다. 다시 기회가 있다는 사실 자체가 위험 감수를 키우는 것입니다. 이런 구조적 통찰을 이 문제 클래스에서 처음으로 증명했다는 점이 이 논문의 이론적 기여입니다.
가볍게 더 보기
거래비용이 가격 자체를 어떻게 바꾸는지에 대한 이론 연구들도 이 달에 모였습니다. 1905.05027은 거래비용이 있으면 자산 수익률이 평균회귀하는 구조가 생긴다는 균형 결과를 유도하고, 1905.04821은 여러 종목을 동시에 매매할 때의 최적 전략을 "평균장" 근사로 풀어, 포트폴리오 위험이 클수록 매매를 더 참아야 한다는 경계를 계산합니다. 1905.04569은 자주 혼동되는 개념을 정리합니다 — 큰 주문이 가격을 밀어내는 '시장충격'은 가격의 자연스러운 '변동성'과 다르며, 둘을 섞어 계산하면 체결 비용을 제대로 못 맞춘다는 것입니다.
이 테마의 공통 인사이트
매매의 '순간'은 최적화 문제 하나로 뭉뚱그릴 수 없습니다. 언제(정지 문제), 어디서(장소 선택), 얼마큼(비용과 충격) 가 서로 얽혀 있고, "실패 후 재시도" 같은 현실적 구조를 넣기만 해도 최적 전략의 모양이 달라집니다.
테마 4: 백테스트를 의심하는 기술 — "제일 잘 나온 것"의 함정
왜 흥미로운가
전략을 개발할 때 우리는 늘 '선택'합니다. 지연(래그)을 며칠로 둘지, 어떤 지표를 쓸지 — 후보를 여러 개 시험해 보고 제일 성과가 좋았던 것을 고릅니다. 이건 자연스러운 일입니다. 하지만 옷 가게에서 사이즈 18벌을 다 입어 보고 제일 예뻐 보였던 옷을 "내 체형에 제일 잘 맞는 옷"이라고 믿는 것과 같은 오류가 숨어 있습니다. 제일 예뻤던 옷은, 내 체형 때문이 아니라 그 옷이 원래 예뻤기 때문일 수도 있습니다. 백테스트에서 "최고 샤프"는 실력일 수도, 순전히 '여러 번 시험한 보너스'일 수도 있습니다.
대표 논문: 파라미터를 골랐다면, 샤프비도 깎아라
이 연구(1905.05023)는 통계학의 오래된 지혜 — 모델을 고르는 데 쓴 자유도만큼 성과를 깎아라 — 를 트레이딩 백테스트에 이식합니다. 파라미터(여기선 며칠짜리 래그) 후보를 시험한 횟수와 사용한 데이터 양에 비례해 샤프비를 낮춰 주는 '공분산 페널티' 보정을 붙이는 방법입니다.
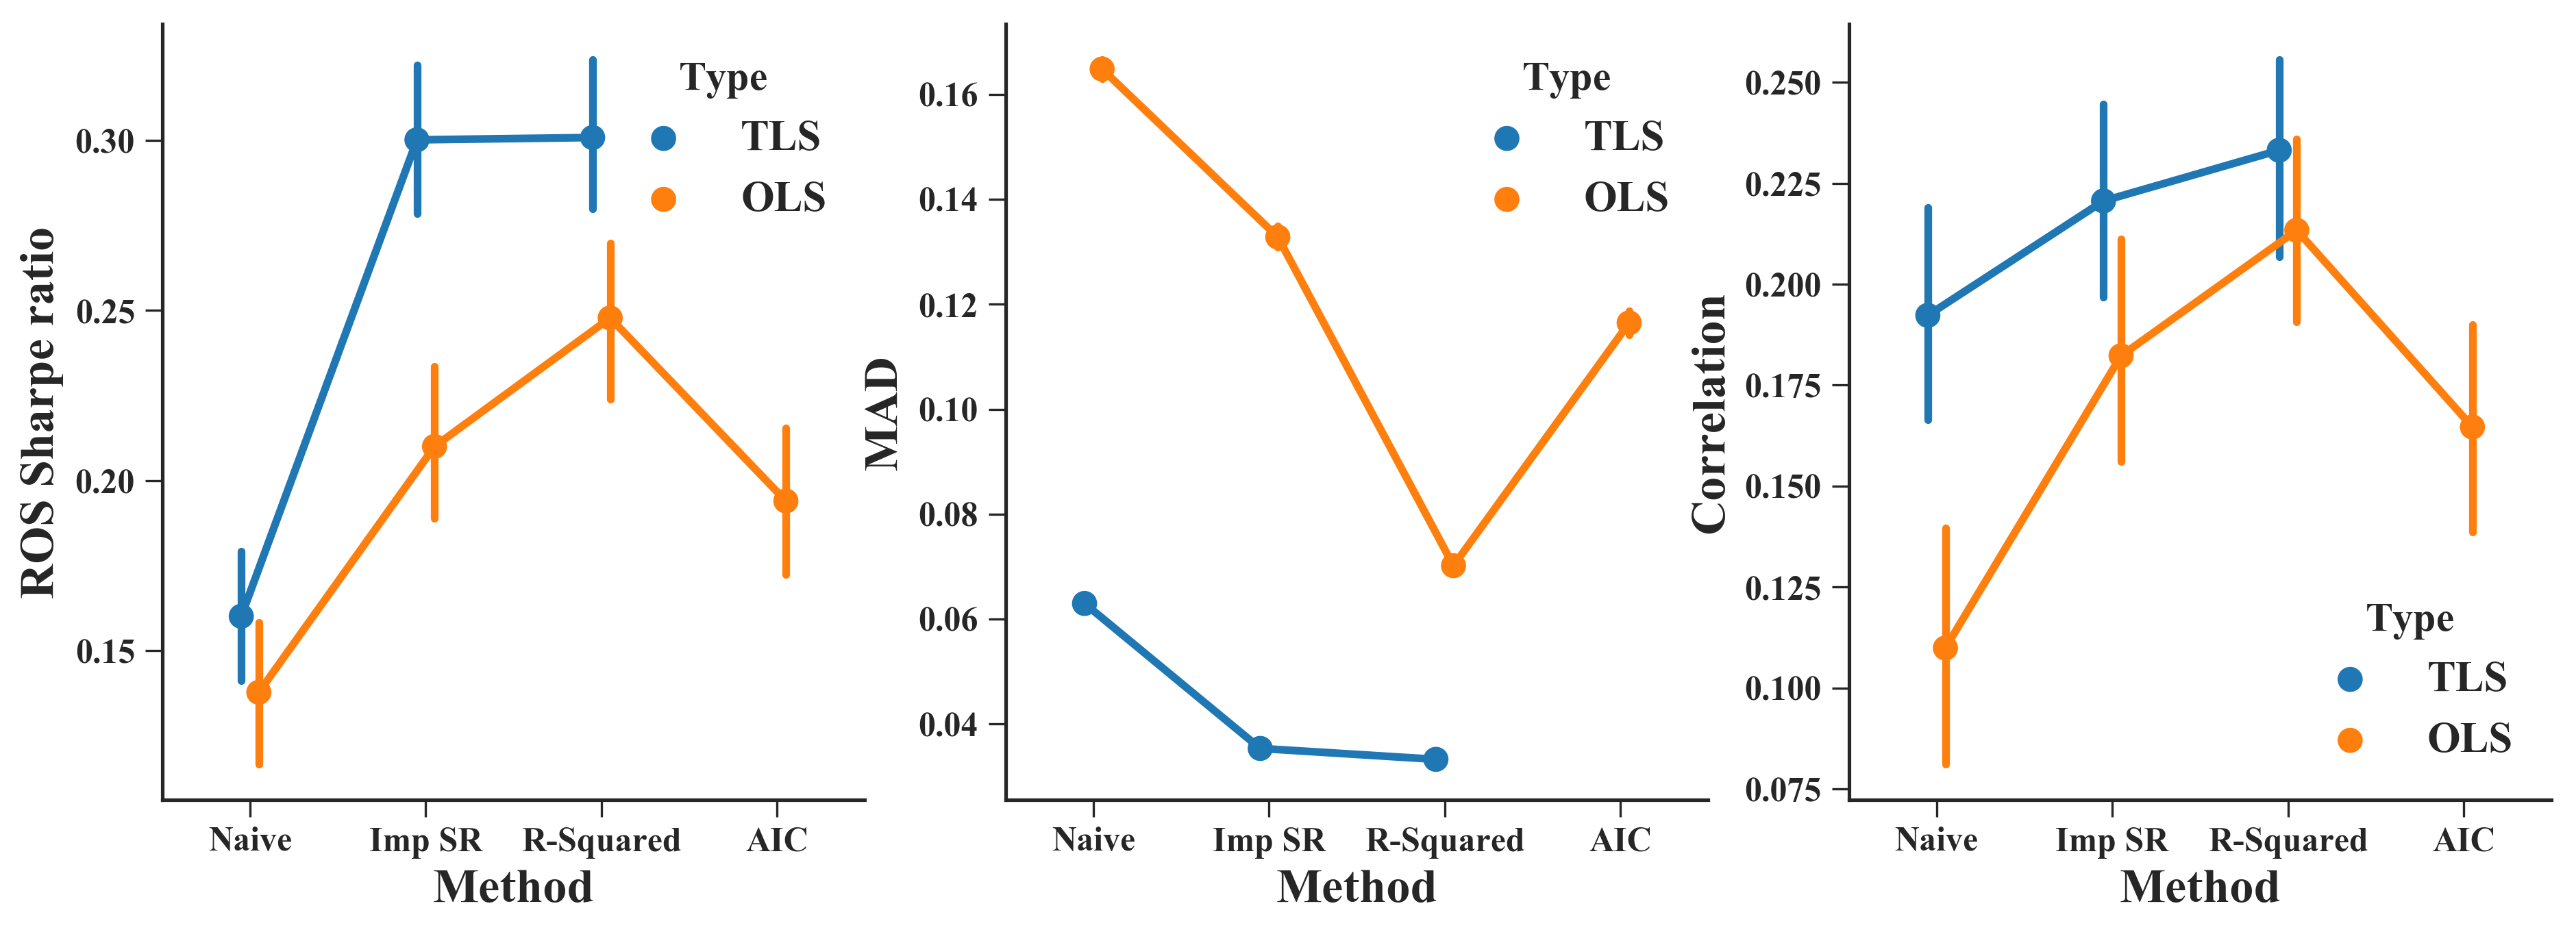
실증 규모가 상당합니다. Bloomberg 자산 1,361개(개별 주식 1,289개와 글로벌 주가지수·스왑·금리·통화 지수), 자산별 변동성을 10%로 맞춘 뒤, 학습 1,008일에 검증 21일을 굴려 나가는 방식으로 18개 래그 후보(3~126일)를 비교했습니다. 네 가지 선택 규칙의 대결입니다 — 순진하게 최고 샤프 선택, AIC(통계학의 고전적 기준), 그리고 제안하는 두 공분산 페널티 방식.
- 공분산 페널티를 쓴 선택은 순진한 선택보다 실현 샤프비가 무조건 평균 80~100% 높았고, 제안한 두 방식은 AIC보다 20~30% 더 좋았습니다.
- 1,361개 자산에 대한 통계 검정(Bonferroni 보정)에서 거의 모든 비교가 유의했습니다. 예를 들어 R² 보정 + 총최소제곱(TLS) 조합은 순진한 선택보다 실현 샤프가 평균 0.162 높았습니다(t = 17.97).
- 재미있는 발견: TLS(측정 오차까지 고려한 회귀)가 OLS보다 잘 나온 이유 중 하나는, 보정이 더 강해 더 단순한 설정(짧은 래그)을 더 자주 선택했기 때문입니다. 복잡한 모델을 고르지 않도록 '제약'이 된 셈입니다.
가볍게 더 보기
1905.07886은 "예측값 하나" 대신 예측 구간을 주는 방법(conformal prediction)을 전력 시장 가격에 적용해, 분포 가정 없이도 신뢰 구간을 만들 수 있음을 보였습니다(재현성 점수 72로 이 달 실증 연구 중 공개 수준이 높은 편). 1905.05237은 미국 주식 50년치 데이터로 수익률과 최대낙폭을 예측하는 여러 기계학습 모델을 비교하며, ESG 정보가 실제로 얼마나 추가되는지 냉정하게 검증합니다.
이 테마의 공통 인사이트
성과의 점추정은 늘 낙관적입니다. "선택한 개수와 사용한 데이터에 따라 숫자를 깎고, 예측은 구간으로 말하라" — 이 달의 실용적 교훈입니다.
테마 5: 함께 움직이는 두 주식, 정말인가 — 고빈도 데이터의 함정
왜 흥미로운가
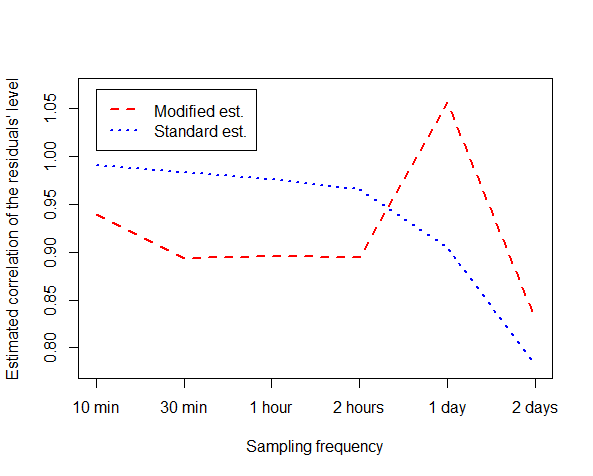
페어 트레이딩의 출발점은 "이 두 주식은 함께 움직인다"는 믿음입니다. 그런데 그 믿음이 통계적으로 '증명'된 것일까요? 표준 검증 도구(공적분 검정)는 1980년대에 만들어졌고, 일주일에 한 번씩 관측하는 데이터를 전제로 설계됐습니다. 10분마다 찍는 데이터를 넣으면 어떻게 될까요?
대표 논문: 표준 검정이 두 번 모두 틀리는 두 가지 방식
이 연구(1905.07081)는 고빈도 데이터의 특성 — 가격의 갑작스러운 점프, 시간에 따라 변하는 변동성 — 이 표준 검정을 어떻게 망가뜨리는지 정면으로 다룹니다. 연구진은 점프와 시간가변 변동성을 견디는 수정 Dickey-Fuller 검정을 새로 만들고, 이론적 근거(일관성, 중심극한정리)까지 증명했습니다. 편리하게도 "관계가 없다"는 귀무가설 아래에서는 기존 검정과 같은 임계값을 그대로 쓸 수 있습니다.
실증에서 두 개의 주식 쌍이 보여 준 장면이 압권입니다 (S&P 500 종목, 20122013년, 10분2일 표본):
- ACE–ALXN 쌍: 최고빈도 표본(19,656개 관측)에서 수정 검정만 "함께 움직인다(공적분)"를 기각해 내는데, 표준 검정 4종은 전부 놓칩니다. 가격 점프가 검정력을 갉아먹은 경우입니다.
- CMS–ES 쌍: 정반대입니다. 수정 검정은 "관계 없다"고 하는데 표준 검정 4종은 전부 "관계 있다"고 기각합니다. 시간에 따라 변하는 변동성이 만든 거짓 긍정입니다.
같은 데이터, 같은 질문에서 표준 검정은 한 번은 관계를 놓치고 한 번은 없는 관계를 만들어 냅니다.
가볍게 더 보기
"데이터에서 구조를 뽑는 일"은 공적분만의 문제가 아닙니다. 1905.00545는 암호화폐 예측 모델의 요인 수를 몇 개로 할지를 랜덤행렬 검정으로 데이터에 묻는 방법을 제안합니다(감으로 정하지 말라는 주문). 1905.13276은 자산 수는 많은데 데이터가 적을 때의 공분산 추정을 시간적 상관 구조로 개선합니다.
이 테마의 공통 인사이트
"구조가 있다"고 말하려면, 데이터가 만드는 잡음(점프, 시간가변성, 높은 차원)을 먼저 반영한 도구를 써야 합니다. 표준 검정의 결론이 표본 간격에 따라 흔들린다면, 그것은 결론이 아니라 경고입니다.
이 달 전체를 관통하는 메시지
2019년 5월의 다섯 이야기는 하나의 문장으로 모입니다 — "편리한 근사가 무엇을 숨기는지 계산하자." 모델을 세우지 않고 곡선의 사전으로 가격을 매기고(테마 1), 측정 오차까지 넣고 나니 변동성은 더 거칠어졌으며(테마 2), 실패 후 재시도라는 현실을 넣자 매매 전략의 지도가 달라졌고(테마 3), 여러 번 시험한 값을 깎으니 전략 성과가 정직해졌으며(테마 4), 표준 검정의 흔들림을 보니 "함께 움직인다"는 믿음이 조심스러워졌습니다(테마 5). 인공지능이 이 모든 것 위에 올라타기 전, 확률론과 최적화로 "정직한 숫자"를 만들던 시기의 연구들입니다. 그리고 이 기준선은 7년 후 "AI 트레이더가 정말 돈을 벌 수 있는가"를 따질 때마다 되돌아오게 됩니다.
더 알아보기
원문 링크와 5차원 평가 점수
이 글에서 다룬 논문들의 원문과, 우리 지식 베이스가 매긴 5차원 점수입니다(신규성 / 적용성 / 엄밀성 / 재현성 / 통찰, 종합점수는 이들의 가중 합).
| 논문 | 티어 | 종합 | 신규성 | 적용성 | 엄밀성 | 재현성 | 통찰 |
|---|---|---|---|---|---|---|---|
| 1905.00711 시그니처 비모수 가격결정 | A | 72.5 | 77 | 70 | 82 | 48 | 79 |
| 1905.07081 고빈도 공적분 검정 | A | 67.8 | 72 | 65 | 84 | 38 | 70 |
| 1905.04852 변동성은 정말 거칠까 | A | 67.8 | 74 | 57 | 82 | 44 | 77 |
| 1905.02650 재귀적 최적정지와 다크풀 | A | 65.1 | 76 | 53 | 87 | 38 | 65 |
| 1905.06213 마르코프 사영 역구성 | B | 64.9 | 68 | 52 | 88 | 38 | 70 |
| 1905.00728 시그니처 최적집행 | B | 64.2 | 73 | 70 | 73 | 43 | 70 |
| 1905.05027 거래비용과 자산 가격 | B | 64.2 | 73 | 49 | 82 | 43 | 70 |
| 1905.04821 선형 비용 다자산 매매 | B | 63.6 | 73 | 72 | 67 | 42 | 70 |
| 1905.01720 시그니처 모델-free 가격추정 | B | 62.5 | 74 | 57 | 67 | 43 | 70 |
| 1905.07886 컨포멀 예측구간과 전력시장 | B | 62.5 | 58 | 53 | 70 | 72 | 61 |
| 1905.05371 Volterra Heston 포트폴리오 | B | 62.0 | 68 | 58 | 76 | 38 | 63 |
| 1905.05237 지속가능 투자와 수익·낙폭 | B | 59.9 | 58 | 65 | 68 | 38 | 61 |
| 1905.05023 공분산 페널티와 백테스트 과적합 | B | 57.6 | 63 | 65 | 56 | 42 | 65 |
| 1905.13276 시간적 공분산 추정 | B | 57.5 | 72 | 64 | 53 | 30 | 65 |
| 1905.00545 랜덤행렬 검정과 요인 수 | B | 56.9 | 65 | 64 | 58 | 35 | 57 |
| 1905.04569 시장충격은 변동성이 아니다 | B | 56.5 | 70 | 62 | 55 | 30 | 78 |
우리 지식 베이스에서 함께 읽을 논문
- 시그니처·헤지 계열: Hedging with memory: shallow and deep learning with signatures, Pricing American options under rough volatility using deep-signatures and signature-kernels
- 거친 변동성 계열: Weak error rates for option pricing under linear rough volatility, Statistical inference for rough volatility: Central limit theorems
- 전략 검증·성과 감쇠 계열: Why and how systematic strategies decay, When is cross impact relevant?
- 고빈도 계량 계열: When Frictions are Fractional: Rough Noise in High-Frequency Data
- 공분산 추정 계열: Ledoit-Wolf linear shrinkage with unknown mean
이 글은 2019년 5월 arXiv 백필 코호트(전체 153편, 관련 63편)의 평가 결과를 바탕으로 작성했습니다. 모든 수치는 원문 논문에서 인용했으며, 블로그 성격상 일부 이론적 세부사항은 생략했습니다. 심층 분석은
analysis/reports/backfill/1905.md를 참고하세요.
📚 이 글에서 다룬 논문 (24편)
- ANonparametric pricing and hedging of exotic derivatives
Terry Lyons, Sina Nejad, Imanol Perez Arribas
- A
- AIs Volatility Rough ?
Masaaki Fukasawa, Tetsuya Takabatake, Rebecca Westphal
- AA class of recursive optimal stopping problems with applications to stock trading
Katia Colaneri, Tiziano De Angelis
- BOptimal execution with rough path signatures
Jasdeep Kalsi, Terry Lyons, Imanol Perez Arribas
- BNumerical method for model-free pricing of exotic derivatives using rough path signatures
Terry Lyons, Sina Nejad, Imanol Perez Arribas
- BMerton's portfolio problem under Volterra Heston model
Bingyan Han, Hoi Ying Wong
- BInverting the Markovian projection, with an application to local stochastic volatility models
Daniel Lacker, Mykhaylo Shkolnikov, Jiacheng Zhang
- BAsset Pricing with General Transaction Costs: Theory and Numerics
Lukas Gonon, Johannes Muhle-Karbe, Xiaofei Shi
- BOptimal multi-asset trading with linear costs: a mean-field approach
Matt Emschwiller, Benjamin Petit, Jean-Philippe Bouchaud
- BImpact is not just volatility
Frédéric Bucci, Iacopo Mastromatteo, Michael Benzaquen 외 1명
- BSustainable Investing and the Cross-Section of Returns and Maximum Drawdown
Lisa R. Goldberg, Saad Mouti
- BDetermining the number of factors in a forecast model by a random matrix test: cryptocurrencies
Andrés García Medina, Graciela González-Farías
- BEfficient Covariance Estimation from Temporal Data
Hrayr Harutyunyan, Daniel Moyer, Hrant Khachatrian 외 2명
- AHedging with memory: shallow and deep learning with signatures
Eduardo Abi Jaber, Louis-Amand Gérard
- APricing American options under rough volatility using deep-signatures and signature-kernels
Christian Bayer, Luca Pelizzari, Jia-Jie Zhu
- AWeak error rates for option pricing under linear rough volatility
Christian Bayer, Eric Joseph Hall, Raúl Tempone
- AStatistical inference for rough volatility: Central limit theorems
Carsten Chong, Marc Hoffmann, Yanghui Liu 외 2명
- AWhy and how systematic strategies decay
Antoine Falck, Adam Rej, David Thesmar
- AWhen is cross impact relevant?
Victor Le Coz, Iacopo Mastromatteo, Damien Challet 외 1명
- AWhen Frictions are Fractional: Rough Noise in High-Frequency Data
Carsten H. Chong, Thomas Delerue, Guoying Li
- BLedoit-Wolf linear shrinkage with unknown mean
Benoit Oriol, Alexandre Miot
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2024-07 월간A
2024년 7월 금융 AI 논문 리뷰: M6 우승 전략, 거친 변동성, 연준의 속마음
2024년 7월 arXiv 금융 논문 309편을 분석했습니다. M6 대회 우승의 하이퍼네트워크 포트폴리오, 거친 변동성 검정, 약한 팩터 이론, GPT-4가 읽는 연준 회의록의 이견, 지정가 체결의 음의 드리프트까지 5가지 테마로 정리합니다.
 📊 2019-07 월간A
옵션 가격결정과 거친 변동성, 그리고 Quant GANs: 2019년 7월 금융 AI 논문
2019년 7월 arXiv 금융 AI 연구를 5개 테마로 정리했습니다. 모델 없이 옵션 가격 상한을 구하는 수학, 미시구조에서 태어나는 거친 변동성, 금융 시계열을 생성하는 Quant GANs, 로보 투자의 진짜 수혜자, 강화학습 자산배분 — 생성형 AI 이전의 기초 공사 현장을 다룹니다.
 📊 2019-03 월간A
2019년 3월 금융 AI 연구: 거친 변동성에서 감정 네트워크까지
2019년 3월 arXiv에 올라온 금융 AI 논문 56편을 5개 테마로 정리했습니다. 거친 변동성 옵션 가격의 근사 수학, 신경망 조건부 밀도 추정 벤치마크, 공분산 앙상블 리스크 모형, 시장조성 백테스트의 함정, 1,944개 암호화폐의 감정 네트워크까지 — 예측이 아니라 분포와 근사가 중심이던 시대의 연구입니다.