
매달 arXiv에 쏟아지는 금융 AI 논문 중에서 의미 있는 연구를 골라 정리합니다. 이번에는 2019년 6월입니다. 이 달의 논문들을 읽다 보면 하나의 질문이 계속 튀어나옵니다 — "내가 지금 보고 있는 이 숫자, 진짜일까?" 전략을 여러 개 시험해 놓고 제일 잘 나온 것을 고르면 그 성과는 실제보다 부풀려져 있고, 주식들의 움직임을 담은 공분산 표는 표본이 조금만 늘어나도 엉망이 되고, 옵션 시세를 그대로 그리면 말이 안 되는 구간이 생깁니다. 2019년 6월의 연구자들은 그 "엉망인 숫자"를 정직하게 고치는 방법을 다섯 갈래로 내놓았습니다.
들어가며: 요리 콘테스트의 함정
백 종류의 전략을 백테스트해 보고, 수익률이 제일 높았던 전략을 실전에 쓴다고 상상해 보세요. 공정해 보이죠? 그런데 잠깐만요. 100개의 주사위를 한 번씩 굴려서 가장 큰 눈이 나온 주사위를 "운이 좋은 주사위"라고 부르면 어떨까요? 그 주사위의 다음 던지기는 평균과 다를 리 없습니다. 전략 백테스트도 같은 구조입니다. 100개를 시험하면, 실력이 없어도 "제일 잘 나온" 하나는 반드시 존재합니다.
이번 달 첫 번째 논문은 이 함정을 정확히 계량하는 방법을 다룹니다. 그리고 나머지 논문들도 각자의 영역에서 같은 정신을 공유합니다. 주식들이 함께 움직이는 방식(공분산)을 추정할 때도, 옵션 가격표(변동성 표면)를 매끈하게 만들 때도, 시장에서 누가 안정성을 만드는지 평가할 때도, 인공지능 전략을 실전에 넣기 전에 검증할 때도 — "숫자가 틀릴 수 있는 방향과 크기"를 함께 계산하는 것이 이 달 연구의 공통 주제입니다.
테마 1: "제일 잘 나온 전략"을 고르면 생기는 일
왜 흥미로운가
투자 전략을 개발할 때 우리는 거의 항상 "선택"을 합니다. 여러 지표 중에서 제일 예측력이 높았던 지표, 여러 전략 중에서 샤프비(수익률을 변동성으로 나눈 '위험 대비 수익' 지표)가 제일 높았던 전략. 문제는, 이 선택이 이미 데이터를 본 뒤에 일어난다는 점입니다. 시험을 100번 보고 제일 높은 점수만 골라서 "이 학생의 실력은 이 정도"라고 말하면 안 되는 것과 같습니다.
대표 논문: 최고 샤프비에도 "선택을 반영한" 신뢰구간이 필요하다
이 연구는 아주 단순한 질문에서 출발합니다. 전략 5개를 시험해서 샤프비가 제일 높게 나온 전략 하나를 골랐다면, 그 전략의 진짜 실력(신호-노이즈 비)은 어느 정도일까?
무엇을 알아냈나
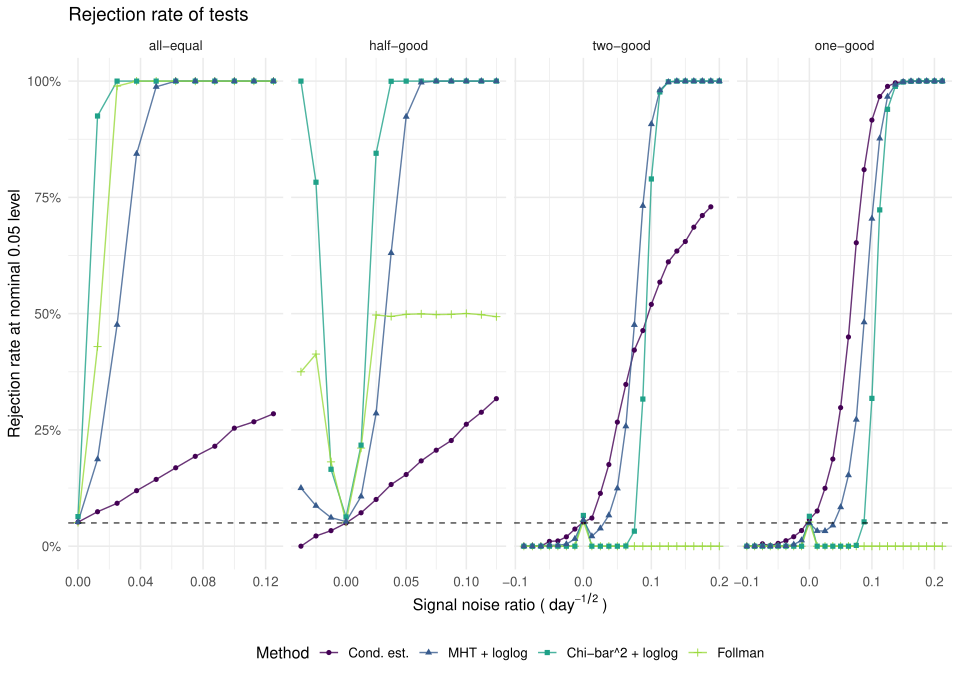
연구진은 "이 전략이 최고였다는 사실 자체"를 확률 계산에 끌어들입니다. 쉽게 말하면, "다른 전략들보다 운이 좋았을 가능성"을 감안해서 신뢰구간을 다시 짜는 것이죠. 이렇게 계산한 구간을 실제 데이터에 적용해 봤는데, 결과가 인상적입니다.
미국 5개 산업 포트폴리오의 월간 수익률(1927년 1월~2018년 12월, 총 1,104개월)에서 샤프비가 제일 높은 산업은 헬스케어였습니다. 월 단위 샤프비 약 0.193(연 단위로 환산하면 약 0.667)이고, 소비재 0.187, 제조업 0.172, 기술주 0.170, 기타 0.140이 뒤를 이었습니다.
그런데 헬스케어의 "진짜 실력" 하한을 계산하는 방식에 따라 답이 이렇게 달라집니다.
- 선택을 아예 무시한 계산: 실력은 최소 0.143 이상
- 선택 편향을 감안한 여러 보정: 0.122 ~ 0.141 사이
- 이 논문의 선택적 추론: 실력은 최소 0.073 이상
같은 데이터, 같은 전략인데 "진짜 실력의 최소치"가 두 배 가까이 벌어집니다. 0.143을 믿고 자신 있게 투자했다면, 실제로는 0.073 수준이었을 수 있다는 뜻입니다. 10만 회 모의 실험에서 이 방법은 틀린 경보를 울리는 비율(거짓 양성)이 약속한 수준에 정확히 들어맞았고, 수익률 분포가 뾰족해지는(첨첨도가 큰) 상황에서도 흔들리지 않았습니다.
한계와 주의점
후보 전략들의 실력이 거의 비슷하면 이 검정의 민감도(검정력)는 낮아집니다. "확실히 낫다"를 증명하기 위한 도구이지, "약간 낫다"를 잡아내는 도구는 아니라는 뜻입니다. 그리고 "최고를 고른다"라는 특정 선택 상황에 맞춰져 있어, 다른 방식으로 전략을 고르면 계산을 다시 해야 합니다.
이 테마의 공통 인사이트
고르는 순간, 숫자는 부풀려진다. 선택 편향 보정(전략), 부도모형 전체의 리스크 범위를 계산하는 연구(신용 리스크), 그리고 "불확실한 분포를 어느 정도 감안하는지"를 확률로 번역하는 연구(분포강건 최적화)까지 — 이 달의 통계·리스크 논문들은 "점 하나의 추정치" 대신 "틀릴 수 있는 범위"를 내놓으라고 말합니다.
테마 2: 포트폴리오의 성패는 종목이 아니라 공분산에서 갈린다
왜 흥미로운가
"달걀을 한 바구니에 담지 마라"는 분산 투자의 원칙은 모두가 압니다. 그런데 실제로 포트폴리오를 짜려면 자산들이 서로 어떻게 함께 움직이는지를 담은 표, 즉 공분산 행렬이 필요합니다. 문제는 이 표가 매우 잘 망가진다는 점입니다. 종목이 200개면 알아야 할 숫자가 수만 개인데, 관측 데이터는 훨씬 적습니다.
대표 논문: 약한 요인까지 잡아내는 스마트한 공분산 추정
무엇이 문제였나
주가 움직임에는 공통 원인(요인)이 있습니다. 금리, 경기, 유가 같은 것이죠. 요인 모형은 이 원인들을 뽑아내면 공분산을 훨씬 안정적으로 추정할 수 있다는 아이디어인데, 전통적인 방법은 "이 요인이 모든 주식에 강하게 작용한다"고 가정합니다. 하지만 현실의 요인은 종종 일부 주식에만 작용하는 '약한 요인'입니다.
무엇을 알아냈나
이 연구는 요인의 영향력을 스스로 골라내는(불필요한 것은 0으로 지우는) 희소 요인 모형을 제안합니다. 마치 장보기 목록에서 진짜 필요한 것만 남기는 것과 같습니다. 그 결과가 인상적인 숫자로 나왔습니다.
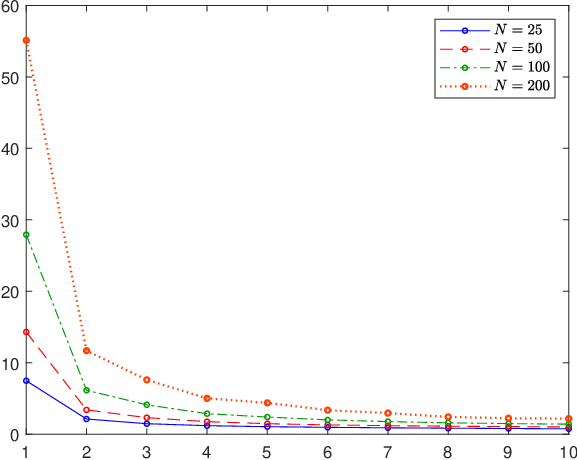
S&P 500 구성 종목 205개의 월간 수익률(1980년 1월~2016년 12월)로, 매달 "변동성이 가장 작은 포트폴리오"를 짜서 실제 성과를 확인했습니다. 종목 수를 30, 50, 100, 200개로 늘려가며 100번 반복 실험한 결과:
- 위험(표준편차, 연율): 종목 200개에서 이 방법은 0.1410으로, 똑같이 나눠 담는 바벨 전략(0.1505)보다 낮았습니다. 흔한 '표본 공분산' 계산법은 종목이 100개, 200개일 때 아예 성과를 내지 못했습니다(계산이 무너짐).
- 위험 대비 수익(샤프비): 종목 200개에서 0.7600으로, 바벨 전략 0.6596을 앞섰습니다.
흥미로운 점은 종목이 많을수록 이 방법의 성과가 오히려 좋아졌다는 것입니다. 보통은 종목이 많아질수록 추정 오류가 쌓여 나빠지는데, '약한 요인'까지 잡아내니 데이터가 늘어나는 것이 득이 된 겁니다.
한계와 주의점
코드가 공개되지 않아(재현성 점수 48) 직접 구현해야 하고, 미국 대형주의 월간 데이터로만 검증했습니다. 거래비용을 빼고 계산한 성과이므로 실전 개선 폭은 별도 확인이 필요합니다.
이 테마의 공통 인사이트
이 달 포트폴리오 연구의 화두는 "어떤 종목을 고르나"가 아니라 "추정 오류를 어떻게 줄이나"입니다. 약한 요인을 허용하는 공분산 추정, 수익률 분포의 뾰족한 꼬리를 반영한 '다양성' 측정, 공분산 역행렬에 의존하지 않는 배분 방법까지 — 모두 "표가 틀릴 것을 전제로" 포트폴리오를 튼튼하게 만드는 작업입니다.
테마 3: 옵션 가격표를 매끈하게 다듬는 두 가지 기술
왜 흥미로운가
옵션 시장에는 만기(언제)와 행사가(얼마에)에 따라 수천 개의 가격이 매일 달라집니다. 이 가격들을 한 장의 지형도로 펼친 것이 내재변동성 표면인데, 시세에는 잡음이 섞여 있고 구간에 따라 데이터가 빈 곳도 많습니다. 이대로 그리면 "어느 조합을 사면 공짜로 돈을 벌 수 있는"(무차익거래) 말도 안 되는 지형도가 나옵니다.
대표 논문: 기존 모델에 신경망 보정을 얹어 무차익 표면 만들기
무엇이 문제였나
은행과 펀드가 쓰는 전통적 옵션 모델은 무차익을 잘 지키지만 시세를 정확히 재현하지 못하고, 신경망은 시세를 잘 재현하지만 무차익을 보장하지 못합니다. 둘 중 하나만 골라야 하는 걸까요?
무엇을 알아냈나
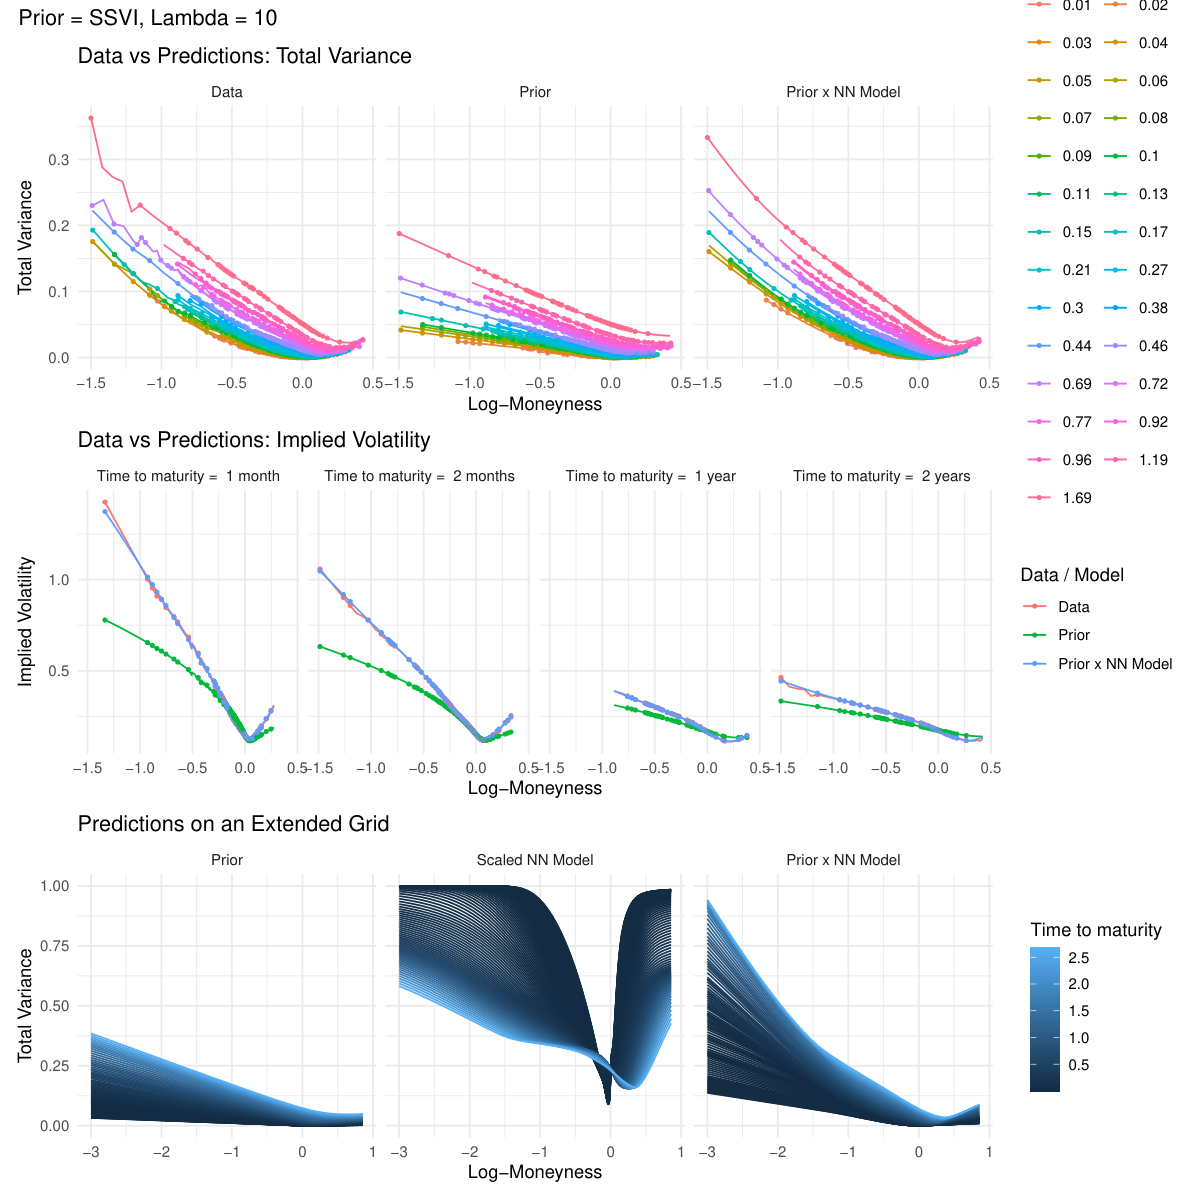
이 연구는 둘을 겹칩니다. 전통 모델이 대략의 지형도를 그리고, 신경망이 그 위에 "고쳐야 할 부분"만 덧그립니다. 그리고 손실함수에 "무차익거래를 어기면 벌점"을 넣어(λ라는 조절 손잡이 사용) 매끄러움과 정확도의 균형을 맞춥니다.
숫자로 확인한 결과가 명확합니다. S&P 500 옵션 데이터(2018년 14월, 그리고 금융위기였던 2008년 912월)로 매일 학습하고 평가했는데:
- 벌점이 없는 모델(λ=0)은 학습 구간과 미관측 구간 모두에서 무차익거래 기회를 만들어 냈습니다(위반 지표가 99를 넘음).
- 벌점을 준 모델(λ=1, 10)은 사실상 무차익 표면을 만들었습니다. 다만 벌점이 셀수록 시세 재현 오차는 조금 늘어났습니다.
- 관측이 없는 먼 구간(외가격 옵션)으로 갈수록 예측 오차가 커졌는데, 이는 내재변동성 값 자체가 큰 구간이라 오차가 부풀려진 결과입니다.
한 가지 더: 데이터가 빈 곳에서는 예측이 얼마나 불안한지도 함께 계산해 줍니다. "여기는 데이터가 없어서 모릅니다"를 숫자로 말해 주는 셈입니다.
한계와 주의점
이 방법은 "수익을 내는 전략"이 아니라 가격표를 정리해 주는 도구입니다. 벌점의 크기(λ)를 정하는 뚜렷한 공식은 없고, 코드 공개 수준도 낮습니다(재현성 48).
이 테마의 공통 인사이트
같은 달에 나온 다른 연구들은 옵션 가격 모델 자체를 시장 가격에 맞게 조정하는 '최적수송' 기법을 제안합니다. 실제 FX 옵션 데이터에서 모델 가격과 시장 가격의 차이가 1 베이시스 포인트(0.01%p) 미만까지 줄어들었고, 모델 가정이 심하게 어긋난 상황(수학적 안전장치인 Feller 조건이 깨진 경우, 0.169로 기준치 1에 한참 못 미침)에서도 성립했습니다. 변동성 표면의 '거칠기'를 수학으로 비교한 연구, 그리고 이 모델들을 누구나 쓸 수 있게 묶은 소프트웨어 패키지까지 — 이 테마의 공통 메시지는 "가격표는 그려서 끝이 아니라, 모순 없이 관리해야 하는 자산"이라는 것입니다.
테마 4: 시장을 안정시키는 진짜 주역은 누구인가
왜 흥미로운가
주식시장에는 '시장조성자'라 불리는 회사들이 있습니다. 사겠다고, 팔겠다고 호가를 내걸어 거래가 잘 되게 기름을 치는 역할이죠. 이들의 좋은 점을 평가할 때 보통은 거래 점유율을 봅니다. 많이 거래할수록 큰 기여를 한다고 생각하죠. 정말 그럴까요?
대표 논문: "그 회사가 떠나면 시장이 얼마나 흔들릴까"로 평가하기
무엇이 문제였나
이 연구는 질문을 뒤집습니다. 개별 참가자의 주문 행동(주문 넣기, 빼기, 시장가로 쳐들어가기) 하나하나에서 출발해, 오더북(호가창) 전체가 어떻게 유지되는지 계산하는 이론을 세웁니다. 그리고 핵심 질문을 던집니다 — "특정 시장조성자가 시장에서 사라지면 가격 변동성은 어떻게 될까?"
무엇을 알아냈나
프랑스 금융당국이 제공한 실제 데이터로 검증했습니다. 유럽 대형 주식 4종목(에어리퀴드, 에실로룩소티카, 미쉐린, 오랑쥬)의 2017년 1년치 주문 기록이죠. 에어리퀴드 한 종목에서만 주문 삽입 236만 건, 취소 240만 건, 공격 주문 21만 건이 일어났습니다(평균 호가차이는 1.07틱).
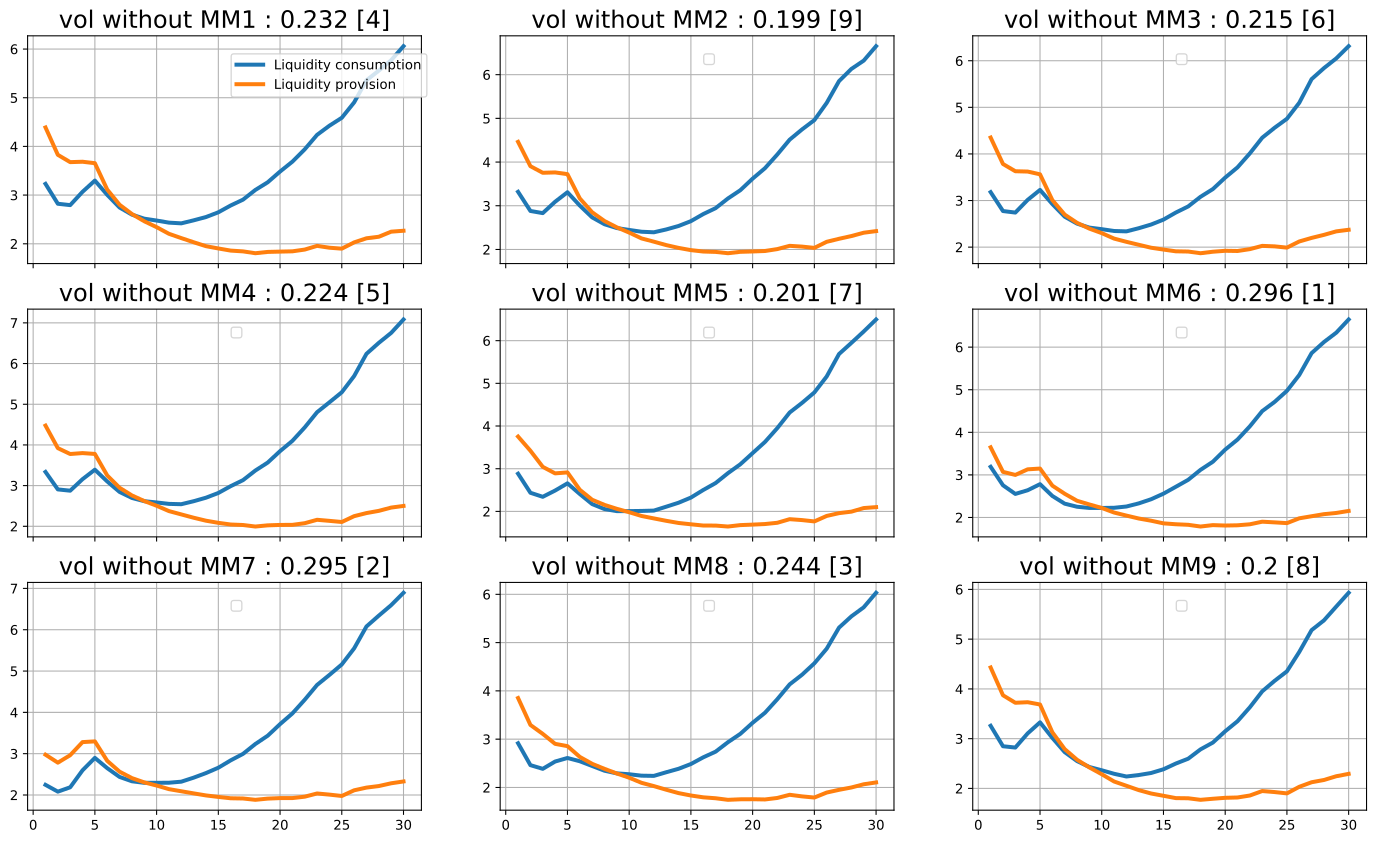
시장조성 의무를 지는 9개 회사를 "떠나는 시뮬레이션"으로 평가한 결과, 놀라운 사실이 나왔습니다.
- 거래 점유율이 3~4%에 불과한 회사(MM6)가 4종목 모두에서 변동성 감소 기여 1위였습니다.
- 점유율 7
12%인 MM7도 12위로 강했습니다. - 반면 가장 점유율이 높은 회사(MM8, 9%)는 3~6위에 그쳤고, 한 회사(MM5)는 오히려 시장 변동성을 키우는 것으로 판정됐습니다.
결국 "얼마나 많이 거래하느냐"와 "시장을 얼마나 안정시키느냐"는 별개였습니다. 세부 행동 패턴도 흥미롭습니다. 호가창의 대기 물량이 적을수록 호가를 더 적극적으로 내거는(대기 순서의 이점을 노리는) 전략이 일반적이었고, 물량이 적어지면 일부 참가자들은 남은 물량을 서둘러 확보하려 들었습니다.
한계와 주의점
유럽의 호가 단위가 큰 주식 4종목, 1년치 데이터에 한정된 결과입니다. 원천 데이터가 비공개라 재현은 어렵습니다(재현성 48). 시장조성 프로그램 참여자의 흐름만 따로 분리해 분석한 점도 일반화에는 주의가 필요합니다.
이 테마의 공통 인사이트
이 달에는 비트코인 선물 상장이 현물 변동성을 어떻게 바꿨는지 분석한 연구, 스테이블코인의 담보 청산이 위기 때 어떤 악순환을 만드는지 모델링한 연구, 전력시장의 호가창 데이터로 가격을 예측한 연구도 함께 나왔습니다. 공통점은 "제도와 구조가 안정성을 어떻게 바꾸는가"를 데이터로 따져 묻는다는 것입니다.
테마 5: 인공지능 전략, 실전에 넣기 전에 어떻게 검증할까
왜 흥미로운가
강화학습(시행착오로 최적 행동을 배우는 인공지능)으로 트레이딩 전략을 만들었다고 칩시다. 이 전략을 실제 돈으로 돌리기 전에 "과거 데이터로 이 전략이 괜찮은지" 확인하고 싶습니다. 이 문제를 '오프라인 정책 평가'라고 부릅니다. 안전벨트 없이 도로에 나가지 않기 위한 최소한의 검사인 셈이죠.
대표 논문: 기간이 길어져도 폭발하지 않는 평가 방법
무엇이 문제였나
기존의 표준 방법은 과거 기록에 "이 전략이라면 어떤 행동을 했을지"의 비율을 곱해 가중치를 매깁니다. 그런데 이 비율을 기간이 길수록 계속 곱하면, 가중치가 눈덩이처럼 불어나 평가 결과가 무용지물이 됩니다. 긴 기간을 보는 전략(월간 리밸런싱 같은 배치 전략)일수록 심각합니다.
무엇을 알아냈나
이 연구는 비율을 곱하는 대신, 매 시점의 "상태 점유율"만 비교합니다. 쉽게 말해, "이 전략이라면 지금 이 상황에 얼마나 자주 와 있었을까"를 기준으로 가중치를 매기는 것이죠. 그 결과:
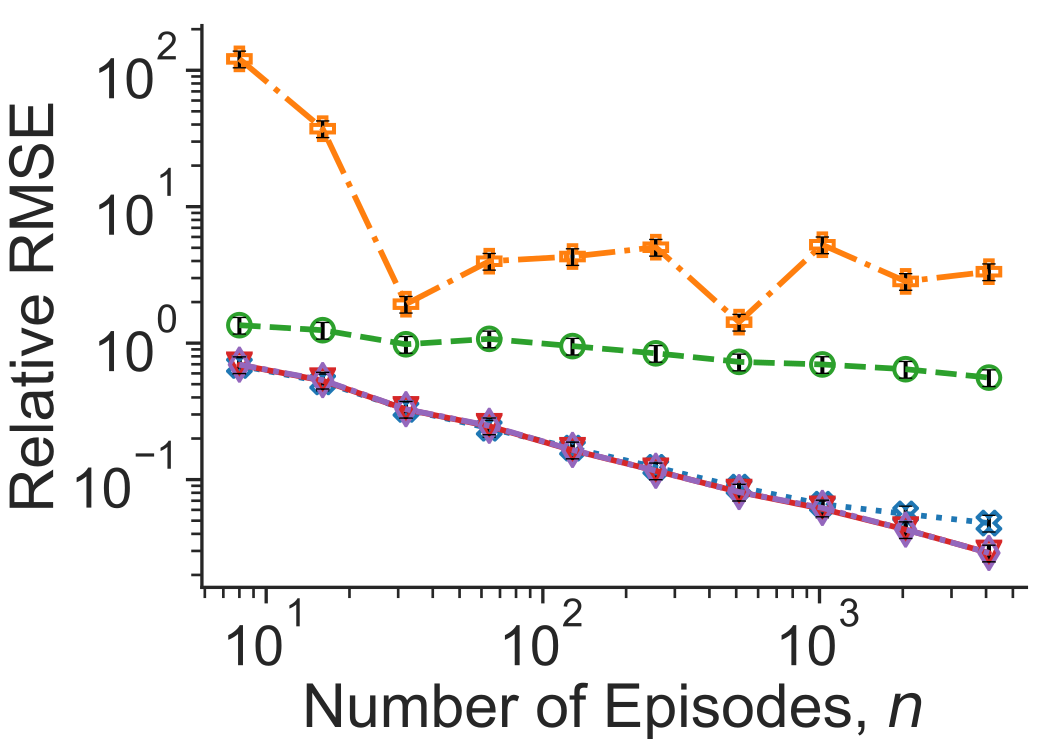
- 기간이 길어져도 오차가 통제됩니다(수학적으로 '기간의 제곱근' 수준까지만 늘어남). 기존 방법은 기하급수적으로 폭증했습니다.
- 표준 벤치마크에서 기존 최선 방법들과 대등하거나 앞섰고, 시간이 변하는 어려운 환경에서는 에피소드 4,096개 이하에서 기존 방법들이 아직 수렴하지 못한 반면 이 방법은 처음부터 안정적으로 수렴했습니다.
- 이론적으로도 오차 상한을 처음으로 증명했고, 이론적 최저 한계(Cramér-Rao 하한) 대비 '기간' 배수 이내라는 점에서 거의 최적에 가깝습니다.
한계와 주의점
수학적으로 '상태 수가 유한한 에피소드형 문제'를 중심으로 증명했고, 실제 트레이딩 데이터에서의 검증은 이 연구의 범위가 아닙니다(적용성 점수 49). 실전 적용 전에 시장 데이터로의 검증 과정이 별도로 필요합니다.
이 테마의 공통 인사이트
이 달의 인공지능 연구들은 "더 똑똑한 알고리즘"이 아니라 "안전하게 쓰기 위한 장치"에 집중했습니다. 기대수익만 보지 않고 위험(꼬리 위험)까지 고려한 학습 방법, 학습 알고리즘이 실제로 최적화하는 목표가 무엇인지 밝힌 기초 연구, 그리고 위험을 감수하는 주문 실행을 해석 가능한 규칙으로 정리한 연구까지 — 인공지능이 거래에 들어오려면 먼저 '검증과 안전장치'가 와야 한다는 이야기입니다.
이 달 전체를 관통하는 메시지
2019년 6월의 다섯 갈래 이야기는 하나의 정신으로 모입니다 — "숫자를 믿기 전에, 그 숫자가 틀릴 수 있는 방식을 계산하라." 최고 전략을 고른 뒤의 신뢰구간은 두 배나 넓어질 수 있고(0.143 대 0.073), 공분산 추정이 튼튼하면 200개 종목 포트폴리오의 위험이 눈에 띄게 줄어들며(0.1505 대 0.1410), 옵션 가격표에 무차익 벌점을 넣으면 말이 안 되는 가격이 사라지고, 시장조성자의 진짜 기여는 점유율이 아니라 행동에서 드러나며, 인공지능 전략은 실전 투입 전에 분산이 통제된 평가를 거쳐야 합니다. 생성형 AI나 대규모 언어모델이 등장하기 전, 확률론과 최적화로 "정직한 숫자"를 만들던 시기의 연구들입니다.
더 알아보기
원문 링크와 5차원 평가 점수
이 글에서 다룬 논문들의 원문과, 우리 지식 베이스가 매긴 5차원 점수입니다(신규성 / 적용성 / 엄밀성 / 재현성 / 통찰, 종합점수는 이들의 가중 합).
| 논문 | 티어 | 종합 | 신규성 | 적용성 | 엄밀성 | 재현성 | 통찰 |
|---|---|---|---|---|---|---|---|
| 1906.00573 최고 샤프비 선택 편향 | A | 76.6 | 72 | 78 | 76 | 82 | 75 |
| 1906.05065 내재변동성 표면 딥러닝 보정 | A | 73.5 | 76 | 84 | 74 | 48 | 77 |
| 1906.05545 희소 요인 공분산 추정 | A | 70.8 | 72 | 76 | 79 | 48 | 70 |
| 1906.05420 금융 에이전트 순위화 | A | 70.7 | 78 | 76 | 84 | 48 | 77 |
| 1906.06478 최적수송 LSV 보정 | A | 70.5 | 76 | 69 | 83 | 43 | 73 |
| 1906.03726 커널 기반 포트폴리오 평가 | A | 69.5 | 68 | 72 | 83 | 48 | 67 |
| 1906.06164 신용 리스크의 모델 리스크 | A | 67.9 | 72 | 68 | 77 | 43 | 72 |
| 1906.00920 포트폴리오 다양성과 차원성 | A | 67.6 | 74 | 66 | 78 | 38 | 74 |
| 1906.03393 주변화 중요도 샘플링 오프라인 평가 | A | 65.7 | 76 | 49 | 83 | 52 | 71 |
| 1906.12317 거래 제약 하 자산배분 | B | 64.6 | 70 | 64 | 76 | 38 | 67 |
| 1906.05187 롱온리 Agnostic Allocation | B | 64.9 | 63 | 76 | 67 | 38 | 70 |
| 1906.12123 R 확률변동성 패키지 | B | 63.5 | 48 | 64 | 67 | 88 | 52 |
| 1906.12134 stochvol 패키지 | B | 62.6 | 42 | 69 | 63 | 82 | 55 |
| 1906.03119 거친 헤스톤 비교 원리 | B | 60.4 | 62 | 50 | 77 | 42 | 65 |
| 1906.03430 비트코인 선물과 변동성 | B | 59.4 | 62 | 68 | 63 | 38 | 72 |
| 1906.02152 스테이블코인 공격과 디레버리징 | B | 59.3 | 78 | 65 | 68 | 25 | 78 |
| 1906.06248 전력 오더북 머신러닝 | B | 58.8 | 65 | 72 | 63 | 35 | 62 |
| 1906.00569 위험 인지 다지 밴딧 | B | 58.2 | 72 | 56 | 78 | 35 | 68 |
| 1906.01427 가우시안 최적 동적 전략 | B | 58.2 | 66 | 65 | 62 | 38 | 67 |
| 1906.07073 정책경사는 진짜 기울기인가 | B | 57.3 | 72 | 38 | 78 | 30 | 68 |
| 1906.02312 위험민감 실행 결정트리 | B | 57.0 | 66 | 73 | 48 | 35 | 62 |
| 1906.01981 분포 불확실성의 확률 해석 | B | 56.7 | 68 | 58 | 57 | 30 | 66 |
우리 지식 베이스에서 함께 읽을 논문
- 선택 편향·전략 검증 계열: Why and how systematic strategies decay, When is cross impact relevant?
- 공분산 추정 계열: Ledoit-Wolf linear shrinkage with unknown mean, Optimal Data Splitting for Holdout Cross-Validation in Large Covariance Estimation, Deep Learning Based Residuals in Non-linear Factor Models
- 옵션 가격·변동성 표면 계열: Finance-Informed Neural Network: Learning the Geometry of Option Pricing, Deep Weighted Monte Carlo: A hybrid option pricing framework, Fast reliable pricing and calibration of the rough Heston model
- 미시구조·호가창 모델링 계열: Estimation of an Order Book Dependent Hawkes Process for Large Datasets, LOB modeling using Hawkes processes with a state-dependent factor, Herding and Liquidity in Order-Book Markets
- 강화학습 오프라인 평가 계열: Off-policy Evaluation in Doubly Inhomogeneous Environments, Bellman Residual Orthogonalization for Offline Reinforcement Learning, Behaviour Policy Optimization
이 글은 2019년 6월 arXiv 백필 코호트(전체 155편, 관련 80편)의 평가 결과를 바탕으로 작성했습니다. 모든 수치는 원문 논문에서 인용했으며, 블로그 성격상 일부 이론적 세부사항은 생략했습니다. 심층 분석은
analysis/reports/backfill/1906.md를 참고하세요.
📚 이 글에서 다룬 논문 (36편)
- ADeep Smoothing of the Implied Volatility Surface
Damien Ackerer, Natasa Tagasovska, Thibault Vatter
- ASparse Approximate Factor Estimation for High-Dimensional Covariance Matrices
Maurizio Daniele, Winfried Pohlmeier, Aygul Zagidullina
- AFrom asymptotic properties of general point processes to the ranking of financial agents
Othmane Mounjid, Mathieu Rosenbaum, Pamela Saliba
- ACalibration of Local-Stochastic Volatility Models by Optimal Transport
Ivan Guo, Gregoire Loeper, Shiyi Wang
- AMachine learning with kernels for portfolio valuation and risk management
Lotfi Boudabsa, Damir Filipovic
- AModel Risk in Credit Risk
Roberto Fontana, Elisa Luciano, Patrizia Semeraro
- AOptimising portfolio diversification and dimensionality
Mathias Barkhagen, Brian Fleming, Sergio Garcia Quiles 외 5명
- ATowards Optimal Off-Policy Evaluation for Reinforcement Learning with Marginalized Importance Sampling
Tengyang Xie, Yifei Ma, Yu-Xiang Wang
- BThe Case for Long-Only Agnostic Allocation Portfolios
Pierre-Alain Reigneron, Vincent Nguyen, Stefano Ciliberti 외 2명
- B
- BModeling Univariate and Multivariate Stochastic Volatility in R with stochvol and factorstochvol
Darjus Hosszejni, Gregor Kastner
- BThe Effects of the Introduction of Bitcoin Futures on the Volatility of Bitcoin Returns
Wonse Kim, Junseok Lee, Kyungwon Kang
- B(In)Stability for the Blockchain: Deleveraging Spirals and Stablecoin Attacks
Ariah Klages-Mundt, Andreea Minca
- BMachine Learning on EPEX Order Books: Insights and Forecasts
Simon Schnürch, Andreas Wagner
- BDistribution oblivious, risk-aware algorithms for multi-armed bandits with unbounded rewards
Anmol Kagrecha, Jayakrishnan Nair, Krishna Jagannathan
- B
- BOptimal Dynamic Strategies on Gaussian Returns
Nick Firoozye, Adriano Koshiyama
- BUnderstanding Distributional Ambiguity via Non-robust Chance Constraint
Qi Wu, Shumin Ma, Cheuk Hang Leung 외 2명
- AWhy and how systematic strategies decay
Antoine Falck, Adam Rej, David Thesmar
- AWhen is cross impact relevant?
Victor Le Coz, Iacopo Mastromatteo, Damien Challet 외 1명
- ALedoit-Wolf linear shrinkage with unknown mean
Benoit Oriol, Alexandre Miot
- AOptimal Data Splitting for Holdout Cross-Validation in Large Covariance Matrix Estimation
Lamia Lamrani, Christian Bongiorno, Marc Potters
- AFinance-Informed Neural Network: Learning the Geometry of Option Pricing
Amine M. Aboussalah, Xuanze Li, Cheng Chi 외 1명
- BDeep Weighted Monte Carlo: A hybrid option pricing framework using neural networks
Sándor Kunsági-Máté, Gábor Fáth, István Csabai 외 1명
- AFast reliable pricing and calibration of the rough Heston model
Svetlana Boyarchenko, Marco de Innocentis, Sergei Levendorskiĭ
- AEstimation of an Order Book Dependent Hawkes Process for Large Datasets
Luca Mucciante, Alessio Sancetta
- BLOB modeling using Hawkes processes with a state-dependent factor
Emmanouil Sfendourakis, Ioane Muni Toke
- BOff-policy Evaluation in Doubly Inhomogeneous Environments
Zeyu Bian, Chengchun Shi, Zhengling Qi 외 1명
- BBellman Residual Orthogonalization for Offline Reinforcement Learning
Andrea Zanette, Martin J. Wainwright
- BBehaviour Policy Optimization: Provably Lower Variance Return Estimates for Off-Policy Reinforcement Learning
Alexander W. Goodall, Edwin Hamel-De le Court, Francesco Belardinelli
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2024-10 월간
Generative AI, Managerial Expectations, and Economic Activity
2024년 10월 발표된 AI 금융 연구 중 가장 주목할 만한 논문들을 살펴봅니다. 포트폴리오 최적화의 공분산 추정 문제부터 강화학습 기반 트레이딩, 생성형 AI를 활용한 거시경제 예측까지 — 현실적 제약 속에서 더 안정적인 투자 전략을 만드는 최신 연구 동향을 쉽게 풀어 설명합니다.
 📊 2026-04 월간
AI가 진짜 돈을 움직이기 시작했다 — 2026년 4월 금융 AI 연구 하이라이트
2026년 4월 금융 AI 연구 동향. LLM 에이전트가 실제 자본으로 온체인 거래를 시작하고, 백테스트의 허상이 대규모 실증으로 검증된 달의 핵심 논문들을 살펴봅니다.
 📊 2026-03 월간
AI가 주식을 예측할 수 있을까? — 2026년 3월 금융 AI 연구 리뷰
2026년 3월 금융 AI 논문 734편을 분석한 월간 종합. LLM의 시간 편향 문제, 백테스트 엔진의 숨겨진 오차, 포트폴리오 최적화의 새로운 수학, LOB 시뮬레이션의 현실화, 강화학습 트레이딩 시스템의 실전 전환까지 — 신뢰할 수 있는 금융 AI를 만드는 5가지 연구 테마를 살펴봅니다.