
2019년 11월 AI 금융 연구 리뷰 — 시장이 흔들릴 때 베타를 잡는 법, 그리고 가짜 옵션 시장을 만든 GAN
한 달 동안 올라온 논문 104편, 그중 진짜 쓸모 있는 9편을 골랐습니다.
들어가며: 왜 "평소와 다를 때"가 문제인가요?
주식 투자를 하다 보면 이런 경험을 한 번쯤 해보셨을 겁니다. "이 종목은 시장과 별로 상관없는 움직임을 보인다"고 생각했는데, 막상 시장이 폭락하는 날 그 종목도 함께 떨어지는 거죠. 시장중립 전략을 쓰는 헤지펀드 매니저들이 매일 밤잠을 설치는 이유가 바로 이것입니다. 평소에는 잘 작동하던 헤지 비율이, 시장이 흔들리는 순간 갑자기 "누수"가 나는 거예요.
2019년 11월, arXiv에 올라온 논문들은 이 문제를 비롯해 흥미로운 주제들을 다루고 있습니다. 인공지능이 옵션 시장을 "가짜로" 만들어내는 기술, 수학자들이 증명한 Uniswap의 가격 추적 메커니즘, 그리고 로봇이 투자자의 성향을 알아서 파악하는 방법까지. 한 달간 올라온 104편의 논문 중 가장 의미 있는 연구들을 다섯 가지 테마로 정리했습니다.
테마 1: 시장이 흔들릴 때, 베타를 보정하는 기술
무엇이 문제였나요?
헤지펀드가 "시장중립" 전략을 쓴다는 건, 시장이 오르든 내리든 상관없이 수익을 내겠다는 뜻입니다. 그러려면 포트폴리오의 "베타" — 시장 움직임에 대한 민감도 — 를 0에 가깝게 유지해야 합니다.
문제는 이 베타 추정이 생각보다 부정확하다는 겁니다. 특히 시장이 급락할 때. 2008년 금융위기 때 "시장중립"이라던 많은 펀드가 함께 폭락한 건 바로 이 때문이에요.
핵심 아이디어: 레버리지 효과를 반영한 "반응형 베타"
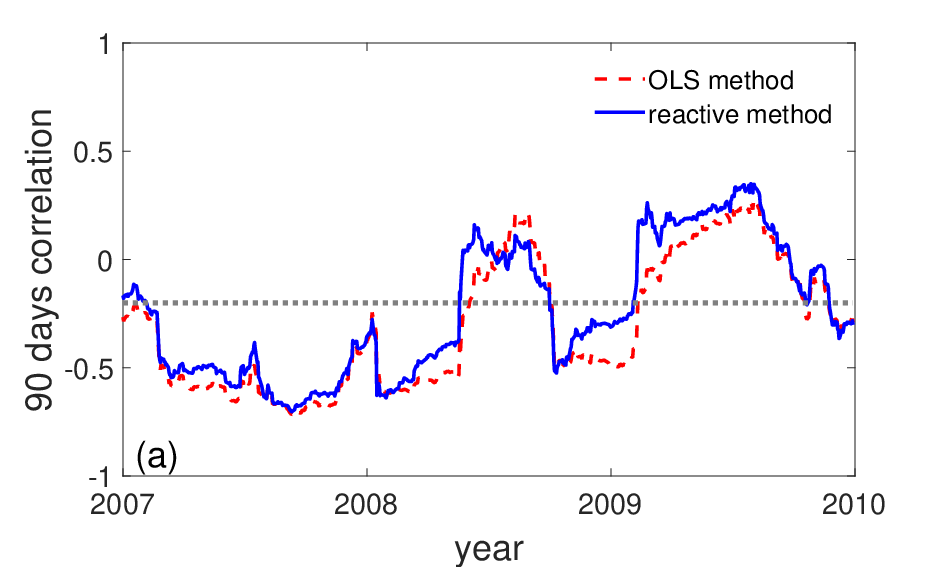
프랑스 연구팀(Valeyre, Grebenkov, Aboura)이 제안한 "반응형 베타(Reactive Beta)" 모형의 핵심은 간단합니다. 기존 방식은 주식과 시장의 관계를 "고정적"으로 봤는데, 실제로는 이 관계가 시장 상황에 따라 변한다는 거예요.
구체적으로 세 가지 현상을 고려합니다:
- 개별 레버리지 효과: 주식 가격이 떨어지면 그 회사의 부채 비율이 상대적으로 올라가면서, 시장에 더 민감해집니다.
- 체계적 레버리지 효과: 시장 전체가 하락하면 모든 주식 간 상관관계가 올라갑니다. "무리 지어 떨어지는" 현상이죠.
- 비선형 베타 탄력성: 이미 베타가 높은 주식은 변동성 변화에 더 강하게 반응합니다.
이 세 가지를 EMA(지수이동평균)로 추정해 실시간으로 보정합니다. 빠른 충격(7일)과 느린 추세(40일)를 따로 추적하는 것이 포인트.
결과 — 얼마나 좋아졌나요?
미국 주식 600종목, 유럽 주식 600종목, 2000~2015년 데이터로 검증한 결과입니다:
| 전략 | 기존(OLS) 바이어스 | 반응형 바이어스 | 개선 |
|---|---|---|---|
| 저변동성 (미국) | -25.54% | -16.79% | 34% 감소 |
| 단기반전 (미국) | 13.09% | -6.06% | 54% 감소 |
| 모멘텀 (미국) | -6.27% | -2.95% | 53% 감소 |
| 규모 (미국) | -7.56% | -1.84% | 76% 감소 |
"바이어스"란 전략과 시장 사이의 예상치 못한 상관관계를 말하는데, 이 수치가 낮을수록 진짜 시장중립에 가깝다는 뜻입니다. 특히 단기반전 전략의 바이어스가 13%에서 -6%로 뒤집힌 게 인상적입니다.
한계와 주의점
- 이 모형도 만능은 아닙니다. 저변동성 팩터에는 여전히 잔여 바이어스가 남아 있는데, 이건 "선택 편향" — 저변동성 주식을 고르는 과정 자체에 내재된 문제 — 때문이라고 연구팀은 설명합니다.
- 코드와 데이터가 공개되지 않아(재현성 점수 48/100) 직접 검증하려면 추가 작업이 필요합니다.
그래서 투자/실무엔?
롱숏 전략이나 팩터 포트폴리오를 운용하시는 분들이라면, 헤지 비율을 "고정값"이 아닌 "시장 상황에 따라 실시간으로 조정하는 값"으로 바꿔보는 것을 고려해볼 만합니다. 이 논문이 제시하는 EMA 기반 보정 공식은 비교적 간단해서 바로 프로토타입을 만들 수 있을 정도예요.
논문: The Reactive Beta Model — Valeyre, Grebenkov, Aboura (2019) 등급: A | 종합 점수: 71.2/100
테마 2: GAN으로 "가짜 옵션 시장" 만들기
무엇이 문제였나요?
인공지능으로 옵션 거래 전략을 학습하려면대량의 시장 데이터가 필요합니다. 문제는 옵션 시장 데이터가 매우 제한적이라는 거예요. 유로스탁스 50 옵션의 경우 약 10년치 데이터면 수천 개 정도밖에 안 됩니다. 이걸로 복잡한 딥러닝 모델을 학습시키기엔 턱없이 부족하죠.
마치 요리사를 훈련시키려는데 재료가 열 가지밖에 없는 것과 같습니다.
핵심 아이디어: GAN으로 옵션 변동성면 생성
J.P. Morgan 연구팀(Wiese, Bai, Wood, Buehler)이 제안한 해결책은 놀랍습니다. GAN(Generative Adversarial Network) — 이미지에서 "가짜 얼굴"을 만들어내는 바로 그 기술 — 을 옵션 시장에 적용한 거예요.
어떻게 작동하냐면:
- 옵션 가격을 "이산 국소 변동성(DLV)"이라는 수학적 표현으로 변환합니다. 이 변환의 장점은 "무차익 조건" — 말도 안 되는 가격이 나오지 않게 하는 규칙 — 이 간단해진다는 거예요.
- GAN의 생성자(generator)가 이 DLV 패턴을 학습해서, 실제와 구분하기 어려운 "가짜" 변동성 곡면을 만들어냅니다.
- 두 가지 아키텍처를 비교했는데, RNN(순환신경망)과 TCN(시간 합성곱 신경망)이 각각 장단점이 있었습니다.
결과 — 얼마나 실제 같은가요?
유로스탁스 50 옵션, 2011~2019년 데이터로 벤치마크한 결과입니다:
| 모델 | 분포 차이 | 왜도 오차 | 첨도 오차 | 시계열 상관 |
|---|---|---|---|---|
| GAN | 0.044 | 0.063 | 0.097 | 0.186 |
| WGAN-GP | 0.046 | 0.296 | 1.023 | 0.296 |
| 전통적(qMLE) | 0.124 | 0.636 | 0.585 | 0.765 |
숫자가 낮을수록 실제 시장에 가깝다는 뜻입니다. GAN이 모든 지표에서 전통적 방법을 크게 앞섰어요. 특히 주목할 건, GAN이 생성한 경로가 실제 시장처럼 고변동성과 저변동성 국면을 오가는 패턴을 보여준다는 점입니다.
"GAN으로 다변량 금융 시계열을 생성하는 데 처음으로 성공"했다고 주장합니다. NeurIPS 2019 워크숍에서 발표되었고요.
한계와 주의점
- J.P. Morgan 내부 코드 기반이라 완전히 공개되지는 않았습니다(재현성 점수 48).
- 바닐라 옵션에 최적화된 변환이라 이국적 옵션(exotic options)에는 추가 검증이 필요합니다.
- 장기 의존성(long-range dependence)을 얼마나 잘 포착하는지는 아직 미검증 상태입니다.
그래서 투자/실무엔?
옵션 트레이딩 전략을 개발할 때, 실제 데이터가 부족한 상황을 보완하는 "합성 데이터 생성기"로 활용할 수 있습니다. 특히 스트레스 테스트 — "2008년 같은 위기가 다시 오면 이 전략이 어떻게 될까?" — 를 위해대량의 시나리오를 생성하는 데 유용합니다.
논문: Deep Hedging: Learning to Simulate Equity Option Markets — Wiese, Bai, Wood, Buehler (2019) 등급: A | 종합 점수: 70.9/100
테마 3: 두 명의 트레이더가 같은 시장에서 경쟁하면?
무엇이 문제였나요?
대형 기관이대량의 주식을 사거나 팔 때, 시장에 미치는 충격(가격 영향)을 최소화하는 건 오래된 과제입니다. 그런데 만약 두 기관이동시에 같은 시장에서 비슷한 거래를 하려 한다면? 서로의 존재가 상대방의 비용에 영향을 미치게 됩니다.
이것은 사실 "게임 이론" 문제입니다. 서로의전략에 따라최적해가 달라지니까요.
핵심 아이디어: 포트폴리오 추적 게임
독일 수학자 Moritz Voß가 연구한 "2인 포트폴리오 추적 게임"은 이 상황을 수학적으로 모델링합니다.
쉽게 비유하면, 두 명의 택배 기사가같은 지역에서 배달을 하려는 것과 같습니다. 둘 다최적 경로를 찾으려 하지만, 상대방이어느 쪽으로 가느냐에 따라자신의 경로를 바꿔야 합니다.
이 논문은 Almgren-Chriss 모형 — 가격 충격을 "영구적"과 "일시적"으로 나누는고전적인 프레임워크 — 을확장해서두 참여자의 상호작용을 분석합니다. 놀라운 건, 이 복잡한 게임의 유일한 균형을 폐형식(닫힌 형태 수식)으로 구할 수 있다는 점입니다.
핵심 발견
균형 전략에서 두 가지행동 패턴이 나타납니다:
- 착취적(intent): 상대방의 거래필요성을이용해서자신의 비용을 줄입니다.
- 유동성 제공:반대로 상대방에게 유동성을 제공하면서자신의 비용을 줄입니다.
어떤 패턴이 나타나느냐는 "영구 가격충격"과 "일시 가격충격"의 비율에 따라 결정됩니다.
그래서 투자/실무엔?
대형 주문을집행할 때,같은 시장에서 비슷한방향으로 거래하는다른 기관이 있는지를고려하는 게중요하다는이론적 근거를 제공합니다.특히 기관투자자들이동시에 리밸런싱하는 시기(분기 말 등)에는이런 상호작용이눈에 띄게 될 수 있습니다.
논문: A two-player portfolio tracking game — Voß (2019) 등급: A | 종합 점수: 69.7/100
같은 테마: Uniswap의수학적비밀
이 테마에서하나 더주목할 만한 논문은 스탠퍼드 연구팀이 쓴 "An analysis of Uniswap markets"입니다.
Uniswap은 이더리움 블록체인 위에서 작동하는 탈중앙화 거래소(DEX)입니다.전통적인 거래소는중간인(마켓메이커)이 가격을호가하지만, Uniswap은 x · y = k라는 간단한 수식으로 가격을 결정합니다. x와 y는두 종류의 가상화폐의 예비량이고, k는불변량입니다.
이 논문은이 간단한 메커니즘이어떻게 잘 작동하는지수학적으로증명합니다:
- 참고 시장 가격(다른 거래소의 가격)과자연스럽게 비슷해진다는 것
- 대규모 에이전트 시뮬레이션으로 광범위한 시장 조건에서안정적이라는 것
- 가격을 조작하려면얼마의 비용이 드는지 —예비량이 클수록 조작이 더 어려워진다는 것
2019년당시 DeFi 자산이 7.5억 달러 규모였는데, 이 논문이 이후 DeFi 폭발의 성장의이론적씨앗을 뿌린 작업입니다.
논문: An analysis of Uniswap markets — Angeris, Kao, Chiang, Noyes, Chitra (2019) 등급: A | 종합 점수: 69.5/100
테마 4: 시장 충격이 "감염"처럼 퍼지는 이유
무엇이 문제였나요?
2010년 5월 6일, 미국 주식 시장에서몇 분 만에 다우존스 지수가 약 1,000포인트 폭락했다가 바로 회복하는 "플래시 크래시"가 발생했습니다. 이후 조사에서발견된 건, 초기 충격이 주문 흐름을 통해"감염"처럼 퍼졌다는 것입니다. 하나의 대규모 주문이촉발한연쇄반응이전체 시장을 뒤흔든 거죠.
핵심 아이디어: 자기흥분적 점프 모형
이 현상을수학적으로 모델링한 것이 "자기흥분적(self-exciting) 점프 동역학"입니다.
비유를 들어보겠습니다. 일반적인 시장 모형은 "비가 무작위로 내린다"고 가정합니다. 하지만 실제 시장은 "비가 오면 더 많이 오는" 경향이 있습니다. 하나의 충격이후속 충격을 유발하는 거죠. 이것이 자기흥분적 프로세스의 핵심입니다.
이 논문은 Hawkes 과정 — 사건이 발생하면후속 사건이 발생할 확률이 올라가는 수학 모형 — 을 사용해서, 기존의각종 확률변동성 모형(Heston, SABR 등)을 하나의 통합된 프레임워크로 묶습니다.
핵심 발견
- 미시구조 관찰(실제 주문 흐름)에서 출발해, 기존 모형들을 특수한 극한 상황으로 복원
- 자기흥분 강도에 따라 점프가 군집(clustering)하는 패턴이 달라짐
- 스케일링 극한의 수렴성을 엄밀하게 증명
그래서 투자/실무엔?
Hawkes 기반 모형을 사용하면, 시장 충격이 어떻게 퍼지는지 실시간으로 추적할 수 있습니다. 이 정보를 사용해서 위험 관리 시스템을 설계하면, "충격이 아직 국소적인 단계에서" 미리 대응할 수 있습니다.
논문: The Microstructure of Stochastic Volatility Models with Self-Exciting Jump Dynamics (2019) 등급: A | 종합 점수: 68.9/100
테마 5: 강화학습으로 선물 트레이딩하기
무엇이 문제였나요?
전통적인 추세추종(trend following) 전략은 보통 "가격이 이동평균선을 위로 돌파하면 매수, 아래로 돌파하면 매도" 같은 고정된 규칙을 사용합니다. 문제는 이 규칙들이 모든 시장 상황에서 equally 잘 작동하지는 않는다는 거예요.
인공지능, 구체적으로 강화학습(RL)을 사용하면 시장 상황에 따라 유연하게 대응하는 전략을 학습할 수 있을까요?
핵심 아이디어: 변동성 타기팅 보상 함수
이 논문의 핵심 기여는 보상 함수 설계입니다. 강화학습에서 "에이전트"가 무엇을 최적화하느냐에 따라 결과가 크게 달라지거든요.
연구팀은 두 가지를 보상 함수에 반영합니다:
- 변동성 스케일링: 시장 변동성이 높을 때는 포지션을 줄이고, 낮을 때는 늘리는 전략. 마치 운전할 때 속도에 따라 안전거리를 조절하는 것과 같습니다.
- 거래 비용:매번 거래마다 발생하는 수수료와 가격 미끄러짐(원하는 가격과 실제 체결 가격의 차이)을 보상에서 차감.
이렇게 설계된 보상 함수로 다자산 선물(유동성 높은 상품) 대상으로 딥강화학습을 학습시켰습니다.
핵심 발견
- 변동성 스케일링이 보상의 안정성을 크게 향상
- 전통적인 추세추종 전략 대비 개선된 위험조정 성과
- 거래비용을 내재화한 보상 함수가 실전에 더 적합
한계와 주의점
- 코드가 부분적으로만 공개(재현성 점수 53)
- 특정 선물 유니버스에서만 검증 — 다른 자산군에는 추가 검증 필요
- 시장 국면 변화(regime change)에 대한 강건성 미검증
그래서 투자/실무엔?
유동성 높은 선물 시장에서 비용 민감형 포지션 정책을 구축하려는 분들에게 실용적인 청사진을 제공합니다. 특히 "변동성 스케일링"이라는 개념은 많은 퀀트 전략에도 이미 사용되고 있어서, RL 없이도 적용 가능한 통찰입니다.
논문: Deep Reinforcement Learning for Trading (2019) 등급: A | 종합 점수: 65.4/100
월 전체 Big Picture: 전통과 AI가 만나는 순간
2019년 11월의 연구들은 흥미로운 교차점에 있습니다.
한쪽에서는 전통적인 금융수학이 완성되어 가고 있습니다. 레버리지 효과를 반영한 베타 보정(71.2점), 확률제어 기반 포트폴리오 게임(69.7점), 자기흥분적 점프 모형(68.9점) — 모두 해석적 해와 이론적 엄밀성을 추구하는 연구입니다.
다른 한쪽에서는 AI가 금융의 새로운 영역을 개척하고 있습니다. GAN으로 옵션 시장을 생성(70.9점), Uniswap AMM의 수학적 분석(69.5점), 딥강화학습으로 선물 트레이딩(65.4점) — 이 연구들은 데이터와 컴퓨터의 힘으로 기존 이론의 한계를 넘어선 시도입니다.
흥미로운 건 이 두 세계가 서로 배우고 있다는 점입니다. GAN 연구팀은 금융의 무차익 조건을 사용해서 생성 품질을 높였고, RL 연구팀은 전통적인 변동성 스케일링 개념을 보상 함수에 녹였습니다.
다만 아쉬운 점도 있습니다. A등급 9건 논문의 평균 재현성 점수가 약 55점으로, 코드와 데이터가 공개되지 않은 경우가 많습니다. 이는 학술 연구가 실전으로 전환되기까지 추가적인 작업이 필요함을 의미합니다.
더 알아보기
이달의 전체 S/A 등급 논문 목록:
| # | 논문 | 분야 | 점수 |
|---|---|---|---|
| 1 | The Reactive Beta Model | 위험 관리 | 71.2 |
| 2 | Deep Hedging: Option Market Simulation | 합성 데이터 | 70.9 |
| 3 | Two-player Portfolio Tracking Game | 게임 이론 | 69.7 |
| 4 | An Analysis of Uniswap Markets | DeFi AMM | 69.5 |
| 5 | Self-Exciting Jump Dynamics | 변동성 | 68.9 |
| 6 | Pairs Trading with Transaction Costs | 통계 차익 | 67.0 |
| 7 | Personalized Robo-Advising | 포트폴리오 | 66.4 |
| 8 | Embedding with Signatures | 시계열 | 66.0 |
| 9 | DRL for Trading | 강화학습 | 65.4 |
함께하기
이런 연구들을 매주 업데이트하고 있습니다.
- 웹사이트: ohselab.com
- 뉴스레터 구독: 최신 AI 금융 연구를 메일로 받아보세요
- 상담 문의: 퀀트 전략 개발·AI 모델 구축에 관심이 있으시다면 연락 주세요
2019년 11월 arXiv에 올라온 q-fin., cs.LG, cs.AI, cs.CL, cs.MA 카테고리 논문 104편을 분석한 것입니다. 모든 점수와 근거는 KB(지식베이스)의 5차원 평가 기준에 따릅니다.*
생성일: 2026-10-01 | 모델: mimo-v2.5-pro | 파이프라인: regen_pump → regen-on-approval
📚 이 글에서 다룬 논문 (9편)
- AThe Reactive Beta Model
Sebastien Valeyre, Denis S. Grebenkov, Sofiane Aboura
- ADeep Hedging: Learning to Simulate Equity Option Markets
Magnus Wiese, Lianjun Bai, Ben Wood 외 1명
- AAn analysis of Uniswap markets
Guillermo Angeris, Hsien-Tang Kao, Rei Chiang 외 2명
- BDeep Reinforcement Learning for Trading
Zihao Zhang, Stefan Zohren, Stephen Roberts
- APersonalized Robo-Advising: Enhancing Investment through Client Interaction
Agostino Capponi, Sveinn Olafsson, Thaleia Zariphopoulou
- B
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2022-01 월간
2022년 1월 AI 금융 연구 요약 — 고차원 리스크 추정, CVaR 집행, 선행-후행 네트워크
2022년 1월 arXiv에 공개된 AI 금융 연구를 5개 테마로 정리합니다. 고차원 포트폴리오의 VaR/CVaR 추정 가속, CVaR 기반 최적 집행 전략, 비동기 고빈도 데이터의 공분산 추정, 선행-후행 네트워크 클러스터링, 리스크 인식 강화학습 트레이딩까지 — 이론과 실전을 잇는 핵심 연구들을 쉽게 풀어 설명합니다.
 📊 2026-04 월간
AI가 진짜 돈을 움직이기 시작했다 — 2026년 4월 금융 AI 연구 하이라이트
2026년 4월 금융 AI 연구 동향. LLM 에이전트가 실제 자본으로 온체인 거래를 시작하고, 백테스트의 허상이 대규모 실증으로 검증된 달의 핵심 논문들을 살펴봅니다.
 📊 2026-03 월간
AI가 주식을 예측할 수 있을까? — 2026년 3월 금융 AI 연구 리뷰
2026년 3월 금융 AI 논문 734편을 분석한 월간 종합. LLM의 시간 편향 문제, 백테스트 엔진의 숨겨진 오차, 포트폴리오 최적화의 새로운 수학, LOB 시뮬레이션의 현실화, 강화학습 트레이딩 시스템의 실전 전환까지 — 신뢰할 수 있는 금융 AI를 만드는 5가지 연구 테마를 살펴봅니다.