
2019년 12월 AI 트레이딩 연구 리뷰 (arXiv 1912 코호트)
들어가며
비행기 조종사는 비행기를 몰기 전에 수천 시간을 시뮬레이터에서 연습합니다. 실제 승객을 태우기 전에 온갖 비상 상황을 미리 경험하는 거죠. 그런데 만약 그 시뮬레이터가 실제 비행과 너무 달라서, 시뮬레이터에서 완벽하게 대처하던 상황이 실제에서는 전혀 다르게 나타난다면 어떨까요?
AI 트레이딩의 세계에서도 정확히 이 문제가 벌어지고 있습니다. 강화학습 에이전트는 "가짜 시장"에서 수백만 번 연습한 뒤 실제 시장에 투입되는데, 그 가짜 시장이 실제와 얼마나 비슷한지 아무도 확신하지 못하는 거죠. 2019년 12월 arXiv에 올라온 논문들은 이 문제를 정면으로 다루고 있습니다.
이번 달에는 LOB(주문장) 시뮬레이터의 현실성 검증, 대량 주문의 시장 충격 최소화, 수천 개 파생상품의 리스크를 빠르게 계산하는 방법, 그리고 뉴스와 주가를 동시에 읽는 AI까지, 7편의 A등급 논문을 다룹니다.
테마 1: 가짜 시장은 진짜와 얼마나 다를까?
문제의식
요즘 AI 트레이딩 에이전트는 주로 시뮬레이터에서 학습합니다. 실제 주식시장에서 실험하면 돈이 나가니까, 가짜 시장을 만들어놓고 거기서 수백만 번 연습하는 거죠. 그런데 그 가짜 시장이 실제와 많이 다르면 어떻게 될까요? 시뮬레이터에서는 훌륭하게 작동하던 전략이 실제 시장에서는 엉망이 될 수 있습니다.
핵심 논문: LOB 시뮬레이터 현실성 벤치마크
"Get Real: Realism Metrics for Robust Limit Order Book Market Simulations" (arXiv:1912.04941)
이 논문의 연구팀(JPMorgan·CMU·IBM)은 기존 문헌을 샅샅이 뒤져서, LOB 시뮬레이터가 얼마나 "진짜 같은지" 평가하는 참조 메트릭 카탈로그를 만들었습니다.
쉽게 말하면, 시뮬레이터의 "성적표"를 만든 겁니다. 이 성적표에는 이런 항목들이 들어있습니다:
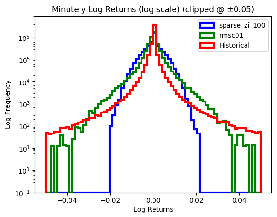
- 수익률 분포: 실제 주식 수익률은 정규분포가 아니라 꼬리가 두꺼운데, 시뮬레이터도 그런가?
- 주문 도착 패턴: 실제 시장에서는 주문이 랜덤하게 오지 않고 클러스터(뭉쳐서)로 오는데, 시뮬레이터는?
- 시장 충격: 큰 주문이 가격을 밀어내는 패턴이 실제와 비슷한가?
- 변동성 클러스터링: 실제 시장에서는 변동성이 한 번 커지면 계속 큰 상태로 유지되는 경향이 있는데?
연구팀은 이 메트릭들을 실제 시장 데이터와 여러 시뮬레이터(ABIDES 등)에 적용해봤더니, 대부분의 메트릭에서 시뮬레이터와 실제 사이에 유의미한 괴리가 있었습니다. 특히 시장 충격의 비선형성과 주문 도착의 자기상관 구조에서 차이가 컸다고 합니다.
왜 중요할까요? 이 논문은 시뮬레이터를 "고치는" 방법을 제시한 건 아닙니다. 하지만 "어디가 틀렸는지"를 체계적으로 알려주는 성적표를 만든 거예요. 앞으로 누군가 시뮬레이터를 개선하면, 이 메트릭으로 얼마나 좋아졌는지 객관적으로 측정할 수 있게 된 겁니다.
이 테마의 공통 인사이트
이 달의 미시구조 논문들이 공통적으로 말하는 건 이겁니다: "시뮬레이션은 편리하지만, 그 편리함에 안주하면 위험하다." 시뮬레이터의 현실성을 검증하는 도구가 없으면, AI 에이전트가 "가짜 시장에서만 잘하는" 상태로 실제 거래에 투입될 수 있다는 거죠. 이건 단순한 학술적 문제가 아니라, 실제 돈이 오가는 문제입니다.
테마 2: 100개 종목을 한 번에 팔 때 — 시장 충격의 과학
문제의식
기관 투자자가 100개 종목을 한꺼번에 매도한다고 상상해보세요. 한 번에 다 팔면 가격이 폭락하겠죠? 그래서 보통 나눠서 팔아요. 그런데 "얼마씩, 얼마나 자주" 팔아야 손실이 최소화될까요? 이 문제를 수학적으로 풀어주는 것이 바로 "최적 실행(optimal execution)" 이론입니다.
핵심 논문: 100개 종목의 포트폴리오 청산
"Portfolio liquidation under transient price impact" (arXiv:1912.06426)
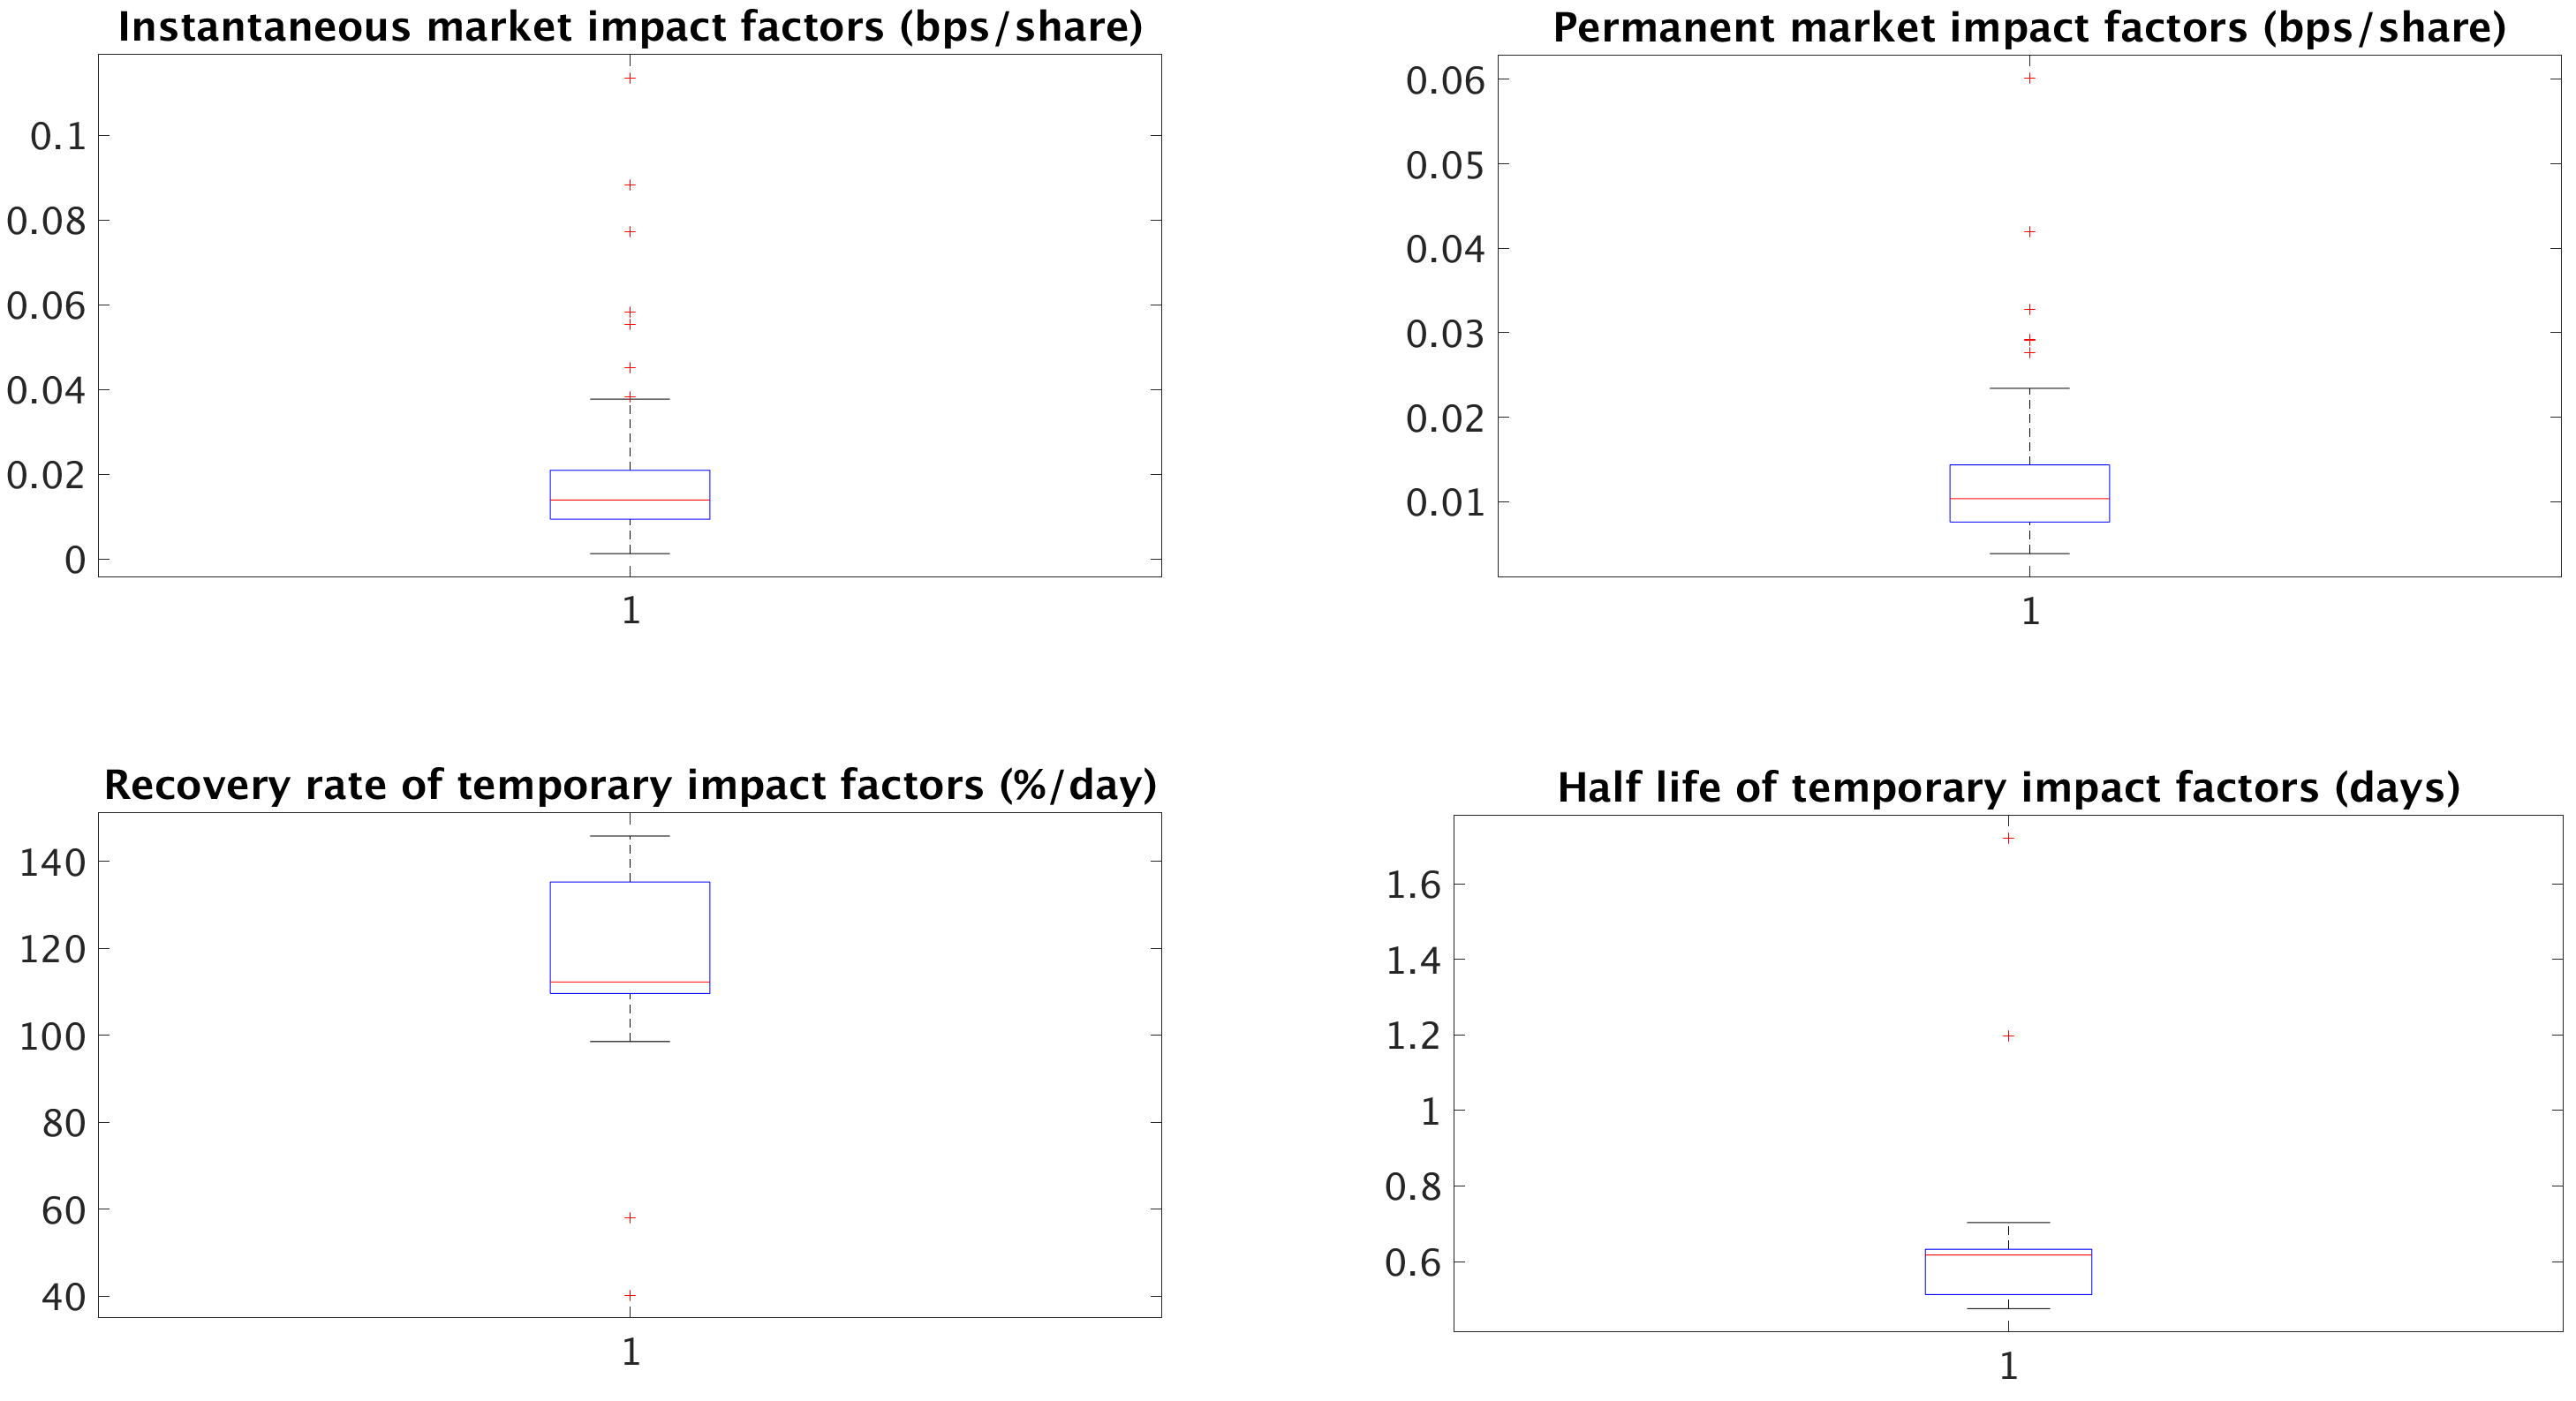
이 논문은 세 가지 형태의 시장 충격을 하나의 수학적 모형으로 통합했습니다:
- 즉시 충격: 주문을 내는 순간 가격이 밀리는 것
- 영구 충격: 한 번 밀린 가격이 다시 돌아오지 않는 것
- 일시적 충격: 밀렸다가 서서히 원래대로 돌아오는 것
기존의 유명한 두 모형 — Almgren-Chriss(2001)와 Obizhaeva-Wang(2013) — 은 각각 이 세 가지 중 일부만 다뤘는데, 이 논문은 셋을 모두 하나의 프레임워크로 묶고, 명시적인 해(수학적 답)를 도출했습니다.
더 인상적인 건 실증 검증입니다. 연구팀은 NASDAQ 100개 종목의 고빈도 주문장 데이터를 사용해서 이 모형의 충격 파라미터를 추정했고, 도출된 최적 전략이 기존 벤치마크들보다 유의미한 비용 절감을 달성했습니다.
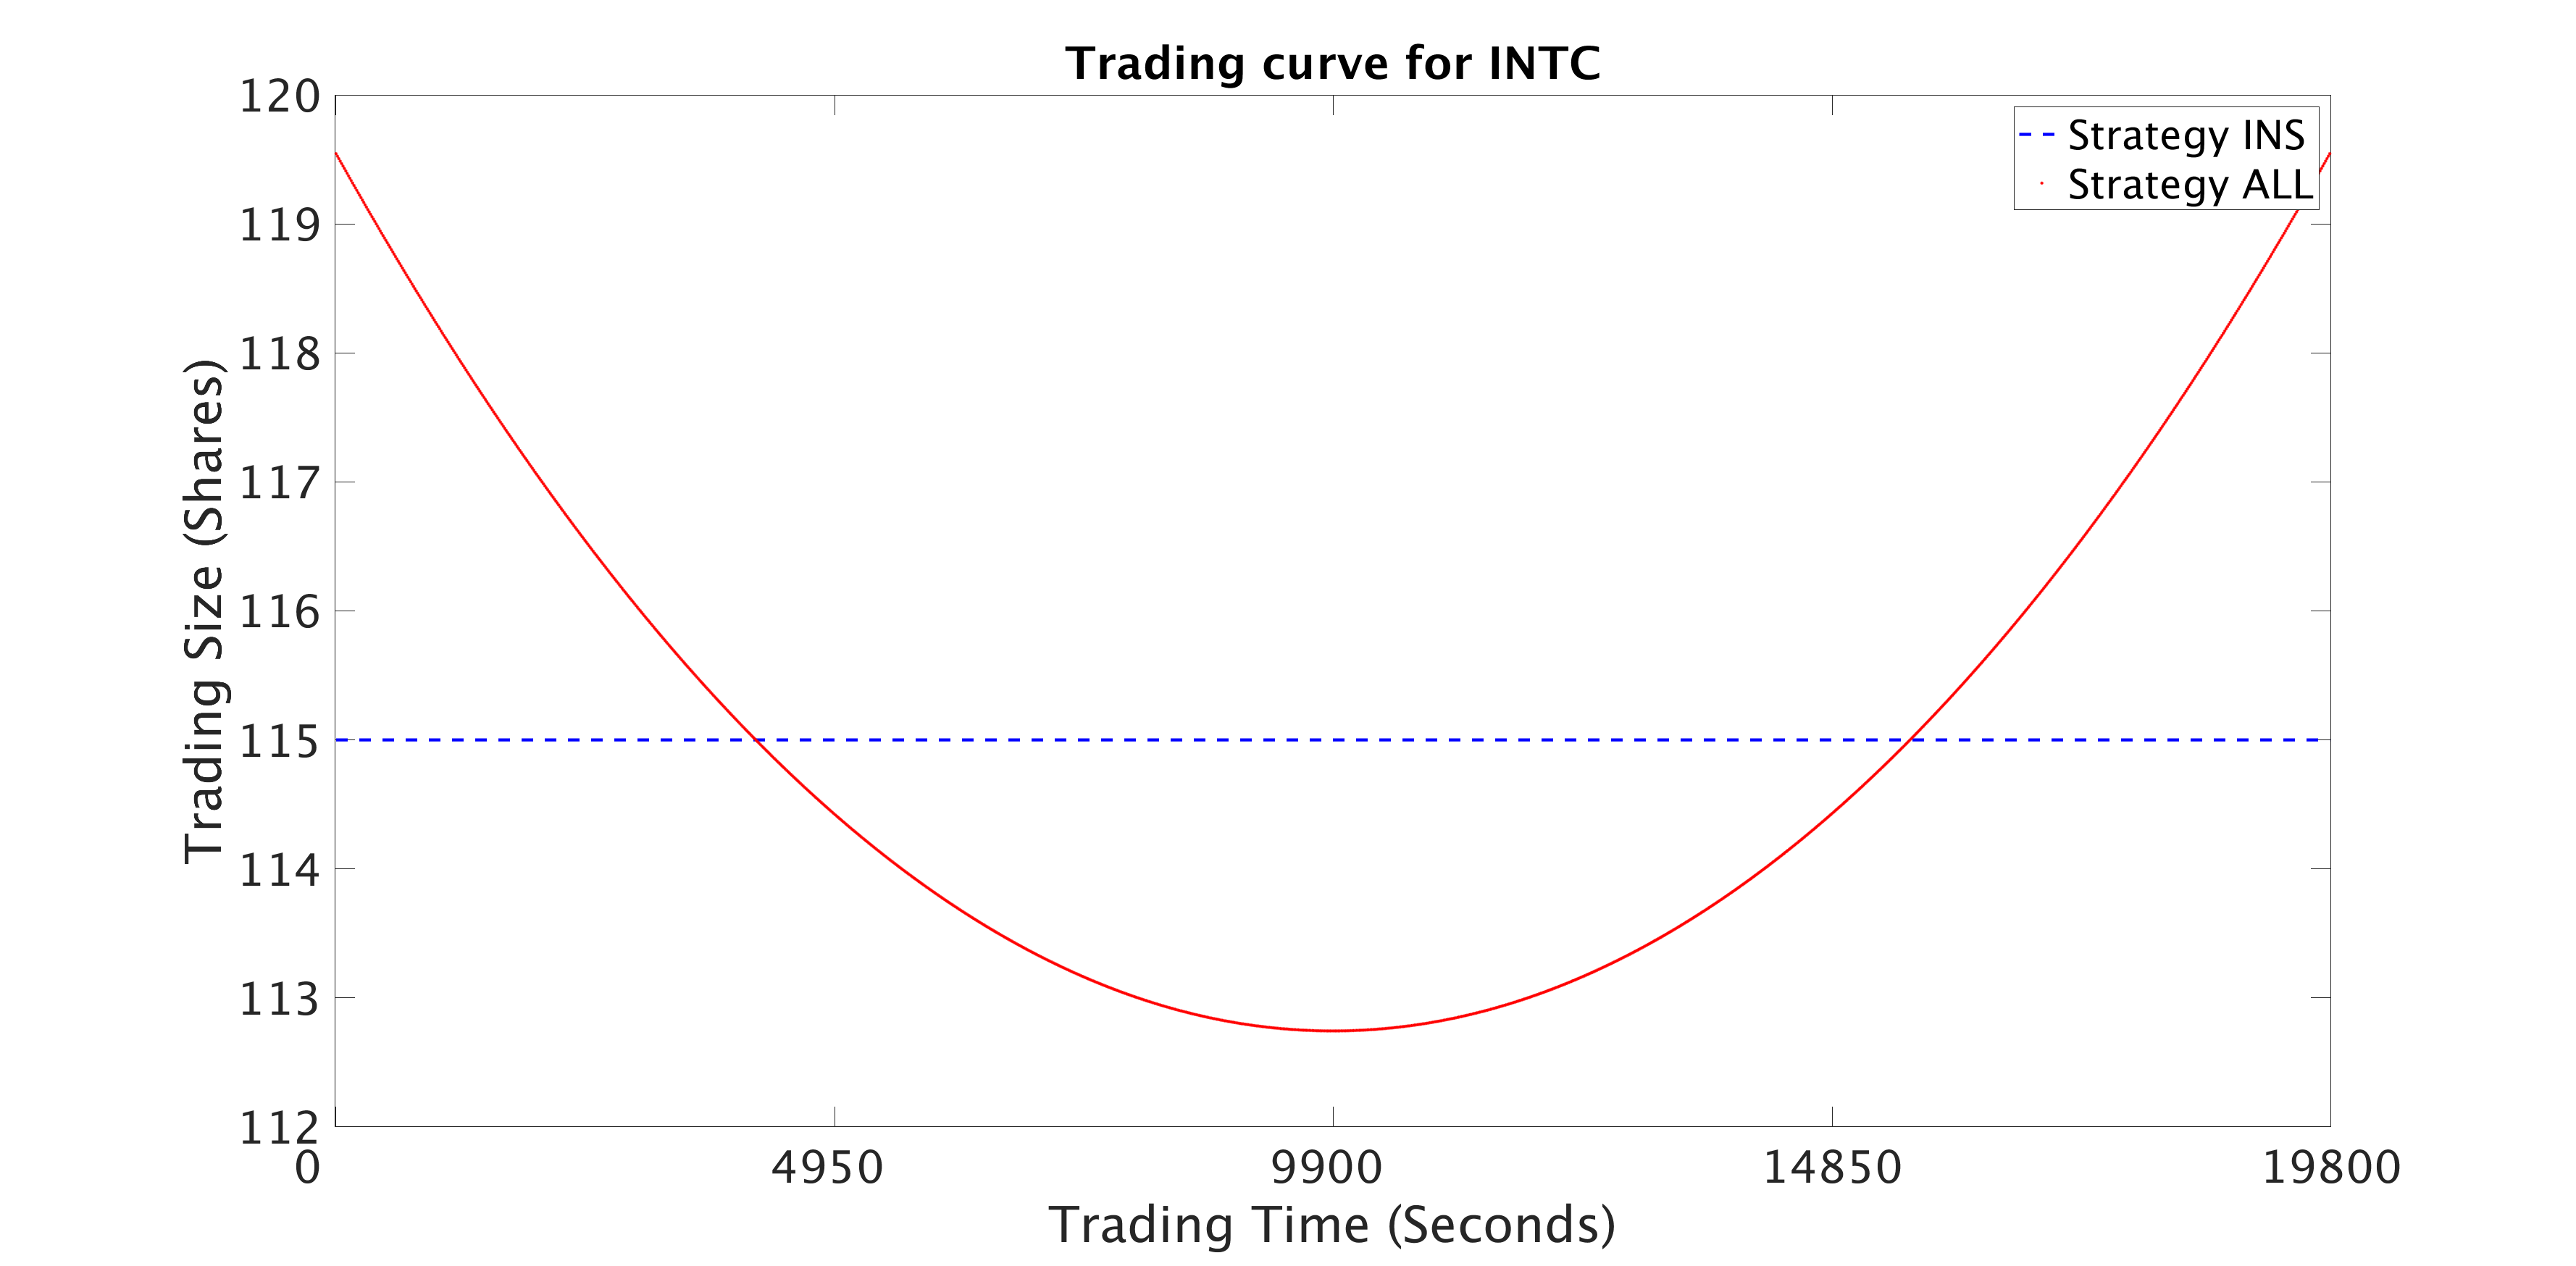
쉽게 말하면: "한 번에 다 팔지 말고 나눠서 팔아라"는 건 모두가 아는 상식입니다. 이 논문은 "정확히 얼마씩, 어떤 간격으로 나눠야 손실이 최소화되는지"를 수학적으로 계산해준 거예요. 그것도 세 가지 종류의 충격을 모두 고려해서요.
이 테마의 공통 인사이트
이 달의 실행 관련 논문들은 "전략의 성공은 알고리즘의 논리만으로 결정되지 않는다"는 점을 강조합니다. 시장 충격, 계산 지연, 주문장의 현실적 구조 — 이런 물리적 제약을 무시한 전략은 시뮬레이터에서는 멋져 보여도 실제에서는 실패할 수 있다는 거죠.
테마 3: 포트폴리오가 1000개면 리스크 계산을 어떻게?
문제의식
대형 기관의 포트폴리오에는 수천 개의 파생상품(옵션, 스왑 등)이 들어있습니다. 이 포트폴리오의 VaR(Value at Risk, "99% 확률로 이 이상은 잃지 않는다"는 금액)을 계산하려면, 수많은 시나리오를 시뮬레이션해야 하는데, 각 시나리오마다 1000개 파생상품의 손실을 계산해야 하니까 시간이 엄청나게 오래 걸립니다.
핵심 논문: 포트폴리오 규모와 무관한 리스크 계산
"Sub-sampling and other considerations for efficient risk estimation in large portfolios" (arXiv:1912.05484)
옥스포드 대학의 Michael Giles 교수팀이 이 문제를 풀었습니다. 핵심 아이디어는 두 가지:
-
멀티레벨 몬테카를로(MLMC): 정밀도가 낮은 빠른 시뮬레이션과 정밀도가 높은 느린 시뮬레이션을 적절히 섞어서, 전체 정밀도는 유지하면서 평균 계산 시간을 줄이는 기법입니다. 마치 그림을 그릴 때 먼저 굵은 붓으로 대략적인 형태를 잡고, 세밀한 부분만 가는 붓으로 그리는 것과 비슷합니다.
-
서브샘플링: 포트폴리오 전체를 계산하지 않고, 일부만 뽑아서 계산한 뒤 통계적으로 보정합니다.
이 두 기법을 결합했더니, 놀라운 결과가 나왔습니다: 계산 복잡도가 포트폴리오 규모에 따라 증가하지 않는다는 것입니다. 100개든 1000개든 10000개든 비슷한 시간이 걸린다는 뜻입니다.
이 논문은 Journal of Computational Finance에 정식 게재(2022년)되어 학술적 검증도 완료했습니다.
쉽게 말하면: "1000개 상품의 리스크를 계산할 때, 전체를 다 계산하지 않아도 된다"는 겁니다. 똑똑한 샘플링 기법으로 전체의 결과를 정확하게 추정할 수 있다는 거죠. 마치 여론조사에서 전체 국민을 다 조사하지 않아도 대략적인 결과를 알 수 있는 것과 같습니다.
테마 4: "빠른 게 항상 이기는 걸까?" — 계산 지연의 역설
문제의식
고빈도 트레이딩(HFT)에서 "1밀리초라도 빠른 쪽이 이긴다"는 건 상식처럼 받아들여집니다. 그런데 이 상식을 정면으로 반박하는 논문이 등장했습니다.
핵심 논문: 느려도 이길 수 있다
"Fools Rush In: Competitive Effects of Reaction Time in Automated Trading" (arXiv:1912.02775)
이 논문은 시뮬레이션 시장에서 여러 트레이딩 알고리즘의 실제 계산 시간을 측정하고, 그 시간 차이를 시장 경쟁에 반영했습니다.
놀라운 결과가 나왔습니다: 지금까지 "가장 지배적인 전략"으로 여겨지던 적응형 공격적(AA) 알고리즘이, 엄청나게 단순한 SHVR 전략(현재 최우선 호가에서 1틱 낮은 가격을 제시하는 것)에게 졌습니다. 이유는 간단합니다: AA는 더 똑똑하지만 계산 시간이 오래 걸리고, 그 사이에 SHVR가 먼저 주문을 넣어버리는 거죠.
쉽게 말하면: 택배 기사 두 명이 있다고 상상해보세요. 한 명은 빠른 오토바이를 타지만, 배송 전에 최적 경로를 30분 동안 계산합니다. 다른 한 명은 느린 자전거를 타지만 바로 출발합니다. 500미터 거리의 배송이라면, 자전거 기사가 먼저 도착할 수 있습니다. 트레이딩에서도 마찬가지로, "얼마나 빨리 계산하느냐"가 "얼마나 좋은 전략이냐"보다 중요할 수 있다는 거예요.
테마 5: 뉴스와 주가를 동시에 읽는 AI
문제의식
주식시장에서 뉴스는 중요합니다. 하지만 하루에 수천 건의 뉴스가 쏟아지는데, 어떤 뉴스가 어떤 종목과 관련 있는지 사람이 일일이 확인하기란 불가능합니다. 이걸 자동으로 해주는 AI가 있다면?
핵심 논문: The Squawk Bot
"The Squawk Bot: Joint Learning of Time Series and Text Data Modalities" (arXiv:1912.10858)
IBM 연구팀이 개발한 MSIN(Multi-Step Interrelation Network) 모델은 가격 시계열과 뉴스 텍스트를 동시에 학습합니다.
기존 모델들은 주로 "뉴스를 읽고 주가를 예측하는" 방향이었습니다. 반면 MSIN은 반대 방향으로 갑니다: "주가의 움직임을 보고, 이 움직임과 가장 관련 있는 뉴스를 찾아주는" 것입니다.
7년간의 Thomson Reuters 뉴스로 Apple과 Google 두 종목에 대해 실험한 결과, MSIN은 관련 뉴스를 84.9%(Apple), 87.2%(Google)의 확률로 정확히 찾아냈습니다. 기존 어텐션 기반 방법들을 크게 웃도는 수치입니다.
쉽게 말하면: "어제 애플 주가가 3% 떨어졌는데, 그 원인이 된 뉴스가 뭐야?"라는 질문에 AI가 수천 건의 뉴스 중에서 가장 관련 있는 기사를 골라주는 겁니다. 그것도 정확도 85% 이상으로요.
월 전체 Big Picture
2019년 12월의 논문들을 관통하는 하나의 메시지가 있습니다: "현실을 무시한 알고리즘은 실패한다."
LOB 시뮬레이터가 실제와 다르면(1912.04941), 그 시뮬레이터에서 학습한 AI 에이전트는 실제에서 실패합니다. 시장 충격을 무시하고 대량 주문을 내면(1912.06426), 전략의 수학적 최적성이 무의미해집니다. 계산 지연을 무시하면(1912.02775), 단순한 전략이 복잡한 전략을 이깁니다.
동시에, 현실의 복잡함을 정면으로 다루는 연구도 진전을 보였습니다. 수천 개 파생상품의 리스크를 실시간에 가깝게 계산하는 방법(1912.05484), 뉴스와 주가를 동시에 이해하는 멀티모달 AI(1912.10858) 같은 연구들은, 이론의 엄밀함과 실용성의 균형을 추구합니다.
이 달은 전통 수리금융의 깊이와 실용 AI의 넓이가 동시에 요구된 전환기적 한 달이었습니다.
더 알아보기
| 논문 | 등급 | 핵심 키워드 |
|---|---|---|
| Get Real: LOB 시뮬레이션 현실성 | A | 시뮬레이션 검증, stylized facts, ABIDES |
| 포트폴리오 청산 시장충격 | A | 최적 실행, Almgren-Chriss, NASDAQ |
| 대규모 리스크 추정 | A | MLMC, 서브샘플링, VaR |
| 거래비용 하 효용최대화 | A | 확장 약수렴, 이론적 수렴 |
| 자동매매 반응시간 | A | HFT, 계산 지연, SHVR vs AA |
| 선물 조건부 상관 | A | 동적 상관, PRA, 선물 |
| Squawk Bot 멀티모달 | A | 뉴스-주가 연관, MSIN |
ohselab — AI 기반 시스템 트레이딩 연구
ohselab.com | 구독하기 | 상담 문의
📚 이 글에서 다룬 논문 (7편)
- AGet Real: Realism Metrics for Robust Limit Order Book Market Simulations
Svitlana Vyetrenko, David Byrd, Nick Petosa 외 4명
- APortfolio liquidation under transient price impact -- theoretical solution and implementation with 100 NASDAQ stocks
Ying Chen, Ulrich Horst, Hoang Hai Tran
- BSub-sampling and other considerations for efficient risk estimation in large portfolios
Michael B. Giles, Abdul-Lateef Haji-Ali
- BExtended Weak Convergence and Utility Maximization with Proportional Transaction Costs
Erhan Bayraktar, Leonid Dolinskyi, Yan Dolinsky
- BFools Rush In: Competitive Effects of Reaction Time in Automated Trading
Henry Hanifan, John Cartlidge
- AConditional Correlations and Principal Regression Analysis for Futures
Armine Karami, Raphael Benichou, Michael Benzaquen 외 1명
- B"The Squawk Bot": Joint Learning of Time Series and Text Data Modalities for Automated Financial Information Filtering
Xuan-Hong Dang, Syed Yousaf Shah, Petros Zerfos
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2023-01 월간
로봇이 주식을 대신 팔아줄 수 있을까? — 2023년 1월 AI 금융 연구 리뷰
2023년 1월에 나온 AI 금융 연구를 살펴봅니다. 주식을 팔 때 발생하는 가격 충격을 로봇이 실시간으로 학습하고, 수천 개 종목을 그래프로 분석하며, 투자자 감정까지 읽는 최신 기술을 쉽게 풀어 설명합니다.
 📊 2026-05 월간
2026년 5월 AI 트레이딩 연구 한눈에 보기 — 성과를 어떻게 믿을 것인가?
2026년 5월 arXiv에 올라온 AI 트레이딩 연구 중 가장 주목할 만한 논문들을 테마별로 정리했습니다. 백테스트 신뢰성, LLM 에이전트 감사, 마켓메이킹 최적화, 포트폴리오 의사결정, 변동성 모형의 다섯 가지 연구 흐름을 살펴봅니다.
 📊 2025-10 월간
FR-LUX: Friction-Aware RL Portfolio Management
2025년 10월 arXiv에 올라온 AI 트레이딩 핵심 논문 5테마를 살펴봅니다. 헤지·포트폴리오·강화학습 실행·LLM 에이전트 검증·시장 미시구조까지, '백테스트 수익'을 '실전 수익'으로 바꾸기 위한 최신 연구 동향을 쉽게 풀어 설명합니다.