
매달 수백 편의 금융·AI 논문이 쏟아집니다. 그중 정말 중요한 것만 골라, 전공자가 아닌 분들도 이해할 수 있게 풀어드립니다.
들어가며: 같은 투자 전략을 따르는 사람들이 너무 많다면?
슈퍼마켓에 사람들이 몰리면 진열대가 비어버리죠. 주식시장에서도 비슷한 일이 일어납니다. 수많은 기관투자자들이 "모멘텀"이라는 같은 신호를 따라 같은 주식을 사기 시작하면, 그 주식 가격은 인위적으로 오르고, 나중에모두 함께 팔려고 하면 가격이 무너집니다. 이를 군집화(crowding)라고 부릅니다.
2020년 1월에 발표된 논문들은 바로 이 문제부터 시작합니다. 그리고 주문서의 수학적 구조, 포트폴리오의 숨겨진 패턴, 딥러닝으로 꼬리위험 예측하기, 변동성 모형의 오랜 난제 해결까지 — 놀랍도록 실용적인 연구들이 쏟아진 달이었습니다.
테마 1: "같은 신호를 따르는 사람이 너무 많다" — 팩터 군집화의 실체
문제가 뭐였을까?
투자자들은 보통 특정 "신호"를 따라 투자합니다. 예를 들어 "최근 3~12개월간 오른 주식은 앞으로도 오를 것이다"라는 모멘텀 전략, 또는 "저평가된 주식을 사라"라는 밸류 전략 등이죠. 문제는 이 신호를 따르는 사람이 너무 많아지면, 신호 자체가 무너질 수 있다는 겁니다.
마치 한 레스토랑이 맛있다는 소문이 퍼지면, 줄이 너무 길어져서 정작 맛있는 음식을 제때 못 먹게 되는 것과 같습니다. 투자에서도 "군집"이 발생하면 거래비용이 늘고, 수익률이 나빠지고, 심하면 시장 전체가 충격을 받을 수 있습니다.
뭐가 새로 나왔나?
Volpati 연구팀은 미국 주식시장의 기관투자자 메타오더(metaorder) — 기관이 하루에 걸쳐 분할 실행하는 대규모 주문 — 데이터를 분석해서, 같은 주식을 같은 방향으로 동시에 거래하는 투자자의 비율을 직접 측정하는 군집 지표를 만들었습니다.
놀라운 발견이 있었습니다. 모멘텀 포트폴리오의 리밸런싱이 전체 주문 흐름의 1~2%를 설명한다는 것입니다. 그게 별것 아닌 것 같다고요? 아닙니다. 시장에서 하루에 거래되는 주문의 1~2%가 단 하나의 전략에서 나온다는 것은 엄청난 비율입니다. 그리고 이 비율이 최근 수년간 계속 증가하고 있다는 사실이 더 중요합니다.
쉽게 말하면, 모멘텀 전략을 따르는 사람이 너무 많아져서, 이 전략 자체가 점점 위험해지고 있다는 뜻입니다.
그래서 투자/실무엔?
팩터 전략을 운용할 때 "지금 이 신호를 따르는 사람이 얼마나 될까?"를 반드시 고려해야 합니다. 모멘텀 전략의 경우, 리밸런싱 시점을 분산시키거나, 군집도가 낮은 시간대에 집행하는 것이 거래비용을 줄이는 방법입니다.
📌 논문: Zooming In on Equity Factor Crowding | 티어 A | Composite 71.2
테마 2: "주문서를 수학으로 읽는다" — 시장 미시구조의 새로운 모형
문제가 뭐였을까?
주식을 사거나 팔 때, 우리는 보통 "시장가 주문" 또는 "지정가 주문"을 냅니다. 이 주문들이 쌓여 있는 것이 호가 주문서(limit order book, LOB)입니다. 초단기 트레이딩에서는 이 주문서의 변화를 예측하는 것이 핵심인데, 기존 모형(Hawkes process 등)은 주문의 "방향"만 예측했지, 주문의 "공격성" — 즉, 현재 가격에서 얼마나 먼 가격에 주문을 냈는지 — 은 고려하지 못했습니다.
뭐가 새로 나왔나?
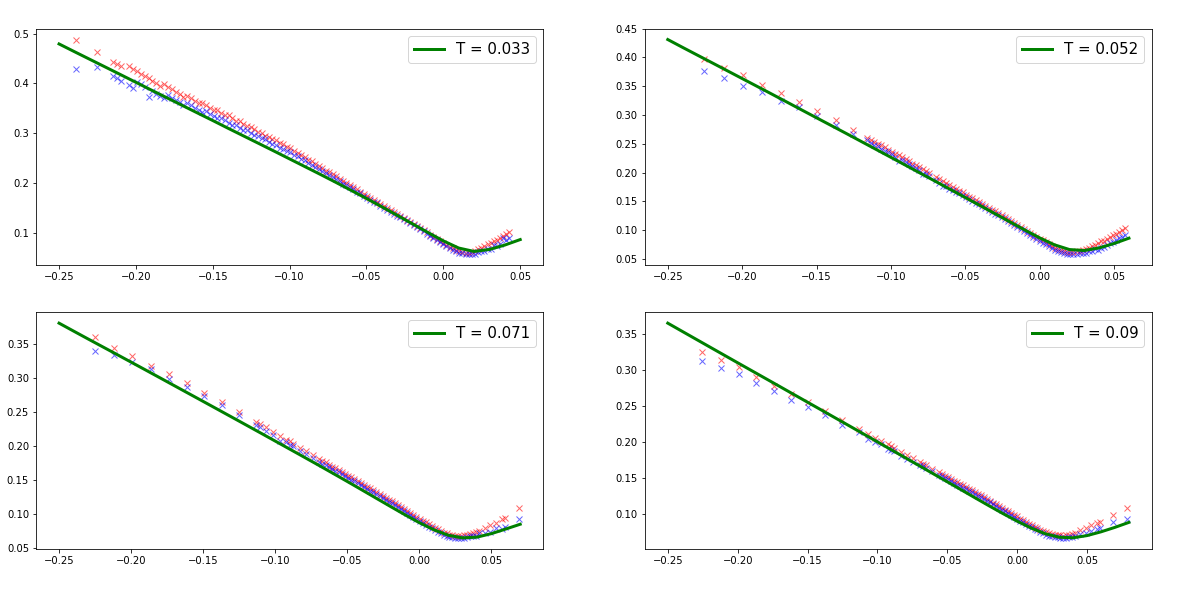
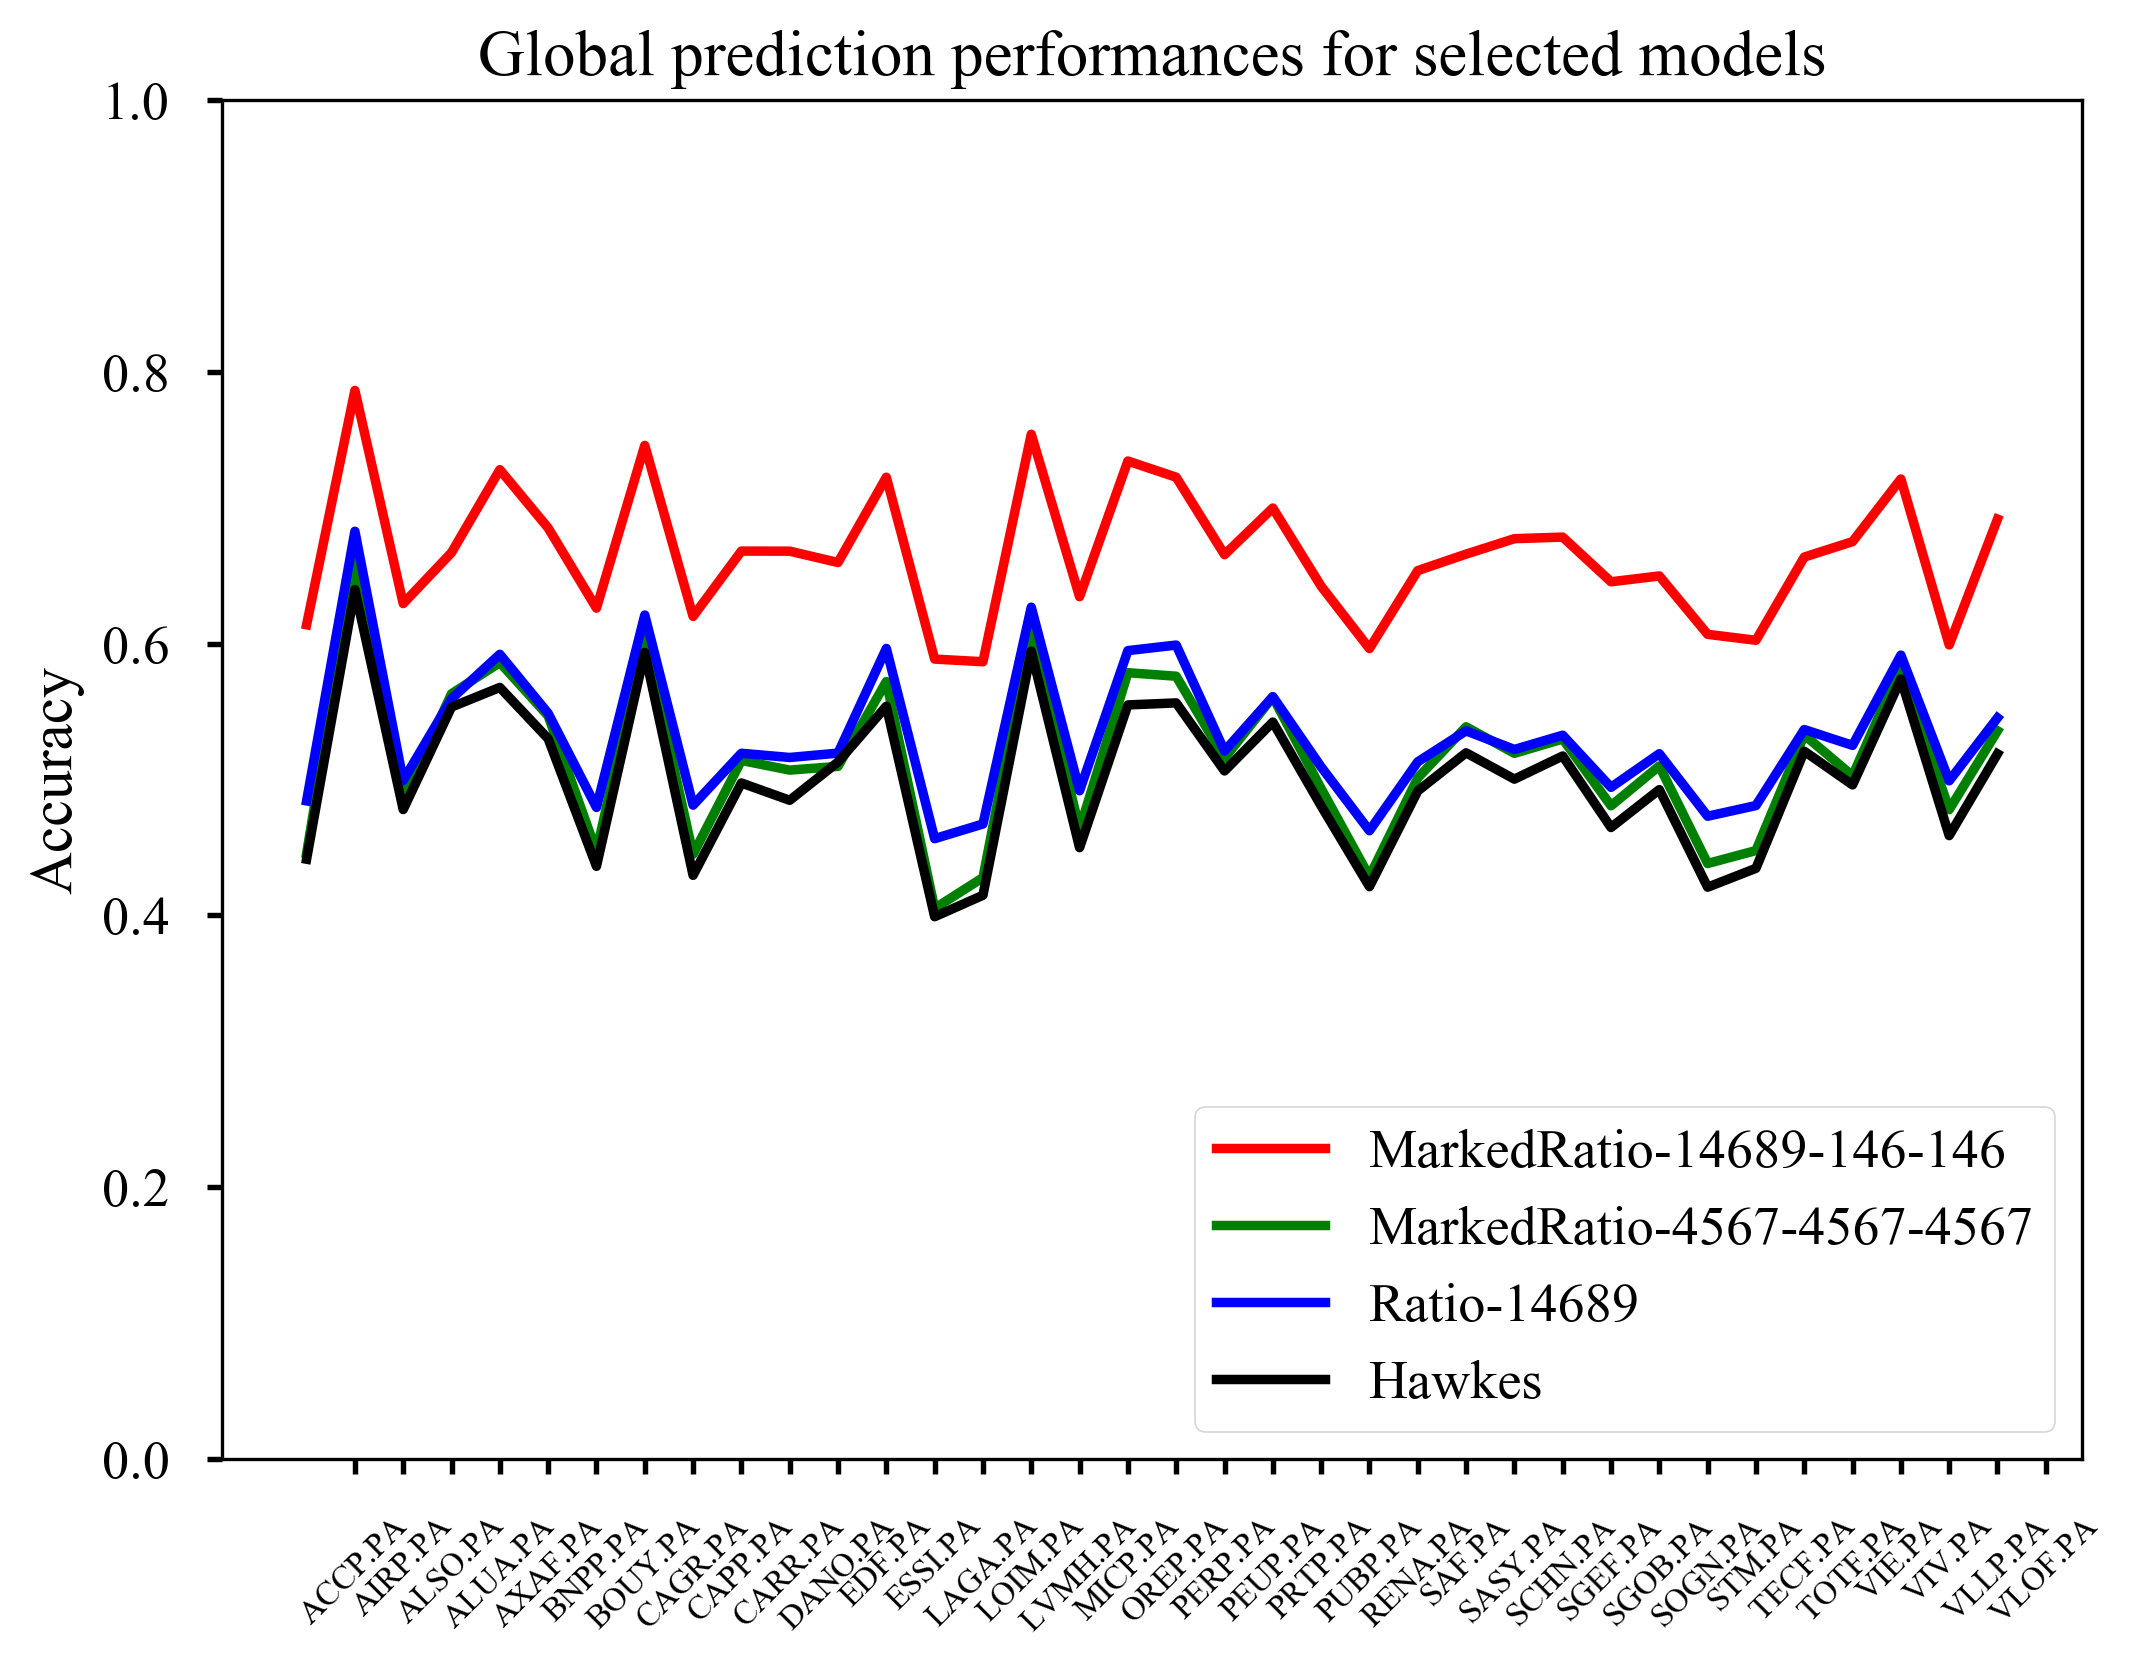
Muni Toke와 Yoshida는 주문서를 세 개의 곱셈적 성분으로 모델링하는 새로운 프레임워크를 제시했습니다:
- 공통 기저 강도: 시장 전체의 활동 수준 (모든 주식에 공통)
- 상태 의존 성분: 호가 불균형, 스프레드 등에 따라 달라지는 주문 방향 예측
- 마크별 성분: 주문의 공격성(시장가 vs. 지정가, 몇 틱 떨어진 가격)까지 예측
핵심은 이겁니다. 호가 불균형(imbalance)과 스프레드가 주문 방향과 공격성을 예측하는 데 모두 유의미한 신호라는 것을 처음으로 체계적으로 보여주었다는 것입니다.
그래서 투자/실무엔?
초단기 체결 방향 예측, 주문 독성(toxicity) 신호 생성, 실행 리스크 모델에 바로 적용할 수 있습니다. 특히 대규모 주문을 분할 실행할 때, "지금 시장이 나에게 불리한 방향으로 움직이고 있는가?"를 실시간으로 판단하는 데 유용합니다.
📌 논문: Marked Point Processes and Intensity Ratios for LOB Modeling | 티어 A | Composite 69.0
이 테마의 다른 논문들
- 상관 부호 예측: 고차원 상관행렬에서 두 주식 간 상관관계의 부호가 미래에 바뀔지를, 두 개가 아닌 세 개의 관계(삼자 관계)로 예측하는 방법이 제시되었습니다. (논문 보기)
- 시장충격 게임: 여러 기관이 동시에 유동성을 놓고 경쟁할 때의 최적 전략을 확률적 환경에서 분석했습니다. (논문 보기)
- 가격충격의 오목성: 개별 거래의 선형적 국소 가격충격만으로, 대규모 동일 방향 주문의 비선형적·오목한 시장충격을 설명하는 간단한 미시구조 모형이 제시되었습니다. (논문 보기)
테마 3: "상관관계의 잡음을 없앤다" — 포트폴리오 최적화의 핵심 입력 정제
문제가 뭐였을까?
포트폴리오를 만들려면 주식들 간의 상관관계(correlation)를 알아야 합니다. 예를 들어 삼성전자와 SK하이닉스가 얼마나 같이 움직이는지, 현대차와 네이버는 얼마나 다른 방향으로 움직이는지 등입니다. 문제는 이 상관관계를 과거 데이터에서 추정하면 잡음(noise)이 많이 끼어든다는 것입니다. 100개 주식의 상관행렬을 추정하려면 약 5,000개의 서로 다른 상관관계를 알아야 하는데, 관측 데이터가 충분하지 않으면 대부분의 상관관계가 사실은 "추측"에 가깝습니다.
뭐가 새로 나왔나?
Valeyre는 재무 특성(Book value, 시가총액 등)으로 제약한 PCA를 적용해 상관행렬의 잡음을 제거하는 새로운 방법을 제시했습니다. 핵심 발견은 네 가지입니다:
- 보편적 가중 법칙: 재무 기준으로 정의한 "Maximum Variance 포트폴리오"의 최적 가중치가 해당 기준의 랭킹에 비례한다는 보편적 법칙이 존재합니다.
- 두 개의 레짐: 고유값이 시간 스케일에 따라 증가하는 패턴이 두 가지 레짐을 보입니다.
- 변동성의 변동성: Maximum Variance 포트폴리오의 vol-of-vol만으로 상관행렬 확산의 상당 부분을 설명할 수 있습니다.
- 레버리지 효과의 한정성: 시장 하락 시 첫 번째 고유값이 커지는 레버리지 효과는 시장 모드(첫 번째 고유벡터)에서만 발생하며, 다른 리스크 팩터에는 일반화되지 않습니다.
그래서 투자/실무엔?
포트폴리오 최적화의 입력인 공분산 행렬을 더 안정적으로 추정할 수 있게 되었습니다. 특히 시장중립 전략에서 헤지 비중을 결정할 때, 잡음이 낀 상관행렬을 사용하면 의도치 않은 방향성 노출이 생길 수 있는데, 이 방법으로 그 위험을 줄일 수 있습니다.
📌 논문: Refined Model of the Covariance/Correlation Matrix | 티어 A | Composite 68.9
이 테마의 다른 논문들
- 순위 기반 원자재 포트폴리오: 가격이 낮은 원자재 선물에 더 많은 비중을 배분하는 단순한 전략이, 장기적으로 전통적인 동일가중·가격가중 포트폴리오를 능가한다는 이론과 실증이 제시되었습니다. (논문 보기)
- 거래비용을 반영한 최적화: 주문 규모에 따라 거래비용이 비선형적으로 증가하는 현실을 반영해, 포트폴리오 최적화를 QCQP(이차 제약 이차계획)으로 풀고 ADMM 알고리즘으로 효율적으로 해결하는 방법이 제시되었습니다. (논문 보기)
- 세미메트릭 포트폴리오: 자산 간 구조적 변동의 동시 발생을 새로운 수학적 양(세미메트릭)으로 측정해, 전통적 분산투자와 다른 위험감축 기준을 제시합니다. (논문 보기)
테마 4: "꼬리위험을 딥러닝으로 예측한다" — VaR·ES의 새로운 접근
문제가 뭐였을까?
투자에서 가장 무서운 것은 "설마 했던 일이 벌어지는 것"입니다. 2008년 금융위기, 2020년 코로나 폭락처럼 말이죠. 이런 극단적 손실을 측정하는 대표적인 지표가 VaR(Value at Risk)와 ES(Expected Shortfall)입니다. VaR는 "99% 확률로 이 이상은 잃지 않는다"는 값이고, ES는 그 1% 안에 들어갔을 때의 평균 손실입니다.
문제는 이 두 지표를 정확하게 예측하기가 매우 어렵다는 것입니다. 기존 모형들은 선형 관계만 포착했지만, 실제 시장은 비선형적이고, 과거 패턴이 미래에 반복된다는 보장이 없습니다.
뭐가 새로 나왔나?
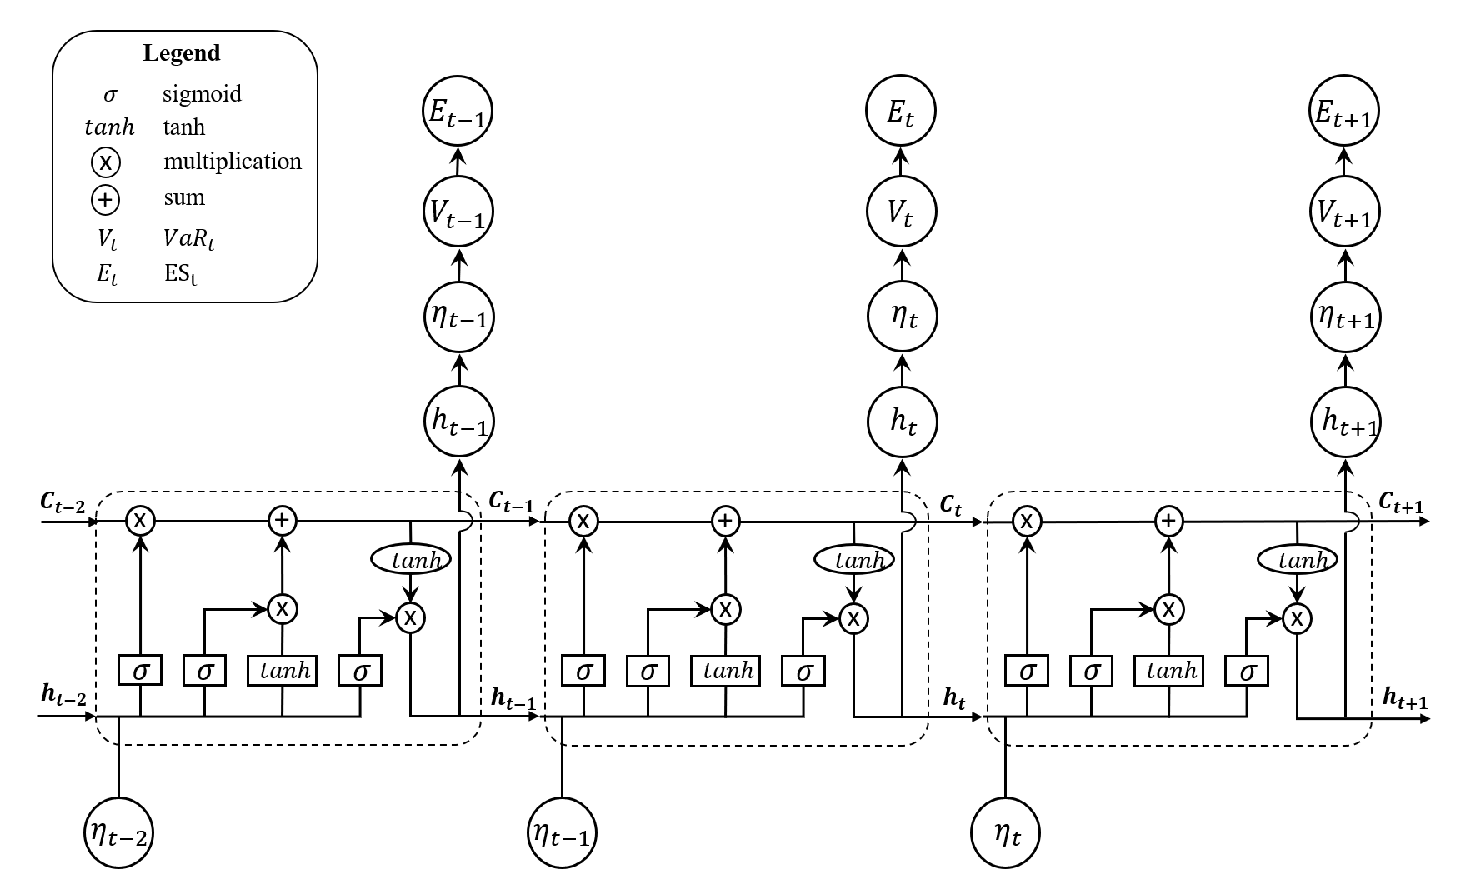
Li 연구팀은 LSTM(Long Short-Term Memory) — 시계열의 패턴을 기억하는 딥러닝 모델 — 과 비대칭 라플라스 우도(Asymmetric Laplace likelihood)를 결합한 하이브리드 모델 LSTM-AL을 제시했습니다.
쉽게 말하면, LSTM이 시장 데이터의 복잡한 패턴을 학습하고, 비대칭 라플라스 분포가 VaR와 ES를 동시에 추정하는 프레임워크를 제공합니다. 여기에 베이지안 추론을 적용해 "이 예측이 얼마나 불확실한지도" 알려줍니다.
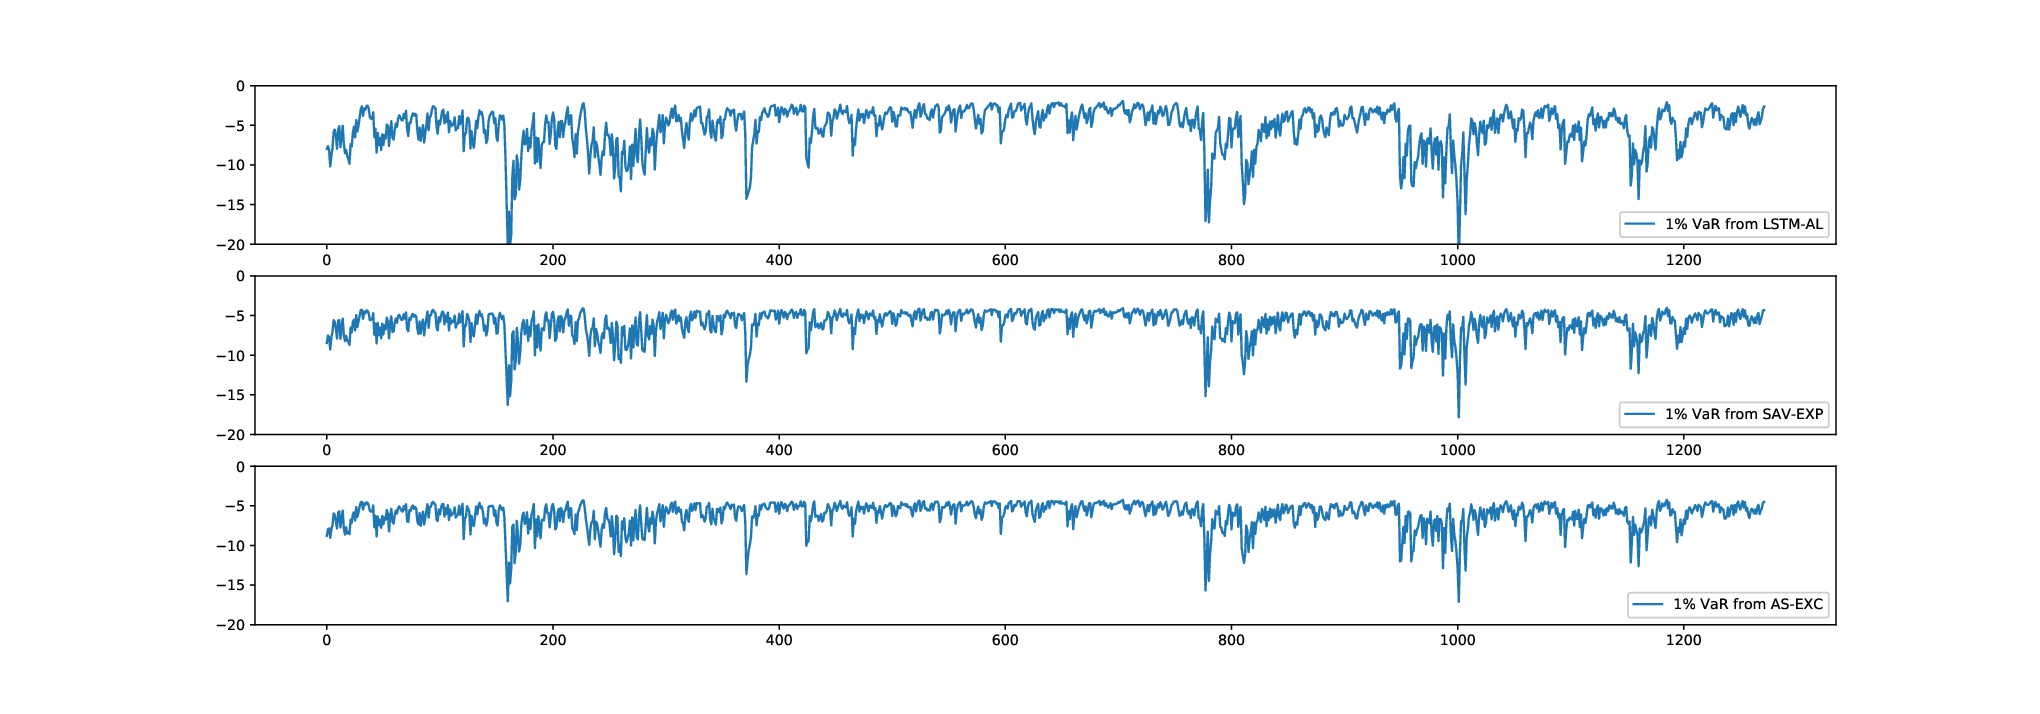
실증 결과, S&P500, ASX200, FTSE100, AUDUSD 등 다양한 자산군에서 기존 확립된 모형들보다 VaR·ES 예측 정확도가 개선되었습니다.
한계와 주의점
학습 비용이 높고, 실시간 리스크 관리에 적용하려면 모델 재학습 주기 문제를 해결해야 합니다. 또한 시장 국면이 급변할 때(예: 코로나 폭락) 과거 학습 데이터가 무용지물이 될 수 있다는 점을 명심해야 합니다.
그래서 투자/실무엔?
포트폴리오의 일별 손실 한도를 설정하거나, 스트레스 국면에서 익스포저를 축소하는 판단을 할 때 LSTM-AL 모델의 예측을 리스크 엔진으로 활용할 수 있습니다. 특히 베이지안 추론이 제공하는 불확실성 구간이 강점입니다. "VaR가 2%라고 예측했는데, 그 예측의 신뢰구간이 1.5%~3%라면?" — 이런 정보가 의사결정에 매우 중요합니다.
📌 논문: Bayesian LSTM for VaR and ES Joint Forecasting | 티어 A | Composite 67.2
테마 5: "SPX와 VIX를 동시에 맞출 수 있을까?" — 변동성 모형의 돌파구
문제가 뭐였을까?
옵션 시장에서는 S&P500 지수 옵션(SPX)과 VIX 지수 옵션을 동시에 봅니다. 그런데 이 두 가지를 하나의 모형으로 동시에 캘리브레이션하는 것은 변동성 모델링 분야의 오랜 난제였습니다. Julien Guyon이라는 유명 수학자는 "연속적인 경로를 가진 모형으로는 이 두 가지를 동시에 맞추기 불가능할 것"이라는 추측을 제기했죠.
쉽게 비유하면, 하나의 레시피로 케이크와 쿠키를 동시에 완벽하게 굽기 어렵다는 것과 비슷합니다. 케이크에 맞추면 쿠키가 타고, 쿠키에 맞추면 케이크가 덜 익죠.
뭐가 새로 나왔나?
Gatheral, Jusselin, Rosenbaum 세 연구자가 Quadratic Rough Heston 모형을 제시하며 이 추측의 반례를 제시했습니다.
핵심 아이디어는 두 가지를 결합한 것입니다:
- 러프 변동성(rough volatility): 변동성이 부드럽게 움직이는 것이 아니라, 거칠고(fractal-like) 불규칙하게 움직인다는 관찰
- Zumbach 효과(가격 피드백): 과거 수익률이 미래 변동성에 영향을 미치는 비대칭적 피드백
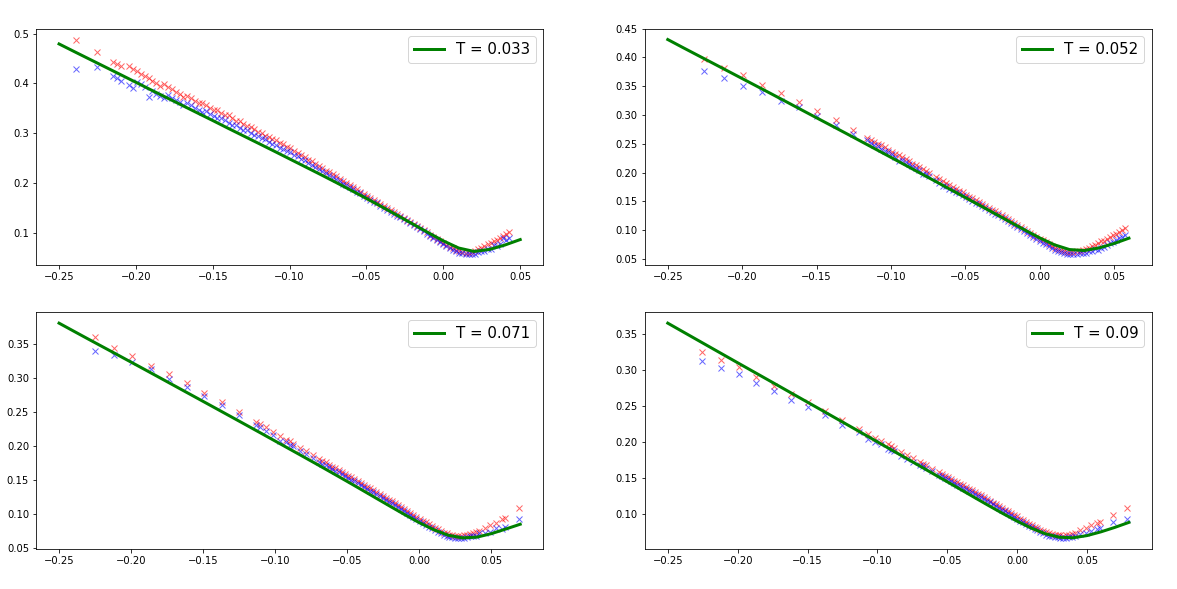
이 두 효과를 결합하니, 연속 경로 모형임에도 SPX와 VIX 옵션 스마일을 동시에 캘리브레이션하는 데 성공했습니다. 변동성 모델링 분야에서 오래된 난제가 풀린 순간입니다.
한계와 주의점
모형이 복잡해서 캘리브레이션 비용이 높고, 실전 헤지에서의 수치 안정성과 거래비용은 아직 검증되지 않았습니다. 또한 rough volatility 자체가 상대적으로 새로운 패러다임이어서, 장기적으로 시장이 이를 "가격에 반영"하기 시작하면 모형의 유효성이 변할 수 있습니다.
그래서 투자/실무엔?
지수·VIX 옵션 상대가치 전략, 변동성 곡면 보정, 파생상품 헤지 엔진의 구조 모형으로 활용 가능합니다. 특히 VIX 옵션의 적정 가격을 SPX 옵션 데이터로 추정할 수 있게 되었다는 점이 실용적 가치가 큽니다.
📌 논문: Quadratic Rough Heston Model and Joint SPX/VIX Smile Calibration | 티어 A | Composite 66.8
이 테마의 다른 논문들
- 변동성 스왑 가격결정: 숙성(이미 발행된) 변동성 스왑의 비모수 가격결정과 분산스왑 기반 헤지 공식이 제시되었습니다. (논문 보기)
- 정상상태 Heston: 기존 Heston 모형의 초기조건을 불변분포로 대체해 단기 변동성 스마일을 개선하고, 이국옵션 가격에 재귀 양자화 방법을 적용했습니다. (논문 보기)
- SABR 이산화 분석: 실무에서 널리 쓰이는 로그정규 SABR 모형의 시간 이산화 오차와 내재변동성 표면의 점근 거동을 분석했습니다. (논문 보기)
🌍 월 전체 Big Picture: 전통 수리금융과 딥러닝의 교차점
2020년 1월은 전통 수리금융의 이론적 깊이와 딥러닝의 실용적 침투가 공존하는 전환기적 달이었습니다.
팩터 군집화 연구에서는 기관투자자 메타오더 데이터로 모멘텀 전략의 위험을 직접 정량화하는 실용적 성과가 나왔고, 미시구조에서는 marked point process 기반 LOB 모델링이 기존 Hawkes 모델을 넘어서는 예측력을 보여주었습니다. 포트폴리오 영역에서는 제약 PCA 기반 상관행렬 정제와 거래비용을 반영한 최적화가 실무적 개선을 이끌었고, 리스크 측정에서는 LSTM과 베이지안 추론의 결합이 VaR·ES 예측의 새로운 기준을 제시했습니다. 변동성 모델링에서는 rough Heston 모형이 SPX·VIX 동시 보정이라는 오랜 난제를 해결하며 rough volatility 패러다임의 실용적 가능성을 입증했습니다.
아직 LLM의 시대는 시작되지 않았지만, attention 메커니즘의 금융 적용이라는 씨앗이 이 시기에 뿌려지고 있었습니다. 2020년 1월은 금융 AI가 "이론의 시대"에서 "실용의 시대"로 넘어가는 문턱이었습니다.
함께하기
이 글이 유익하셨나요? 저희는 금융 AI 연구를 지속적으로 모니터링하고 분석합니다.
- 🌐 웹사이트: ohselab.com
- 📬 뉴스레터 구독: 최신 금융 AI 연구 동향을 받아보세요
- 💬 상담 문의: 투자 전략 및 리서치 협업
더 알아보기
이 달의 S/A 논문 전체 목록
| # | 논문 | 제목 | 도메인 | 티어 | Composite |
|---|---|---|---|---|---|
| 1 | 2001.04185 | Zooming In on Equity Factor Crowding | 팩터 투자 | A | 71.2 |
| 2 | 2001.08442 | Marked Point Processes for LOB | 시장 미시구조 | A | 69.0 |
| 3 | 2001.08911 | Refined Covariance Matrix Model | 포트폴리오 | A | 68.9 |
| 4 | 2001.08374 | Bayesian LSTM for VaR/ES | 리스크 | A | 67.2 |
| 5 | 2001.01789 | Quadratic Rough Heston | 변동성 | A | 66.8 |
| 6 | 2001.09466 | Stock Prediction to News Relevance | NLP | A | 66.4 |
| 7 | 2001.06914 | Permutation-Weighted Portfolios | 포트폴리오 | A | 66.0 |
| 8 | 2001.01612 | Quadratic Transaction Costs | 포트폴리오 | A | 65.5 |
2020년 1월 arXiv에 공개된 금융·AI 논문 중 KB 평가 상위 논문을 기반으로 작성되었습니다. (재생성: 2026-09-29, mimo-v2.5-pro)
📚 이 글에서 다룬 논문 (15편)
- BZooming In on Equity Factor Crowding
Valerio Volpati, Michael Benzaquen, Zoltan Eisler 외 3명
- BMarked point processes and intensity ratios for limit order book modeling
Ioane Muni Toke, Nakahiro Yoshida
- BA Bayesian Long Short-Term Memory Model for Value at Risk and Expected Shortfall Joint Forecasting
Zhengkun Li, Minh-Ngoc Tran, Chao Wang 외 2명
- AThe quadratic rough Heston model and the joint S&P 500/VIX smile calibration problem
Jim Gatheral, Paul Jusselin, Mathieu Rosenbaum
- BNonparametric sign prediction of high-dimensional correlation matrix coefficients
Christian Bongiorno, Damien Challet
- An FBSDE approach to market impact games with stochastic parameters
Samuel Drapeau, Peng Luo, Alexander Schied 외 1명
- BPermutation-Weighted Portfolios and the Efficiency of Commodity Futures Markets
Ricardo T. Fernholz, Robert Fernholz
- BA Note on Portfolio Optimization with Quadratic Transaction Costs
Pierre Chen, Edmond Lezmi, Thierry Roncalli 외 1명
- BSemi-metric portfolio optimization: a new algorithm reducing simultaneous asset shocks
Nick James, Max Menzies, Jennifer Chan
- BStationary Heston model: Calibration and Pricing of exotics using Product Recursive Quantization
Vincent Lemaire, Thibaut Montes, Gilles Pagès
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2026-04 월간
AI가 진짜 돈을 움직이기 시작했다 — 2026년 4월 금융 AI 연구 하이라이트
2026년 4월 금융 AI 연구 동향. LLM 에이전트가 실제 자본으로 온체인 거래를 시작하고, 백테스트의 허상이 대규모 실증으로 검증된 달의 핵심 논문들을 살펴봅니다.
 📊 2026-03 월간
AI가 주식을 예측할 수 있을까? — 2026년 3월 금융 AI 연구 리뷰
2026년 3월 금융 AI 논문 734편을 분석한 월간 종합. LLM의 시간 편향 문제, 백테스트 엔진의 숨겨진 오차, 포트폴리오 최적화의 새로운 수학, LOB 시뮬레이션의 현실화, 강화학습 트레이딩 시스템의 실전 전환까지 — 신뢰할 수 있는 금융 AI를 만드는 5가지 연구 테마를 살펴봅니다.
 📊 2026-01 월간
AI가 포트폴리오를 짜고, 뉴스를 조작하고, 블록체인에서 대량 매도한다 — 2026년 1월 금융 AI 연구 하이라이트
2026년 1월 arXiv에 올라온 금융 AI 연구를 5개 테마로 정리했습니다. 파라미터 불확실성을 포트폴리오에 반영하는 방법, LLM 에이전트의 결정 재현성 문제, DEX에서의 대량 매도 최적화, 연합학습으로 신용리스크를 예측하는 방법, 그리고 주문흐름과 변동성을 하나로 묶는 미시구조 이론까지.