
Deep Empirical Risk Minimization in finance: looking into the future
A. Max Reppen, H. Mete Soner
훈련 데이터 안에서는 완벽한 전략이, 실제 시장에서는 형편없는 전략이 되는 진짜 이유 — 2020년, 두 수학자가 그 메커니즘을 증명했습니다.
들어가며: 시험 문제를 외운 학생의 비밀
어떤 학생이 지난 10년치 기출문제를 완벽히 외워서 모의고사에서 100점을 맞았다고 해봅시다. 부모님은 기뻐하겠지만, 우리는 직감적으로 압니다. "저 학생, 진짜 시험에서는 다를 거야." 외운 것과 아는 것은 다르니까요.
투자 AI도 마찬가지입니다. 과거 데이터로 학습한 매매 전략이 백테스트(과거 시뮬레이션)에서는 연 수십 %의 성과를 내는데, 실제 돈을 넣으면 그 성과가 쑥 빠지는 현상 — 퀀트 업계에서 가장 흔하고 가장 아픈 경험이죠. 흔히 "과적합(overfitting)" 탓으로 돌립니다. 그런데 2020년 11월에 발표된 한 논문은 이 문제를 더 정확하게 짚었습니다. 딥러닝 투자 모델은 단순히 데이터를 외우는 것을 넘어, 훈련 데이터 안에서 '미래를 훔쳐보는' 전략이 된다는 것입니다.
이 글은 S등급(최고 등급)으로 평가된 논문 "Deep Empirical Risk Minimization in finance: looking into the future"(Reppen & Soner, arXiv:2011.09349)를 처음부터 끝까지 쉽게 풀어쓴 단독 리뷰입니다.
무엇이 문제였나: 잘 쓰이지만 검증이 애매했던 방법
요즘 헤징(위험 대비)이나 포트폴리오 운용에서 인공지능을 쓰는 표준적인 방법이 하나 있습니다. 바로 '경험적 위험 최소화(Empirical Risk Minimization, ERM)'인데, 이름은 어렵지만 원리는 간단합니다.
- 과거 데이터나 시뮬레이션 데이터를 잔뜩 모은다.
- "이 데이터에서 이 전략을 썼다면 손실이 얼마였을까?"를 계산해 평균을 낸다.
- 이 평균 손실이 가장 작아지도록 신경망을 학습시킨다.
- 학습된 신경망이 '최적의 매매 결정'이 된다.
유연하고 만들기 쉬워서 딥 헤징, 옵션 헤징, 투자 비중 결정 등 최근의 딥러닝 금융 연구 대부분이 이 프레임워크입니다. 문제는 "이 방법이 새 데이터에 대해서도 잘 작동할까?" — 즉 일반화 성능 — 가 이론으로 정리되어 있지 않았다는 점입니다. 실무자들은 경험칙으로 "데이터를 많이 모아라", "모델을 너무 크게 만들지 마라"라고만 알고 있었습니다.
핵심 아이디어: 과적합의 정체는 '미래 정보 누설'
1단계 — 문제를 다시 쓰면 통계학이 온다
논문의 첫 번째 묘안은 관점을 바꾸는 것입니다. 전략의 손실을 "무작위성(시장의 운)에 대한 함수"로 쓰면, 학습에 쓰는 손실 함수가 그 함수의 '경험 평균'이 됩니다. 이렇게 쓰는 순간, 통계적 기계학습이 100년 동안 쌓아온 수학 — 일반화 상한, Rademacher 복잡도 같은 도구들 — 을 그대로 가져다 쓸 수 있게 됩니다.
2단계 — 과적합은 '미래를 내다보기'다 (Theorem 7.1)
핵심 증명입니다. 훈련 데이터 위에서 손실을 최소화하는 신경망은, 사실 "미래의 무작위성까지 포함한 전체 가격 경로"에 의존하는 계수로 최솟값을 달성합니다. 쉽게 말하면, 학습된 전략은 훈련 데이터 안에서만 "미래를 알기 때문에" 이상적으로 좋은 결정을 내리는 겁니다.
금융에서 가장 중요한 규칙 하나를 떠올려 보세요. "오늘의 결정은 오늘까지의 정보만으로." 미래를 알 수 없는 것이 현실의 전제죠. 그런데 훈련 데이터 안에서 학습된 모델은 이 규칙을 어기게 됩니다. 수학자들은 이런 전략을 "anticipative(예지하는)"라고 부릅니다. 시험 문제를 미리 들여다본 학생이 100점을 맞는 것과 같은 이치입니다.
3단계 — 언제 안전한가: 데이터 크기 vs 모델 복잡도 (Theorem 8.5)
그러면 무조건 작은 모델만 써야 할까요? 아닙니다. 논문은 Rademacher 복잡도로 측정한 "모델이 얼마나 복잡한가" 대비 "데이터가 얼마나 많은가"의 균형으로 이 문제를 정리합니다. 학습 데이터가 모델 복잡도에 비해 충분히 크면 과학습(overlearning)은 무시할 수 있는 수준으로 줄어듭니다. 반대로 가설 공간(모델의 표현력)이 크면 과학습이 일어남이 증명됩니다(Theorem 7.4). 그리고 문제의 차원 — 자산 수, 상태 변수 수 — 이 높을수록 과학습은 쉬워지고, 필요한 데이터는 더 많아집니다.
결과: 차원이 10배 커지면 과학습은 16배 커진다
저자들은 의도적으로 아주 단순한 예제를 골랐습니다. "진짜 답을 아는 문제"에서만, 학습된 전략이 얼마나 미래를 훔쳐보는지 정확히 재울 수 있으니까요. 2단계 투자 결정 문제(최적의 정답: 항상 같은 비중 a*=0.9297)에서, 학습 데이터 10만 개, 은닉층 3층·뉴런 10개의 신경망으로 차원별 30회씩 실험했습니다.
| 문제 차원 (d) | 훈련 데이터 안 성과 (평균) | 안과 밖의 격차 (평균) |
|---|---|---|
| 10 | 0.54% | 1.46% |
| 25 | 2.12% | 4.59% |
| 40 | 3.75% | 7.91% |
| 55 | 5.06% | 10.94% |
| 70 | 7.33% | 15.62% |
| 85 | 8.38% | 20.16% |
| 100 | 10.13% | 23.67% |
해석해 보죠. 차원이 10일 때는 훈련 안에서 0.54%의 과대 성과에 그칩니다. 그런데 차원이 100이 되면 훈련 데이터 안에서만 10.13%가 부풀려지고, 실제 밖에서는 그 격차가 23.67%포인트까지 벌어집니다. 자산 수와 상태 변수를 늘려가며 모델을 키우는 순간, "좋은 성과"의 상당 부분이 사실 미래를 몰래 참고한 것이라는 뜻입니다.
흥미로운 점은 저자들의 태도입니다. "과적합을 막을 수 없다"고 선언하지 않습니다. 오히려 "상식적인 학습 설정 — 잘 만든 신경망, 조기 종료(early stopping), 표준 하이퍼파라미터 — 에서도 과학습이 발생하니 반드시 검증하라"고 말합니다. 그리고 실용적인 출구를 제시합니다. 모형이 주어지면 학습 중에 시뮬레이션 데이터를 계속 만들어내 규모를 키우고, 모형이 없으면 시장 데이터에 캘리브레이션된 시뮬레이션을 설계하라는 것입니다. 재현성도 훌륭합니다 — 코드, 로그, 난수 시드까지 공개되어 있습니다(https://gitlab.com/mreppen/dderm).
한계와 주의점
정직하게 짚어야 할 부분입니다.
- 실험이 단순한 stylized 예제 기반입니다. 진짜 답을 알 수 있는 문제라서 과학습을 정확히 재는 데는 최적이지만, 실제 시장 문제에서의 크기를 그대로 말해주지는 않습니다. 저자들도 "특정 튜닝으로 개선될 수 있다"고 인정합니다.
- Rademacher 복잡도 상한이 얼마나 타이트한지는 검증되지 않았습니다. "데이터가 충분하면 안전"이라는 이론이 실제 과학습을 얼마나 빡빡하게 잡는지는 열린 문제입니다.
- 시뮬레이션 데이터를 어떻게 만들지는 논문 밖의 문제입니다. 논문은 "캘리브레이션이 중요하다"고 강조하지만, 좋은 합성 데이터 생성법 자체를 제공하지는 않습니다.
- 2020년 11월 초판 이후 2022년까지 개정(v3)이 이어진, 잘 다듬어진 작업이지만 여전히 이론+stylized 실험 단계의 연구입니다.
그래서 투자/실무엔?
이 논문이 우리에게 주는 교훈은 냉정하면서도 실용적입니다.
- 백테스트 성과를 그대로 믿지 마세요. 특히 자산 수·상태 변수가 많은 전략일수록 훈련 데이터 안 성과의 '부풀림'이 크다는 것이 이론으로 확인됐습니다.
- 모델을 키우면 데이터도 그만큼 키워야 합니다. "복잡한 모델 → 더 많은 (검증된) 학습 데이터"가 수학적으로 요구되는 균형입니다.
- 조기 종료만으로 안심하지 마세요. 잘 만든 학습 파이프라인에서도 과학습은 발생합니다. 외부 데이터 검증(out-of-sample), 그리고 가능하면 시장 데이터에 캘리브레이션된 시뮬레이션 기반 검증을 병행해야 합니다.
- 차원이 큰 문제일수록 경계를 높여야 합니다. 멀티 자산, 고빈도 상태 변수를 쓰는 전략이라면 이 논문의 경고가 직접 적용됩니다.
한마디로, "시험 문제를 외운 학생"에게 100점이 아니라 "새 문제로 다시 시험을 봐야" 한다는 것을 수학으로 증명해 준 논문입니다.
더 알아보기
- 원문: arXiv:2011.09349 — Deep Empirical Risk Minimization in finance: looking into the future (A. Max Reppen, H. Mete Soner, 2020)
- OHSE AI Lab 5차원 점수: 새로움 76 · 적용성 72 · 엄밀성 86 · 재현성 82 · 통찰 84 (복합점수 80.0, S등급) — 엄밀성과 재현성이 특히 높습니다. 코드·로그·난수 시드 공개가 재현성 점수를 끌어올렸습니다.
- 함께 읽으면 좋은 논문 (KB 엔티티 기준 연관 논문):
- Towards Generalizable Reinforcement Learning for Trade Execution (arXiv:2307.11685) — 최적 실행 강화학습의 일반화 문제를 정면으로 다룹니다.
- On Parametric Optimal Execution and Machine Learning Surrogates (arXiv:2204.08581) — ML 대리 모형의 정확성과 대체 가능성 검증.
- Deep Hedging: Learning Risk-Neutral Implied Volatility Dynamics (arXiv:2103.11948) — 딥 헤징에서의 변동성 동역학 학습.
- Robust pricing and hedging via neural SDEs (arXiv:2007.04154) — 신경 확률미분방정식 기반 강건한 가격결정.
2020년 이 논문 이후에도 딥 헤징·최적 실행 문헌은 일반화와 강건성 문제를 계속 다루고 있습니다. "더 큰 모델" 경쟁이 아니라 "더 정직한 검증"으로 연구의 무게중심이 옮겨간 흐름 — 이 논문이 그 출발점 중 하나입니다.
관련 글
 포트폴리오 최적화S
2021년 세금·주식 수량까지 반영한 포트폴리오 최적화: 수백 밀리초에 풀고 '좋은 답인지'까지 증명하는 법
이론의 포트폴리오 최적화는 매끈한데, 현실은 세금·정수 주식·최소 거래 단위로 뒤범벅입니다. 스탠퍼드 연구진은 이 지저분한 문제를 '쪼개서' 수백 밀리초에 풀고, 그 답이 최적에 얼마나 가까운지 하한까지 계산해 보증하는 프레임워크를 제시했습니다. 소규모 계좌 운용과 세금 인식 리밸런싱에 바로 쓸 수 있는 실용 최적화의 교과서를 쉽게 풀어 설명합니다.
 알고리즘 트레이딩S
강화학습 주문집행이 실전에서 실패하는 이유: 2023년 일반화 거래집행 RL
백테스트에서는 완벽했던 강화학습 주문집행 알고리즘이 실전에서 무너지는 이유를 이론과 실험으로 규명한 2023년 연구를 쉽게 풀어 설명합니다. 과적합의 구조적 원인, 컨텍스트 압축 해법, 그리고 실전 적용 시사점을 다룹니다.
 팩터 투자S
팩터 t-통계량 임계값을 올려야 할까? 2022년 출판편향 연구의 답
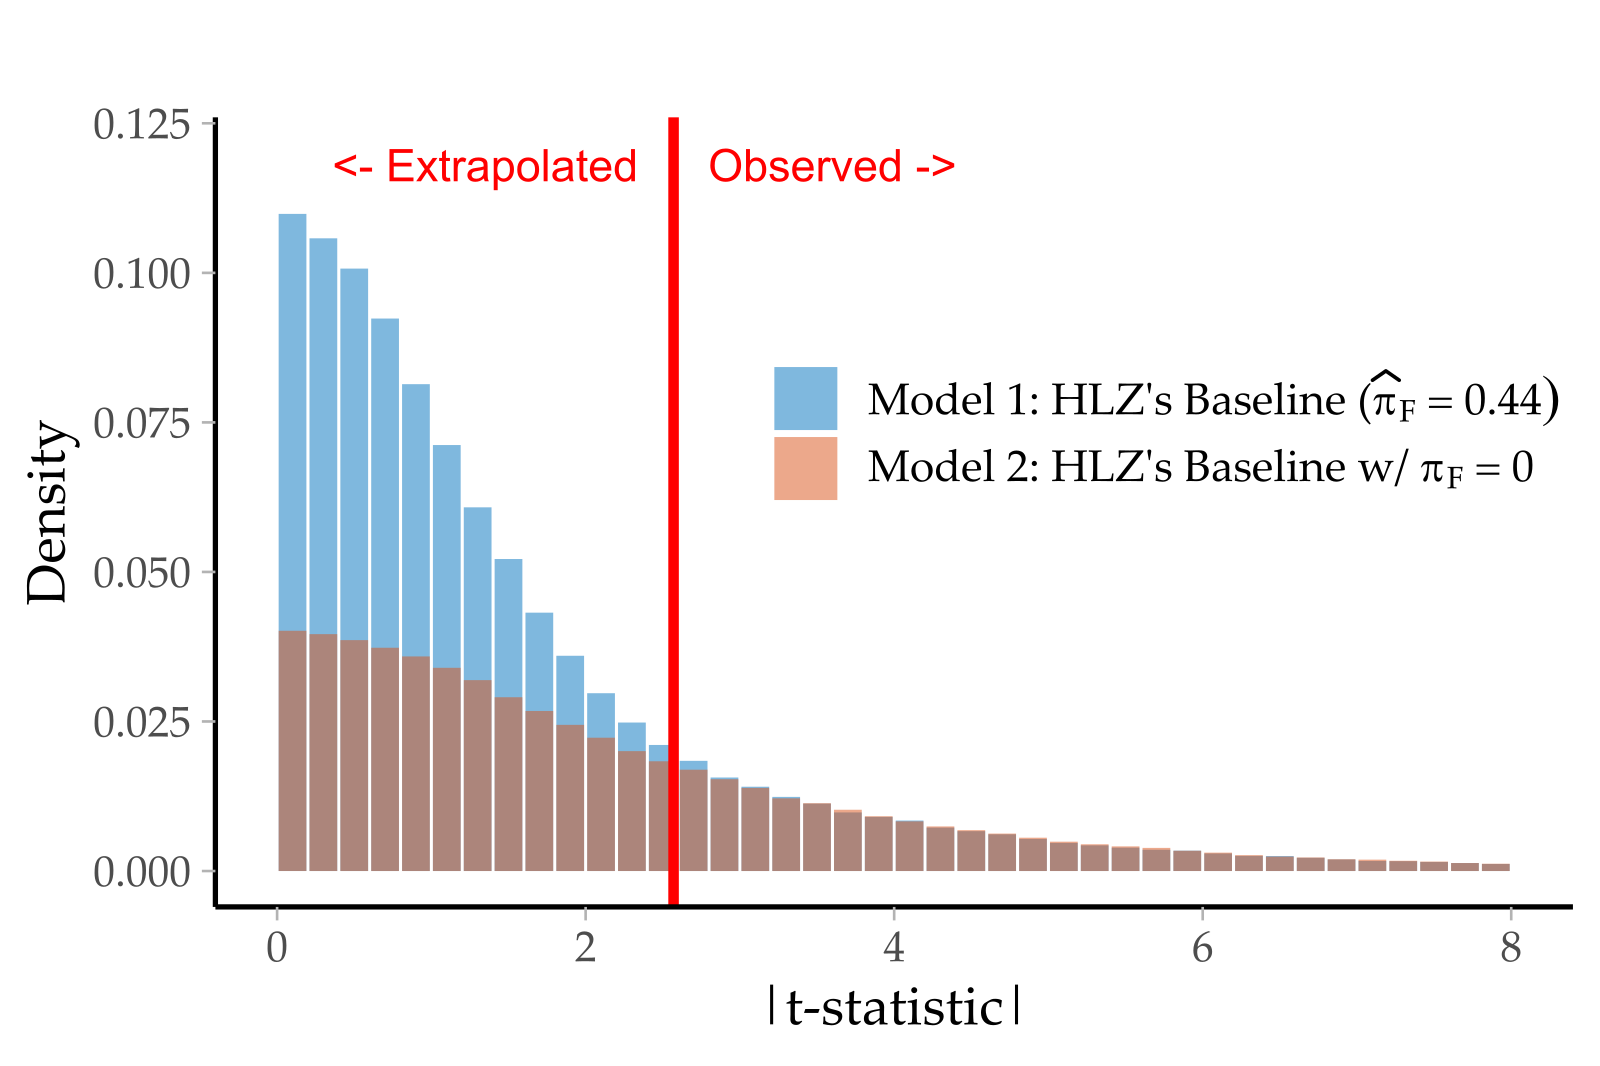
수백 개 팩터를 검증하다 보면 거짓 신호가 섞이기 마련이고, 학계는 't-통계량 임계값을 올리자'고 제안했습니다. 그런데 2022년 논문은 그 임계값 자체가 데이터로는 정해질 수 없다는 놀라운 결론을 내립니다. 대신 써야 할 지표가 무엇인지, 퀀트 실무에 어떻게 적용하는지 쉽게 풀어 설명합니다.