
Towards Generalizable Reinforcement Learning for Trade Execution
Chuheng Zhang, Yitong Duan, Xiaoyu Chen, Jianyu Chen, Jian Li, Li Zhao
"학습한 시장 데이터를 통째로 외운" 강화학습 트레이더의 실패를, 연구자들은 수학으로 추적하고 실험으로 증명해 냈습니다.
들어가며: 기출문제를 외운 학생의 함정
어떤 학생이 지난 10년치 기출문제를 완벽히 외워서 모의고사에서 100점을 맞았다고 해봅시다. 우리는 직감적으로 압니다. "저 학생, 진짜 시험에서는 다를 거예요." 문제의 패턴을 배운 게 아니라 답을 외웠기 때문입니다.
주식·선물 시장에서 큰 주문을 나눠서 '적당한 가격에' 처분하는 일 — 소위 최적 거래집행(optimal trade execution) — 을 강화학습으로 자동화하려는 시도가 최근 몇 년간 계속되어 왔습니다. 그런데 백테스트에서는 대단한 성능을 보이던 알고리즘들이 실제 시장에 내놓으면 형편없어지는 일이 반복됐습니다. 마치 기출문제를 외운 학생처럼요.
2023년 7월, 마이크로소프트 리서치와 칭화대 연구팀은 이 현상을 "모델이 미래를 예측해서가 아니라 과거 가격 시퀀스를 통째로 암기했기 때문"이라고 진단하고, 그 메커니즘을 이론으로 증명하고 실험으로 확인한 논문을 발표했습니다. 오늘은 이 논문 — S등급으로 평가한 이유가 분명한 연구 — 를 함께 따라가 봅니다.
무엇이 문제였나: 시뮬레이터 안의 대박, 밖의 참사
최적 거래집행 문제는 단순합니다. "정해진 시간 안에, 정해진 수량을, 최대한 좋은 가격에 팔아라." 과거에는 이 문제를 미리 짜인 공식(Almgren-Chriss 같은 고전적 모형)으로 풀었지만, 이런 공식은 시장이 어떻게 움직일지에 대해 강한 가정을 해야 했고 실제 상황에는 잘 맞지 않았습니다.
그래서 등장한 것이 강화학습(RL) 접근입니다. 과거 시장 데이터를 시뮬레이터에 넣고, 에이전트가 스스로 "지금은 조금 팔까, 좀 더 기다릴까"를 학습하게 하는 겁니다. 겉보기엔 완벽한 해법입니다. 데이터가 충분히 많고 시뮬레이터가 현실적이면요.
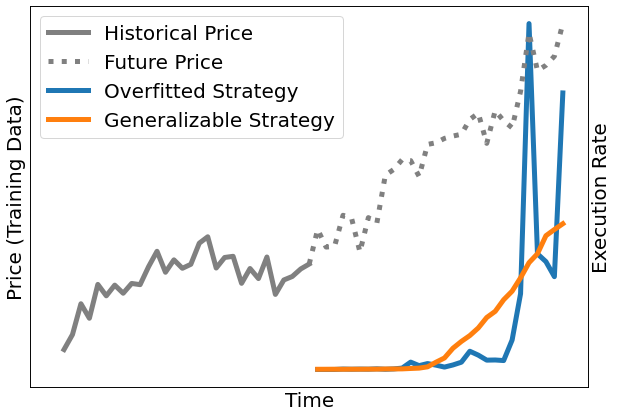
문제는 시뮬레이터의 본질에 있었습니다. 시뮬레이터는 결국 유한한 개수의 과거 가격 시퀀스(이 논문은 이것을 '컨텍스트'라고 부릅니다)를 재생하는 기계입니다. 훈련을 100만 스텝 돌려도 가격 시퀀스는 그 몇백 개가 전부입니다. 에이전트는 시장의 '법칙'을 배우는 대신 그 몇백 개의 시나리오 각각의 정답을 외워 버립니다.
외움의 결과는 아주 구체적입니다. 논문이 보여준 과적합된 전략 그래프를 보면, 에이전트는 훈련 데이터에서 가격이 가장 높았던 바로 그 순간에 재고를 거의 전량 던지는 날카로운 스파이크를 그립니다. 훈련 시퀀스에서는 완벽한 전략입니다. 새로운 날에는? 그 '최고점'은 다시는 오지 않습니다.
핵심 아이디어: "외울 재료를 줄이면" 과적합도 줄어든다
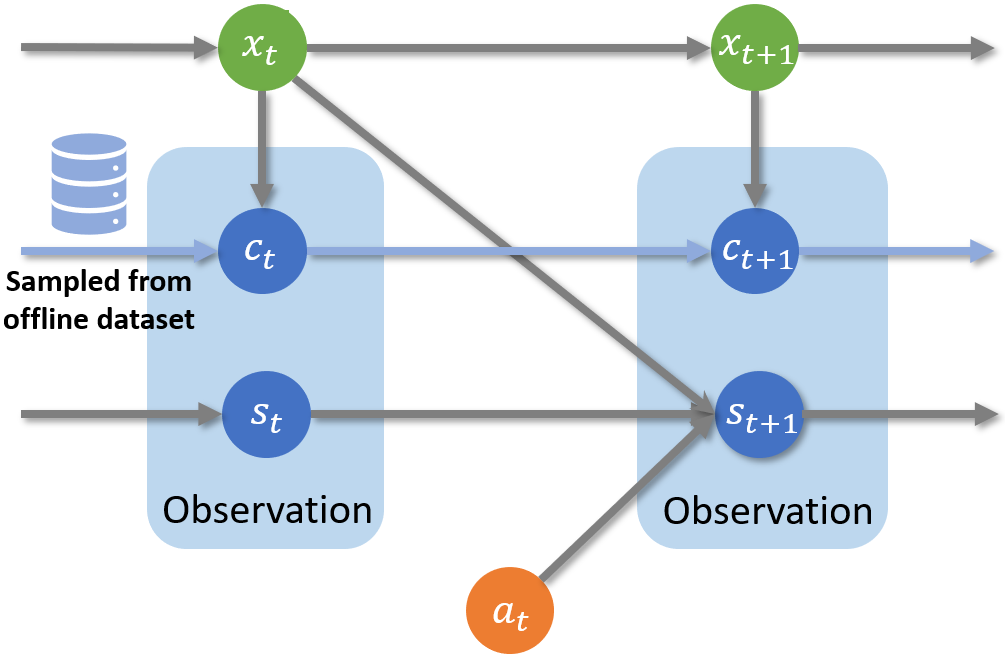
이 논문의 첫 번째 기여는 문제의 정식화입니다. 연구진은 이 설정을 ORDC(Offline RL with Dynamic Context, 동적 컨텍스트를 가진 오프라인 강화학습)라는 이름으로 정리했습니다.
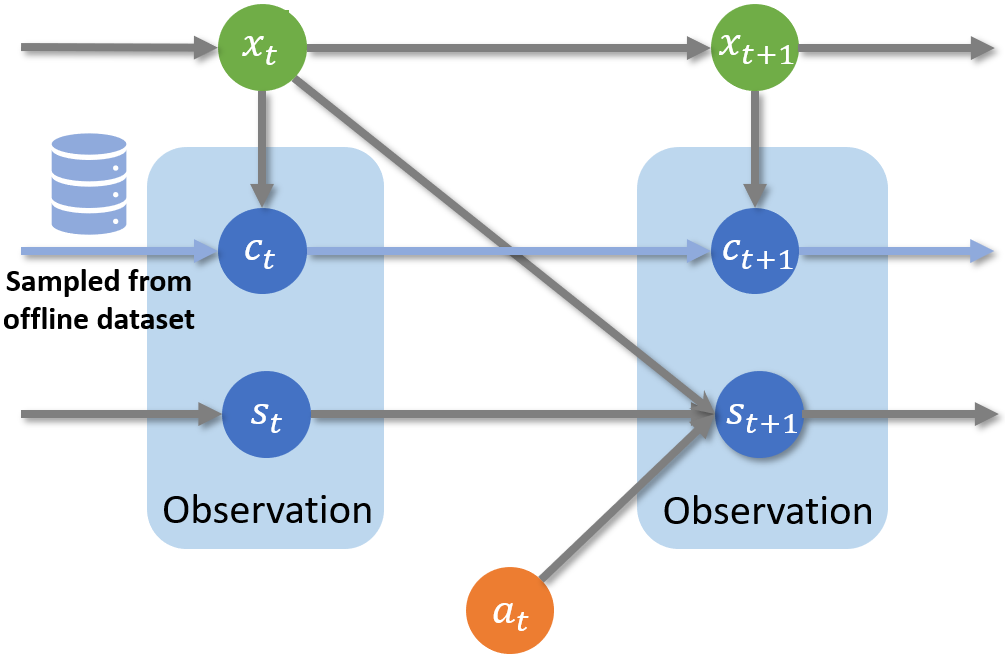
핵심은 이겁니다. 시장 변수(가격 흐름, 호가 흐름)는 우리의 행동과 무관하게 움직이며, 우리는 그중 유한한 조각만 가지고 있습니다. 그리고 이론적으로, 일반화 오차는 (컨텍스트 공간의 크기) ÷ (컨텍스트 샘플 수) 로 커집니다.
쉽게 말하면 이런 겁니다. 암기할 재료의 종류가 많고(컨텍스트 공간 큼), 그걸 반복해 볼 기회가 적으면(샘플 적음) 무조건 외운다는 거예요. 시뮬레이션 스텝을 백만 번 돌려봤자 외울 시나리오는 여전히 몇백 개뿐이니, 더 오래 학습하면 할수록 더 외웁니다.
그러면 해결책은 두 가지입니다. 데이터를 늘리거나(현실적으로 어렵습니다 — 금융 데이터의 차원과 잡음에 비해 턱없이 부족하고, 오래된 데이터는 시장 환경이 달라져서 오히려 독이 됩니다), 아니면 외울 재료 자체를 줄이거나. 논문은 후자를 택합니다: 컨텍스트를 결정에 필요한 소량의 정보로 압축하는 것입니다.
- CASH 방법은 사람이 설계한 '안정적인 통계량'을 압축 목표로 삼습니다. "미래 가격의 평균/최고/최저와 현재의 차이"(추세와 고점/저점), "미래 가격의 변동성", "스프레드 관련 지표들" 같은 것들이죠. 영리한 통찰이 숨어 있습니다. 미래의 정확한 최고점 순간은 암기해 봤자 소용없지만(그건 예측 불가능합니다), 미래의 추세와 변동성은 어느 정도 예측 가능하고 일반화됩니다. 예측 가능한 것만 배우게 강제하는 겁니다. 게다가 이 압축 표현은 사람이 읽을 수 있는 숫자라, 학습된 정책이 '왜 지금 이 가격에 걸었는지' 해석할 수 있습니다.
- CATE 방법은 도메인 지식 없이, 인코더-디코더(변분 오토인코더) 구조로 미래 통계량을 스스로 찾게 합니다.
연구진은 평가를 위해 호가창(LOB, limit order book) 스냅샷을 재구성하는 고충실도 시뮬레이터도 직접 만들었습니다. 일시적 시장충격, 체결 지연까지 반영해서, "시뮬레이터에서만 좋은" 알고리즘을 걸러내려 한 겁니다.
결과 — 무엇을 알아냈나
실험은 중국 A주 시장의 유동성 상위 100개 종목으로 진행했습니다. 2022년 4~6월 데이터로 학습, 7월로 검증, 8월로 테스트. 과제는 "하루 거래량의 0.5%를 무작위로 고른 30분 구간 안에서 처분"이고, 1분마다 주문을 결정합니다.
성능 지표는 거래 비용(bp)입니다. "정해진 기간의 시간가중평균가(TWAP)보다 얼마나 불리하게 체결됐는지"를 만분의 1 단위(bp, basis point)로 나타낸 것으로, 작을수록 좋고, 마이너스면 TWAP보다 유리한 가격에 팔았다는 뜻입니다.
결과는 이렇습니다.
| 전략 | 테스트 거래 비용 (bp) | 일반화 갭 (bp) |
|---|---|---|
| TWAP (균등 분할) | 14.10 | — |
| Momentum | 12.25 | — |
| 튜닝된 DQN | 5.92 | 3.89 |
| 튜닝된 PPO | 2.76 | 3.71 |
| 선행 연구 (Fang et al., 2021) | 11.87 | 16.78 |
| 튜닝된 PPO + CASH (제안) | −4.58 | 0.07 |
| 튜닝된 PPO + CATE (제안) | −4.91 | 0.13 |
세 가지가 눈에 들어옵니다.
첫째, 겉보기 성능과 진짜 성능이 완전히 다릅니다. 선행 연구의 알고리즘은 훈련 데이터에서 −4.91bp로 '제안 방법보다 좋아 보입니다'. 그런데 테스트에서는 11.87bp로 무너집니다. 훈련과 테스트 사이의 격차 — 일반화 갭 — 가 16.78bp에 달하는 겁니다. 반면 제안 방법의 갭은 0.07bp입니다. 학습한 시나리오와 못 본 시나리오에서 거의 같은 성능을 낸다는 뜻이고, 이것이 "외운 게 아니라 배웠다"는 증거입니다.
둘째, 데이터를 늘려도 소용없습니다. 학습 데이터를 3개월치에서 6개월치(약 300만 샘플)로 두 배로 늘렸는데, 기준 알고리즘의 과적합은 줄지 않았습니다. 오히려 압축 표현을 쓰는 제안 방법이 데이터가 많을 때 더 좋아졌습니다. 금융 데이터는 잡음과 차원이 커서 "데이터가 많다"와 "학습에 충분하다"가 다르다는 점을 뒷받침합니다.
셋째, 아무 압축이나 좋은 게 아닙니다. 같은 8차원 압축을 PCA(분산을 가장 잘 보존하는 고전적 차원 축소)로 하면 성능이 0.93bp로 떨어집니다(갭 1.66). 결정과 안정적으로 연결된 통계량을 예측하게 하는 것이, 단순히 정보를 덜 버리는 것보다 중요합니다.
추가 실험도 의미심장합니다. 비트코인(OKEX 거래소, 15분 간격 롱/숏, 수수료 0.03%) 시장에서는 기준 알고리즘의 일일 수익이 마이너스였던 반면, CASH·CATE를 얹자 양수로 반전되었고 일일 샤프 비율은 약 2.58이 나왔습니다. 그리고 CASH의 정책은 해석 가능했습니다. 예측된 추세가 1단위 오르면 호가 가격을 4.554bp씩 높게 불렀고, 스프레드 변동성이 커지면 호가 수량을 줄였습니다 — 사람이 읽어도 말이 되는 행동입니다.
한계와 주의점
정직하게 짚어 둘 것들이 있습니다.
- 표현 학습만 다룬 연구입니다. 저자들도 명시하듯, 피처 설계, 신경망 구조, 기존 정규화 기법 등 과적합을 막는 다른 수단들과의 상호작용은 열린 문제로 남아 있습니다.
- 시장이 한정적입니다. 중국 A주 100개 종목과 비트코인 두 곳에서 검증했을 뿐, 미국 주식·선물 등 다른 시장에서의 검증은 추가로 필요합니다.
- CASH는 사람이 통계량을 설계해야 합니다. 그 통계량 선택이 곧 성능 상한을 만드는 셈이라, 도메인 이해가 없으면 쓰기 어렵습니다. CATE는 이 의존성을 없애지만, 압축 표현이 진짜 신호 대신 잡음까지 압축할 위험을 저자 스스로 인정합니다.
- 시뮬레이터는 여전히 시뮬레이터입니다. 논문의 시뮬레이터가 정교하다는 것이지, 실제 체결의 모든 마찰(유동성 고갈, 거래소별 특수성)을 담았다는 뜻은 아닙니다.
그래서 투자/실무엔?
일반 독자분들이 눈여겨볼 지점은 "더 똑똑한 모델"이 아니라 "평가 방식의 교훈"입니다.
- 백테스트 성능의 진짜 이름은 '훈련 성능'입니다. 이 논문은 훈련과 테스트의 격차(일반화 갭)를 성능표에 함께 적었습니다. 투자 전략을 검증할 때 수익률만 보지 말고, "못 본 구간에서 얼마나 떨어지는가"를 함께 보라는 이야기입니다. 좋은 전략은 백테스트에서 가장 높은 전략이 아니라, 훈련 구간과 검증 구간의 격차가 가장 작은 전략일 수 있습니다.
- 데이터가 적다고 불안해할 필요는 없습니다. 오히려 "외울 재료를 줄이는" 설계(결정에 필요한 핵심 지표만 남기기)가 데이터를 억지로 늘리는 것보다 효과적이었습니다. 개인 투자자가 기관보다 데이터가 적은 현실과도 맞닿아 있는 결론입니다.
- 해석 가능한 모델의 가치. 이 알고리즘은 "왜 지금 팔았는지"를 숫자로 설명할 수 있었습니다. 자기자본 운용처럼 책임 소재가 분명해야 하는 영역에서는, 성능 0.몇 bp보다 설명 가능성의 가치가 클 수 있습니다.
이 연구가 2023년에 나왔고 지금 다시 읽어도 의미 있는 이유는, 이후 강화학습 거래집행 연구가 '일반화와 검증'을 중심 주제로 이동했기 때문입니다. 최근 발표된 연구들도 오프라인 정책의 신뢰성, 제약 조건 하의 안전한 실행, 시장가/지정가를 함께 쓰는 집행 같은 문제를 계속 파고들고 있습니다. "시뮬레이터 안의 대박"을 경계하는 이 논문의 질문은 그 흐름의 출발점에 있습니다.
더 알아보기
- 원문: Towards Generalizable Reinforcement Learning for Trade Execution (arXiv:2307.11685)
- 발표: 2023년 7월 (Microsoft Research + 칭화대 IIIS) | 코드: RL4Execution
- 5차원 점수 (ohselab KB 기준, 복합점수 83.0): 새로움 78 · 적용성 86 · 엄밀성 82 · 재현성 84 · 통찰 81
- S등급 판정 근거: 과적합이라는 실전 실패 요인을 이론(일반화 하한)과 실험(고충실도 LOB 시뮬레이터)으로 동시에 규명하고, 즉시 적용 가능한 해법(컨텍스트 압축)과 공개 코드를 함께 제공한 완결성이 높습니다. 적용성 86점은 "자체 주문집행 프로토타입에 바로 이식 가능한" 설계라는 점에서, 재현성 84점은 시뮬레이터와 코드 공개에서 나온 점수입니다.
- 관련 논문 (
kb.py related기준):- Deep Empirical Risk Minimization in finance (arXiv:2011.09349) — 투자 모델이 미래 정보를 암기하는 문제를 다룬 또 다른 S등급 연구
- Your Offline Policy is Not Trustworthy (arXiv:2505.12759) — 오프라인 강화학습 정책의 신뢰성 문제를 후속으로 다룸
- Distributional Model Equivalence for Risk-Sensitive RL (arXiv:2307.01708) — 같은 달의 위험민감 강화학습 연구
관련 글
 포트폴리오 최적화S
2020년 Deep Empirical Risk Minimization in finance: AI 투자 전략이 '미래를 훔쳐보는' 이유
백테스트에서는 대박이 나는데 실전에서는 안 되는 그 이유. 2020년 발표된 이 논문은 딥러닝 투자 모델이 훈련 데이터 안에서 미래 정보를 몰래 암기하는 메커니즘을 이론적으로 증명했습니다. 데이터 규모와 모델 복잡도의 균형으로 과학습을 통제하는 조건까지 쉽게 풀어 설명합니다.
 알고리즘 트레이딩S
최적 집행 딥러닝 대리모델: 2022년 연구가 대규모 주문 스케줄을 짜는 법
수십만 주를 팔 때 '얼마나 빨리, 어떻게 쪼개서' 팔아야 시장 충격을 최소화할까? 2022년 연구는 선형 충격에서는 공식 해를, 비선형 충격에서는 딥러닝 대리모델을 제안합니다. 시장 매개변수가 틀려도 견디는 설계와 실제 성능 수치까지 쉽게 풀어 설명합니다.
 팩터 투자S
팩터 t-통계량 임계값을 올려야 할까? 2022년 출판편향 연구의 답
수백 개 팩터를 검증하다 보면 거짓 신호가 섞이기 마련이고, 학계는 't-통계량 임계값을 올리자'고 제안했습니다. 그런데 2022년 논문은 그 임계값 자체가 데이터로는 정해질 수 없다는 놀라운 결론을 내립니다. 대신 써야 할 지표가 무엇인지, 퀀트 실무에 어떻게 적용하는지 쉽게 풀어 설명합니다.