
On Parametric Optimal Execution and Machine Learning Surrogates
Tao Chen, Mike Ludkovski, Moritz Voß
"이 주문을 어떻게 쪼개야 가장 싸게 처리될까?" — 정확한 답은 매개변수에 달려 있고, 매개변수는 아무도 정확히 모릅니다. 그래서 아예 '매개변수를 먹고 자라는' 신경망을 만든 연구.
들어가며: 큰 물건을 팔 때의 딜레마
중고거래를 생각해 봅시다. 오래된 피아노를 팔아야 하는데, 당장 내놓으면 동네에 물건이 풀려 가격이 뚝 떨어집니다. 조금씩 나눠서 팔면 가격을 지키지만 시간이 걸리고, 그 사이 시세가 빠질 수도 있습니다. 빨리 팔면 가격이 무너지고, 천천히 팔면 시간이 걸립니다. 이게 바로 대규모 주문의 본질적인 딜레마입니다.
주식시장에서 수십만 주를 매도하는 기관투자자도 같은 문제에 부딪힙니다. 주문을 시장에 쏟아내면 그 자체가 가격을 움직입니다(가격 충격). 그런데 시장은 원래대로 돌아오려는 성질(회복력)이 있고, 이 회복 속도가 얼마나 되는지, 충격이 주문량에 비례하는지(선형) 아니면 더 빠르게 커지는지(비선형)를 정확히 아는 사람은 없습니다.
2022년 4월의 이 논문, On Parametric Optimal Execution and Machine Learning Surrogates(Chen, Ludkovski, Voß, arXiv:2204.08581)는 이 문제를 두 층으로 나눠 풀어냅니다. 풀리는 부분은 공식으로, 풀리지 않는 부분은 딥러닝 대리모델로. 이 글은 S등급(최고 등급)으로 평가된 이 연구를 처음부터 끝까지 쉽게 풀어쓴 단독 리뷰입니다.
무엇이 문제였나: 풀리면 빠른데, 현실은 '안 풀리는' 모형
주문 실행 문제는 오래된 연구 주제입니다. 고전적인 Almgren-Chriss 프레임워크나 Obizhaeva-Wang(2013) 모형에서는 시장 충격을 선형으로 가정하면 최적 주문 스케줄을 공식(닫힌형 해)으로 구할 수 있습니다. 공식이 있으면 계산이 순간이고, 매개변수가 바뀌어도 바로 다시 계산할 수 있습니다.
문제는 현실의 가격 충격이 선형이 아니라는 데 있습니다. 많은 실증 연구는 충격이 주문량의 약 0.5제곱(사각근 법칙)처럼 비선형으로 커진다고 보고합니다. 비선형이 되면 공식이 사라집니다. 동적 계획법(벨만 방정식)으로 수치 풀이는 가능하지만, 매개변수(회복 속도 κ, 일시적 충격 η 등) 하나가 바뀔 때마다 처음부터 다시 풀어야 합니다. 게다가 이 매개변수들은 추정 자체가 극도로 어렵습니다.
즉, 현실적인 문제일수록 풀기가 비싸고, 매개변수가 틀리면 답도 틀립니다. 이 한계가 논문의 출발점입니다.
핵심 아이디어: 반은 공식으로, 반은 신경망으로
논문의 접근은 세 단계로 요약됩니다.
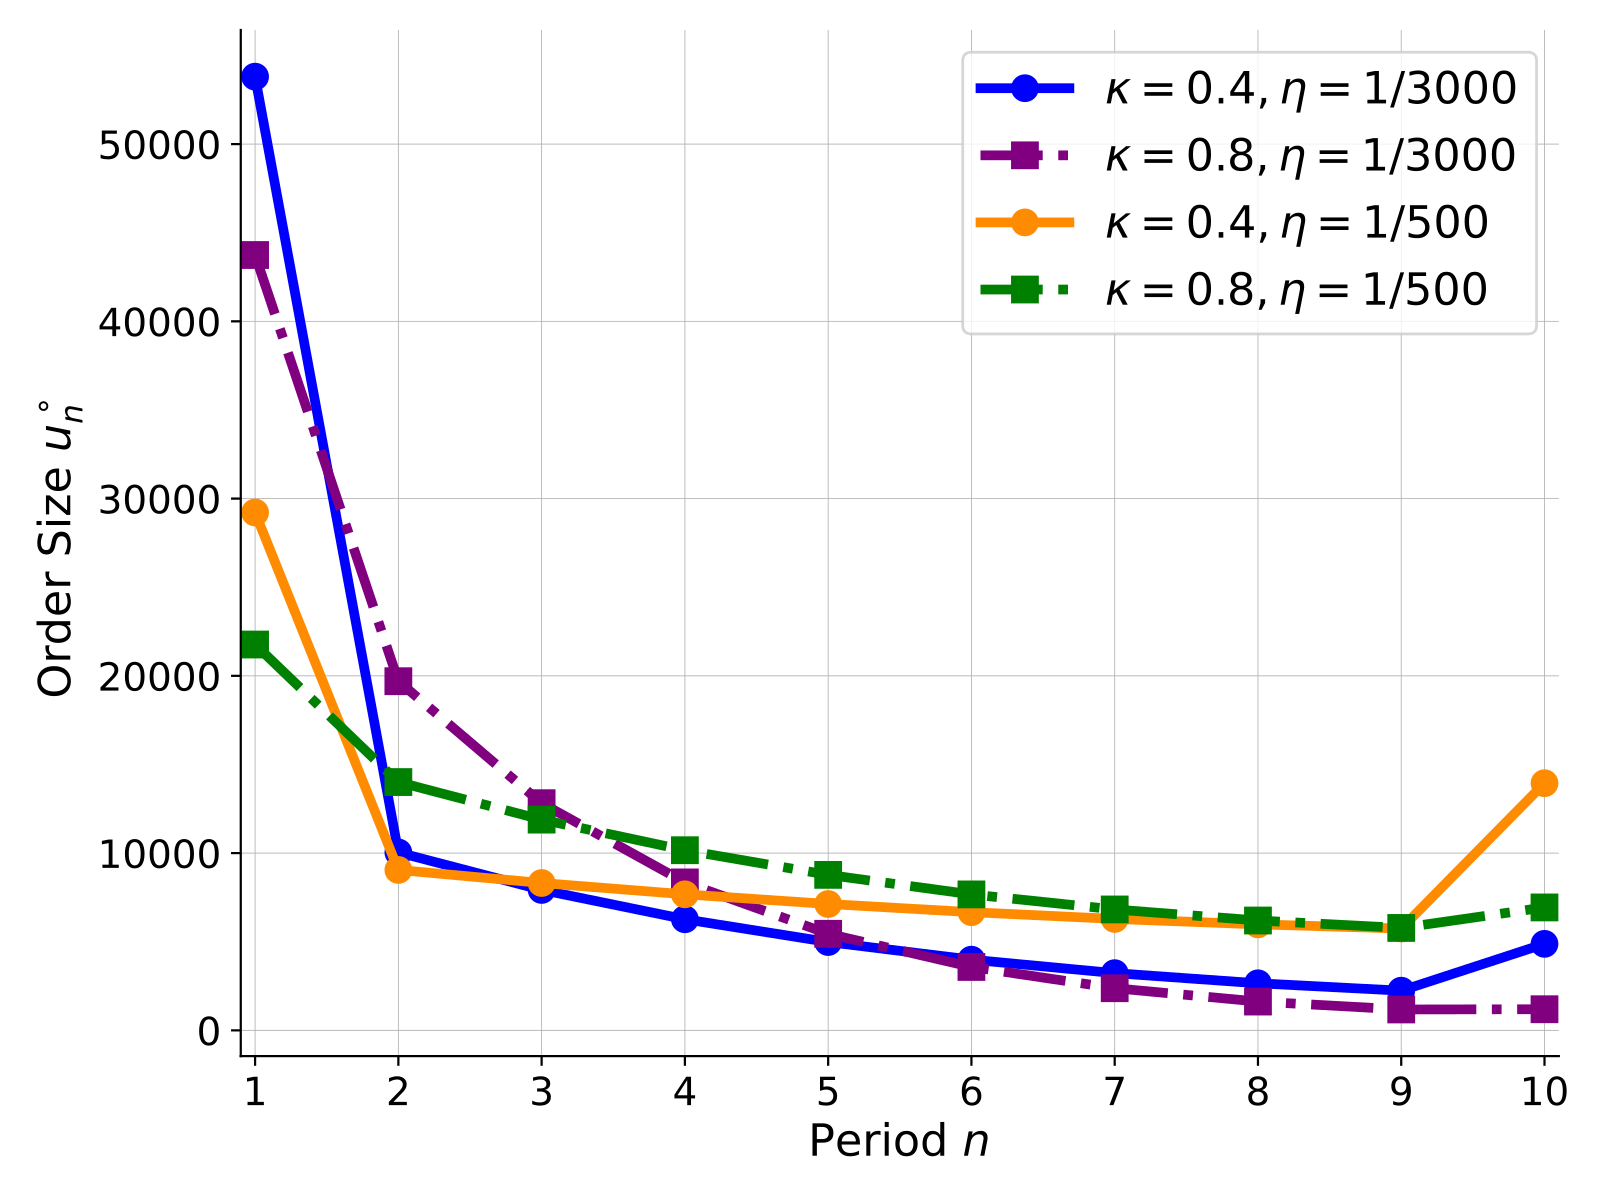
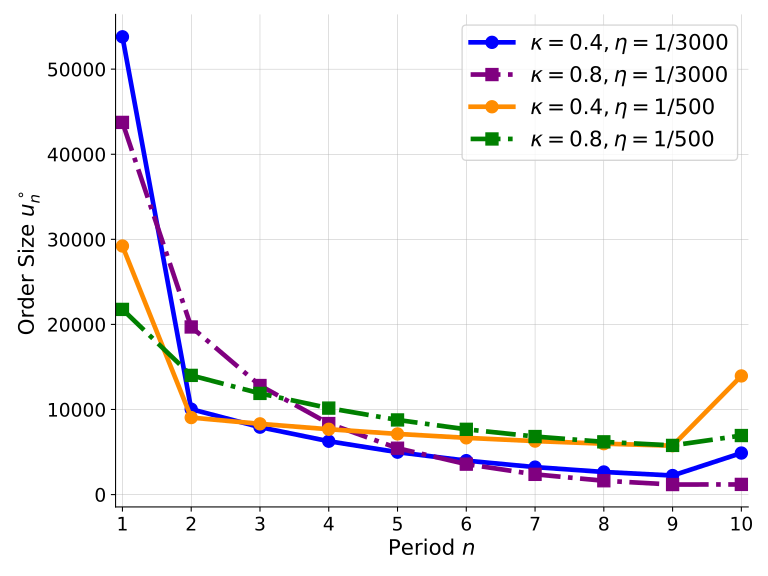
1단계 — 선형에서는 공식을 만든다. 일시적 가격충격이 선형이고 시장 회복력이 '확률적'(즉, 회복 속도가 시간에 따라 흔들림)인 설정에서 최적 전략의 닫힌형 재귀를 유도합니다. 결정론적 회복력에 대한 Obizhaeva-Wang(2013)의 유명한 결과를 확률적 회복력까지 넓힌 것으로, 이론적 기여입니다. 흥미로운 결론 하나: 실행 긴급도(재고 페널티)가 있고 일시적 충격이 작으면, 최적 스케줄은 흔히 아는 U자형이 아니라 앞으로 몰린 모노톤 감소 형태가 됩니다.
2단계 — 비선형에서는 두 개의 신경망을 쓴다. 공식이 없는 영역에서 동적 계획법의 계산 결과를 대리모델(surrogate)로 압축합니다. 강화학습의 액터-크리틱 구조를 빌려, 하나의 신경망은 "이 상태에서 남은 비용이 얼마인가"(가치함수)를, 다른 하나는 "이 상태에서 몇 주를 사야 하는가"(제어 정책)를 각각 학습합니다. 정책 신경망은 학습된 가치함수에서 매번 최적화를 다시 돌리지 않고도 바로 주문량을 출력하므로 빠르고 실용적입니다.
3단계 — 매개변수를 입력으로 넣는다(파라메트릭 학습). 이게 논문의 실용적 핵심입니다. 회복력 κ나 충격 η를 고정하지 않고 신경망의 입력 차원에 포함시킵니다. 그러면 학습된 모델 하나가 수많은 시장 상황을 전부 커버하고, "κ가 우리가 생각한 것보다 절반이면?" 같은 민감도 질문에 즉시 답할 수 있습니다. 캘리브레이션이 틀려도 전략이 무너지지 않게 만드는 설계인 셈입니다.
결과 — 무엇을 알아냈나
1. 선형 모델에서 공식 해가 나왔고, 스케줄의 '모양'이 매개변수에 따라 달라집니다.
- 실험 설정: 10만 주(10⁵)를 10단계에 걸쳐 처리하는 상황. 회복력 κ, 일시적 충격 η, 긴급도 ν를 바꿔 가며 최적 매수 프로그램을 비교했습니다.
- 회복력이 빠르고 충격이 크면 전통적인 U자형(처음과 끝에 크게)이 유지되지만, 긴급도가 있고 충격이 작으면 처음에 몰아서 사는 감소형 스케줄이 최적이 됩니다. 직관과 다른 부분이라 실무자에게 유용한 통찰입니다.
2. 비선형 모델에서 딥러닝 대리모델의 정확도가 '실무에 충분한' 수준입니다.
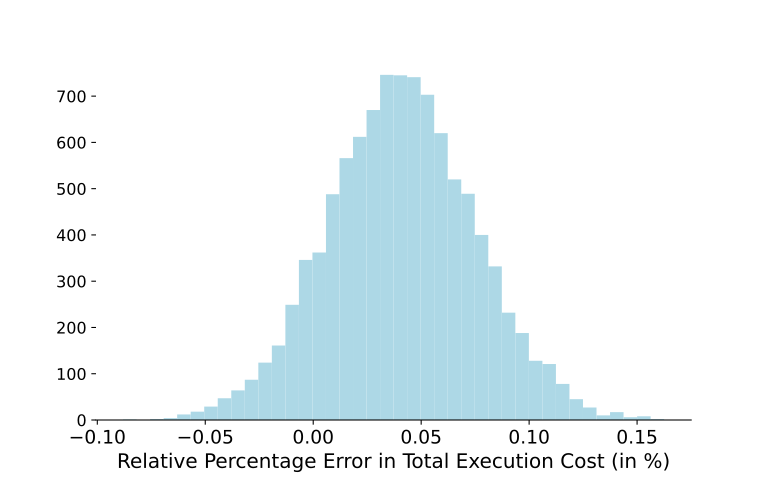
- 검증용 10,000개(10⁴)의 전진 시뮬레이션 경로에서, 신경망 전략의 실현 실행 비용이 정밀 벤치마크 전략보다 평균 0.041% 높은 수준이었습니다.
- 경로의 약 11.6%에서는 신경망 전략이 오히려 더 저렴했고(근사 과정에서 우연히 좋은 결정이 나온 경우), 95.5% 이상의 경로에서 비용 차이가 0.1% 미만이었습니다.
- 같은 경로 위에서 최적 정책과 신경망 정책의 주문량을 겹쳐 보면 경로별로도 거의 일치합니다.
3. 비선형 사각근 사례(α = 0.5)까지 검증했습니다.
- 비교 대상은 선형 피드백 전략(공식을 억지로 적용)과 VWAP(거래량 가중 평균)였고, 다양한 κ·η·ν 구성에서 신경망 솔버들이 더 나은 비용을 냅니다. 매개변수 입력을 바꿔 가며 정책이 어떻게 변하는지도 시각화했습니다.
4. 재현성이 훌륭합니다.
- 신경망 구현 전체가 담긴 Jupyter Notebook을 공개했습니다. 저자들은 이것이 독립적인 교육 가치가 있다고 강조합니다 — 확률적 제어 문제에 대리모델을 붙이는 방법의 실제 예시이기 때문입니다. KB 평가에서도 재현성 점수가 88점으로 S등급의 핵심 근거가 되었습니다.
5. 그 뒤의 흐름(과장 없이). 2022년 이후 딥러닝을 확률적 제어·헤징·실행 문제에 붙이는 접근은 deep hedging, 자동 마켓메이커 최적화 등 여러 후속 문헌으로 이어졌고, "공식이 풀리는 범위 + 나머지는 학습된 솔루션"이라는 역할 분담은 이제 흔한 설계 패턴이 되었습니다. 다만 이 논문 자체가 제안한 적응형 학습(매개변수를 실시간으로 갱신하는 확률과정으로 다루기)과 강건(min-max) 확장은 아이디어 제안 수준이며, 실제로 상용 시스템에 들어갔는지는 이 논문만으로는 알 수 없습니다.
한계와 주의점
- 모형 세계 안의 검증: 결과는 시뮬레이션 기반입니다. 실제 시장 데이터에서 이 대리모델이 시장 충격·회복력을 얼마나 잘 다루는지는 이 논문의 범위 밖입니다.
- 이산 시간: 문제를 10단계 같은 이산 구간으로 설정합니다. 연속시간 모형과의 이론적 연결은 추가 과제로 남아 있습니다.
- 블랙박스: 신경망 정책은 해석이 어렵습니다. "왜 이 시점에 이렇게 많이 팔았는지"를 설명해야 하는 상황에는 별도의 해석 도구가 필요합니다.
- 캘리브레이션 난이도: 매개변수를 입력으로 받는 설계가 불확실성을 완화하지만, 입력값 자체가 엉터리라면 전략도 틀어집니다. 저자들도 정확한 캘리브레이션이 극도로 어렵다는 점을 문제로 명시합니다.
- 비용 모형의 단순화: 가격충격과 회복력 중심의 비용 구조이며, 세금·기회비용·경쟁 주문 등 현실의 다른 마찰은 다루지 않습니다.
그래서 투자/실무엔?
자기자본 운용이나 기관 실행 데스크 관점에서 이 논문이 주는 실무 지침은 명확합니다.
- 실행 엔진을 '매개변수 입력형'으로 설계하라. 회복력·충격·유동성 추정치를 입력으로 받아 주문 스케줄을 즉시 출력하는 구조가, 매번 최적화를 다시 돌리는 구조보다 캘리브레이션 오차에 강합니다. 추정치가 갱신되면 정책도 즉시 따라 움직입니다.
- 공식과 학습 모델의 경계를 구분하라. 선형 충격 영역에서는 닫힌형 공식이 빠르고 정확합니다. 비선형 영역에서만 학습된 솔루션을 쓰고, 두 영역의 성능을 같은 벤치마크에서 비교하라 — 이 논문의 검증 방식(비용 차이 분포로 따지기)이 좋은 템플릿입니다.
- 근사 오차를 '비용'으로 번역하라. "신경망이 99% 정확하다"는 말보다 "비용이 평균 0.041% 더 들고, 95.5%의 경우 0.1% 미만"이라는 표현이 의사결정에 유용합니다. 실행 전략 평가도 이 문법으로 남기면 조직에서 소통이 빨라집니다.
더 알아보기
- 원문: On Parametric Optimal Execution and Machine Learning Surrogates (arXiv:2204.08581) — Tao Chen, Mike Ludkovski, Moritz Voß (UC Santa Barbara). Jupyter Notebook 공개.
- 5차원 점수 (KB 기준): 종합 80.3 — 새로움 68 · 적용성 83 · 엄밀성 82 · 재현성 88 · 통찰 73. 재현성과 적용성이 특히 높습니다.
- 함께 읽으면 좋은 논문:
- Randomization in Optimal Execution Games (arXiv:2503.08833) — 실행 게임에서의 무작위화 전략
- Optimal Trading in Automated Market Makers with Deep Learning (arXiv:2304.02180) — 딥러닝을 쓴 자동화 마켓메이커 최적 거래
- Deep Empirical Risk Minimization in Finance (arXiv:2011.09349) — 금융에서 딥러닝 제어 모델의 과학습 문제 (S등급, 본 블로그에 별도 리뷰 있음)
관련 글
 알고리즘 트레이딩S
강화학습 주문집행이 실전에서 실패하는 이유: 2023년 일반화 거래집행 RL
백테스트에서는 완벽했던 강화학습 주문집행 알고리즘이 실전에서 무너지는 이유를 이론과 실험으로 규명한 2023년 연구를 쉽게 풀어 설명합니다. 과적합의 구조적 원인, 컨텍스트 압축 해법, 그리고 실전 적용 시사점을 다룹니다.
 포트폴리오 최적화S
2020년 Deep Empirical Risk Minimization in finance: AI 투자 전략이 '미래를 훔쳐보는' 이유
백테스트에서는 대박이 나는데 실전에서는 안 되는 그 이유. 2020년 발표된 이 논문은 딥러닝 투자 모델이 훈련 데이터 안에서 미래 정보를 몰래 암기하는 메커니즘을 이론적으로 증명했습니다. 데이터 규모와 모델 복잡도의 균형으로 과학습을 통제하는 조건까지 쉽게 풀어 설명합니다.
 팩터 투자S
팩터 t-통계량 임계값을 올려야 할까? 2022년 출판편향 연구의 답
수백 개 팩터를 검증하다 보면 거짓 신호가 섞이기 마련이고, 학계는 't-통계량 임계값을 올리자'고 제안했습니다. 그런데 2022년 논문은 그 임계값 자체가 데이터로는 정해질 수 없다는 놀라운 결론을 내립니다. 대신 써야 할 지표가 무엇인지, 퀀트 실무에 어떻게 적용하는지 쉽게 풀어 설명합니다.