
Do t-Statistic Hurdles Need to be Raised?
Andrew Y. Chen
"임계값을 2.0에서 2.27로 올리세요"라는 조언은, 놀랍게도 데이터가 감당할 수 없는 주장입니다 — 대신 무엇을 믿을 수 있는지는 정확히 알려 주는 논문.
들어가며: 커트라인을 올리면 문제가 해결될까
수능 커트라인을 올리면 합격생의 평균 실력이 올라갈까요? 대체로 그렇습니다. 그런데 이런 반론이 가능합니다. "지금 합격생들 중에도 운으로 붙은 사람이 섞여 있는데, 커트라인만 올려서는 그걸 걸러낼 수 없다. 오히려 진짜 실력자까지 떨어질 수 있다."
퀀트 투자에서 팩터(가치, 모멘텀, 품질 같은 투자 신호)를 연구하다 보면 똑같은 고민에 빠집니다. 팩터를 수백, 수천 개 검증하면 순수한 우연으로 '유의미해 보이는' 팩터가 대거 나옵니다. 이걸 막으려고 학계에서는 "지금은 t-통계량 2.0이면 통과인데, 2.27이나 3.0으로 올리자"는 주장을 펴 왔습니다(Harvey, Liu, Zhu 2016 등). 검증 문턱을 높이면 가짜 팩터가 걸러진다는 논리죠.
그런데 2022년 4월 arXiv에 올라온 이 논문은 단도직입적으로 묻습니다. "그 임계값을 올리자는 결정, 실은 데이터가 뒷받침하지 못합니다." 이 글은 S등급(최고 등급)으로 평가된 Do t-Statistic Hurdles Need to be Raised?(Andrew Y. Chen, arXiv:2204.10275)를 처음부터 끝까지 쉽게 풀어쓴 단독 리뷰입니다.
무엇이 문제였나: '가짜 팩터'를 세는 게 왜 어려운가
먼저 배경을 정리해 봅시다. 어떤 팩터의 t-통계량(수익률 신호가 우연인지 판정하는 지표)이 2.0을 넘으면 "유의미하다"고 쳐 줍니다. 순수한 우연이라면 t가 1.96을 넘을 확률이 대략 5%입니다. 그런데 모든 후보 팩터가 사실은 가짜인데 1,000개를 검증하면, 대략 50개가 이 커트라인을 통과합니다. 이 50개 전부가 가짜라면 '발견'의 100%가 거짓인 셈이죠. 이런 비율을 거짓발견률(FDR, false discovery rate)이라고 합니다.
그래서 Harvey-Liu-Zhu(HLZ, 2016)는 이렇게 논증했습니다. "문헌에 보고된 팩터들의 t-통계량 분포를 보면, 가짜 팩터가 꽤 많은 것 같다(그들의 추정으로는 약 44%). 따라서 FDR 5%를 맞추려면 커트라인을 1.96에서 2.27로 올려야 한다."
문제는 이 추정의 출발점입니다. 우리가 관측하는 건 '통과된' 팩터들뿐입니다. t가 작아서 탈락한 실험은 대부분 서랍에 처박혀 논문이 되지 못합니다(출판편향). 가짜 팩터가 전체의 몇 %인지 알려면, 보이지 않는 탈락자들의 분포를 외삽해야 하는데 이 외삽이 극도로 불안정합니다.
핵심 아이디어: '보이는 데이터만으로 계산하는 지표'에 집중하라
논문은 이 문제를 약한 식별(weak identification)이라는 개념으로 정확히 짚습니다. 약한 식별이란 "데이터가 매개변수를 거의 특정해 주지 못한다"는 뜻입니다. 저자는 두 개의 모형을 나란히 놓고 보여 줍니다.
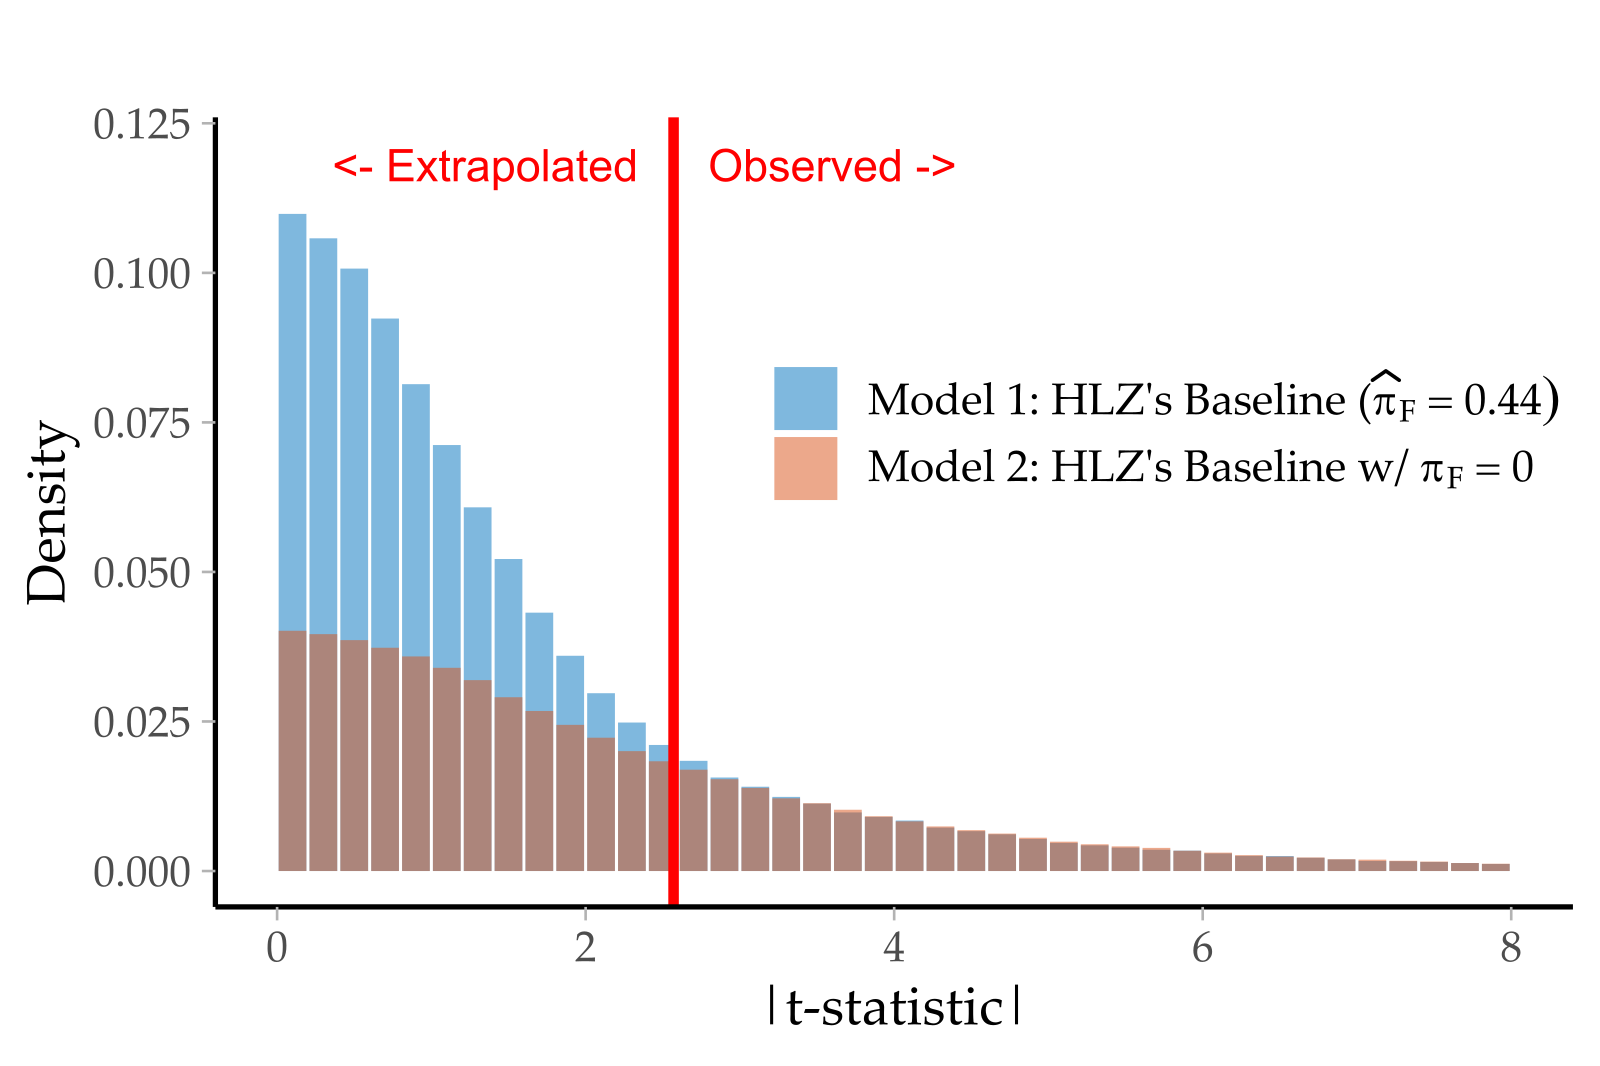
첫 번째 모형은 HLZ의 기준 추정입니다(거짓 팩터 비중 π_F = 0.444). 이 모형은 "커트라인을 2.27로 올려야 한다"고 말합니다. 두 번째 모형은 모든 매개변수를 그대로 두고 거짓 팩터 비중만 0으로 바꾼 것입니다. 이 모형은 "커트라인을 0으로 낮춰도 된다"고 말합니다. 정반대의 정책 처방이지만, 두 모형이 예측하는 t-통계량 분포는 거의 똑같아서 관측 데이터로는 둘을 구분할 수 없습니다.
그럼 무엇을 믿을 수 있을까요? 저자의 답은 우아합니다. 출판된 결과만으로 계산되는 지표는 약한 식별 문제를 피한다. 왜냐? 출판된 데이터는 풍부하게 관측되니까요. 대표적인 두 지표가 경험적 베이즈 축소추정(empirical Bayes shrinkage)과 로컬 FDR입니다.
- 축소추정: 관측된 팩터 수익률을 "진짜 기대수익 + 편향"으로 분해해서, 편향 부분을 깎아 내는 방법. "문헌의 샘플 평균수익을 몇 % 깎아야 하는가"라는 질문에 답합니다.
- 로컬 FDR: "이 특정 팩터가 가짜일 확률은?"이라는 질문에 답합니다.
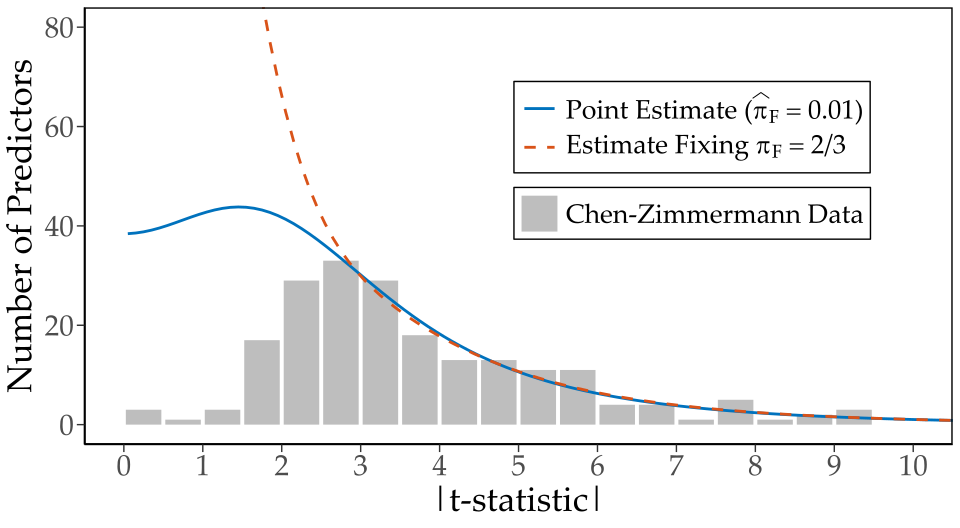
저자는 Chen-Zimmermann의 오픈 자산가격결정 데이터(횡단면 수익률 예측 문헌의 복제 데이터)로 구조모형을 추정하고, 부트스트랩(500회 재추정)으로 불확실성을 측정합니다.
결과 — 무엇을 알아냈나
핵심 수치를 하나씩 정리합니다.
1. "임계값을 올려라"는 결론은 데이터로 지지되지 않는다.
- 저자가 직접 추정한 거짓 팩터 비중의 점추정은 0.01(사실상 거의 모든 팩터가 진짜)이지만, 90% 신뢰구간이 0.01~0.90으로 어마어마하게 넓습니다. 약 50% 구간조차 0.01~0.70입니다.
- 부트스트랩으로 반복 추정한 '적정 t-임계값'의 분포는 0에서 3.0까지 넓게 퍼집니다. FDR 상한을 5%로 놓은 기준입니다. 고전적 기준인 1.96은 이 분포의 한가운데에 있습니다. 데이터가 "올려야 할까요, 낮춰야 할까요?"에 거의 답을 못 해 주는 겁니다.
2. 반면 축소추정과 로컬 FDR은 놀랍도록 안정적이다.
- 축소추정은 26% 이하로 확신할 수 있습니다. 쉽게 말하면, 문헌에 보고된 샘플 평균수익의 최소 74%는 진짜 기대수익이라는 뜻입니다. 참고로 26%는 McLean-Pontiff(2016)가 표본 외(out-of-sample)에서 측정한 통계적 편향 상한과 정확히 맞아떨어집니다.
- 축소추정 분포의 최빈값은 약 12%로, Chen-Zimmermann(2020)의 점추정과 일치합니다.
- 로컬 FDR은 95% 신뢰로 최대 22%. "이 팩터가 가짜일 확률"을 묻는 지표가 이 정도면, 문헌은 상당 부분 건강하다고 읽을 수 있습니다.
- 10개의 대체 모형 사양(출판 확률 함수, 분포 가정, 작은 t-통계량 사용 여부 등)을 전부 바꿔 보아도 축소추정 ≤ 29%, 로컬 FDR ≤ 25%로 결과가 견고합니다.
3. 그래서 저자의 결론: 횡단면 수익률 예측 문헌에 대해서는 "출판된 발견의 최소 75%는 진짜"이며, 이 정도면 적어도 일부 독자는 t-임계값을 올릴 필요가 없다고 판단할 것입니다. 반대로 "문헌이 거의 진짜여야 한다"는 기준을 고수하는 독자는 여전히 더 높은 임계값을 원할 수 있습니다. 저자는 이 판단이 주관적임을 숨기지 않습니다.
흥미로운 점은 논문의 이력입니다. 2018년 SSRN 초고로 처음 공개된 뒤 2024년 v4까지 갱신되면서 동료심사 의견이 반영되었고, 그 과정에서 "임계값을 올려야 한다"는 진영과의 논쟁이 정밀해졌습니다. 지금도 자산가격결정 분야의 다중검정 논쟁에서 자주 인용되는 기준점입니다.
한계와 주의점
- 분과 한정: 실증 분석이 횡단면 수익률 예측 문헌에만 기반합니다. 이 분과는 데이터가 깔끔하고 복제 연구(Chen-Zimmermann)가 잘 갖춰져 있어 코딩 오류나 t-통계량 산출 실수의 우려가 적습니다. 다른 경제학·금융 분과에 그대로 적용하려면 별도 검증이 필요합니다.
- "최소 75% 진짜"의 해석: 이 숫자가 정책적으로 무엇을 의미하는지는 독자에 따라 다릅니다. 커트라인 유지의 근거가 될 수도, "아직 25%까지는 열려 있다"는 반론의 근거가 될 수도 있습니다.
- 축소추정의 세부 사양: 경험적 베이즈 방법의 세부 선택(분포 가정 등)에 따른 민감도는 주로 부록과 대체 사양 분석에서 다루어집니다.
- 오래된 질문, 그러나 여전히 유효: 이 논문이 다루는 HLZ 논쟁 자체가 2016~2020년 문헌을 대상으로 합니다. 최근의 팩터 연구 관행(사전 등록, 표본 외 검증)이 널리 퍼지면서 문제의 양상은 일부 달라졌을 수 있습니다.
그래서 투자/실무엔?
퀀트 연구실이나 자산운용사의 알파 리서치 파이프라인에서 바로 쓸 수 있는 교훈은 세 가지입니다.
- "t > 2.0" 같은 컷오프 하나로 신호를 채택하지 마라. 컷오프를 올리는 것으로는 거짓 발견을 통제한다는 보장이 없습니다. 대신 채택된 신호의 기대수익을 축소추정으로 보정하고, 후보 팩터풀 전체에 대한 FDR을 관리하는 편이 데이터가 실제로 지지하는 접근입니다.
- 백테스트 성과의 최소 74%는 '진짜'일 수 있지만, 나머지는 편향일 수 있다. 연구 단계의 샘플 평균수익을 그대로 기대수익으로 쓰지 말고 평균 12% 안팎의 축소(문헌에 따라 최대 26~29%)를 감안해 설계하는 것이 안전합니다.
- 불확실성이 큰 매개변수에 정책을 걸지 마라. 이 논문의 가장 깊은 통찰은 "모른다"를 정확히 아는 것도 정보라는 점입니다. 거짓 팩터 비중처럼 약하게 식별되는 매개변수로 규칙을 만드는 대신, 강하게 식별되는 지표(축소추정, 로컬 FDR)로 의사결정을 옮기는 것이 견고합니다.
더 알아보기
- 원문: Do t-Statistic Hurdles Need to be Raised? (arXiv:2204.10275) — Andrew Y. Chen. 2018년 SSRN 초고, 2024년 v4.
- 5차원 점수 (KB 기준): 종합 83.3 — 새로움 78 · 적용성 76 · 엄밀성 89 · 재현성 86 · 통찰 87. 엄밀성과 통찰이 특히 높은, 이론과 실증이 균형 잡힌 논문입니다.
- 함께 읽으면 좋은 논문:
- Controlling False Discovery Rates under Cross-Sectional Correlations (arXiv:2102.07826) — 상관관계가 있는 팩터들 사이에서 FDR을 통제하는 방법 (A등급)
- Robust Knockoffs for Controlling False Discoveries (arXiv:2206.06026) — 모형 오차에 강건한 거짓발견 통제
- Equity Strategy Backtesting: Luck or Edge? MinervaScore (arXiv:2608.23808) — 백테스트가 실력인지 운인지 판정하는 통계 프레임
관련 글
 포트폴리오 최적화S
2020년 Deep Empirical Risk Minimization in finance: AI 투자 전략이 '미래를 훔쳐보는' 이유
백테스트에서는 대박이 나는데 실전에서는 안 되는 그 이유. 2020년 발표된 이 논문은 딥러닝 투자 모델이 훈련 데이터 안에서 미래 정보를 몰래 암기하는 메커니즘을 이론적으로 증명했습니다. 데이터 규모와 모델 복잡도의 균형으로 과학습을 통제하는 조건까지 쉽게 풀어 설명합니다.
 포트폴리오 최적화S
2021년 세금·주식 수량까지 반영한 포트폴리오 최적화: 수백 밀리초에 풀고 '좋은 답인지'까지 증명하는 법
이론의 포트폴리오 최적화는 매끈한데, 현실은 세금·정수 주식·최소 거래 단위로 뒤범벅입니다. 스탠퍼드 연구진은 이 지저분한 문제를 '쪼개서' 수백 밀리초에 풀고, 그 답이 최적에 얼마나 가까운지 하한까지 계산해 보증하는 프레임워크를 제시했습니다. 소규모 계좌 운용과 세금 인식 리밸런싱에 바로 쓸 수 있는 실용 최적화의 교과서를 쉽게 풀어 설명합니다.
 알고리즘 트레이딩S
강화학습 주문집행이 실전에서 실패하는 이유: 2023년 일반화 거래집행 RL
백테스트에서는 완벽했던 강화학습 주문집행 알고리즘이 실전에서 무너지는 이유를 이론과 실험으로 규명한 2023년 연구를 쉽게 풀어 설명합니다. 과적합의 구조적 원인, 컨텍스트 압축 해법, 그리고 실전 적용 시사점을 다룹니다.